


ניהול צינורות עיבוד נתונים
המסמך הזה עוזר למהנדסי אבטחה להגדיר ולנהל צינורות עיבוד נתונים ב-Google SecOps כדי לסנן אירועים, לשנות שדות או לצנזר ערכים רגישים לפני ההטמעה. התכונה הזו מספקת שליטה חזקה לפני הניתוח בתהליך הטמעת הנתונים. אם תפעלו לפי השיטות המומלצות במדריך הזה, תוכלו לשפר את תאימות הנתונים, להוזיל עלויות ולהגן על מידע רגיש ב-Google SecOps.
עיבוד הנתונים מפשט את ניהול היומנים באמצעות הפעולות העיקריות הבאות:
- סינון: כדי לצמצם את כמות הנתונים הלא רלוונטיים ולהפחית את העלויות, אפשר להטמיע רק אירועים רלוונטיים.
- טרנספורמציה: שינוי של פורמטים של נתונים, ניתוח שדות והעשרת יומנים כדי לשפר את נוחות השימוש.
- Redact: הגנה על מידע רגיש על ידי הסתרה או הסרה של ערכים רגישים לפני האחסון.
בתרשים הבא מוצג איך הנתונים זורמים אל Google SecOps ואיך המערכת מעבדת אותם:
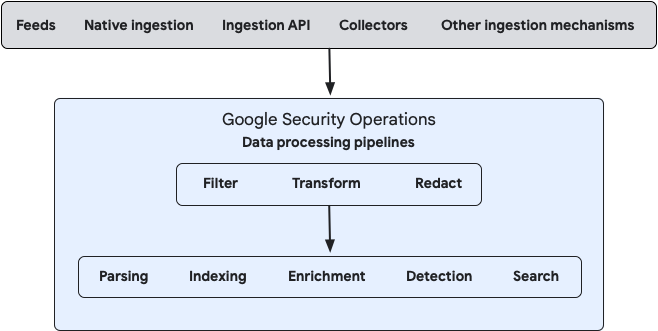
אתם יכולים להגדיר עיבוד נתונים גם לסטרימינג של נתונים מקומיים וגם לסטרימינג של נתונים בענן, באמצעות מסוף הניהול של Bindplane או באמצעות ממשקי ה-API הציבוריים של Google SecOps Data Pipeline באופן ישיר.
תרחישים נפוצים לדוגמה
דוגמאות לתרחישים לדוגמה של עיבוד נתונים:
- מסירים צמדי מפתח/ערך ריקים מיומנים גולמיים.
- צנזור מידע אישי רגיש.
- הוספת תוויות הטמעה מתוכן של יומן גולמי.
- בסביבות עם כמה מופעים במקביל, צריך להוסיף תוויות הטמעת נתונים לנתוני היומן שמוטמעים ישירות כדי לזהות את המכונה של מקור הסטרימינג (למשלGoogle Cloud Workspace).
- סינון נתוני Palo Alto Cortex לפי ערכי שדות.
- צמצום נתוני SentinelOne לפי קטגוריה.
- חילוץ מידע על המארח מפידים ומיומני הטמעה ישירה, ומיפוי שלו לשדה
ingestion_sourceב-Cloud Monitoring.
מונחים חשובים
עיבוד הנתונים כולל את הרכיבים הבאים:
- מקורות נתונים: זרימה ספציפית של נתונים, שמוגדרת לפי סוג היומן ומקור ההטמעה (כמו פיד או API), ומשמשת כקלט לפייפליין של עיבוד נתונים.
- צומת מעבד: רכיב בתוך צינור עיבוד נתונים שמכיל מעבד אחד או יותר, כמו פעולות סינון, המרה או צנזור. המעבדים האלה משנים את הנתונים באופן רציף כשהם עוברים דרך הצומת.
- יעד: נקודת הקצה של צינור עיבוד הנתונים, בדרך כלל המכונה של Google SecOps שאליה נשלחים הנתונים המעובדים להטמעה ולניתוח סופיים.
לפני שמתחילים
לפני שמתחילים להגדיר צינורות עיבוד נתונים, חשוב לעיין בדרישות הבאות:
- ההשפעה על המנתח ועל ה-UDM: צינורות עיבוד הנתונים משנים את נתוני היומן הגולמיים לפני שהם מגיעים למנתחים של Google SecOps. השינויים האלה יכולים להשפיע על האופן שבו מנתחי הנתונים מפרשים את היומנים וממירים אותם לפורמט Unified Data Model (UDM). לפני שמפעילים צינור עיבוד נתונים של פיד או סוג יומן, חשוב לוודא שכללי הסינון, הטרנספורמציה או הצינזור לא משנים בטעות את הנתונים באופן שמונע מהמנתחים ליצור אירועי UDM נכונים.
תמיכה ב-API: עיבוד הנתונים נתמך בסטרימינג מבוסס-דחיפה באמצעות קריאה ל-Chronicle API. מסננים שמוגדרים בכלי לניהול עיבוד נתונים (DPM) מופעלים אחרי שהנתונים מתקבלים על ידי Chronicle Ingestion API. לכן, המסננים האלה לא מונעים מהלקוחות לחרוג מהמכסות ומהמגבלות של Ingestion API, כמו המגבלות של importPushLog API, כי המגבלות האלה נבדקות לפני הסינון של DPM. כדי לנהל ביעילות את מגבלות ה-Ingestion API ולעמוד בהן, הלקוחות צריכים להטמיע סינון במקור הנתונים עצמו, ולא להסתמך על מסנני DPM.
חשיפת הנתונים: נתונים שמועברים ממעבירי נתונים ומ-Bindplane מתויגים ב-
collectorIDנפרד מנתונים שמועברים ישירות. כדי לתמוך בחשיפה מלאה של היומנים, צריך לבחור את כל שיטות ההטמעה כששולחים שאילתות למקורות נתונים, או להפנות באופן מפורש ל-collectorIDהרלוונטי כשמקיימים אינטראקציה עם ה-API.הגדרה של מסוף Bindplane: אם אתם מתכננים להשתמש במסוף Bindplane להגדרה ולניהול, בצעו את השלבים הבאים:
במסוף Google SecOps, מקצים את אחד מהתפקידים הבאים למשתמש או לחשבון השירות שבאמצעותם תגדירו את השילוב של Bindplane:
תפקיד בהתאמה אישית עם ההרשאות הבאות:
chronicle.logProcessingPipelines.associateStreamschronicle.logProcessingPipelines.createchronicle.logProcessingPipelines.deletechronicle.logProcessingPipelines.dissociateStreamschronicle.logProcessingPipelines.fetchAssociatedPipelinechronicle.logProcessingPipelines.fetchSampleLogsByStreamschronicle.logProcessingPipelines.getchronicle.logProcessingPipelines.listchronicle.logProcessingPipelines.testPipelinechronicle.logProcessingPipelines.updatechronicle.logTypes.getchronicle.logTypes.listchronicle.feeds.getchronicle.feeds.listchronicle.logs.list-
chronicle.parsers.list: ההרשאה הזו נדרשת רק אם משתמשים בפעולה Validate SecOps Parser של Bindplane. -
chronicle.parsers.runParser: ההרשאה הזו נדרשת רק אם משתמשים בפעולה Validate SecOps Parser של Bindplane.
מומלץ להשתמש בתפקיד בהתאמה אישית עם ההרשאות הנדרשות שצוינו.
מידע נוסף זמין במאמרים יצירה וניהול של תפקידים בהתאמה אישית והגדרת בקרת גישה לתכונות באמצעות IAM.
התפקיד המוגדר מראש "אדמין של Chronicle API" (
roles/chronicle.admin).פרטים נוספים זמינים במאמר הקצאת התפקיד "אדמין IAM בפרויקט" בפרויקט ייעודי.
מתקינים את מסוף Bindplane Server. ל-SaaS או ל-on-premises, ראו התקנת מסוף Bindplane Server. חשוב לוודא שאתם מתקינים את הגרסה העדכנית של Bindplane (או את גרסה 1.96.4 ואילך של Bindplane).
במסוף Bindplane, מחברים את מכונת היעד של Google SecOps לפרויקט Bindplane. פרטים נוספים זמינים במאמר התחברות למכונה של Google SecOps.
התחברות למכונה של Google SecOps
לפני שמתחילים, ודאו שיש לכם הרשאות אדמין בפרויקט ב-Bindplane כדי לגשת לדף Project Integrations.
מכונת Google SecOps משמשת כיעד לפלט הנתונים.
כדי להתחבר למכונה של Google SecOps באמצעות מסוף Bindplane Server:
- במסוף Bindplane Server, לוחצים על Menu ובוחרים באפשרות הגדרות הפרויקט.
- בדף Project Settings (הגדרות הפרויקט), עוברים לכרטיס Integrations (שילובים) ולוחצים על Connect to Google SecOps (התחברות ל-Google SecOps) כדי לפתוח את החלון Edit Integration (עריכת השילוב).
מזינים את פרטי המכונה של Google SecOps שאליה רוצים להעביר את הנתונים.
המופע הזה מטמיע את הנתונים המעובדים (הפלט של עיבוד הנתונים) באופן הבא:שדה תיאור אזור האזור של מכונת Google SecOps.
כדי למצוא את המכונה במסוף Google Cloud , נכנסים אל Security > Detections and Controls > Google Security Operations > Instance details.מספר לקוח מספר הלקוח של המכונה שלכם ב-Google SecOps.
במסוף Google SecOps, עוברים אל Settings > Administration > Profile > Organization details.Google Cloud מספר הפרויקט Google Cloud מספר הפרויקט של מכונת Google SecOps.
כדי למצוא את מספר הפרויקט במסוף Google SecOps, עוברים אל Settings > Administration > Profile > Organization details.פרטי כניסה פרטי הכניסה לחשבון השירות הם ערך ה-JSON שנדרש כדי לאמת את ממשקי ה-API של פייפליין הנתונים של Google SecOps ולגשת אליהם. את ערך ה-JSON הזה אפשר לקבל מקובץ פרטי הכניסה של חשבון השירות ב-Google.
חשבון השירות צריך להיות באותו פרויקט Google Cloud כמו המכונה של Google SecOps, וצריך להיות לו את התפקיד "אדמין של Chronicle API" (roles/chronicle.admin) או תפקיד בהתאמה אישית עם ההרשאות הנדרשות (ראו דרישות מוקדמות).
במאמר יצירה ומחיקה של מפתחות לחשבונות שירות מוסבר איך יוצרים חשבון שירות ומורידים את קובץ ה-JSON.
לחלופין, פריסות של Bindplane Cloud תומכות באיחוד שירותי אימות הזהות של עומסי עבודה (WIF) לצורך אימות. אין תמיכה ב-WIF בפריסות של Bindplane באירוח עצמי. מידע נוסף זמין במאמר קישור של Google SecOps Integration עם אימות WIF.לוחצים על Connect. אם פרטי החיבור נכונים והתחברתם בהצלחה ל-Google SecOps, אתם יכולים לצפות לדברים הבאים:
- נפתח חיבור למכונה של Google SecOps.
- בפעם הראשונה שמתחברים, הכרטיסייה SecOps Pipelines מופיעה במסוף Bindplane.
- במסוף Bindplane מוצגים כל הנתונים המעובדים שהגדרתם בעבר למכונה הזו באמצעות ה-API. המערכת ממירה חלק מהמעבדים שהגדרתם באמצעות ה-API למעבדי Bindplane, ומציגה אחרים בפורמט הגולמי שלהם ב-OpenTelemetry Transformation Language (OTTL). אתם יכולים להשתמש במסוף Bindplane כדי לערוך צינורות עיבוד נתונים ומעבדים שהוגדרו בעבר באמצעות ה-API.
אחרי שיוצרים חיבור למכונה של Google SecOps, אפשר להגדיר את עיבוד הנתונים.
הגדרת עיבוד נתונים באמצעות מסוף Bindplane
בקטע הזה מוסבר איך להקצות ולפרוס צינור עיבוד נתונים חדש של יומנים ב-Google SecOps באמצעות מסוף Bindplane. אתם יכולים גם להשתמש במסוף Bindplane כדי לנהל צינורות עיבוד נתונים שהוגדרו בעבר באמצעות ה-API.
יצירת צינור עיבוד נתונים חדש ב-Google SecOps
צינור עיבוד נתונים ב-Google SecOps הוא מאגר שבו אתם יכולים להגדיר מאגר אחד של עיבוד נתונים. כדי ליצור מאגר חדש של צינור עיבוד נתונים ב-Google SecOps:
- במסוף Bindplane, לוחצים על הכרטיסייה SecOps Pipelines כדי לפתוח את הדף SecOps Pipelines.
- לוחצים על Create SecOps Pipeline.
מזינים את שם הצינור של SecOps ואת התיאור.
לוחצים על יצירה. מאגר הצינורות החדש מופיע בדף SecOps Pipelines.
מגדירים את ה-processors וה-streams של מאגר עיבוד הנתונים בתוך המאגר הזה.
הגדרת מאגר לעיבוד נתונים
מאגר עיבוד נתונים מגדיר את מקורות הנתונים שצריך להטמיע ואת המעבדים שצריך להפעיל לפני שהנתונים מגיעים אל היעד.
מגדירים את הסטרימינג ואת צומתי המעבדים בכרטיס ההגדרות של pipeline.
כדי להגדיר מאגר לעיבוד נתונים:
- אם עדיין לא עשיתם את זה, יוצרים צינור עיבוד נתונים חדש ב-Google SecOps.
- במסוף Bindplane, לוחצים על הכרטיסייה SecOps Pipelines כדי לפתוח את הדף SecOps Pipelines.
- בוחרים את צינור עיבוד הנתונים ב-Google SecOps שבו רוצים להגדיר את מאגר עיבוד הנתונים החדש.
בכרטיס ההגדרות של Pipeline:
- מוסיפים מקור נתונים.
- מגדירים את צומת המעבד. כדי להוסיף מעבד באמצעות מסוף Bindplane, קראו את המאמר הגדרת מעבדים.
אחרי שמשלימים את ההגדרות האלה, אפשר לעבור לקטע השקת עיבוד הנתונים כדי להתחיל לעבד את הנתונים.
הוספת מקור נתונים
כדי להוסיף שידור:
- בכרטיס ההגדרות Pipeline, לוחצים על add Add Stream כדי לפתוח את החלון Add Stream.
בחלון הוספת מקור נתונים, מזינים פרטים בשדות הבאים:
שדה תיאור סוג היומן בוחרים את סוג היומן של הנתונים שרוצים להטמיע. לדוגמה, CrowdStrike Falcon (CS_EDR).
הערה: סמל האזהרה Warning מציין שסוג היומן כבר מוגדר בסטרימינג אחר (בצינור עיבוד הנתונים הזה או בצינור עיבוד נתונים אחר במכונה של Google SecOps).
כדי להשתמש בסוג יומן שלא זמין, צריך קודם למחוק אותו מההגדרה של הסטרימינג האחר.
הוראות לאיתור הגדרת הסטרימינג שבה מוגדר סוג היומן מפורטות במאמר סינון הגדרות של צינור עיבוד נתונים ב-SecOps.שיטת הטמעת הנתונים בוחרים את שיטת ההטמעה שבה רוצים להשתמש כדי להטמיע את הנתונים של סוג היומן שנבחר. שיטות ההטמעה האלה הוגדרו בעבר למכונה שלכם ב-Google SecOps.
צריך לבחור אחת מהאפשרויות הבאות:
- All Ingestion Methods: כולל את כל שיטות ההטמעה של סוג היומן שנבחר. אם בוחרים באפשרות הזו, אי אפשר להוסיף עוד מקורות נתונים שמשתמשים בשיטות הטמעה ספציפיות לאותו סוג של יומן. חריג: אתם יכולים לבחור שיטות הטמעה ספציפיות אחרות שלא הוגדרו לסוג היומן הזה בסטרימים אחרים.
- שיטת הטמעה ספציפית, כמו
Cloud Native Ingestion,Feed,Modern Chronicle Ingestion APIאוWorkspace Ingestion.
פיד אם בוחרים באפשרות Feedכשיטת ההטמעה, מופיע שדה נוסף עם רשימה של פידים זמינים בהגדרות > ניהול נתונים > פידים במכונה של Google SecOps לסוג היומן שנבחר. כדי להשלים את ההגדרה, צריך לבחור את הפיד הרלוונטי. כדי לראות ולנהל את הפידים הזמינים, עוברים אל הגדרות > ניהול נתונים > פידים. אם אתם משתמשים בפלטפורמה של SIEM בלבד, עוברים אל הגדרות > פידים.- All Ingestion Methods: כולל את כל שיטות ההטמעה של סוג היומן שנבחר. אם בוחרים באפשרות הזו, אי אפשר להוסיף עוד מקורות נתונים שמשתמשים בשיטות הטמעה ספציפיות לאותו סוג של יומן. חריג: אתם יכולים לבחור שיטות הטמעה ספציפיות אחרות שלא הוגדרו לסוג היומן הזה בסטרימים אחרים.
לוחצים על הוספת מקור נתונים כדי לשמור את מקור הנתונים החדש.מקור הנתונים החדש מופיע מיד בכרטיס ההגדרות של Pipeline. הסטרימינג מקושר באופן אוטומטי לצומת המעבד וליעד של Google SecOps.
סינון הגדרות של צינורות עיבוד נתונים ב-SecOps
סרגל החיפוש בדף SecOps Pipelines מאפשר לכם לסנן ולאתר את צינורות עיבוד הנתונים של Google SecOps (מאגרי עיבוד נתונים) על סמך כמה רכיבי הגדרה. אפשר לסנן צינורות עיבוד נתונים לפי קריטריונים ספציפיים, כמו סוג היומן, שיטת ההטמעה או שם הפיד.
כדי לסנן, משתמשים בתחביר הבא:
logType:valueingestionMethod:valuefeed:value
לדוגמה, כדי לזהות הגדרות של מקורות נתונים שמכילות סוג יומן ספציפי, מזינים logtype: בשורת החיפוש ובוחרים את סוג היומן מהרשימה שמופיעה.
הגדרת מעבדים
במאגר לעיבוד נתונים יש צומת מעבד אחד, שמכיל מעבד אחד או יותר. כל מעבד משנה את נתוני הסטרימינג ברצף:
- המעבד הראשון מעבד את הנתונים הגולמיים של הסטרימינג.
- הפלט שמתקבל מהמעבד הראשון הופך מיד לקלט של המעבד הבא ברצף.
- הרצף הזה ממשיך לכל המעבדים הבאים, בדיוק בסדר שבו הם מופיעים בחלונית Processors, כשהפלט של מעבד אחד הופך לקלט של המעבד הבא.
- מגדירים את צומת המעבד על ידי הוספה, הסרה או שינוי של הרצף של מעבד אחד או יותר.
דרישות להגדרת מעבד Unroll
- המעבד Unroll לא יכול לפעול ישירות על מחרוזות גולמיות. הוא דורש ייצוג אובייקט פנימי מובנה, כמו JSON, XML או CSV מנותחים.
- כדי לנתח את המטען הייעודי (payload) של היומן הגולמי לפני ביטול הפריסה, צריך להציב מעבד Transform תואם לפני מעבד Unroll בצינור עיבוד הנתונים.
- דוגמה ל-JSON: כדי לנתח מחרוזת מטען ייעודי (payload) גולמית של JSON לפני פריסת רכיבי המערך, מוסיפים מעבד טרנספורמציה עם הצהרת OTTL:
set(body, ParseJSON(body)). - פורמטים אחרים: נדרשים שלבי טרנספורמציה דומים לפני הניתוח של נתוני יומן בפורמט CSV, XML או YAML.
בטבלה הבאה מפורטים המעבדים:
| סוג המעבד | יכולת |
|---|---|
| מסנן | סינון לפי תנאים |
| מסנן | סינון לפי סטטוס HTTP |
| מסנן | סינון לפי שם המדד |
| מסנן | סינון לפי ביטוי רגולרי (regex) |
| מסנן | סינון לפי חומרה |
| צנזור | צנזור מידע אישי רגיש |
| המרה | הוספת שדות |
| המרה | Coalesce |
| המרה | Concat |
| המרה | העתקת השדה |
| המרה | מחיקת שדות |
| המרה | מרשל |
| המרה | העברת השדה |
| המרה | ניתוח קובץ CSV |
| המרה | ניתוח JSON |
| המרה | ניתוח ערך המפתח |
| המרה | ניתוח שדות של חומרה |
| המרה | ניתוח חותמת הזמן |
| המרה | ניתוח באמצעות ביטוי רגולרי (regex) |
| המרה | ניתוח XML |
| המרה | שינוי שמות של שדות |
| המרה | שכתוב חותמת הזמן |
| המרה | פיצול |
| המרה | המרה |
| ביטול ההרשמה | פיצול אירועים פיצול של פרוסת יומנים לכמה אירועי יומן נפרדים |
הוספת מעבד
כדי להוסיף מעבד, פועלים לפי השלבים הבאים:
בכרטיס ההגדרות Pipeline, לוחצים על הצומת Processor כדי לפתוח את החלון Edit Processors. החלון Edit Processors מחולק לחלוניות הבאות, שמסודרות לפי זרימת הנתונים:
- קלט (או נתוני מקור): נתוני יומן של סטרימינג נכנס מהזמן האחרון (לפני העיבוד)
- הגדרה (או רשימת מעבדים): מעבדים וההגדרות שלהם
- פלט (או תוצאות): נתוני יומן של תוצאות יוצאות מהזמן האחרון (אחרי עיבוד)
אם הצינור כבר הושק, המערכת מציגה בחלוניות את נתוני היומן הנכנסים האחרונים (לפני העיבוד) ואת נתוני היומן היוצאים האחרונים (אחרי העיבוד).
לוחצים על Add Processor כדי להציג את רשימת המעבדים. לנוחיותכם, רשימת המעבדים מקובצת לפי סוג המעבד. כדי לארגן את הרשימה ולהוסיף חבילות משלכם, בוחרים מעבד אחד או יותר ולוחצים על הוספת חבילות מעבדים חדשות.
ברשימת המעבדים, בוחרים מעבד שרוצים להוסיף.
מגדירים את המעבד לפי הצורך.
לוחצים על Save כדי לשמור את הגדרת המעבד בצומת Processor.
המערכת בודקת מיד את ההגדרה החדשה על ידי עיבוד דגימה חדשה של נתוני הסטרימינג הנכנסים (מהחלונית Input) ומציגה את הנתונים היוצאים שנוצרו בחלונית Output.
השקת צינור עיבוד נתונים
אחרי שמסיימים להגדיר את הסטרימינג והמעבד, צריך להשיק את צינור עיבוד הנתונים כדי להתחיל לעבד את הנתונים:
- לוחצים על התחלת ההשקה. הפעולה הזו מפעילה מיד את עיבוד הנתונים ומאפשרת לתשתית של Google להתחיל לעבד נתונים בהתאם להגדרות שלכם. אם ההשקה תצליח, מספר הגרסה של מאגר עיבוד הנתונים יגדל ויוצג לצד
nameשל המאגר.
הגדרת עיבוד נתונים באמצעות שיטות API
במקום להשתמש במסוף Bindplane, אתם יכולים להשתמש בשיטות של פייפליין של Google SecOps כדי לנהל את הנתונים המעובדים. השיטות האלה של פייפליינים כוללות יצירה, עדכון, מחיקה ורישום של פייפליינים, ושיוך של פידים וסוגי יומנים לפייפליינים.
כדי להשתמש בדוגמאות שבקטע הזה:
- החליפו את הפרמטרים הספציפיים ללקוח (לדוגמה, כתובות URL ומזהי פידים) בפרמטרים שמתאימים לסביבה שלכם.
- הוסיפו אימות משלכם. בקטע הזה, הטוקנים למוכ"ז מצונזרים באמצעות
******.
הצגת רשימה של כל צינורות עיבוד הנתונים במכונה ספציפית של Google SecOps
הפקודה הבאה מציגה את כל צינורות עיבוד הנתונים שקיימים במכונה ספציפית של Google SecOps:
curl --location 'https://abc.def.googleapis.com/v123/'\
'projects/projectabc-byop/locations/us/'\
'instances/aaaa1aa1-111a-11a1-1111-11111a1aa1aa/'\
'logProcessingPipelines' \
--header 'Authorization: Bearer ******'
יצירת צינור עיבוד נתונים בסיסי עם מעבד אחד
כדי ליצור צינור עיבוד נתונים בסיסי עם מעבד טרנספורמציה אחד שמעדכן או מוסיף (upsert) את הערך של תווית הטמעה בהתאמה אישית, ומשייך אליו שלושה מקורות:
מריצים את הפקודה הבאה:
curl --location 'https://abc.def.googleapis.com/v123/projects/projectabc-byop/locations/us/instances/aaaa1aa1-111a-11a1-1111-11111a1aa1aa/logProcessingPipelines' \
--header 'Content-Type: application/json' \
--header 'Authorization: Bearer ******' \
--data '{
    "displayName": "Example Pipeline",
    "description": "My description",
    "processors": [
        {
            "transformProcessor": {
                "statements": [
                    "set(attributes[\"labels.myLabel.value\"], \"myValue\")"
                ]
            }
        }
    ]
}'
מעתיקים את הערך של השדה
nameמהתשובה.מריצים את הפקודה הבאה כדי לשייך שלושה מקורות נתונים (סוג יומן, סוג יומן עם מזהה אוסף ופיד) לצינור עיבוד הנתונים. משתמשים בערך של השדה
nameבתור הערך של{pipelineName}.curl --location 'https://abc.def.googleapis.com/v123/{pipelineName}:associateStreams' \ --header 'Content-Type: application/json' \ --header 'Authorization: Bearer ******' \ --data '{ "streams": [ { "logType": "MICROSOFT_SENTINEL" }, { "logType": "A10_LOAD_BALANCER", "collectorId": "dddddddd-dddd-dddd-dddd-dddddddddddd" }, { "feed": "1a1a1a1a-1a1a-1a1a-1a1a-1a1a1a1a1a1a" } ] }'
יצירת צינור עיבוד נתונים עם שלושה מעבדים
צינור עיבוד נתונים משתמש במעבדים הבאים:
- Filter: סינון של יומנים שתואמים לתנאי שמבוסס על תוויות ההטמעה.
- Transform: מעדכן או מוסיף (upsert) את הערך של מרחב השמות.
- צנזור: צנזור של כתובות אימייל ומספרי תעודות זהות מנתוני היומן על סמך תבניות של ביטויים רגולריים בהתאמה אישית.
כדי ליצור צינור עיבוד נתונים ולשייך אליו שלושה מקורות:
מריצים את הפקודה הבאה:
curl --location 'https://abc.def.googleapis.com/v123/projects/projectabc-byop/locations/us/instances/aaaa1aa1-111a-11a1-1111-11111a1aa1aa/logProcessingPipelines' \
--header 'Content-Type: application/json' \
--header 'Authorization: Bearer ******' \
--data-raw '{
    "displayName": "My Pipeline 2",
    "description": "My description 2",
    "processors": [
        {
            "filterProcessor": {
                "logConditions": [
                    "attributes[\"labels.log_source.value\"] == \"myLogSourceToFilterOut\""
                ]
            }
        },
        {
            "transformProcessor": {
                "statements": [
                    "set(attributes[\"environment_namespace\"], \"myValue\")"
                ]
            }
        },
        {
            "redactProcessor": {
                "blockedValues": [
                    "\\b\\d{3}[- ]\\d{2}[- ]\\d{4}\\b",
                    "\\b[a-zA-Z0-9._/\\+\\-—|]+@[A-Za-z0-9\\-—|]+\\.[a-zA-Z|]{2,6}\\b"
                ],
                "allowAllKeys": true
            }
        }
    ]
}'
מעתיקים את הערך של השדה
nameמהתשובה.מריצים את הפקודה הבאה כדי לשייך שלושה מקורות נתונים (סוג יומן, סוג יומן עם מזהה אוסף ופיד) לצינור עיבוד הנתונים. משתמשים בערך של השדה
nameבתור הערך של{pipelineName}.curl --location 'https://abc.def.googleapis.com/v123/{pipelineName}:associateStreams' \ --header 'Content-Type: application/json' \ --header 'Authorization: Bearer ******' \ --data '{ "streams": [ { "logType": "MICROSOFT_SENTINEL" }, { "logType": "A10_LOAD_BALANCER", "collectorId": "dddddddd-dddd-dddd-dddd-dddddddddddd" }, { "feed": "1a1a1a1a-1a1a-1a1a-1a1a-1a1a1a1a1a1a" } ] }'
פתרון בעיות
בקטע הזה מפורטות הציפיות לגבי הביצועים ופתרונות בשירות עצמי לבעיות נפוצות.
זמן אחזור ומגבלות
אם אתם מגדירים סוכן באמצעות Ingestion API, יכול להיות שזמני האישור יהיו ארוכים יותר בצינורות עיבוד נתונים בנפח נמוך ב-Google SecOps.
ממוצעי זמן האחזור יכולים לעלות מ-700 אלפיות השנייה עד ל-2 שניות. מגדילים את תקופות הזמן הקצוב לתפוגה ואת הזיכרון לפי הצורך. זמן האישור מתקצר כשקצב העברת הנתונים עולה על 4MB.
אימות ובדיקה
אתם יכולים לראות את פרטי עיבוד הנתונים במסוף Google SecOps:
הצגת כל ההגדרות של עיבוד הנתונים
- במסוף Google SecOps, עוברים אל הגדרות > ניהול נתונים > עיבוד נתונים. שם אפשר לראות את כל צינורות עיבוד הנתונים שהוגדרו.
- בשורת החיפוש צינורות עיבוד נתונים נכנסים, חפשו את הפייפליין שיצרתם. אפשר לחפש לפי רכיבים, כמו שם צינור עיבוד הנתונים או רכיבים. בתוצאות החיפוש מוצגים המעבדים של צינור עיבוד הנתונים וסיכום של ההגדרות שלו.
- בסיכום של צינור עיבוד הנתונים, אתם יכולים לבצע את הפעולות הבאות:
- בודקים את הגדרות המעבד.
- מעתיקים את פרטי ההגדרות.
- לוחצים על Open in Bindplane כדי לגשת לצינור עיבוד הנתונים ולנהל אותו ישירות במסוף Bindplane.
צפייה בפידים שהוגדרו
כדי לראות את הפידים שהוגדרו במערכת:
- במסוף Google SecOps, עוברים אל Settings > ניהול נתונים > Feeds. אם אתם משתמשים בפלטפורמה של SIEM בלבד, עוברים אל הגדרות > פידים. בדף פידים מוצגים כל הפידים שהגדרתם במערכת.
- מעבירים את הסמן מעל כל שורה כדי להציג את תפריט האפשרויות הנוספות ⋮, שבו אפשר לראות את פרטי הפיד, לערוך, להשבית או למחוק אותו.
- לוחצים על הצגת פרטים כדי לפתוח את חלון הפרטים.
- לוחצים על Open in Bindplane כדי לפתוח את הגדרות הסטרימינג של הפיד הזה במסוף Bindplane.
הצגת פרטי עיבוד הנתונים של סוגי היומנים הזמינים
כדי לראות את פרטי עיבוד הנתונים בדף Available Log Types, שבו אפשר לראות את כל סוגי היומנים הזמינים:
- במסוף Google SecOps, עוברים אל Settings > ניהול נתונים > Available Log Types. אם אתם משתמשים בפלטפורמה של SIEM בלבד, עוברים אל הגדרות > סוגי יומנים זמינים. בדף הראשי מוצגים כל סוגי היומנים.
- מעבירים את הסמן מעל כל שורה של פיד כדי להציג את התפריט more_vert עוד. בתפריט הזה אפשר לראות, לערוך, להשבית או למחוק את פרטי הפיד.
- לוחצים על הצגת עיבוד הנתונים כדי לראות את הגדרות הפיד.
- לוחצים על Open in Bindplane כדי לפתוח את הגדרות המעבד במסוף Bindplane.
הבעיה עדיין לא נפתרה? קבלת תשובות מחברי הקהילה וממומחי Google SecOps.