


Architettura e flussi di dati di Google SecOps
Gli ambienti di sicurezza moderni generano enormi quantità di telemetria in infrastrutture cloud-native, microservizi ed endpoint distribuiti. Le architetture SIEM (Security Information and Event Management) legacy spesso faticano a scalare con questi volumi di dati, con conseguenti query lente e visibilità frammentata.
La piattaforma Google Security Operations fornisce un livello di analisi della sicurezza unificato e ad alte prestazioni. Basato sulla stessa infrastruttura alla base dei principali servizi globali di Google, importa ed esegue query su petabyte di telemetria di sicurezza con una latenza inferiore a un secondo, eliminando la distinzione legacy tra i livelli di dati ad accesso frequente e ad accesso raro.
Questo documento descrive l'architettura e i flussi di dati di Google SecOps, coprendo l'importazione, la normalizzazione UDM, il rilevamento delle minacce YARA-L e la risposta automatica.
Convergenza di intelligence, analisi e risposta
Google SecOps unifica funzionalità di operazioni di sicurezza storicamente separate. Combina l'analisi SIEM e la Security Orchestration, Automation and Response (SOAR) in una piattaforma strettamente accoppiata. Inoltre, incorpora la threat intelligence di Google Threat Intelligence e VirusTotal, nonché funzionalità di AI generativa basate su Gemini direttamente nei workflow di indagine e rilevamento.
Panoramica dell'architettura della piattaforma
Google SecOps opera come un piano di sicurezza specializzato e cloud-native basato sull'infrastruttura Google Cloud di base. Eredita le proprietà di scalabilità, durabilità e prestazioni dei servizi Google sottostanti, tra cui Spanner e Colossus.
Contesto del sistema
Google SecOps funge da piano operativo centrale per il tuo ambiente di sicurezza, gestendo i dati in tre fasi principali:
- Input: acquisisce la telemetria da ambienti ibridi, inclusi i raccoglitori on-premise (come l'agente BindPlane), le API del provider di servizi cloud e i connettori Software as a Service (SaaS) di terze parti diretti.
- Core di elaborazione: normalizza la telemetria non elaborata nello schema UDM strutturato, valuta gli eventi utilizzando il motore di rilevamento YARA-L e orchestra i flussi di lavoro utilizzando il motore di gestione dei casi SOAR.
- Output: fornisce informazioni di sicurezza utilizzabili e approfondimenti sul triage dell'AI agli analisti, inviando al contempo comandi di contenimento automatizzati agli ambienti di destinazione tramite API e agenti remoti.
Il seguente diagramma illustra il contesto del sistema e i flussi di dati.

Vantaggio dell'infrastruttura
Un vantaggio architettonico fondamentale di Google SecOps è il suo modello di hot storage unificato. Le architetture legacy spostano la telemetria precedente nell'archiviazione a freddo, rallentando le query o richiedendo la reidratazione manuale. Al contrario, Google SecOps conserva tutta la telemetria importata in uno stato attivo e ricercabile nell'indice per un massimo di 12 mesi. Questo design ti consente di eseguire query su un anno intero di dati storici con le stesse prestazioni dell'esecuzione di query sull'ultima ora.
Pipeline di raccolta e normalizzazione dei dati
Google SecOps utilizza una pipeline di importazione ad alta velocità effettiva che trasforma i log non strutturati non elaborati nel Unified Data Model (UDM) strutturato. Durante la normalizzazione, la pipeline arricchisce ogni evento con metadati contestuali dal grafico del contesto delle entità.
Architettura della raccolta
L'acquisizione dei dati avviene in tre vettori principali:
- Collector: collector basati su agenti (come l'agente BindPlane o gli agenti OpenTelemetry) di cui è stato eseguito il deployment all'interno delle reti locali per aggregare i dati syslog e dei pacchetti. I raccoglitori memorizzano nel buffer, comprimono e criptano la telemetria a livello di trasporto (TLS) prima di inoltrarla a Google SecOps.
- API di importazione: endpoint API REST diretti che importano la telemetria strutturata e non strutturata da servizi cloud, applicazioni personalizzate e pipeline serverless.
- Integrazioni di terze parti: connettori integrati basati su pull che recuperano log, avvisi e dati di directory direttamente da piattaforme SaaS esterne e API cloud (come Microsoft 365 o Microsoft Entra ID).
Flusso della pipeline di raccolta e preparazione dei dati
Il seguente diagramma descrive in dettaglio i passaggi di trasformazione specifici dai dati non elaborati al formato UDM.

Panoramica dello schema del modello di dati unificato
L'Unified Data Model (UDM) normalizza i log di fornitori diversi in un unico schema strutturato. Questa rappresentazione standard semplifica l'analisi e la ricerca garantendo che entità equivalenti (come indirizzi IP, nomi utente o hash di file) condividano percorsi di campo coerenti in tutte le origini log.
Architettura dello schema UDM
UDM utilizza uno schema gerarchico fortemente tipizzato per rappresentare eventi ed entità di sicurezza. Organizza i dati nelle seguenti strutture logiche principali:
- Metadati: contesto dell'evento di log stesso, inclusi il timestamp dell'evento, l'ora di importazione, il nome del prodotto del fornitore e il tipo di evento.
- Entità: l'entità che ha avviato l'attività (ad esempio l'utente, l'host, l'indirizzo IP o il processo di origine).
- Destinazione: l'entità direttamente interessata dall'attività (ad esempio il file di destinazione, l'host di destinazione o l'account utente).
- Sorgente, intermediario e osservatore: partecipanti alla rete secondaria (come proxy di inoltro, firewall o hop di routing) coinvolti nella transazione.
- Rete: attributi del protocollo di rete e artefatti delle transazioni (inclusi protocolli applicativi, query DNS e dettagli delle richieste HTTP).
- Risultato di sicurezza: l'azione o il risultato di gravità segnalato dal dispositivo di sicurezza (ad esempio
ALLOWED,BLOCKEDoQUARANTINED). - Estensioni: campi personalizzati e coppie chiave-valore specifici del fornitore che non rientrano nello schema principale standard. Per informazioni dettagliate sulle definizioni di mappatura e sullo sviluppo del parser, vedi Configurare i parser personalizzati e Campi UDM importanti.
Diagramma delle classi UDM
Il seguente diagramma fornisce un progetto strutturale del modello UDM.

Architettura di ricerca
Google SecOps fornisce potenti meccanismi di ricerca personalizzati per diversi flussi di lavoro di indagine. Puoi eseguire query sulla telemetria normalizzata nell'archiviazione a caldo, eseguire la corrispondenza di pattern con i log non analizzati o cercare dati strutturati dei casi. Per indicazioni sull'ottimizzazione, consulta Best practice per la ricerca UDM.
La seguente tabella riassume le principali funzionalità di ricerca disponibili sulla piattaforma:
| Tipo di ricerca | Funzione architettonica |
|---|---|
| Ricerca UDM | Il motore di ricerca strutturato principale che esegue query sugli eventi UDM normalizzati e indicizzati nella finestra calda di 12 mesi. Consente il filtraggio, le aggregazioni e le correlazioni su più campi in origini log disparate. |
| Scansione log non elaborati | Esegue la scansione delle stringhe di testo originali e non analizzate dei log importati. Questa funzionalità supporta le ricerche di espressioni regolari (`regex`) e sottostringhe per artefatti e parametri personalizzati non mappati a una sintassi UDM specifica. |
| Ricerca in linguaggio naturale | Utilizza Gemini AI per tradurre le domande in linguaggio naturale direttamente nella sintassi di ricerca UDM formale, velocizzando i flussi di lavoro di creazione e indagine delle query. |
| Ricerca delle richieste | Un motore di ricerca specializzato all'interno del livello di risposta che esegue query su casi investigativi, avvisi, playbook e metadati delle entità annotati all'interno del database SOAR. |
Ciclo di rilevamento e risposta alle minacce
L'architettura di Google SecOps crea un ciclo di feedback continuo tra l'analisi del rilevamento e la risposta automatizzata. Le regole di rilevamento generano avvisi ad alta fedeltà che attivano i workflow di risposta, mentre i risultati dell'indagine forniscono feedback utilizzati per perfezionare e ottimizzare la logica di rilevamento futura.
Architettura del funnel di rilevamento
Il motore di rilevamento utilizza un approccio a funnel multifase per trasformare enormi volumi di telemetria di sicurezza non elaborata in avvisi ad alta fedeltà:
- Importazione e normalizzazione: i log non elaborati vengono importati e formattati continuamente in strutture di eventi UDM standard.
- Arricchimento: gli eventi vengono arricchiti dinamicamente con mappature degli alias, dati contestuali degli asset e threat intelligence globale da fonti come Google Threat Intelligence.
- Valutazione del rilevamento: il motore YARA-L 2.0 stateful valuta gli eventi arricchiti in base a regole comportamentali e di minaccia in finestre temporali estese. Per le linee guida per l'ottimizzazione delle regole, consulta le best practice di YARA-L.
- Prioritizzazione e raggruppamento: i rilevamenti corrispondenti vengono aggregati in avvisi, a cui vengono assegnati punteggi di rischio dinamici e raggruppati in casi unificati.
Combinando i dati contestuali degli asset con la threat intelligence, questa strategia a imbuto filtra le anomalie innocue (riducendo i falsi positivi) ed evidenzia le minacce reali (riducendo i falsi negativi), aiutando il tuo team di sicurezza a concentrarsi sugli incidenti attuabili.

Correzione automatica e ciclo di feedback
La pipeline di rilevamento e risposta combina la valutazione delle regole stateful con il triage e il contenimento automatizzati:
- Valutazione continua: flussi di telemetria UDM arricchiti tramite il motore di rilevamento stateful YARA-L 2.0.
- Creazione di casi e triage dell'AI: quando viene soddisfatta una condizione della regola, Google SecOps genera un avviso e apre un caso. Un agente di triage e indagine basato sull'AI esegue ricerche dinamiche e ricerche di threat intelligence per valutare i risultati.
- Esecuzione automatizzata dei playbook: se il triage dell'AI conferma un vero positivo, la piattaforma attiva playbook di risposta automatizzati (ad esempio l'isolamento di un endpoint o la sospensione di un account utente tramite agenti remoti). Se viene classificato come falso positivo, il caso viene chiuso automaticamente.
- Ottimizzazione continua: i risultati della correzione e i verdetti di triage degli analisti vengono riutilizzati per perfezionare le soglie di rilevamento e ridurre i falsi positivi futuri.

Livello di rilevamento delle minacce
Il motore YARA-L 2.0 valuta la telemetria UDM in entrata utilizzando una pipeline di streaming in più fasi per rilevare anomalie comportamentali e pattern di attacco multi-evento in finestre temporali estese. Puoi anche generare e perfezionare le regole YARA-L utilizzando Gemini.
Il ciclo di vita dell'elaborazione per ogni regola YARA-L segue cinque fasi di valutazione distinte:
- Importazione (
Ingest): gli eventi UDM arricchiti entrano nella pipeline di valutazione del rilevamento in tempo reale. - Filtro (
Filter): gli eventi in entrata vengono valutati in base ai criteri degli eventi della regola (sezioneevents). Gli eventi che non corrispondono vengono ignorati, mentre quelli corrispondenti vengono sottoposti alla valutazione stateful. - Raggruppamento delle corrispondenze (
Window): gli eventi corrispondenti vengono raggruppati in base alle chiavi di correlazione specificate in una finestra temporale definita (da secondi a 12 mesi). Il motore tiene traccia di più timer stateful simultanei (daTimerStartaTimerEnd) man mano che gli eventi si accumulano. - Valutazione delle condizioni (
Condition): quando la finestra di corrispondenza si chiude o viene attivata, il motore valuta i requisiti di soglia e le espressioni matematiche definiti nella sezioneconditiondella regola (ad esempio conteggi degli eventi, soglie distinte o unioni tra dati). - Attivazione (
Trigger): se la condizione restituisce il valoreTrue, il motore genera un rilevamento, attivando un avviso e aprendo o aggiornando una richiesta nel livello di risposta. SeFalse, lo stato viene cancellato senza attivare un avviso.
Macchina a stati di esecuzione della regola
Il seguente diagramma illustra il ciclo di vita dell'esecuzione di una regola.

Architettura di risposta ed esecuzione remota
Google SecOps SOAR rappresenta il pilastro della risposta della piattaforma. Funziona come motore di orchestrazione sopra il livello di analisi per importare gli avvisi, eseguire il triage dei casi ed eseguire flussi di lavoro di risposta automatizzati.
Orchestrazione, automazione e indagine
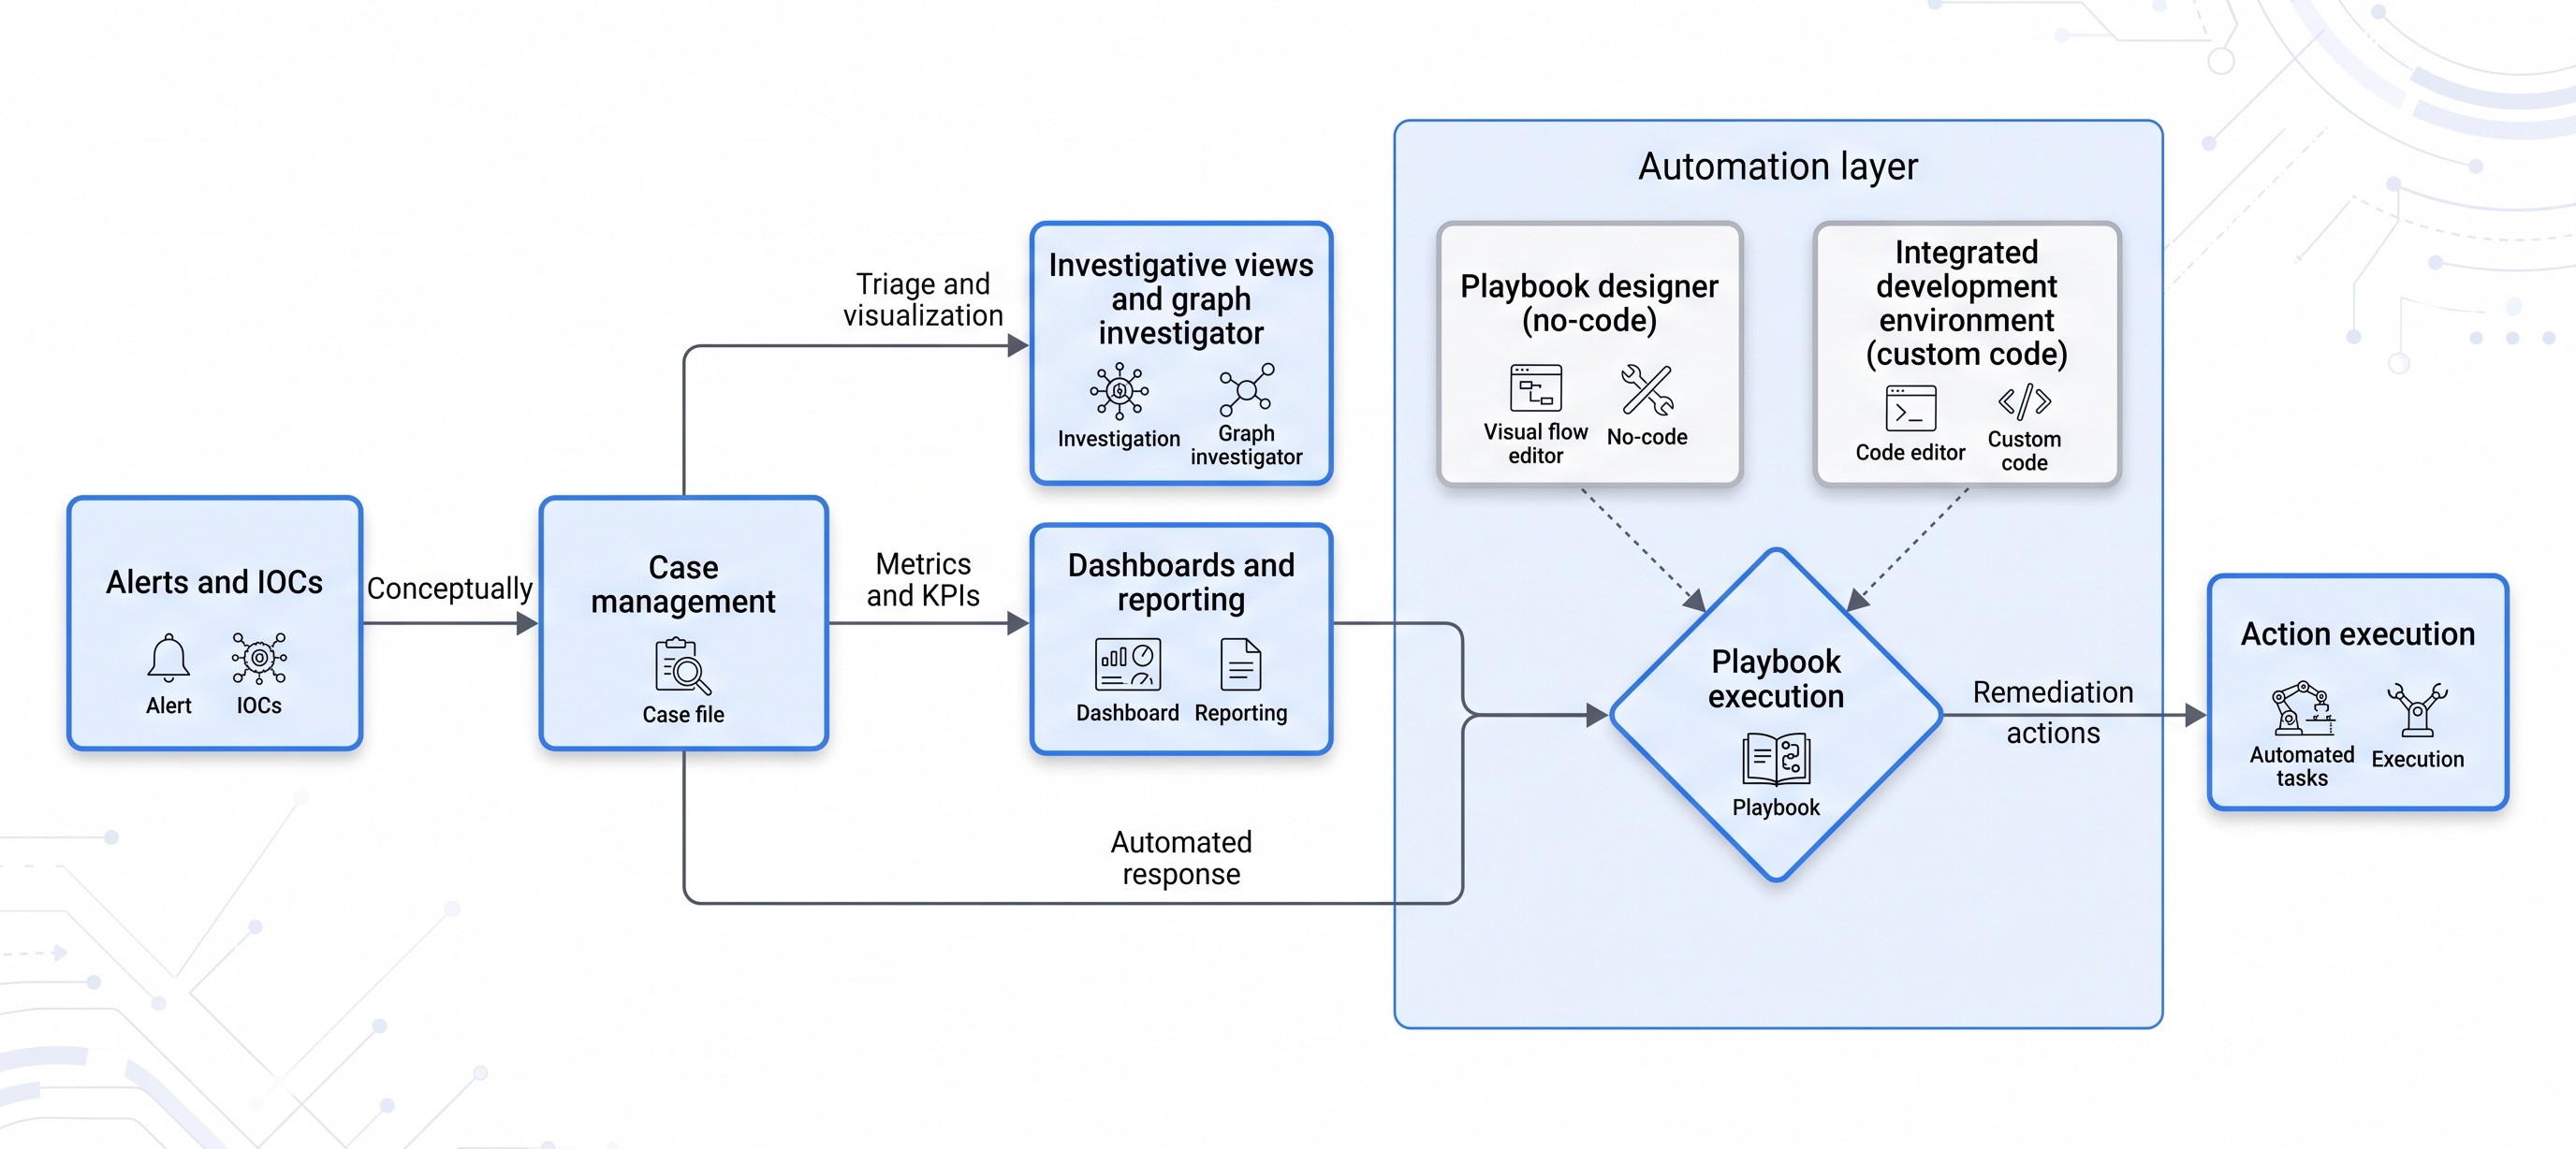
Il livello di risposta include strumenti specializzati progettati per semplificare i workflow del Security Operations Center (SOC) in indagini, gestione dei casi e automazione dei playbook:
- Gestione dei casi: raggruppa gli avvisi correlati in casi unificati, ordina e filtra le code degli incidenti, assegna attività e collabora alle indagini con il monitoraggio completo degli audit.
- Designer di playbook: crea playbook di risposta automatizzati utilizzando un canvas visivo no-code drag and drop con azioni di integrazione predefinite.
- Ambiente di sviluppo integrato (IDE): utilizza l'IDE integrato basato su codice per scrivere script Python personalizzati, modificare le integrazioni di azioni esistenti ed eseguire il debug di workflow di automazione complessi.
- Visualizzazioni investigative e strumento di indagine sui grafici: visualizza i percorsi di attacco e le relazioni tra le entità utilizzando le visualizzazioni investigative basate su grafici. I riepiloghi delle entità dedicati (come le visualizzazioni Asset, Indirizzo IP, Hash, Dominio e Utente) mostrano immediatamente gli eventi della sequenza temporale pertinenti.
- Dashboard e report: monitora le metriche operative del SOC, il carico di lavoro degli analisti e il tempo medio di risposta (MTTR) utilizzando dashboard predefinite o widget di reporting personalizzati.
Architettura dei componenti SOAR
Il seguente diagramma illustra il flusso degli avvisi in entrata nel motore di gestione delle richieste e l'attivazione di workflow di correzione automatizzati in playbook visivi e integrazioni IDE personalizzate.
Architettura dell'agente remoto
Per eseguire azioni di correzione all'interno di reti private (come data center on-premise o cloud privati virtuali), Google SecOps si basa su un'architettura di agenti remoti sicura e solo in uscita.
In base a questo modello, la piattaforma Google SecOps non avvia mai connessioni in entrata al tuo ambiente privato:
- Avvio dell'attività: quando un'azione del playbook richiede l'esecuzione locale, Google SecOps pubblica l'istruzione in una coda di publisher sicura ospitata in Google Cloud.
- Polling asincrono: l'agente remoto di cui è stato eseguito il deployment all'interno del tuo ambiente privato esegue il polling continuo della coda del publisher tramite una connessione in uscita criptata con TLS.
- Esecuzione locale: quando viene recuperata un'istruzione di attività, l'agente remoto esegue l'azione richiesta localmente rispetto a strumenti di sicurezza interni o endpoint di rete (ad esempio, disattivando un account o bloccando una porta firewall).
- Report sullo stato: una volta completata, l'agente remoto restituisce lo stato dell'azione e i log di esecuzione alla coda del publisher tramite TLS, dove vengono recuperati e visualizzati nella visualizzazione del caso SOAR.

Sicurezza, conformità e responsabilità condivisa
In quanto piattaforma cloud-native, Google SecOps opera in base a un modello di responsabilità condivisa: Google è responsabile della sicurezza della piattaforma, mentre tu sei responsabile della sicurezza nella piattaforma.
Modello di responsabilità condivisa
Google SecOps eredita la progettazione della sicurezza di base, le funzionalità di computing e l'architettura di archiviazione dell'infrastruttura Google Cloud . In base a questo modello:
- Gestione di Google:sicurezza fisica del data center, infrastruttura cloud sottostante, disponibilità della piattaforma e crittografia predefinita dei dati at-rest e in transito.
- Gestisci:governance dei dati, controlli dell'accesso e RBAC dei dati configurati tramite Identity and Access Management (IAM), regole di rilevamento personalizzate e impostazioni di conformità del tenant.
Tutti i requisiti di conformità, le regole di residenza dei dati e le policy di accesso vengono ereditati e applicati dalla gerarchia dell'organizzazione fino alle cartelle e ai progetti al tenant controllato dalla conformità.
Conformità e prontezza di livello enterprise
Per soddisfare i rigorosi requisiti di governance normativa e organizzativa, Google SecOps offre tenant controllati per la conformità. Questi tenant applicano standard di sicurezza rigorosi tramite Assured Workloads, supportando sia i framework di conformità legale sia i pacchetti di protezione dei dati tecnici.
Framework di conformità legale supportati:
- FedRAMP: livelli di impatto moderato e alto (
FEDRAMP_MODERATE,FEDRAMP_HIGH) - Livelli di impatto del Dipartimento della difesa: IL4 e IL5 (
IL4_AND_IL5) - Sanità e finanza:HIPAA e PCI DSS (
HIPAA,PCI_DSS)
Per eseguire il deployment di un tenant controllato per la conformità, collega la tua istanza Google SecOps a un progetto Google Cloud che si trova in una cartella Assured Workloads configurata per il pacchetto di controllo richiesto.

Residenza dei dati e trasparenza degli accessi
Google SecOps applica un rigoroso isolamento logico dei tenant e supporta Access Transparency per offrirti un controllo verificabile e visibilità di audit sull'accesso ai dati amministrativi.
Pacchetti di sicurezza e residenza dei dati supportati:
- Chiavi di crittografia gestite dal cliente (CMEK): controlla e gestisci le chiavi utilizzate per crittografare i dati a riposo (
CMEK_V1). - Residenza dei dati avanzata:applica i limiti regionali di residenza dei dati e i controlli dell'accesso amministrativo (
DRZ_ADVANCED). - Controlli di servizio VPC:stabilisci perimetri sicuri e personalizzati attorno alle tue risorse di sicurezza cloud utilizzando i Controlli di servizio VPC (
VPC-SC).
L'architettura di sicurezza della piattaforma si basa su un modello di ereditarietà a quattro livelli, in cui i controlli di sicurezza amministrativi si basano sulle fondamenta rafforzate dell'infrastruttura Google principale:

Lo stack di sicurezza a quattro livelli:
- Livello di controllo della sicurezza del cliente: i controlli amministrativi di primo livello, inclusi i controlli degli accessi basati su ruoli (RBAC) gestiti tramite Identity and Access Management (IAM), le chiavi di crittografia gestite dal cliente (CMEK) e le norme di residenza dei dati regionali.
- Livello di sicurezza della piattaforma: isolamento logico dei tenant, crittografia predefinita per i dati a riposo e in transito (TLS) e audit logging di Access Transparency.
- Livello dell'infrastruttura Google: infrastruttura di calcolo e archiviazione di base, inclusi la gestione dei cluster Borg, l'archiviazione distribuita Colossus e i database globali Spanner.
- Livello di sicurezza fisica: sicurezza di base supportata dai data center aziendali di Google, controlli biometrici multifattore e chip di sicurezza Titan personalizzati (
roots of trust).
Ad esempio, quando Access Transparency è abilitato, se un tecnico dell'assistenza o un ingegnere Google accede ai dati del tuo tenant per risolvere una ticket di assistenza, deve inviare una giustificazione dell'accesso crittografica valida. Questa richiesta di accesso viene registrata in modo sicuro e resa visibile nei log di controllo quasi in tempo reale.
Hai bisogno di ulteriore assistenza? Ricevi risposte dai membri della community e dai professionisti di Google SecOps.