


Mit der Feeds-Benutzeroberfläche arbeiten
In diesem Dokument wird beschrieben, wie Sie Feeds in der Feed Management-Benutzeroberfläche erstellen, Fehler beheben und verwalten. Außerdem finden Sie hier Anleitungen zum Ändern, Aktivieren und Löschen von Feeds.
Hinweis
Für jeden Datenfeed sind bestimmte Voraussetzungen erforderlich, bevor er in Google Security Operations eingerichtet werden kann. Die Anforderungen für Ihren Feed finden Sie unter Konfiguration nach Quelltyp. Suchen Sie dort nach Ihrer spezifischen Datenquelle.
Unterstützte Komprimierungsformate und Dateigrößen
Für die Aufnahme von Feeds werden die Komprimierungsformate .gz, .tar.gz, .tar und solr.gz unterstützt. In der folgenden Tabelle sind die verschiedenen Dateigrößen aufgeführt, die von der Transformation von Google SecOps-Feeds unterstützt werden:
| Vorgang | Eingabetyp | Empfohlene Größe | Erwartete Dauer | Max. Größe |
|---|---|---|---|---|
| Datenmodellierung | CSV | < 5 GB | < 7 Min. | 10 GB |
| Datenmodellierung | CSV | < 5 GB | ~30 Min. | 10 GB |
| Datenmodellierung | CSV | TBD | TBD | 2 GB |
| Datenmodellierung | XML / JSON | < 1 GB | < 10 Min. | 2 GB |
| Datenmodellierung | XLS / XLSX | < 50 MB | ~1 Min. | 50 MB |
| Dateien zusammenführen | Beliebig | < 1 GB | Variiert je nach Anzahl der Dateien | 100 GB |
| Dateien dekomprimieren | Nicht-ZIP | < 5 GB | Variiert je nach Anzahl der Dateien | 10 GB (unkomprimiert) |
| Dateien dekomprimieren | Postleitzahl | - | Variiert je nach Anzahl der Dateien | 4 GB (unkomprimiert) |
Grenzwerte und Trennzeichen für Protokollzeilen
Achten Sie beim Erfassen von textbasierten Logs (JSON, CSV oder Syslog) darauf, dass Ihre Daten die folgenden Erfassungslimits einhalten:
- Maximale Zeilengröße: Eine einzelne Protokollzeile darf nicht größer als 4 MB sein. Wenn eine einzelne Zeile dieses Limit überschreitet, schlägt der Feed mit dem Fehler
MaxLogLineSize4MBExceededfehl. - Unterstützte Trennzeichen: Sowohl Zeilenvorschub (
\n) als auch Zeilenumbruch + Zeilenvorschub (\r\n) werden unterstützt.
Auswirkungen der Änderung des verknüpften Cloud-Projekts auf Datenfeeds
Wenn Sie das Google Cloud Projekt aktualisieren, das mit Ihrer Google SecOps-Instanz verknüpft ist, werden alle Feeds, die Daten über die folgenden Connectors aufnehmen, beendet und müssen manuell neu erstellt werden:
- AMAZON_S3_V2
- AMAZON_SQS_V2
- GOOGLE_CLOUD_STORAGE_V2
- AZURE_BLOBSTORE_V2
- GOOGLE_CLOUD_STORAGE_EVENT_DRIVEN
Bei allen anderen Feeds, die diese Connectors nicht verwenden, wird die Aufnahme ohne Unterbrechung fortgesetzt. Kunden müssen nichts weiter unternehmen.
Erwartungen während der Migration
Bei betroffenen Feeds sind folgende Änderungen zu beobachten:
- Feedstatus: Für Feeds, die vor der Migration erstellt wurden, werden sofort keine Live-Daten mehr abgerufen. Sie sind dann schreibgeschützt.
- Vorhandene Daten: Alle Daten, die vor der Migration bereits in Google SecOps übertragen wurden, werden automatisch aufgenommen. Es gehen keine Daten verloren.
- Fehlermeldungen: Wenn Sie versuchen, einen älteren Feed zu bearbeiten oder zu löschen, wird die folgende Meldung angezeigt:
This feed is read-only because this SecOps has now moved to a new Google Cloud Project (BYOP). To continue ingesting data from this source, please create a new feed.
Erforderliche Maßnahmen für Kunden
Damit Daten weiterhin aufgenommen werden, müssen Sie Ihre Feeds in der neuen Umgebung manuell neu erstellen. So minimieren Sie Unterbrechungen:
- Feeds neu erstellen: Sie müssen neue Feeds erstellen, um die Feeds zu ersetzen, die vor der Migration vorhanden waren.
- Maximales Dateialter konfigurieren: Legen Sie beim Einrichten Ihrer neuen Feeds das maximale Dateialter auf etwa 2 Stunden vor dem Start des BYOP-Updates fest. Dieser Puffer sorgt für einen reibungslosen Übergang.
Doppelte Daten verwalten: Je nach ausgewähltem Maximales Dateialter kann es zu einer Übertragung doppelter Daten kommen. Technische Details dazu, wie Google SecOps diese redundanten Logs filtert, finden Sie unter Deduplizierung verhindern.
Vorhandene Feeds aufzeichnen und löschen (vor der Migration): Bevor Sie mit der BYOP-Migration beginnen, zeichnen Sie die Konfigurationseinstellungen für alle vorhandenen Feeds auf, die die betroffenen Connectors (z. B. Amazon S3 V2) verwenden, und löschen Sie dann die Feeds. Wenn Sie vor der Migration erstellte Feeds nicht löschen, sind sie nicht mehr verwaltbar und verbleiben als verwaiste Einstellungen in der Google SecOps-Weboberfläche.
Möglichkeiten zum Einrichten von Feeds
Google SecOps-Kunden haben zwei Möglichkeiten, einen Feed in der Plattform einzurichten. Wählen Sie die Methode aus, die am besten für Ihre Umgebung geeignet ist:
- SIEM-Einstellungen > Feeds (Standard)
- Content Hub > Content-Pakete (Premium)
Zulassen von IP-Adressen einrichten
Wenn Google SecOps Daten aus S3, SQS, Azure und Drittanbieter-APIs abruft, stellt die Google-Infrastruktur eine ausgehende Verbindung zum Bucket des Kunden oder zur Drittanbieter-API her.
Wenn Sie eingehende Verbindungen für Ihre Speicher-Buckets oder Firewalls auf die Zulassungsliste setzen möchten, müssen Sie die Zulassungsliste entsprechend dem Feedtyp konfigurieren, wie in der folgenden Liste beschrieben:
- V2-Feeds (S3_V2, SQS_V2, Azure_Blobstore_V2): Bei diesen Feeds wird ausschließlich der Google Cloud Storage Transfer Service (STS) verwendet, um Daten aus dem Kundenspeicher abzurufen. Dazu müssen die STS-IP-Bereiche auf die Zulassungsliste gesetzt werden: ipranges.json.
- Drittanbieter-APIs: Erfordern goog.json.
- Legacy-Feeds (S3, Azure_Blobstore): Erfordern dedizierte IP-Bereiche. Weitere Informationen erhalten Sie vom Google SecOps-Support.
- Azure Event Hub: Erfordert regionsspezifische IP-Bereiche. Weitere Informationen finden Sie unter Netzwerksicherheit konfigurieren (optional) im Artikel Azure Event Hub-Feed erstellen.
Da sich die IP-Bereiche von Google-Diensten dynamisch ändern, empfiehlt Google, Ihre Firewall so zu konfigurieren, dass die Feeds regelmäßig abgerufen und geparst werden:
- V2-Feeds (S3_V2, SQS_V2, Azure_Blobstore_V2): Die Datenübertragung wird ausschließlich von Storage Transfer Service-Workern ausgeführt. Sie müssen ipranges.json nur regelmäßig abrufen und parsen.
- Legacy-Feeds (S3, SQS, Azure_Blobstore, Azure Event Hub) und Drittanbieter-APIs: Diese Verbindungen stammen aus der Google-Infrastruktur. Sie müssen goog.json und cloud.json nur regelmäßig abrufen und parsen.
Feeds konfigurieren
In diesem Abschnitt wird beschrieben, wie Sie Ihre Feeds allgemein konfigurieren. Wir beginnen mit dem standardmäßigen Ablauf. Die auf der Seite Feeds aufgeführten Datenfeeds umfassen alle Feeds, die Google für Ihr Konto konfiguriert hat, einschließlich der von Ihnen konfigurierten Feeds.
Feed hinzufügen
So fügen Sie Ihrem Google SecOps-Konto einen Feed hinzu:
Wählen Sie im Google SecOps-Menü SIEM-Einstellungen > Feeds aus.
Klicken Sie auf Neuen Feed hinzufügen.
Klicken Sie auf der nächsten Seite auf Einen einzelnen Feed konfigurieren. Hinweis: Dieser Schritt ist für Kunden, die die eigenständige Google SecOps SIEM-Plattform verwenden, nicht relevant.
Geben Sie einen Feednamen ein.
Wählen Sie in der Liste Quelltyp den Quelltyp für den Import von Daten in Google SecOps aus. Folgende Feedquellentypen stehen zur Auswahl:
- Amazon Data Firehose
- Amazon S3 (eingestellt)
- Amazon S3 (V2)
- Amazon SQS (eingestellt)
- Amazon SQS (V2)
- Azure Blob Storage (eingestellt)
- Azure Blob Storage (V2)
- Benutzerdefinierte API
- Cloud Pub/Sub
- Cloud Storage (eingestellt)
- Cloud Storage (V2)
- Cloud Storage-ereignisgesteuert
- Drittanbieter-API
- Webhook
Wichtig:
- Wenn Sie Feeds für Amazon S3 (eingestellt), Amazon SQS (eingestellt), Azure Blob Storage (eingestellt) und Google Cloud Cloud Storage (eingestellt) verwenden, muss der Verzeichnispfad gültig sein.
- Wenn Sie Amazon SQS (eingestellt) oder Amazon SQS (V2) verwenden, müssen Sie Google SecOps explizit die Berechtigung zum Löschen von Nachrichten aus der Amazon SQS-Warteschlange erteilen.
- Wenn Sie Amazon SQS-Feeds (eingestellt) verwenden, achten Sie darauf, dass nur ein Feed Nachrichten aus der Warteschlange abruft. Nachrichten, die von einer anderen Anwendung oder einem anderen Feed gelesen wurden, werden nicht in den aktuellen Feed aufgenommen.
- Die Verwendung von Amazon SQS (eingestellt) als Feedquelltyp wird nur für Logs in Amazon S3-Buckets unterstützt.
Wählen Sie in der Liste Logtyp den Logtyp aus, der den Logs entspricht, die Sie aufnehmen möchten. Die verfügbaren Protokolle variieren je nach dem zuvor ausgewählten Quelltyp.
Wenn Sie Cloud Storage als Quelltyp auswählen, verwenden Sie die Option Dienstkonto abrufen, um ein eindeutiges Dienstkonto zu erhalten. Beispiel für die Einrichtung eines Google Cloud Storage-Feeds
Klicken Sie auf Weiter.
Geben Sie auf dem Tab Eingabeparameter die erforderlichen Parameter an. Die hier angezeigten Optionen variieren je nach Quelle und Protokolltyp, die auf dem Tab Eigenschaften festlegen ausgewählt sind. Bewegen Sie den Mauszeiger auf das Fragezeichensymbol neben den einzelnen Feldern, um weitere Informationen dazu zu erhalten, was Sie angeben müssen.
Optional: Sie können auf dem Tab Eigenschaften festlegen einen Namespace angeben. Weitere Informationen zu Namespaces finden Sie unter Mit Asset-Namespaces arbeiten.
Klicken Sie auf Weiter.
Prüfen Sie die neue Feedkonfiguration auf dem Tab Abschließen.
Klicken Sie auf Senden. Google SecOps führt eine Validierungsprüfung des neuen Feeds durch. Wenn der Feed die Prüfung besteht, wird ein Name für den Feed generiert, er wird an Google SecOps gesendet und Google SecOps versucht, Daten abzurufen.
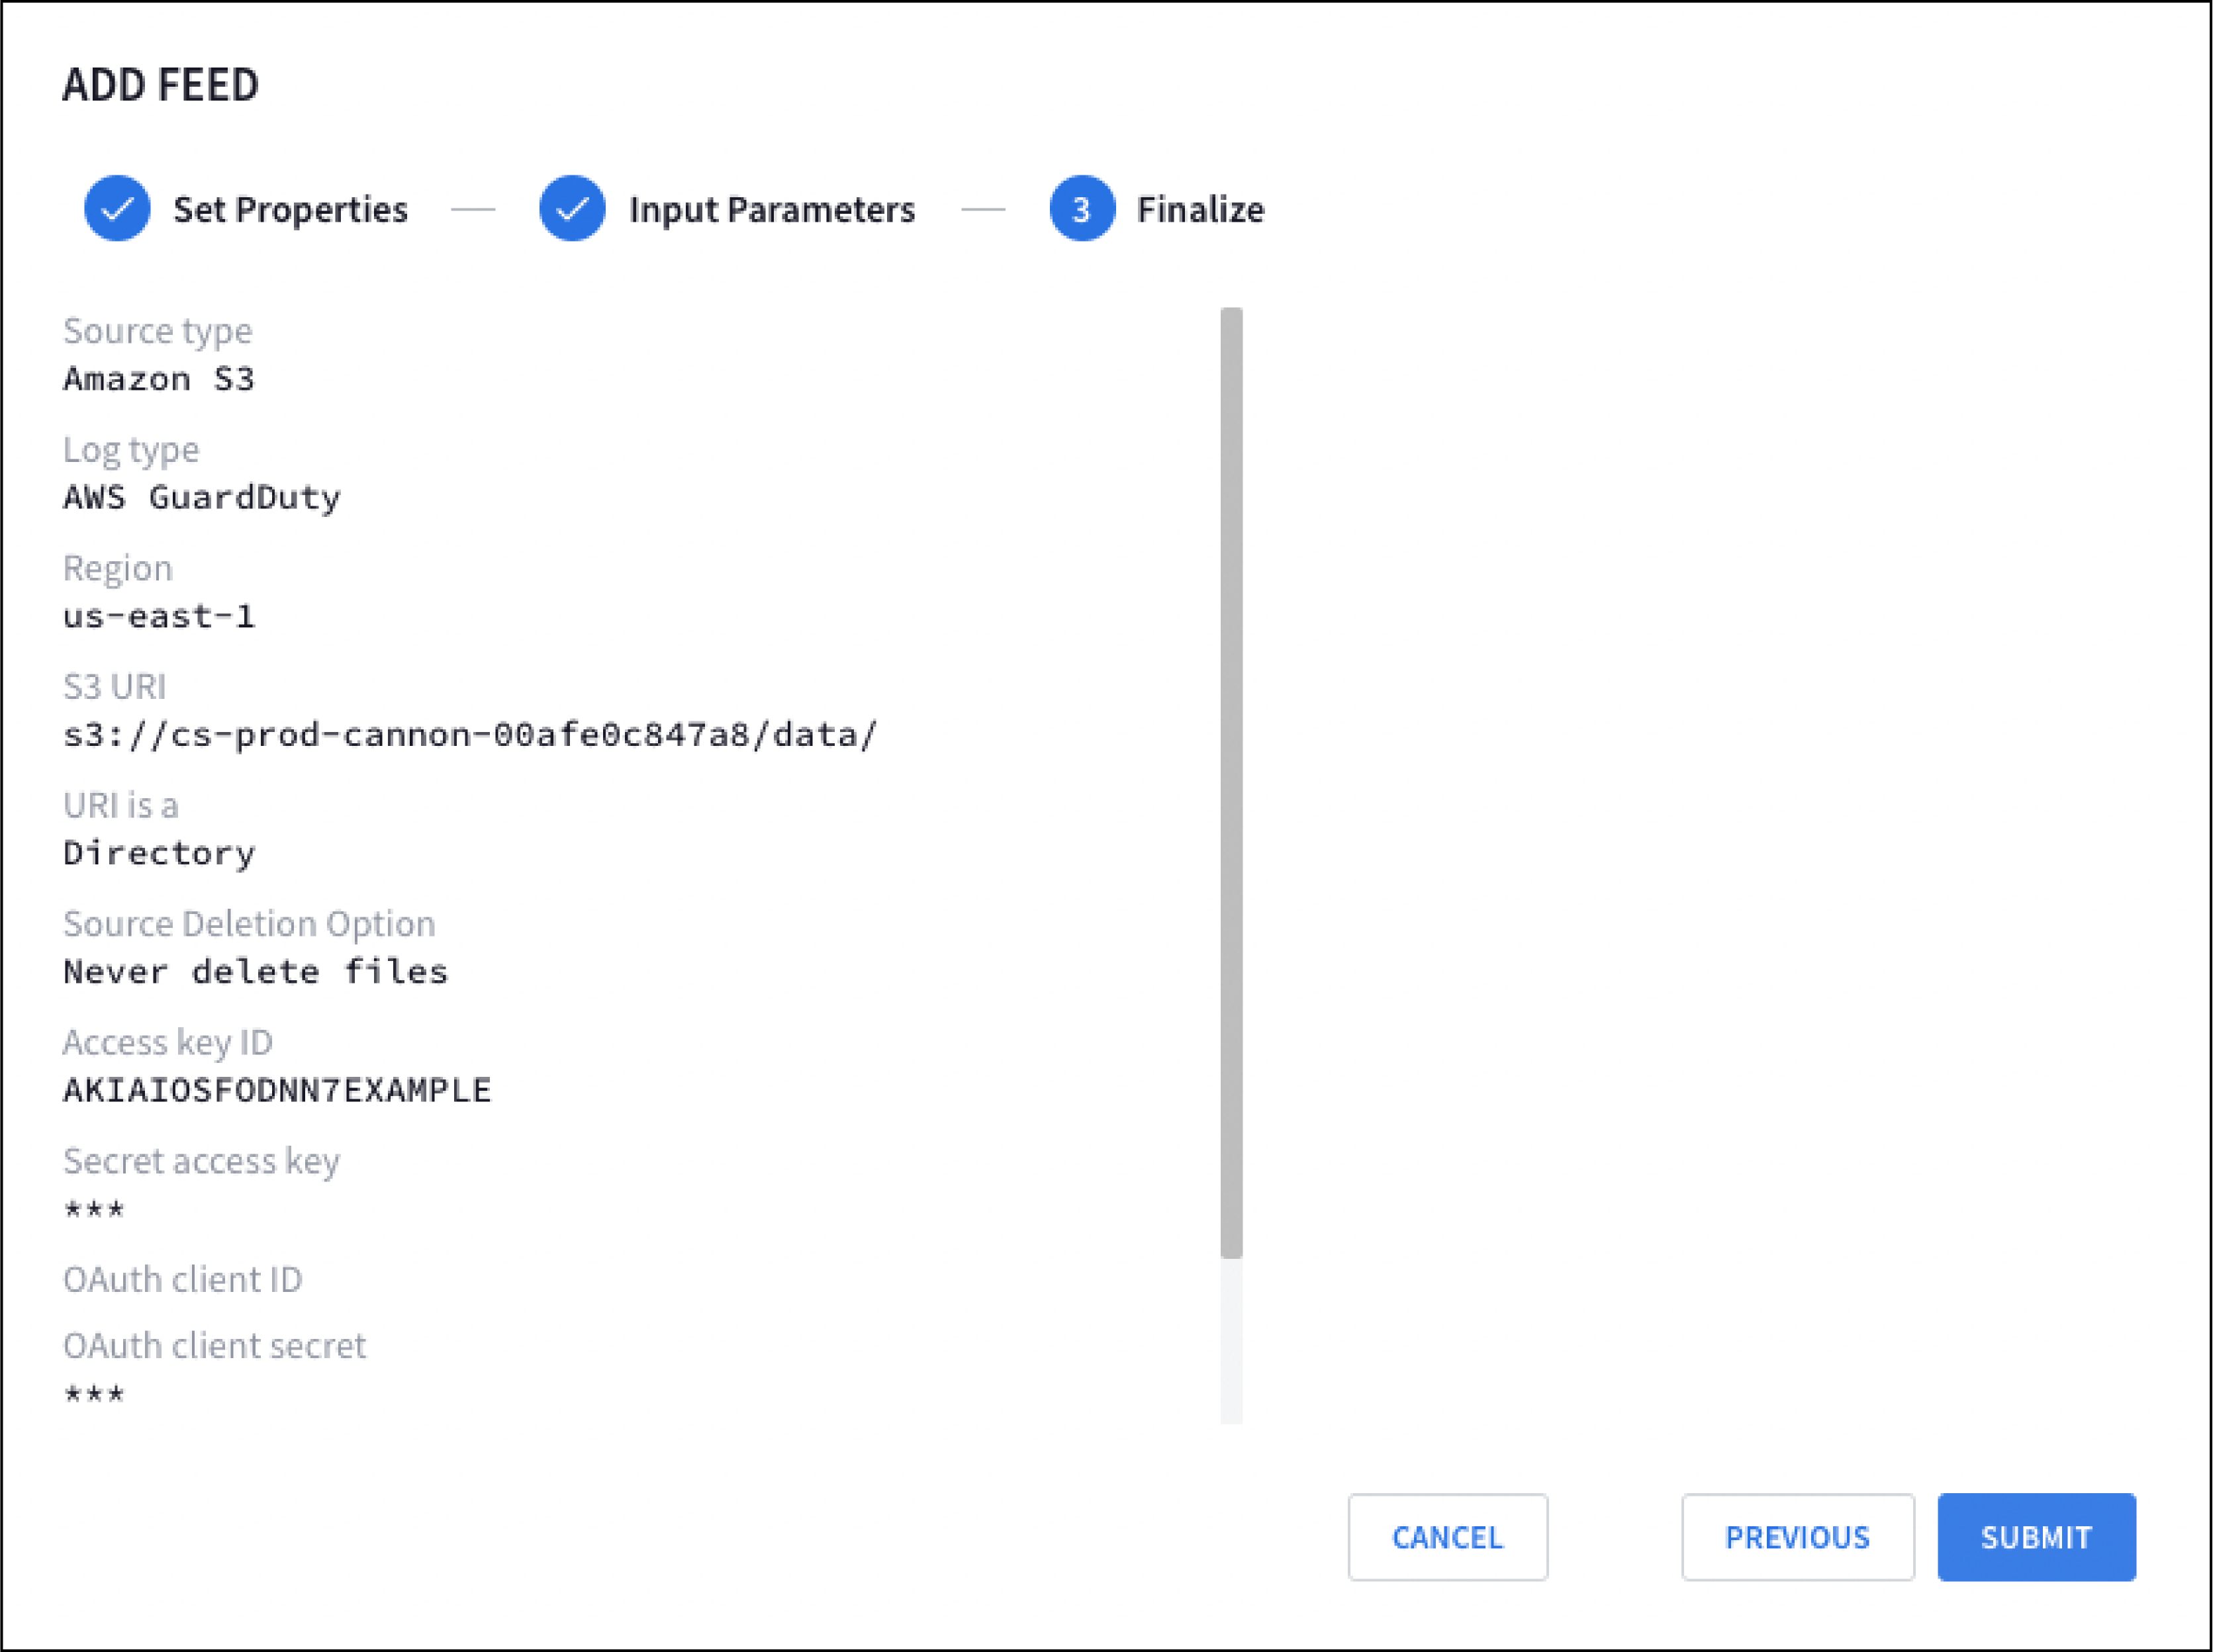
Mehrere Feeds für eine Produktfamilie konfigurieren (nur Google SecOps-Kunden)
Sie können mehrere Feeds pro Produktfamilie konfigurieren, basierend auf dem Logtyp.
- Baseline-Protokolltypen: Mit Empfohlen gekennzeichnet. Diese Logtypen werden für die Kernfunktionen der Plattform empfohlen.
- Zusätzliche Logtypen: Als optional gekennzeichnet. Diese Protokolltypen bieten zusätzlichen Kontext.
Um die Einrichtung zu vereinfachen, bietet die Plattform für jede Konfiguration spezifische Einrichtungsanleitungen und vordefinierte Parameter. Für CrowdStrike Falcon können Sie beispielsweise mehrere eindeutige Feeds für die empfohlenen und optionalen Logtypen erstellen, um eine umfassende Datenabdeckung zu gewährleisten.
Feed für CrowdStrike EDR konfigurieren
So konfigurieren Sie einen Logfeed für CrowdStrike EDR:
- Klicken Sie unter Einstellungen > Feeds auf Neuen Feed hinzufügen.
- Klicken Sie auf das Produkt CrowdStrike Falcon:
- Wählen Sie den Logtyp CrowdStrike EDR aus.
- Alternativ können Sie unter Content Hub > Content-Pakete auf das Produkt CrowdStrike Falcon klicken:
- Klicken Sie auf Jetzt starten.
- Wählen Sie den Protokolltyp CrowdStrike EDR aus.
Geben Sie Werte für die folgenden Felder an:
Feld Beschreibung Source TypeAmazon SQS RegionDie AWS S3-Region, die dem URI zugeordnet ist. Queue NameDer Name der SQS-Warteschlange, aus der gelesen werden soll. Account NumberDie SQS-Kontonummer. Source Deletion OptionGibt an, ob Dateien und Verzeichnisse nach der Übertragung gelöscht werden sollen. Queue Access Key IDEin alphanumerischer Zugriffsschlüssel mit 20 Zeichen für das Konto, z. B. AKIAOSFOODNN7EXAMPLE.Queue Secret Access KeyEin 40-stelliger alphanumerischer Secret-Zugriffsschlüssel für das Konto, z. B. wJalrXUtnFEMI/K7MDENG/bPxRfiCYEXAMPLEKEY.Optional: Konfigurieren Sie die folgenden Parameter:
- Feedname: Ein eindeutiger Name für den Feed, der automatisch ausgefüllt wird.
- Asset-Namespace: Der mit dem Feed verknüpfte Namespace.
- Aufnahmelabels: Labels, die auf die Ereignisse aus diesem Feed angewendet werden.
Klicken Sie auf Feed erstellen.
Sie können diesen Vorgang wiederholen, um zusätzliche Feeds für denselben Logtyp zu erstellen. Sie können auch Feeds für andere verfügbare Logtypen direkt auf dieser Seite konfigurieren. Rufen Sie nach Abschluss die Seite Feed Management auf, um eine detaillierte Zusammenfassung aller konfigurierten Protokolltypen zu sehen.
Quelldateien löschen
Mit der Option zum Löschen der Quelle können Sie Feedquellenobjekte (Dateien und Ordner) nach einer erfolgreichen Übertragung aus dem Speicher löschen. Diese Option ist nur für ausgewählte Feedquelltypen verfügbar, darunter Cloud Storage. Diese Feedquellentypen enthalten das Feld SOURCE DELETION OPTION (Option zum Löschen der Quelle) in den Workflows Add new (Neu hinzufügen) und Edit feed (Feed bearbeiten).
Optionen zum Löschen von Quellen
Für unterstützte Feedquellentypen, einschließlich Cloud Storage, bietet das Feld SOURCE DELETION OPTION (Option zum Löschen der Quelle) die folgenden Optionen:
- Dateien nie löschen
- Übertragene Dateien und leere Verzeichnisse löschen
- Übertragene Dateien löschen
Microsoft Azure Blob Storage (AZURE_BLOBSTORE) unterstützt das Löschen von Quelldateien nicht. Wählen Sie für das Feld SOURCE DELETION OPTION (Option zum Löschen der Quelle) nur die Option Never delete files (Dateien nie löschen) aus.
Für die folgenden Feedquellen (
"feedSourceType"):GOOGLE_CLOUD_STORAGE_V2,GOOGLE_CLOUD_STORAGE_EVENT_DRIVEN,AMAZON_S3_V2,AMAZON_SQS_V2undAZURE_BLOBSTORE_V2bietet das Feld OPTION ZUM LÖSCHEN DER QUELLE zwei Optionen:- NIE: Es werden nie Dateien nach Übertragungen gelöscht.
- ON_SUCCESS: Löscht alle Dateien und leeren Verzeichnisse nach der Übertragung.
Quellspezifische Einrichtung und Berechtigungen
Für die Kommunikation mit Google SecOps sind für die verschiedenen Quelltypen bestimmte Authentifizierungs- und Netzwerkkonfigurationen erforderlich. In diesem Abschnitt wird beschrieben, wie Sie Berechtigungen konfigurieren und Dienstkonten einrichten. Die beschriebene Einrichtung konzentriert sich auf die Aufnahme in Cloud Storage (Pull-basiert), die Aufnahme in mehreren Clouds (cloudübergreifender Pull) und die Push-basierte Aufnahme (API oder Echtzeit).
Beispiel für die Einrichtung eines Google Cloud Storage-Feeds
- Wählen Sie im Google SecOps-Menü Einstellungen und dann Feeds aus.
- Klicken Sie auf Neuen Feed hinzufügen.
- Klicken Sie auf der nächsten Seite auf Einen einzelnen Feed konfigurieren. Dieser Schritt ist nicht erforderlich, wenn Sie die eigenständige Google SecOps SIEM-Plattform verwenden.
- Wählen Sie Cloud Storage v2 als Quelltyp aus.
- Wählen Sie den Protokolltyp aus. Wenn Sie beispielsweise einen Feed für Google Kubernetes Engine-Audit-Logs erstellen möchten, wählen Sie Google Kubernetes Engine-Audit-Logs als Logtyp aus.
- Klicken Sie auf Dienstkonto abrufen. Google SecOps stellt ein eindeutiges Dienstkonto bereit, das von Google SecOps zum Erfassen von Daten verwendet wird. Alternativ können Sie dieses Dienstkonto programmatisch über die API abrufen. Siehe Dienstkonto abrufen.
- Optional: Dienstkonto konfigurieren Weitere Informationen finden Sie unter Zugriff auf das Google SecOps-Dienstkonto gewähren.
- Klicken Sie auf Weiter.
Geben Sie basierend auf der von Ihnen erstellten Cloud Storage-Konfiguration Werte für die folgenden Felder an:
Storage-Bucket-URI
Option zum Löschen von Quellen
Weitere Informationen zum Einrichten von Cloud Storage-Buckets finden Sie unter Buckets erstellen.
Klicken Sie auf Weiter und dann auf Senden.
Zugriff auf das Google SecOps-Dienstkonto gewähren
- Wechseln Sie in der Google Cloud Console unter „Cloud Storage“ zur Seite Buckets.
Gewähren Sie dem Dienstkonto Zugriff auf die relevanten Cloud Storage-Objekte.
So gewähren Sie die Leseberechtigung für eine bestimmte Datei:
- Wählen Sie die Datei aus und klicken Sie auf Zugriff bearbeiten.
- Klicken Sie auf Hauptkonto hinzufügen.
- Geben Sie im Feld Neue Hauptkonten den Namen des Google SecOps-Dienstkontos ein.
- Weisen Sie dem Google SecOps-Dienstkonto eine Rolle mit der Leseberechtigung zu. Zum Beispiel Storage-Objekt-Betrachter (
roles/storage.objectViewer). Dies ist nur möglich, wenn Sie den einheitlichen Zugriff auf Bucket-Ebene nicht aktiviert haben. - Klicken Sie auf Speichern.
Wenn Sie mehreren Dateien die Leseberechtigung erteilen möchten, gewähren Sie den Zugriff auf Bucket-Ebene so:
Für
"feedSourceType": "GOOGLE_CLOUD_STORAGE":- Fügen Sie das Google SecOps-Dienstkonto als Hauptkonto zu Ihrem Speicher-Bucket hinzu und weisen Sie ihm die IAM-Rolle Storage-Objekt-Betrachter (
roles/storage.objectViewer) zu. - Wenn Sie den Feed so konfigurieren, dass Quelldateien gelöscht werden, müssen Sie das Google SecOps-Dienstkonto als Hauptkonto für Ihren Bucket hinzufügen und ihm die IAM-Rolle Storage-Objekt-Administrator (
roles/storage.objectAdmin) zuweisen.
- Fügen Sie das Google SecOps-Dienstkonto als Hauptkonto zu Ihrem Speicher-Bucket hinzu und weisen Sie ihm die IAM-Rolle Storage-Objekt-Betrachter (
Gewähren Sie für
"feedSourceType": "GOOGLE_CLOUD_STORAGE_V2"die folgenden Rollen:So weisen Sie diese Rolle zu:
- Storage-Objekt-Betrachter (
roles/storage.objectViewer), wenn die Übertragung in einen anderen Cloud Storage-Bucket erfolgt.
- Storage-Objekt-Betrachter (
Weisen Sie eine der folgenden Rollen zu, je nachdem, was Sie für die Option zum Löschen der Quelle auswählen. Wenn Sie Bei Erfolg auswählen, weisen Sie die Rolle Autor alter Storage-Buckets zu. Wenn Sie Nie auswählen, weisen Sie die Rolle Storage Legacy Bucket Reader zu:
- Autor von Legacy-Storage-Buckets (
roles/storage.legacyBucketWriter), wenn die Berechtigung zum Löschen von Objekten erforderlich ist. - Leser von Legacy-Storage-Buckets (
roles/storage.legacyBucketReader), wenn die Berechtigung zum Löschen von Objekten nicht erforderlich ist.
- Autor von Legacy-Storage-Buckets (
Für
"feedSourceType": "GOOGLE_CLOUD_STORAGE_EVENT_DRIVEN":Weisen Sie eine der folgenden Rollen zu:
- Storage-Objekt-Betrachter (
roles/storage.objectViewer), wenn die Übertragung in einen anderen Cloud Storage-Bucket erfolgt. - Storage-Objekt-Ersteller (
roles/storage.objectCreator), wenn die Übertragung in ein Dateisystem erfolgt.
- Storage-Objekt-Betrachter (
Weisen Sie eine der folgenden Rollen zu:
- Autor von Legacy-Storage-Buckets (
roles/storage.legacyBucketWriter), wenn die Berechtigung zum Löschen von Objekten erforderlich ist. - Leser von Legacy-Storage-Buckets (
roles/storage.legacyBucketReader), wenn die Berechtigung zum Löschen von Objekten nicht erforderlich ist.
- Autor von Legacy-Storage-Buckets (
STS-Zugriff für Amazon S3 und Azure Storage aktivieren
Der STS wird von den folgenden Google Cloud Storage-Feeds verwendet, um Daten aus Amazon S3- und Azure Storage-Blobstores in Google SecOps zu übertragen:
- Amazon S3 (V2)
- Amazon SQS (V2)
- Azure Blob Storage (V2)
STS sendet Datenübertragungsanfragen an die Amazon S3- und Azure-Speicherdienste über eine Reihe definierter STS-IP-Adressbereiche. Diese STS-IP-Adressbereiche werden in der folgenden JSON-Datei veröffentlicht: IP-Bereiche.
Wenn Sie diese STS-Feedquelltypen verwenden möchten, müssen Sie möglicherweise die IP-Zugriffsbeschränkungen anpassen, damit STS auf Ihre Amazon S3- und Azure-Speicherdienste zugreifen kann:
Rufen Sie die neuesten IP-Bereiche aus der JSON-Datei ab.
Wir empfehlen, Daten aus dieser JSON-Datei mindestens wöchentlich zu lesen, um Ihre Sicherheitskonfiguration auf dem neuesten Stand zu halten. Wenn der Datei ein neuer Bereich hinzugefügt wird, wartet das System mindestens sieben Tage, bevor es diesen Bereich für Anfragen von STS verwendet.
Ein Beispiel für ein Python-Skript, mit dem IP-Bereiche aus einer JSON-Datei abgerufen werden, finden Sie unter IP-Adressen für Standarddomains.
Vergleichen Sie den aktuellen IP-Bereich
creationTimemit dem IP-BereichcreationTimeaus der vorherigen JSON-Datei. Wenn sie sich unterscheiden, aktualisieren Sie die IP-Zugriffsbeschränkungen in Amazon S3 und Azure Storage-Blobspeichern.Für Amazon S3
So aktualisieren Sie die IP-Zugriffsbeschränkungen in Ihrem Amazon S3-Blobstore:
Wenn in Ihrem AWS-Projekt IP-Einschränkungen für den Zugriff auf Speicher verwendet werden, müssen Sie die von STS-Workern verwendeten IP-Bereiche der Liste der zulässigen IP-Adressen hinzufügen.
Wenn Sie diese Bereiche als zulässige IPs hinzufügen möchten, verwenden Sie das Feld
Conditionin einerbucket policy, wie in der AWS S3-Dokumentation unter Zugriff basierend auf bestimmten IP-Adressen verwalten beschrieben.Für Azure Storage
So aktualisieren Sie die IP-Zugriffsbeschränkungen in Ihrem Azure Storage-Blobstore:
Wenn Sie den Zugriff auf Ihre Azure-Ressourcen über eine Azure Storage-Firewall beschränken, müssen Sie die von STS-Workern verwendeten IP-Bereiche der Liste der zulässigen IP-Adressen hinzufügen.
Wenn Sie diese Bereiche als zulässige IPs hinzufügen möchten, folgen Sie dieser Anleitung: Azure Storage-Firewalls und virtuelle Netzwerke konfigurieren.
Pub/Sub-Push-Feed einrichten
So richten Sie einen Pub/Sub-Push-Feed ein:
- Pub/Sub-Push-Feed erstellen
- Geben Sie die Endpunkt-URL in einem Pub/Sub-Abo an.
Pub/Sub-Push-Feed erstellen
- Wählen Sie im Google SecOps-Menü Einstellungen und dann Feeds aus.
- Klicken Sie auf Neu hinzufügen.
- Geben Sie im Feld Feedname einen Namen für den Feed ein.
- Wählen Sie in der Liste Quelltyp die Option Google Cloud Pub/Sub Push aus.
- Wählen Sie den Protokolltyp aus. Wenn Sie beispielsweise einen Feed für das Open Cybersecurity Schema Framework erstellen möchten, wählen Sie Open Cybersecurity Schema Framework (OCSF) als Log-Typ aus.
- Klicken Sie auf Weiter.
- Optional: Geben Sie Werte für die folgenden Eingabeparameter an:
- Trennzeichen für Aufteilung: Das Trennzeichen, das zum Trennen von Logzeilen verwendet wird. Sie können nur
\nverwenden. - Asset-Namespace: der Asset-Namespace.
- Aufnahmelabels: Das Label, das auf die Ereignisse aus diesem Feed angewendet werden soll.
- Trennzeichen für Aufteilung: Das Trennzeichen, das zum Trennen von Logzeilen verwendet wird. Sie können nur
- Klicken Sie auf Weiter.
- Prüfen Sie die neue Feedkonfiguration auf dem Bildschirm Abschließen und klicken Sie dann auf Senden.
- Kopieren Sie auf dem Tab Details die Feed-Endpunkt-URL aus dem Feld Endpunktinformationen. Sie benötigen diese Endpunkt-URL, um ein Push-Abo in Pub/Sub zu erstellen.
- Optional: Klicken Sie auf den Ein/Aus-Button Feed aktiviert, um den Feed zu deaktivieren. Der Feed ist standardmäßig aktiviert.
- Klicken Sie auf Fertig.
Endpunkt-URL angeben
Nachdem Sie einen Pub/Sub-Push-Feed erstellt haben, geben Sie die Endpunkt-URL so an:
- Erstellen Sie in Pub/Sub ein Push-Abo. Weitere Informationen zum Erstellen eines Push-Abos finden Sie unter Push-Abos erstellen.
- Geben Sie die Endpunkt-URL an, die im Google Cloud Pub/Sub-Push-Feed verfügbar ist.
- Wählen Sie Authentifizierung aktivieren und ein Dienstkonto aus.
- Deaktivieren Sie die Optionen Entpacken der Push-Nutzlast und Entpacken der Push-Nutzlast, Nachrichtenmetadaten schreiben.
Amazon Data Firehose-Feed einrichten
So richten Sie einen Amazon Data Firehose-Feed ein:
- Erstellen Sie einen Amazon Data Firehose-Feed und kopieren Sie die Endpunkt-URL und den geheimen Schlüssel.
- Erstellen Sie einen API-Schlüssel, um sich bei Google SecOps zu authentifizieren. Sie können auch Ihren vorhandenen API-Schlüssel zur Authentifizierung bei Google SecOps wiederverwenden.
- Geben Sie die Endpunkt-URL in Amazon Data Firehose an.
Amazon Data Firehose-Feed erstellen
- Wählen Sie im Google SecOps-Menü Einstellungen und dann Feeds aus.
- Klicken Sie auf Neu hinzufügen.
- Geben Sie im Feld Feedname einen Namen für den Feed ein.
- Wählen Sie in der Liste Quelltyp die Option Amazon Data Firehose aus.
- Wählen Sie den Protokolltyp aus. Wenn Sie beispielsweise einen Feed für das Open Cybersecurity Schema Framework erstellen möchten, wählen Sie Open Cybersecurity Schema Framework (OCSF) als Logtyp aus.
- Klicken Sie auf Weiter.
- Optional: Geben Sie Werte für die folgenden Eingabeparameter an:
- Trennzeichen für Aufteilung: Das Trennzeichen, das zum Trennen von Logzeilen verwendet wird. Sie können nur
\nverwenden. - Asset-Namespace: der Asset-Namespace.
- Aufnahmelabels: Das Label, das auf die Ereignisse aus diesem Feed angewendet werden soll.
- Trennzeichen für Aufteilung: Das Trennzeichen, das zum Trennen von Logzeilen verwendet wird. Sie können nur
- Klicken Sie auf Weiter.
- Prüfen Sie die neue Feedkonfiguration auf dem Bildschirm Abschließen und klicken Sie dann auf Senden.
- Klicken Sie auf Geheimen Schlüssel generieren, um einen geheimen Schlüssel zur Authentifizierung dieses Feeds zu generieren.
- Kopieren Sie den geheimen Schlüssel und speichern Sie ihn, da Sie ihn nicht noch einmal aufrufen können. Sie können einen neuen geheimen Schlüssel generieren, aber durch die Neugenerierung wird der vorherige geheime Schlüssel ungültig.
- Kopieren Sie auf dem Tab Details die Feed-Endpunkt-URL aus dem Feld Endpunktinformationen. Sie benötigen diese Endpunkt-URL, wenn Sie die Zieleinstellungen für Ihren Bereitstellungsstream in Amazon Data Firehose angeben.
- Optional: Klicken Sie auf den Ein/Aus-Button Feed aktiviert, um den Feed zu deaktivieren. Der Feed ist standardmäßig aktiviert.
- Klicken Sie auf Fertig.
API-Schlüssel für den Amazon Data Firehose-Feed erstellen
So erstellen Sie einen API-Schlüssel für den Amazon Data Firehose-Feed:
- Rufen Sie in der Google Cloud Console die Seite Anmeldedaten auf.
- Klicken Sie auf Anmeldedaten erstellen und wählen Sie den API-Schlüssel aus.
- Schränken Sie den API-Schlüsselzugriff auf die Chronicle API ein.
Endpunkt-URL angeben
Geben Sie in Amazon Data Firehose den HTTPS-Endpunkt und den Zugriffsschlüssel an:
Hängen Sie den API-Schlüssel an die Feed-Endpunkt-URL an und geben Sie diese URL als HTTP-Endpunkt-URL im folgenden Format an:
ENDPOINT_URL?key=API_KEYErsetzen Sie Folgendes:
ENDPOINT_URL: Die Feed-Endpunkt-URL.API_KEY: Der API-Schlüssel für die Authentifizierung bei Google SecOps.
Geben Sie für den Zugriffsschlüssel den geheimen Schlüssel an, den Sie beim Erstellen des Amazon Data Firehose-Feeds erhalten haben.
HTTPS-Webhook-Feed einrichten
Hinweise:
- Achten Sie darauf, dass ein Google Cloud -Projekt für Google SecOps konfiguriert ist und die Chronicle API für das Projekt aktiviert ist.
So richten Sie einen HTTPS-Webhook-Feed ein:
- Erstellen Sie einen HTTPS-Webhook-Feed und kopieren Sie die Endpunkt-URL und den geheimen Schlüssel.
- Erstellen Sie einen API-Schlüssel, der mit der Endpunkt-URL angegeben wird. Sie können auch Ihren vorhandenen API-Schlüssel zur Authentifizierung bei Google SecOps verwenden.
- Geben Sie die Endpunkt-URL in Ihrer Anwendung an.
Mehrere Ereignisse in einer einzelnen Webhook-Anfrage senden
Das folgende Codebeispiel zeigt, wie Sie einen einzelnen Anfragetext mit mehreren, durch Zeilenumbrüche getrennten JSON-Objekten nach dem curl --location-Element formatieren:
--header 'Content-Type: application/json' \
--header 'X-goog-api-key: API_KEY' \
--header 'X-Webhook-Access-Key: SECRET' \
--data '{"principal": {"asset_id": "asset 123"}, "metadata": {"event_type": "GENERIC_EVENT", "product_name": "Product Acme"}}
{"principal": {"asset_id": "asset 123"}, "metadata": {"event_type": "GENERIC_EVENT", "product_name": "Product Acme"}}'
HTTPS-Webhook-Feed erstellen
- Wählen Sie im Google SecOps-Menü Einstellungen und dann Feeds aus.
- Klicken Sie auf Neu hinzufügen.
- Geben Sie im Feld Feedname einen Namen für den Feed ein.
- Wählen Sie in der Liste Quelltyp die Option Webhook aus.
- Wählen Sie den Protokolltyp aus. Wenn Sie beispielsweise einen Feed für das Open Cybersecurity Schema Framework erstellen möchten, wählen Sie Open Cybersecurity Schema Framework (OCSF) als Logtyp aus.
- Klicken Sie auf Weiter.
- Optional: Geben Sie Werte für die folgenden Eingabeparameter an:
- Trennzeichen für Aufteilung: Das Trennzeichen, das zum Trennen von Logzeilen verwendet wird. Sie können nur
\nverwenden. - Asset-Namespace: der Asset-Namespace.
- Aufnahmelabels: Das Label, das auf die Ereignisse aus diesem Feed angewendet werden soll.
- Trennzeichen für Aufteilung: Das Trennzeichen, das zum Trennen von Logzeilen verwendet wird. Sie können nur
- Klicken Sie auf Weiter.
- Prüfen Sie die neue Feedkonfiguration auf dem Bildschirm Abschließen und klicken Sie dann auf Senden.
- Klicken Sie auf Geheimen Schlüssel generieren, um einen geheimen Schlüssel zur Authentifizierung dieses Feeds zu generieren.
- Kopieren Sie den geheimen Schlüssel und speichern Sie ihn, da Sie ihn nicht noch einmal aufrufen können. Sie können einen neuen geheimen Schlüssel generieren, aber durch die Neugenerierung wird der vorherige geheime Schlüssel ungültig.
- Kopieren Sie auf dem Tab Details die Feed-Endpunkt-URL aus dem Feld Endpunktinformationen. Sie müssen diese Endpunkt-URL in Ihrer Clientanwendung angeben.
- Optional: Klicken Sie auf den Ein/Aus-Button Feed aktiviert, um den Feed zu deaktivieren. Der Feed ist standardmäßig aktiviert.
- Klicken Sie auf Fertig.
API-Schlüssel für den Webhook-Feed erstellen
- Rufen Sie in der Google Cloud Console die Seite Anmeldedaten auf.
- Klicken Sie auf Anmeldedaten erstellen und wählen Sie anschließend API-Schlüssel aus.
- Schränken Sie den API-Schlüsselzugriff auf die Chronicle API ein.
Endpunkt-URL angeben
- Geben Sie in Ihrer Clientanwendung den HTTPS-Endpunkt an, der im Webhook-Feed verfügbar ist.
Aktivieren Sie die Authentifizierung, indem Sie den API-Schlüssel und den geheimen Schlüssel als Teil des benutzerdefinierten Headers im folgenden Format angeben:
X-goog-api-key = API_KEYX-Webhook-Access-Key = SECRETWir empfehlen, den API-Schlüssel als Header anzugeben, anstatt ihn in der URL anzugeben. Wenn Ihr Webhook-Client keine benutzerdefinierten Header unterstützt, können Sie den API-Schlüssel und den geheimen Schlüssel mit Suchparametern im folgenden Format angeben:
ENDPOINT_URL?key=API_KEY&secret=SECRETErsetzen Sie Folgendes:
ENDPOINT_URL: Die Feed-Endpunkt-URL.API_KEY: Der API-Schlüssel für die Authentifizierung bei Google SecOps.SECRET: Der geheime Schlüssel, den Sie zur Authentifizierung des Feeds generiert haben.
Benutzerdefinierten API-Feed einrichten
Mit benutzerdefinierten API-Feeds für Google Security Operations (auch als „Codeless Connectors“ bezeichnet) können Sie Telemetriedaten aus REST APIs von Drittanbietern über ein flexibles, konfigurationsbasiertes Modell aufnehmen. Sie können Datenabrufe konfigurieren, indem Sie Endpunkte, Authentifizierung, Paginierungsstrategien und Statusverwaltung direkt in der Konsole definieren.
Hauptvorteile
- Integration beschleunigen: Neue Telemetriequellen lassen sich in wenigen Minuten über einen geführten Assistenten einbinden, ohne dass Sie auf Backend-Updates warten müssen.
- Statusbezogene Prüfpunkte: Sorgen Sie dafür, dass es über alle Abfragezyklen hinweg keine doppelten Daten und keine fehlenden Logs gibt.
- Fan-out für über- und untergeordnete Elemente:Unterstützt zweistufige Ermittlungsworkflows, z. B. das Auflisten von Ressourcen und das Abrufen der zugehörigen Telemetrie.
- Automatisierte Ausfallsicherheit und Ratenbegrenzung: Verhindert die Drosselung von Anbietern und die Erschöpfung von Kontingenten. Für eine zuverlässige, unterbrechungsfreie Aufnahme werden HTTP 429-Antworten im Custom API-Feed automatisch mit exponentiellem Backoff behandelt. Anfragen werden mit konfigurierbarer Ratenbegrenzung und Staffelung der Aufgabenverzögerung gesteuert und es werden Sicherheitsvorkehrungen getroffen. Weitere Informationen finden Sie unter Guardrails für Ratenbegrenzung und Drosselung.
Vorbereitung
Prüfen Sie, ob die folgenden Voraussetzungen erfüllt sind, bevor Sie einen benutzerdefinierten API-Feed erstellen:
- Berechtigungen:Zum Erstellen oder Ändern von Feeds benötigen Sie die Rolle „Chronicle API Admin“ (
roles/chronicle.admin) oder „Chronicle API Editor“ (roles/chronicle.editor). - Anforderungen an Drittanbieter-APIs:
- Eine gültige API-Basis-URL (muss
https://verwenden). - API-Anmeldedaten (API-Schlüssel, Basisauthentifizierungsanmeldedaten oder OAuth 2.0-Client-ID/geheimer Clientschlüssel)
- Vendor API-Dokumentation mit Details zu Endpunktpfaden, Anfrageparametern, JSON-Antwortstrukturen und Ratenbeschränkungen.
- Eine gültige API-Basis-URL (muss
- Secret Manager-Zugriff:Anmeldedaten werden verschlüsselt und sicher in Secret Manager verwaltet. Die Dienstidentität, die den Connector ausführt, interagiert automatisch mit Secret Manager (
roles/secretmanager.secretAccessorundroles/secretmanager.admin).
Benutzerdefinierten API-Feed konfigurieren
So konfigurieren Sie einen benutzerdefinierten API-Feed:
- Rufen Sie die SIEM-Einstellungen > Feeds auf.
- Klicken Sie auf Neuen Feed hinzufügen.
- Klicken Sie auf Einzelnen Feed konfigurieren.
- Geben Sie im Feld Feedname einen eindeutigen aussagekräftigen Namen ein, z. B.
1Password-Audit-Events. - Wählen Sie in der Liste Quelltyp die Option Benutzerdefinierte API aus.
- Wählen Sie in der Liste Logtyp den Ziel-Google SecOps-Logtyp aus.
- Klicken Sie auf Weiter.
Konfigurieren Sie unter Allgemeine Einstellungen Folgendes:
Basis-URL:Geben Sie den primären Host ein, z. B.
https://events.1password.com. Er muss mithttps://beginnen. Hängen Sie keine Unterpfade oder abschließenden Schrägstriche an.Abfragehäufigkeit:Geben Sie an, wie oft die Plattform die API in Minuten nach neuen Telemetriedaten abfragen soll. Unterstützter Bereich: 5 bis 2.880 Minuten (Standard: 15 Minuten). Bei Standard-APIs (sequenziell) sind 10–15 Minuten üblich. Bei Listen- und Detail-Feeds (über- und untergeordnet) werden 30–60 Minuten empfohlen, damit die Ausführung von Fan-out-Aufgaben ohne Überschneidungen möglich ist.
Wählen Sie unter Authentifizierung eine der unterstützten Authentifizierungsmethoden aus und konfigurieren Sie dann die erforderlichen Felder:
- Basisauthentifizierung:Geben Sie den Nutzernamen (Identität des API-Kontos) und den Schlüssel (das geheime Passwort oder Token) ein.
- OAuth 2.0-Clientanmeldedaten:Authentifizieren Sie sich mit dem OAuth 2.0-Grant-Typ „Clientanmeldedaten“. Google SecOps fordert automatisch Bearer-Zugriffstokens an, speichert sie im Cache und aktualisiert sie vor jedem Erfassungszyklus. Geben Sie den OAuth-Token-Endpunkt (z. B.
https://auth.vendor.com/oauth/token), die OAuth-Client-ID und das OAuth-Client-Secret ein. - API-Schlüsselanfrageheader:Authentifizierung mit benutzerdefinierten API-Schlüsseln, die in Anfrageheader eingefügt werden (das gängigste REST-Muster für Unternehmen). Geben Sie den Header-Namen ein, z. B.
AuthorizationoderX-API-Key, und den Header-Wert, z. B.Bearer <SECRET_TOKEN>oder<SECRET_KEY>. - API-Schlüssel-Suchparameter:Authentifizierung mit benutzerdefinierten API-Schlüsseln, die in URL-Suchparameter eingefügt werden. Geben Sie den Namen des Suchparameters (z. B.
api_key) und den Parameterwert (z. B.<SECRET_KEY>) ein.
Wählen Sie das Connectormodell aus, das von Ihrer benutzerdefinierten API verwendet wird:
- Standard-API (sequenziell): Ein linearer Polling-Ablauf, bei dem jeder Poll direkt auf dem Status des vorherigen aufbaut. Bei diesem Modell wird beim nächsten Abruf ein Cursor, ein Token oder ein Zeitstempel verwendet, der aus dem vorherigen Abruf extrahiert wurde, um nur neue Daten abzurufen. Wählen Sie diese Karte aus, wenn der Anbieter einen Endpunkt bereitstellt, der Telemetrie-Ereignisdatensätze direkt zurückgibt (z. B. 1Password, Okta, SentinelOne, GitHub oder Slack).
- Liste und Details (über-/untergeordnet): Ein zweistufiger Ablauf. Mit dem Feed wird ein erster Aufruf (übergeordnet) ausgeführt, um eine Liste von Ressourcen oder Objekten abzurufen, z. B. eine Liste von Nutzer-IDs oder Zonen. Aus dem Feed werden dann automatisch abhängige Folgeaufrufe (untergeordnete Elemente) generiert, um detaillierte Telemetriedaten für jede identifizierte Ressource abzurufen. Wählen Sie diese Karte aus, wenn für die API des Anbieters ein zweistufiges Erkennungsmuster erforderlich ist: Zuerst wird ein Endpunkt aufgerufen, um eine dynamische Liste von Einheiten (z. B. Zonen, Konten, Projekte, Geräte) abzurufen, und dann werden für jede Einheit Detailanfragen ausgeführt, um Telemetriedaten abzurufen (z. B. Cloudflare, AWS CloudWatch oder Tenable).
Wenn Sie Standard-API (sequenziell) ausgewählt haben, gehen Sie so vor:
- Konfigurieren Sie unter API-Endpunkt die folgenden Parameter, um die technische Weiterleitung und die Ratenabstimmung für die Anfrage zu definieren:
- Endpunktpfad:Die spezifische API-Route, die an die Basis-URL angehängt wird (z. B.
/api/v1/auditevents). Damit wird die genaue Telemetrieressource definiert, die abgefragt werden soll. - HTTP-Methode:Wählen Sie GET aus, um Daten mithilfe von URL-Suchparametern abzurufen, oder POST, um eine Suchnutzlast oder einen Filtertext zu senden.
- Endpunktpfad:Die spezifische API-Route, die an die Basis-URL angehängt wird (z. B.
- Anfragetext:Geben Sie für POST-Anfragen die JSON-Daten-Nutzlast an. Sie können dynamische Prüfpunktvariablen wie
{"limit": 100, "start_time": "{{.last_timestamp}}"}einbetten. - Maximale Anzahl von Anfragen pro Minute:Geben Sie die maximale Anzahl von Anfragen ein, die pro Minute gesendet werden sollen. Dies ist eine clientseitige Ratenbegrenzung, um die API-Ratenbegrenzungen des Anbieters einzuhalten (Standard: 5 RPM = 1 Anfrage alle 12 Sekunden). Diese Einstellung verhindert, dass das Kontingent bei der mehrseitigen Paginierung erschöpft wird.
- Optional: Konfigurieren Sie unter Benutzerdefinierte Header den Header-Namen und den Wert und klicken Sie dann auf Hinzufügen, um spezielle HTTP-Header zu definieren, die von der Ziel-API benötigt werden (z. B.
Content-Type: application/json, Accept: application/json). - Optional: Konfigurieren Sie unter Abfrageparameter den Schlüssel und den Wert und klicken Sie dann auf Hinzufügen, um zusätzliche Filter oder Optionen anzugeben, die an den URL-Suchstring angehängt werden (z. B.
count=1000,status=active), oder um dynamische Vorlagenvariablen zu binden (z. B.start={{.last_run_time}}). - Wählen Sie unter Paginierungsstrategie den Paginierungsmechanismus aus, der für die Verarbeitung mehrseitiger Ergebnismengen in der Drittanbieter-API erforderlich ist, und konfigurieren Sie dann die erforderlichen Felder:
- Keine:Daten in einer einzelnen Anfrage ohne Paging abrufen.
- Token-Paginierung:Verwenden Sie Tokens (benutzerdefinierte Schlüssel), um die nächste Seite abzurufen. Geben Sie den JSON-Pfad für das Token der nächsten Seite (z. B.
meta.next_cursor) und den Namen des Abfrageparameters für die Token-Paginierung (z. B.cursor) ein. - Link-Paginierung:Folgen Sie den in der Antwort angegebenen URLs, um weitere Daten zu erhalten. Geben Sie den JSON-Pfad für den Link zur nächsten Seite ein, z. B.
links.nextoder@odata.nextLink. - Offset-Paginierung:Eine bestimmte Anzahl von Datensätzen wird übersprungen, um den nächsten Satz abzurufen. Geben Sie den Namen des Offset-Suchparameters ein, z. B.
offset. - Seitenzahlnummerierung:Gehen Sie zur nächsten fortlaufenden Seitenzahl. Geben Sie den Namen des Suchparameters für die Seitenzahl ein, z. B.
page.
Konfigurieren Sie unter Checkpointing die Einstellungen, mit denen sich der Connector zwischen wiederkehrenden Abfragezyklen merken kann, wo er aufgehört hat:
- Strategie:Wählen Sie eine der folgenden Strategien aus und konfigurieren Sie die erforderlichen Felder:
- Keine:Alle verfügbaren Daten abrufen, ohne den Fortschritt über Zyklen hinweg zu verfolgen.
- Letzter Zeitstempel:Zeitstempel des neuesten Datensatzes. Geben Sie den JSON-Pfad des Prüfpunktwerts (z. B.
timestampoderevent_time) und die Prüfpunktvariable (z. B.last_run_time, auf die in nachfolgenden Umfragen als{{.last_run_time}}verwiesen wird) ein. - Letzter Datensatz:Verfolgen Sie die höchste Datensatz-ID, um nur neue Datensätze abzurufen. Geben Sie den JSON-Pfad des Prüfpunktwerts ein, z. B.
idoderevent_id, und die Prüfpunktvariable, z. B.last_id, auf die als{{.last_id}}verwiesen wird. - Iterator-Token:Verwenden Sie persistente Fortsetzungstokens, die von der API bereitgestellt werden. Geben Sie den JSON-Pfad des Prüfpunkts und die Prüfpunktvariable ein (z. B.
iterator_token, auf die als{{.iterator_token}}verwiesen wird).
- Strategie:Wählen Sie eine der folgenden Strategien aus und konfigurieren Sie die erforderlichen Felder:
Geben Sie unter Antwortzuordnung Regeln an, die der Plattform mitteilen, wie Logs gefunden und extrahiert werden:
- JSON-Pfad für Zieldaten:Geben Sie den genauen Pfad in der API-Antwortnutzlast ein, in dem sich die Liste der Ziel-Logeinträge befindet. Geben Sie für in Objekte eingeschlossene Arrays (z. B.
{"items": [...]})itemsein. Lassen Sie dieses Feld für APIs, die direkt ein JSON-Root-Array zurückgeben (z. B.[{...}, {...}]), vollständig leer ([]).
- JSON-Pfad für Zieldaten:Geben Sie den genauen Pfad in der API-Antwortnutzlast ein, in dem sich die Liste der Ziel-Logeinträge befindet. Geben Sie für in Objekte eingeschlossene Arrays (z. B.
- Konfigurieren Sie unter API-Endpunkt die folgenden Parameter, um die technische Weiterleitung und die Ratenabstimmung für die Anfrage zu definieren:
Wenn Sie Liste und Details (über-/untergeordnet) ausgewählt haben, gehen Sie so vor:
- Übergeordnete Anfrage (Discovery): Konfigurieren Sie den Endpunkt, der eine Liste von Elementen zurückgibt:
- Konfigurieren Sie unter API-Endpunkt die folgenden Parameter, um die technische Weiterleitung und die Ratensteuerung für die Anfrage zu definieren:
- Endpunktpfad:Die spezifische API-Route, die an die Basis-URL angehängt wird (z. B.
/api/v1/auditevents). Dadurch wird die genaue Telemetrieressource definiert, die abgefragt werden soll. - HTTP-Methode:Wählen Sie GET aus, um Daten mithilfe von URL-Suchparametern abzurufen, oder POST, um eine Suchnutzlast oder einen Filtertext zu senden.
- Anfragetext:Geben Sie für POST-Anfragen die JSON-Daten-Nutzlast an. Sie können dynamische Prüfpunktvariablen wie
{"limit": 100, "start_time": "{{.last_timestamp}}"}einbetten.
- Endpunktpfad:Die spezifische API-Route, die an die Basis-URL angehängt wird (z. B.
- Maximale Anzahl von Anfragen pro Minute:Geben Sie die maximale Anzahl von Anfragen ein, die pro Minute gesendet werden sollen. Dies ist eine clientseitige Ratenbegrenzung, um die API-Ratenbegrenzungen des Anbieters einzuhalten (Standard: 5 RPM = 1 Anfrage alle 12 Sekunden). Diese Einstellung verhindert, dass das Kontingent bei der mehrseitigen Paginierung erschöpft wird.
- Optional: Konfigurieren Sie unter Benutzerdefinierte Header den Header-Namen und den Wert und klicken Sie dann auf Hinzufügen, um spezielle HTTP-Header zu definieren, die von der Ziel-API benötigt werden (z. B.
Content-Type: application/json, Accept: application/json). - Optional: Konfigurieren Sie unter Abfrageparameter den Schlüssel und den Wert und klicken Sie dann auf Hinzufügen, um zusätzliche Filter oder Optionen anzugeben, die an den URL-Suchstring angehängt werden (z. B.
count=1000,status=active), oder um dynamische Vorlagenvariablen zu binden (z. B.start={{.last_run_time}}). - Wählen Sie unter Paginierungsstrategie den Paginierungsmechanismus aus, der für die Verarbeitung von mehrseitigen Ergebnismengen durch die Drittanbieter-API erforderlich ist, und konfigurieren Sie dann die erforderlichen Felder:
- Keine:Daten in einer einzelnen Anfrage ohne Paging abrufen.
- Token-Paginierung:Verwenden Sie Tokens (benutzerdefinierte Schlüssel), um die nächste Seite abzurufen. Geben Sie den JSON-Pfad für das Token der nächsten Seite (z. B.
meta.next_cursor) und den Namen des Abfrageparameters für die Token-Paginierung (z. B.cursor) ein. - Link-Paginierung:Folgen Sie den in der Antwort angegebenen URLs, um weitere Daten zu erhalten. Geben Sie den JSON-Pfad für den Link zur nächsten Seite ein, z. B.
links.nextoder@odata.nextLink. - Offset-Paginierung:Eine bestimmte Anzahl von Datensätzen wird übersprungen, um den nächsten Satz abzurufen. Geben Sie den Namen des Offset-Suchparameters ein, z. B.
offset. - Seitenzahlnummerierung:Gehen Sie zur nächsten fortlaufenden Seitenzahl. Geben Sie den Namen des Suchparameters für die Seitenzahl ein, z. B.
page.
- Konfigurieren Sie unter Checkpointing die Einstellungen, mit denen sich der Connector zwischen wiederkehrenden Abfragezyklen merken kann, wo er aufgehört hat:
- Strategie:Wählen Sie eine der folgenden Strategien aus und konfigurieren Sie die erforderlichen Felder:
- Keine:Alle verfügbaren Daten abrufen, ohne den Fortschritt über Zyklen hinweg zu verfolgen.
- Letzter Zeitstempel:Zeitstempel des neuesten Datensatzes. Geben Sie den JSON-Pfad des Prüfpunktwerts (z. B.
timestampoderevent_time) und die Prüfpunktvariable (z. B.last_run_time, auf die in nachfolgenden Umfragen als{{.last_run_time}}verwiesen wird) ein. - Letzter Datensatz:Verfolgen Sie die höchste Datensatz-ID, um nur neue Datensätze abzurufen. Geben Sie den JSON-Pfad des Prüfpunktwerts ein, z. B.
idoderevent_id, und die Prüfpunktvariable, z. B.last_id, auf die als{{.last_id}}verwiesen wird. - Iterator-Token:Verwenden Sie persistente Fortsetzungstokens, die von der API bereitgestellt werden. Geben Sie den JSON-Pfad des Prüfpunktwerts und die Prüfpunktvariable ein (z. B.
iterator_token, auf die als{{.iterator_token}}verwiesen wird).
- Strategie:Wählen Sie eine der folgenden Strategien aus und konfigurieren Sie die erforderlichen Felder:
- Konfigurieren Sie unter API-Endpunkt die folgenden Parameter, um die technische Weiterleitung und die Ratensteuerung für die Anfrage zu definieren:
- Datenextraktion (die Brücke): Konfigurieren Sie Folgendes:
- JSON-Pfad für die Element-ID:Das spezifische Feld in der übergeordneten Antwort, das eine einzelne Einheit eindeutig identifiziert (z. B.
idoderzone_id). Der Connector extrahiert diese ID aus jedem Element im übergeordneten Array. - Name der Vorlagenvariablen:Geben Sie einen benutzerdefinierten Variablennamen für die extrahierte ID an, z. B.
zone_id. In der Benutzeroberfläche wird ein dynamisches Badge angezeigt: Verwenden Sie{{.zone_id}}in der untergeordneten Anfrage unten.
- JSON-Pfad für die Element-ID:Das spezifische Feld in der übergeordneten Antwort, das eine einzelne Einheit eindeutig identifiziert (z. B.
- Untergeordnete Anfrage (Detail): Konfigurieren Sie den Endpunkt, der detaillierte Logs für jedes Element zurückgibt:
- Konfigurieren Sie unter API-Endpunkt die folgenden Parameter, um die technische Weiterleitung und die Ratenabstimmung für die Anfrage zu definieren:
- Endpunktpfad:Die spezifische API-Route, die an die Basis-URL angehängt wird (z. B.
/client/v4/zones/{{.zone_id}}/logs/received). Dadurch wird die genaue Telemetrieressource definiert, die abgefragt werden soll. - HTTP-Methode:Wählen Sie GET aus, um Daten mithilfe von URL-Suchparametern abzurufen, oder POST, um eine Suchnutzlast oder einen Filterkörper zu senden.
- Anfragetext:Geben Sie für POST-Anfragen die JSON-Daten-Nutzlast an. Sie können dynamische Prüfpunktvariablen wie
{"limit": 100, "start_time": "{{.last_timestamp}}"}einbetten.
- Endpunktpfad:Die spezifische API-Route, die an die Basis-URL angehängt wird (z. B.
- Maximale Anzahl von Anfragen pro Minute:Geben Sie die maximale Anzahl von Anfragen ein, die pro Minute gesendet werden sollen. Dies ist eine clientseitige Ratenbegrenzung, um die API-Ratenbegrenzungen des Anbieters einzuhalten (Standard: 5 RPM = 1 Anfrage alle 12 Sekunden). Diese Einstellung verhindert, dass das Kontingent bei der mehrseitigen Paginierung erschöpft wird.
- Optional: Konfigurieren Sie unter Benutzerdefinierte Header den Header-Namen und den Wert und klicken Sie dann auf Hinzufügen, um spezielle HTTP-Header zu definieren, die von der Ziel-API benötigt werden (z. B.
Content-Type: application/json, Accept: application/json). - Optional: Konfigurieren Sie unter Abfrageparameter den Schlüssel und den Wert und klicken Sie dann auf Hinzufügen, um zusätzliche Filter oder Optionen anzugeben, die an den URL-Suchstring angehängt werden (z. B.
count=1000,status=active), oder um dynamische Vorlagenvariablen zu binden (z. B.start={{.last_run_time}}). - Wählen Sie unter Paginierungsstrategie den Paginierungsmechanismus aus, der für die Verarbeitung mehrseitiger Ergebnismengen in der Drittanbieter-API erforderlich ist, und konfigurieren Sie dann die erforderlichen Felder:
- Keine:Daten in einer einzelnen Anfrage ohne Paging abrufen.
- Token-Paginierung:Verwenden Sie Tokens (benutzerdefinierte Schlüssel), um die nächste Seite abzurufen. Geben Sie den JSON-Pfad für das Token der nächsten Seite (z. B.
meta.next_cursor) und den Namen des Abfrageparameters für die Token-Paginierung (z. B.cursor) ein. - Link-Paginierung:Folgen Sie den in der Antwort angegebenen URLs, um weitere Daten zu erhalten. Geben Sie den JSON-Pfad für den Link zur nächsten Seite ein, z. B.
links.nextoder@odata.nextLink. - Offset-Paginierung:Eine bestimmte Anzahl von Datensätzen wird übersprungen, um den nächsten Satz abzurufen. Geben Sie den Namen des Offset-Suchparameters ein, z. B.
offset. - Seitenzahlnummerierung:Gehen Sie zur nächsten fortlaufenden Seitenzahl. Geben Sie den Namen des Suchparameters für die Seitenzahl ein, z. B.
page.
- Konfigurieren Sie unter Checkpointing die Einstellungen, mit denen sich der Connector zwischen wiederkehrenden Abfragezyklen merken kann, wo er aufgehört hat:
- Strategie:Wählen Sie eine der folgenden Strategien aus und konfigurieren Sie die erforderlichen Felder:
- Keine:Alle verfügbaren Daten abrufen, ohne den Fortschritt über Zyklen hinweg zu verfolgen.
- Letzter Zeitstempel:Zeitstempel des neuesten Datensatzes. Geben Sie den JSON-Pfad des Prüfpunktwerts (z. B.
timestampoderevent_time) und die Prüfpunktvariable (z. B.last_run_time, auf die in nachfolgenden Umfragen als{{.last_run_time}}verwiesen wird) ein.
- Strategie:Wählen Sie eine der folgenden Strategien aus und konfigurieren Sie die erforderlichen Felder:
- Konfigurieren Sie unter API-Endpunkt die folgenden Parameter, um die technische Weiterleitung und die Ratenabstimmung für die Anfrage zu definieren:
- Übergeordnete Anfrage (Discovery): Konfigurieren Sie den Endpunkt, der eine Liste von Elementen zurückgibt:
Konfigurieren Sie die folgenden Einstellungen unter Planung und Labels:
- Abfragehäufigkeit:Wählen Sie ein Standardintervall aus, z. B.
5moder1h. - Namespace:Optionales Organisations-Tag.
- Aufnahme-Labels:Schlüssel/Wert-Paare für die rollenbasierte Zugriffssteuerung für Daten.
- Abfragehäufigkeit:Wählen Sie ein Standardintervall aus, z. B.
Klicken Sie auf Senden. Google SecOps führt eine automatische Überprüfung der Anmeldedaten und Endpunkte durch. Wenn die Validierung erfolgreich ist, beginnt das Polling des Feeds.
Beispielkonfiguration 1: 1Password-Audit-Ereignisse (Standard-API-Modell (sequenziell))
Die folgende deklarative JSON-Konfiguration zeigt ein Standard API (Sequential)-Modell mit cursorbasierten Checkpoints für 1Password:
{
  "base_url": "https://events.1password.com",
  "polling_frequency": 15,
  "header_auth": {
    "header_key_values": [
      {
        "key": "Authorization",
        "value": "Bearer <SECRET_STORED_IN_SECRET_MANAGER>"
      }
    ]
  },
  "primary_request": {
    "request_settings": {
      "endpoint_path": "/api/v1/auditevents",
      "http_method": "POST",

      "request_body": "{\"limit\": 1000, \"start_time\": \"{{.last_run_time}}\"}",

      "custom_headers": [
        {
          "key": "Content-Type",
          "value": "application/json"
        }
      ],
      "max_requests_per_minute": 5
    },
    "pagination_strategy": {
      "token": {
        "next_page_token_json_path": "additional_items_url",
        "query_param": "cursor"
      }
    },
    "checkpointing": {
      "latest_timestamp_strategy": {
        "checkpoint_value_path": "timestamp",
        "checkpoint_variable": "last_run_time"
      }
    },
    "response_mapping": {
      "target_data_path": ["items"]
    }
  }
}
Konkrete Beispielkonfiguration 2: Cloudflare-Zonen-Telemetrie (über-/untergeordnetes Modell für Liste und Details)
Die folgende deklarative JSON-Konfiguration zeigt ein List & Detail (Parent-Child)-Fan-Out-Modell für Cloudflare:
{
 "base_url": "https://api.cloudflare.com",
 "polling_frequency": 30,
 "header_auth": {
   "header_key_values": [
     {
       "key": "Authorization",
       "value": "Bearer <SECRET_STORED_IN_SECRET_MANAGER>"
     }
   ]
 },

 "primary_request": {
   "request_settings": {
     "endpoint_path": "/client/v4/zones",
     "http_method": "GET"
   },
   "response_mapping": {
     "target_data_path": ["result"]
   },
   "pagination_strategy": {
     "none": {}
   },
   "checkpointing": {
     "none_strategy": {}
   },
   "dependent_requests_config": {
     "item_id_json_path": "id",
     "item_id_variable": "zone_id",
     "dependent_requests": [
       {
         "request_settings": {
           "endpoint_path": "/client/v4/zones/{{.zone_id}}/logs/received",
           "http_method": "GET",
           "query_parameters": [
             {
               "key": "start",
               "value": "{{.last_run_time}}"
             },
             {
               "key": "count",
               "value": "1000"
             }
           ],
           "max_requests_per_minute": 5
         },

         "pagination_strategy": {
           "none": {}
         },
         "checkpointing": {
           "latest_timestamp_strategy": {
             "checkpoint_value_path": "EdgeStartTimestamp",
             "checkpoint_variable": "last_run_time"
           }
         },
         "response_mapping": {
           "target_data_path": []
         }
       }
     ]
   }
 }
}
Best Practices für benutzerdefinierte APIs
- Anleitung zur Abfragehäufigkeit:
- Mit moderaten Abfrageintervallen beginnen: Legen Sie das anfängliche Abfrageintervall für Endpunkte mit hohem Volumen auf 15 oder 30 Minuten fest, um das Kontingentverhalten der Anbieter-API zu beobachten, bevor Sie es auf 5 Minuten senken.
- Für hohes Fan-out-Volumen optimieren: Wenn in Parent-Child (List & Detail)-Feeds Dutzende oder Hunderte von Ressourcen erkannt werden, empfiehlt Google dringend, die Polling frequency auf 30 bis 60 Minuten festzulegen, damit alle Child-Aufgaben mit Pacing abgeschlossen werden können, bevor der nächste Erkennungszyklus beginnt.
- Aufnahmepfade validieren: Verwenden Sie die Anbieterdokumentation oder API-Testtools, um den genauen JSON-Feldnamen für Zeitstempel zu bestätigen, bevor Sie die Statusprüfung konfigurieren.
- Multi-Child-APIs aufschlüsseln: Wenn für eine Drittanbieter-API Warnungen und Prüfprotokolle für eine einzelne Nutzerliste abgerufen werden müssen, erstellen Sie zwei separate Single-Child-Feeds (einen für Warnungen und einen für Prüfprotokolle), um eine optimale Isolation zu gewährleisten.
Schutzmaßnahmen für Ratenbegrenzung und Drosselung
Damit die Kontingente von Drittanbietern nicht durch Kundenfeedkonfigurationen überlastet werden oder Systemressourcen monopolisiert werden, werden für den Feedtyp „Benutzerdefinierte API“ die folgenden automatisierten Schutzmaßnahmen implementiert:
- Konfigurierbare Anfrageratenbegrenzung: Ausgehende HTTP-Anfragen werden automatisch so gesteuert, dass die Ratenbegrenzungen des Anbieters nicht überschritten werden. Die standardmäßige Pacing-Rate beträgt 5 Anfragen pro Minute (1 Anfrage alle 12 Sekunden). Sie können diesen Wert für jeden Endpunkt über das Feld Max. requests per minute (Maximale Anfragen pro Minute) in den Endpunkteinstellungen an die veröffentlichten API-Kontingente Ihres Anbieters anpassen.
- Obergrenze für untergeordnete Anfragen:Bei Parent-Child (List & Detail)-Feeds können pro Abrufzyklus bis zu 500 untergeordnete Anfragen gesendet werden.
- Fan-out-Tiefe auf einer Ebene:Der Connector erzwingt eine maximale Fan-out-Tiefe von einer Ebene (übergeordnetes Element ermitteln → untergeordnete Details). Verschachtelte abhängige Anfragen (Enkelaufrufe) werden nicht unterstützt.
- Obergrenze für die Größe der Antwortnutzlast:Die maximal zulässige HTTP-Antwortgröße für eine einzelne Anfrage oder Seite beträgt 50 MB. Wenn eine nicht paginierte API eine Antwort zurückgibt, die 50 MB überschreitet, schlägt der Abruf mit einem Fehler vom Typ „resource exhausted“ fehl. Um dies zu verhindern, konfigurieren Sie immer Paginierungsabfrageparameter (z. B.
limitoderpage_size), um Datensätze in kleineren Batches abzurufen. - Automatischer HTTP 429-Backoff:Wenn eine API eines Drittanbieters mit HTTP 429 (Zu viele Anfragen) antwortet, erfasst Google SecOps automatisch den Status und leitet einen exponentiellen Backoff-Zeitraum ein. Die Ausführung von Aufgaben wird pausiert, bis das Kontingent des Anbieters wieder aufgefüllt ist.
Benutzerdefinierte API-Einschränkungen
Beachten Sie bei der Planung Ihrer Aufnahmepfade die folgenden Einschränkungen für den Feedtyp „Benutzerdefinierte API“:
- Strikte JSON-Unterstützung:Es werden nur JSON-API-Antworten unterstützt. Andere Formate wie XML, CSV, Parquet und Avro werden nicht unterstützt.
- Keine dynamische Anforderungssignierung:APIs, für die dynamische kryptografische Signaturen pro Anfrage erforderlich sind, werden nicht unterstützt (z. B. AWS SigV4, Akamai oder Oracle OCI).
- Keine mehrstufige Authentifizierung:APIs, für die ein anfänglicher programmatischer Anmeldeaufruf erforderlich ist, um Anmeldedaten gegen ein temporäres Sitzungstoken einzutauschen (z. B. Saviynt), bevor abgefragt wird, werden nicht unterstützt.
- Keine WebSockets oder Push-Aufnahme:Benutzerdefinierte API-Feeds unterstützen das standardmäßige HTTPS-Pull-Polling. Nichtflüchtige Streamingverbindungen (WebSockets) und eingehende Webhooks werden nicht unterstützt.
- Keine gegenseitige TLS-Authentifizierung (mTLS): Die Authentifizierung muss auf API-Schlüsseln, der Basisauthentifizierung oder Standardanmeldedaten des OAuth 2.0-Clients basieren. Clientseitige Zertifikathandshakes werden nicht unterstützt.
Fehlerbehebung bei benutzerdefinierten API-Feeds
Verwenden Sie die folgenden Abfragen, um Fehler für benutzerdefinierte API-Feeds im Cloud Logging Logs Explorer zu untersuchen:
resource.type="gce_instance" OR resource.type="generic_task"
jsonPayload.service="gopher"
jsonPayload.feed_id="FEED_ID"
Ersetzen Sie FEED_ID durch Ihre Feed-ID.
Wenn Sie speziell nach fehlgeschlagenen HTTP-Anfragen filtern möchten, verwenden Sie die folgende Abfrage:
jsonPayload.service="gopher"
jsonPayload.feed_id="FEED_ID"
jsonPayload.http_status_code >= 400
Ersetzen Sie FEED_ID durch Ihre Feed-ID.
Häufige Fehlerarten und Lösungen
| Symptom / Fehler | Ursache | Lösung / Abhilfe |
|---|---|---|
| HTTP 401 Unauthorized / HTTP 403 Forbidden | Abgelaufener oder ungültiger API-Schlüssel, abgelaufenes oder ungültiges Passwort oder abgelaufene oder ungültige OAuth-Anmeldedaten. | Bearbeiten Sie den Feed, geben Sie gültige Anmeldedaten ein und klicken Sie auf Senden. |
| HTTP 404 Nicht gefunden | Falsche Basis-URL oder Endpunktpfadvorlage. | Sehen Sie sich den Endpunkt in der API-Dokumentation des Anbieters an. Die Basis-URL muss sauber enden und der Endpunktpfad mit „/“ beginnen. |
| HTTP 429 Too Many Requests | Die Ratenbegrenzungen der Anbieter-API wurden überschritten. | Erhöhen Sie die Polling-Häufigkeit oder verringern Sie den Parameter limit in den Abfrageparametern. |
| Fehler beim Extrahieren von JSON (items_path leer) | Der Pfad der Antwortkonfiguration stimmt nicht überein. | Prüfen Sie die Struktur der API-Antwortnutzlast und aktualisieren Sie den JSON-Pfad der Zieldaten. |
| Doppelte Datenaufnahme | Ungültiger Zeitstempel für die Statuskonfiguration oder ungültiger Pfad für den ID-Extractor. | Prüfen Sie den Feldnamen des Logeintrags für den Zeitstempel und aktualisieren Sie den Extraktorpfad. |
Feeds verwalten
Nachdem Sie Ihre Datenfeeds konfiguriert haben, können Sie mit den Verwaltungstools den Status der Aufnahme überwachen, vorhandene Parameter ändern und den Feed-Lebenszyklus verwalten. In diesem Abschnitt wird beschrieben, wie Sie Feedstatus interpretieren und wichtige Wartungsaufgaben ausführen, um eine kontinuierliche Datensichtbarkeit zu gewährleisten.
Auf der Seite Feeds finden Sie verschiedene Tools, mit denen Sie Ihre Liste der konfigurierten Feeds verwalten und organisieren können:
Suchen: Über die Suchleiste können Sie nach einem Feed anhand des Feednamens, der Feed-ID oder des Quelltyps suchen.
Filtern: Klicken Sie auf das Filtersymbol, um die Liste anhand bestimmter Feedattribute einzugrenzen.
CSV-Datei herunterladen: Klicken Sie auf Als CSV-Datei herunterladen, um die aktuelle Liste der Feeds in eine CSV-Datei zu exportieren.
Paginierung: Mit den Paginierungssteuerelementen können Sie:
Ändern Sie die Anzahl der Zeilen pro Seite.
Mit den Seitentabs und Pfeilen können Sie durch mehrere Seiten mit Feeds navigieren.
Letzte Aktualisierung: Hier sehen Sie den Zeitstempel der letzten Aktualisierung der Feedliste.
Konfigurierte Feeds ansehen
Auf der Seite Feeds werden alle von Ihnen konfigurierten Feeds angezeigt.
- Rufen Sie die SIEM-Einstellungen > Feeds auf. Auf der Hauptseite werden alle konfigurierten Feeds angezeigt.
- Bewegen Sie den Mauszeiger auf die einzelnen Zeilen, um das Dreipunkt-Menü Mehr anzuzeigen.
- Im Menü können Sie Feeddetails aufrufen, den Feed bearbeiten, deaktivieren oder löschen.
Feedstatus überwachen
Sie können den Status des Feeds auf der Seite Feeds im Blick behalten. Dort können Feeds die folgenden Status haben:
- Aktiv: Der Feed ist konfiguriert und bereit, Daten in Ihr Google SecOps-Konto aufzunehmen.
- InProgress: Google SecOps versucht, Daten vom konfigurierten Drittanbieter abzurufen.
- Abgeschlossen: Daten wurden von diesem Feed erfolgreich abgerufen.
- Archiviert: Deaktivierter Feed.
Fehlgeschlagen: Daten können nicht erfolgreich aus dem Feed abgerufen werden. Wahrscheinlich liegt ein Konfigurationsproblem vor. Klicken Sie auf die Frage, um den Konfigurationsfehler aufzurufen. Nachdem Sie den Fehler behoben und den Feed noch einmal eingereicht haben, kehren Sie zur Seite Feeds zurück, um zu prüfen, ob der Feed jetzt funktioniert.
Vorhandene Feeds bearbeiten
Auf der Seite Feeds können Sie einen vorhandenen Feed so bearbeiten:
Bewegen Sie den Mauszeiger auf einen vorhandenen Feed und klicken Sie in der rechten Spalte auf das Dreipunkt-Menü more_vert.
Klicken Sie auf Feed bearbeiten. Sie können die Eingabeparameter für den Feed jetzt ändern und ihn noch einmal an Google SecOps senden. Google SecOps versucht dann, den aktualisierten Feed zu verwenden.
Feeds aktivieren (fortsetzen) und deaktivieren (pausieren)
Wenn Sie einen Feed deaktivieren, werden keine neuen Daten mehr aus dieser Quelle in Google SecOps aufgenommen. Wenn Sie die Datenaufnahme sofort beenden möchten, müssen Sie den Feed löschen. Bestehende aktive oder gedrosselte Übertragungen werden fortgesetzt, bis sie abgeschlossen sind. Wenn Sie den Feed wieder aktivieren, kann Google SecOps Daten abrufen, die während der Deaktivierung des Feeds nicht erfasst wurden. Diese Funktion wird als „Backfill-Fähigkeit“ bezeichnet.
In der Spalte Status sind aktivierte Feeds mit Aktiv, In Bearbeitung, Abgeschlossen oder Fehlgeschlagen gekennzeichnet. Deaktivierte Felder sind mit Archiviert gekennzeichnet. Eine Beschreibung finden Sie unter Feedstatus im Blick behalten.
Auf der Seite Feeds können Sie vorhandene Feeds aktivieren (fortsetzen) oder deaktivieren (pausieren):
Bewegen Sie den Mauszeiger auf einen vorhandenen Feed und klicken Sie in der rechten Spalte auf das Dreipunkt-Menü more_vert.
Optional: Klicken Sie auf den Ein/Aus-Button Feed aktiviert, um den Feed zu aktivieren.
Optional: Klicken Sie auf den Ein/Aus-Button Feed deaktivieren, um den Feed zu deaktivieren. Der Feed ist jetzt mit Archiviert gekennzeichnet.
Datenwiederherstellung beim Reaktivieren von Feeds (Backfill-Fähigkeit)
Ob Google SecOps Daten nachträglich einfügen kann, hängt davon ab, ob Ihr Feed pull-basiert (unterstützt) oder push-basiert (nicht unterstützt) ist.
Pull-basierte Feeds
Über diese Feeds ruft Google SecOps Daten aus externen Quellen ab. Pull-Feeds umfassen:
- Cloud-Speicher-Buckets wie Amazon S3, Google Cloud Storage oder Azure Blob Storage
- SFTP-Server
Drittanbieter-APIs wie Microsoft 365, Okta und Proofpoint
Wenn Sie Pull-basierte Feeds wieder aktivieren, kann Google SecOps Daten abrufen, die generiert wurden, als der Feed deaktiviert war.
Push-basierte Feeds
Mit diesen Feeds werden Daten aus externen Systemen an Google SecOps „übertragen“. Push-Feeds umfassen:
- HTTPS-Webhooks
- Google Cloud Pub/Sub
- Amazon Kinesis Data Firehose
- Direkte API-/Agent-Aufnahmen, z. B. Bindplane
Google SecOps kann das Backfilling von Daten aus Push-basierten Feeds nicht automatisch starten. Wenn der Feed deaktiviert ist und Ihr System Daten sendet, gibt Google SecOps entweder einen HTTP 403 Forbidden-Fehler oder einen generischen 4xx-Fehler zurück.
Wenn Ihr System die Daten nicht speichert und den Sendevorgang an Google SecOps nicht wiederholt, gehen die Daten verloren. Wenn Ihr System außerdem so eingestellt ist, dass Daten bei einem Fehler verworfen oder der Puffer geleert wird, gehen die Daten für den entsprechenden Zeitraum dauerhaft verloren. Um Datenverlust zu vermeiden, sollten Sie Ihr System so konfigurieren, dass Daten gepuffert und noch einmal gesendet werden, sobald ein Feed wieder aktiviert wird. Google SecOps kann die fehlenden Daten dann aufnehmen, wenn der Feed fortgesetzt wird.
Hinweise zu Backfill
- Beschränkungen des Quellsystems:Die Menge an Verlaufsdaten, die Google SecOps aus Pull-basierten Feeds ergänzen kann, wird dadurch begrenzt, wie lange das Quellsystem die Daten speichert und was seine API zulässt. Einige APIs bieten beispielsweise nur Zugriff auf Daten der letzten sieben Tage.
- Google SecOps-Puffer:Für die automatische Wiederherstellung werden Daten für Pull-basierte Feeds im internen Puffer von Google SecOps bis zu 90 Tage lang gespeichert. Danach werden sie gelöscht.
- Mandanteneinschränkungen:Bei nicht zahlenden Mandanten, z. B. bei Proof-of-Concept-Mandanten, kann es Einschränkungen beim Backfilling älterer Daten geben.
- Aufnahmekontingente:Um die Echtzeit-Datenaufnahme nicht zu beeinträchtigen, werden Backfill-Daten mit einer niedrigeren Priorität als Live-Daten verarbeitet. Das Pull-basierte Daten-Backfill ist ebenfalls ratenbeschränkt, in der Regel auf ein Drittel (33%) des Burst-Limits Ihres Mandanten pro Protokolltyp. So wird sichergestellt, dass wichtige Push-basierte Feeds wie EDR-Agents nicht negativ beeinträchtigt werden.
- Dynamische Ratenbegrenzung:Wenn beim Backfill das gesamte verfügbare Pull-Kontingent aufgebraucht wird, wird die Aufnahme für den Rest des Fünf-Minuten-Intervalls pausiert und automatisch fortgesetzt, wenn das Intervall neu beginnt.
- Cloud-Speicher:Mit den Feedeinstellungen können Sie das Backfilling steuern, z. B. mit Filtern für neue oder aktualisierte Dateien oder mit Datumsbereichsfiltern wie „Maximales Dateialter“.
- Große Backlogs:Wenn ein großer Backlog aus einem Pull-basierten Feed beim Reaktivieren Probleme verursacht, können Sie sich an den Google-Support wenden, um den Backlog zu löschen. Das bedeutet, dass im Feed ab sofort nur noch neue Daten aufgenommen werden und die fehlenden Daten nicht nachgetragen werden.
- Bearbeiten deaktivierter Feeds:Alle Konfigurationsänderungen, die an einem Feed vorgenommen werden, während er deaktiviert ist, werden angewendet, sobald der Feed wieder aktiviert wird.
Feeds löschen
Auf der Seite Feeds können Sie auch einen vorhandenen Feed löschen:
Bewegen Sie den Mauszeiger auf einen vorhandenen Feed und klicken Sie in der rechten Spalte auf das Dreipunkt-Menü more_vert.
Klicken Sie auf Feed löschen. Das Fenster FEED LÖSCHEN wird geöffnet. Wenn Sie den Feed endgültig löschen möchten, klicken Sie auf Ja, löschen.
Bei benutzerdefinierten API-Feeds wird ein Dialogfeld mit einem optionalen Kästchen angezeigt: Ausstehende Backlog-Daten löschen:
- Nicht aktiviert (Standard): Die Feedkonfiguration und die Anmeldedaten werden gelöscht, aber in der Warteschlange befindliche Backlog-Daten können bis zur Aufnahme verarbeitet werden.
- Aktiviert:Die Feedkonfiguration, die Anmeldedaten und alle ausstehenden Backlog-Daten werden endgültig entfernt.
Aufnahmerate steuern
Wenn die Datenaufnahmerate für einen Mandanten einen bestimmten Schwellenwert erreicht, wird die Aufnahmerate für neue Datenfeeds in Google Security Operations eingeschränkt, um zu verhindern, dass sich eine Quelle mit einer hohen Aufnahmerate auf die Aufnahmerate einer anderen Datenquelle auswirkt. In diesem Fall kommt es zu einer Verzögerung, aber es gehen keine Daten verloren. Der Schwellenwert wird durch das Aufnahmevolumen und den Nutzungsverlauf des Mandanten bestimmt.
Sie können eine Erhöhung der Ratenbegrenzung anfordern, indem Sie sich an Cloud Customer Care wenden.
Fehlerbehebung bei fehlgeschlagenen Feeds
Auf der Seite Feeds können Sie Details wie Quellentyp, Logtyp, Feed-ID und Status der vorhandenen Feeds ansehen:
Bewegen Sie den Mauszeiger auf einen vorhandenen Feed und klicken Sie in der rechten Spalte auf das Dreipunkt-Menü more_vert.
Klicken Sie auf Feed ansehen. Ein Dialogfeld mit den Feeddetails wird angezeigt. Bei einem fehlgeschlagenen Feed finden Sie Fehlerdetails unter Details > Status.
Bei einem fehlgeschlagenen Feed sind in den Details die Ursache des Fehlers und Schritte zur Behebung des Problems enthalten.
In der Tabelle Quell- und Erfassungsfehler finden Sie Fehlermeldungen, die beim Arbeiten mit Datenfeeds auftreten können.
Für eine detaillierte Analyse und Fehlerbehebung von Feedaktivitäten können Sie Logs in Cloud Logging ansehen. Weitere Informationen finden Sie unter Feedaktivität mit Cloud Logging analysieren.
Benötigen Sie weitere Hilfe? Antworten von Community-Mitgliedern und Google SecOps-Experten erhalten