


本頁面介紹 Gemini Enterprise 的「搜尋並回答及後續追蹤」功能,並說明如何使用方法呼叫實作。
「搜尋答案」和「後續問題」功能採用回答方法。answer 方法也提供一些重要的額外功能,例如處理複雜查詢。
回答方式的特色
answer 方法的主要功能如下:
生成複雜查詢的答案。舉例來說,answer 方法可以將複合查詢 (例如以下查詢) 拆解成多個較小的查詢,傳回更準確的結果,進而提供更優質的答案:
- 「Google Cloud 和 Google Ads 在 2024 年的收益分別是多少?」
- 「Google 成立幾年後,收益達到 10 億美元?」
在多輪對話中,透過在每輪對話呼叫 answer 方法,結合搜尋和答案生成功能。
可與搜尋方法配對,縮短搜尋延遲時間。您可以分別呼叫搜尋方法和解答方法,並在不同時間,於不同 iframe 中算繪搜尋結果和解答。也就是說,您可以在幾毫秒內向使用者顯示搜尋結果 (10 個藍色連結)。您不必等到系統生成答案,就能顯示搜尋結果。
回答和後續問題的功能可分為查詢、搜尋和回答三個階段:
回答和搜尋功能的適用時機
Gemini Enterprise 有兩種方法可用於查詢應用程式。兩者功能不同,但有部分重疊。
在下列情況下,請使用 answer 方法:
您希望取得 AI 生成的搜尋結果答案 (或摘要)。
您想要多輪搜尋,也就是保留內容的搜尋,可供後續提問。
在下列情況下,請使用 search 方法:
您只需要搜尋結果,不需要生成的答案。
您希望系統傳回超過十個搜尋結果 (「藍色連結」)。
您具備下列任一條件:
- 自備嵌入
- 同義詞或重新導向控制項
- facet
- 使用者國家/地區代碼
在下列情況下,請同時使用回答和搜尋方法:
您希望傳回超過十筆搜尋結果,「且」希望取得生成的答案。
您有延遲問題,且希望在系統傳回生成的答案前,先傳回並顯示搜尋結果。
查詢階段功能
「答案和後續問題」功能支援自然語言查詢處理。
本節將說明並圖解查詢改寫和分類的各種選項。
重新措辭查詢
查詢重述功能預設為開啟。這項功能會自動選擇最佳方式改寫查詢,提升搜尋結果品質。這項功能也能處理不需要重新措辭的查詢。
將複雜查詢拆解為多項查詢,並執行同步子查詢。
例如:將複雜查詢拆解成四個較簡單的查詢。
使用者輸入內容 從複雜查詢建立的子查詢 Andie Ram 和 Arnaud Clément 有哪些共同的職業和興趣? - Andie Ram 職業
- Arnaud Clément 職業
- Andie Ram 嗜好
- Arnaud Clément 嗜好
彙整多輪查詢,讓後續問題能考量上下文和狀態。
例如,根據使用者在每個回合輸入的內容合成的查詢可能如下所示:
使用者輸入內容 已統整查詢 Turn 1: laptops for school 上學用筆電 第 2 輪:不是 mac 學校適用的筆記型電腦 (非 Mac) Turn 3: bigger screen and i also need wireless keyboard and mouse 學校用大螢幕筆電,非 Mac,附無線鍵盤和滑鼠 第 4 輪:和一個背包 學校用的筆電,螢幕要大一點,不要 Mac,要有無線鍵盤和滑鼠,還要能裝筆電的背包 簡化冗長的查詢,提升檢索成效。
例如:將冗長的查詢縮短為簡單的查詢。
使用者輸入內容 查詢簡化 我們網站上的「加入購物車」按鈕無法正常運作,我想找出原因。使用者點選按鈕後,商品似乎不會加入購物車,而且會收到錯誤訊息。我檢查了程式碼,看起來正確無誤,因此不確定問題出在哪裡。可以幫我排解這個問題嗎? 網站上的「加入購物車」按鈕無法運作。 執行多步驟推論
多步驟推論是以 ReAct (推論 + 行動) 範式為基礎,可讓 LLM 使用自然語言推論解決複雜工作。預設最多可有五個步驟。
例如:
使用者輸入內容 生成答案的兩個步驟 Google 創立幾年後,收益達到 10 億美元? 步驟 1:
[想法]:我需要知道 Google 的成立時間,才能查詢自那時起的收益。
[Act] Search: When was Google founded?[Observe Search Results]: "1998"
Step 2:
[Thought]: Now I need to Google's yearly revenue since 1998, and find out when it exceeded 1 billion for the first time.
[Act] Search: Google revenue since 1998
[Observe Search Results] Google revenue in 1998, Google revenue in 1999…..
[Answer]: Google reached more than 1 billion USD revenue in 2003 [1], 5 years after its founding in 1998[2].
查詢分類
查詢分類選項可識別惡意查詢和非尋求答案的查詢。根據預設,查詢分類選項會關閉。
如要進一步瞭解對抗性查詢和非尋求答案的查詢,請參閱「忽略對抗性查詢」和「忽略非尋求摘要的查詢」。
搜尋階段功能
在搜尋方面,answer 方法的選項與 search 方法相同。例如:
套用篩選器,將搜尋範圍限定在特定文件。詳情請參閱「篩選結構化或非結構化資料的自訂搜尋結果」。
指定提升條件,提高或降低搜尋傳回文件的排名。詳情請參閱「提高搜尋結果排名」。
回答階段功能
在回答階段,系統會根據搜尋結果生成答案,您可以啟用與搜尋方法相同的各項功能。例如:
取得引用資料,指出答案中每個句子的來源。詳情請參閱「加入引用內容」。
使用前導提示,自訂答案的語氣、樣式和詳細程度等。詳情請參閱「指定自訂前言」。
選擇要用於生成答案的模型。詳情請參閱「答案生成模型版本和生命週期」。
選擇是否忽略已歸類為對抗性或非尋求答案的查詢。
如要進一步瞭解對抗性查詢和非尋求答案的查詢,請參閱「忽略對抗性查詢」和「忽略非尋求摘要的查詢」。非尋求答案的查詢也稱為非尋求摘要的查詢。
搜尋方法不支援的其他答案階段功能包括:
取得每項主張 (生成答案中的句子) 的支援分數。 支援分數是介於 0 到 1 之間的浮點值,表示資料儲存庫中的資料對主張的支持程度。詳情請參閱「傳回基準支援分數」。
取得答案的匯總支援分數。支援分數代表答案與資料儲存庫中資料的關聯程度。詳情請參閱「傳回基準支援分數」。
只傳回有充分依據的答案。您可以選擇只傳回符合特定支援分數門檻的答案。詳情請參閱「僅顯示有充分依據的答案」。
在查詢中加入個人化資訊,讓系統為個別使用者提供客製化答案。詳情請參閱「個人化回覆」。
如要取得多模態回覆 (除了文字外,還包含圖表或圖片),可使用下列選項:
取得的回覆包含圖表,可繪製回覆中的資料。詳情請參閱「生成答案圖表」。
從資料儲存庫擷取圖片。如果資料儲存庫包含圖片,答案方法可以在答案中傳回圖片。如果要求提供引文,也可以在參照中傳回資料儲存空間中的圖片。詳情請參閱「從資料儲存空間擷取現有圖片」。
搜尋及回答 (基本)
下列指令說明如何呼叫 answer 方法,並傳回生成的答案和搜尋結果清單,以及來源連結。
這個指令只會顯示必要輸入內容。其餘選項則保留預設值。
REST
如要搜尋並取得生成的答案,請按照下列步驟操作:
執行下列 curl 指令:
curl -X POST -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://discoveryengine.googleapis.com/v1/projects/PROJECT_ID/locations/global/collections/default_collection/engines/APP_ID/servingConfigs/default_search:answer" \
  -d '{
        "query": { "text": "QUERY"}
      }'
更改下列內容:
PROJECT_ID:專案的 ID。APP_ID:要查詢的應用程式 ID。QUERY:包含問題或搜尋查詢的任意文字字串。例如「比較 BigQuery 和 Spanner 資料庫」。
Python
在試用這個範例之前,請先按照「使用用戶端程式庫的 Gemini Enterprise 快速入門導覽課程」中的 Python 設定說明操作。詳情請參閱 Gemini Enterprise Python API 參考文件。
如要向 Gemini Enterprise 進行驗證,請設定應用程式預設憑證。 詳情請參閱「為本機開發環境設定驗證機制」。
查詢階段指令
本節說明如何為 answer 方法呼叫的查詢階段指定選項。
搜尋並回答 (已停用重述功能)
下列指令說明如何呼叫 answer 方法,並傳回生成的答案和搜尋結果清單。由於換句話說選項已停用,答案可能與前一個答案不同。
REST
如要搜尋並取得生成式答案,但不套用查詢重述,請按照下列步驟操作:
執行下列 curl 指令:
curl -X POST -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://discoveryengine.googleapis.com/v1/projects/PROJECT_ID/locations/global/collections/default_collection/engines/APP_ID/servingConfigs/default_search:answer" \
  -d '{
        "query": { "text": "QUERY"},
        "queryUnderstandingSpec": {
           "queryRephraserSpec": {
              "disable": true
        }
    }
      }'
更改下列內容:
PROJECT_ID:專案的 ID。APP_ID:應用程式 ID。QUERY:包含問題或搜尋查詢的自由文字字串。例如「比較 BigQuery 和 Spanner 資料庫」。
Python
在試用這個範例之前,請先按照「使用用戶端程式庫的 Gemini Enterprise 快速入門導覽課程」中的 Python 設定說明操作。詳情請參閱「Gemini Enterprise Python API 參考文件」。
如要向 Gemini Enterprise 進行驗證,請設定應用程式預設憑證。詳情請參閱「為本機開發環境設定驗證機制」。
搜尋並回答 (指定步驟上限)
下列指令說明如何呼叫 answer 方法,並傳回生成的答案和搜尋結果清單。答案與先前的答案不同,因為重新措辭的步驟數量已增加。
REST
如要搜尋並取得生成式答案,最多可重新措辭五次,請按照下列步驟操作:
執行下列 curl 指令:
curl -X POST -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://discoveryengine.googleapis.com/v1/projects/PROJECT_ID/locations/global/collections/default_collection/engines/APP_ID/servingConfigs/default_search:answer" \
  -d '{
        "query": { "text": "QUERY"},
        "queryUnderstandingSpec": {
            "queryRephraserSpec": {
                "maxRephraseSteps": MAX_REPHRASE
             }
         }
      }'
更改下列內容:
PROJECT_ID:專案的 ID。APP_ID:要查詢的應用程式 ID。QUERY:包含問題或搜尋查詢的自由文字字串。例如:「比較 BigQuery 和 Spanner 資料庫」。MAX_REPHRASE:改寫步驟數量上限。允許的最大值為5。 如未設定或設定的值小於1,則會採用預設值1。
Python
在試用這個範例之前,請先按照「使用用戶端程式庫的 Gemini Enterprise 快速入門導覽課程」中的 Python 設定說明操作。詳情請參閱「Gemini Enterprise Python API 參考文件」。
如要向 Gemini Enterprise 進行驗證,請設定應用程式預設憑證。 詳情請參閱「為本機開發環境設定驗證機制」。
使用查詢分類功能搜尋及回答
下列指令說明如何呼叫 answer 方法,查詢查詢是否為對抗性、非尋求答案或兩者皆非。
回覆會包含查詢的分類類型,但答案本身不受分類影響。如要根據查詢類型變更回答行為,可以在回答階段執行這項操作。請參閱「忽略對抗性查詢」和「忽略非摘要查詢」。
REST
如要判斷查詢是否為對抗性或非尋求答案,請按照下列步驟操作:
執行下列 curl 指令:
curl -X POST -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://discoveryengine.googleapis.com/v1/projects/PROJECT_ID/locations/global/collections/default_collection/engines/APP_ID/servingConfigs/default_search:answer" \
  -d '{
        "query": { "text": "QUERY"},
        "queryUnderstandingSpec": {
            "queryClassificationSpec": {
                "types": ["QUERY_CLASSIFICATION_TYPE"]
             }
         }
      }'
更改下列內容:
PROJECT_ID:專案的 ID。APP_ID:要查詢的應用程式 ID。QUERY:包含問題或搜尋查詢的自由文字字串。例如「hello」。QUERY_CLASSIFICATION_TYPE:要識別的查詢類型:ADVERSARIAL_QUERY、NON_ANSWER_SEEKING_QUERY或兩者。
Python
在試用這個範例之前,請先按照「使用用戶端程式庫的 Gemini Enterprise 快速入門導覽課程」中的 Python 設定說明操作。詳情請參閱「Gemini Enterprise Python API 參考文件」。
如要向 Gemini Enterprise 進行驗證,請設定應用程式預設憑證。 詳情請參閱「為本機開發環境設定驗證機制」。
搜尋階段指令:搜尋並回答,附帶搜尋結果選項
本節說明如何為 answer 方法呼叫的搜尋階段部分指定選項,例如設定傳回的文件數量上限、提升和篩選,以及如何在提供自己的搜尋結果時取得答案。
下列指令說明如何呼叫 answer 方法,並指定搜尋結果傳回方式的各種選項。(搜尋結果與答案無關)。
REST
如要設定各種選項,決定要傳回哪些搜尋結果及傳回方式,請按照下列步驟操作:
執行下列 curl 指令:
curl -X POST -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://discoveryengine.googleapis.com/v1/projects/PROJECT_ID/locations/global/collections/default_collection/engines/APP_ID/servingConfigs/default_search:answer" \
  -d '{
        "query": { "text": "QUERY"},
          "searchSpec": {
          "searchParams": {
            "maxReturnResults": MAX_RETURN_RESULTS,
            "filter": "FILTER",
            "boostSpec": BOOST_SPEC,
            "orderBy": "ORDER_BY",
            "searchResultMode": SEARCH_RESULT_MODE
           }
         }
      }'
更改下列內容:
PROJECT_ID:專案的 ID。APP_ID:要查詢的應用程式 ID。QUERY:包含問題或搜尋查詢的任意文字字串。例如:「比較 BigQuery 和 Spanner 資料庫?」MAX_RETURN_RESULTS:要傳回的搜尋結果數量。預設值為 10。FILTER:篩選條件會指定要查詢的文件。如果文件的中繼資料符合篩選器規格,系統就會查詢該文件。如需更多資訊 (包括篩選器語法),請參閱「篩選結構化或非結構化資料的自訂搜尋」。BOOST_SPEC:提升規格可讓您在搜尋結果中提升特定文件,這可能會影響答案。如要進一步瞭解提升規格的語法等資訊,請參閱「提升搜尋結果」。ORDER_BY:傳回文件的順序。文件可以依 Document 物件中的欄位排序。orderBy運算式須區分大小寫。 如果無法辨識這個欄位,系統會傳回INVALID_ARGUMENT。SEARCH_RESULT_MODE:指定搜尋結果模式,可以是DOCUMENTS或CHUNKS。詳情請參閱「剖析及分塊文件」和「ContentSearchSpec」。這個欄位僅適用於 API 的 v1alpha 版本。
Python
在試用這個範例之前,請先按照「使用用戶端程式庫的 Gemini Enterprise 快速入門導覽課程」中的 Python 設定說明操作。詳情請參閱「Gemini Enterprise Python API 參考文件」。
如要向 Gemini Enterprise 進行驗證,請設定應用程式預設憑證。詳情請參閱「為本機開發環境設定驗證機制」。
回答階段指令
本節說明如何自訂 answer 方法呼叫。您可以視需要結合下列選項。
忽略對抗查詢和非尋求答案的查詢
下列指令說明如何在呼叫 answer 方法時,避免回答對抗性查詢和非尋求答案的查詢。
REST
如要略過回答對抗性或非尋求答案的查詢,請按照下列步驟操作:
執行下列 curl 指令:
curl -X POST -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://discoveryengine.googleapis.com/v1/projects/PROJECT_ID/locations/global/collections/default_collection/engines/APP_ID/servingConfigs/default_search:answer" \
  -d '{
        "query": { "text": "QUERY"},
        "answerGenerationSpec": {
           "ignoreAdversarialQuery": true,
           "ignoreNonAnswerSeekingQuery": true
        }
      }'
更改下列內容:
PROJECT_ID:專案的 ID。APP_ID:要查詢的應用程式 ID。QUERY:包含問題或搜尋查詢的自由文字字串。
Python
在試用這個範例之前,請先按照「使用用戶端程式庫的 Gemini Enterprise 快速入門導覽課程」中的 Python 設定說明操作。詳情請參閱 Gemini Enterprise Python API 參考文件。
如要向 Gemini Enterprise 進行驗證,請設定應用程式預設憑證。詳情請參閱「為本機開發環境設定驗證機制」。
只顯示相關答案
Gemini Enterprise 可評估結果與查詢的關聯性。如果系統判定沒有足夠相關的結果,您可以選擇傳回備用答案「We do not have a summary for your query.」,而不是從不相關或相關性極低的結果生成答案。
下列指令說明如何在呼叫 answer 方法時,傳回不相關結果的備用答案。
REST
如要傳回備用答案 (找不到相關結果時),請執行下列操作:
執行下列 curl 指令:
curl -X POST -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://discoveryengine.googleapis.com/v1/projects/PROJECT_ID/locations/global/collections/default_collection/engines/APP_ID/servingConfigs/default_search:answer" \
  -d '{
        "query": { "text": "QUERY"},
        "answerGenerationSpec": {
           "ignoreLowRelevantContent": true
        }
      }'
更改下列內容:
PROJECT_ID:專案的 ID。APP_ID:要查詢的應用程式 ID。QUERY:包含問題或搜尋查詢的自由文字字串。
Python
在試用這個範例之前,請先按照「使用用戶端程式庫的 Gemini Enterprise 快速入門導覽課程」中的 Python 設定說明操作。詳情請參閱 Gemini Enterprise Python API 參考文件。
如要向 Gemini Enterprise 進行驗證,請設定應用程式預設憑證。詳情請參閱「為本機開發環境設定驗證機制」。
傳回基準支援分數
下列指令說明如何傳回答案和論述的基準支援分數。
REST
如要傳回每項主張 (答案中的句子) 的支援分數,以及答案的匯總支援分數,請按照下列步驟操作:
執行下列 curl 指令:
curl -X POST -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://discoveryengine.googleapis.com/v1/projects/PROJECT_ID/locations/global/collections/default_collection/engines/APP_ID/servingConfigs/default_search:answer" \
  -d '{
        "query": { "text": "QUERY"},
        "groundingSpec": {
           "includeGroundingSupports": true,
        }
      }'
更改下列內容:
PROJECT_ID:專案的 ID。APP_ID:要查詢的應用程式 ID。QUERY:包含問題或搜尋查詢的自由文字字串。
僅顯示有充分依據的答案
下列指令說明如何只傳回在語料庫 (資料儲存庫中的資訊) 中有充分根據的答案。系統會篩除依據不足的答案。
您可以選擇低或高層級的基礎支援分數門檻。然後,只有在答案達到或超過該等級時,才會傳回。您可以實驗這兩種篩選器門檻,以及不設門檻的情況,判斷哪種篩選器等級最有可能為使用者提供最佳結果。
REST
如要只傳回符合支援分數門檻的答案,請按照下列步驟操作:
執行下列 curl 指令:
curl -X POST -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://discoveryengine.googleapis.com/v1/projects/PROJECT_ID/locations/global/collections/default_collection/engines/APP_ID/servingConfigs/default_search:answer" \
  -d '{
        "query": { "text": "QUERY"},
        "groundingSpec": {
           "filteringLevel": "FILTER_LEVEL"
        }
      }'
更改下列內容:
PROJECT_ID:專案的 ID。APP_ID:要查詢的應用程式 ID。QUERY:包含問題或搜尋查詢的任意文字字串。FILTER_LEVEL:根據基準支援分數篩選答案的列舉。選項包括:FILTERING_LEVEL_LOW和FILTERING_LEVEL_HIGH。如果未納入filteringLevel,系統就不會對答案套用支援分數篩選器。
指定答案模型
下列指令說明如何變更用於生成答案的模型版本。
如要瞭解支援的機型,請參閱「答案生成模型版本和生命週期」。
REST
如要使用預設模型以外的模型生成答案,請按照下列步驟操作:
執行下列 curl 指令:
curl -X POST -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://discoveryengine.googleapis.com/v1/projects/PROJECT_ID/locations/global/collections/default_collection/engines/APP_ID/servingConfigs/default_search:answer" \
  -d '{
        "query": { "text": "QUERY"},
        "answerGenerationSpec": {
           "modelSpec": {
              "modelVersion": "MODEL_VERSION",
           }
         }
      }'
更改下列內容:
PROJECT_ID:專案的 ID。APP_ID:要查詢的應用程式 ID。QUERY:包含問題或搜尋查詢的任意文字字串。MODEL_VERSION:用於生成答案的模型版本。詳情請參閱「答案生成模型版本和生命週期」。
Python
在試用這個範例之前,請先按照「使用用戶端程式庫的 Gemini Enterprise 快速入門導覽課程」中的 Python 設定說明操作。詳情請參閱 Gemini Enterprise Python API 參考文件。
如要向 Gemini Enterprise 進行驗證,請設定應用程式預設憑證。詳情請參閱「為本機開發環境設定驗證機制」。
指定自訂前序
下列指令說明如何為生成的答案設定前導提示。前導提示包含自然語言指令,可用來自訂答案。你可以要求自訂長度、詳細程度、輸出風格 (例如「簡單」)、輸出語言、答案重點和格式 (例如表格、項目符號和 XML)。舉例來說,前導提示可以是「用十歲小孩的口吻解釋」。
前導提示可能會對生成的答案品質造成重大影響。如要瞭解前言的撰寫方式和前言範例,請參閱「關於自訂前言」。
REST
如要使用預設模型以外的模型生成回覆,請按照下列步驟操作:
執行下列 curl 指令:
curl -X POST -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://discoveryengine.googleapis.com/v1/projects/PROJECT_ID/locations/global/collections/default_collection/engines/APP_ID/servingConfigs/default_search:answer" \
  -d '{
        "query": { "text": "QUERY"},
        "answerGenerationSpec": {
           "promptSpec": {
               "preamble": "PREAMBLE",
           }
        }
      }'
更改下列內容:
PROJECT_ID:專案的 ID。APP_ID:要查詢的應用程式 ID。QUERY:包含問題或搜尋查詢的自由文字字串。PREAMBLE:以自然語言提供指示,自訂回覆內容。例如,嘗試show the answer format in an ordered list或give a very detailed answer。
Python
在試用這個範例之前,請先按照「使用用戶端程式庫的 Gemini Enterprise 快速入門導覽課程」中的 Python 設定說明操作。詳情請參閱 Gemini Enterprise Python API 參考文件。
如要向 Gemini Enterprise 進行驗證,請設定應用程式預設憑證。詳情請參閱「為本機開發環境設定驗證機制」。
加入引用內容
下列指令說明如何要求在回覆中加入引用來源。
REST
如要使用預設模型以外的模型生成答案,請按照下列步驟操作:
執行下列 curl 指令:
curl -X POST -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://discoveryengine.googleapis.com/v1/projects/PROJECT_ID/locations/global/collections/default_collection/engines/APP_ID/servingConfigs/default_search:answer" \
  -d '{
        "query": { "text": "QUERY"},
        "answerGenerationSpec": {
           "includeCitations": INCLUDE_CITATIONS
        }
      }'
更改下列內容:
PROJECT_ID:專案的 ID。APP_ID:要查詢的應用程式 ID。QUERY:包含問題或搜尋查詢的自由文字字串。INCLUDE_CITATIONS:指定是否要在答案中加入引用中繼資料。預設值為false。
Python
在試用這個範例之前,請先按照「使用用戶端程式庫的 Gemini Enterprise 快速入門導覽課程」中的 Python 設定說明操作。詳情請參閱 Gemini Enterprise Python API 參考文件。
如要向 Gemini Enterprise 進行驗證,請設定應用程式預設憑證。詳情請參閱「為本機開發環境設定驗證機制」。
設定答案語言代碼
下列指令說明如何設定答案的語言代碼。
REST
如要使用預設模型以外的模型生成答案,請按照下列步驟操作:
執行下列 curl 指令:
curl -X POST -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://discoveryengine.googleapis.com/v1/projects/PROJECT_ID/locations/global/collections/default_collection/engines/APP_ID/servingConfigs/default_search:answer" \
  -d '{
        "query": { "text": "QUERY"},
        "answerGenerationSpec": {
           "answerLanguageCode": "ANSWER_LANGUAGE_CODE"
           }
      }'
更改下列內容:
PROJECT_ID:專案的 ID。APP_ID:要查詢的應用程式 ID。QUERY:包含問題或搜尋查詢的任意文字字串。ANSWER_LANGUAGE_CODE:答案的語言代碼。請使用 BCP47:語言辨識標記中定義的語言標記。
Python
在試用這個範例之前,請先按照「使用用戶端程式庫的 Gemini Enterprise 快速入門導覽課程」中的 Python 設定說明操作。詳情請參閱 Gemini Enterprise Python API 參考文件。
如要向 Gemini Enterprise 進行驗證,請設定應用程式預設憑證。詳情請參閱「為本機開發環境設定驗證機制」。
個人化答案
如果有使用者的特定資訊 (例如設定檔中的資料),您可以在 endUserMetadata 物件中指定該資訊,以便為使用者提供個人化的查詢結果。
舉例來說,如果使用者搜尋升級手機的相關資訊,系統會根據個人資料中的資訊 (例如目前的手機型號和行動網路方案),提供個人化的生成回覆。
如要新增查詢者的個人資訊,並生成考量個人資訊的回覆,請按照下列步驟操作:
執行下列 curl 指令:
curl -X POST -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://discoveryengine.googleapis.com/v1/projects/PROJECT_ID/locations/global/collections/default_collection/engines/APP_ID/servingConfigs/default_search:answer" \
-d '{
    "query": { "text": "QUERY"},
    "endUserSpec": {
       "endUserMetadata": [
         {
           "chunkInfo": {
              "content": "PERSONALIZED_INFO",
              "documentMetadata":  { "title": "INFO_DESCRIPTION"}
           }
         }
       ]
    }
  }'
更改下列內容:
PROJECT_ID:專案的 ID。APP_ID:要查詢的應用程式 ID。QUERY:包含問題或搜尋查詢的自由文字字串。PERSONALIZATION_INFO:這個字串包含查詢使用者的專屬資訊。例如This customer has a Pixel 6 Pro purchased over a period of 24-months starting 2023-01-15. This customer is on the Business Plus International plan. No payment is due at this time.。這個字串的長度上限為 8,000 個字元。INFO_DESCRIPTION:簡短說明個人化資訊的字串,例如Customer profile data, including model, plan, and billing status.。模型會同時使用這項說明和個人化資訊,生成查詢的自訂答案。
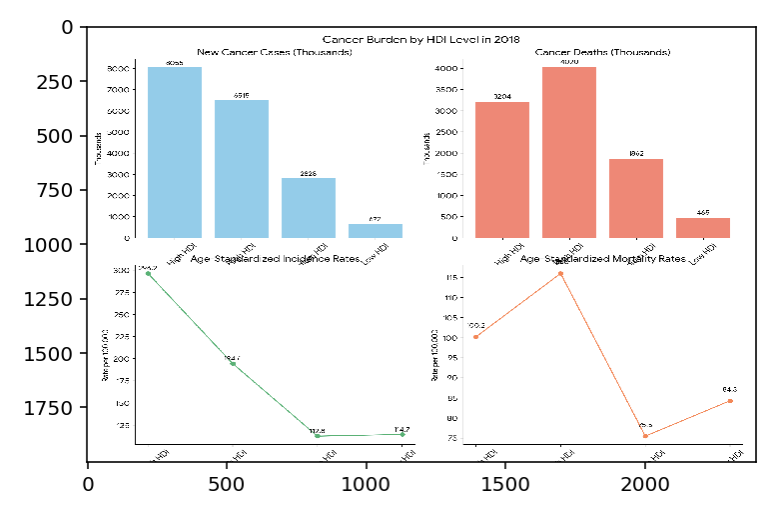
為答案生成圖表
answer 方法可以生成圖表,並在查詢回覆中傳回。
您可以特別要求答案包含圖表,例如「根據可用資料,繪製小型企業付款的年增率圖表」。如果系統判定資料充足,就會傳回圖表。通常會傳回一些答案文字和圖表。
此外,如果資料量足以建立圖表,即使查詢未明確要求圖表,答案方法仍可傳回圖表。例如:「在 2010 年到 2020 年這十年間,乾淨飲用水取得管道增加,與人類發展指數分數提升有何關聯?」
每個答案只會生成一個圖表。不過,圖表可能是複合圖表,包含其他較小的圖表。複合圖表示例:
限制
查詢內容必須以英文輸入。
常見失敗情境
系統不一定會隨答案傳回圖片。如果資料不足,就無法產生圖表。
其他失敗情況包括程式碼執行失敗和逾時。如果發生上述任一情況,請改用其他字詞,然後再試一次。
事前準備
執行查詢要求生成圖表前,請先完成下列事項:
請確認您使用的是 Gemini 2.0 以上版本模型。如要瞭解模型,請參閱「答案生成模型版本和生命週期」。
如果非結構化資料儲存庫中的文件包含大量表格和圖片,請開啟「Layout parser」(版面配置剖析器)。雖然這並非絕對必要,但可以提供更優質的結果。
程序
REST
呼叫 answer 方法,如下所示,傳回的答案可包含根據資料儲存庫中的資料生成的圖表:
執行下列 curl 指令:
curl -X POST -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://discoveryengine.googleapis.com/v1beta/projects/PROJECT_ID/locations/global/collections/default_collection/engines/APP_ID/servingConfigs/default_search:answer" \
  -d '{
        "query": { "text": "QUERY"},
        "answerGenerationSpec": {
          "model_spec": {
             "model_version": "MODEL_VERSION"
         },
          "multimodalSpec": {
             "imageSource": "IMAGE_SOURCE"
             }
        }
      }'
更改下列內容:
PROJECT_ID:專案的 ID。APP_ID:要查詢的應用程式 ID。QUERY:以英文撰寫的自由格式字串,內含問題或搜尋查詢。MODEL_VERSION:模型版本stable或其他支援的模型,請參閱「答案生成模型版本和生命週期」。IMAGE_SOURCE:列舉,要求答案包含生成的圖表FIGURE_GENERATION_ONLY,或答案可包含生成的圖表或資料儲存庫中的現有圖片ALL_AVAILABLE_SOURCES。
從資料儲存庫擷取現有圖片
您可以選擇讓回覆和引用參考資料傳回資料儲存庫中的圖片。資料儲存庫必須是非結構化資料儲存庫,且已開啟版面配置剖析器。
如果 imageSource 為 CORPUS_IMAGE_ONLY 或 ALL_AVAILABLE_SOURCES,answer 方法會視情況從資料儲存庫擷取圖片。不過,開啟這項功能並不代表系統一律會傳回圖片。
每個答案最多可附一張圖片。引文可包含多張圖片。
限制
您使用的應用程式必須連結至非結構化資料儲存庫。圖片無法從網站或結構化資料儲存庫傳回。
查詢內容必須以英文輸入。
透過版面配置剖析器進行的圖片註解必須套用至資料儲存庫。如要瞭解版面配置剖析器,請參閱「剖析及分塊文件」。
程序
REST
呼叫 answer 方法,傳回可包含資料儲存庫圖片的答案:
執行下列 curl 指令:
curl -X POST -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://discoveryengine.googleapis.com/v1beta/projects/PROJECT_ID/locations/global/collections/default_collection/engines/APP_ID/servingConfigs/default_search:answer" \
  -d '{
        "query": { "text": "QUERY"},
        "answerGenerationSpec": {
          "model_spec": {
             "model_version": "MODEL_VERSION"
          },
          includeCitations: true,
          "multimodalSpec": {
             "imageSource": "IMAGE_SOURCE"
             }
        }
      }'
更改下列內容:
PROJECT_ID:專案的 ID。APP_ID:要查詢的應用程式 ID。QUERY:以英文撰寫的自由格式字串,內含問題或搜尋查詢。MODEL_VERSION:模型版本stable或其他支援的模型,請參閱「答案生成模型版本和生命週期」。IMAGE_SOURCE:列舉,要求答案包含資料儲存庫中的圖片 (CORPUS_IMAGE_ONLY),或答案可包含資料儲存庫中的圖片或生成式圖表 (ALL_AVAILABLE_SOURCES)。
後續問題的指令
後續問題是多輪查詢。在後續工作階段中,系統會根據第一個查詢,以及先前的互動,此外,回答方法還會根據後續問題建議相關問題,使用者可以選擇這些問題,不必自行輸入後續問題。
上述各節提到的所有答案和後續問題功能,例如引用、篩選器、安全搜尋、忽略特定類型的查詢,以及使用前導提示自訂答案,都可以與後續問題搭配使用。
後續追蹤工作階段範例
以下是後續追蹤的對話範例。假設你想瞭解在墨西哥度假的相關資訊:
第 1 輪:
你:一年中什麼時候最適合去墨西哥度假?
回答並提供後續資訊:墨西哥的最佳旅遊時間是乾季,也就是 11 月到 4 月。
第 2 輪:
你:匯率是多少?
回答並提供後續資訊:1 美元約等於 17.65 墨西哥披索。
第 3 輪:
你:12 月的平均溫度是多少?
回答並提供後續資訊:平均溫度介於 70 至 78°F 之間。 坎昆的平均溫度約為 25°C。
如果沒有後續問題,系統就無法回答「匯率是多少?」這個問題,因為一般搜尋不會知道您想查詢墨西哥的匯率。同樣地,如果沒有後續追問,我們就無法取得提供墨西哥專屬溫度資訊所需的背景資訊。
相關問題範例
當你詢問「一年中什麼時候最適合到墨西哥度假?」時,除了回答你的問題,回答和後續問題還會建議你可能想問的其他問題,例如「到墨西哥度假最便宜的月份是哪幾個月?」和「墨西哥的旅遊旺季是哪幾個月?」。
啟用相關問題功能後,問題會以字串形式傳回。
關於工作階段
如要瞭解 Gemini Enterprise 中的後續追問功能,必須先瞭解工作階段。
工作階段是由使用者提供的文字查詢和 Gemini Enterprise 的回覆組成。
這類查詢和回覆組合有時稱為對話。在上述範例中,第二輪對話包含「匯率是多少?」和「1 美元約等於 17.65 墨西哥披索」。
工作階段會與應用程式一起儲存。在應用程式中,工作階段會以工作階段資源表示。
除了查詢和回應訊息外,工作階段資源還包含:
專屬名稱 (工作階段 ID)。
狀態 (進行中或已完成)。
使用者虛擬 ID,也就是追蹤使用者的訪客 ID。可以透過程式輔助方式指派。
開始時間和結束時間。
一輪對話,也就是查詢和答案的配對。
儲存工作階段資訊並取得回覆
您可以使用命令列產生搜尋回覆和答案,並將這些內容連同工作階段中的每項查詢儲存起來。
REST
如要使用指令列建立工作階段,並根據使用者輸入內容生成回覆,請按照下列步驟操作:
指定要儲存工作階段的應用程式:
curl -X POST \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://discoveryengine.googleapis.com/v1/projects/PROJECT_ID/locations/global/collections/default_collection/engines/APP_ID/sessions" \
  -d '{
        "userPseudoId": "USER_PSEUDO_ID"
      }'
更改下列內容:
PROJECT_ID:專案的 ID。APP_ID:應用程式 ID。USER_PSEUDO_ID:用來追蹤搜尋訪客的專屬 ID。舉例來說,您可以使用 HTTP Cookie 實作這項功能,在單一裝置上明確識別訪客。
指令與結果範例
curl -X POST -H "Authorization: Bearer $(gcloud auth print-access-token)"
-H "Content-Type: application/json"
"https://discoveryengine.googleapis.com/v1/projects/my-project-123/locations/global/collections/default_collection/engines/my-app/sessions"
-d '{
"userPseudoId": "test_user"
}'

{
  "name": "projects/123456/locations/global/collections/default_collection/engines/my-app/sessions/16002628354770206943",
  "state": "IN_PROGRESS",
  "userPseudoId": "test_user",
  "startTime": "2024-09-13T18:47:10.465311Z",
  "endTime": "2024-09-13T18:47:10.465311Z"
}
記下工作階段 ID,也就是 JSON 回應中
name:欄位結尾的數字。在範例結果中,ID 為5386462384953257772。下一個步驟會用到這個 ID。生成答案並新增至應用程式中的工作階段:
curl -X POST \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://discoveryengine.googleapis.com/v1/projects/PROJECT_ID/locations/global/collections/default_collection/engines/APP_ID/servingConfigs/default_search:answer" \
  -d '{
        "query": { "text": "QUERY"},
        "session": "projects/PROJECT_ID/locations/global/collections/default_collection/engines/APP_ID/sessions/SESSION_ID",
          "searchSpec":{ "searchParams": {"filter": "FILTER"} }
}'
更改下列內容:
PROJECT_ID:專案的 ID。APP_ID:應用程式 ID。QUERY:包含問題或搜尋查詢的任意文字字串。SESSION_ID:您在步驟 1 建立的工作階段 ID。這些是name:欄位結尾的數字,如步驟 2 所示。在一個工作階段中,每次輪流對話都使用相同的工作階段 ID。FILTER:文字欄位,用於透過篩選運算式篩選搜尋結果。預設值為空白字串。建構篩選條件的方式取決於您擁有的是含中繼資料的非結構化資料、結構化資料,還是網站資料。詳情請參閱「篩選結構化或非結構化資料的自訂搜尋」。
指令與結果範例
curl -X POST -H "Authorization: Bearer $(gcloud auth print-access-token)"
-H "Content-Type: application/json"
"https://discoveryengine.googleapis.com/v1/projects/my-project-123/locations/global/collections/default_collection/engines/my-app/servingConfigs/default_search:answer"
-d '{
"query": { "text": "Compare bigquery with spanner database?"},
"session":  "projects/123456/locations/global/collections/default_collection/engines/my-app/sessions/16002628354770206943",
}'

{
  "answer": {
    "name": "projects/123456/locations/global/collections/default_collection/engines/my-app/sessions/16002628354770206943/answers/4861507376861383072",
    "state": "SUCCEEDED",
    "answerText": "BigQuery and Spanner are both powerful tools that can be used together to handle transactional and analytical workloads. Spanner is a fully managed relational database optimized for transactional workloads, while BigQuery is a serverless data warehouse designed for business agility. Spanner provides seamless replication across regions in Google Cloud and processes over 1 billion requests per second at peak. BigQuery analyzes over 110 terabytes of data per second. Users can leverage federated queries to read data from Spanner and write to a native BigQuery table. \n",
    "steps": [
      {
        "state": "SUCCEEDED",
        "description": "Rephrase the query and search.",
        "actions": [
          {
            "searchAction": {
              "query": "Compare bigquery with spanner database?"
            },
            "observation": {
              "searchResults": [
                {
                  "document": "projects/123456/locations/global/collections/default_collection/dataStores/my-data-store/branches/0/documents/ecc0e7547253f4ca3ff3328ce89995af",
                  "uri": "https://cloud.google.com/blog/topics/developers-practitioners/how-spanner-and-bigquery-work-together-handle-transactional-and-analytical-workloads",
                  "title": "How Spanner and BigQuery work together to handle transactional and analytical workloads | Google Cloud Blog",
                  "snippetInfo": [
                    {
                      "snippet": "Using Cloud \u003cb\u003eSpanner\u003c/b\u003e and \u003cb\u003eBigQuery\u003c/b\u003e also allows customers to build their \u003cb\u003edata\u003c/b\u003e clouds using Google Cloud, a unified, open approach to \u003cb\u003edata\u003c/b\u003e-driven transformation ...",
                      "snippetStatus": "SUCCESS"
                    }
                  ]
                },
                {
                  "document": "projects/123456/locations/global/collections/default_collection/dataStores/my-data-store/branches/0/documents/d7e238f73608a860e00b752ef80e2941",
                  "uri": "https://cloud.google.com/blog/products/databases/cloud-spanner-gets-stronger-with-bigquery-federated-queries",
                  "title": "Cloud Spanner gets stronger with BigQuery-federated queries | Google Cloud Blog",
                  "snippetInfo": [
                    {
                      "snippet": "As enterprises compete for market share, their need for real-time insights has given rise to increased demand for transactional \u003cb\u003edatabases\u003c/b\u003e to support \u003cb\u003edata\u003c/b\u003e ...",
                      "snippetStatus": "SUCCESS"
                    }
                  ]
                },
                {
                  "document": "projects/123456/locations/global/collections/default_collection/dataStores/my-data-store/branches/0/documents/e10a5a3c267dc61579e7c00fefe656eb",
                  "uri": "https://cloud.google.com/blog/topics/developers-practitioners/replicating-cloud-spanner-bigquery-scale",
                  "title": "Replicating from Cloud Spanner to BigQuery at scale | Google Cloud Blog",
                  "snippetInfo": [
                    {
                      "snippet": "... \u003cb\u003eSpanner data\u003c/b\u003e into \u003cb\u003eBigQuery\u003c/b\u003e for analytics. In this post, you will learn how to efficiently use this feature to replicate large tables with high throughput ...",
                      "snippetStatus": "SUCCESS"
                    }
                  ]
                },
                ...
                {
                  "document": "projects/123456/locations/global/collections/default_collection/dataStores/my-data-store/branches/0/documents/8100ad36e1cac149eb9fc180a41d8f25",
                  "uri": "https://cloud.google.com/blog/products/gcp/from-nosql-to-new-sql-how-spanner-became-a-global-mission-critical-database",
                  "title": "How Spanner became a global, mission-critical database | Google Cloud Blog",
                  "snippetInfo": [
                    {
                      "snippet": "... SQL \u003cb\u003evs\u003c/b\u003e. NoSQL dichotomy may no longer be relevant." The \u003cb\u003eSpanner\u003c/b\u003e SQL query processor, while recognizable as a standard implementation, has unique ...",
                      "snippetStatus": "SUCCESS"
                    }
                  ]
                }
              ]
            }
          }
        ]
      }
    ]
  },
  "session": {
    "name": "projects/123456/locations/global/collections/default_collection/engines/my-app/sessions/16002628354770206943",
    "state": "IN_PROGRESS",
    "userPseudoId": "test_user",
    "turns": [
      {
        "query": {
          "queryId": "projects/123456/locations/global/questions/741830",
          "text": "Compare bigquery with spanner database?"
        },
        "answer": "projects/123456/locations/global/collections/default_collection/engines/my-app/sessions/16002628354770206943/answers/4861507376861383072"
      }
    ],
    "startTime": "2024-09-13T18:47:10.465311Z",
    "endTime": "2024-09-13T18:47:10.465311Z"
  },
  "answerQueryToken": "NMwKDAjFkpK3BhDU24uZAhIkNjZlNDIyZWYtMDAwMC0yMjVmLWIxMmQtZjQwMzA0M2FkYmNj"
}
針對工作階段中的每項新查詢,重複執行步驟 3。
Python
在試用這個範例之前,請先按照「使用用戶端程式庫的 Gemini Enterprise 快速入門導覽課程」中的 Python 設定說明操作。詳情請參閱「Gemini Enterprise Python API 參考文件」。
如要向 Gemini Enterprise 進行驗證,請設定應用程式預設憑證。詳情請參閱「為本機開發環境設定驗證機制」。
從資料儲存庫取得工作階段
下列指令說明如何呼叫 get 方法,並從資料儲存庫取得工作階段。
REST
如要從資料儲存庫取得工作階段,請按照下列步驟操作:
執行下列 curl 指令:
curl -X GET -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://discoveryengine.googleapis.com/v1/projects/PROJECT_ID/locations/global/collections/default_collection/engines/APP_ID/sessions/SESSION_ID"
更改下列內容:
PROJECT_ID:專案的 ID。APP_ID:應用程式 ID。SESSION_ID:要取得的工作階段 ID。
Python
在試用這個範例之前,請先按照「使用用戶端程式庫的 Gemini Enterprise 快速入門導覽課程」中的 Python 設定說明操作。詳情請參閱 Gemini Enterprise Python API 參考文件。
如要向 Gemini Enterprise 進行驗證,請設定應用程式預設憑證。 詳情請參閱「為本機開發環境設定驗證機制」。
從應用程式中刪除工作階段
下列指令說明如何呼叫 delete 方法,並從資料儲存庫中刪除工作階段。
根據預設,系統會自動刪除超過 60 天的記錄。 不過,如要刪除特定工作階段 (例如含有敏感內容),請使用這個 API 呼叫。
REST
如要從應用程式中刪除工作階段,請按照下列步驟操作:
執行下列 curl 指令:
curl -X DELETE -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://discoveryengine.googleapis.com/v1/projects/PROJECT_ID/locations/global/collections/default_collection/engines/APP_ID/sessions/SESSION_ID"
更改下列內容:
PROJECT_ID:專案的 ID。APP_ID:應用程式 ID。SESSION_ID:要刪除的工作階段 ID。
Python
在試用這個範例之前,請先按照「使用用戶端程式庫的 Gemini Enterprise 快速入門導覽課程」中的 Python 設定說明操作。詳情請參閱「Gemini Enterprise Python API 參考文件」。
如要向 Gemini Enterprise 進行驗證,請設定應用程式預設憑證。 詳情請參閱「為本機開發環境設定驗證機制」。
更新工作階段
您可能基於各種原因需要更新工作階段。例如,執行下列任一操作:
- 將工作階段標示為完成
- 將一個工作階段的訊息併入另一個工作階段
- 變更使用者的虛擬 ID
下列指令說明如何呼叫 patch 方法,並更新資料儲存庫中的工作階段。
REST
如要透過應用程式更新工作階段,請按照下列步驟操作:
執行下列 curl 指令:
curl -X PATCH \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://discoveryengine.googleapis.com/v1/projects/PROJECT_ID/locations/global/collections/default_collection/engines/APP_ID/sessions/SESSION_ID?updateMask=state" \
  -d '{
        "state": "NEW_STATE"
      }'
更改下列內容:
PROJECT_ID:專案的 ID。APP_ID:應用程式 ID。SESSION_ID:要更新的會期 ID。NEW_STATE:狀態的新值,例如IN_PROGRESS。
Python
在試用這個範例之前,請先按照「使用用戶端程式庫的 Gemini Enterprise 快速入門導覽課程」中的 Python 設定說明操作。詳情請參閱 Gemini Enterprise Python API 參考文件。
如要向 Gemini Enterprise 進行驗證,請設定應用程式預設憑證。 詳情請參閱「為本機開發環境設定驗證機制」。
列出所有工作階段
下列指令說明如何呼叫 list 方法,並列出資料儲存庫中的工作階段。
REST
如要列出應用程式的工作階段,請按照下列步驟操作:
執行下列 curl 指令:
curl -X GET \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://discoveryengine.googleapis.com/v1/projects/PROJECT_ID/locations/global/collections/default_collection/engines/APP_ID/sessions"
更改下列內容:
PROJECT_ID:專案的 ID。APP_ID:應用程式 ID。
Python
在試用這個範例之前,請先按照「使用用戶端程式庫的 Gemini Enterprise 快速入門導覽課程」中的 Python 設定說明操作。詳情請參閱「Gemini Enterprise Python API 參考文件」。
如要向 Gemini Enterprise 進行驗證,請設定應用程式預設憑證。 詳情請參閱「為本機開發環境設定驗證機制」。
列出使用者的工作階段
下列指令說明如何呼叫 list 方法,列出與使用者或訪客相關聯的工作階段。
REST
如要列出與使用者或訪客相關聯的工作階段,請按照下列步驟操作:
執行下列 curl 指令:
curl -X GET \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://discoveryengine.googleapis.com/v1/projects/PROJECT_ID/locations/global/collections/default_collection/engines/APP_ID/sessions?filter=userPseudoId=USER_PSEUDO_ID"
更改下列內容:
PROJECT_ID:專案的 ID。APP_ID:應用程式 ID。USER_PSEUDO_ID:要列出工作階段的使用者虛擬 ID。
Python
在試用這個範例之前,請先按照「使用用戶端程式庫的 Gemini Enterprise 快速入門導覽課程」中的 Python 設定說明操作。詳情請參閱 Gemini Enterprise Python API 參考文件。
如要向 Gemini Enterprise 進行驗證,請設定應用程式預設憑證。 詳情請參閱「為本機開發環境設定驗證機制」。
列出使用者和狀態的工作階段
下列指令說明如何呼叫 list 方法,列出特定使用者處於指定狀態的工作階段。
REST
如要列出與特定使用者或訪客相關聯的開啟或關閉工作階段,請按照下列步驟操作:
執行下列 curl 指令:
curl -X GET -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://discoveryengine.googleapis.com/v1/projects/PROJECT_ID/locations/global/collections/default_collection/engines/APP_ID/sessions?filter=userPseudoId=USER_PSEUDO_ID%20AND%20state=STATE"
更改下列內容:
PROJECT_ID:專案的 ID。APP_ID:應用程式 ID。USER_PSEUDO_ID:要列出工作階段的使用者虛擬 ID。STATE:工作階段狀態:STATE_UNSPECIFIED(已關閉或不明) 或IN_PROGRESS(已開啟)。
Python
在試用這個範例之前,請先按照「使用用戶端程式庫的 Gemini Enterprise 快速入門導覽課程」中的 Python 設定說明操作。詳情請參閱 Gemini Enterprise Python API 參考文件。
如要向 Gemini Enterprise 進行驗證,請設定應用程式預設憑證。詳情請參閱「為本機開發環境設定驗證機制」。