


本页面介绍了 Gemini Enterprise 的“搜索并回答和跟进”功能,并展示了如何使用方法调用来实现该功能。
提供回答和跟进问题的搜索基于回答方法。answer 方法还具有一些重要的附加功能,例如能够处理复杂查询。
回答方法的特点
answer 方法的主要功能如下:
能够针对复杂查询生成回答。例如,answer 方法可以将复合查询(例如以下查询)分解为多个较小的查询,以返回更好的结果,从而提供更好的答案:
- “Google Cloud 和 Google Ads 在 2024 年的收入分别是多少?”
- “Google 在成立多少年后,收入达到了 10 亿美元?”
通过在每个轮次中调用回答方法,在多轮对话中结合搜索和回答生成功能。
能够与搜索方法配对,以减少搜索延迟。您可以分别调用搜索方法和回答方法,并在不同时间在不同 iframe 中呈现搜索结果和回答。这意味着您可以在几毫秒内向用户显示搜索结果(10 个蓝色链接)。您无需等待生成回答,即可显示搜索结果。
回答和跟进功能可分为查询、搜索和回答三个阶段:
何时使用“回答”功能,何时使用“搜索”功能
Gemini Enterprise 有两种方法可用于查询应用。它们具有不同但重叠的功能。
在以下情况下,请使用 answer 方法:
您希望获得 AI 生成的搜索结果回答(或摘要)。
您希望进行多轮搜索,即保留上下文的搜索,以便提出后续问题。
在以下情况下,请使用 search 方法:
您只需要搜索结果,不需要生成式回答。
您希望返回十条以上的搜索结果(“蓝色链接”)。
您有以下任一情况:
- 您自己的嵌入
- 同义词或重定向控件
- 分面
- 用户国家/地区代码
在以下情况下,同时使用回答和搜索方法:
您希望返回 10 个以上的搜索结果,并且希望获得生成的回答。
您遇到了延迟问题,希望在返回生成的答案之前快速返回并显示搜索结果。
查询阶段功能
“回答和后续问题”功能支持自然语言查询处理。
本部分介绍并说明了查询改写和分类的各种选项。
查询改写
查询改写功能默认处于开启状态。此功能会自动选择最佳方式来改写查询,以改进搜索结果。此功能还可以处理不需要改写的查询。
将复杂查询分解为多个查询,并执行同步子查询。
例如:一个复杂的查询被拆分为四个较小、较简单的查询。
用户输入 基于复杂查询创建的子查询 Andie Ram 和 Arnaud Clément 有哪些共同的工作和爱好? - Andie Ram 的职业
- Arnaud Clément 职业
- Andie Ram 的爱好
- Arnaud Clément hobby
整合多轮查询,使后续问题具有上下文感知能力和状态。
例如:在每个轮次中根据用户输入合成的查询可能如下所示:
用户输入 已整合查询 Turn 1: laptops for school 学生笔记本电脑 轮次 2:不是 Mac 非 Mac 校园笔记本电脑 Turn 3: bigger screen and i also need wireless keyboard and mouse 适合在学校使用的大屏笔记本电脑,非 Mac,配有无线键盘和鼠标 Turn 4: and a backpack for it 适合在学校使用的大屏幕笔记本电脑,非 Mac,配有无线键盘和鼠标,以及配套背包 简化长查询,以提高检索效率。
例如:将长查询缩短为简单查询。
用户输入 查询已简化 我想了解为什么我们网站上的“添加到购物车”按钮无法正常工作。似乎当用户点击该按钮时,商品并未添加到购物车,并且用户会收到一条出错提示。我检查了代码,似乎没有问题,所以我不确定问题出在哪里。您能帮我排查此问题吗? 网站上的“添加到购物车”按钮无法正常使用。 执行多步推理
多步推理基于 ReAct(推理 + 行动)范式,使 LLM 能够使用自然语言推理来解决复杂任务。默认情况下,步骤数上限为 5。
例如:
用户输入 只需两步即可生成答案 Google 在成立多少年后,收入达到了 10 亿美元? 第 1 步:
[Thought]: I need to know when Google was founded, then I can query it is revenue since then.
[Act] Search: When was Google founded?[Observe Search Results]: "1998"
第 2 步:
[Thought]: Now I need to Google's yearly revenue since 1998, and find out when it exceeded 1 billion for the first time.
[Act] Search: Google revenue since 1998
[Observe Search Results] Google revenue in 1998, Google revenue in 1999…..
[Answer]: Google reached more than 1 billion USD revenue in 2003 [1], 5 years after its founding in 1998[2].
查询分类
查询分类选项用于识别对抗性查询和非求答查询。默认情况下,查询分类选项处于关闭状态。
如需详细了解对抗性查询和非寻求答案的查询,请参阅忽略对抗性查询和忽略非寻求摘要的查询。
搜索阶段功能
对于搜索,答案方法具有与搜索方法相同的选项。例如:
应用过滤条件,将搜索范围限制在特定文档内。如需了解详情,请参阅过滤结构化或非结构化数据的自定义搜索结果。
指定提升条件,以提升或降低搜索返回的文档的排名。如需了解详情,请参阅提升搜索结果。
应答阶段功能
在回答阶段,当根据搜索结果生成回答时,您可以启用与搜索方法相同的功能。例如:
获取引用,以指明回答中每个句子的来源。如需了解详情,请参阅添加引用。
使用提示前导词来自定义回答,例如语气、风格和详细程度。如需了解详情,请参阅指定自定义预置指令。
选择要用于生成回答的模型。 如需了解详情,请参阅回答生成模型版本和生命周期。
选择是否忽略已被归类为对抗性或非求答的查询。
如需详细了解对抗性查询和非寻求答案的查询,请参阅忽略对抗性查询和忽略非寻求摘要的查询。非求答查询也称为非摘要类查询。
搜索方法中不提供的其他回答阶段功能包括:
为每个主张(生成的回答中的句子)获取支持得分。 支持分数是一个介于 [0,1] 范围内的浮点值,表示主张在数据存储区中的数据中的接地程度。如需了解详情,请参阅返回接地支持分数。
获取回答的汇总支持得分。支持分数表示回答与数据存储区中的数据的接地程度。如需了解详情,请参阅返回接地支持分数。
仅返回有充分依据的答案。您可以选择仅返回满足特定支持分数阈值的答案。如需了解详情,请参阅仅显示有充分依据的回答。
向查询添加个性化信息,以便为个别用户自定义回答。如需了解详情,请参阅个性化回答。
如需接收除文本之外还包含图表或图片的多模态回答,可以使用以下选项:
获取包含图表和图形的回答,这些图表和图形会绘制回答中包含的数据。如需了解详情,请参阅为答案生成图表。
正在从数据存储区检索图片。如果数据存储区包含图片,则回答方法可以在回答中返回图片。如果请求引用,数据存储区中的图片也可以在引用中返回。如需了解详情,请参阅从数据存储区检索现有图片。
搜索和回答(基本)
以下命令展示了如何调用 answer 方法,并返回生成的答案和搜索结果列表,其中包含指向来源的链接。
此命令仅显示必需的输入。这些选项保留默认值。
REST
如需搜索并获取包含生成答案的结果,请执行以下操作:
运行以下 curl 命令:
curl -X POST -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://discoveryengine.googleapis.com/v1/projects/PROJECT_ID/locations/global/collections/default_collection/engines/APP_ID/servingConfigs/default_search:answer" \
  -d '{
        "query": { "text": "QUERY"}
      }'
替换以下内容:
PROJECT_ID:您的项目的 ID。APP_ID:您要查询的应用的 ID。QUERY:包含问题或搜索查询的自由文本字符串。例如,“比较 BigQuery 和 Spanner 数据库?”
Python
试用此示例之前,请按照 Gemini Enterprise 快速入门:使用客户端库中的 Python 设置说明进行操作。 如需了解详情,请参阅 Gemini Enterprise Python API 参考文档。
如需向 Gemini Enterprise 进行身份验证,请设置应用默认凭证。 如需了解详情,请参阅为本地开发环境设置身份验证。
查询阶段命令
本部分介绍了如何为 answer 方法调用的查询阶段指定选项。
搜索和回答(已停用改写功能)
以下命令展示了如何调用 answer 方法,并返回生成的答案和搜索结果列表。由于改写选项已停用,因此回答可能与之前的回答不同。
REST
如需在不应用查询改写的情况下搜索并获取包含生成式回答的结果,请执行以下操作:
运行以下 curl 命令:
curl -X POST -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://discoveryengine.googleapis.com/v1/projects/PROJECT_ID/locations/global/collections/default_collection/engines/APP_ID/servingConfigs/default_search:answer" \
  -d '{
        "query": { "text": "QUERY"},
        "queryUnderstandingSpec": {
           "queryRephraserSpec": {
              "disable": true
        }
    }
      }'
替换以下内容:
PROJECT_ID:您的项目的 ID。APP_ID:应用的 ID。QUERY:包含问题或搜索查询的自由文本字符串。例如,“比较 BigQuery 和 Spanner 数据库?”
Python
试用此示例之前,请按照 Gemini Enterprise 快速入门:使用客户端库中的 Python 设置说明进行操作。 如需了解详情,请参阅 Gemini Enterprise Python API 参考文档。
如需向 Gemini Enterprise 进行身份验证,请设置应用默认凭证。 如需了解详情,请参阅为本地开发环境设置身份验证。
搜索和回答(指定最大步骤数)
以下命令展示了如何调用 answer 方法,并返回生成的答案和搜索结果列表。此答案与前面的答案不同,因为改写步骤的数量有所增加。
REST
如需搜索并获取结果,同时生成答案(最多允许五个改写步骤),请执行以下操作:
运行以下 curl 命令:
curl -X POST -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://discoveryengine.googleapis.com/v1/projects/PROJECT_ID/locations/global/collections/default_collection/engines/APP_ID/servingConfigs/default_search:answer" \
  -d '{
        "query": { "text": "QUERY"},
        "queryUnderstandingSpec": {
            "queryRephraserSpec": {
                "maxRephraseSteps": MAX_REPHRASE
             }
         }
      }'
替换以下内容:
PROJECT_ID:您的项目的 ID。APP_ID:您要查询的应用的 ID。QUERY:包含问题或搜索查询的自由文本字符串。例如,“比较 BigQuery 和 Spanner 数据库?”MAX_REPHRASE:改写步骤数上限。允许的最大值为5。 如果未设置或设置为小于1,则该值为默认值1。
Python
试用此示例之前,请按照 Gemini Enterprise 快速入门:使用客户端库中的 Python 设置说明进行操作。 如需了解详情,请参阅 Gemini Enterprise Python API 参考文档。
如需向 Gemini Enterprise 进行身份验证,请设置应用默认凭证。 如需了解详情,请参阅为本地开发环境设置身份验证。
使用查询分类进行搜索和回答
以下命令展示了如何调用 answer 方法来查询某个查询是否属于对抗性查询、非寻求答案查询或两者都不是。
回答中包含查询的分类类型,但回答本身不受分类影响。 如果您想根据查询类型更改回答行为,可以在回答阶段执行此操作。请参阅忽略对抗性查询和忽略非摘要搜索查询。
REST
如需确定查询是否具有对抗性或非寻求答案性,请执行以下操作:
运行以下 curl 命令:
curl -X POST -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://discoveryengine.googleapis.com/v1/projects/PROJECT_ID/locations/global/collections/default_collection/engines/APP_ID/servingConfigs/default_search:answer" \
  -d '{
        "query": { "text": "QUERY"},
        "queryUnderstandingSpec": {
            "queryClassificationSpec": {
                "types": ["QUERY_CLASSIFICATION_TYPE"]
             }
         }
      }'
替换以下内容:
PROJECT_ID:您的项目的 ID。APP_ID:您要查询的应用的 ID。QUERY:包含问题或搜索查询的自由文本字符串。例如“hello”。QUERY_CLASSIFICATION_TYPE:您要识别的查询类型:ADVERSARIAL_QUERY、NON_ANSWER_SEEKING_QUERY或两者。
Python
试用此示例之前,请按照 Gemini Enterprise 快速入门:使用客户端库中的 Python 设置说明进行操作。 如需了解详情,请参阅 Gemini Enterprise Python API 参考文档。
如需向 Gemini Enterprise 进行身份验证,请设置应用默认凭证。 如需了解详情,请参阅为本地开发环境设置身份验证。
搜索阶段命令:搜索和回答(含搜索结果选项)
本部分介绍了如何为 answer 方法调用的搜索阶段部分指定选项,例如设置返回的文档数量上限、提升和过滤,以及如何在提供自己的搜索结果时获取答案。
以下命令展示了如何调用 answer 方法,并指定了各种选项来控制搜索结果的返回方式。(搜索结果与回答无关。)
REST
如需设置与返回哪些搜索结果以及如何返回搜索结果相关的各种选项,请执行以下操作:
运行以下 curl 命令:
curl -X POST -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://discoveryengine.googleapis.com/v1/projects/PROJECT_ID/locations/global/collections/default_collection/engines/APP_ID/servingConfigs/default_search:answer" \
  -d '{
        "query": { "text": "QUERY"},
          "searchSpec": {
          "searchParams": {
            "maxReturnResults": MAX_RETURN_RESULTS,
            "filter": "FILTER",
            "boostSpec": BOOST_SPEC,
            "orderBy": "ORDER_BY",
            "searchResultMode": SEARCH_RESULT_MODE
           }
         }
      }'
替换以下内容:
PROJECT_ID:您的项目的 ID。APP_ID:您要查询的应用的 ID。QUERY:包含问题或搜索查询的自由文本字符串。例如,“比较 BigQuery 和 Spanner 数据库?”MAX_RETURN_RESULTS:要返回的搜索结果数。默认值为 10。FILTER:过滤条件指定要查询哪些文档。如果文档的元数据符合过滤条件规范,则系统会查询该文档。如需了解详情(包括过滤条件语法),请参阅过滤结构化或非结构化数据的自定义搜索结果。BOOST_SPEC:通过提升规范,您可以提升搜索结果中的特定文档,这可能会影响回答。如需了解详情(包括提升规范的语法),请参阅提升搜索结果。ORDER_BY:文档的返回顺序。文档可以按 Document 对象中的字段排序。orderBy表达式应区分大小写。如果此字段无法识别,则系统会返回INVALID_ARGUMENT。SEARCH_RESULT_MODE:指定搜索结果模式:DOCUMENTS或CHUNKS。如需了解详情,请参阅解析和分块文档以及 ContentSearchSpec。 此字段仅在 v1alpha 版本的 API 中可用。
Python
试用此示例之前,请按照 Gemini Enterprise 快速入门:使用客户端库中的 Python 设置说明进行操作。 如需了解详情,请参阅 Gemini Enterprise Python API 参考文档。
如需向 Gemini Enterprise 进行身份验证,请设置应用默认凭证。 如需了解详情,请参阅为本地开发环境设置身份验证。
回答阶段命令
本部分介绍了如何自定义 answer 方法调用。
您可以根据需要组合使用以下选项。
忽略对抗性查询和非求答查询
以下命令展示了如何在调用 answer 方法时避免回答对抗性查询和非寻求答案的查询。
REST
如需跳过回答对抗性或非求答查询,请执行以下操作:
运行以下 curl 命令:
curl -X POST -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://discoveryengine.googleapis.com/v1/projects/PROJECT_ID/locations/global/collections/default_collection/engines/APP_ID/servingConfigs/default_search:answer" \
  -d '{
        "query": { "text": "QUERY"},
        "answerGenerationSpec": {
           "ignoreAdversarialQuery": true,
           "ignoreNonAnswerSeekingQuery": true
        }
      }'
替换以下内容:
PROJECT_ID:您的项目的 ID。APP_ID:您要查询的应用的 ID。QUERY:包含问题或搜索查询的自由文本字符串。
Python
试用此示例之前,请按照 Gemini Enterprise 快速入门:使用客户端库中的 Python 设置说明进行操作。 如需了解详情,请参阅 Gemini Enterprise Python API 参考文档。
如需向 Gemini Enterprise 进行身份验证,请设置应用默认凭证。 如需了解详情,请参阅为本地开发环境设置身份验证。
仅显示相关回答
Gemini Enterprise 可以评估结果与查询的相关性。如果系统判定没有任何结果具有足够的关联性,您可以选择返回后备答案“We do not have a summary for your query.”,而不是根据不相关或关联性极低的结果生成答案。
以下命令展示了如何在调用 answer 方法时,在结果不相关的情况下返回后备回答。
REST
如需在未找到相关结果时返回后备回答,请执行以下操作:
运行以下 curl 命令:
curl -X POST -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://discoveryengine.googleapis.com/v1/projects/PROJECT_ID/locations/global/collections/default_collection/engines/APP_ID/servingConfigs/default_search:answer" \
  -d '{
        "query": { "text": "QUERY"},
        "answerGenerationSpec": {
           "ignoreLowRelevantContent": true
        }
      }'
替换以下内容:
PROJECT_ID:您的项目的 ID。APP_ID:您要查询的应用的 ID。QUERY:包含问题或搜索查询的自由文本字符串。
Python
试用此示例之前,请按照 Gemini Enterprise 快速入门:使用客户端库中的 Python 设置说明进行操作。 如需了解详情,请参阅 Gemini Enterprise Python API 参考文档。
如需向 Gemini Enterprise 进行身份验证,请设置应用默认凭证。 如需了解详情,请参阅为本地开发环境设置身份验证。
返回依据支持分数
以下命令展示了如何返回答案和声明的接地支持分数。
REST
如需返回每个主张(回答中的句子)的支持得分以及回答的汇总支持得分,请执行以下操作:
运行以下 curl 命令:
curl -X POST -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://discoveryengine.googleapis.com/v1/projects/PROJECT_ID/locations/global/collections/default_collection/engines/APP_ID/servingConfigs/default_search:answer" \
  -d '{
        "query": { "text": "QUERY"},
        "groundingSpec": {
           "includeGroundingSupports": true,
        }
      }'
替换以下内容:
PROJECT_ID:您的项目的 ID。APP_ID:您要查询的应用的 ID。QUERY:包含问题或搜索查询的自由文本字符串。
仅显示有充分依据的回答
以下命令展示了如何仅返回被认为在语料库(数据存储区中的信息)中有充分依据的回答。接地程度较差的回答会被滤除。
您可以为依据支持分数选择低阈值或高阈值。然后,仅当答案达到或超过该级别时,才会返回答案。您可以尝试使用这两个过滤阈值,也可以不使用阈值,以确定哪种过滤级别可能为用户提供最佳结果。
REST
如需仅在回答符合支持分数阈值时返回回答,请执行以下操作:
运行以下 curl 命令:
curl -X POST -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://discoveryengine.googleapis.com/v1/projects/PROJECT_ID/locations/global/collections/default_collection/engines/APP_ID/servingConfigs/default_search:answer" \
  -d '{
        "query": { "text": "QUERY"},
        "groundingSpec": {
           "filteringLevel": "FILTER_LEVEL"
        }
      }'
替换以下内容:
PROJECT_ID:您的项目的 ID。APP_ID:您要查询的应用的 ID。QUERY:包含问题或搜索查询的自由文本字符串。FILTER_LEVEL:一个枚举,用于根据接地支持得分过滤答案。选项为FILTERING_LEVEL_LOW和FILTERING_LEVEL_HIGH。如果未包含filteringLevel,则不会对回答应用支持分数过滤条件。
指定回答模型
以下命令展示了如何更改用于生成答案的模型版本。
如需了解支持的模型,请参阅回答生成模型版本和生命周期。
REST
如需使用默认模型以外的模型生成回答,请执行以下操作:
运行以下 curl 命令:
curl -X POST -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://discoveryengine.googleapis.com/v1/projects/PROJECT_ID/locations/global/collections/default_collection/engines/APP_ID/servingConfigs/default_search:answer" \
  -d '{
        "query": { "text": "QUERY"},
        "answerGenerationSpec": {
           "modelSpec": {
              "modelVersion": "MODEL_VERSION",
           }
         }
      }'
替换以下内容:
PROJECT_ID:您的项目的 ID。APP_ID:您要查询的应用的 ID。QUERY:包含问题或搜索查询的自由文本字符串。MODEL_VERSION:您要用于生成回答的模型版本。如需了解详情,请参阅回答生成模型版本和生命周期。
Python
试用此示例之前,请按照 Gemini Enterprise 快速入门:使用客户端库中的 Python 设置说明进行操作。 如需了解详情,请参阅 Gemini Enterprise Python API 参考文档。
如需向 Gemini Enterprise 进行身份验证,请设置应用默认凭证。 如需了解详情,请参阅为本地开发环境设置身份验证。
指定自定义前导码
以下命令展示了如何为生成的答案设置前言。预置指令包含用于自定义回答的自然语言指令。您可以要求进行自定义,例如长度、详细程度、输出样式(例如“简单”)、输出语言、回答重点和格式(例如表格、项目符号和 XML)。例如,预置指令可以是“请像十岁的孩子一样解释”。
预置指令可能会对生成的回答的质量产生重大影响。如需了解预置指令中应包含的内容以及优质预置指令的示例,请参阅自定义预置指令简介。
REST
如需使用默认模型以外的模型生成回答,请执行以下操作:
运行以下 curl 命令:
curl -X POST -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://discoveryengine.googleapis.com/v1/projects/PROJECT_ID/locations/global/collections/default_collection/engines/APP_ID/servingConfigs/default_search:answer" \
  -d '{
        "query": { "text": "QUERY"},
        "answerGenerationSpec": {
           "promptSpec": {
               "preamble": "PREAMBLE",
           }
        }
      }'
替换以下内容:
PROJECT_ID:您的项目的 ID。APP_ID:您要查询的应用的 ID。QUERY:包含问题或搜索查询的自由文本字符串。PREAMBLE:用于自定义回答的自然语言指令。例如,尝试show the answer format in an ordered list或give a very detailed answer。
Python
试用此示例之前,请按照 Gemini Enterprise 快速入门:使用客户端库中的 Python 设置说明进行操作。 如需了解详情,请参阅 Gemini Enterprise Python API 参考文档。
如需向 Gemini Enterprise 进行身份验证,请设置应用默认凭证。 如需了解详情,请参阅为本地开发环境设置身份验证。
包含引用
以下命令展示了如何请求在回答中包含引用。
REST
如需使用默认模型以外的模型生成回答,请执行以下操作:
运行以下 curl 命令:
curl -X POST -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://discoveryengine.googleapis.com/v1/projects/PROJECT_ID/locations/global/collections/default_collection/engines/APP_ID/servingConfigs/default_search:answer" \
  -d '{
        "query": { "text": "QUERY"},
        "answerGenerationSpec": {
           "includeCitations": INCLUDE_CITATIONS
        }
      }'
替换以下内容:
PROJECT_ID:您的项目的 ID。APP_ID:您要查询的应用的 ID。QUERY:包含问题或搜索查询的自由文本字符串。INCLUDE_CITATIONS:指定是否在回答中包含引用元数据。默认值为false。
Python
试用此示例之前,请按照 Gemini Enterprise 快速入门:使用客户端库中的 Python 设置说明进行操作。 如需了解详情,请参阅 Gemini Enterprise Python API 参考文档。
如需向 Gemini Enterprise 进行身份验证,请设置应用默认凭证。 如需了解详情,请参阅为本地开发环境设置身份验证。
设置回答语言代码
以下命令展示了如何设置答案的语言代码。
REST
如需使用默认模型以外的模型生成回答,请执行以下操作:
运行以下 curl 命令:
curl -X POST -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://discoveryengine.googleapis.com/v1/projects/PROJECT_ID/locations/global/collections/default_collection/engines/APP_ID/servingConfigs/default_search:answer" \
  -d '{
        "query": { "text": "QUERY"},
        "answerGenerationSpec": {
           "answerLanguageCode": "ANSWER_LANGUAGE_CODE"
           }
      }'
替换以下内容:
PROJECT_ID:您的项目的 ID。APP_ID:您要查询的应用的 ID。QUERY:包含问题或搜索查询的自由文本字符串。ANSWER_LANGUAGE_CODE:答案的语言代码。使用 BCP47:用于标识语言的标记中定义的语言标记。
Python
试用此示例之前,请按照 Gemini Enterprise 快速入门:使用客户端库中的 Python 设置说明进行操作。 如需了解详情,请参阅 Gemini Enterprise Python API 参考文档。
如需向 Gemini Enterprise 进行身份验证,请设置应用默认凭证。 如需了解详情,请参阅为本地开发环境设置身份验证。
个性化回答
如果有关于用户的特定信息(例如个人资料中的数据),您可以在 endUserMetadata 对象中指定这些信息,以便为用户提供个性化的查询结果。
例如,如果用户正在搜索有关升级手机的信息,则其个人资料中的信息(例如当前手机型号和手机套餐)可提供个性化生成答案的信息。
如需添加有关进行查询的用户个人信息,并生成考虑个人信息的回答,请执行以下操作:
运行以下 curl 命令:
curl -X POST -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://discoveryengine.googleapis.com/v1/projects/PROJECT_ID/locations/global/collections/default_collection/engines/APP_ID/servingConfigs/default_search:answer" \
-d '{
    "query": { "text": "QUERY"},
    "endUserSpec": {
       "endUserMetadata": [
         {
           "chunkInfo": {
              "content": "PERSONALIZED_INFO",
              "documentMetadata":  { "title": "INFO_DESCRIPTION"}
           }
         }
       ]
    }
  }'
替换以下内容:
PROJECT_ID:您的项目的 ID。APP_ID:您要查询的应用的 ID。QUERY:包含问题或搜索查询的自由文本字符串。PERSONALIZATION_INFO:一个字符串,其中包含特定于发出查询的用户的信息。例如This customer has a Pixel 6 Pro purchased over a period of 24-months starting 2023-01-15. This customer is on the Business Plus International plan. No payment is due at this time.。此字符串的长度上限为 8,000 个字符。INFO_DESCRIPTION:简要描述个性化信息的字符串,例如Customer profile data, including model, plan, and billing status.。模型在生成查询的自定义答案时,会同时使用此说明和个性化信息。
为回答生成图表
answer 方法可以生成图表,并将其作为查询回答的一部分返回。
您可以明确要求回答中包含图表,例如“绘制有可用数据年份的小型企业付款同比增长率”。如果系统确定存在足够的数据,则会返回图表。通常,系统会返回一些答案文本以及图表。
此外,如果有足够的数据来创建图表,即使查询未明确请求图表,回答方法也可以返回图表。例如,“在 2010 年至 2020 年这十年间,与获得更多清洁饮用水相关的 HDI 得分提高了多少?”
每个回答只会生成一个图表。不过,该图表可能是复合图表,其中包含其他较小的图表。复合图表示例:
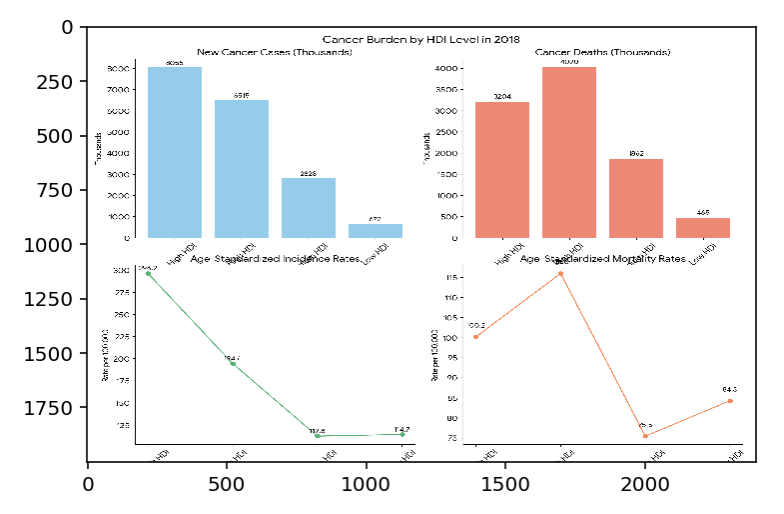
限制
查询必须使用英语。
常见故障场景
回答中不一定会包含图片。如果数据不足,则无法生成图表。
其他故障场景包括代码执行失败和超时。如果发生上述任一情况,请重新措辞查询,然后重试。
准备工作
在运行请求生成式图表的查询之前,请执行以下操作:
确保您使用的是 Gemini 2.0 或更高版本的模型。如需了解这些模型,请参阅回答生成模型版本和生命周期。
如果您的非结构化数据存储区包含包含大量表格和图片的文档,请开启布局解析器。虽然这不是绝对必要的,但可以提供更优质的结果。
过程
REST
按如下方式调用 answer 方法,以返回可能包含根据数据存储区中的数据生成的图表的回答:
运行以下 curl 命令:
curl -X POST -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://discoveryengine.googleapis.com/v1beta/projects/PROJECT_ID/locations/global/collections/default_collection/engines/APP_ID/servingConfigs/default_search:answer" \
  -d '{
        "query": { "text": "QUERY"},
        "answerGenerationSpec": {
          "model_spec": {
             "model_version": "MODEL_VERSION"
         },
          "multimodalSpec": {
             "imageSource": "IMAGE_SOURCE"
             }
        }
      }'
替换以下内容:
PROJECT_ID:您的项目的 ID。APP_ID:您要查询的应用的 ID。QUERY:包含问题或搜索查询的英文自由文本字符串。MODEL_VERSION:模型版本stable或其他受支持的模型,请参阅回答生成模型版本和生命周期。IMAGE_SOURCE:一个枚举,用于请求答案包含生成的图表 (FIGURE_GENERATION_ONLY),或者答案可以包含生成的图表或数据存储区中的现有图片 (ALL_AVAILABLE_SOURCES)。
从数据存储区中检索现有图片
您可以选择让系统在回答和引用参考中返回数据存储区中的图片。数据存储区必须是非结构化数据存储区,且已启用布局解析器。
当 imageSource 为 CORPUS_IMAGE_ONLY 或 ALL_AVAILABLE_SOURCES 时,answer 方法可以根据需要从数据存储区检索图片。不过,开启此功能并不意味着系统始终会返回图片。
每个回答最多只能生成一张图片。引用可以包含多张图片。
限制
您使用的应用必须关联到非结构化数据存储区。 无法从网站或结构化数据存储区返回图片。
查询必须使用英语。
必须对数据存储区应用通过布局解析器进行的图片注解。 如需了解布局解析器,请参阅对文档进行解析和分块。
过程
REST
按如下方式调用 answer 方法,以返回可在回答中包含数据存储区中的图片的回答:
运行以下 curl 命令:
curl -X POST -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://discoveryengine.googleapis.com/v1beta/projects/PROJECT_ID/locations/global/collections/default_collection/engines/APP_ID/servingConfigs/default_search:answer" \
  -d '{
        "query": { "text": "QUERY"},
        "answerGenerationSpec": {
          "model_spec": {
             "model_version": "MODEL_VERSION"
          },
          includeCitations: true,
          "multimodalSpec": {
             "imageSource": "IMAGE_SOURCE"
             }
        }
      }'
替换以下内容:
PROJECT_ID:您的项目的 ID。APP_ID:您要查询的应用的 ID。QUERY:包含问题或搜索查询的英文自由文本字符串。MODEL_VERSION:模型版本stable或其他受支持的模型,请参阅回答生成模型版本和生命周期。IMAGE_SOURCE:一个枚举,用于请求答案包含数据存储区中的图片 (CORPUS_IMAGE_ONLY),或者答案可以包含数据存储区中的图片或生成式图表 (ALL_AVAILABLE_SOURCES)。
用于提出后续问题的指令
后续问题是多轮查询。在后续会话中,除了第一个查询之外,后续的“回合”都会考虑之前的互动。借助跟进问题,回答方法还可以建议相关问题,用户可以选择这些问题,而无需输入自己的跟进问题。
前面部分中介绍的所有回答和跟进功能(例如引用、过滤条件、安全搜索、忽略某些类型的查询以及使用预置指令自定义回答)都可以与跟进功能一起应用。
后续会话示例
以下是一个包含后续问题的会话示例。假设您想了解在墨西哥度假的相关信息:
第 1 轮:
您:一年中什么时候最适合去墨西哥度假?
回答并提供后续问题:去墨西哥度假的最佳时间是旱季,即 11 月至次年 4 月。
第 2 轮:
您:汇率是多少?
回答并提供后续问题:1 美元约等于 17.65 墨西哥比索。
第 3 轮:
您:12 月的平均气温是多少?
回答并提供后续问题:平均温度在 70-78°F 之间。 坎昆的平均气温约为 77°F。
如果没有后续问题,您的“汇率是多少?”问题将无法回答,因为常规搜索无法知道您想要的是墨西哥汇率。同样,如果没有后续问题,系统就不会有必要的上下文信息来提供墨西哥的具体温度。
相关问题示例
当您询问“一年中什么时间最适合去墨西哥度假?”时,除了回答您的问题之外,回答和后续问题还可以建议您可能提出的其他问题,例如“去墨西哥度假最便宜的月份是哪个月?”和“墨西哥的旅游月份是哪几个月?”。
启用相关问题功能后,系统会在响应中以字符串形式返回问题。
关于会话
如需了解 Gemini Enterprise 中的后续问题如何运作,您需要了解会话。
会话由用户提供的文本查询和 Gemini Enterprise 提供的回答组成。
这些查询和回答对有时称为轮次。在前面的示例中,第二轮对话由“汇率是多少?”和“1 美元大约等于 17.65 墨西哥比索”组成。
会话存储在应用中。在应用中,会话由会话资源表示。
除了包含查询和响应消息之外,会话资源还具有:
唯一名称(会话 ID)。
状态(进行中或已完成)。
用户伪 ID,即跟踪用户的访问者 ID。可以通过编程方式进行分配。
开始时间和结束时间。
一个对话轮次,即一个查询回答对。
存储会话信息并获取回答
您可以使用命令行生成搜索回答和答案,并将这些内容与会话中的每个查询一起存储。
REST
如需使用命令行创建会话并根据用户输入生成回答,请按以下步骤操作:
指定要用于存储会话的应用:
curl -X POST \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://discoveryengine.googleapis.com/v1/projects/PROJECT_ID/locations/global/collections/default_collection/engines/APP_ID/sessions" \
  -d '{
        "userPseudoId": "USER_PSEUDO_ID"
      }'
替换以下内容:
PROJECT_ID:您的项目的 ID。APP_ID:应用的 ID。USER_PSEUDO_ID:这是用于跟踪搜索访问者的唯一标识符。例如,您可以通过 HTTP Cookie 实现此目的,该 Cookie 可唯一标识单个设备上的访问者。
命令和结果示例
curl -X POST -H "Authorization: Bearer $(gcloud auth print-access-token)"
-H "Content-Type: application/json"
"https://discoveryengine.googleapis.com/v1/projects/my-project-123/locations/global/collections/default_collection/engines/my-app/sessions"
-d '{
"userPseudoId": "test_user"
}'

{
  "name": "projects/123456/locations/global/collections/default_collection/engines/my-app/sessions/16002628354770206943",
  "state": "IN_PROGRESS",
  "userPseudoId": "test_user",
  "startTime": "2024-09-13T18:47:10.465311Z",
  "endTime": "2024-09-13T18:47:10.465311Z"
}
记下会话 ID,即 JSON 响应中
name:字段末尾的数字。在示例结果中,此 ID 为5386462384953257772。下一步中您需要用到此 ID。生成回答并将其添加到应用中的会话:
curl -X POST \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://discoveryengine.googleapis.com/v1/projects/PROJECT_ID/locations/global/collections/default_collection/engines/APP_ID/servingConfigs/default_search:answer" \
  -d '{
        "query": { "text": "QUERY"},
        "session": "projects/PROJECT_ID/locations/global/collections/default_collection/engines/APP_ID/sessions/SESSION_ID",
          "searchSpec":{ "searchParams": {"filter": "FILTER"} }
}'
替换以下内容:
PROJECT_ID:您的项目的 ID。APP_ID:应用的 ID。QUERY:包含问题或搜索查询的自由文本字符串。SESSION_ID:您在第 1 步中创建的会话的 ID。这些是name:字段末尾的数字,在第 2 步中已记下。对于会话,请在每个轮次中使用相同的会话 ID。FILTER:用于通过过滤表达式来过滤搜索结果的文本字段。默认值为空字符串。 过滤条件的构建方式取决于您拥有的是包含元数据的非结构化数据、结构化数据还是网站数据。如需了解详情,请参阅过滤结构化或非结构化数据的自定义搜索结果。
命令和结果示例
curl -X POST -H "Authorization: Bearer $(gcloud auth print-access-token)"
-H "Content-Type: application/json"
"https://discoveryengine.googleapis.com/v1/projects/my-project-123/locations/global/collections/default_collection/engines/my-app/servingConfigs/default_search:answer"
-d '{
"query": { "text": "Compare bigquery with spanner database?"},
"session":  "projects/123456/locations/global/collections/default_collection/engines/my-app/sessions/16002628354770206943",
}'

{
  "answer": {
    "name": "projects/123456/locations/global/collections/default_collection/engines/my-app/sessions/16002628354770206943/answers/4861507376861383072",
    "state": "SUCCEEDED",
    "answerText": "BigQuery and Spanner are both powerful tools that can be used together to handle transactional and analytical workloads. Spanner is a fully managed relational database optimized for transactional workloads, while BigQuery is a serverless data warehouse designed for business agility. Spanner provides seamless replication across regions in Google Cloud and processes over 1 billion requests per second at peak. BigQuery analyzes over 110 terabytes of data per second. Users can leverage federated queries to read data from Spanner and write to a native BigQuery table. \n",
    "steps": [
      {
        "state": "SUCCEEDED",
        "description": "Rephrase the query and search.",
        "actions": [
          {
            "searchAction": {
              "query": "Compare bigquery with spanner database?"
            },
            "observation": {
              "searchResults": [
                {
                  "document": "projects/123456/locations/global/collections/default_collection/dataStores/my-data-store/branches/0/documents/ecc0e7547253f4ca3ff3328ce89995af",
                  "uri": "https://cloud.google.com/blog/topics/developers-practitioners/how-spanner-and-bigquery-work-together-handle-transactional-and-analytical-workloads",
                  "title": "How Spanner and BigQuery work together to handle transactional and analytical workloads | Google Cloud Blog",
                  "snippetInfo": [
                    {
                      "snippet": "Using Cloud \u003cb\u003eSpanner\u003c/b\u003e and \u003cb\u003eBigQuery\u003c/b\u003e also allows customers to build their \u003cb\u003edata\u003c/b\u003e clouds using Google Cloud, a unified, open approach to \u003cb\u003edata\u003c/b\u003e-driven transformation ...",
                      "snippetStatus": "SUCCESS"
                    }
                  ]
                },
                {
                  "document": "projects/123456/locations/global/collections/default_collection/dataStores/my-data-store/branches/0/documents/d7e238f73608a860e00b752ef80e2941",
                  "uri": "https://cloud.google.com/blog/products/databases/cloud-spanner-gets-stronger-with-bigquery-federated-queries",
                  "title": "Cloud Spanner gets stronger with BigQuery-federated queries | Google Cloud Blog",
                  "snippetInfo": [
                    {
                      "snippet": "As enterprises compete for market share, their need for real-time insights has given rise to increased demand for transactional \u003cb\u003edatabases\u003c/b\u003e to support \u003cb\u003edata\u003c/b\u003e ...",
                      "snippetStatus": "SUCCESS"
                    }
                  ]
                },
                {
                  "document": "projects/123456/locations/global/collections/default_collection/dataStores/my-data-store/branches/0/documents/e10a5a3c267dc61579e7c00fefe656eb",
                  "uri": "https://cloud.google.com/blog/topics/developers-practitioners/replicating-cloud-spanner-bigquery-scale",
                  "title": "Replicating from Cloud Spanner to BigQuery at scale | Google Cloud Blog",
                  "snippetInfo": [
                    {
                      "snippet": "... \u003cb\u003eSpanner data\u003c/b\u003e into \u003cb\u003eBigQuery\u003c/b\u003e for analytics. In this post, you will learn how to efficiently use this feature to replicate large tables with high throughput ...",
                      "snippetStatus": "SUCCESS"
                    }
                  ]
                },
                ...
                {
                  "document": "projects/123456/locations/global/collections/default_collection/dataStores/my-data-store/branches/0/documents/8100ad36e1cac149eb9fc180a41d8f25",
                  "uri": "https://cloud.google.com/blog/products/gcp/from-nosql-to-new-sql-how-spanner-became-a-global-mission-critical-database",
                  "title": "How Spanner became a global, mission-critical database | Google Cloud Blog",
                  "snippetInfo": [
                    {
                      "snippet": "... SQL \u003cb\u003evs\u003c/b\u003e. NoSQL dichotomy may no longer be relevant." The \u003cb\u003eSpanner\u003c/b\u003e SQL query processor, while recognizable as a standard implementation, has unique ...",
                      "snippetStatus": "SUCCESS"
                    }
                  ]
                }
              ]
            }
          }
        ]
      }
    ]
  },
  "session": {
    "name": "projects/123456/locations/global/collections/default_collection/engines/my-app/sessions/16002628354770206943",
    "state": "IN_PROGRESS",
    "userPseudoId": "test_user",
    "turns": [
      {
        "query": {
          "queryId": "projects/123456/locations/global/questions/741830",
          "text": "Compare bigquery with spanner database?"
        },
        "answer": "projects/123456/locations/global/collections/default_collection/engines/my-app/sessions/16002628354770206943/answers/4861507376861383072"
      }
    ],
    "startTime": "2024-09-13T18:47:10.465311Z",
    "endTime": "2024-09-13T18:47:10.465311Z"
  },
  "answerQueryToken": "NMwKDAjFkpK3BhDU24uZAhIkNjZlNDIyZWYtMDAwMC0yMjVmLWIxMmQtZjQwMzA0M2FkYmNj"
}
对会话中的每个新查询重复第 3 步。
Python
试用此示例之前,请按照 Gemini Enterprise 快速入门:使用客户端库中的 Python 设置说明进行操作。 如需了解详情,请参阅 Gemini Enterprise Python API 参考文档。
如需向 Gemini Enterprise 进行身份验证,请设置应用默认凭证。 如需了解详情,请参阅为本地开发环境设置身份验证。
从数据存储区获取会话
以下命令展示了如何调用 get 方法并从数据存储区获取会话。
REST
如需从数据存储区获取会话,请执行以下操作:
运行以下 curl 命令:
curl -X GET -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://discoveryengine.googleapis.com/v1/projects/PROJECT_ID/locations/global/collections/default_collection/engines/APP_ID/sessions/SESSION_ID"
替换以下内容:
PROJECT_ID:您的项目的 ID。APP_ID:应用的 ID。SESSION_ID:您要获取的会话的 ID。
Python
试用此示例之前,请按照 Gemini Enterprise 快速入门:使用客户端库中的 Python 设置说明进行操作。 如需了解详情,请参阅 Gemini Enterprise Python API 参考文档。
如需向 Gemini Enterprise 进行身份验证,请设置应用默认凭证。 如需了解详情,请参阅为本地开发环境设置身份验证。
从应用中删除会话
以下命令展示了如何调用 delete 方法并从数据存储区中删除会话。
默认情况下,系统会自动删除保留时长超过 60 天的会话。 不过,如果您想删除特定会话(例如,如果会话包含敏感内容),则可以使用此 API 调用将其删除。
REST
如需从应用中删除会话,请执行以下操作:
运行以下 curl 命令:
curl -X DELETE -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://discoveryengine.googleapis.com/v1/projects/PROJECT_ID/locations/global/collections/default_collection/engines/APP_ID/sessions/SESSION_ID"
替换以下内容:
PROJECT_ID:您的项目的 ID。APP_ID:应用的 ID。SESSION_ID:您要删除的会话的 ID。
Python
试用此示例之前,请按照 Gemini Enterprise 快速入门:使用客户端库中的 Python 设置说明进行操作。 如需了解详情,请参阅 Gemini Enterprise Python API 参考文档。
如需向 Gemini Enterprise 进行身份验证,请设置应用默认凭证。 如需了解详情,请参阅为本地开发环境设置身份验证。
更新会话
您可能出于各种原因而需要更新会话。例如,执行以下操作之一:
- 将会话标记为已完成
- 将一个会话中的消息合并到另一个会话中
- 更改用户的伪 ID
以下命令展示了如何调用 patch 方法并更新数据存储区中的会话。
REST
如需通过应用更新会话,请执行以下操作:
运行以下 curl 命令:
curl -X PATCH \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://discoveryengine.googleapis.com/v1/projects/PROJECT_ID/locations/global/collections/default_collection/engines/APP_ID/sessions/SESSION_ID?updateMask=state" \
  -d '{
        "state": "NEW_STATE"
      }'
替换以下内容:
PROJECT_ID:您的项目的 ID。APP_ID:应用的 ID。SESSION_ID:您要更新的会话的 ID。NEW_STATE:状态的新值,例如IN_PROGRESS。
Python
试用此示例之前,请按照 Gemini Enterprise 快速入门:使用客户端库中的 Python 设置说明进行操作。 如需了解详情,请参阅 Gemini Enterprise Python API 参考文档。
如需向 Gemini Enterprise 进行身份验证,请设置应用默认凭证。 如需了解详情,请参阅为本地开发环境设置身份验证。
列出所有会话
以下命令展示了如何调用 list 方法并列出数据存储区中的会话。
REST
如需列出应用的会话,请执行以下操作:
运行以下 curl 命令:
curl -X GET \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://discoveryengine.googleapis.com/v1/projects/PROJECT_ID/locations/global/collections/default_collection/engines/APP_ID/sessions"
替换以下内容:
PROJECT_ID:您的项目的 ID。APP_ID:应用的 ID。
Python
试用此示例之前,请按照 Gemini Enterprise 快速入门:使用客户端库中的 Python 设置说明进行操作。 如需了解详情,请参阅 Gemini Enterprise Python API 参考文档。
如需向 Gemini Enterprise 进行身份验证,请设置应用默认凭证。 如需了解详情,请参阅为本地开发环境设置身份验证。
列出用户的会话
以下命令展示了如何调用 list 方法来列出与用户或访问者关联的会话。
REST
如需列出与用户或访客关联的会话,请执行以下操作:
运行以下 curl 命令:
curl -X GET \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://discoveryengine.googleapis.com/v1/projects/PROJECT_ID/locations/global/collections/default_collection/engines/APP_ID/sessions?filter=userPseudoId=USER_PSEUDO_ID"
替换以下内容:
PROJECT_ID:您的项目的 ID。APP_ID:应用的 ID。USER_PSEUDO_ID:您要列出其会话的用户的伪 ID。
Python
试用此示例之前,请按照 Gemini Enterprise 快速入门:使用客户端库中的 Python 设置说明进行操作。 如需了解详情,请参阅 Gemini Enterprise Python API 参考文档。
如需向 Gemini Enterprise 进行身份验证,请设置应用默认凭证。 如需了解详情,请参阅为本地开发环境设置身份验证。
列出特定用户和状态的会话
以下命令展示了如何调用 list 方法来列出特定用户处于给定状态的会话。
REST
如需列出与给定用户或访问者关联的已打开或已关闭的用户会话,请执行以下操作:
运行以下 curl 命令:
curl -X GET -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://discoveryengine.googleapis.com/v1/projects/PROJECT_ID/locations/global/collections/default_collection/engines/APP_ID/sessions?filter=userPseudoId=USER_PSEUDO_ID%20AND%20state=STATE"
替换以下内容:
PROJECT_ID:您的项目的 ID。APP_ID:应用的 ID。USER_PSEUDO_ID:您要列出其会话的用户的伪 ID。STATE:会话的状态:STATE_UNSPECIFIED(已关闭或未知)或IN_PROGRESS(已打开)。
Python
试用此示例之前,请按照 Gemini Enterprise 快速入门:使用客户端库中的 Python 设置说明进行操作。 如需了解详情,请参阅 Gemini Enterprise Python API 参考文档。
如需向 Gemini Enterprise 进行身份验证,请设置应用默认凭证。 如需了解详情,请参阅为本地开发环境设置身份验证。