


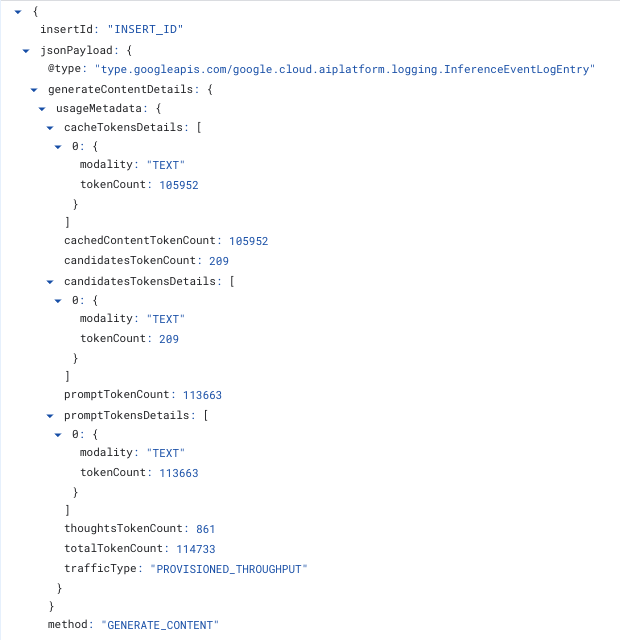
Agent Platform dapat menulis satu entri log terstruktur untuk setiap permintaan inferensi yang disajikan project Anda. Setiap entri mencatat metadata tentang permintaan: model, region, jumlah token (termasuk token input, token output, token yang di-cache, token pemikiran), burndown Throughput yang Disediakan, latensi permintaan end-to-end, kode error, dan label header atau label permintaan yang Anda lampirkan. Entri akan dikirim ke Cloud Logging, dan Anda dapat mengkuerinya dengan SQL di Observability Analytics. Untuk mengaktifkan logging, lihat Mengaktifkan log metadata permintaan inferensi.
Logging permintaan inferensi hanya mencatat metadata. Sistem ini tidak merekam perintah atau respons. Jika Anda memerlukan konten perintah dan respons, gunakan logging permintaan-respons.
Halaman ini menjelaskan cara mengaktifkan log metadata permintaan inferensi, isi setiap entri, dan cara membuat kueri log tersebut.
Kasus penggunaan
Log metadata permintaan inferensi menjawab pertanyaan yang tidak dapat dijawab oleh metrik gabungan:
- Atribusikan penggunaan token ke tim, aplikasi, atau tenant, dengan melampirkan label header, label permintaan, atau keduanya ke setiap permintaan.
- Lihat permintaan individual mana yang diperhitungkan dalam kuota Throughput yang Disediakan dan permintaan mana yang disajikan sesuai permintaan.
- Mengelompokkan throughput, latensi, dan tingkat error berdasarkan label header atau label permintaan.
- Mengukur perilaku caching per permintaan, bukan secara agregat.
- Dapatkan visibilitas ke penggunaan di tingkat kedua, misalnya alasan project menerima error 429, atau alasan Throughput yang Disediakan meluap. Untuk mengetahui langkah-langkah menyelesaikan error 429, lihat Memecahkan masalah kode error 429. Untuk menemukan detik yang menerimanya, lihat Tingkat error dan latensi menurut region.
Metode API yang didukung untuk logging
Log metadata permintaan inferensi didukung untuk hal berikut:
- Model Gemini yang menggunakan
generateContentataustreamGenerateContent, termasuk pembuatan gambar melalui metode tersebut. - Model Claude yang menggunakan
rawPredictataustreamRawPredict. Model partner lainnya tidak dicatat dalam log. Untuk nama kolom Claude, lihat Jumlah token untuk model Claude.
Throughput yang Disediakan dan setiap opsi bayar sesuai penggunaan didukung.
Hal berikut tidak didukung:
chatCompletions.embedContent,predict, dancountTokens. Model yang menghasilkan gambar melaluipredict, seperti Imagen, tidak dicatat dalam log.- Permintaan ke model yang telah disesuaikan, termasuk model Gemini yang disesuaikan dengan supervised fine-tuning.
- Tugas penyesuaian, inferensi batch, dan operasi yang berjalan lama lainnya.
- Model yang Anda deploy sendiri dalam container kustom.
Mengaktifkan log metadata permintaan inferensi
Anda dapat mengonfigurasi log metadata permintaan inferensi untuk seluruh project, atau untuk model tertentu di region tertentu. Jika Anda perlu mengaktifkan di tingkat organisasi, hubungi tim akun Anda. Konfigurasi logging dapat memerlukan waktu beberapa menit untuk diterapkan.
Sebelum memulai
- Pastikan Anda memiliki izin IAM berikut pada project:
aiplatform.endpoints.setPublisherModelConfigdanaiplatform.endpoints.fetchPublisherModelConfiguntuk mengubah dan membaca setelan, sertalogging.buckets.get,logging.buckets.list,logging.buckets.update, danlogging.operations.getuntuk mengupgrade bucket log. Untuk peran bawaan yang menyertakan izin ini, lihat Kontrol akses dan Kontrol akses untuk Logging. - Tentukan apakah akan
mengupgrade bucket log
_Defaultke Observability Analytics. Anda memerlukan upgrade untuk mengkueri entri dengan SQL atau untuk melihat metrik mendetail di konsol Google Cloud . Upgrade memerlukan waktu beberapa menit dan tidak dapat diurungkan. Entri yang ditulis sebelum upgrade tidak dapat dikueri dengan SQL setelahnya. - Tinjau harga Cloud Logging. Entri disimpan selama periode retensi bucket, secara default 30 hari, dan biaya penyerapan serta penyimpanan Cloud Logging berlaku. Untuk memperkirakan biaya, lihat Harga.
Mengaktifkan di konsol
Mengaktifkan di konsol akan mengaktifkan logging untuk setiap model dalam project, baik
Gemini maupun Claude, pada Throughput yang Disediakan dan setiap
opsi bayar sesuai penggunaan yang didukung log. Perintah ini juga mengupgrade bucket log _Default jika belum diupgrade. Tindakan ini menetapkan default lingkup project yang dijelaskan dalam Prioritas konfigurasi. Sebelum memulai, periksa
izin dan upgrade bucket.
Di konsol Google Cloud , buka halaman Throughput yang Disediakan.
Lakukan salah satu hal berikut:
- Di banner yang bertuliskan Gemini Enterprise Agent Platform is upgrading observability, klik Enable.
- Di toolbar, klik Setelan metrik. Pilih Enable detailed metrics, lalu klik Save.

Gambar 1. Banner upgrade kemampuan observasi di halaman Throughput yang Disediakan. 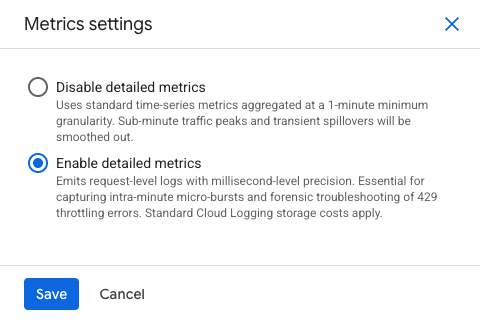
Gambar 2. Panel setelan Metrik, dengan opsi Aktifkan metrik mendetail dipilih. Dalam dialog Enable detailed metrics?, tinjau detail logging dan upgrade bucket, lalu klik Enable.
Dialog akan ditutup segera setelah logging diaktifkan. Upgrade bucket berlanjut di latar belakang dan dapat memerlukan waktu beberapa menit. Saat berjalan, banner akan menampilkan pesan
"Detailed metrics are on, and this project's _Default log bucket is being
upgraded to Observability Analytics".
Jika banner melaporkan bahwa bucket belum diupgrade, klik Upgrade untuk mencoba lagi. Jika laporan menunjukkan bahwa bucket tidak dapat diupgrade, log per permintaan tidak dapat dikueri. Klik Setelan metrik, lalu pilih Nonaktifkan metrik mendetail untuk menghentikan tagihan.
Prioritas konfigurasi
Agent Platform me-resolve setelan untuk setiap permintaan dalam urutan berikut:
- Setelan per model dan per wilayah, jika ada.
- Default di seluruh project, jika setelan per model tidak ditetapkan.
- Jika keduanya tidak ditetapkan, logging akan dinonaktifkan.
Setelan per model lebih diutamakan daripada setelan default project. Anda dapat mengaktifkan logging di seluruh project dan menonaktifkannya untuk satu model bervolume tinggi di satu region, atau sebaliknya.
Mengaktifkan dengan REST API
Anda mengonfigurasi log metadata permintaan inferensi dengan metode setPublisherModelConfig,
dengan menetapkan inferenceEventLoggingConfig.state ke ENABLED.
Untuk menetapkan default di seluruh project, alamatkan project:
curl -X POST \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://aiplatform.googleapis.com/v1beta1/projects/PROJECT_ID:setPublisherModelConfig" \
  -d '{
        "publisherModelConfig": {
          "inferenceEventLoggingConfig": {"state": "ENABLED"}
        },
        "updateMask": "inferenceEventLoggingConfig"
      }'
Untuk mengganti satu model di satu region, tentukan model penayang:
curl -X POST \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://aiplatform.googleapis.com/v1beta1/projects/PROJECT_ID/locations/LOCATION/publishers/PUBLISHER/models/MODEL:setPublisherModelConfig" \
  -d '{
        "publisherModelConfig": {
          "inferenceEventLoggingConfig": {"state": "ENABLED"}
        },
        "updateMask": "inferenceEventLoggingConfig"
      }'
Tetapkan PUBLISHER ke google untuk model Gemini dan ke anthropic untuk model Claude. Misalnya, untuk mengaktifkan logging untuk Claude Sonnet 4.5 di endpoint global, gunakan publishers/anthropic/models/claude-sonnet-4-5 dengan LOCATION ditetapkan ke global. Untuk ID model Claude, lihat
Model Claude.
Metode ini menampilkan operasi yang berjalan lama.
Mendapatkan konfigurasi logging
Baca konfigurasi saat ini dengan metode fetchPublisherModelConfig. Gunakan project untuk membaca default seluruh project, atau model penayang untuk membaca penggantiannya.
curl -X GET \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  "https://aiplatform.googleapis.com/v1beta1/projects/PROJECT_ID:fetchPublisherModelConfig"
curl -X GET \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  "https://aiplatform.googleapis.com/v1beta1/projects/PROJECT_ID/locations/LOCATION/publishers/PUBLISHER/models/MODEL:fetchPublisherModelConfig"
Responsnya berisi setelan yang ditetapkan pada resource tersebut:
{
  "inferenceEventLoggingConfig": {
    "state": "ENABLED"
  }
}
Memastikan logging berfungsi
- Kirim satu permintaan ke model yang Anda aktifkan.
Di Logs Explorer, jalankan kueri berikut. Sebagian besar entri muncul dalam waktu 12 detik; tunggu hingga 5 menit.
logName="projects/PROJECT_ID/logs/aiplatform.googleapis.com%2Finference_request"Untuk mengonfirmasi bahwa SQL berfungsi, buka Observability Analytics dan jalankan contoh kueri apa pun. Jika kueri melaporkan bahwa set data tidak ditemukan, upgrade bucket log belum selesai.
Menonaktifkan logging
Di konsol Google Cloud , buka halaman Throughput yang Disediakan, klik Metrics settings, pilih Disable detailed metrics, lalu klik Save. Tindakan ini akan membalikkan Aktifkan di konsol.
Dengan REST API, ikuti langkah-langkah berikut.
Nonaktifkan logging dengan menetapkan inferenceEventLoggingConfig.state ke DISABLED pada
resource yang sama dengan yang Anda aktifkan.
curl -X POST \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://aiplatform.googleapis.com/v1beta1/projects/PROJECT_ID:setPublisherModelConfig" \
  -d '{
        "publisherModelConfig": {
          "inferenceEventLoggingConfig": {"state": "DISABLED"}
        },
        "updateMask": "inferenceEventLoggingConfig"
      }'
Karena setelan per model lebih diutamakan daripada setelan default project, menonaktifkan di level project tidak akan menonaktifkan model yang diaktifkan secara eksplisit. Hapus atau nonaktifkan juga setelan per model.
Tempat log ditulis
Entri ditulis ke log berikut:
projects/PROJECT_NUMBER/logs/aiplatform.googleapis.com%2Finference_request
Dari sana, Anda memiliki tujuan Cloud Logging standar:
- Observability Analytics: Buat kueri entri dengan SQL di Observability Analytics di konsolGoogle Cloud .
- Set data BigQuery tertaut: Tautkan set data untuk membaca data yang sama dari BigQuery. Untuk mengetahui detailnya, lihat Membuat kueri set data BigQuery tertaut.
- Sink gabungan: Mengumpulkan entri dari setiap project di folder atau organisasi dengan satu sink. Filter di
logName="projects/*/logs/aiplatform.googleapis.com%2Finference_request".
Untuk mengumpulkan entri dari setiap project dalam folder atau organisasi, lihat Ringkasan sink gabungan.
Entri dapat dikueri beberapa saat setelah permintaan selesai. Sebagian besar entri dapat dikueri dalam waktu 12 detik; tunggu hingga 5 menit.
Skema entri log
Setiap entri memiliki dua bagian yang Anda buat kuerinya secara terpisah: resource yang dimonitor dan labelnya, yang mengidentifikasi apa yang menyajikan permintaan, dan payload JSON, yang mencatat apa yang dilakukan permintaan. Bagian berikut menjelaskan keduanya.
Label resource
Untuk model penayang bersama, jenis resource yang dimonitor adalah
aiplatform.googleapis.com/PublisherModel, dengan label berikut.
| Label | Jenis | Catatan |
|---|---|---|
resource_container |
STRING |
Project yang menyajikan permintaan tersebut. |
location |
STRING |
Region yang menyajikan permintaan, misalnya us-central1. Permintaan yang dikirim ke endpoint global melaporkan global. |
publisher |
STRING |
Penayang model, misalnya google atau anthropic. |
model_user_id |
STRING |
Modelnya, misalnya gemini-2.5-pro. |
Kolom payload
| Nama kolom | Jenis | Catatan |
|---|---|---|
method |
ENUM |
GENERATE_CONTENT, STREAM_GENERATE_CONTENT, RAW_PREDICT, atau STREAM_RAW_PREDICT. |
trafficType |
ENUM |
Opsi konsumsi yang menyajikan permintaan. Nilai saat ini adalah PROVISIONED_THROUGHPUT, ON_DEMAND, ON_DEMAND_FLEX, dan ON_DEMAND_PRIORITY. Tidak ada pada permintaan yang gagal. |
requestStartTime |
TIMESTAMP |
Waktu saat frontend penayangan menerima permintaan. |
requestDuration |
STRING |
Latensi penyajian menyeluruh, yang diformat sebagai string durasi seperti 3.53s. |
generateContentDetails.usageMetadata |
JSON |
Jumlah token untuk generateContent dan streamGenerateContent, termasuk perincian per modalitas. Output gambar muncul di sini sebagai entri IMAGE di candidatesTokensDetails. |
rawPredictDetails.usageMetadata |
JSON |
Jumlah token untuk rawPredict dan streamRawPredict, termasuk model partner. |
provisionedThroughput |
JSON |
Hadir untuk traffic Throughput yang Disediakan. |
httpHeaders |
JSON |
Header permintaan yang diambil. |
error |
JSON |
Hanya ada jika tingkat keparahan adalah ERROR. |
principal |
JSON |
Akun layanan yang mengeluarkan permintaan, jika tersedia. |
Kolom LogEntry.labels membawa gen_ai.operation.name, yang mengikuti konvensi semantik GenAI OpenTelemetry. generateContent dan
streamGenerateContent melaporkan generate_content. rawPredict dan
streamRawPredict melaporkan raw_predict.
Kolom Throughput yang Disediakan
| Nama kolom | Jenis | Catatan |
|---|---|---|
ptChargedInputTokenCount |
INT64 |
Token input yang mengurangi kuota Throughput yang Disediakan, setelah tarif burndown diterapkan. |
ptChargedOutputTokenCount |
INT64 |
Token output yang mengurangi kuota Throughput yang Disediakan, setelah tarif burndown diterapkan. |
accountingResource |
STRING |
Project yang komitmen Throughput yang Disediakan-nya digunakan oleh permintaan. |
Mengidentifikasi permintaan limpahan
Permintaan akan meluap jika memenuhi syarat untuk Throughput yang Disediakan, tetapi
disajikan sesuai permintaan karena throughput Anda telah habis. Entri spillover memiliki
trafficType dari ON_DEMAND dan tidak ada objek provisionedThroughput. Permintaan
bayar sesuai penggunaan biasa terlihat sama, jadi gunakan aturan berikut untuk
membedakannya:
- Jika Anda mengirim
X-Vertex-AI-LLM-Request-Typedengan nilaishared, Anda sengaja mengarahkan permintaan ke bayar sesuai penggunaan. Ini bukan limpahan. - Jika Anda tidak mengirim header
X-Vertex-AI-LLM-Request-Type, atau nilai selaindedicatedataushared, dan entri melaporkanON_DEMAND, permintaan akan meluap, asalkan Anda memiliki Throughput yang Disediakan untuk model tersebut di region tersebut. - Jika Anda tidak memiliki Throughput yang Disediakan untuk model, setiap entri
ON_DEMANDadalah bayar sesuai penggunaan biasa.
Untuk nilai header, lihat Menggunakan Throughput yang Disediakan.
Untuk kueri yang menghitung permintaan spillover, lihat Spillover per menit.
Mengidentifikasi permintaan yang didowngrade
Permintaan akan didowngrade jika Anda meminta satu opsi bayar sesuai penggunaan dan permintaan tersebut
dilayani di opsi lain. Bandingkan header X-Vertex-AI-LLM-Shared-Request-Type yang Anda kirim dengan trafficType yang menyajikan permintaan:
| Nilai header yang Anda kirim | trafficType saat disajikan sesuai permintaan |
|---|---|
priority |
ON_DEMAND_PRIORITY |
flex |
ON_DEMAND_FLEX |
trafficType lainnya pada entri yang berhasil berarti permintaan telah didowngrade,
atau model tidak menawarkan opsi yang Anda minta. Untuk kueri, lihat
Downgrade menurut model.
Kode error
Permintaan yang gagal ditulis dengan tingkat keparahan ERROR dan membawa objek error dengan kode status gRPC dan alasan kanonis. Alasannya adalah string tetap. Log ini tidak pernah berisi teks perintah, teks respons, atau nilai header Anda.
| Kode | Status | Status HTTP umum |
|---|---|---|
8 |
Resource telah habis, misalnya batas kuota. | 429 |
4 |
Batas waktu berakhir sebelum operasi selesai. | 504 |
14 |
Layanan tidak tersedia. | 503 |
13 |
Terjadi error internal. | 500 |
3 |
Permintaan berisi argumen yang tidak valid. | 400 |
7 |
Pemanggil tidak memiliki izin. | 403 |
5 |
Entitas yang diminta tidak ditemukan. | 404 |
Melampirkan label header kustom
Untuk mengatribusikan penggunaan ke dimensi Anda sendiri, seperti tim, aplikasi, atau tenant, kirim header permintaan dengan awalan x-goog-agent-platform-observability-label-:
x-goog-agent-platform-observability-label-team: payments
x-goog-agent-platform-observability-label-application: invoice-ocr
Setiap header muncul dalam entri di bagian jsonPayload.httpHeaders. Label header
berfungsi pada model Gemini dengan generateContent dan
streamGenerateContent, serta pada model Claude dengan rawPredict dan
streamRawPredict, pada Throughput yang Disediakan dan setiap opsi
bayar sesuai penggunaan.
Untuk contoh panggilan API dengan label header, entri log yang dihasilkan, model yang didukung, batasan, dan perbandingan label header dengan label permintaan, lihat Label metadata kustom. Untuk membuat kueri, lihat Penggunaan menurut label header kustom.
Membuat kueri log dengan Logs Explorer
Gunakan Logs Explorer untuk menemukan dan memeriksa setiap permintaan inferensi. Alat ini tidak memerlukan penyiapan selain mengaktifkan logging, dan membaca log secara langsung, sehingga entri terlihat segera setelah tiba.
Di konsol Google Cloud , buka halaman Logs Explorer dan masukkan kueri di kolom editor kueri menggunakan Logging query language. Untuk mengetahui informasi selengkapnya tentang panel dan kontrol, lihat Antarmuka Logs Explorer.
Mulai dari nama log, yang memilih setiap entri permintaan inferensi dalam project:
logName="projects/PROJECT_ID/logs/aiplatform.googleapis.com%2Finference_request"
Tambahkan istilah untuk mempersempit hasil. Istilah pada baris terpisah digabungkan dengan AND.
- Untuk memilih permintaan yang disajikan dari satu region, tambahkan
resource.labels.location="us-central1". - Untuk memilih satu metode API, tambahkan
jsonPayload.method="GENERATE_CONTENT". - Untuk memilih traffic Throughput yang Disediakan saja, tambahkan
jsonPayload.trafficType="PROVISIONED_THROUGHPUT". - Untuk memilih error kuota saja, tambahkan
severity=ERRORdanjsonPayload.error.code=8. - Untuk memilih satu nilai label header kustom, tambahkan
jsonPayload.httpHeaders."x-goog-agent-platform-observability-label-team".values="payments".
Logs Explorer memfilter dan menampilkan entri. Google tidak menggabungkannya. Untuk menghitung, mengelompokkan, atau membuat diagram entri Anda, gunakan Observability Analytics. Di toolbar Query results, klik Analyze results untuk membawa kueri Anda saat ini. Tombol tersebut hanya muncul setelah bucket log diupgrade.
Membuat kueri dan menganalisis log dengan Observability Analytics
Anda dapat menggunakan Observability Analytics untuk membuat kueri dan menganalisis log.
Sebelum memulai
Observability Analytics menjawab pertanyaan yang tidak dapat dijawab oleh Logs Explorer. Logs Explorer menemukan dan menampilkan setiap entri, yang Anda inginkan saat mengejar satu permintaan. Observability Analytics menjalankan SQL di seluruh set, sehingga dapat menghitung, mengelompokkan, menggabungkan, dan menghitung persentil. Setiap pertanyaan di bagian ini memerlukan agregasi: pembelanjaan per tim, burndown per project, dan latensi p95 per region tidak dapat dijawab satu per satu.
Hal ini mengharuskan bucket log _Default di project Anda diupgrade untuk menggunakan
Observability Analytics. Untuk mengetahui informasi selengkapnya, lihat Mengonfigurasi bucket log.
Contoh berikut berjalan di Observability Analytics. Ganti PROJECT_ID dengan project Anda.
Throughput menurut region dan model
SELECT
  JSON_VALUE(resource.labels.location)      AS region,
  JSON_VALUE(resource.labels.model_user_id) AS model,
  JSON_VALUE(json_payload.trafficType)      AS traffic_type,
  COUNT(*)                                  AS requests,
  SUM(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.promptTokenCount) AS INT64))     AS input_tokens,
  SUM(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.candidatesTokenCount) AS INT64)) AS output_tokens
FROM `PROJECT_ID.global._Default._Default`
WHERE log_id = "aiplatform.googleapis.com/inference_request"
  AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 24 HOUR)
GROUP BY region, model, traffic_type
ORDER BY requests DESC
Pengurangan Throughput yang Disediakan menurut project
SELECT
  JSON_VALUE(resource.labels.location) AS region,
  JSON_VALUE(json_payload.provisionedThroughput.accountingResource) AS pt_project,
  COUNTIF(JSON_VALUE(json_payload.trafficType) = "PROVISIONED_THROUGHPUT") AS pt_requests,
  COUNTIF(JSON_VALUE(json_payload.trafficType) = "ON_DEMAND")              AS on_demand_requests,
  SUM(CAST(JSON_VALUE(json_payload.provisionedThroughput.ptChargedInputTokenCount)  AS INT64)) AS pt_input_tokens,
  SUM(CAST(JSON_VALUE(json_payload.provisionedThroughput.ptChargedOutputTokenCount) AS INT64)) AS pt_output_tokens
FROM `PROJECT_ID.global._Default._Default`
WHERE log_id = "aiplatform.googleapis.com/inference_request"
  AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 24 HOUR)
GROUP BY region, pt_project
ORDER BY pt_input_tokens DESC
Penggunaan menurut label header kustom
SELECT
  JSON_VALUE(json_payload.httpHeaders
    ["x-goog-agent-platform-observability-label-team"].values[0]) AS team,
  COUNT(*) AS requests,
  SUM(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.totalTokenCount) AS INT64)) AS total_tokens
FROM `PROJECT_ID.global._Default._Default`
WHERE log_id = "aiplatform.googleapis.com/inference_request"
  AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 7 DAY)
GROUP BY team
ORDER BY total_tokens DESC
Token yang digunakan per menit, Gemini dan Claude secara berdampingan
Kueri ini melaporkan token yang digunakan per menit dalam satu kolom per penayang. Setiap kolom memberi bobot pada jenis token dengan cara yang sama seperti metrik publisher/online_serving/consumed_token_throughput untuk penayang tersebut, sehingga setiap kolom cocok dengan Cloud Monitoring. Gemini dan Claude memberi bobot pada token output dan cache secara berbeda, jadi jangan menjumlahkan kedua kolom tersebut. Untuk kolom Claude, lihat
Jumlah token untuk model Claude.
SELECT
  TIMESTAMP_TRUNC(timestamp, MINUTE) AS minute_ts,
  SUM(IF(JSON_VALUE(resource.labels.publisher) = "google",
    IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.promptTokenCount) AS INT64), 0)
      + IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.toolUsePromptTokenCount) AS INT64), 0)
      - 0.9 * IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.cachedContentTokenCount) AS INT64), 0)
      + IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.candidatesTokenCount) AS INT64), 0)
      + IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.thoughtsTokenCount) AS INT64), 0), 0)) AS gemini_consumed_tokens,
  SUM(IF(JSON_VALUE(resource.labels.publisher) = "anthropic",
    IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.input_tokens) AS INT64), 0)
      + 0.1  * IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.cache_read_input_tokens) AS INT64), 0)
      + 1.25 * IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.cache_creation_input_tokens) AS INT64), 0)
      + 0.75 * IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.cache_creation.ephemeral_1h_input_tokens) AS INT64), 0)
      + 5    * IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.output_tokens) AS INT64), 0), 0)) AS claude_consumed_tokens
FROM `PROJECT_ID.global._Default._Default`
WHERE log_id = "aiplatform.googleapis.com/inference_request"
  AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 24 HOUR)
GROUP BY minute_ts
ORDER BY minute_ts DESC
Rasio cache ditemukan di Gemini dan Claude
Rasio cache ditemukan adalah token input yang di-cache dibagi dengan total token input. Input Gemini menyertakan token penggunaan alat, karena cache dapat mencakupnya. Input Claude adalah input yang tidak di-cache ditambah pembacaan cache ditambah penulisan cache. Untuk mengetahui cara setiap penayang melakukan caching, lihat Ringkasan caching konteks dan Caching perintah Claude.
SELECT
  JSON_VALUE(resource.labels.model_user_id) AS model,
  JSON_VALUE(json_payload.trafficType)      AS traffic_type,
  ROUND(100 * SAFE_DIVIDE(
    SUM(IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.cachedContentTokenCount) AS INT64), 0)
      + IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.cache_read_input_tokens) AS INT64), 0)),
    SUM(GREATEST(
          IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.promptTokenCount) AS INT64), 0)
          + IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.toolUsePromptTokenCount) AS INT64), 0),
          IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.cachedContentTokenCount) AS INT64), 0))
      + IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.input_tokens) AS INT64), 0)
      + IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.cache_read_input_tokens) AS INT64), 0)
      + IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.cache_creation_input_tokens) AS INT64), 0))), 1) AS cache_hit_rate_pct
FROM `PROJECT_ID.global._Default._Default`
WHERE log_id = "aiplatform.googleapis.com/inference_request"
  AND JSON_VALUE(json_payload.trafficType) IS NOT NULL
  AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 7 DAY)
GROUP BY model, traffic_type
ORDER BY model, traffic_type
Downgrade menurut model
Kueri ini membandingkan opsi bayar sesuai penggunaan yang diminta setiap permintaan dengan opsi yang menyajikannya. Untuk mengetahui cara downgrade diidentifikasi, lihat Mengidentifikasi permintaan yang didowngrade.
WITH entries AS (
  SELECT
    JSON_VALUE(resource.labels.model_user_id) AS model,
    severity,
    JSON_VALUE(json_payload.trafficType)      AS served,
    (SELECT LOWER(v)
     FROM UNNEST(JSON_VALUE_ARRAY(json_payload.httpHeaders["x-vertex-ai-llm-shared-request-type"].values)) AS v
     WHERE LOWER(v) IN ("priority", "flex")
     LIMIT 1)                                 AS requested
  FROM `PROJECT_ID.global._Default._Default`
  WHERE log_id = "aiplatform.googleapis.com/inference_request"
    AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 7 DAY)
)
SELECT
  model,
  requested,
  COUNTIF(served = CONCAT("ON_DEMAND_", UPPER(requested))) AS served_as_requested,
  COUNTIF(served IS NOT NULL
          AND served != CONCAT("ON_DEMAND_", UPPER(requested))) AS downgraded,
  COUNTIF(severity = "ERROR")                              AS failed
FROM entries
WHERE requested IS NOT NULL
GROUP BY model, requested
ORDER BY downgraded DESC
Limpahan per menit
Kueri ini menghitung permintaan spillover per menit untuk setiap model yang memiliki traffic Throughput yang Disediakan dalam periode tersebut. Untuk mengetahui cara mengidentifikasi limpahan, lihat Mengidentifikasi permintaan limpahan.
WITH entries AS (
  SELECT
    timestamp,
    JSON_VALUE(resource.labels.location)      AS region,
    JSON_VALUE(resource.labels.model_user_id) AS model,
    JSON_VALUE(json_payload.trafficType)      AS traffic_type,
    EXISTS(
      SELECT 1
      FROM UNNEST(JSON_VALUE_ARRAY(json_payload.httpHeaders["x-vertex-ai-llm-request-type"].values)) AS v
      WHERE LOWER(v) IN ("dedicated", "shared")) AS routed_by_header
  FROM `PROJECT_ID.global._Default._Default`
  WHERE log_id = "aiplatform.googleapis.com/inference_request"
    AND severity = "INFO"
    AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 24 HOUR)
),
pt_models AS (
  SELECT DISTINCT region, model FROM entries WHERE traffic_type = "PROVISIONED_THROUGHPUT"
)
SELECT
  TIMESTAMP_TRUNC(e.timestamp, MINUTE) AS minute_ts,
  e.region,
  e.model,
  COUNTIF(e.traffic_type = "PROVISIONED_THROUGHPUT")              AS pt_requests,
  COUNTIF(e.traffic_type = "ON_DEMAND" AND NOT e.routed_by_header) AS spillover_requests
FROM entries AS e
JOIN pt_models USING (region, model)
GROUP BY minute_ts, e.region, e.model
HAVING spillover_requests > 0
ORDER BY minute_ts DESC
Tingkat error dan latensi berdasarkan region
SELECT
  JSON_VALUE(resource.labels.location) AS region,
  TIMESTAMP_TRUNC(timestamp, MINUTE)   AS minute_ts,
  COUNT(*)                             AS total,
  COUNTIF(severity = "ERROR")          AS errors,
  COUNTIF(CAST(JSON_VALUE(json_payload.error.code) AS INT64) = 8) AS resource_exhausted,
  APPROX_QUANTILES(
    CAST(REGEXP_REPLACE(JSON_VALUE(json_payload.requestDuration), r"s$", "") AS FLOAT64),
    100)[OFFSET(95)] AS p95_latency_seconds
FROM `PROJECT_ID.global._Default._Default`
WHERE log_id = "aiplatform.googleapis.com/inference_request"
  AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 6 HOUR)
GROUP BY region, minute_ts
ORDER BY minute_ts DESC
Jumlah token untuk model Claude
Model Claude melaporkan penggunaan di bagian rawPredictDetails.usageMetadata, dengan nama kolom Claude API. rawPredict dan streamRawPredict menulis kolom yang sama; untuk streaming, log menggabungkan penggunaan yang dilaporkan dalam streaming.
| Kolom | Yang dihitung |
|---|---|
input_tokens |
Token input yang tidak dibaca dari atau ditulis ke cache. |
cache_read_input_tokens |
Token input yang dibaca dari cache perintah. |
cache_creation_input_tokens |
Token input yang ditulis ke cache perintah, kedua TTL digabungkan. |
cache_creation.ephemeral_5m_input_tokens |
Cache menulis dengan TTL 5 menit. |
cache_creation.ephemeral_1h_input_tokens |
Cache menulis dengan TTL 1 jam. |
output_tokens |
Token output, termasuk penalaran ekstensif. Jangan menambahkan token penalaran secara terpisah. |
Total input Claude adalah input_tokens ditambah cache_read_input_tokens ditambah
cache_creation_input_tokens. Gemini berbeda: promptTokenCount
sudah menyertakan token yang di-cache.
Entri Claude tidak memiliki perincian modalitas. Label header berfungsi dengan cara yang sama untuk Gemini dan Claude; lihat Melampirkan label header kustom.
Harga
Logging metadata permintaan inferensi menulis ke Cloud Logging dan ditagih sebagai penyerapan dan penyimpanan Cloud Logging. Pembuatan kueri melalui Observability Analytics ditagih sebagai penggunaan Cloud Monitoring. Menautkan set data BigQuery tidak akan menambah biaya penyimpanan BigQuery.
Ukuran entri bergantung pada permintaan Anda, misalnya pada jumlah label header yang dimuat. Untuk memperkirakan biaya, aktifkan logging untuk workload yang representatif selama sehari, ukur volume yang diserap dengan Analisis volume log, lalu proyeksikan volume bulanan Anda di Google Cloud kalkulator harga.
Langkah berikutnya
- Pelajari cara memantau model dengan metrik.
- Pelajari cara memantau biaya menggunakan label metadata kustom.
- Gunakan logging permintaan-respons jika Anda memerlukan konten perintah dan respons.
- Baca tentang Throughput yang Disediakan.
- Lihat metrik mendetail untuk Throughput yang Disediakan di konsol Google Cloud .
- Pecahkan masalah error 429.
- Kumpulkan entri dari setiap project dalam folder atau organisasi dengan sink gabungan.