


פלטפורמת Agent יכולה לכתוב רשומת יומן מובנית אחת לכל בקשת הסקה שהפרויקט שלכם משרת. כל רשומה מתעדת מטא-נתונים על הבקשה: המודל, האזור, מספר הטוקנים (כולל טוקנים של קלט, טוקנים של פלט, טוקנים במטמון, טוקנים של שלבים בתהליך החשיבה), הקצאת משאבים לפי התפוקה שנקבעה, זמן האחזור של הבקשה מקצה לקצה, קוד השגיאה וכל התוויות של הכותרות או התוויות של הבקשות שאתם מצרפים. הרשומות נשלחות ל-Cloud Logging, ואפשר לשלוח שאילתות לגביהן באמצעות SQL ב-Observability Analytics. כדי להפעיל את הרישום ביומן, קראו את המאמר הפעלת יומני המטא-נתונים של בקשות להסקת נתונים.
רישום בקשות ההסקה ביומן מתעד מטא-נתונים בלבד. הוא לא מתעד הנחיות או תשובות. אם אתם צריכים את התוכן של ההנחיה והתשובה, השתמשו במקום זאת ברישום ביומן של בקשות ותגובות.
בדף הזה מוסבר איך להפעיל יומני מטא-נתונים של בקשות להסקת נתונים, מה כל רשומה מכילה ואיך לשלוח שאילתות לגביהם.
תרחישים לדוגמה
יומני המטא-נתונים של בקשות להסקת מסקנות עונים על שאלות שמדדים נצברים לא יכולים לענות עליהן:
- כדי לשייך את הוצאת האסימונים לצוות, לאפליקציה או לדייר, אתם יכולים לצרף לכל בקשה תוויות כותרת, תוויות בקשה או את שתיהן.
- אתם יכולים לראות אילו בקשות נספרו במכסה של הקצאת המשאבים לפי התפוקה שנקבעה, ואילו בקשות טופלו על פי דרישה.
- פירוט של קצב העברת הנתונים, זמן האחזור ושיעור השגיאות לפי תוויות של כותרות או תוויות של בקשות.
- למדוד את התנהגות השמירה במטמון לכל בקשה, במקום באופן מצטבר.
- לקבל תובנות לגבי השימוש ברמת השנייה, למשל למה פרויקט קיבל שגיאות 429 או למה הייתה חריגה מהקצאת המשאבים לפי התפוקה שנקבעה. כדי לפתור שגיאות 429, עיינו במאמר פתרון בעיות בקוד שגיאה 429. כדי למצוא את השניות שבהן התקבלו השגיאות, אפשר לעיין בקטע שיעור השגיאות וזמן האחזור לפי אזור.
שיטות API נתמכות לרישום ביומן
אפשר להשתמש ביומני מטא-נתונים של בקשות להסקת מסקנות במקרים הבאים:
- מודלים של Gemini שמשתמשים ב-
generateContentאו ב-streamGenerateContent, כולל יצירת תמונות באמצעות השיטות האלה. - מודלים של Claude שמשתמשים ב-
rawPredictאו ב-streamRawPredict. מודלים של שותפים אחרים לא מתועדים ביומן. לשמות השדות של Claude, ראו ספירת טוקנים במודלים של Claude.
יש תמיכה בהקצאת משאבים לפי התפוקה שנקבעה ובכל אפשרות של תשלום לפי שימוש.
אין תמיכה בתכונות הבאות:
chatCompletions.-
embedContent,predictוגםcountTokens. מודלים שיוצרים תמונות באמצעותpredict, כמו Imagen, לא מתועדים ביומן. - בקשות למודלים שעברו כוונון עדין, כולל מודלים של Gemini שעברו כוונון עדין בפיקוח.
- משימות כוונון, הסקת מסקנות באצווה וכל פעולה ממושכת אחרת.
- מודלים שאתם פורסים בעצמכם בקונטיינר בהתאמה אישית.
הפעלת יומני מטא-נתונים של בקשות להסקת מסקנות
אפשר להגדיר יומני מטא-נתונים של בקשות להסקת מסקנות לפרויקט שלם, או למודל ספציפי באזור ספציפי. אם אתם צריכים להפעיל את התכונה ברמת הארגון, פנו לצוות ניהול החשבון. יכול להיות שיעברו כמה דקות עד שההגדרות של רישום ביומן ייכנסו לתוקף.
לפני שמתחילים
- מוודאים שיש לכם את ההרשאות הבאות של IAM בפרויקט:
aiplatform.endpoints.setPublisherModelConfigו-aiplatform.endpoints.fetchPublisherModelConfigכדי לשנות ולקרוא את ההגדרה, ו-logging.buckets.get,logging.buckets.list,logging.buckets.updateו-logging.operations.getכדי לשדרג את קטגוריית היומנים. במאמרים בקרת גישה ובקרת גישה ל-Logging מפורטים התפקידים המוגדרים מראש שכוללים את ההרשאות האלה. - מחליטים אם לשדרג את קטגוריית היומנים
_Defaultל-Observability Analytics. כדי לשלוח שאילתות לרשומות באמצעות SQL או כדי להציג מדדים מפורטים במסוף Google Cloud , צריך לשדרג. השדרוג נמשך כמה דקות ואי אפשר לבטל אותו. אי אפשר להריץ שאילתות SQL על רשומות שנכתבו לפני השדרוג. - התמחור של Cloud Logging הרשומות נשמרות למשך תקופת השמירה של הקטגוריה, כברירת מחדל 30 יום, וכוללות חיובים על הטמעה ואחסון ב-Cloud Logging. במחירון תוכלו לראות אומדן של העלויות.
הפעלה במסוף
כשמפעילים את הרישום ביומן במסוף, הוא מופעל לכל מודל בפרויקט, גם Gemini וגם Claude, בהקצאת משאבים לפי התפוקה שנקבעה ובכל אפשרות של תשלום לפי שימוש שהיומנים תומכים בה. הוא גם משדרג את קטגוריית היומנים _Default אם היא לא שודרגה. היא מגדירה את ברירת המחדל ברמת הפרויקט, כפי שמתואר בקטע סדר הקדימויות של ההגדרות. לפני שמתחילים, צריך לבדוק את ההרשאות ואת שדרוג הקטגוריה.
במסוף Google Cloud , נכנסים לדף הקצאת משאבים לפי התפוקה שנקבעה.
מבצעים אחת מהפעולות הבאות:
- בבאנר Gemini Enterprise Agent Platform is upgrading observability, לוחצים על Enable.
- בסרגל הכלים, לוחצים על הגדרות המדדים. בוחרים באפשרות Enable detailed metrics ולוחצים על Save.

תרשים 1. הבאנר לשדרוג יכולת התצפית בדף "הקצאת משאבים לפי התפוקה שנקבעה". 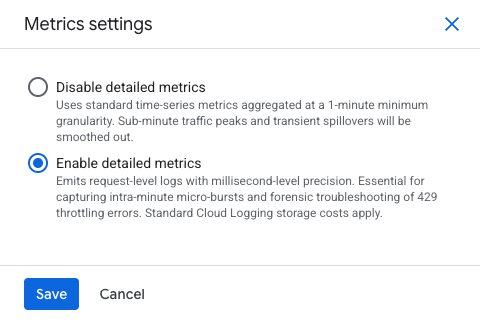
איור 2. חלונית ההגדרות של המדדים, עם האפשרות "הפעלת מדדים מפורטים" מסומנת. בתיבת הדו-שיח Enable detailed metrics?, בודקים את פרטי הרישום ביומן ושדרוג הקטגוריה ולוחצים על Enable.
תיבת הדו-שיח נסגרת ברגע שהרישום ביומן מופעל. שדרוג הקטגוריה ממשיך ברקע ויכול להימשך כמה דקות. בזמן שהשדרוג פועל, בבאנר מופיע הכיתוב "המדדים המפורטים מופעלים, ודלי היומנים _Default של הפרויקט הזה משודרג ל-Observability Analytics".
אם בבאנר מדווח שהקטגוריה לא שודרגה, לוחצים על Upgrade כדי לנסות שוב. אם מדווח שהקטגוריה לא ניתנת לשדרוג, אי אפשר לשלוח שאילתות ליומנים לפי בקשה. לוחצים על הגדרות המדדים ובוחרים באפשרות השבתת מדדים מפורטים כדי להפסיק את החיובים.
סדר הקדימויות של ההגדרות
פלטפורמת Agent פותרת את ההגדרה של כל בקשה בסדר הבא:
- ההגדרה לפי דגם ולפי אזור, אם הוגדרה כזו.
- ברירת המחדל ברמת הפרויקט, אם ההגדרה ברמת המודל לא הוגדרה.
- אם אף אחת מהן לא מוגדרת, הרישום ביומן מושבת.
ההגדרה לכל מודל מקבלת עדיפות על פני ברירת המחדל של הפרויקט. אתם יכולים להפעיל את הרישום ביומן בכל הפרויקט ולהשבית אותו במודל אחד עם נפח גבוה באזור אחד, או להפך.
הפעלה באמצעות ה-API בארכיטקטורת REST
כדי להגדיר יומני מטא-נתונים של בקשות להסקת נתונים, משתמשים ב-method setPublisherModelConfig ומגדירים את inferenceEventLoggingConfig.state ל-ENABLED.
כדי להגדיר את ברירת המחדל ברמת הפרויקט, צריך לציין את הפרויקט:
curl -X POST \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://aiplatform.googleapis.com/v1beta1/projects/PROJECT_ID:setPublisherModelConfig" \
  -d '{
        "publisherModelConfig": {
          "inferenceEventLoggingConfig": {"state": "ENABLED"}
        },
        "updateMask": "inferenceEventLoggingConfig"
      }'
כדי לשנות מודל אחד באזור אחד, צריך לפנות למודל של בעל האתר:
curl -X POST \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://aiplatform.googleapis.com/v1beta1/projects/PROJECT_ID/locations/LOCATION/publishers/PUBLISHER/models/MODEL:setPublisherModelConfig" \
  -d '{
        "publisherModelConfig": {
          "inferenceEventLoggingConfig": {"state": "ENABLED"}
        },
        "updateMask": "inferenceEventLoggingConfig"
      }'
מגדירים את PUBLISHER לערך google למודלי Gemini ולערך anthropic למודלי Claude. לדוגמה, כדי להפעיל את הרישום ביומן של Claude Sonnet 4.5 בנקודת הקצה הגלובלית, משתמשים ב-publishers/anthropic/models/claude-sonnet-4-5 ומגדירים את LOCATION ל-global. במאמר מודלים של Claude מפורטים מזהי המודלים של Claude.
השיטה מחזירה פעולה ממושכת.
אחזור של הגדרת הרישום ביומן
קוראים את ההגדרות האישיות הנוכחיות באמצעות השיטה fetchPublisherModelConfig. כדי לקרוא את ברירת המחדל ברמת הפרויקט, משתמשים בפרויקט. כדי לקרוא את ההגדרה שמחליפה את ברירת המחדל, משתמשים במודל של בעל התוכן הדיגיטלי.
curl -X GET \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  "https://aiplatform.googleapis.com/v1beta1/projects/PROJECT_ID:fetchPublisherModelConfig"
curl -X GET \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  "https://aiplatform.googleapis.com/v1beta1/projects/PROJECT_ID/locations/LOCATION/publishers/PUBLISHER/models/MODEL:fetchPublisherModelConfig"
התשובה מכילה את ההגדרות שנקבעו במשאב הזה:
{
  "inferenceEventLoggingConfig": {
    "state": "ENABLED"
  }
}
איך לוודא שהרישום ביומן פועל
- שולחים בקשה אחת למודל שהפעלתם.
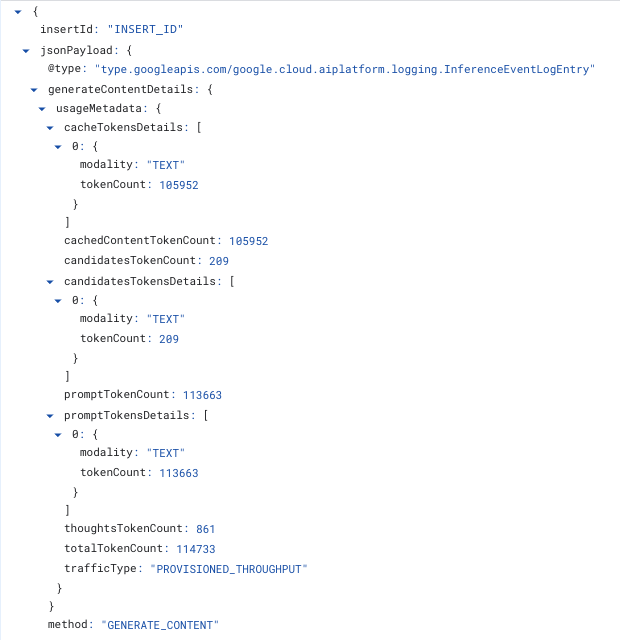
ב-Logs Explorer, מריצים את השאילתה הבאה. רוב הרשומות מופיעות תוך 12 שניות, אבל לפעמים זה יכול לקחת עד 5 דקות.
logName="projects/PROJECT_ID/logs/aiplatform.googleapis.com%2Finference_request"כדי לוודא ש-SQL פועל, פותחים את Observability Analytics ומריצים שאילתה לדוגמה. אם השאילתה מדווחת שקבוצת הנתונים לא נמצאה, סימן ששדרוג קטגוריית היומנים לא הסתיים.
השבתת רישום ביומן
במסוף Google Cloud , נכנסים לדף Provisioned Throughput, לוחצים על Metrics settings, בוחרים באפשרות Disable detailed metrics ולוחצים על Save. הפעולה הזו מבטלת את ההפעלה במסוף.
כדי לעשות את זה באמצעות ה-API בארכיטקטורת REST, פועלים לפי השלבים הבאים.
כדי להשבית את הרישום ביומן, מגדירים את inferenceEventLoggingConfig.state ל-DISABLED באותו משאב שבו הפעלתם אותו.
curl -X POST \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://aiplatform.googleapis.com/v1beta1/projects/PROJECT_ID:setPublisherModelConfig" \
  -d '{
        "publisherModelConfig": {
          "inferenceEventLoggingConfig": {"state": "DISABLED"}
        },
        "updateMask": "inferenceEventLoggingConfig"
      }'
הגדרה ברמת המודל מקבלת עדיפות על פני ברירת המחדל של הפרויקט, ולכן השבתה ברמת הפרויקט לא משביתה מודל שהופעל באופן מפורש. צריך גם לנקות או להשבית את ההגדרה לכל מודל.
איפה היומנים נכתבים
הרשומות נכתבות ביומן הבא:
projects/PROJECT_NUMBER/logs/aiplatform.googleapis.com%2Finference_request
משם אפשר להשתמש ביעדים הרגילים של Cloud Logging:
- Observability Analytics: שליחת שאילתות לרשומות באמצעות SQL ב-Observability Analytics במסוףGoogle Cloud .
- מערך נתונים מקושר ב-BigQuery: קישור של מערך נתונים כדי לקרוא את אותם נתונים מ-BigQuery. לפרטים נוספים, קראו את המאמר שליחת שאילתות למערך נתונים מקושר ב-BigQuery.
- כיורים נצברים: איסוף רשומות מכל פרויקט בתיקייה או בארגון באמצעות כיור אחד. סינון לפי
logName="projects/*/logs/aiplatform.googleapis.com%2Finference_request".
כדי לאסוף רשומות מכל פרויקט בתיקייה או בארגון, קראו את המאמר סקירה כללית של אובייקטים נצברים מסוג sink.
זמן קצר אחרי שהבקשה מסתיימת, אפשר לשלוח שאילתות לגבי הרשומות. אפשר לשלוח שאילתות לגבי רוב הרשומות תוך 12 שניות, אבל לפעמים זה לוקח עד 5 דקות.
סכימת הרשומה ביומן
לכל רשומה יש שני חלקים ששולחים אליהם שאילתות בנפרד: המשאב במעקב והתוויות שלו, שמזהים מה טיפל בבקשה, והמטען הייעודי (payload) בפורמט JSON, שמתעד מה הבקשה עשתה. בקטעים הבאים מתוארות שתי השיטות.
תוויות של משאבים
במודלים משותפים של בעלי תוכן דיגיטלי, סוג המשאב במעקב הוא aiplatform.googleapis.com/PublisherModel, עם התוויות הבאות.
| תווית | סוג | הערות |
|---|---|---|
resource_container |
STRING |
הפרויקט שטיפל בבקשה. |
location |
STRING |
האזור שבו הבקשה טופלה, לדוגמה us-central1. בקשות שנשלחות לנקודת הקצה הגלובלית מדווחות על global. |
publisher |
STRING |
מפתח המודל, לדוגמה google או anthropic. |
model_user_id |
STRING |
המודל, למשל gemini-2.5-pro. |
שדות המטען הייעודי (payload)
| שם השדה | סוג | הערות |
|---|---|---|
method |
ENUM |
GENERATE_CONTENT, STREAM_GENERATE_CONTENT, RAW_PREDICT או STREAM_RAW_PREDICT. |
trafficType |
ENUM |
אפשרות הצריכה ששימשה למילוי הבקשה. הערכים הנוכחיים הם PROVISIONED_THROUGHPUT, ON_DEMAND, ON_DEMAND_FLEX ו-ON_DEMAND_PRIORITY. לא מופיע בבקשות שנכשלו. |
requestStartTime |
TIMESTAMP |
השעה שבה החזית (frontend) המציגה אישרה את הבקשה. |
requestDuration |
STRING |
זמן האחזור של הצגת המודעות מקצה לקצה, בפורמט של מחרוזת משך זמן כמו 3.53s. |
generateContentDetails.usageMetadata |
JSON |
מספר הטוקנים של generateContent ו-streamGenerateContent, כולל פירוט לפי אופן. פלט התמונה מופיע כאן כרשומה של IMAGE ב-candidatesTokensDetails. |
rawPredictDetails.usageMetadata |
JSON |
מספר הטוקנים ב-rawPredict וב-streamRawPredict, כולל מודלים של שותפים. |
provisionedThroughput |
JSON |
מוצג לתנועה של הקצאת משאבים לפי התפוקה שנקבעה. |
httpHeaders |
JSON |
כותרות הבקשות שתועדו. |
error |
JSON |
מוצג רק כשדרגת החומרה היא ERROR. |
principal |
JSON |
חשבון השירות ששלח את הבקשה, אם הוא זמין. |
השדה LogEntry.labels מכיל את הערך gen_ai.operation.name, בהתאם למוסכמות הסמנטיות של OpenTelemetry GenAI. גם generateContent וגם streamGenerateContent מדווחים על generate_content. גם rawPredict וגם streamRawPredict מדווחים על raw_predict.
שדות של הקצאת משאבים לפי התפוקה שנקבעה
| שם השדה | סוג | הערות |
|---|---|---|
ptChargedInputTokenCount |
INT64 |
אסימוני קלט שנכללים במכסת הקצאת המשאבים לפי התפוקה שנקבעה, אחרי החלת שיעורי הניצול. |
ptChargedOutputTokenCount |
INT64 |
אסימוני פלט שנספרים במכסת הקצאת המשאבים לפי התפוקה שנקבעה, אחרי החלת שיעורי הניצול. |
accountingResource |
STRING |
הפרויקט שהבקשה השתמשה בהתחייבות שלו להקצאת משאבים לפי התפוקה שנקבעה. |
זיהוי בקשות שחורגות מהמכסה
בקשה נחשבת כחורגת אם היא עמדה בתנאים להקצאת משאבים לפי התפוקה שנקבעה, אבל טופלה על פי דרישה כי התפוקה נוצלה. לרשומה של גלישה יש trafficType של ON_DEMAND ואין אובייקט provisionedThroughput. בקשה רגילה לתשלום לפי שימוש נראית אותו דבר, אז כדי להבדיל ביניהן, צריך להשתמש בכללים הבאים:
- אם שלחתם את
X-Vertex-AI-LLM-Request-Typeעם הערךshared, ניתבתם את הבקשה לתשלום לפי שימוש בכוונה. זה לא זליגה. - אם לא שלחתם כותרת
X-Vertex-AI-LLM-Request-Type, או ששלחתם ערך שהוא לאdedicatedאוshared, והרשומה מדווחת עלON_DEMAND, הבקשה גלשה, בתנאי שיש לכם הקצאת משאבים לפי התפוקה שנקבעה למודל הזה באזור הזה. - אם לא הקציתם משאבים לפי התפוקה שנקבעה למודל, כל רשומה של
ON_DEMANDהיא תשלום רגיל לפי שימוש.
ערכי הכותרות מפורטים במאמר שימוש בהקצאת משאבים לפי התפוקה שנקבעה.
במאמר Spillover by minute מופיעה שאילתה שסופרת את בקשות הגלישה.
זיהוי בקשות ששודרגו לאחור
בקשה משונמכת כשמבקשים אפשרות אחת של תשלום לפי שימוש, והיא מוגשת באפשרות אחרת. משווים בין הכותרת X-Vertex-AI-LLM-Shared-Request-Type ששלחתם לבין הכותרת trafficType ששימשה לבקשה:
| ערך הכותרת ששלחתם | trafficType כשהיא מוצגת לפי בקשה |
|---|---|
priority |
ON_DEMAND_PRIORITY |
flex |
ON_DEMAND_FLEX |
כל ערך אחר של trafficType ברשומה מוצלחת מציין שהבקשה שונמכה, או שהמודל לא מציע את האפשרות שביקשתם. לשאילתה, ראו שדרוגים לאחור לפי מודל.
קודי שגיאה
בקשות שנכשלו נכתבות עם רמת חומרה של ERROR, והן כוללות אובייקט error עם קוד סטטוס של gRPC וסיבה קנונית. הסיבה היא מחרוזת קבועה. הוא אף פעם לא מכיל טקסט של הנחיה, טקסט של תשובה או ערכים של כותרות.
| קוד | סטטוס | סטטוס HTTP אופייני |
|---|---|---|
8 |
המשאב מוצה, למשל מגבלת מכסה. | 429 |
4 |
המועד האחרון חלף לפני שהפעולה הושלמה. | 504 |
14 |
השירות לא זמין. | 503 |
13 |
אירעה שגיאה פנימית. | 500 |
3 |
הבקשה מכילה ארגומנט לא תקין. | 400 |
7 |
למתקשר אין הרשאה. | 403 |
5 |
הישות המבוקשת לא נמצאה. | 404 |
הוספת תוויות לכותרות בהתאמה אישית
כדי לשייך את השימוש למאפיינים משלכם, כמו צוות, אפליקציה או דייר, שולחים כותרות של בקשות עם הקידומת x-goog-agent-platform-observability-label-:
x-goog-agent-platform-observability-label-team: payments
x-goog-agent-platform-observability-label-application: invoice-ocr
כל כותרת מופיעה ברשומה בקטע jsonPayload.httpHeaders. תוויות הכותרת פועלות במודלים של Gemini עם generateContent ו-streamGenerateContent, ובמודלים של Claude עם rawPredict ו-streamRawPredict, בהקצאת משאבים לפי התפוקה שנקבעה ובכל אפשרות של תשלום על השימוש.
במאמר תוויות של מטא-נתונים בהתאמה אישית תוכלו לקרוא דוגמאות לקריאות ל-API עם תוויות של כותרות, רשומות ביומן שנוצרות מהן, מודלים נתמכים, מגבלות והשוואה בין תוויות של כותרות לתוויות של בקשות. כדי לשלוח שאילתה לגביהן, ראו שימוש לפי תווית של כותרת בהתאמה אישית.
שליחת שאילתות ליומנים באמצעות Logs Explorer
אתם יכולים להשתמש ב-Logs Explorer כדי למצוא ולבדוק בקשות הסקה ספציפיות. כדי להשתמש בו, צריך רק להפעיל את הרישום ביומן. הוא קורא את היומן ישירות, כך שהרשומות מופיעות ברגע שהן מגיעות.
במסוף Google Cloud , נכנסים לדף Logs Explorer ומזינים שאילתה בשדה של עורך השאילתות באמצעות שפת השאילתות של Logging. למידע נוסף על החלוניות והפקדים, קראו את המאמר ממשק Logs Explorer.
מתחילים משם היומן, שבוחר את כל הרשומות של בקשות ההסקה בפרויקט:
logName="projects/PROJECT_ID/logs/aiplatform.googleapis.com%2Finference_request"
להוסיף מונחים כדי לצמצם את התוצאות. מונחים בשורות נפרדות משולבים עם AND.
- כדי לבחור בקשות שהתקבלו מאזור אחד, מוסיפים את הערך
resource.labels.location="us-central1". - כדי לבחור שיטת API אחת, מוסיפים את
jsonPayload.method="GENERATE_CONTENT". - כדי לבחור רק תנועה של הקצאת משאבים לפי התפוקה שנקבעה, מוסיפים את הפרמטר
jsonPayload.trafficType="PROVISIONED_THROUGHPUT". - כדי לבחור רק שגיאות שקשורות למכסות, מוסיפים את
severity=ERRORו-jsonPayload.error.code=8. - כדי לבחור ערך אחד של תווית כותרת בהתאמה אישית, מוסיפים את הערך
jsonPayload.httpHeaders."x-goog-agent-platform-observability-label-team".values="payments".
Logs Explorer מסנן ומציג רשומות. הוא לא צובר אותם. כדי לספור, לקבץ או להציג בתרשים את הרשומות, אתם יכולים להשתמש ב-Observability Analytics. בסרגל הכלים Query results, לוחצים על Analyze results כדי להעביר את השאילתה הנוכחית. הלחצן הזה מופיע רק אחרי שמשדרגים את קטגוריית היומנים.
שליחת שאילתות וניתוח יומנים באמצעות Observability Analytics
אתם יכולים להשתמש ב-Observability Analytics כדי לשלוח שאילתות ולנתח יומנים.
לפני שמתחילים
בעזרת Observability Analytics אפשר לענות על שאלות שאי אפשר לענות עליהן באמצעות Logs Explorer. ב-Logs Explorer אפשר למצוא ולהציג רשומות ספציפיות, וזה מה שצריך כשמחפשים בקשה אחת. הכלי Observability Analytics מריץ שאילתות SQL על כל קבוצת הנתונים, כך שהוא יכול לספור, לקבץ, לאחד ולחשב אחוזונים. כל שאלה בחלק הזה דורשת צבירה: אי אפשר לענות על שאלות כמו הוצאות לכל צוות, תרשים התקדמות לכל פרויקט וזמן אחזור p95 לכל אזור, רשומה אחת בכל פעם.
כדי לעשות את זה, צריך לשדרג את קטגוריית היומנים _Default בפרויקט כך שתשתמש ב-Observability Analytics. למידע נוסף, קראו את המאמר הגדרת קטגוריות של יומנים.
הדוגמאות הבאות פועלות ב-Observability Analytics. מחליפים את PROJECT_ID בפרויקט שלכם.
קצב העברת הנתונים לפי אזור ומודל
SELECT
  JSON_VALUE(resource.labels.location)      AS region,
  JSON_VALUE(resource.labels.model_user_id) AS model,
  JSON_VALUE(json_payload.trafficType)      AS traffic_type,
  COUNT(*)                                  AS requests,
  SUM(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.promptTokenCount) AS INT64))     AS input_tokens,
  SUM(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.candidatesTokenCount) AS INT64)) AS output_tokens
FROM `PROJECT_ID.global._Default._Default`
WHERE log_id = "aiplatform.googleapis.com/inference_request"
  AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 24 HOUR)
GROUP BY region, model, traffic_type
ORDER BY requests DESC
הקצאת משאבים לפי התפוקה שנקבעה – ניצול לפי פרויקט
SELECT
  JSON_VALUE(resource.labels.location) AS region,
  JSON_VALUE(json_payload.provisionedThroughput.accountingResource) AS pt_project,
  COUNTIF(JSON_VALUE(json_payload.trafficType) = "PROVISIONED_THROUGHPUT") AS pt_requests,
  COUNTIF(JSON_VALUE(json_payload.trafficType) = "ON_DEMAND")              AS on_demand_requests,
  SUM(CAST(JSON_VALUE(json_payload.provisionedThroughput.ptChargedInputTokenCount)  AS INT64)) AS pt_input_tokens,
  SUM(CAST(JSON_VALUE(json_payload.provisionedThroughput.ptChargedOutputTokenCount) AS INT64)) AS pt_output_tokens
FROM `PROJECT_ID.global._Default._Default`
WHERE log_id = "aiplatform.googleapis.com/inference_request"
  AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 24 HOUR)
GROUP BY region, pt_project
ORDER BY pt_input_tokens DESC
שימוש לפי תווית כותרת בהתאמה אישית
SELECT
  JSON_VALUE(json_payload.httpHeaders
    ["x-goog-agent-platform-observability-label-team"].values[0]) AS team,
  COUNT(*) AS requests,
  SUM(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.totalTokenCount) AS INT64)) AS total_tokens
FROM `PROJECT_ID.global._Default._Default`
WHERE log_id = "aiplatform.googleapis.com/inference_request"
  AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 7 DAY)
GROUP BY team
ORDER BY total_tokens DESC
טוקנים מנוצלים לדקה, Gemini ו-Claude זה לצד זה
השאילתה הזו מדווחת על אסימונים שנצרכו לדקה בעמודה אחת לכל בעל תוכן דיגיטלי. כל עמודה משקללת את סוגי האסימונים באותו אופן שבו המדד publisher/online_serving/consumed_token_throughput משקלל אותם עבור אותו בעל תוכן דיגיטלי, כך שכל עמודה תואמת ל-Cloud Monitoring. Gemini ו-Claude משקללים את הטוקנים של הפלט והמטמון בצורה שונה, אז אל תחברו את שתי העמודות. לשדות של Claude, ראו ספירת טוקנים למודלים של Claude.
SELECT
  TIMESTAMP_TRUNC(timestamp, MINUTE) AS minute_ts,
  SUM(IF(JSON_VALUE(resource.labels.publisher) = "google",
    IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.promptTokenCount) AS INT64), 0)
      + IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.toolUsePromptTokenCount) AS INT64), 0)
      - 0.9 * IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.cachedContentTokenCount) AS INT64), 0)
      + IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.candidatesTokenCount) AS INT64), 0)
      + IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.thoughtsTokenCount) AS INT64), 0), 0)) AS gemini_consumed_tokens,
  SUM(IF(JSON_VALUE(resource.labels.publisher) = "anthropic",
    IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.input_tokens) AS INT64), 0)
      + 0.1  * IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.cache_read_input_tokens) AS INT64), 0)
      + 1.25 * IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.cache_creation_input_tokens) AS INT64), 0)
      + 0.75 * IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.cache_creation.ephemeral_1h_input_tokens) AS INT64), 0)
      + 5    * IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.output_tokens) AS INT64), 0), 0)) AS claude_consumed_tokens
FROM `PROJECT_ID.global._Default._Default`
WHERE log_id = "aiplatform.googleapis.com/inference_request"
  AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 24 HOUR)
GROUP BY minute_ts
ORDER BY minute_ts DESC
שיעור המציאה במטמון ב-Gemini וב-Claude
שיעור המציאה במטמון הוא מספר הטוקנים של הקלט שנשמרו במטמון חלקי המספר הכולל של הטוקנים של הקלט. הקלט של Gemini כולל טוקנים של שימוש בכלים, כי המטמון יכול לכסות אותם. הקלט של Claude הוא קלט שלא נשמר במטמון, בתוספת קריאות מהמטמון וכתיבות למטמון. כדי לראות איך כל ספק שומר במטמון, עיינו בסקירה הכללית על שמירת הקשר במטמון ובשמירת הנחיות במטמון ב-Claude.
SELECT
  JSON_VALUE(resource.labels.model_user_id) AS model,
  JSON_VALUE(json_payload.trafficType)      AS traffic_type,
  ROUND(100 * SAFE_DIVIDE(
    SUM(IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.cachedContentTokenCount) AS INT64), 0)
      + IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.cache_read_input_tokens) AS INT64), 0)),
    SUM(GREATEST(
          IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.promptTokenCount) AS INT64), 0)
          + IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.toolUsePromptTokenCount) AS INT64), 0),
          IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.cachedContentTokenCount) AS INT64), 0))
      + IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.input_tokens) AS INT64), 0)
      + IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.cache_read_input_tokens) AS INT64), 0)
      + IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.cache_creation_input_tokens) AS INT64), 0))), 1) AS cache_hit_rate_pct
FROM `PROJECT_ID.global._Default._Default`
WHERE log_id = "aiplatform.googleapis.com/inference_request"
  AND JSON_VALUE(json_payload.trafficType) IS NOT NULL
  AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 7 DAY)
GROUP BY model, traffic_type
ORDER BY model, traffic_type
שדרוגים לאחור לפי דגם
השאילתה הזו משווה בין האפשרות של תשלום לפי שימוש שכל בקשה ביקשה לבין האפשרות ששירתה אותה. כדי לדעת איך מזהים בקשות ששודרגו לאחור, קראו את המאמר זיהוי בקשות ששודרגו לאחור.
WITH entries AS (
  SELECT
    JSON_VALUE(resource.labels.model_user_id) AS model,
    severity,
    JSON_VALUE(json_payload.trafficType)      AS served,
    (SELECT LOWER(v)
     FROM UNNEST(JSON_VALUE_ARRAY(json_payload.httpHeaders["x-vertex-ai-llm-shared-request-type"].values)) AS v
     WHERE LOWER(v) IN ("priority", "flex")
     LIMIT 1)                                 AS requested
  FROM `PROJECT_ID.global._Default._Default`
  WHERE log_id = "aiplatform.googleapis.com/inference_request"
    AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 7 DAY)
)
SELECT
  model,
  requested,
  COUNTIF(served = CONCAT("ON_DEMAND_", UPPER(requested))) AS served_as_requested,
  COUNTIF(served IS NOT NULL
          AND served != CONCAT("ON_DEMAND_", UPPER(requested))) AS downgraded,
  COUNTIF(severity = "ERROR")                              AS failed
FROM entries
WHERE requested IS NOT NULL
GROUP BY model, requested
ORDER BY downgraded DESC
זליגה לפי דקה
השאילתה הזו סופרת את הבקשות שחרגו מהמכסה לדקה בכל מודל שהייתה בו תנועה של הקצאת משאבים לפי התפוקה שנקבעה בחלון הזמן. כדי לדעת איך לזהות זליגה, קראו את המאמר זיהוי בקשות זליגה.
WITH entries AS (
  SELECT
    timestamp,
    JSON_VALUE(resource.labels.location)      AS region,
    JSON_VALUE(resource.labels.model_user_id) AS model,
    JSON_VALUE(json_payload.trafficType)      AS traffic_type,
    EXISTS(
      SELECT 1
      FROM UNNEST(JSON_VALUE_ARRAY(json_payload.httpHeaders["x-vertex-ai-llm-request-type"].values)) AS v
      WHERE LOWER(v) IN ("dedicated", "shared")) AS routed_by_header
  FROM `PROJECT_ID.global._Default._Default`
  WHERE log_id = "aiplatform.googleapis.com/inference_request"
    AND severity = "INFO"
    AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 24 HOUR)
),
pt_models AS (
  SELECT DISTINCT region, model FROM entries WHERE traffic_type = "PROVISIONED_THROUGHPUT"
)
SELECT
  TIMESTAMP_TRUNC(e.timestamp, MINUTE) AS minute_ts,
  e.region,
  e.model,
  COUNTIF(e.traffic_type = "PROVISIONED_THROUGHPUT")              AS pt_requests,
  COUNTIF(e.traffic_type = "ON_DEMAND" AND NOT e.routed_by_header) AS spillover_requests
FROM entries AS e
JOIN pt_models USING (region, model)
GROUP BY minute_ts, e.region, e.model
HAVING spillover_requests > 0
ORDER BY minute_ts DESC
שיעור השגיאות וזמן האחזור לפי אזור
SELECT
  JSON_VALUE(resource.labels.location) AS region,
  TIMESTAMP_TRUNC(timestamp, MINUTE)   AS minute_ts,
  COUNT(*)                             AS total,
  COUNTIF(severity = "ERROR")          AS errors,
  COUNTIF(CAST(JSON_VALUE(json_payload.error.code) AS INT64) = 8) AS resource_exhausted,
  APPROX_QUANTILES(
    CAST(REGEXP_REPLACE(JSON_VALUE(json_payload.requestDuration), r"s$", "") AS FLOAT64),
    100)[OFFSET(95)] AS p95_latency_seconds
FROM `PROJECT_ID.global._Default._Default`
WHERE log_id = "aiplatform.googleapis.com/inference_request"
  AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 6 HOUR)
GROUP BY region, minute_ts
ORDER BY minute_ts DESC
ספירת טוקנים במודלים של Claude
במודלים של Claude, השימוש מדווח ב-rawPredictDetails.usageMetadata עם שמות השדות של Claude API. גם rawPredict וגם streamRawPredict כותבים את אותם שדות. בסטרימינג, היומן ממזג את השימוש שדווח בסטרימינג.
| שדה | מה נספר |
|---|---|
input_tokens |
אסימוני קלט שלא נקראו מהמטמון או נכתבו אליו. |
cache_read_input_tokens |
טוקנים של קלט שנקראו מהמטמון של ההנחיות. |
cache_creation_input_tokens |
טוקנים של קלט שנכתבו במטמון ההנחיות, שני ה-TTL ביחד. |
cache_creation.ephemeral_5m_input_tokens |
כתיבה למטמון עם TTL של 5 דקות. |
cache_creation.ephemeral_1h_input_tokens |
כתיבה למטמון עם TTL של שעה. |
output_tokens |
טוקנים של פלט, כולל חשיבה מעמיקה. אל תוסיפו טוקנים של חשיבה בנפרד. |
הקלט הכולל של Claude הוא input_tokens ועוד cache_read_input_tokens ועוד cache_creation_input_tokens. ב-Gemini זה שונה: promptTokenCount
כבר כולל טוקנים במטמון.
ברשומות של Claude אין פירוט של המודאליות. תוויות הכותרת פועלות באותו אופן ב-Gemini וב-Claude. ראו צירוף תוויות כותרת בהתאמה אישית.
תמחור
רישום המטא-נתונים של בקשות ההסקה ביומן מתבצע ב-Cloud Logging, והחיוב הוא על הטמעה ואחסון ב-Cloud Logging. החיוב על שאילתות דרך Observability Analytics הוא לפי השימוש ב-Cloud Monitoring. קישור של מערך נתונים ב-BigQuery לא מוסיף חיובי אחסון ב-BigQuery.
גודל הרשומה תלוי בבקשות, למשל במספר תוויות הכותרת שהן מכילות. כדי להעריך את העלות, אתם יכולים להפעיל את הרישום ביומן של עומס עבודה מייצג למשך יום אחד, למדוד את נפח הנתונים שנקלטו באמצעות ניתוח נפח היומן, ואז לחזות את הנפח החודשי במחשבון העלויות שלGoogle Cloud .
המאמרים הבאים
- איך עוקבים אחרי מודלים באמצעות מדדים
- איך עוקבים אחרי העלויות באמצעות תוויות מטא-נתונים בהתאמה אישית
- אם אתם צריכים את תוכן ההנחיה והתשובה, השתמשו ברישום ביומן של בקשות ותשובות.
- מידע על הקצאת משאבים לפי התפוקה שנקבעה
- אפשר לראות מדדים מפורטים של הקצאת משאבים לפי התפוקה שנקבעה במסוף Google Cloud .
- פתרון בעיות שקשורות לשגיאות 429
- לאסוף רשומות מכל פרויקט בתיקייה או בארגון באמצעות כיורים נצברים.