


בדף הזה מוסבר איך פועלת הקצאת המשאבים לפי התפוקה שנקבעה, איך לשלוט בחיובים על חריגות או לעקוף את הקצאת המשאבים לפי התפוקה שנקבעה, ואיך לעקוב אחרי השימוש.
איך פועלת הקצאת המשאבים לפי התפוקה שנקבעה
בקטע הזה מוסבר איך פועלת הקצאת המשאבים לפי התפוקה שנקבעה, באמצעות בדיקת המכסות בתקופת אכיפת המכסות.
בדיקת המכסות של הקצאת המשאבים לפי התפוקה שנקבעה
המכסה המקסימלית של הקצאת המשאבים לפי התפוקה שנקבעה היא מכפלה של מספר יחידות התפוקה ל-AI גנרטיבי (GSU) שנרכשו והתפוקה לכל GSU. היא נבדקת בכל פעם שאתם שולחים בקשה בתוך תקופת אכיפת המכסה, שהיא התדירות שבה נאכפת המכסה המקסימלית של הקצאת המשאבים לפי התפוקה שנקבעה.
כשמתקבלת בקשה, גודל התגובה האמיתי לא ידוע. מכיוון שאנחנו נותנים עדיפות למהירות התגובה באפליקציות בזמן אמת, הקצאת משאבים לפי התפוקה שנקבעה מעריכה את גודל הטוקן של הפלט. אם ההערכה הראשונית חורגת מהמכסה המקסימלית הזמינה של הקצאת המשאבים לפי התפוקה שנקבעה, הבקשה מעובדת לפי תשלום לפי שימוש. אחרת, היא מעובדת לפי הקצאת המשאבים לפי התפוקה שנקבעה. כדי לעשות את זה, המערכת משווה בין האומדן הראשוני לבין המכסה המקסימלית של הקצאת המשאבים לפי התפוקה שנקבעה.
אחרי שהתשובה נוצרת והגודל האמיתי של טוקן הפלט ידוע, המערכת מתאימה בין השימוש בפועל לבין המכסה. היא מוסיפה את ההפרש בין ההערכה לבין השימוש בפועל לכמות המכסה הזמינה של הקצאת המשאבים לפי התפוקה שנקבעה.
חלונות אכיפה של מכסות להקצאת משאבים לפי התפוקה שנקבעה
ב-Agent Platform מופעל חלון דינמי בזמן אכיפת המכסה של הקצאת המשאבים לפי התפוקה שנקבעה למודלי Gemini. כך אפשר לשמור על יציבות אופטימלית בתנועה שנוטה לעליות חדות. במקום חלון קבוע, פלטפורמת Agent אוכפת את המכסה בחלון גמיש שמתאים את עצמו באופן אוטומטי, בהתאם לסוג המודל ולמספר יחידות ה-GSU שהקציתם. כתוצאה מכך, יכול להיות שבמקרים מסוימים תהיה לכם באופן זמני תנועה בעדיפות גבוהה שחורגת מהמכסה שלכם לשנייה. עם זאת, אסור לחרוג מהמכסה במהלך חלון הזמן. התקופות האלה מבוססות על השעון הפנימי של Agent Platform, והן לא תלויות במועד שליחת הבקשות.
איך פועל חלון אכיפת המכסות
חלון האכיפה קובע בכמה אפשר לחרוג מהמגבלה לשנייה, או "להתפרץ" מעליה, לפני שהמערכת תגביל את הקצב. החלון הזה מופעל באופן אוטומטי. חשוב לזכור שהחלונות האלה עשויים להשתנות כדי לשפר את הביצועים והאמינות.
הקצאות קטנות של יחידות GSU (3 יחידות GSU או פחות): החלון יכול להיות בין 40 ל-120 שניות, כדי לאפשר עיבוד של בקשות גדולות יותר בלי הפרעות.
לדוגמה, אם קונים יחידת GSU אחת של
gemini-2.5-flash, מקבלים בממוצע 2,690 טוקנים לשנייה של תפוקה רציפה. השימוש הכולל בכל חלון של 120 שניות לא יכול לחרוג מ-322,800 טוקנים (2,690 טוקנים לשנייה * 120 שניות). לכן, אם אתם שולחים בקשה שמשתמשת ב-70,000 טוקנים לשנייה, אבל השימוש הכולל במשך 120 שניות נשאר מתחת ל-322,800 טוקנים, פרץ השימוש של 70,000 טוקנים לשנייה עדיין נחשב כהקצאת משאבים לפי התפוקה שנקבעה, כי השימוש הממוצע לא חורג מ-2,690 טוקנים לשנייה.הקצאות GSU סטנדרטיות (בינוניות) (יותר מ-3 יחידות GSU): בפריסות GSU בינוניות (לדוגמה, פחות מ-50 יחידות GSU), החלון יכול לנוע בין 5 שניות ל-30 שניות. הסף של ה-GSU וחלונות ההקשר משתנים בהתאם למודל.
לדוגמה, אם קונים 25 יחידות GSU של
gemini-2.5-flash, מקבלים קצב העברת נתונים רציף של 67,250 טוקנים לשנייה בממוצע (2,690 טוקנים לשנייה * 25). השימוש הכולל בחלון של 30 שניות לא יכול להיות יותר מ-2,017,500 טוקנים (67,250 טוקנים לשנייה * 30 שניות). לכן, אם אתם שולחים בקשה שמשתמשת ב-1,000,000 טוקנים לשנייה, אבל השימוש הכולל במשך 30 שניות נשאר בטווח של 2,017,500 טוקנים, פרץ השימוש של 1,000,000 טוקנים לשנייה עדיין נחשב כהקצאת משאבים לפי התפוקה שנקבעה, כי השימוש הממוצע לא חורג מ-67,250 טוקנים לשנייה.הקצאות GSU ברמת דיוק גבוהה (בקנה מידה גדול): בפריסות GSU בקנה מידה גדול (לדוגמה, 50 יחידות GSU או יותר), החלון יכול לנוע בין שנייה אחת ל-5 שניות כדי להבטיח שבקשות בתדירות גבוהה יעובדו ברמת דיוק מקסימלית בכל התשתית.
לדוגמה, אם קונים 250 יחידות GSU של
gemini-2.5-flash, מקבלים קצב העברה ממוצע של 672,500 טוקנים לשנייה (2,690 טוקנים לשנייה * 250). השימוש הכולל בחלון של 5 שניות לא יכול לחרוג מ-3,362,500 טוקנים (672,500 טוקנים לשנייה כפול 5 שניות). לכן, אם תשלחו בקשה שמשתמשת ב-5,000,000 טוקנים לשנייה, היא לא תעובד כהקצאת משאבים לפי התפוקה שנקבעה, כי השימוש הכולל ב-5,000,000 טוקנים חורג מהמגבלה של 3,362,500 טוקנים בחלון של 5 שניות. לעומת זאת, בקשה שמשתמשת ב-1,000,000 טוקנים לשנייה יכולה להיות מעובדת כהקצאת משאבים לפי התפוקה שנקבעה, אם השימוש הממוצע בחלון של 5 שניות לא חורג מ-672,500 טוקנים לשנייה.
שליטה על חריגות או עקיפת הקצאת המשאבים לפי התפוקה שנקבעה
אתם יכולים להשתמש ב-API כדי לשלוט בחיובים על חריגה מהתפוקה שרכשתם, או כדי לעקוף את הקצאת המשאבים לפי התפוקה שנקבעה בכל בקשה.
כדאי לקרוא את כל האפשרויות כדי להבין מה צריך לעשות כדי לעמוד בדרישות של תרחיש השימוש שלכם.
התנהגות ברירת מחדל
אם בקשה חורגת מהמכסה שנותרה להקצאת משאבים לפי התפוקה שנקבעה, כברירת מחדל כל הבקשה מעובדת כבקשה על פי דרישה ומחויבת לפי תעריף תשלום לפי שימוש. במצב כזה, תעבורת הנתונים מופיעה כזליגה בלוחות הבקרה של המעקב. איך עוקבים אחרי השימוש בהקצאת המשאבים לפי התפוקה שנקבעה
אחרי שההזמנה של הקצאת המשאבים לפי התפוקה שנקבעה פעילה, פעולת ברירת המחדל מתבצעת באופן אוטומטי. אתם לא צריכים לשנות את הקוד כדי להתחיל להשתמש בהזמנה, כל עוד אתם משתמשים בה באזור שהוקצה.
שימוש רק בהקצאת משאבים לפי התפוקה שנקבעה
אם אתם רוצים להימנע מחיובים לפי דרישה כדי לנהל את העלויות, השתמשו רק בהקצאת משאבים לפי התפוקה שנקבעה. בקשות שחורגות מכמות ההזמנות של הקצאת המשאבים לפי התפוקה שנקבעה מחזירות שגיאה 429.
כששולחים בקשות ל-API, מגדירים את כותרת ה-HTTP X-Vertex-AI-LLM-Request-Type לערך dedicated.
שימוש רק בתשלום לפי שימוש
האפשרות הזו נקראת גם "שימוש על פי דרישה". הבקשות עוקפות את ההזמנה של הקצאת המשאבים לפי התפוקה שנקבעה ונשלחות ישירות לתשלום לפי שימוש. האפשרות הזו יכולה להיות שימושית לניסויים או לאפליקציות שנמצאות בפיתוח.
כששולחים בקשות ל-API, צריך להגדיר את כותרת ה-HTTP X-Vertex-AI-LLM-Request-Type לערך shared.
דוגמה
Python
התקנה
pip install --upgrade google-genai
מידע נוסף זמין ב מאמרי העזרה של ה-SDK.
מגדירים משתני סביבה כדי להשתמש ב-Google Gen AI SDK עם Vertex AI:
# Replace the `GOOGLE_CLOUD_PROJECT` and `GOOGLE_CLOUD_LOCATION` values
# with appropriate values for your project.
export GOOGLE_CLOUD_PROJECT=GOOGLE_CLOUD_PROJECT
export GOOGLE_CLOUD_LOCATION=global
export GOOGLE_GENAI_USE_ENTERPRISE=True
Go
thought איך מתקינים או מעדכנים את Go
מידע נוסף זמין ב מאמרי העזרה של ה-SDK.
מגדירים משתני סביבה כדי להשתמש ב-Google Gen AI SDK עם Vertex AI:
# Replace the `GOOGLE_CLOUD_PROJECT` and `GOOGLE_CLOUD_LOCATION` values
# with appropriate values for your project.
export GOOGLE_CLOUD_PROJECT=GOOGLE_CLOUD_PROJECT
export GOOGLE_CLOUD_LOCATION=global
export GOOGLE_GENAI_USE_ENTERPRISE=True
Node.js
התקנה
npm install @google/genai
מידע נוסף זמין ב מאמרי העזרה של ה-SDK.
מגדירים משתני סביבה כדי להשתמש ב-Google Gen AI SDK עם Vertex AI:
# Replace the `GOOGLE_CLOUD_PROJECT` and `GOOGLE_CLOUD_LOCATION` values
# with appropriate values for your project.
export GOOGLE_CLOUD_PROJECT=GOOGLE_CLOUD_PROJECT
export GOOGLE_CLOUD_LOCATION=global
export GOOGLE_GENAI_USE_ENTERPRISE=True
Java
thought איך מתקינים או מעדכנים את Java
מידע נוסף זמין ב מאמרי העזרה של ה-SDK.
מגדירים משתני סביבה כדי להשתמש ב-Google Gen AI SDK עם Vertex AI:
# Replace the `GOOGLE_CLOUD_PROJECT` and `GOOGLE_CLOUD_LOCATION` values
# with appropriate values for your project.
export GOOGLE_CLOUD_PROJECT=GOOGLE_CLOUD_PROJECT
export GOOGLE_CLOUD_LOCATION=global
export GOOGLE_GENAI_USE_ENTERPRISE=True
REST
curl -X POST \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  -H "X-Vertex-AI-LLM-Request-Type: dedicated" \ # Options: dedicated, shared
  $URL \
  -d '{"contents": [{"role": "user", "parts": [{"text": "Hello."}]}]}'
שימוש בהקצאת משאבים לפי התפוקה שנקבעה עם מפתח API
אם רכשתם הקצאת משאבים לפי התפוקה שנקבעה לפרויקט, למודל של Google ולאזור ספציפיים, ואתם רוצים להשתמש בה כדי לשלוח בקשה עם מפתח API, אתם צריכים לכלול בבקשה את מזהה הפרויקט, המודל, המיקום ומפתח ה-API כפרמטרים.
במאמר איך מקבלים מפתח API של Google Cloud מוסבר איך יוצרים מפתח API של Google Cloud שמשויך לחשבון שירות. במאמר התחברות לשרת Knowledge MCP מוסבר איך לשלוח בקשות ל-Gemini API באמצעות מפתח API.
לדוגמה, הקוד הבא מראה איך לשלוח בקשה עם מפתח API כשמשתמשים בהקצאת משאבים לפי התפוקה שנקבעה:
REST
curl \
-X POST \
-H "Content-Type: application/json" \
"https://aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/LOCATION/publishers/google/models/MODEL_ID:generateContent?key=YOUR_API_KEY" \
-d $'{
  "contents": [
    {
      "role": "user",
      "parts": [
        {
          "text": "Explain how AI works in a few words"
        }
      ]
    }
  ]
}'
קבלת התראות באימייל
אתם יכולים לקבל התראות באימייל על ההזמנות שלכם להקצאת משאבים לפי התפוקה שנקבעה באמצעות Essential Contacts API. אחרי שמפעילים את ההתראות, לוחצים על התראות בחלק העליון של הדף "הזמנות של הקצאת משאבים לפי התפוקה שנקבעה". בתיבת הדו-שיח שנפתחת, לוחצים על Essential contacts ופועלים לפי ההוראות במסך.
-
מפעילים את Essential Contacts API, אם הוא עדיין לא מופעל.
התפקידים שנדרשים כדי להפעיל ממשקי API
כדי להפעיל ממשקי API, צריך את ההרשאה
serviceusage.services.enable. אם אתם יצרתם את הפרויקט, סביר להניח שכבר יש לכם את ההרשאה הזו דרך התפקיד "בעלים" (roles/owner). אחרת, אתם יכולים לקבל את ההרשאה הזו דרך התפקיד "אדמין בממשק 'שימוש בשירות'" (roles/serviceusage.serviceUsageAdmin). איך מקצים תפקידים? נכנסים לדף Provisioned Throughput.
לוחצים על התראות.
בתיבת הדו-שיח Notifications, לוחצים על Essential contacts.
הדף Essential contacts ייפתח.
לוחצים על הוספת איש קשר.
בתיבת הדו-שיח Add a contact, מזינים את כתובת האימייל של איש הקשר בשדות Email ו-Confirm email.
לוחצים על עדכוני מוצרים.
לוחצים על Save.
כתובת האימייל ליצירת קשר מקבלת הודעות על האירועים הבאים שקשורים להקצאת משאבים לפי התפוקה שנקבעה:
| אירוע | מתי איש הקשר מקבל הודעה |
|---|---|
| ההזמנה נשלחה | תוך דקות |
| ההזמנה הופעלה | תוך דקות |
| העדכון של ההזמנה נשלח | תוך דקות |
| עדכון ההזמנה הופעל | תוך דקות |
| תפוגת ההזמנה: חודש, 3 חודשים או שנה | שבועיים לפני תאריך התפוגה |
| תוקף ההזמנה יפוג אחרי שבוע. | 3 ימים לפני תאריך התפוגה |
| חידוש אוטומטי לחודש, ל-3 חודשים או לשנה | שבועיים לפני תאריך החידוש האוטומטי |
מעקב אחרי הקצאת המשאבים לפי התפוקה שנקבעה
אתם יכולים לעקוב בעצמכם אחרי השימוש בהקצאת המשאבים לפי התפוקה שנקבעה, באמצעות קבוצת מדדים שנמדדים בסוג המשאב aiplatform.googleapis.com/PublisherModel.
התכונה "מעקב אחרי התנועה בהקצאת משאבים לפי התפוקה שנקבעה" נמצאת בגרסת טרום-השקה (Preview) ציבורית.
מידות
אפשר לסנן מדדים לפי המאפיינים הבאים:
| מאפיין | ערכים |
|---|---|
type |
inputoutput |
request_type |
|
קידומת הנתיב
קידומת הנתיב של מדד היא aiplatform.googleapis.com/publisher/online_serving.
לדוגמה, הנתיב המלא של המדד /consumed_throughput הוא aiplatform.googleapis.com/publisher/online_serving/consumed_throughput.
מדדים
המדדים הבאים של Cloud Monitoring זמינים במשאב aiplatform.googleapis.com/PublisherModel למודלים של Gemini. כדי לסנן לפי השימוש בהקצאת המשאבים לפי התפוקה שנקבעה, משתמשים בסוגי הבקשות של dedicated.
| מדד | השם המוצג | תיאור |
|---|---|---|
/dedicated_gsu_limit |
מגבלה (GSU) | מגבלה ייעודית ביחידות GSU. המדד הזה מאפשר לכם להבין את המכסה המקסימלית של הקצאת המשאבים לפי התפוקה שנקבעה ביחידות GSU. |
/tokens |
טוקנים | התפלגות של מספר הטוקנים בקלט ובפלט. |
/token_count |
כמות הטוקנים | מספר הטוקנים המצטבר של הקלט והפלט. |
/consumed_token_throughput |
קצב העברת נתונים של טוקנים | שימוש בנפח עיבוד נתונים, שמביא בחשבון את קצב הניצול בטוקנים וכולל התאמה של המכסות. אפשר לעיין במאמר בדיקת המכסה של הקצאת המשאבים לפי התפוקה שנקבעה. המדד הזה מאפשר להבין איך נוצלה המכסה של הקצאת המשאבים לפי התפוקה שנקבעה. |
/dedicated_token_limit |
מגבלה (אסימונים לשנייה) | מגבלה ייעודית בטוקנים לשנייה. המדד הזה מאפשר לכם להבין את המכסה המקסימלית של הקצאת המשאבים לפי התפוקה שנקבעה למודלים שמבוססים על טוקנים. |
/characters |
תווים | התפלגות מספר התווים בקלט ובפלט. |
/character_count |
מספר תווים | מספר התווים המצטבר של הקלט והפלט. |
/consumed_throughput |
קצב העברת תווים | שימוש בנפח, שכולל את קצב הניצול בתווים ומשלב התאמה של המכסות בדיקת המכסות של הקצאת המשאבים לפי התפוקה שנקבעה. המדד הזה מאפשר להבין איך נוצלה המכסה של הקצאת המשאבים לפי התפוקה שנקבעה. במודלים שמבוססים על טוקנים, המדד הזה שווה לנפח הנתונים שנצרך בטוקנים כפול 4. |
/dedicated_character_limit |
מגבלה (תווים לשנייה) | מגבלה ייעודית של תווים לשנייה. המדד הזה מאפשר לכם להבין את המכסה המקסימלית של הקצאת המשאבים לפי התפוקה שנקבעה במודלים שמבוססים על תווים. |
/model_invocation_count |
מספר ההפעלות של המודל | מספר ההפעלות של המודל (בקשות לחיזוי). |
/model_invocation_latencies |
זמני האחזור של הפעלת המודל | זמני האחזור של הפעלת המודל (זמני האחזור של החיזוי). |
/first_token_latencies |
זמני האחזור של הטוקן הראשון | משך הזמן מקבלת הבקשה ועד להחזרת הטוקן הראשון. |
במודלים של Anthropic יש גם מסנן להקצאת משאבים לפי התפוקה שנקבעה, אבל רק ל-tokens ול-token_count.
מרכזי שליטה
לוחות הבקרה שמוגדרים כברירת מחדל למעקב אחרי הקצאת המשאבים לפי התפוקה שנקבעה מספקים מדדים שמאפשרים לכם להבין טוב יותר את השימוש ואת ניצול המשאבים. כדי לגשת למרכזי הבקרה:
במסוף Google Cloud , נכנסים לדף הקצאת משאבים לפי התפוקה שנקבעה.
כדי לראות את ניצול המשאבים שהוקצו לפי התפוקה שנקבעה בכל מודל בהזמנות, בוחרים בכרטיסייה Utilization summary.
בטבלה Provisioned Throughput utilization by model אפשר לראות את הפרטים הבאים לגבי טווח הזמן שנבחר:
המספר הכולל של יחידות ה-GSU שהיו לכם.
שיא השימוש ברוחב הפס במונחי GSU.
השימוש הממוצע ב-GSU.
מספר הפעמים שהגעתם למגבלה של הקצאת המשאבים לפי התפוקה שנקבעה.
כדי לראות מדדים נוספים שספציפיים למודל מסוים, בוחרים מודל מהטבלה הקצאת משאבים לפי התפוקה שנקבעה לפי ניצול מודל.
מדדים מפורטים
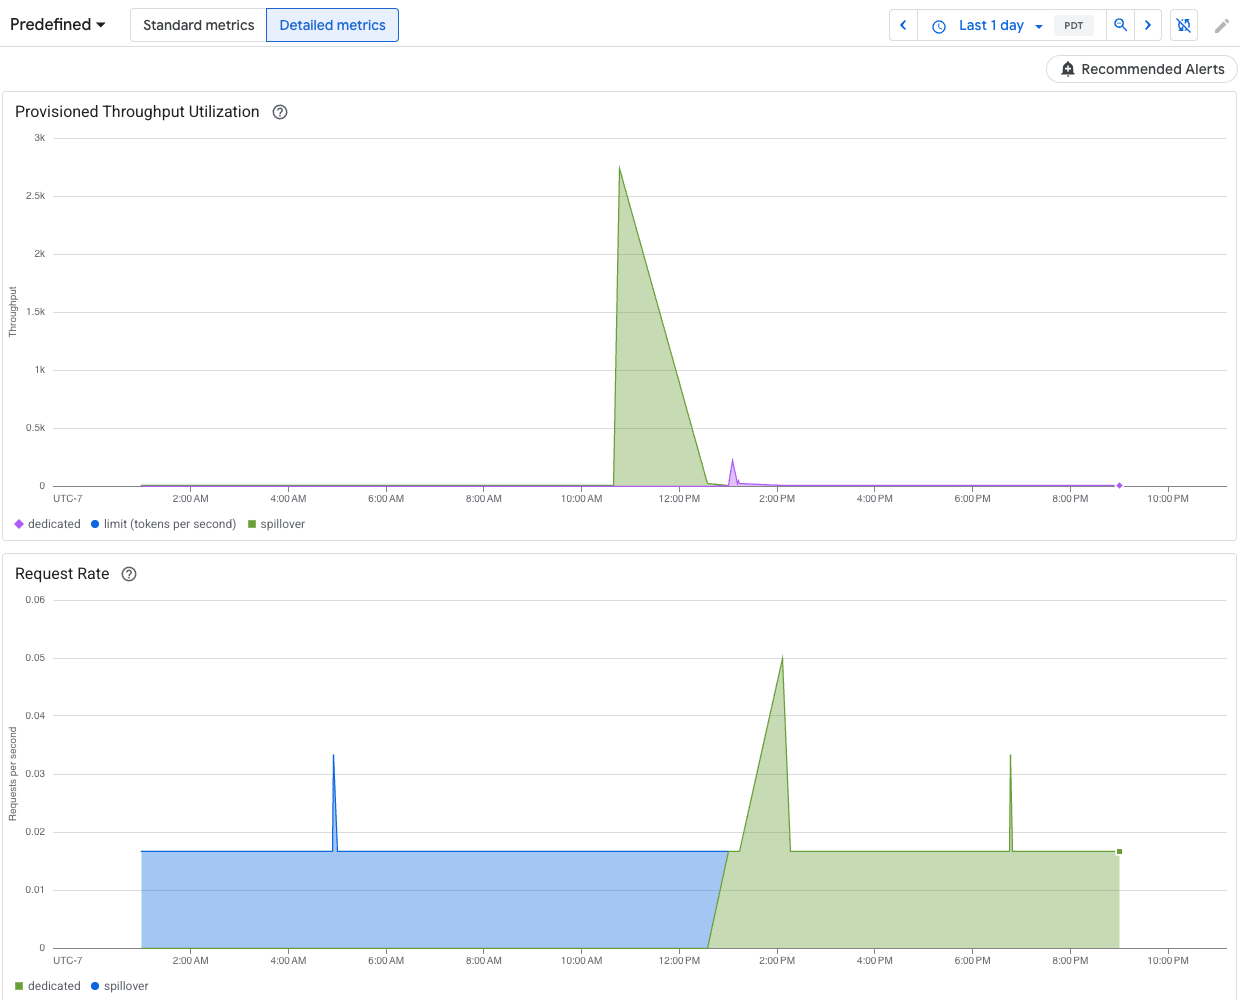
המדדים המפורטים מחשבים את מרכזי הבקרה של "הקצאת משאבים לפי התפוקה שנקבעה" מיומני הסקה לכל בקשה, במקום מדדים מצטברים של דקה אחת. הם מציגים את התנועה ברזולוציה של שניות, כך שתוכלו לראות פרצים שממוצע של דקה מסתיר, ואת השניות הספציפיות שבהן התנועה חרגה מהמכסה.
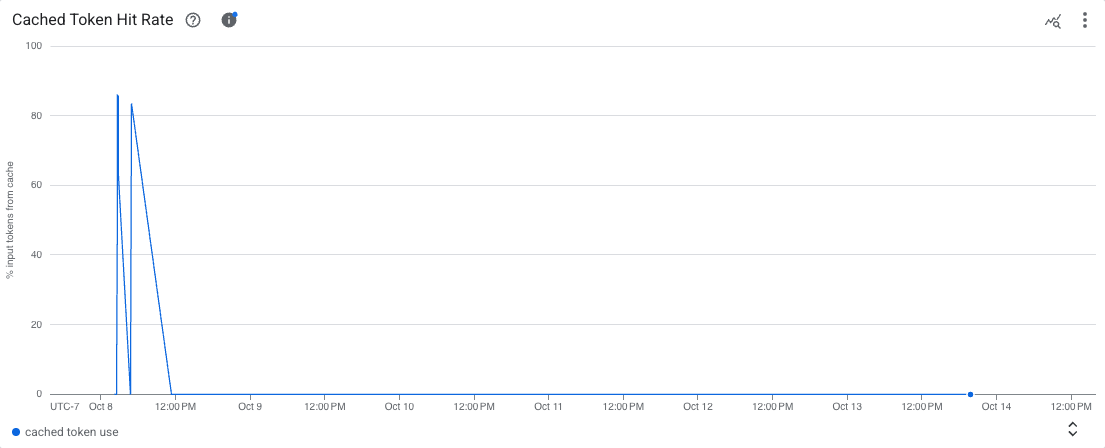
במדדים המפורטים, לצד התרשימים הרגילים מופיעים גם התרשימים הבאים: קצב העיבוד, שיעור המציאה במטמון והשימוש בטוקנים שנשמרו במטמון.
כדי להפעיל מדדים מפורטים, עיינו בקטע הפעלה במסוף. אחרי שהשדרוג של קטגוריית היומנים מסתיים, פותחים הזמנה או מודל מהכרטיסייה Utilization summary כדי לראות את התרשימים המפורטים. כדי לשלוח שאילתות לאותם נתונים באמצעות SQL, למשל קצב ניצול לפי פרויקט, חריגה לפי דקה או שיעור המציאה במטמון, קראו את המאמר שאילתות באמצעות Observability Analytics.
איך מפרשים את לוחות הבקרה למעקב
הקצאת המשאבים לפי התפוקה שנקבעה בודקת את המכסה הזמינה בזמן אמת ברמת האלפית השנייה לבקשות כשהן מתבצעות, אבל משווה את הנתונים האלה לתקופת אכיפת המכסות המתגלגלת, על סמך השעון הפנימי של Agent Platform. ההשוואה הזו לא תלויה בזמן שבו הבקשות נשלחות. מרכזי הבקרה של המעקב מדווחים על מדדי שימוש אחרי התאמת המכסות. עם זאת, המדדים האלה נצברים כדי לספק ממוצעים לתקופות ההתאמה של לוח הבקרה, על סמך טווח התאריכים שנבחר. רמת הפירוט הנמוכה ביותר שאפשר להגדיר בלוחות הבקרה למעקב היא ברמת הדקה. כדי לראות תנועה ברמה השנייה, צריך להפעיל את המדדים המפורטים. בנוסף, השעה שמוצגת במרכזי הבקרה למעקב שונה מהשעה שמוצגת ב-Agent Platform.
ההבדלים האלה בתזמון עלולים לגרום מדי פעם לאי-התאמות בין הנתונים בלוחות הבקרה של המעקב לבין הביצועים בזמן אמת. הסיבות האפשריות לכך:
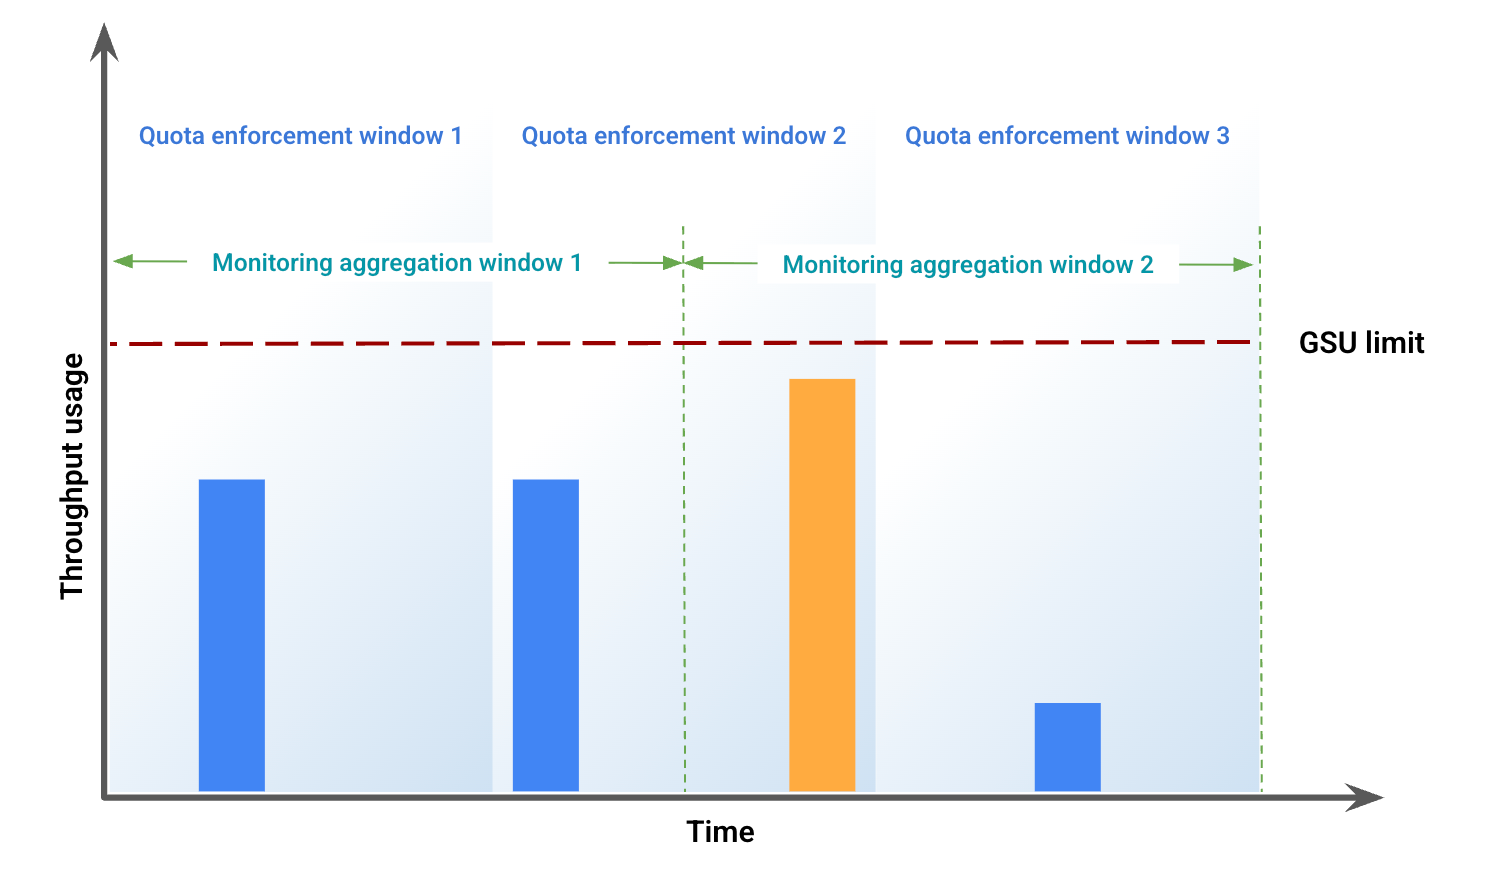
המכסה נאכפת בזמן אמת, אבל בתרשימי המעקב הנתונים נצברים לתקופות יישור של דקה אחת או יותר בממוצע בלוח הבקרה, בהתאם לטווח הזמן שצוין בלוחות הבקרה של המעקב.
פלטפורמת הסוכן ולוחות הבקרה למעקב פועלים על שעוני מערכת שונים.
אם במהלך שנייה אחת, פרץ תנועה חורג ממכסת הקצאת המשאבים לפי התפוקה שנקבעה על סמך חלון האכיפה, כל הבקשה מעובדת כתנועה חורגת. עם זאת, יכול להיות שהניצול הכולל של הקצאת המשאבים לפי התפוקה שנקבעה ייראה נמוך כשנתוני המעקב של אותה שנייה מחושבים כממוצע בתוך תקופת ההתאמה של דקה אחת, כי יכול להיות שהניצול הממוצע בכל תקופת ההתאמה לא יעלה על 100%. אם אתם רואים תנועה עודפת, סימן שמכסת הקצאת המשאבים לפי התפוקה שנקבעה נוצלה במלואה בתקופת אכיפת המכסה שבה נשלחו הבקשות הספציפיות האלה. זה נכון בלי קשר לניצול הממוצע שמוצג בלוחות הבקרה למעקב.
דוגמה לפער אפשרי בנתוני המעקב
הדוגמה הזו ממחישה חלק מהפערים שנובעים מחוסר התאמה בין החלונות. איור 1 מייצג את השימוש בנפח הנתונים בתקופה מסוימת. באיור הזה:
העמודות הכחולות מייצגות את התנועה שהתקבלה כהקצאת משאבים לפי התפוקה שנקבעה.
העמודה הכתומה מייצגת את התנועה שדוחפת את השימוש מעבר למגבלת ה-GSU, ומעובדת כחריגה.
בהתאם לשימוש ברוחב הפס, איור 2 מייצג פערים חזותיים אפשריים, בגלל חוסר התאמה בחלונות. באיור הזה:
הקו הכחול מייצג את התנועה של הקצאת המשאבים לפי התפוקה שנקבעה.
הקו הכתום מייצג את התנועה שזלגה.
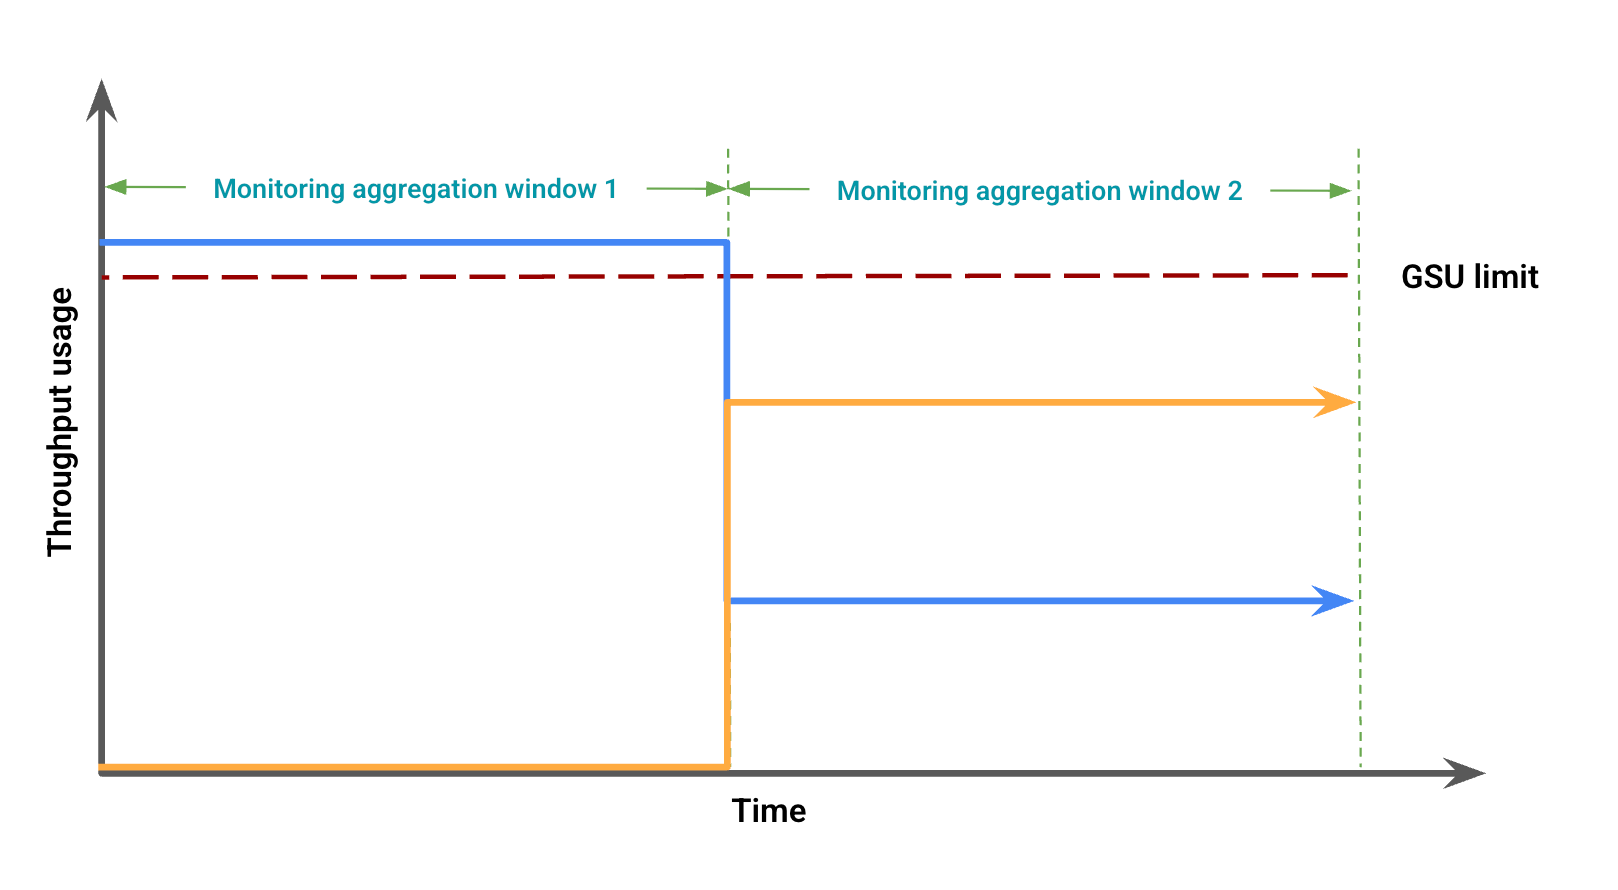
במקרה כזה, יכול להיות שבנתוני המעקב תראו שימוש בהקצאת המשאבים לפי התפוקה שנקבעה בלי חריגה במסגרת זמן מסוימת של צבירת נתונים, ובמקביל תראו שימוש בהקצאת המשאבים לפי התפוקה שנקבעה מתחת למגבלת ה-GSU, שחופף לחריגה במסגרת זמן אחרת של צבירת נתונים.
פתרון בעיות בלוחות הבקרה של Monitoring
כדי לפתור בעיות של חריגה בלתי צפויה במרכזי הבקרה או שגיאות 429, מבצעים את הפעולות הבאות:
הגדלת התצוגה: מגדירים את טווח התאריכים של לוח הבקרה ל-12 שעות או פחות, כדי לספק את תקופת ההתאמה המפורטת ביותר של דקה אחת. טווח תאריכים גדולים מחליקים את הפיקים שגורמים לוויסות, ומגדילים את הממוצעים של תקופת ההתאמה.
בודקים את נפח התנועה הכולל: במרכזי הבקרה הספציפיים למודל, התנועה הייעודית והתנועה שמועברת מוצגות כשני קווים נפרדים. זה עלול להוביל למסקנה השגויה שהמכסה של הקצאת המשאבים לפי התפוקה שנקבעה לא מנוצלת במלואה, ושהתנועה מועברת מוקדם מדי. אם התנועה חורגת מהמכסה הזמינה, כל הבקשה מעובדת כזליגה. כדי להוסיף עוד תצוגה חזותית שימושית, אתם יכולים להוסיף שאילתה ללוח הבקרה באמצעות Metrics Explorer, ולכלול את קצב העברת הנתונים של הטוקנים במודל ובאזור הספציפיים. אל תכללו צבירות או מסננים נוספים כדי להציג את התנועה הכוללת בכל סוגי התנועה (ייעודית, חריגה ומשותפת).
מעקב אחרי מודלים גנרטיביים ליצירת מדיה
אי אפשר לעקוב אחרי הקצאת המשאבים לפי התפוקה שנקבעה במודלים של Veo.
שליחת התראות
אחרי שמפעילים את ההתראות, מגדירים התראות ברירת מחדל שיעזרו לכם לנהל את השימוש בתנועה.
הפעלת התראות
כדי להפעיל התראות במרכז הבקרה, מבצעים את הפעולות הבאות:
במסוף Google Cloud , נכנסים לדף הקצאת משאבים לפי התפוקה שנקבעה.
כדי לראות את ניצול המשאבים שהוקצו לפי התפוקה שנקבעה בכל מודל בהזמנות, בוחרים בכרטיסייה Utilization summary.
בוחרים באפשרות התראות מומלצות, וההתראות הבאות יוצגו:
Provisioned Throughput Usage Reached LimitProvisioned Throughput Utilization Exceeded 80%Provisioned Throughput Utilization Exceeded 90%
בודקים את ההתראות שעוזרות לנהל את התנועה.
הצגת פרטים נוספים על ההתראה
כדי לראות מידע נוסף על התראות:
עוברים לדף שילובים.
מזינים Agent Platform בשדה Filter ולוחצים על Enter. מופיע הדף Google Agent Platform.
כדי לראות מידע נוסף, לוחצים על לפרטים. החלונית Google Agent Platform details נפתחת.
בוחרים בכרטיסייה התראות, ואז בוחרים תבנית של מדיניות התראות.