


Gemini Robotics ER は、物理世界に関する高度な推論をロボット工学にもたらす視覚言語モデル(VLM)です。このモデルは、視覚データを解釈し、空間的および時間的な推論を行い、複数ステップのタスクを計画し、ロボットとツールをオーケストレートします。
モデル
Gemini Robotics ER 2 は、ロボットの物理環境に関する正確な推論を可能にする推論モデルのアップデートです。ロボットのエージェント型オーケストレーション(ビジョン言語アクション(VLA)モデルの使用など)、ロボット動画の理解(進捗状況の理解や成功検出など)、計器の読み取り、ポインティング、空間推論など、身体化された推論機能に特化しています。
プレビュー版では、次のモデルを使用できます。
gemini-robotics-er-2-preview: Gemini 3.5 Flash をベースに、空間推論、動画の瞬間検索、動画の進行状況の分類、マルチロボット オーケストレーション、マルチステップ ツール使用が改善されています。技術仕様、トークンと割り当ての上限、サポートされている機能、リージョン別の提供状況、料金については、Gemini Robotics ER 2 モデルの情報ページをご覧ください。
このガイドでは、Gemini Enterprise Agent Platform で Google Gen AI SDK を使用します。すべての例で、enterprise=True を使用してクライアントを初期化し、 Google Cloud認証情報で認証します。これにより、独自の Google Cloud プロジェクトを使用してモデルを呼び出すことができます。
ロボティクス機能
次の表は、Gemini Robotics ER 2 の主な機能をまとめたものです。
| 能力 | 説明 | ガイド |
|---|---|---|
| 空間推論 | オブジェクトを指し示し、動画内で追跡し、境界ボックスで検出し、軌道を計画します。 | 空間推論 |
| エージェントによるコード実行 | コード実行を使用して、画像のズームや切り抜き、計器の読み取り、シーンへのアノテーションを行います。 | エージェント機能 |
| タスク オーケストレーション | 空間推論とカスタム ロボット API を組み合わせて、長期的なタスクを完了します。 | タスク オーケストレーション |
| 動画理解 | 連続した動画フィードからのモーメント検出と進行状況の分類。 | 動画に関する理解を深める |
始める前に
Agent Platform は、Gemini API キーではなく Google Cloud認証情報を使用して認証します。サンプルを実行する前に、次の設定を完了します。
Google Gen AI SDK をインストールする。
pip install --upgrade google-genaiGoogle Cloud プロジェクトで API を有効にし、プロジェクト ID があることを確認します。既存のプロジェクトを使用するか、新しいプロジェクトを作成します。
アプリケーションのデフォルト認証情報(ADC)を使用して認証する。ローカル開発の場合は、次のコマンドを実行します。
gcloud auth application-default loginAgent Platform バックエンドを使用してクライアントを初期化します。このページの Python の例では、すべて次のクライアントを使用しているため、独自のプロジェクト ID を設定します。
from google import genai

client = genai.Client(
    enterprise=True,
    project="your-project-id",
    location="global",
)
または、
enterprise=Trueをクライアントに渡す代わりに、GOOGLE_GENAI_USE_ENTERPRISE=True環境変数を設定することもできます。
使ってみる
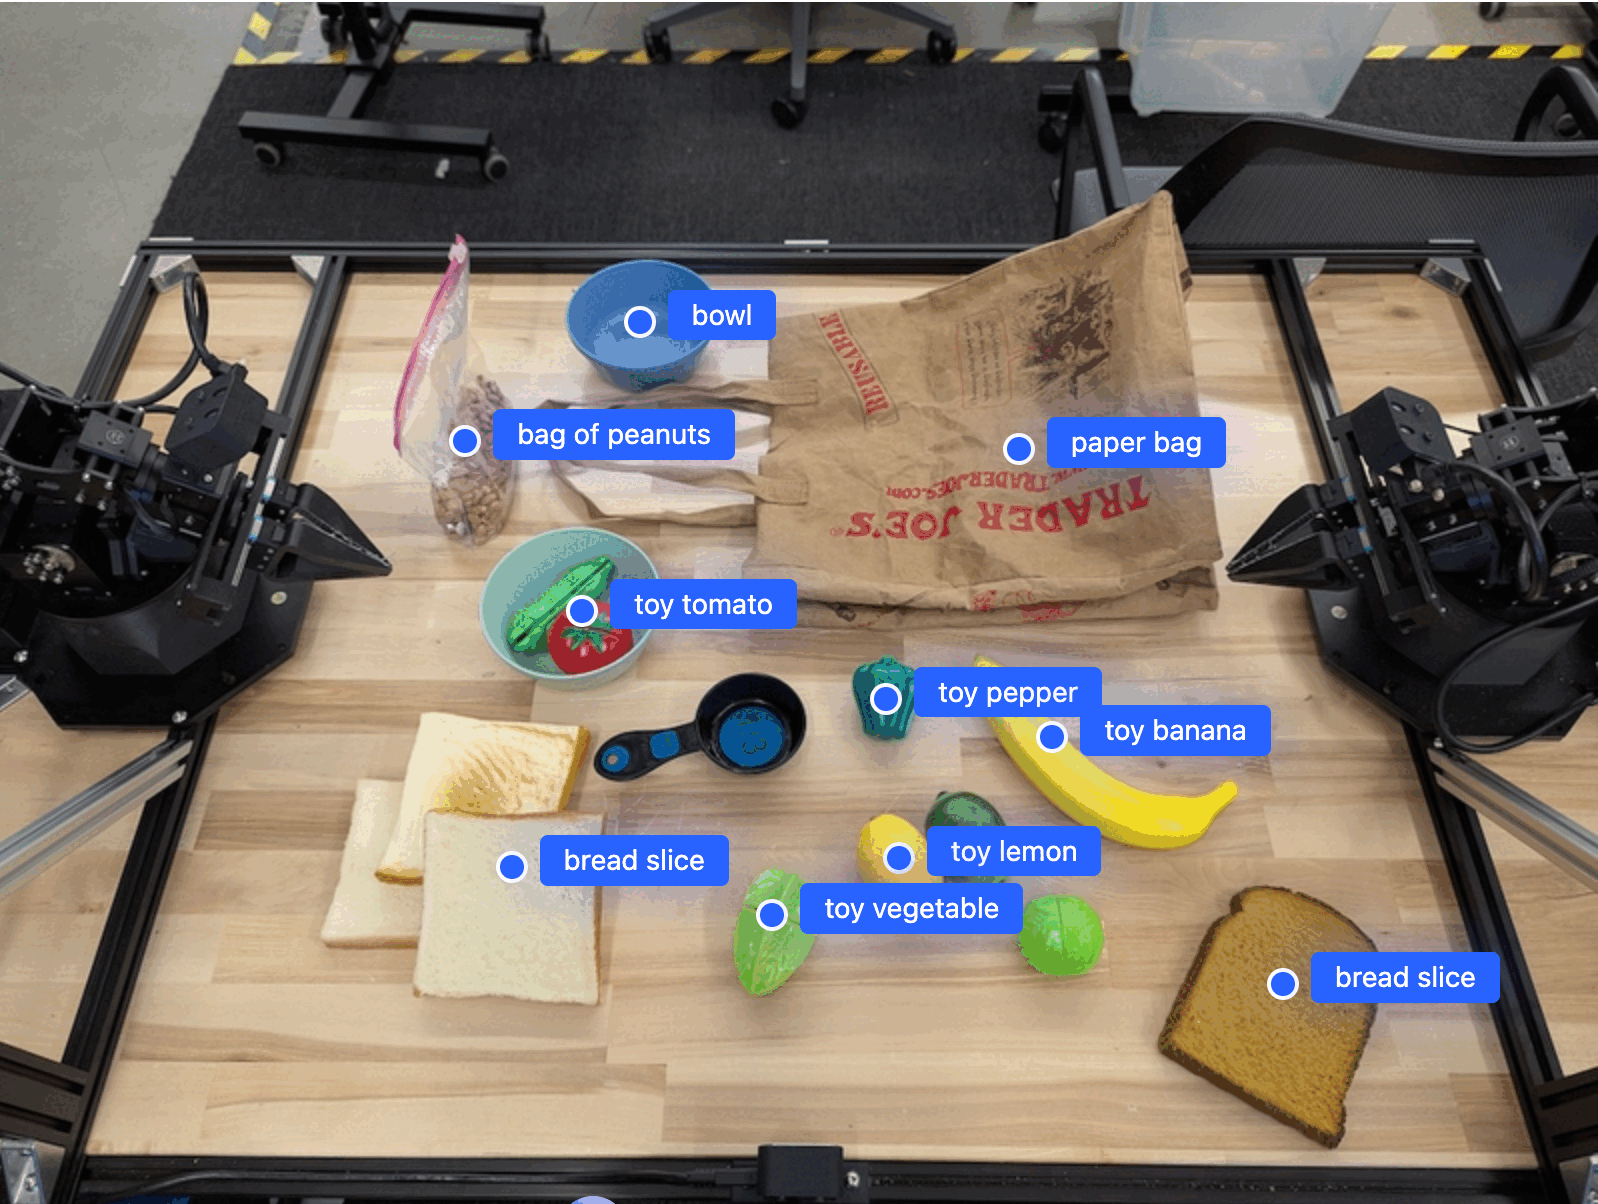
次の例では、画像内のオブジェクトを検出し、正規化された 2D 座標とラベルを返します。この出力は、ロボティクス API またはビジョン言語アクション(VLA)モデルに直接渡して、ロボット アクションを生成できます。
Python
from google import genai
from google.genai import types

PROMPT = """
          Point to no more than 10 items in the image. The label returned
          should be an identifying name for the object detected.
          The answer should follow the json format: [{"point": <point>,
          "label": <label1>}, ...]. The points are in [y, x] format
          normalized to 0-1000.
        """
client = genai.Client(
    enterprise=True,
    project="your-project-id",
    location="global",
)

# Load your image
with open("my-image.png", 'rb') as f:
    image_bytes = f.read()

image_response = client.models.generate_content(
    model="gemini-robotics-er-2-preview",
    contents=[
        types.Part.from_bytes(
            data=image_bytes,
            mime_type='image/png',
        ),
        PROMPT
    ],
    config = types.GenerateContentConfig(
        temperature=1.0,
        thinking_config=types.ThinkingConfig(
            thinking_level=types.ThinkingLevel.HIGH
        ),
    )
)

print(image_response.text)
REST
# First, ensure you have the image file locally.
# Encode the image to base64
IMAGE_BASE64=$(base64 -w 0 my-image.png)

# Set your Google Cloud project and location.
export PROJECT_ID="your-project-id"
export LOCATION="global"
export MODEL="gemini-robotics-er-2-preview"

# For the "global" location, use the aiplatform.googleapis.com host.
# For a regional location, prefix the host with the region, for example:
# https://us-central1-aiplatform.googleapis.com

curl -X POST \
  "https://aiplatform.googleapis.com/v1/projects/${PROJECT_ID}/locations/${LOCATION}/publishers/google/models/${MODEL}:generateContent" \
  -H "Authorization: Bearer $(gcloud auth application-default print-access-token)" \
  -H "Content-Type: application/json" \
  -d '{
    "contents": [
      {
        "parts": [
          {
            "inlineData": {
              "mimeType": "image/png",
              "data": "'"${IMAGE_BASE64}"'"
            }
          },
          {
            "text": "Point to no more than 10 items in the image. The label returned should be an identifying name for the object detected. The answer should follow the json format: [{\"point\": [y, x], \"label\": <label1>}, ...]. The points are in [y, x] format normalized to 0-1000."
          }
        ]
      }
    ],
    "generationConfig": {
      "temperature": 1.0,
      "thinkingConfig": {
        "thinkingLevel": "HIGH"
      }
    }
  }'
出力は、オブジェクトを含む JSON 配列になります。各オブジェクトには、point(正規化された [y, x] 座標)と、オブジェクトを識別する label が含まれます。
JSON
[
  {"point": [376, 508], "label": "small banana"},
  {"point": [287, 609], "label": "larger banana"},
  {"point": [223, 303], "label": "pink starfruit"},
  {"point": [435, 172], "label": "paper bag"},
  {"point": [270, 786], "label": "green plastic bowl"},
  {"point": [488, 775], "label": "metal measuring cup"},
  {"point": [673, 580], "label": "dark blue bowl"},
  {"point": [471, 353], "label": "light blue bowl"},
  {"point": [492, 497], "label": "bread"},
  {"point": [525, 429], "label": "lime"}
]
次の画像は、これらのポイントの表示例です。
仕組み
Gemini Robotics ER 2 は、自然言語プロンプトを使用して画像、動画、音声の入力を受け取ります。オブジェクトを識別し、シーンのコンテキストと空間関係を推論して、座標や境界ボックスなどの構造化された出力を返します。
また、エージェント型でもあります。複雑なタスクをサブタスクに分割し、ロボット関数を呼び出すか、生成されたコードを実行して、それらのサブタスクを実行します。たとえば、「リンゴをボウルに入れる」は、位置を特定し、つかみ、置くという一連のステップになります。
Gemini での関数呼び出しの仕組みについては、関数呼び出しページをご覧ください。
安全性
Gemini Robotics ER 2 は安全性を考慮して構築されていますが、ロボットの周囲の安全な環境を維持することは、お客様の責任です。生成 AI モデルは間違えることがあり、物理的なロボットは損傷を引き起こす可能性があります。安全性は最優先事項であり、実世界のロボット工学で使用される生成 AI モデルの安全性を確保することは、Google の研究において活発かつ重要な分野です。詳細については、Google DeepMind のロボティクス安全性ページをご覧ください。
ベスト プラクティス
Gemini Robotics ER 2 で最適な結果を得るには、次のベスト プラクティスに沿ってください。
わかりやすく自然言語を使用します。ロボットにさせたいことを、人に伝えるように説明します。用語が機能しない場合は、一般的な類義語を試してください。
視覚入力を最適化します。画像を送信する前に、小さいオブジェクトや不鮮明なオブジェクトを切り抜くか、ズームします。照明や色のコントラストが低いと、検出に影響することがあります。
複雑なタスクをステップに分割する。各ステップを個別のプロンプトとして送信して、各サブタスクの精度を向上させます。
高精度のタスクでは、クエリを複数回実行して結果を平均化します。このコンセンサス アプローチにより、空間出力の分散が減少します。
制限事項
Gemini Robotics ER 2 を使用して開発する場合は、次の制限事項を考慮してください。
- レイテンシとパフォーマンス: 複雑なクエリ、高解像度の入力、
thinking_level.HIGHにより、処理時間が長くなる可能性があります。レイテンシとパフォーマンスのバランスが取れたthinking_level.MEDIUMを使用します。 - ハルシネーション: すべての大規模言語モデルと同様に、Gemini Robotics ER 2 は、特に曖昧なプロンプトや分布外の入力に対して、「ハルシネーション」を起こしたり、不正確な情報を提供したりすることがあります。
- プロンプトの品質への依存: モデルの出力の品質は、入力プロンプトの明確さと具体性に大きく依存します。曖昧なプロンプトや構造が不適切なプロンプトは、最適な結果が得られない可能性があります。
- コンピューティング リソース: モデルの実行(特に動画入力や
thinking_level.HIGHを使用する場合)では、追加のコンピューティング リソースが消費されます。詳細については、思考のページをご覧ください。 入力タイプ: 各モダリティの制限事項の詳細については、次のトピックをご覧ください。
プライバシーに関するお知らせ
このドキュメントで言及されているモデル(「ロボティクス モデル」)は、お客様の指示に従ってハードウェアを操作および移動するために、動画データと音声データを利用します。したがって、特定できる人物のデータ(音声、画像、肖像データなど)(「個人データ」)がロボティクス モデルによって収集されるように、ロボティクス モデルを操作できます。個人データを収集する方法でロボティクス モデルを運用することを選択した場合、特定できる個人が、該当するエージェント プラットフォームの利用規約に記載されている個人データの収集と使用について十分に通知され、同意するまで、特定できる個人がロボティクス モデルとやり取りしたり、ロボティクス モデルの周囲に存在したりすることを許可しないことに同意するものとします。お客様は、当該通知が、本規約に記載されている個人データの収集および使用を許可することを保証するものとします。また、お客様は、顔のぼかしなどの技術を使用し、可能な限り、特定できる人物がいない場所でロボティクス モデルを運用することにより、個人データの収集および配布を最小限に抑えるために商業上合理的な努力を払うものとします。
次のステップ
Gemini Robotics ER 2 の詳細については、次のリソースをご覧ください。
- Gemini Robotics ER 2 モデル情報: 技術仕様、トークン制限、サポートされている機能。
- Gemini Robotics ER の料金: Agent Platform の料金の詳細。
- 空間推論: ポインティング、トラッキング、境界ボックス、軌跡。
- エージェント機能: コード実行、計器の読み取り、画像アノテーション。
- タスク オーケストレーション: カスタム ロボット API を使用した長期的なタスク。
- 動画の理解: モーメントの検出と進行状況の分類。
- Gemini Robotics ER 2 モデルカード: 評価ベンチマーク、アーキテクチャ、トレーニングの詳細。
- Gemini Robotics ER 2 のブログ投稿: Google DeepMind からのお知らせと概要。
- Google DeepMind のロボット工学の安全性: モデル ファミリーの基盤となる安全性研究。