


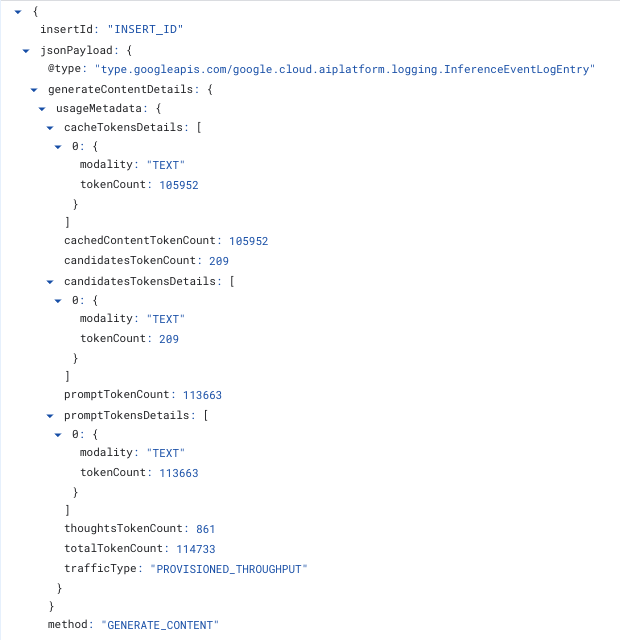
Agent Platform puede escribir una entrada de registro estructurada para cada solicitud de inferencia que entrega tu proyecto. Cada entrada registra metadatos sobre la solicitud: el modelo, la región, los recuentos de tokens (incluidos los tokens de entrada, los tokens de salida, los tokens almacenados en caché, los tokens de pensamiento), las reducciones de la capacidad de procesamiento aprovisionada, la latencia de la solicitud de extremo a extremo, el código de error y las etiquetas de encabezado o de solicitud que adjuntes. Las entradas van a Cloud Logging y puedes consultarlas con SQL en Estadísticas de observabilidad. Para activar el registro, consulta Habilita los registros de metadatos de solicitudes de inferencia.
El registro de solicitudes de inferencia solo registra metadatos. No registra instrucciones ni respuestas. Si necesitas contenido de instrucciones y respuestas, usa el registro de solicitudes y respuestas en su lugar.
En esta página, se describe cómo habilitar los registros de metadatos de solicitudes de inferencia, qué contiene cada entrada y cómo consultarlos.
Casos de uso
Los registros de metadatos de solicitudes de inferencia responden preguntas que las métricas agregadas no pueden:
- Atribuye la inversión de tokens a un equipo, una aplicación o un usuario, adjuntando tus propias etiquetas de encabezado, etiquetas de solicitud o ambas a cada solicitud.
- Consulta qué solicitudes individuales se descontaron de tu cuota de Capacidad de procesamiento aprovisionada y cuáles se entregaron según demanda.
- Desglosa la capacidad de procesamiento, la latencia y la tasa de errores por etiquetas de encabezado o de solicitud.
- Mide el comportamiento del almacenamiento en caché por solicitud, en lugar de hacerlo de forma agregada.
- Obtén visibilidad del uso en el segundo nivel, por ejemplo, por qué un proyecto recibió errores 429 o por qué se desbordó la capacidad de procesamiento aprovisionada. Para conocer los pasos para resolver los errores 429, consulta Soluciona problemas del código de error 429. Para encontrar los segundos en los que se recibieron, consulta Tasa de errores y latencia por región.
Métodos de API compatibles para el registro
Los registros de metadatos de solicitudes de inferencia son compatibles con lo siguiente:
- Modelos de Gemini que usan
generateContentostreamGenerateContent, incluida la generación de imágenes a través de esos métodos - Modelos de Claude que usan
rawPredictostreamRawPredict. No se registran otros modelos de socios. Para conocer los nombres de los campos de Claude, consulta Recuentos de tokens para los modelos de Claude.
Se admiten la capacidad de procesamiento aprovisionada y todas las opciones de pago por uso.
Las siguientes opciones no son compatibles:
chatCompletionsembedContent,predictycountTokens. Los modelos que generan imágenes a través depredict, como Imagen, no se registran.- Solicitudes a modelos ajustados, incluidos los modelos de Gemini ajustados con ajuste supervisado.
- Trabajos de ajuste, inferencia por lotes y cualquier otra operación de larga duración.
- Modelos que implementas tú mismo en un contenedor personalizado.
Habilita los registros de metadatos de solicitudes de inferencia
Puedes configurar los registros de metadatos de solicitudes de inferencia para todo un proyecto o para un modelo específico en una región determinada. Si necesitas habilitarlo a nivel de la organización, comunícate con tu equipo de cuentas. La configuración de los registros puede tardar unos minutos en aplicarse.
Antes de comenzar
- Asegúrate de tener los siguientes permisos de IAM en el proyecto:
aiplatform.endpoints.setPublisherModelConfigyaiplatform.endpoints.fetchPublisherModelConfigpara cambiar y leer el parámetro de configuración, ylogging.buckets.get,logging.buckets.list,logging.buckets.updateylogging.operations.getpara actualizar el bucket de registros. Para conocer los roles predefinidos que incluyen estos permisos, consulta Control de acceso y Control de acceso para Logging. - Decide si quieres
actualizar el bucket de registros
_Defaulta Estadísticas de observabilidad. Necesitas la actualización para consultar entradas con SQL o ver métricas detalladas en la consola de Google Cloud . La actualización tarda varios minutos y no se puede deshacer. Las entradas escritas antes de la actualización no se pueden consultar con SQL después. - Revisa los precios de Cloud Logging. Las entradas se almacenan durante el período de retención del bucket, que es de 30 días de forma predeterminada, y se aplican cargos por transferencia y almacenamiento de Cloud Logging. Para estimar tu costo, consulta Precios.
Habilita en la consola
Si habilitas el registro en la consola, se activará para todos los modelos del proyecto, tanto
Gemini como Claude, en la capacidad de procesamiento aprovisionada y en todas las
opciones de pago por uso que admiten los registros. También actualiza el bucket de registros _Default
si aún no se actualizó. Establece el valor predeterminado para todo el proyecto que se describe
en Precedencia de la configuración. Antes de comenzar, verifica los
permisos y la actualización del bucket.
En la consola de Google Cloud , ve a la página Capacidad de procesamiento aprovisionada.
Realiza una de las siguientes acciones:
- En el banner que dice Gemini Enterprise Agent Platform está actualizando la observabilidad, haz clic en Habilitar.
- En la barra de herramientas, haz clic en Configuración de métricas. Selecciona Habilitar métricas detalladas y, luego, haz clic en Guardar.

Figura 1. El banner de actualización de observabilidad en la página Capacidad de procesamiento aprovisionada. 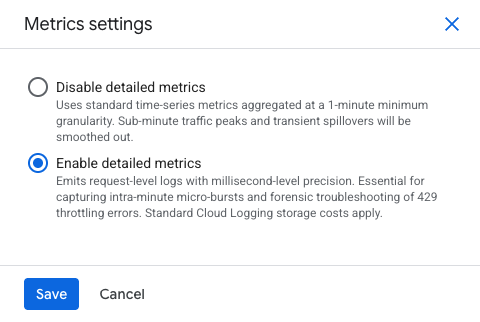
Figura 2: Panel de configuración de métricas, con la opción Habilitar métricas detalladas seleccionada. En el cuadro de diálogo ¿Quieres habilitar las métricas detalladas?, revisa los detalles de la actualización del bucket y el registro y, luego, haz clic en Habilitar.
El diálogo se cierra en cuanto se activa el registro. La actualización del bucket continúa en segundo plano
y puede tardar varios minutos. Mientras se ejecuta, el banner dice
"Las métricas detalladas están activadas y el bucket de registros _Default de este proyecto se está
actualizando a Estadísticas de observabilidad".
Si, en cambio, el banner informa que el bucket no se actualizó, haz clic en Actualizar para volver a intentarlo. Si se informa que el bucket no se puede actualizar, no se pueden consultar los registros por solicitud. Haz clic en Configuración de métricas y selecciona Inhabilitar métricas detalladas para detener los cargos.
Prioridad de la configuración
Agent Platform resuelve el parámetro de configuración para cada solicitud en este orden:
- La configuración por modelo y por región, si se establece una.
- Es el valor predeterminado para todo el proyecto, si no se establece el parámetro de configuración por modelo.
- Si no se establece ninguno, el registro estará desactivado.
La configuración por modelo tiene prioridad sobre la configuración predeterminada del proyecto. Puedes habilitar el registro en todo el proyecto y desactivarlo para un modelo de alto volumen en una región, o viceversa.
Habilita con la API de REST
Configura los registros de metadatos de la solicitud de inferencia con el método setPublisherModelConfig,
estableciendo inferenceEventLoggingConfig.state en ENABLED.
Para establecer el valor predeterminado de todo el proyecto, dirígete al proyecto:
curl -X POST \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://aiplatform.googleapis.com/v1beta1/projects/PROJECT_ID:setPublisherModelConfig" \
  -d '{
        "publisherModelConfig": {
          "inferenceEventLoggingConfig": {"state": "ENABLED"}
        },
        "updateMask": "inferenceEventLoggingConfig"
      }'
Para anular un modelo en una región, dirígete al modelo del publicador:
curl -X POST \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://aiplatform.googleapis.com/v1beta1/projects/PROJECT_ID/locations/LOCATION/publishers/PUBLISHER/models/MODEL:setPublisherModelConfig" \
  -d '{
        "publisherModelConfig": {
          "inferenceEventLoggingConfig": {"state": "ENABLED"}
        },
        "updateMask": "inferenceEventLoggingConfig"
      }'
Establece PUBLISHER en google para los modelos de Gemini y en anthropic para
los modelos de Claude. Por ejemplo, para habilitar el registro de Claude Sonnet 4.5 en el
extremo global, usa publishers/anthropic/models/claude-sonnet-4-5 con
LOCATION establecido en global. Para obtener los IDs de los modelos de Claude, consulta
Modelos de Claude.
El método devuelve una operación de larga duración.
Obtén la configuración de registros
Lee la configuración actual con el método fetchPublisherModelConfig. Usa
el proyecto para leer el valor predeterminado de todo el proyecto o un modelo de publicador para leer su
anulación.
curl -X GET \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  "https://aiplatform.googleapis.com/v1beta1/projects/PROJECT_ID:fetchPublisherModelConfig"
curl -X GET \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  "https://aiplatform.googleapis.com/v1beta1/projects/PROJECT_ID/locations/LOCATION/publishers/PUBLISHER/models/MODEL:fetchPublisherModelConfig"
La respuesta contiene los parámetros de configuración que se establecen en ese recurso:
{
  "inferenceEventLoggingConfig": {
    "state": "ENABLED"
  }
}
Verifica que el registro funcione
- Envía una solicitud a un modelo que hayas habilitado.
En el Explorador de registros, ejecuta la siguiente consulta. La mayoría de las entradas aparecen en un plazo de 12 segundos, pero pueden tardar hasta 5 minutos.
logName="projects/PROJECT_ID/logs/aiplatform.googleapis.com%2Finference_request"Para confirmar que SQL funciona, abre Estadísticas de observabilidad y ejecuta cualquier consulta de ejemplo. Si la consulta informa que no se encontró el conjunto de datos, la actualización del bucket de registros no finalizó.
Inhabilita el registro
En la consola de Google Cloud , ve a la página Capacidad de procesamiento aprovisionada, haz clic en Configuración de métricas, selecciona Inhabilitar métricas detalladas y, luego, haz clic en Guardar. Esto revierte la acción Habilitar en la consola.
Con la API de REST, sigue estos pasos.
Para inhabilitar el registro, configura inferenceEventLoggingConfig.state como DISABLED en
el mismo recurso en el que lo habilitaste.
curl -X POST \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://aiplatform.googleapis.com/v1beta1/projects/PROJECT_ID:setPublisherModelConfig" \
  -d '{
        "publisherModelConfig": {
          "inferenceEventLoggingConfig": {"state": "DISABLED"}
        },
        "updateMask": "inferenceEventLoggingConfig"
      }'
Debido a que un parámetro de configuración por modelo tiene prioridad sobre el valor predeterminado del proyecto, inhabilitar a nivel del proyecto no desactiva un modelo que está habilitado de forma explícita. Borra o inhabilita también el parámetro de configuración por modelo.
Dónde se escriben los registros
Las entradas se escriben en el siguiente registro:
projects/PROJECT_NUMBER/logs/aiplatform.googleapis.com%2Finference_request
Desde allí, tienes los destinos estándar de Cloud Logging:
- Estadísticas de observabilidad: Consulta las entradas con SQL en Estadísticas de observabilidad en la consola deGoogle Cloud .
- Conjunto de datos de BigQuery vinculado: Vincula un conjunto de datos para leer los mismos datos desde BigQuery. Para obtener más detalles, consulta Consulta un conjunto de datos de BigQuery vinculado.
- Receptores agregados: Recopila entradas de cada proyecto en una carpeta o
organización con un solo receptor. Filtrar por
logName="projects/*/logs/aiplatform.googleapis.com%2Finference_request".
Para recopilar entradas de cada proyecto en una carpeta u organización, consulta Descripción general de los receptores agregados.
Las entradas se pueden consultar poco después de que se completa la solicitud. La mayoría de las entradas se pueden consultar en un plazo de 12 segundos; se permiten hasta 5 minutos.
Esquema de entrada de registro
Cada entrada tiene dos partes que consultas por separado: el recurso supervisado y sus etiquetas, que identifican qué entregó la solicitud, y la carga útil de JSON, que registra lo que hizo la solicitud. En las siguientes secciones, se describen ambos.
Etiquetas de recursos
Para los modelos de publicador compartidos, el tipo de recurso supervisado es
aiplatform.googleapis.com/PublisherModel, con las siguientes etiquetas.
| Etiqueta | Tipo | Notas |
|---|---|---|
resource_container |
STRING |
Es el proyecto que entregó la solicitud. |
location |
STRING |
La región que entregó la solicitud, por ejemplo, us-central1. Las solicitudes enviadas al extremo global informan global. |
publisher |
STRING |
El publicador del modelo, por ejemplo, google o anthropic. |
model_user_id |
STRING |
El modelo, por ejemplo, gemini-2.5-pro. |
Campos de carga útil
| Nombre del campo | Tipo | Notas |
|---|---|---|
method |
ENUM |
GENERATE_CONTENT, STREAM_GENERATE_CONTENT, RAW_PREDICT o STREAM_RAW_PREDICT. |
trafficType |
ENUM |
Es la opción de consumo que entregó la solicitud. Los valores actuales son PROVISIONED_THROUGHPUT, ON_DEMAND, ON_DEMAND_FLEX y ON_DEMAND_PRIORITY. No está presente en las solicitudes con errores. |
requestStartTime |
TIMESTAMP |
Es la hora en que el frontend de entrega admitió la solicitud. |
requestDuration |
STRING |
Es la latencia de entrega de extremo a extremo, con formato de cadena de duración, como 3.53s. |
generateContentDetails.usageMetadata |
JSON |
Recuentos de tokens para generateContent y streamGenerateContent, incluidos los desgloses por modalidad. El resultado de la imagen aparece aquí como una entrada IMAGE en candidatesTokensDetails. |
rawPredictDetails.usageMetadata |
JSON |
Recuentos de tokens para rawPredict y streamRawPredict, incluidos los modelos de socios. |
provisionedThroughput |
JSON |
Está presente para el tráfico de capacidad de procesamiento aprovisionada. |
httpHeaders |
JSON |
Son los encabezados de la solicitud capturados. |
error |
JSON |
Solo está presente cuando la gravedad es ERROR. |
principal |
JSON |
Es la cuenta de servicio que emitió la solicitud, cuando está disponible. |
El campo LogEntry.labels contiene gen_ai.operation.name, que sigue las
convenciones semánticas de la IA generativa de OpenTelemetry. Tanto generateContent como
streamGenerateContent informan generate_content. Tanto rawPredict como
streamRawPredict informan raw_predict.
Campos de capacidad de procesamiento aprovisionada
| Nombre del campo | Tipo | Notas |
|---|---|---|
ptChargedInputTokenCount |
INT64 |
Son los tokens de entrada que se consideran en tu cuota de Capacidad de procesamiento aprovisionada, después de que se aplican las tasas de consumo. |
ptChargedOutputTokenCount |
INT64 |
Los tokens de salida se consideran en tu cuota de Capacidad de procesamiento aprovisionada, después de que se aplican las tasas de consumo. |
accountingResource |
STRING |
El proyecto cuyo compromiso de Capacidad de procesamiento aprovisionada se usó para la solicitud. |
Identifica las solicitudes de desbordamiento
Una solicitud se desborda cuando era apta para la capacidad de procesamiento aprovisionada, pero
se entregó según demanda porque se agotó tu capacidad de procesamiento. Una entrada de desbordamiento tiene
un trafficType de ON_DEMAND y ningún objeto provisionedThroughput. Una solicitud de pago por uso común se ve igual, por lo que debes usar las siguientes reglas para distinguirlas:
- Si enviaste
X-Vertex-AI-LLM-Request-Typecon un valor deshared, enrutaste la solicitud al pago por uso a propósito. No es un desbordamiento. - Si no enviaste ningún encabezado
X-Vertex-AI-LLM-Request-Typeo un valor que no seadedicatedoshared, y la entrada informaON_DEMAND, la solicitud se desbordó, siempre que tengas la capacidad de procesamiento aprovisionada para ese modelo en esa región. - Si no tienes capacidad de procesamiento aprovisionada para el modelo, cada
entrada de
ON_DEMANDes de pago por uso común.
Para conocer los valores de los encabezados, consulta Usa la capacidad de procesamiento aprovisionada.
Para obtener una consulta que cuente las solicitudes de desbordamiento, consulta Desbordamiento por minuto.
Identifica las solicitudes que se cambiaron a una versión anterior
Una solicitud se cambia a una versión inferior cuando solicitas una opción de pago por uso y se
entrega en otra. Compara el encabezado X-Vertex-AI-LLM-Shared-Request-Type que
enviaste con el trafficType que entregó la solicitud:
| Valor del encabezado que enviaste | trafficType cuando se publica según lo solicitado |
|---|---|
priority |
ON_DEMAND_PRIORITY |
flex |
ON_DEMAND_FLEX |
Cualquier otro trafficType en una entrada correcta significa que la solicitud se cambió a una versión anterior
o que el modelo no ofrece la opción que solicitaste. Para obtener una consulta, consulta
Cambios a una versión inferior por modelo.
Códigos de error
Las solicitudes con errores se escriben con una gravedad de ERROR y llevan un objeto error
con un código de estado de gRPC y un motivo canónico. El motivo es una cadena fija. Nunca contiene texto de instrucciones, texto de respuesta ni valores de encabezado.
| Código | Estado | Estado HTTP típico |
|---|---|---|
8 |
Se agotó el recurso, por ejemplo, un límite de cuota. | 429 |
4 |
El plazo venció antes de que se completara la operación. | 504 |
14 |
El servicio no está disponible. | 503 |
13 |
Se produjo un error interno. | 500 |
3 |
La solicitud contiene un argumento no válido. | 400 |
7 |
El emisor no tiene permiso. | 403 |
5 |
No se encontró la entidad solicitada. | 404 |
Adjunta etiquetas de encabezado personalizadas
Para atribuir el uso a tus propias dimensiones, como un equipo, una aplicación o un usuario, envía encabezados de la solicitud con el prefijo
x-goog-agent-platform-observability-label-:
x-goog-agent-platform-observability-label-team: payments
x-goog-agent-platform-observability-label-application: invoice-ocr
Cada encabezado aparece en la entrada en jsonPayload.httpHeaders. Las etiquetas de encabezado
funcionan en los modelos de Gemini con generateContent y
streamGenerateContent, y en los modelos de Claude con rawPredict y
streamRawPredict, en la capacidad de procesamiento aprovisionada y en todas las opciones de
pago por uso.
Para ver ejemplos de llamadas a la API con etiquetas de encabezado, las entradas de registro que producen, los modelos compatibles, los límites y cómo se comparan las etiquetas de encabezado con las etiquetas de solicitud, consulta Etiquetas de metadatos personalizados. Para consultarlos, consulta Uso por etiqueta de encabezado personalizada.
Consulta los registros con el Explorador de registros
Usa el Explorador de registros para buscar y, luego, inspeccionar solicitudes de inferencia individuales. No necesita configuración más allá de tener habilitado el registro, y lee el registro directamente, por lo que las entradas son visibles en cuanto llegan.
En la consola de Google Cloud , ve a la página Explorador de registros y, en el campo del editor de consultas, ingresa una consulta con el lenguaje de consulta de Logging. Para obtener más información sobre los paneles y los controles, consulta Interfaz del Explorador de registros.
Comienza con el nombre del registro, que selecciona cada entrada de solicitud de inferencia en el proyecto:
logName="projects/PROJECT_ID/logs/aiplatform.googleapis.com%2Finference_request"
Agrega términos para limitar los resultados. Los términos en líneas separadas se combinan con AND.
- Para seleccionar las solicitudes que se entregan desde una región, agrega
resource.labels.location="us-central1". - Para seleccionar un método de API, agrega
jsonPayload.method="GENERATE_CONTENT". - Para seleccionar solo el tráfico de capacidad de procesamiento aprovisionada, agrega
jsonPayload.trafficType="PROVISIONED_THROUGHPUT". - Para seleccionar solo errores de cuota, agrega
severity=ERRORyjsonPayload.error.code=8. - Para seleccionar un valor de etiqueta de encabezado personalizado, agrega
jsonPayload.httpHeaders."x-goog-agent-platform-observability-label-team".values="payments".
El Explorador de registros filtra y muestra las entradas. No los agrega. Para contar, agrupar o graficar tus entradas, usa las Estadísticas de observabilidad. En la barra de herramientas Resultados de la consulta, haz clic en Analizar resultados para transferir tu consulta actual. Ese botón aparece solo después de que se actualiza el bucket de registros.
Consulta y analiza registros con Estadísticas de observabilidad
Puedes usar Estadísticas de observabilidad para consultar y analizar registros.
Antes de comenzar
Las Estadísticas de observabilidad responden preguntas que el Explorador de registros no puede responder. El Explorador de registros busca y muestra entradas individuales, que es lo que quieres cuando buscas una solicitud. Estadísticas de observabilidad ejecuta SQL en todo el conjunto, por lo que puede contar, agrupar, unir y calcular percentiles. Cada pregunta en esta sección necesita agregación: el gasto por equipo, el burndown por proyecto y la latencia p95 por región no se pueden responder una entrada a la vez.
Para ello, se debe actualizar el bucket de registros _Default de tu proyecto para usar
Estadísticas de observabilidad. Para obtener más
información, consulta Configura buckets de registros.
Los siguientes ejemplos se ejecutan en Estadísticas de observabilidad. Reemplaza PROJECT_ID
por tu proyecto.
Capacidad de procesamiento por región y modelo
SELECT
  JSON_VALUE(resource.labels.location)      AS region,
  JSON_VALUE(resource.labels.model_user_id) AS model,
  JSON_VALUE(json_payload.trafficType)      AS traffic_type,
  COUNT(*)                                  AS requests,
  SUM(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.promptTokenCount) AS INT64))     AS input_tokens,
  SUM(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.candidatesTokenCount) AS INT64)) AS output_tokens
FROM `PROJECT_ID.global._Default._Default`
WHERE log_id = "aiplatform.googleapis.com/inference_request"
  AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 24 HOUR)
GROUP BY region, model, traffic_type
ORDER BY requests DESC
Consumo de la capacidad de procesamiento aprovisionada por proyecto
SELECT
  JSON_VALUE(resource.labels.location) AS region,
  JSON_VALUE(json_payload.provisionedThroughput.accountingResource) AS pt_project,
  COUNTIF(JSON_VALUE(json_payload.trafficType) = "PROVISIONED_THROUGHPUT") AS pt_requests,
  COUNTIF(JSON_VALUE(json_payload.trafficType) = "ON_DEMAND")              AS on_demand_requests,
  SUM(CAST(JSON_VALUE(json_payload.provisionedThroughput.ptChargedInputTokenCount)  AS INT64)) AS pt_input_tokens,
  SUM(CAST(JSON_VALUE(json_payload.provisionedThroughput.ptChargedOutputTokenCount) AS INT64)) AS pt_output_tokens
FROM `PROJECT_ID.global._Default._Default`
WHERE log_id = "aiplatform.googleapis.com/inference_request"
  AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 24 HOUR)
GROUP BY region, pt_project
ORDER BY pt_input_tokens DESC
Uso por etiqueta de encabezado personalizada
SELECT
  JSON_VALUE(json_payload.httpHeaders
    ["x-goog-agent-platform-observability-label-team"].values[0]) AS team,
  COUNT(*) AS requests,
  SUM(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.totalTokenCount) AS INT64)) AS total_tokens
FROM `PROJECT_ID.global._Default._Default`
WHERE log_id = "aiplatform.googleapis.com/inference_request"
  AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 7 DAY)
GROUP BY team
ORDER BY total_tokens DESC
Tokens consumidos por minuto, Gemini y Claude en paralelo
Esta consulta informa los tokens consumidos por minuto en una columna por publicador. Cada
columna pondera los tipos de tokens de la misma manera que lo hace la
métrica publisher/online_serving/consumed_token_throughput para ese
publicador, por lo que cada columna coincide con Cloud Monitoring. Gemini y
Claude ponderan los tokens de salida y de caché de forma diferente, por lo que no debes sumar las dos
columnas. Para los campos de Claude, consulta
Recuentos de tokens para los modelos de Claude.
SELECT
  TIMESTAMP_TRUNC(timestamp, MINUTE) AS minute_ts,
  SUM(IF(JSON_VALUE(resource.labels.publisher) = "google",
    IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.promptTokenCount) AS INT64), 0)
      + IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.toolUsePromptTokenCount) AS INT64), 0)
      - 0.9 * IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.cachedContentTokenCount) AS INT64), 0)
      + IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.candidatesTokenCount) AS INT64), 0)
      + IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.thoughtsTokenCount) AS INT64), 0), 0)) AS gemini_consumed_tokens,
  SUM(IF(JSON_VALUE(resource.labels.publisher) = "anthropic",
    IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.input_tokens) AS INT64), 0)
      + 0.1  * IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.cache_read_input_tokens) AS INT64), 0)
      + 1.25 * IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.cache_creation_input_tokens) AS INT64), 0)
      + 0.75 * IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.cache_creation.ephemeral_1h_input_tokens) AS INT64), 0)
      + 5    * IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.output_tokens) AS INT64), 0), 0)) AS claude_consumed_tokens
FROM `PROJECT_ID.global._Default._Default`
WHERE log_id = "aiplatform.googleapis.com/inference_request"
  AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 24 HOUR)
GROUP BY minute_ts
ORDER BY minute_ts DESC
Tasa de aciertos de caché en Gemini y Claude
La tasa de aciertos de caché es la cantidad de tokens de entrada almacenados en caché dividida por la cantidad total de tokens de entrada. La entrada de Gemini incluye tokens de uso de herramientas, ya que la caché puede cubrirlos. La entrada de Claude es la entrada no almacenada en caché más las lecturas de caché más las escrituras de caché. Para saber cómo almacena en caché cada publicador, consulta Descripción general del almacenamiento en caché de contexto y Almacenamiento en caché de instrucciones de Claude.
SELECT
  JSON_VALUE(resource.labels.model_user_id) AS model,
  JSON_VALUE(json_payload.trafficType)      AS traffic_type,
  ROUND(100 * SAFE_DIVIDE(
    SUM(IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.cachedContentTokenCount) AS INT64), 0)
      + IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.cache_read_input_tokens) AS INT64), 0)),
    SUM(GREATEST(
          IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.promptTokenCount) AS INT64), 0)
          + IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.toolUsePromptTokenCount) AS INT64), 0),
          IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.cachedContentTokenCount) AS INT64), 0))
      + IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.input_tokens) AS INT64), 0)
      + IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.cache_read_input_tokens) AS INT64), 0)
      + IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.cache_creation_input_tokens) AS INT64), 0))), 1) AS cache_hit_rate_pct
FROM `PROJECT_ID.global._Default._Default`
WHERE log_id = "aiplatform.googleapis.com/inference_request"
  AND JSON_VALUE(json_payload.trafficType) IS NOT NULL
  AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 7 DAY)
GROUP BY model, traffic_type
ORDER BY model, traffic_type
Cambios a una versión inferior por modelo
Esta consulta compara la opción de pago por uso que solicitó cada solicitud con la opción que la entregó. Para saber cómo se identifican las versiones anteriores, consulta Identifica las solicitudes de versiones anteriores.
WITH entries AS (
  SELECT
    JSON_VALUE(resource.labels.model_user_id) AS model,
    severity,
    JSON_VALUE(json_payload.trafficType)      AS served,
    (SELECT LOWER(v)
     FROM UNNEST(JSON_VALUE_ARRAY(json_payload.httpHeaders["x-vertex-ai-llm-shared-request-type"].values)) AS v
     WHERE LOWER(v) IN ("priority", "flex")
     LIMIT 1)                                 AS requested
  FROM `PROJECT_ID.global._Default._Default`
  WHERE log_id = "aiplatform.googleapis.com/inference_request"
    AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 7 DAY)
)
SELECT
  model,
  requested,
  COUNTIF(served = CONCAT("ON_DEMAND_", UPPER(requested))) AS served_as_requested,
  COUNTIF(served IS NOT NULL
          AND served != CONCAT("ON_DEMAND_", UPPER(requested))) AS downgraded,
  COUNTIF(severity = "ERROR")                              AS failed
FROM entries
WHERE requested IS NOT NULL
GROUP BY model, requested
ORDER BY downgraded DESC
Derrame por minuto
Esta consulta cuenta las solicitudes de desbordamiento por minuto para cada modelo que tuvo tráfico de capacidad de procesamiento aprovisionada en la ventana. Para saber cómo se identifica el desbordamiento, consulta Identifica las solicitudes de desbordamiento.
WITH entries AS (
  SELECT
    timestamp,
    JSON_VALUE(resource.labels.location)      AS region,
    JSON_VALUE(resource.labels.model_user_id) AS model,
    JSON_VALUE(json_payload.trafficType)      AS traffic_type,
    EXISTS(
      SELECT 1
      FROM UNNEST(JSON_VALUE_ARRAY(json_payload.httpHeaders["x-vertex-ai-llm-request-type"].values)) AS v
      WHERE LOWER(v) IN ("dedicated", "shared")) AS routed_by_header
  FROM `PROJECT_ID.global._Default._Default`
  WHERE log_id = "aiplatform.googleapis.com/inference_request"
    AND severity = "INFO"
    AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 24 HOUR)
),
pt_models AS (
  SELECT DISTINCT region, model FROM entries WHERE traffic_type = "PROVISIONED_THROUGHPUT"
)
SELECT
  TIMESTAMP_TRUNC(e.timestamp, MINUTE) AS minute_ts,
  e.region,
  e.model,
  COUNTIF(e.traffic_type = "PROVISIONED_THROUGHPUT")              AS pt_requests,
  COUNTIF(e.traffic_type = "ON_DEMAND" AND NOT e.routed_by_header) AS spillover_requests
FROM entries AS e
JOIN pt_models USING (region, model)
GROUP BY minute_ts, e.region, e.model
HAVING spillover_requests > 0
ORDER BY minute_ts DESC
Tasa de errores y latencia por región
SELECT
  JSON_VALUE(resource.labels.location) AS region,
  TIMESTAMP_TRUNC(timestamp, MINUTE)   AS minute_ts,
  COUNT(*)                             AS total,
  COUNTIF(severity = "ERROR")          AS errors,
  COUNTIF(CAST(JSON_VALUE(json_payload.error.code) AS INT64) = 8) AS resource_exhausted,
  APPROX_QUANTILES(
    CAST(REGEXP_REPLACE(JSON_VALUE(json_payload.requestDuration), r"s$", "") AS FLOAT64),
    100)[OFFSET(95)] AS p95_latency_seconds
FROM `PROJECT_ID.global._Default._Default`
WHERE log_id = "aiplatform.googleapis.com/inference_request"
  AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 6 HOUR)
GROUP BY region, minute_ts
ORDER BY minute_ts DESC
Recuentos de tokens para los modelos de Claude
Los modelos de Claude informan el uso en rawPredictDetails.usageMetadata, con los
nombres de los campos de la API de Claude. Tanto rawPredict como streamRawPredict escriben los mismos campos. En el caso de la transmisión, el registro combina el informe de uso en la transmisión.
| Campo | Qué cuenta |
|---|---|
input_tokens |
Tokens de entrada que no se leyeron ni se escribieron en la caché. |
cache_read_input_tokens |
Son los tokens de entrada que se leen de la caché de instrucciones. |
cache_creation_input_tokens |
Tokens de entrada escritos en la caché de instrucciones, ambos TTL combinados. |
cache_creation.ephemeral_5m_input_tokens |
Escrituras en caché con un TTL de 5 minutos. |
cache_creation.ephemeral_1h_input_tokens |
Escrituras en caché con un TTL de 1 hora. |
output_tokens |
Tokens de salida, incluido el razonamiento extendido. No agregues tokens de razonamiento por separado. |
La entrada total de Claude es input_tokens más cache_read_input_tokens más
cache_creation_input_tokens. Gemini difiere: promptTokenCount
ya incluye tokens almacenados en caché.
Las entradas de Claude no incluyen un desglose de modalidades. Las etiquetas de encabezado funcionan de la misma manera para Gemini y Claude. Consulta Adjunta etiquetas de encabezado personalizadas.
Precios
El registro de metadatos de solicitudes de inferencia escribe en Cloud Logging y se factura como transferencia y almacenamiento de Cloud Logging. Las consultas a través de las Estadísticas de observabilidad se facturan como uso de Cloud Monitoring. Vincular un conjunto de datos de BigQuery no agrega cargos de almacenamiento de BigQuery.
El tamaño de la entrada depende de tus solicitudes, por ejemplo, de cuántas etiquetas de encabezado contengan. Para estimar el costo, habilita el registro de una carga de trabajo representativa durante un día, mide el volumen transferido con el Análisis del volumen de registros y, luego, proyecta el volumen mensual en la calculadora de precios deGoogle Cloud .
¿Qué sigue?
- Obtén más información para supervisar modelos con métricas.
- Obtén información para supervisar los costos con etiquetas de metadatos personalizados.
- Usa el registro de solicitudes y respuestas si necesitas el contenido de las instrucciones y las respuestas.
- Obtén información sobre la capacidad de procesamiento aprovisionada.
- Consulta las métricas detalladas de la capacidad de procesamiento aprovisionada en la consola de Google Cloud .
- Soluciona problemas de errores 429.
- Recopila entradas de cada proyecto en una carpeta u organización con receptores agregados.