


שכפול של מערכי נתונים באזורים שונים
באמצעות שכפול מערכי נתונים ב-BigQuery, אתם יכולים להגדיר שכפול אוטומטי של מערך נתונים בין שני אזורים שונים או בין מספר אזורים.
סקירה כללית
כשיוצרים מערך נתונים ב-BigQuery, בוחרים את האזור או את מספר האזורים שבהם הנתונים מאוחסנים. אזור הוא אוסף של מרכזי נתונים בתוך אזור גיאוגרפי, ומספר אזורים הוא אזור גיאוגרפי גדול שמכיל שני אזורים גיאוגרפיים או יותר. הנתונים מאוחסנים באחד מהאזורים הכלולים, ולא נוצרת להם רפליקה בתוך מספר האזורים. מידע נוסף על אזורים ועל מספר אזורים זמין במאמר מיקומים ב-BigQuery.
ב-BigQuery תמיד נשמרים עותקים של הנתונים בשניGoogle Cloud אזורים שונים במיקום של מערך הנתונים. תחום הוא מקום הפריסה של משאבי Google Cloud בתוך אזור מסוים. בכל האזורים, הרפליקציה בין אזורים משתמשת בכתיבה כפולה סינכרונית. בחירה במיקום במספר אזורים לא מספקת רפליקציה בין אזורים או יתירות אזורית, כך שאין עלייה בזמינות של מערך הנתונים במקרה של הפסקה אזורית. הנתונים מאוחסנים באזור אחד בתוך המיקום הגיאוגרפי.
כדי להוסיף שכפול נתונים בשני מקומות שונים, אפשר לשכפל כל מערך נתונים. BigQuery יוצר רפליקה משנית של קבוצת הנתונים, שנמצאת באזור אחר שאתם מציינים. לאחר מכן, הרפליקה הזו משוכפלת באופן אסינכרוני בין שני אזורים באזור השני, כך שנוצרים בסך הכול ארבעה עותקים אזוריים.
שכפול של מערך נתונים
אם משכפלים מערך נתונים, BigQuery מאחסן את הנתונים באזור שציינתם.
האזור הראשי. כשיוצרים מערך נתונים בפעם הראשונה, BigQuery ממקם אותו באזור הראשי.
אזור משני. כשמוסיפים רפליקה של מערך נתונים, BigQuery ממקם את הרפליקה באזור המשני.
בהתחלה, הרפליקה באזור הראשי היא הרפליקה הראשית, והרפליקה באזור המשני היא הרפליקה המשנית.
הרפליקה הראשית ניתנת לכתיבה, והרפליקה המשנית היא לקריאה בלבד. פעולות כתיבה ברפליקה הראשית משוכפלות באופן אסינכרוני לרפליקה המשנית. בכל אזור, הנתונים מאוחסנים באופן יתיר בשני אזורים. התנועה ברשת אף פעם לא יוצאת מהרשת של Google Cloud .
בתרשים הבא מוצג תהליך השכפול שמתרחש כשמשכפלים מערך נתונים:
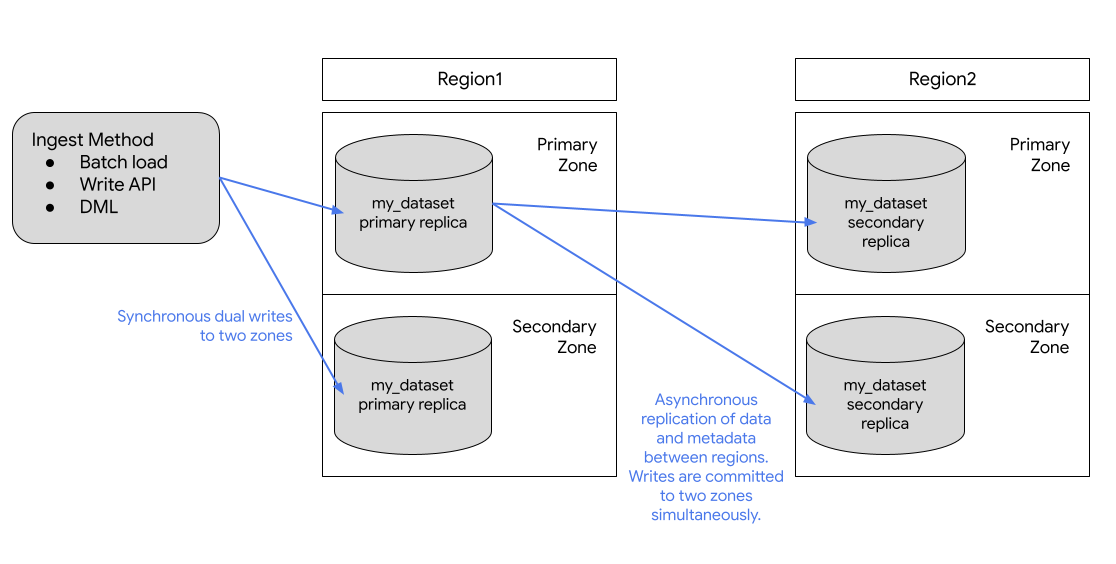
אם האזור הראשי אונליין, אתם יכולים לעבור ידנית לרפליקה המשנית. מידע נוסף זמין במאמר קידום הרפליקה המשנית.
רפליקציה ו-DML
ב-BigQuery, הנתונים מאוחסנים בבלוקים שלא ניתנים לשינוי. פעולות של שפת טיפול בנתונים (DML) (כמו ההצהרות UPDATE, DELETE או MERGE) משכתבות את הנתונים ששונו ואת הנתונים שלא שונו מהקבצים המושפעים, לבלוקים חדשים של אחסון בסיסי. מכיוון שהרפליקציה בין אזורים מתרחשת ברמת הקובץ, אחרי הרצת פעולת DML, BigQuery צריך לשכפל את כל הקובץ החדש לאזור המשני.
לדוגמה, כדי לעדכן נתונים בנפח של 100MB בקובץ אחסון בנפח של 1GB, צריך לשכפל ב-BigQuery את כל הקובץ החדש שנוצר בנפח של 1GB, ולא רק את ה-100MB המעודכנים. פעולות DML תכופות בטבלאות גדולות או לא מחולקות למחיצות יכולות להגדיל באופן משמעותי את הנפח הכולל של הנתונים שמועברים.
בגלל ההתנהגות הזו, פעולות DML תכופות בנתונים משוכפלים יכולות להוביל לעלייה חדה בעלויות של העברת הנתונים. במקום זאת, העבירו את הטבלאות עם הרבה פעולות DML למערך נתונים נפרד שלא משוכפל.
תמחור
החיוב על מערכי נתונים משוכפלים כולל את הפריטים הבאים:
- אחסון. בייטים של אחסון באזור המשני מחויבים כעותק נפרד באזור המשני. טבלאות ומחיצות באחסון לטווח ארוך לא מאופסות לאחסון פעיל ברפליקה המשנית.
- שכפול נתונים. למידע נוסף על החיוב על שכפול נתונים, קראו את המאמר תמחור של שכפול נתונים.
שכפול הנתונים מנוהל על ידי BigQuery ולא משתמש במשאבי ה-slot שלכם. החיוב על רפליקציית נתונים מתבצע בנפרד.
קיבולת המחשוב באזור המשני
כדי להריץ משימות ושאילתות על הרפליקה באזור המשני, צריך לרכוש משבצות באזור המשני או להריץ שאילתה על פי דרישה.
אתם יכולים להשתמש במשבצות כדי לבצע שאילתות לקריאה בלבד מהרפליקה המשנית. אם תקדמו את הרפליקה המשנית להיות הראשית, תוכלו להשתמש במשבצות האלה גם כדי לכתוב לרפליקה.
אתם יכולים לרכוש את אותו מספר של slots כמו באזור הראשי, או מספר שונה של slots. אם תרכשו פחות חריצים, יכול להיות שזה ישפיע על ביצועי השאילתות.
שיקולים בקשר למיקום
לפני שמוסיפים רפליקה של מערך נתונים, צריך ליצור ב-BigQuery את מערך הנתונים הראשוני שרוצים לשכפל, אם הוא עדיין לא קיים. המיקום של הרפליקה שנוספה מוגדר למיקום שציינתם כשאתם מוסיפים את הרפליקה. המיקום של הרפליקה שנוספה חייב להיות שונה מהמיקום של מערך הנתונים הראשוני. כלומר, הנתונים במערך הנתונים משוכפלים באופן רציף בין המיקום שבו נוצר מערך הנתונים לבין המיקום של הרפליקה. אם אתם מוסיפים רפליקה במיקום שונה מהמיקום של נתוני המקור או לא תואם לו, יכול להיות שיהיו שגיאות במשימות. זה נכון לגבי רפליקות שדורשות מיקום משותף, כמו תצוגות, תצוגות מהותיות או טבלאות חיצוניות שהן לא BigLake.
כשלקוחות משכפלים מערך נתונים בין אזורים, BigQuery מוודא שהנתונים נמצאים רק במיקומים שבהם נוצרו הרפליקות.
דרישות לגבי מיקום משותף
השימוש בשכפול של מערך נתונים תלוי בדרישות הבאות למיקום משותף.
Cloud Storage
כדי לשלוח שאילתות על נתונים ב-Cloud Storage, הקטגוריה של Cloud Storage צריכה להיות באותו מיקום של הרפליקה. כשמחליטים איפה למקם את הרפליקה, כדאי להשתמש בשיקולים לגבי מיקום של טבלאות חיצוניות.
מגבלות
השכפול של מערכי נתונים ב-BigQuery כפוף למגבלות הבאות:
- נתונים בסטרימינג שנכתבים לרפליקה הראשית מ-BigQuery Storage Write API (gRPC) או מ-BigQuery Storage Write API (REST), ומשוכפלים לרפליקה המשנית, מבוצעים על בסיס "המאמץ הטוב ביותר" וייתכן שיהיה עיכוב משמעותי בשכפול.
- העברה (streaming) של פעולות עדכון או הוספה (upsert) שנכתבו לרפליקה הראשית מ-Datastream או מהטמעת נתונים שהשתנו (CDC) ב-BigQuery, שמשוכפלת לאחר מכן לרפליקה המשנית, מתבצעת על בסיס "המאמץ המרבי" (best-effort) ועלול להיות עיכוב משמעותי בשכפול. אחרי השכפול, פעולות ה-upsert ברפליקה המשנית מתמזגות עם טבלת הבסיס של הרפליקה המשנית, בהתאם לערך
max_stalenessשמוגדר בטבלה. - אי אפשר לשכפל בין אזורים טבלאות שמופעל בהן DML פרטני. המערכת חוסמת יצירה של מערכי נתונים משוכפלים שכבר מכילים טבלאות כאלה, אבל היא לא חוסמת הפעלה של DML ברמת פירוט גבוהה בטבלאות בתוך מערכי נתונים משוכפלים קיימים. עם זאת, הפעולה הזו עלולה לגרום לתוצאות שאילתה שגויות בשרת המשני בטבלה שבה מופעל DML ברמת פירוט גבוהה.
- אפשר לנהל את הרפליקציה והמעבר באמצעות מסוף Google Cloud או הצהרות של שפת הגדרת נתונים (DDL) ב-SQL.
- אפשר ליצור רק עותק אחד של כל מערך נתונים בכל אזור או בכל קבוצת אזורים. אי אפשר ליצור שתי רפליקות משניות של אותו מערך נתונים באותו אזור יעד.
- המשאבים ברפליקות כפופים למגבלות שמתוארות בקטע התנהגות המשאבים.
- תגי מדיניות וכללי מדיניות נתונים משויכים לא משוכפלים לרפליקה המשנית. כל שאילתה שפועלת מחוץ לאזור הראשי תיכשל אם יש תגי מדיניות בעמודות שאליהן מפנה השאילתה, אלא אם למשתמש יש את התפקיד
roles/datacatalog.categoryFineGrainedReaderברמת הפרויקט, התיקייה או הארגון. קידום של רפליקה לא מתקן את הקישורים האלה באופן אוטומטי. צריך לעדכן אותם כך שיצביעו על טקסונומיה תקינה באזור הראשי החדש. - האפשרות Time travel זמינה ברפליקה המשנית רק אחרי שהיצירה של הרפליקה המשנית הושלמה.
- כדי להפעיל רפליקציה חוצת-אזורים במערך נתונים, מגבלת הגודל של אזור היעד (בבייטים לוגיים) היא 10PB במספר אזורים ב-
usוב-eu, ו-500TB באזורים אחרים כברירת מחדל. אפשר לשנות את המגבלות האלה. לקבלת מידע נוסף, אפשר לפנות אל Google Cloud התמיכה. - המכסה חלה על משאבים לוגיים.
- אפשר לשכפל רק מערך נתונים עם פחות מ-100,000 טבלאות.
- אפשר להוסיף (ואז להסיר) עד 4 רפליקות לאותו אזור לכל מערך נתונים ביום.
- אתם מוגבלים על ידי רוחב הפס.
- אם הערך של
replica_kms_keyלא מוגדר, אי אפשר לשלוח שאילתות לאזור המשני בטבלאות שמוגדרים בהן מפתחות הצפנה בניהול הלקוח (CMEK). - אין תמיכה בטבלאות BigLake.
- אי אפשר לשכפל מערכי נתונים חיצוניים או מאוחדים.
- אי אפשר להשתמש במיקומים של BigQuery Omni.
- אם אתם מגדירים שכפול נתונים לתוכנית התאוששות מאסון (DR), אתם לא יכולים להגדיר את צמדי האזורים הבאים:
-
us-central1–usבמספר אזורים -
us-west1–usבמספר אזורים -
eu-west1–euבמספר אזורים -
eu-west4–euבמספר אזורים
-
- אי אפשר לשכפל את אמצעי בקרת הגישה ברמת השגרה, אבל אפשר לשכפל את אמצעי בקרת הגישה ברמת מערך הנתונים בשביל השגרות.
- ההתנהגות הבאה חלה על אינדקסים של חיפוש:
- רק המטא-נתונים של אינדקס החיפוש משוכפלים לאזור המשני, ולא נתוני האינדקס עצמם.
- אם תעברו לרפליקה, האינדקס יימחק מהאזור הראשי הקודם וייווצר מחדש באזור שקודם.
- אם תעברו בין המצבים בתוך 8 שעות, יצירת האינדקס תתעכב ב-8 שעות.
- שאילתות מתוזמנות לא מופנות אוטומטית למיקום ראשי חדש אם מקדמים רפליקה משנית. הם נשארים קשורים לאזור שצוין בזמן היצירה שלהם.
- אם הרפליקה הראשית המקורית הופכת לרפליקה משנית לקריאה בלבד אחרי הקידום, שאילתות מתוזמנות שמנסות לכתוב נתונים במערך הנתונים נכשלות.
- אם האזור הראשי המקורי לא זמין, השאילתות המתוזמנות נכשלות, גם אם הן מבצעות רק פעולות קריאה.
- כדי לוודא שהשאילתות המתוזמנות ימשיכו לפעול מול הרפליקה הראשית שקודמה, צריך ליצור אותן מחדש באופן ידני במיקום הראשי החדש.
- אי אפשר לשכפל מערכי נתונים מוסתרים.
- אי אפשר לשכפל בין אזורים מערכי נתונים שמכילים כללי מדיניות IAM מותנים. כדי לזהות אם השגיאה הזו משבשת את הרפליקציה, אפשר לבדוק את העמודה
sync_statusבתצוגהINFORMATION_SCHEMA.SCHEMATA_REPLICAS.
התנהגות המשאב
אי אפשר לבצע את הפעולות הבאות במשאבים ברפליקה המשנית:
הרפליקה המשנית היא לקריאה בלבד. אם אתם צריכים ליצור עותק של משאב ברפליקה משנית, אתם צריכים להעתיק את המשאב או לשלוח שאילתה למשאב קודם, ואז להציג את התוצאות מחוץ לרפליקה המשנית. לדוגמה, אפשר להשתמש ב-CREATE TABLE AS SELECT כדי ליצור משאב חדש ממשאב הרפליקה המשני.
יש כמה הבדלים בין רפליקות ראשיות ומשניות:
| רפליקה ראשית באזור 1 | רפליקה משנית באזור 2 | הערות |
|---|---|---|
| קבוצת נתונים מורשית | קבוצת נתונים מורשית | אי אפשר ליצור מערך נתונים מורשה ברפליקה משנית. צריך ליצור אותם ברפליקה הראשית, ואז אפשר לשלוח אליהם שאילתות מהאזור המשני. |
| תרחיש מורשה | תרחיש מורשה | אי אפשר ליצור שגרה מורשית ברפליקה משנית. צריך ליצור אותם ברפליקה הראשית, ואז אפשר לשלוח אליהם שאילתות מהאזור המשני. |
| תצוגה מורשית | תצוגה מורשית | אי אפשר ליצור תצוגה מורשית ברפליקה משנית. צריך ליצור אותם ברפליקה הראשית, ואז אפשר לשלוח אליהם שאילתות מהאזור המשני. |
| טבלת BigLake | טבלת BigLake | לא נתמך. |
| טבלת BigLake Apache Iceberg | טבלת BigLake Apache Iceberg | רפליקציה בין אזורים ותוכנית התאוששות מאסון (DR) בקטלוג הייעודי לזמן ריצה של Lakehouse |
| טבלה חיצונית | טבלה חיצונית | רק ההגדרה של הטבלה החיצונית משוכפלת. השאילתה נכשלת אם הקטגוריה של Cloud Storage לא נמצאת באותו מיקום כמו הרפליקה. |
| תצוגה לוגית | תצוגה לוגית | תצוגות לוגיות שמפנות למערך נתונים או למשאב שלא נמצאים באותו מיקום כמו התצוגה הלוגית, נכשלות כששולחים אליהן שאילתות. |
| טבלה מנוהלת | טבלה מנוהלת | אין הבדל. |
| תצוגה מהותית | תצוגה מהותית | אם טבלה שהתצוגה המהותית מפנה אליה לא נמצאת באותו אזור, השאילתה נכשלת. בתצוגות מהותיות משוכפלות, יכול להיות שהנתונים יהיו פחות עדכניים מהערך של max staleness בתצוגה. |
| דגם | דגם | מאוחסנים כטבלאות מנוהלות. |
| פונקציה מרוחקת | פונקציה מרוחקת | החיבורים הם אזוריים. פונקציות מרוחקות שמפנות למערך נתונים או למשאב (חיבור) שלא נמצאים באותו מיקום כמו הפונקציה המרוחקת, נכשלות בזמן ההפעלה. |
| תרחישים | פונקציה בהגדרת המשתמש (UDF) או תהליך מאוחסן | אם מריצים שגרות שמפנות למערך נתונים או למשאב שלא נמצא באותו מיקום כמו השגרה, הן נכשלות. כל שגרה שמפנה לחיבור, כמו פונקציות מרוחקות, לא פועלת מחוץ לאזור המקור. |
| מדיניות גישה לשורות | מדיניות גישה לשורות | אין הבדל. |
| אינדקס החיפוש | אינדקס החיפוש | רק המטא-נתונים של האינדקס משוכפלים. נתוני האינדקס קיימים רק באזור הראשי. |
| תהליך מאוחסן | תהליך מאוחסן | תהליכים מאוחסנים שמפנים למערך נתונים או למשאב שלא נמצא באותו מיקום כמו התהליך המאוחסן, נכשלים בזמן ההרצה. |
| שכפול טבלה | טבלה מנוהלת | החיוב הוא על עותק מלא ברפליקה המשנית. |
| Snapshot של טבלה | Snapshot של טבלה | החיוב הוא על עותק מלא ברפליקה המשנית. |
| פונקציה עם ערך טבלה (TVF) | TVF | פונקציות TVF שמפנות לקבוצת נתונים או למשאב שלא נמצא באותו מיקום כמו פונקציית ה-TVF נכשלות בזמן ההרצה. |
| UDF | UDF | פונקציות UDF שמפנות למערך נתונים או למשאב שלא נמצא באותו מיקום כמו פונקציית ה-UDF, נכשלות בזמן ההרצה. |
| מדיניות נתונים בעמודה | מדיניות נתונים בעמודה | מדיניות נתונים בהתאמה אישית שמפנה לפונקציה מוגדרת-משתמש שלא נמצאת באותו מיקום כמו המדיניות, נכשלת כששולחים שאילתה לטבלה שאליה המדיניות מצורפת. |
תרחישים של הפסקות זמניות בשירות
רפליקציה בין אזורים לא מיועדת לשמש כתוכנית התאוששות מאסון (DR) במהלך הפסקה מוחלטת של השירות באזור. אם יש הפסקה מוחלטת באזור של הרפליקה הראשית, אי אפשר לקדם את הרפליקה המשנית. מכיוון שהרפליקות המשניות הן לקריאה בלבד, אי אפשר להריץ משימות כתיבה ברפליקה המשנית ואי אפשר לקדם את האזור המשני עד שהאזור של הרפליקה הראשית ישוחזר. מידע נוסף על הכנה לתוכנית התאוששות מאסון (DR) זמין במאמר תוכנית התאוששות מאסון (DR) מנוהלת.
בטבלה הבאה מוסבר איך הפסקות חשמל באזור כולו משפיעות על הנתונים המשוכפלים:
| אזור 1 | אזור 2 | אזור ההפסקה הזמנית בשירות | השפעה |
|---|---|---|---|
| רפליקה ראשית | רפליקה משנית | אזור 2 | משימות לקריאה בלבד שפועלות באזור 2 מול הרפליקה המשנית נכשלות. |
| רפליקה ראשית | רפליקה משנית | אזור 1 | כל המשימות שפועלות באזור 1 נכשלות. משימות לקריאה בלבד ממשיכות לפעול באזור 2 שבו נמצאת הרפליקה המשנית. התוכן של אזור 2 לא מעודכן עד שהוא מסונכרן עם אזור 1. |
שימוש ברפליקציה של מערכי נתונים
בקטע הזה מוסבר איך לשכפל מערך נתונים, לקדם את הרפליקה המשנית ולהריץ משימות קריאה של BigQuery באזור המשני.
ההרשאות הנדרשות
כדי לקבל את ההרשאות שדרושות לניהול רפליקות, צריך לבקש מהאדמין להקצות לכם את ההרשאה bigquery.datasets.update.
שכפול של מערך נתונים
כדי לשכפל מערך נתונים, בוחרים באחת מהאפשרויות הבאות:
המסוף
נכנסים לדף BigQuery.
בחלונית Explorer, לוחצים על מערך הנתונים שרוצים לשכפל.
לוחצים על הכרטיסייה פרטים.
בקטע Replicas, לוחצים על Create replica.
בחלונית Create dataset replica:
- בקטע Location type, בוחרים סוג מיקום לרפליקה.
- ברשימה Region, בוחרים אזור לרפליקה.
- אופציונלי: כדי להשתמש במפתחות הצפנה בניהול הלקוח (CMEK), מרחיבים את הקטע Advanced options ובוחרים באפשרות Customer-managed encryption key (CMEK).
לוחצים על Create replica.
SQL
כדי לשכפל קבוצת נתונים, משתמשים בהצהרת ה-DDL ALTER SCHEMA ADD REPLICA.
אפשר להוסיף רפליקה לכל מערך נתונים שנמצא באזור או במספר אזורים, אם עדיין לא נוצרה לו רפליקה באותו אזור או באותם מספר אזורים. אחרי שמוסיפים רפליקה, לוקח זמן עד שפעולת ההעתקה הראשונית מסתיימת. בזמן שהנתונים משוכפלים, אתם עדיין יכולים להריץ שאילתות שמפנות לרפליקה הראשית, בלי להפחית את קיבולת עיבוד השאילתות. אי אפשר לשכפל נתונים בתוך המיקומים הגיאוגרפיים שבתוך מספר אזורים.
בדוגמה הבאה נוצרת קבוצת נתונים בשם my_dataset באזור us-central1, ואז נוספת רפליקה באזור us-east4:
-- Create the primary replica in the us-central1 region.
CREATE SCHEMA my_dataset OPTIONS(location='us-central1');

-- Create a replica in the secondary region.
ALTER SCHEMA my_dataset
ADD REPLICA `my_replica`
OPTIONS(location='us-east4');
כדי לוודא שהרפליקה המשנית נוצרה, אפשר לשלוח שאילתה לעמודה creation_complete בתצוגה INFORMATION_SCHEMA.SCHEMATA_REPLICAS.
אחרי שיוצרים את הרפליקה המשנית, אפשר לשלוח אליה שאילתות על ידי הגדרה מפורשת של מיקום השאילתה לאזור המשני. אם לא מגדירים מיקום באופן מפורש, המערכת של BigQuery משתמשת באזור של הרפליקה הראשית של מערך הנתונים.
קידום הרפליקה המשנית
אם האזור הראשי מחובר לאינטרנט, אתם יכולים לקדם את הרפליקה המשנית. הקידום הופך את הרפליקה המשנית לרפליקה הראשית שניתן לכתוב בה. הפעולה הזו מסתיימת תוך כמה שניות אם הרפליקה המשנית מעודכנת בהתאם לרפליקה הראשית. אם הרפליקה המשנית לא מעודכנת, אי אפשר להשלים את הקידום עד שהיא תתעדכן. אי אפשר לקדם את הרפליקה המשנית לרפליקה הראשית אם יש הפסקה זמנית בשירות באזור שבו נמצאת הרפליקה הראשית.
שימו לב לנקודות הבאות:
- כל פעולות הכתיבה בטבלאות מחזירות שגיאות בזמן שהקידום מתבצע. הרפליקה הראשית הישנה הופכת ללא ניתנת לכתיבה מיד עם תחילת הקידום.
- טבלאות שלא שוכפלו באופן מלא בזמן שהקידום מתחיל מחזירות קריאות בעבר.
כדי להפוך רפליקה לרפליקה הראשית, בוחרים באחת מהאפשרויות הבאות:
המסוף
נכנסים לדף BigQuery.
בחלונית Explorer, לוחצים על מערך הנתונים שרוצים לקדם.
לוחצים על הכרטיסייה פרטים.
בקטע Replicas, מוצאים את הרפליקה שרוצים לקדם ולוחצים על Make primary.
בתיבת הדו-שיח Promote replica, מקלידים
confirmבשדה הטקסט ולוחצים על Confirm.
SQL
כדי לקדם רפליקה לרפליקה הראשית, משתמשים בהצהרת ה-DDL ALTER SCHEMA SET
OPTIONS ומגדירים את האפשרות primary_replica.
שימו לב לנקודות הבאות:
- צריך להגדיר באופן מפורש את מיקום המשימה לאזור המשני בהגדרות השאילתה. מידע נוסף זמין במאמר ציון מיקומים ב-BigQuery.
בדוגמה הבאה, הרפליקה us-east4 הופכת לרפליקה הראשית:
ALTER SCHEMA my_dataset SET OPTIONS(primary_replica = 'us-east4');
כדי לוודא שהרפליקה המשנית קודמה בהצלחה, אפשר לשלוח שאילתה לעמודה replica_primary_assignment_complete בתצוגה INFORMATION_SCHEMA.SCHEMATA_REPLICAS.
הסרת רפליקה של מערך נתונים
כדי להסיר רפליקה ולהפסיק את הרפליקציה של קבוצת הנתונים, בוחרים באחת מהאפשרויות הבאות:
המסוף
נכנסים לדף BigQuery.
בחלונית Explorer, לוחצים על מערך הנתונים שבו רוצים להסיר רפליקה.
לוחצים על הכרטיסייה פרטים.
בקטע Replicas, מוצאים את הרפליקה שרוצים להסיר, לוחצים על More actions ואז על Delete.
בתיבת הדו-שיח Delete dataset replica?, מקלידים
deleteבשדה הטקסט ולוחצים על Delete.
SQL
כדי להסיר רפליקה ולהפסיק את הרפליקציה של מערך הנתונים, משתמשים בהצהרת ה-DDL ALTER SCHEMA DROP REPLICA.
בדוגמה הבאה מסירים את הרפליקה us:
ALTER SCHEMA my_dataset
DROP REPLICA IF EXISTS `us`;
כדי למחוק את כל קבוצת הנתונים, קודם צריך למחוק את כל הרפליקות המשניות. אם תמחקו את כל מערך הנתונים, למשל באמצעות ההצהרה DROP
SCHEMA, בלי להסיר את כל הרפליקות המשניות, תופיע השגיאה הבאה:
The dataset replica of the cross region dataset 'project_id:dataset_id' in region 'REGION' is not yet writable because the primary assignment is not yet complete.
מידע נוסף זמין במאמר קידום הרפליקה המשנית.
מעקב אחרי הרפליקציה
אתם יכולים לעקוב אחרי הסטטוס של הרפליקות של מערכי הנתונים באמצעות BigQuery, Cloud Monitoring או תצוגות INFORMATION_SCHEMA.
למידע על יצירת התראות לגבי המדדים האלה, ראו יצירת לוחות בקרה, תרשימים והתראות.
הצגת סטטוס הרפליקציה באמצעות BigQuery
כדי לראות את סטטוס הרפליקציה ואת זמן האחזור של מערך נתונים במסוףGoogle Cloud :
נכנסים לדף BigQuery במסוף Google Cloud .
בחלונית Explorer, מרחיבים את הפרויקט.
לוחצים על מערך הנתונים שרוצים לעקוב אחריו.
בחלונית הפרטים של מערך הנתונים, לוחצים על הכרטיסייה Details.
בקטע Replicas, בודקים את Replication latency ואת Status. כדי לראות פרטים נוספים, כולל תרשים של זמן האחזור של הרפליקציה, לוחצים על View details.
צפייה בסטטוס הרפליקציה באמצעות Cloud Monitoring
כדי לעזור לכם לעקוב אחרי סטטוס הרפליקציה, BigQuery מספק את המדדים הבאים ב-Monitoring:
- זמן אחזור של רפליקציה: מידת העדכניות של הנתונים באזור המשני שנוצרה לו רפליקה כחלק מרפליקציה חוצת-אזורים או מתוכנית התאוששות מאסון (DR) מנוהלת. המדד הזה משמש כ-proxy ליעד להתאוששות מאסון (RPO).
- בייטים של תעבורת נתונים יוצאת ברשת: נפח הנתונים (בבייטים) שחויב, ששוכפל מהאזור הראשי לאזור המשני. המדד הזה עוזר לכם לעקוב אחרי ניצול מכסת רוחב הפס.
כדי לראות את המדדים האלה ב-Monitoring:
נכנסים לדף Monitoring במסוף Google Cloud .
לוחצים על Metrics explorer.
בשדה בחירת מדד, מחפשים את האפשרות מערך נתונים ב-BigQuery ובוחרים בה.
בוחרים באפשרות Replication latency (
bigquery.googleapis.com/storage/replication/dataset_staleness) או Network egress bytes (bigquery.googleapis.com/storage/replication/network_egress_bytes_count).לוחצים על אישור.
בקטע Aggregation, בוחרים שיטת צבירה. למדד זמן האחזור של השכפול, מומלץ לבחור באפשרות 99th percentile. הצבירה הזו מציגה בצורה טובה יותר את הביצועים במקרה הגרוע ביותר בהשוואה לממוצע או לצבירות אחרות.
אופציונלי: כדי לראות מדדים של מערך נתונים ספציפי או של אזור משני, לוחצים על Add filter, בוחרים באפשרות dataset_id או location ומזינים ערך. אם אתם משכפלים נתונים לכמה אזורים משניים, אתם יכולים לקבץ לפי מיקום כדי לראות את המדדים של כל אזור.
הצגת סטטוס הרפליקציה באמצעות INFORMATION_SCHEMA
כדי להציג רשימה של הרפליקות של מערכי הנתונים בפרויקט, שולחים שאילתה לתצוגה INFORMATION_SCHEMA.SCHEMATA_REPLICAS.
העברת מערכי נתונים
אתם יכולים להשתמש בשכפול של מערכי נתונים באזורים שונים כדי להעביר את מערכי הנתונים מאזור אחד לאחר. בדוגמה הבאה מוסבר איך להעביר את קבוצת הנתונים הקיימת my_migration מהמיקום US במספר אזורים למיקום EU במספר אזורים, באמצעות שכפול בין אזורים.
שכפול של מערך הנתונים
כדי להתחיל את תהליך המיגרציה, קודם צריך לשכפל את קבוצת הנתונים באזור שאליו רוצים להעביר את הנתונים. בתרחיש הזה, אתם מעבירים את מערך הנתונים my_migration למספר האזורים EU.
-- Create a replica in the secondary region.
ALTER SCHEMA my_migration
ADD REPLICA `eu`
OPTIONS(location='eu');
כך נוצרת רפליקה משנית בשם eu במספר האזורים EU.
הרפליקה הראשית היא מערך הנתונים my_migration במספר האזורים US.
קידום הרפליקה המשנית
כדי להמשיך להעביר את מערך הנתונים למספר האזורים EU, צריך לקדם את הרפליקה המשנית:
ALTER SCHEMA my_migration SET OPTIONS(primary_replica = 'eu')
אחרי שהקידום מסתיים, eu היא הרפליקה הראשית. זו רפליקה שניתן לכתוב בה.
השלמת ההעברה
כדי להשלים את ההעברה מהאזור US לאזור EU, צריך למחוק את הרפליקה us. השלב הזה לא נדרש, אבל הוא שימושי אם אתם לא צריכים עותק של מערך הנתונים מעבר לצרכים של ההעברה.
ALTER SCHEMA my_migration
DROP REPLICA IF EXISTS us;
מערך הנתונים נמצא במספר אזורים ב-EU, ואין רפליקות של מערך הנתונים my_migration. העברתם בהצלחה את מערך הנתונים לאזור EU. הרשימה המלאה של המשאבים שמועברים מופיעה בקטע התנהגות המשאבים.
מפתחות הצפנה בניהול הלקוח (CMEK)
מפתחות Cloud Key Management Service בניהול הלקוח לא משוכפלים באופן אוטומטי כשיוצרים עותק משני. כדי לשמור על ההצפנה במערך הנתונים המשוכפל, צריך להגדיר את replica_kms_key למיקום של הרפליקה שנוספה. אפשר להגדיר את replica_kms_key באמצעות הצהרת ה-DDL ALTER SCHEMA ADD REPLICA.
שכפול של מערכי נתונים עם CMEK פועל כמו שמתואר בתרחישים הבאים:
אם לקבוצת הנתונים של המקור יש
default_kms_key, צריך לספקreplica_kms_keyשנוצר באזור של קבוצת הנתונים של הרפליקה כשמשתמשים בהצהרת ה-DDLALTER SCHEMA ADD REPLICA.אם לא מוגדר ערך ל-
default_kms_keyבמערך הנתונים של המקור, אי אפשר להגדיר אתreplica_kms_key.אם אתם משתמשים ברוטציית מפתחות של Cloud KMS ב-
default_kms_keyאו ב-replica_kms_key(או בשניהם), עדיין אפשר לשלוח שאילתות למערך הנתונים המשוכפל אחרי רוטציית המפתחות.- רוטציית מפתחות באזור הראשי מעדכנת את גרסת המפתח רק בטבלאות שנוצרו אחרי הרוטציה. בטבלאות שהיו קיימות לפני רוטציית המפתחות עדיין נעשה שימוש בגרסת המפתח שהוגדרה לפני הרוטציה.
- רוטציית מפתחות באזור המשני מעדכנת את כל הטבלאות ברפליקה המשנית לגרסת המפתח החדשה.
- כשמחליפים את הרפליקה הראשית ברפליקה משנית, כל הטבלאות ברפליקה המשנית (לשעבר הרפליקה הראשית) מתעדכנות לגרסת המפתח החדשה.
- אם גרסת המפתח שהוגדרה בטבלאות ברפליקה הראשית לפני רוטציית המפתחות נמחקת, אי אפשר לשלוח שאילתות לטבלאות שעדיין משתמשות בגרסת המפתח שהוגדרה לפני רוטציית המפתחות עד שגרסת המפתח מתעדכנת. כדי לעדכן את גרסת המפתח, גרסת המפתח הישנה צריכה להיות פעילה (לא מושבתת או מחוקה).
אם למערך הנתונים המקורי לא הוגדר ערך ל-
default_kms_key, אבל יש טבלאות נפרדות במערך הנתונים המקורי שמוגדר להן CMEK, אי אפשר לשלוח שאילתות לטבלאות האלה במערך הנתונים המשוכפל. כדי לשלוח שאילתות לטבלאות:- מוסיפים ערך
default_kms_keyלמקור של קבוצת הנתונים. - כשיוצרים רפליקה חדשה באמצעות הצהרת ה-DDL
ALTER SCHEMA ADD REPLICA, מגדירים ערך לאפשרותreplica_kms_key. אפשר לשלוח שאילתות לטבלאות CMEK באזור היעד.
כל הטבלאות עם CMEK באזור היעד משתמשות באותו
replica_kms_key, בלי קשר למפתח שבו השתמשו באזור המקור.- מוסיפים ערך
יצירת רפליקה עם CMEK
בדוגמה הבאה נוצרת רפליקה באזור us-west1 עם ערך replica_kms_key מוגדר. למפתח CMEK, צריך לתת לחשבון השירות של BigQuery הרשאה להצפנה ולפענוח.
-- Create a replica in the secondary region.
ALTER SCHEMA my_dataset
ADD REPLICA `us-west1`
OPTIONS(location='us-west1',
  replica_kms_key='my_us_west1_kms_key_name');
מגבלות של CMEK
שכפול של מערכי נתונים שמופעל בהם CMEK כפוף למגבלות הבאות:
אי אפשר לעדכן את מפתח Cloud KMS המשוכפל אחרי שנוצר העותק המשוכפל.
אי אפשר לעדכן את הערך של
default_kms_keyבמערך הנתונים המקורי אחרי שנוצרו הרפליקות של מערך הנתונים.אם הערך של
replica_kms_keyלא תקין באזור היעד, מערך הנתונים לא ישוכפל.
מדיניות נתונים שהוקצתה לעמודה או לתג משילות מידע (data governance)
בקטעים הבאים מוסבר איך מדיניות נתונים שמוקצית ישירות לעמודה ומדיניות נתונים שמוקצית לתגי משילות מידע (גרסת טרום-השקה) פועלות עם שכפול בין אזורים.
כללי מדיניות הנתונים שמוקצים לעמודות או לתגי משילות מידע הם משאבים אזוריים. כלומר, מדיניות הנתונים והטבלה שמצורפת אליה צריכות להיות באותו אזור. מדיניות הנתונים משוכפלת באופן אוטומטי כשיוצרים רפליקה משנית. אם מדיניות נתונים מצורפת לטבלה כלשהי במערך נתונים משוכפל, או אם היא מוקצית לתג של משילות מידע באותה טבלה, BigQuery יוצר או מעדכן את מדיניות הנתונים ואת כללי מדיניות ה-IAM התואמים שלה באזור המשני.
יכולת שינוי
כללי המדיניות של הנתונים המשוכפלים הם לקריאה בלבד באזורים המשניים. אי אפשר לעדכן את מדיניות הנתונים באזור משני. מדיניות הנתונים המקורית שמצורפת לטבלה באזור הראשי נשארת ניתנת לשינוי. אפשר לשנות מדיניות נתונים באזור רק אם היא לא משויכת לטבלאות משניות. אם הוא מצורף לטבלאות באזורים משניים, הוא הופך לבלתי ניתן לשינוי. אם מדיניות הנתונים לא ניתנת לשינוי, BigQuery דוחה כל פעולה שמעדכנת או מגדירה את מדיניות ה-IAM.
התנגשויות בין שמות
משאב מדיניות הנתונים זהה בין האזור הראשי לאזור המשני, מלבד המיקום. במדיניות נתונים וברפליקה שלה באזורים המשניים, המזהים בפורמט projects/PROJECT_NUMBER/locations/LOCATION_ID/dataPolicies/DATA_POLICY_ID זהים, חוץ מהערך של LOCATION_ID.
הרפליקציה נכשלת אם באזור המשני כבר קיימת מדיניות נתונים עם מזהה מתנגש. כדי שהרפליקציה תמשיך, צריך לפתור את ההתנגשות בשמות באזור הראשי או באזור המשני.
כללי מדיניות מותאמים אישית להסתרת נתונים
אם אתם משתמשים בשגרת מיסוך בהתאמה אישית, חשוב לוודא שאתם משכפלים את הפונקציות המוגדרות על ידי המשתמש (UDF) בהתאמה אישית. אפשר לכלול את ה-UDF האלה כחלק מקבוצת הנתונים שמשכפלים.
צירוף, ניתוק או מחיקה של מדיניות נתונים לעמודות בטבלה
צירוף, ניתוק או מחיקה של מדיניות נתונים לעמודה באזור הראשי או ממנה, נחשבים לשינוי בסכימה של הטבלה. הסכימות של הטבלאות בכל האזורים המשניים מתעדכנות בהתאם לשינוי. עם זאת, אם תנתקו מדיניות נתונים מכל עמודות הטבלה באזור הראשי, מדיניות הנתונים תהפוך למיותמת באזור המשני, ותצטרכו לנקות אותה באופן ידני. לא מומלץ לצרף באופן ידני מדיניות נתונים משוכפלת באזור המשני, כי זה יכול להוביל למצבים מסובכים, למשל, אי אפשר להוסיף או להסיר הרשאות FGAC.
אם מוחקים מדיניות נתונים מנותקת, משימת רקע מסירה אותה מסכימת הטבלה. במקרה כזה, השינוי בסכימה של הטבלה מופץ לאזור היעד. כמו בניתוק כללי מדיניות, צריך למחוק ידנית את מדיניות הנתונים באזור המשני.
הוספת רפליקה
אם תמחקו את הרפליקה, כללי מדיניות הנתונים שמצורפים אליה לא יימחקו באופן אוטומטי. כמו בניתוק כללי מדיניות, צריך למחוק ידנית את מדיניות הנתונים באזור המשני.
המאמרים הבאים
- איך עובדים עם BigQuery Reservations
- מידע ולמידה על תכונות האמינות של BigQuery