


עדכון טבלאות בזמן אמת באמצעות הטמעת נתונים שהשתנו (CDC)
הטמעת נתונים ב-BigQuery באמצעות CDC מעדכנת את הטבלאות ב-BigQuery על ידי עיבוד ויישום של שינויים בנתונים קיימים שהועברו בסטרימינג. הסנכרון מתבצע באמצעות פעולות של עדכון או הוספה (upsert) ומחיקה של שורות, שמועברות בסטרימינג בזמן אמת על ידי BigQuery Storage Write API (gRPC). חשוב להכיר את ה-API הזה לפני שממשיכים.
לפני שמתחילים
מקצים תפקידים של ניהול זהויות והרשאות גישה (IAM) שנותנים למשתמשים את ההרשאות הנדרשות כדי לבצע כל משימה במסמך הזה, ומוודאים שתהליך העבודה עומד בכל דרישות הקדם.
ההרשאות הנדרשות
כדי לקבל את ההרשאה שדרושה לשימוש ב-Storage Write API (gRPC), בקשו מהאדמין להקצות לכם את תפקיד ה-IAM עריכת נתונים ב-BigQuery (roles/bigquery.dataEditor).
כדי לקרוא הסבר על מתן תפקידים, ראו איך מנהלים את הגישה ברמת הפרויקט, התיקייה והארגון.
התפקיד המוגדר מראש הזה כולל את ההרשאה bigquery.tables.updateData, שנדרשת כדי להשתמש ב-Storage Write API (gRPC).
יכול להיות שתוכלו לקבל את ההרשאה הזו גם בתפקידים בהתאמה אישית או בתפקידים מוגדרים מראש.
במאמר מבוא ל-IAM מוסבר בהרחבה על התפקידים וההרשאות ב-IAM ב-BigQuery.
דרישות מוקדמות
כדי להשתמש בהטמעת CDC ב-BigQuery, תהליך העבודה צריך לעמוד בתנאים הבאים:
- אתם צריכים להשתמש ב-Storage Write API (gRPC) בזרם ברירת המחדל.
- צריך להשתמש בפורמט protobuf כפורמט ההטמעה. אין תמיכה בפורמט Apache Arrow.
- צריך להצהיר על מפתחות ראשיים בטבלת היעד ב-BigQuery. יש תמיכה במפתחות ראשיים מורכבים שמכילים עד 16 עמודות.
- צריכים להיות מספיק משאבי מחשוב זמינים ב-BigQuery כדי לבצע את פעולות השורות של ה-CDC. חשוב לזכור שאם פעולות השינוי של שורות CDC נכשלות, יכול להיות שנתונים שרציתם למחוק יישמרו בטעות. מידע נוסף זמין במאמר שיקולים לגבי נתונים שנמחקו.
ציון שינויים ברשומות קיימות
בהטמעת CDC ב-BigQuery, העמודה המדומה _CHANGE_TYPE מציינת את סוג השינוי שצריך לעבד בכל שורה. כדי להשתמש ב-CDC, צריך להגדיר את _CHANGE_TYPE כשמעבירים בסטרימינג שינויים בשורות באמצעות Storage Write API (gRPC). בעמודה המדומה _CHANGE_TYPE אפשר להזין רק את הערכים UPSERT ו-DELETE. טבלה נחשבת פעילה עם CDC כש-Storage Write API (gRPC) מעביר בסטרימינג שינויים בשורות לטבלה באופן הזה.
דוגמה עם הערכים UPSERT ו-DELETE
נניח שיש לכם את הטבלה הבאה ב-BigQuery:
| מזהה | שם | שכר |
|---|---|---|
| 100 | Charlie (צ'רלי) | 2000 |
| 101 | טל | 3000 |
| 102 | Lee | 5,000 |
השינויים הבאים בשורות מועברים בסטרימינג באמצעות Storage Write API (gRPC):
| מזהה | שם | שכר | _CHANGE_TYPE |
|---|---|---|---|
| 100 | מחיקה | ||
| 101 | טל | 8000 | עדכון או הוספה (upsert) |
| 105 | איזומי | 6000 | עדכון או הוספה (upsert) |
הטבלה המעודכנת:
| מזהה | שם | שכר |
|---|---|---|
| 101 | טל | 8000 |
| 102 | Lee | 5,000 |
| 105 | איזומי | 6000 |
ניהול טבלאות לא עדכניות
כברירת מחדל, בכל פעם שמריצים שאילתה, BigQuery מחזיר את התוצאות העדכניות ביותר. כדי לספק את התוצאות העדכניות ביותר כששולחים שאילתה לטבלה עם CDC פעיל, BigQuery צריך להחיל כל שינוי בשורות שהועברו בסטרימינג עד לשעת ההתחלה של השאילתה, כדי שהשאילתה תתבצע בגרסה העדכנית ביותר של הטבלה. החלת השינויים האלה בשורות בזמן הרצת השאילתה מגדילה את זמן האחזור ואת העלות של השאילתה. עם זאת, אם אתם לא צריכים תוצאות שאילתה עדכניות לחלוטין, אתם יכולים להפחית את העלות והזמן שלוקח להריץ את השאילתות על ידי הגדרת האפשרות max_staleness בטבלה. כשהאפשרות הזו מוגדרת, BigQuery מחיל שינויים בשורות לפחות פעם אחת בתוך המרווח שמוגדר בערך max_staleness, וכך מאפשר לכם להריץ שאילתות בלי לחכות להחלת העדכונים, אבל הנתונים עלולים להיות קצת מיושנים.
ההתנהגות הזו שימושית במיוחד למרכזי בקרה ולדוחות שבהם עדכניות הנתונים לא חיונית. הוא גם עוזר לנהל את העלויות, כי הוא מאפשר לכם לשלוט בתדירות שבה BigQuery מבצע שינויים בשורות.
הרצת שאילתות על טבלאות עם האפשרות max_staleness
כששולחים שאילתה לטבלה שמוגדרת בה האפשרות max_staleness, המערכת של BigQuery מחזירה את התוצאה על סמך הערך של max_staleness והשעה שבה התרחשה משימת ההחלה האחרונה, שמיוצגת על ידי חותמת הזמן upsert_stream_apply_watermark של הטבלה.
בדוגמה הבאה, האפשרות max_staleness של הטבלה מוגדרת ל-10 דקות, ומשימת ההחלה האחרונה התרחשה ב-T20:
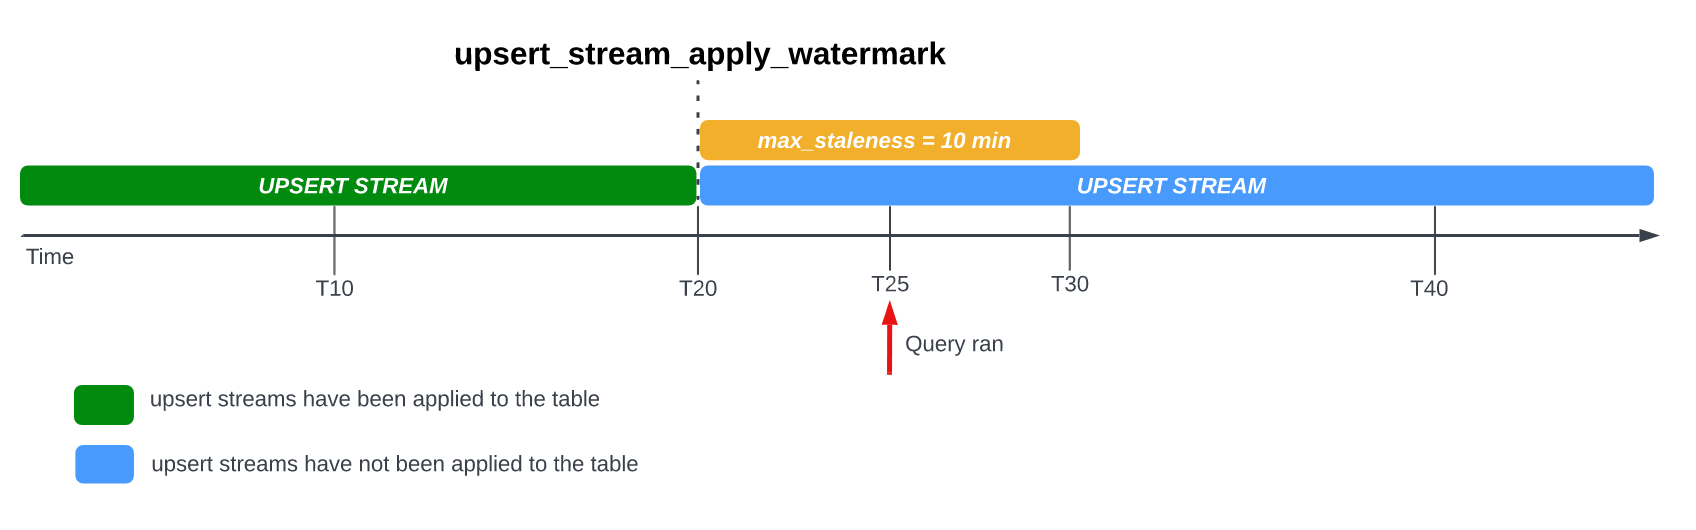
אם תשלחו שאילתה לטבלה ב-T25, הגרסה הנוכחית של הטבלה תהיה בת 5 דקות, כלומר פחות ממרווח הזמן של max_staleness שהוא 10 דקות. במקרה כזה, BigQuery מחזירה את גרסת הבסיס של הטבלה ב-T20, כלומר הנתונים שמוחזרים הם גם לא עדכניים ב-5 דקות.
כשמגדירים את האפשרות max_staleness בטבלה, BigQuery מחיל שינויים בהמתנה בשורות לפחות פעם אחת במרווח הזמן של max_staleness. עם זאת, במקרים מסוימים יכול להיות ש-BigQuery לא ישלים את תהליך ההחלה של השינויים האלה בשורות בהמתנה במהלך המרווח.
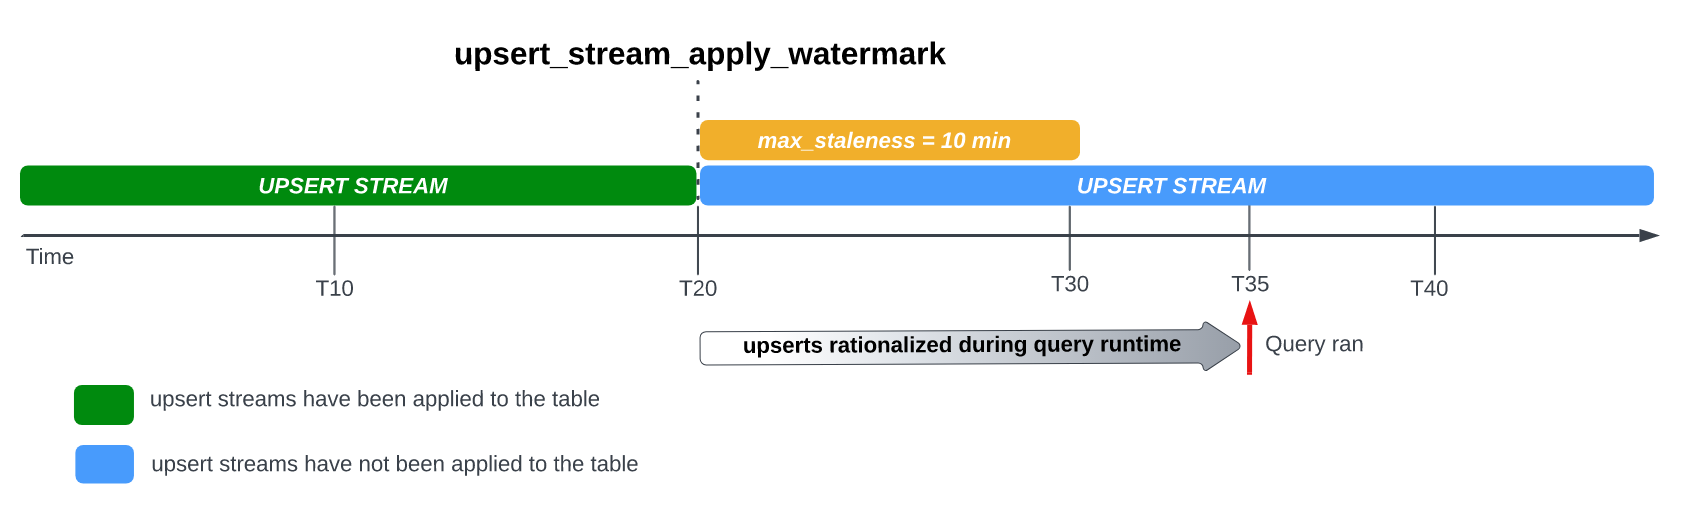
לדוגמה, אם שולחים שאילתה לטבלה ב-T35, ותהליך ההחלה של השינויים הממתינים בשורות לא הסתיים, הגרסה הנוכחית של הטבלה לא מעודכנת ב-15 דקות, וזה יותר ממרווח הזמן של max_staleness שהוא 10 דקות.
במקרה הזה, בזמן הרצת השאילתה, BigQuery מחיל את כל השינויים בשורות בין T20 ל-T35 על השאילתה הנוכחית. כלומר, הנתונים שמוצגים בשאילתה מעודכנים לחלוטין, אבל זמן האחזור של השאילתה ארוך יותר.
הפעולה הזו נחשבת למשימת מיזוג בזמן ריצה.
גיזום מחיצות ומיזוג בזמן ריצה
כששולחים שאילתה לטבלה מחולקת למחיצות עם CDC פעיל, כמו טבלת יעד ששוכפלה על ידי Datastream, היכולת של BigQuery להחיל גיזום מחיצות תלויה בשאלה אם השאילתה מפעילה משימת מיזוג בזמן ריצה:
- שאילתות בתוך חלון הזמן של
max_staleness: אם הזמן שחלף מאז משימת ההחלה האחרונה ברקע הוא בטווח שלmax_stalenessבטבלה, BigQuery קורא ישירות מטבלת הבסיס. קיצוץ מחיצות וקיצוץ אשכולות פועלים כצפוי, ו-BigQuery סורק רק את המחיצות שתואמות למסנן של משפט ה-WHERE. - שאילתות שמפעילות מיזוג בזמן הריצה: אם לא הוגדר ערך ל-
max_staleness, אם הוגדר הערך0או אם טבלת הבסיס ישנה יותר מהמרווח שלmax_staleness, המערכת של BigQuery מבצעת מיזוג בזמן הריצה של טבלת הבסיס ושל השינויים בשורות שהועברו בסטרימינג לאחרונה. במהלך מיזוג בזמן ריצה, מתבצע דילוג על חיתוך המחיצות כי BigQuery לא יכול לקבוע מראש אילו מחיצות מושפעות משינויים בסטרימינג שלא הוחלו. כתוצאה מכך, השאילתה סורקת את כל הטבלה גם כשמסננים לפי עמודת החלוקה למחיצות.
אם השאילתות שלכם יכולות לסבול נתונים קצת מיושנים, אתם יכולים להפעיל חיתוך מחיצות ולהימנע מסריקות מלאות של הטבלה על ידי הגדרת האפשרות max_staleness בטבלה, למשל ל-15 דקות, כדי שמשימות ההחלה ברקע ימזגו את השינויים לפני שהשאילתות יפעלו:
ALTER TABLE `DATASET_NAME.TABLE_NAME`
SET OPTIONS (
  max_staleness = INTERVAL 15 MINUTE);
מחליפים את מה שכתוב בשדות הבאים:
-
DATASET_NAME: השם של מערך הנתונים שבו נמצאת הטבלה. -
TABLE_NAME: שם הטבלה המחולקת למחיצות.
בקטע ערך מומלץ לטבלה max_staleness מוסבר איך לבחור מרווח זמן שימנע מיזוגים בזמן הריצה של עומס העבודה.
ערך מומלץ לטבלה max_staleness
הערך של max_staleness בטבלה צריך להיות בדרך כלל הגבוה מבין שני הערכים הבאים:
- הזמן המקסימלי שבו הנתונים יכולים להיות לא עדכניים בתהליך העבודה.
- פרק הזמן המקסימלי שלוקח להחיל את השינויים של העדכון או ההוספה (upsert) בטבלה, כפול שתיים, בתוספת זמן נוסף.
כדי לחשב את הזמן שלוקח להחיל שינויים מעודכנים או נוספים על טבלה קיימת, משתמשים בשאילתת ה-SQL הבאה כדי לקבוע את משך הזמן של האחוזון ה-95 של משימות ההחלה ברקע, בתוספת מאגר נתונים זמני של שבע דקות כדי לאפשר את ההמרה של האחסון מותאם הכתיבה (מאגר נתונים זמני של סטרימינג) ב-BigQuery.
SELECT
  project_id,
  destination_table.dataset_id,
  destination_table.table_id,
  APPROX_QUANTILES((TIMESTAMP_DIFF(end_time, creation_time,MILLISECOND)/1000), 100)[OFFSET(95)] AS p95_background_apply_duration_in_seconds,
  CEILING(APPROX_QUANTILES((TIMESTAMP_DIFF(end_time, creation_time,MILLISECOND)/1000), 100)[OFFSET(95)]*2/60)+7 AS recommended_max_staleness_with_buffer_in_minutes
FROM `region-REGION`.INFORMATION_SCHEMA.JOBS AS job
WHERE
  project_id = 'PROJECT_ID'
  AND DATE(creation_time) BETWEEN DATE_SUB(CURRENT_DATE(), INTERVAL 7 DAY) AND CURRENT_DATE()
  AND job_id LIKE "%cdc_background%"
GROUP BY 1,2,3;
מחליפים את מה שכתוב בשדות הבאים:
-
REGION: שם האזור שבו נמצא הפרויקט. לדוגמה,us. -
PROJECT_ID: מזהה הפרויקט שמכיל את הטבלאות ב-BigQuery שמשתנות על ידי הטמעת CDC ב-BigQuery.
משך הזמן של משימות ההחלה ברקע מושפע מכמה גורמים, כולל מספר הפעולות של ה-CDC שהונפקו במרווח הזמן של העדכניות והמורכבות שלהן, גודל הטבלה והזמינות של המשאבים ב-BigQuery. מידע נוסף על זמינות המשאבים מופיע במאמר הגדרת הגודל של הזמנות BACKGROUND ומעקב אחריהן.
יצירת טבלה עם האפשרות max_staleness
כדי ליצור טבלה עם האפשרות max_staleness, משתמשים בהצהרה CREATE TABLE.
בדוגמה הבאה נוצרת הטבלה employees עם מגבלת max_staleness של 10 דקות:
CREATE TABLE employees (
  id INT64 PRIMARY KEY NOT ENFORCED,
  name STRING)
  CLUSTER BY
    id
  OPTIONS (
    max_staleness = INTERVAL 10 MINUTE);
שינוי האפשרות max_staleness בטבלה קיימת
כדי להוסיף או לשנות מגבלת max_staleness בטבלה קיימת, משתמשים בהצהרה ALTER TABLE.
בדוגמה הבאה, מגבלת max_staleness של הטבלה employees משתנה ל-15 דקות:
ALTER TABLE employees
SET OPTIONS (
  max_staleness = INTERVAL 15 MINUTE);
איך בודקים את הערך הנוכחי של max_staleness בטבלה
כדי לקבוע את הערך הנוכחי של max_staleness בטבלה, שולחים שאילתה לתצוגה INFORMATION_SCHEMA.TABLE_OPTIONS.
בדוגמה הבאה נבדק הערך הנוכחי של max_staleness בטבלה mytable:
SELECT
  option_name,
  option_value
FROM
  DATASET_NAME.INFORMATION_SCHEMA.TABLE_OPTIONS
WHERE
  option_name = 'max_staleness'
  AND table_name = 'TABLE_NAME';
מחליפים את מה שכתוב בשדות הבאים:
-
DATASET_NAME: השם של מערך הנתונים שבו נמצאת הטבלה. -
TABLE_NAME: שם הטבלה.
התוצאות מראות שהערך של max_staleness הוא 10 דקות:
+---------------------+--------------+
| Row |  option_name  | option_value |
+---------------------+--------------+
|  1  | max_staleness | 0-0 0 0:10:0 |
+---------------------+--------------+
מעקב אחרי ההתקדמות של פעולת העדכון או ההוספה (upsert) בטבלה
כדי לעקוב אחרי מצב הטבלה ולבדוק מתי בוצעו השינויים האחרונים בשורות, שולחים שאילתה לתצוגה INFORMATION_SCHEMA.TABLES כדי לקבל את חותמת הזמן של upsert_stream_apply_watermark.
בדוגמה הבאה נבדק הערך של upsert_stream_apply_watermark בטבלה mytable:
SELECT upsert_stream_apply_watermark
FROM DATASET_NAME.INFORMATION_SCHEMA.TABLES
WHERE table_name = 'TABLE_NAME';
מחליפים את מה שכתוב בשדות הבאים:
-
DATASET_NAME: השם של מערך הנתונים שבו נמצאת הטבלה. -
TABLE_NAME: שם הטבלה.
התוצאה אמורה להיראות כך:
[{
 "upsert_stream_apply_watermark": "2022-09-15T04:17:19.909Z"
}]
פעולות העדכון או ההוספה (upsert) מבוצעות על ידי חשבון השירות bigquery-adminbot@system.gserviceaccount.com ומופיעות בהיסטוריית המשימות של הפרויקט שמכיל את הטבלה עם ה-CDC הפעיל.
ניהול סדר מותאם אישית
כשמעבירים בסטרימינג פעולות upsert ל-BigQuery, פעולת ברירת המחדל של סידור הרשומות עם מפתחות ראשיים זהים נקבעת לפי זמן המערכת של BigQuery שבו הרשומה הוטמעה ב-BigQuery. במילים אחרות, הרשומה שנטמעה לאחרונה עם חותמת הזמן העדכנית ביותר מקבלת קדימות על פני הרשומה שנטמעה קודם לכן עם חותמת זמן ישנה יותר. במקרים מסוימים, למשל כשמתרחשות פעולות עדכון או הוספה (upsert) תכופות מאוד לאותו מפתח ראשי בחלון זמן קצר מאוד, או כשסדר העדכון או ההוספה לא מובטח, יכול להיות שזה לא יספיק. בתרחישים כאלה, יכול להיות שיהיה צורך במפתח סידור שהמשתמש מספק.
כדי להגדיר מפתחות סידור שהמשתמשים סיפקו, משתמשים בעמודה המדומה _CHANGE_SEQUENCE_NUMBER כדי לציין את הסדר שבו BigQuery צריך להחיל רשומות, על סמך הערך הגדול יותר של _CHANGE_SEQUENCE_NUMBER בין שתי רשומות תואמות עם אותו מפתח ראשי. העמודה המדומה _CHANGE_SEQUENCE_NUMBER היא עמודה אופציונלית, והיא מקבלת רק ערכים בפורמט קבוע STRING.
פורמט _CHANGE_SEQUENCE_NUMBER
העמודה המדומה _CHANGE_SEQUENCE_NUMBER מקבלת רק ערכי STRING, שכתובים בפורמט קבוע. הפורמט הקבוע הזה משתמש בערכים של STRING שנכתבים בבסיס הקסדצימלי, ומופרדים לקטעים באמצעות לוכסן /. כל קטע יכול להכיל עד 16 תווים הקסדצימליים, וכל _CHANGE_SEQUENCE_NUMBER יכול להכיל עד ארבעה קטעים. הטווח המותר של _CHANGE_SEQUENCE_NUMBER תומך בערכים בין 0/0/0/0 ל-FFFFFFFFFFFFFFFF/FFFFFFFFFFFFFFFF/FFFFFFFFFFFFFFFF/FFFFFFFFFFFFFFFF.
ערכי _CHANGE_SEQUENCE_NUMBER תומכים גם באותיות רישיות וגם באותיות קטנות.
כדי להגדיר מפתחות הזמנה בסיסיים, אפשר להשתמש בקטע אחד. לדוגמה, כדי לסדר מפתחות רק על סמך חותמת הזמן של עיבוד הרשומה משרת אפליקציות, אפשר להשתמש בקטע אחד: '2024-04-30 11:19:44 UTC', שמבוטא כהקסדצימלי על ידי המרת חותמת הזמן למילישניות מ-Epoch, במקרה הזה '18F2EBB6480'. הלוגיקה להמרת נתונים לבסיס הקסדצימלי היא באחריות הלקוח שמבצע את הכתיבה ל-BigQuery באמצעות Storage Write API (gRPC).
התמיכה בכמה קטעים מאפשרת לשלב כמה ערכים של לוגיקת עיבוד במפתח אחד, לתרחישי שימוש מורכבים יותר. לדוגמה, כדי לסדר מפתחות לפי חותמת הזמן של עיבוד הרשומה משרת אפליקציה, מספר סידורי ביומן והסטטוס של הרשומה, אפשר להשתמש בשלושה חלקים: '2024-04-30 11:19:44 UTC' / '123' / 'complete', שכל אחד מהם מיוצג כבסיס הקסדצימלי.
סדר הסעיפים הוא שיקול חשוב בדירוג של לוגיקת העיבוד. BigQuery משווה בין ערכי _CHANGE_SEQUENCE_NUMBER על ידי השוואה של החלק הראשון, ואז השוואה של החלק הבא רק אם החלקים הקודמים היו שווים.
BigQuery משתמש ב-_CHANGE_SEQUENCE_NUMBER כדי לבצע סידור על ידי השוואה בין שני שדות _CHANGE_SEQUENCE_NUMBER או יותר כערכים מספריים לא חתומים.
הנה כמה דוגמאות להשוואה בין _CHANGE_SEQUENCE_NUMBER ותוצאות הקדימות שלהן:
דוגמה 1:
- רשומה מס' 1:
_CHANGE_SEQUENCE_NUMBER= '77' - רשומה מס' 2:
_CHANGE_SEQUENCE_NUMBER= '7B'
תוצאה: רשומה מס' 2 נחשבת לרשומה העדכנית ביותר כי '7B' > '77' (כלומר '123' > '119')
- רשומה מס' 1:
דוגמה 2:
- רשומה מס' 1:
_CHANGE_SEQUENCE_NUMBER= 'FFF/B' - רשומה מס' 2:
_CHANGE_SEQUENCE_NUMBER= 'FFF/ABC'
תוצאה: רשומה מס' 2 נחשבת לרשומה העדכנית ביותר כי "FFF/ABC" > "FFF/B" (כלומר "4095/2748" > "4095/11")
- רשומה מס' 1:
דוגמה 3:
- רשומה מס' 1:
_CHANGE_SEQUENCE_NUMBER= "BA/FFFFFFFF" - רשומה מס' 2:
_CHANGE_SEQUENCE_NUMBER= "ABC"
תוצאה: רשומה מס' 2 נחשבת לרשומה העדכנית ביותר כי 'ABC' > 'BA/FFFFFFFF' (כלומר '2748' > '186/4294967295')
- רשומה מס' 1:
דוגמה 4:
- רשומה מס' 1:
_CHANGE_SEQUENCE_NUMBER= 'FFF/ABC' - רשומה מס' 2:
_CHANGE_SEQUENCE_NUMBER= "ABC"
תוצאה: רשומה מס' 1 נחשבת לרשומה העדכנית ביותר כי "FFF/ABC" > "ABC" (כלומר, "4095/2748" > "2748")
- רשומה מס' 1:
אם שני ערכי _CHANGE_SEQUENCE_NUMBER זהים, הרשומה עם זמן ההטמעה האחרון במערכת BigQuery מקבלת עדיפות על פני רשומות שהוטמעו קודם לכן.
כשמשתמשים בסדר מותאם אישית בטבלה, תמיד צריך לספק את הערך _CHANGE_SEQUENCE_NUMBER. כל בקשת כתיבה שלא מצוין בה הערך של
_CHANGE_SEQUENCE_NUMBER, שמובילה לשילוב של שורות עם ערכי ובלי ערכי
_CHANGE_SEQUENCE_NUMBER, תגרום לסדר לא צפוי.
הגדרת הזמנה ב-BigQuery לשימוש עם הטמעת CDC
אתם יכולים להשתמש בהזמנות ב-BigQuery כדי להקצות משאבי מחשוב ייעודיים ב-BigQuery לפעולות שינוי של שורות CDC. ההזמנות מאפשרות להגדיר מגבלה על עלות ביצוע הפעולות האלה. הגישה הזו שימושית במיוחד לתהליכי עבודה עם פעולות CDC תכופות בטבלאות גדולות, שאחרת היו כרוכות בעלויות גבוהות על פי דרישה בגלל המספר הגדול של בייטים שעובדו במהלך כל פעולה.
משימות הטמעה של BigQuery CDC שמחילות שינויים בהמתנה בשורות בתוך המרווח של max_staleness נחשבות למשימות ברקע, ומשתמשות בסוג ההקצאה BACKGROUND או BACKGROUND_CHANGE_DATA_CAPTURE במקום בסוג ההקצאה QUERY.
לעומת זאת, שאילתות מחוץ למרווח הזמן של max_staleness שדורשות שינויים בשורות בזמן הרצת השאילתה, משתמשות בסוג ההקצאה QUERY. טבלאות ללא הגדרת max_staleness או טבלאות שבהן max_staleness מוגדר כ-0 משתמשות גם בסוג ההקצאה QUERY.
משימות ברקע של הטמעת CDC ב-BigQuery שבוצעו בלי הקצאה של BACKGROUND או BACKGROUND_CHANGE_DATA_CAPTURE, משתמשות בתמחור על פי דרישה.
השיקול הזה חשוב כשמתכננים את האסטרטגיה לניהול עומסי העבודה של הטמעת CDC ב-BigQuery.
כדי להגדיר הזמנה ב-BigQuery לשימוש עם CDC, קודם צריך להגדיר הזמנה באזור שבו נמצאות הטבלאות ב-BigQuery. למידע על גודל ההזמנה, קראו את המאמר גודל ההזמנות של BACKGROUND ומעקב אחריהן.
אחרי שיוצרים הזמנה, מקצים את הפרויקט ב-BigQuery להזמנה ומגדירים את האפשרות job_type לערך BACKGROUND באמצעות הרצת הצהרת CREATE ASSIGNMENT הבאה:
CREATE ASSIGNMENT
  `ADMIN_PROJECT_ID.region-REGION.RESERVATION_NAME.ASSIGNMENT_ID`
OPTIONS (
  assignee = 'projects/PROJECT_ID',
  job_type = 'BACKGROUND');
מחליפים את מה שכתוב בשדות הבאים:
-
ADMIN_PROJECT_ID: המזהה של פרויקט האדמין שבבעלותו נמצא המקום שהוזמן. -
REGION: שם האזור שבו נמצא הפרויקט. לדוגמה,us. -
RESERVATION_NAME: שם ההזמנה. -
ASSIGNMENT_ID: מזהה המטלה. המזהה צריך להיות ייחודי לפרויקט ולמיקום, להתחיל ולהסתיים באות קטנה או במספר, ולהכיל רק אותיות קטנות, מספרים ומקפים. -
PROJECT_ID: מזהה הפרויקט שמכיל את הטבלאות ב-BigQuery שמשתנות על ידי הטמעת CDC ב-BigQuery. הפרויקט הזה מוקצה ל-reservation.
הגדרת הגודל של הזמנות BACKGROUND ומעקב אחריהן
הזמנות קובעות את כמות משאבי המחשוב שזמינים לביצוע פעולות מחשוב ב-BigQuery. אם המאגר קטן מדי, יכול להיות שפעולות השינוי של שורות ה-CDC יימשכו יותר זמן. כדי לקבוע את הגודל של ההזמנה בצורה מדויקת, עוקבים אחרי צריכת ה-slots ההיסטורית של הפרויקט שמבצע את פעולות ה-CDC, על ידי שליחת שאילתה לתצוגה INFORMATION_SCHEMA.JOBS_TIMELINE:
SELECT
  period_start,
  SUM(period_slot_ms) / (1000 * 60) AS slots_used
FROM
  region-REGION.INFORMATION_SCHEMA.JOBS_TIMELINE_BY_PROJECT
WHERE
  DATE(job_creation_time) BETWEEN DATE_SUB(CURRENT_DATE(), INTERVAL 7 DAY)
  AND CURRENT_DATE()
  AND job_id LIKE '%cdc_background%'
GROUP BY
  period_start
ORDER BY
  period_start DESC;
מחליפים את REGION בשם האזור שבו נמצא הפרויקט. לדוגמה,
us.
שיקולים לגבי נתונים שנמחקו
- פעולות הטמעת CDC ב-BigQuery משתמשות במשאבי המחשוב של BigQuery. אם פעולות ה-CDC מוגדרות לשימוש בחיוב על פי דרישה, פעולות ה-CDC מבוצעות באופן קבוע באמצעות משאבים פנימיים של BigQuery. אם פעולות ה-CDC מוגדרות עם הזמנה של
BACKGROUNDאוBACKGROUND_CHANGE_DATA_CAPTURE, פעולות ה-CDC כפופות לזמינות המשאבים של ההזמנה שהוגדרה. אם אין מספיק משאבים זמינים בהזמנה שהוגדרה, יכול להיות שעיבוד פעולות ה-CDC, כולל מחיקה, יימשך יותר זמן מהצפוי. - פעולת CDC
DELETEנחשבת לפעולה שהוחלה רק כשחותמת הזמן שלupsert_stream_apply_watermarkעברה את חותמת הזמן שבה Storage Write API (gRPC) העביר בסטרימינג את הפעולה. למידע נוסף על חותמת הזמןupsert_stream_apply_watermark, קראו את המאמר מעקב אחרי ההתקדמות של פעולת העדכון או ההוספה (upsert) בטבלה. - כדי להחיל פעולות CDC
DELETEשמגיעות לא לפי הסדר, BigQuery שומר חלון שמירת נתונים של יומיים למחיקה. פעולות בטבלהDELETEנשמרות לתקופה הזו לפני שמתחיל תהליך מחיקת הנתוניםGoogle Cloud הרגיל. פעולותDELETEבחלון השמירה למחיקה מתומחרות לפי מחירי האחסון הסטנדרטיים של BigQuery.
מגבלות
- הטמעת CDC ב-BigQuery לא אוכפת מפתחות, ולכן חשוב שהמפתחות הראשיים יהיו ייחודיים.
- המפתחות הראשיים לא יכולים לכלול יותר מ-16 עמודות.
- בטבלאות עם CDC פעיל לא יכולות להיות יותר מ-2,000 עמודות ברמה העליונה שמוגדרות על ידי הסכימה של הטבלה.
- טבלאות עם CDC פעיל לא תומכות בפעולות הבאות:
- הצהרות של שפת טיפול בנתונים (DML) לשינוי, כמו
DELETE, UPDATEו-MERGE - הרצת שאילתות על טבלאות תווים כלליים לחיפוש
- אינדקסים של חיפוש
- הצהרות של שפת טיפול בנתונים (DML) לשינוי, כמו
- טבלאות עם CDC פעיל שמבצעות משימות מיזוג בזמן ריצה כי הערך
max_stalenessשל הטבלה נמוך מדי, לא יכולות לתמוך בפעולות הבאות: - פעולות ייצוא של BigQuery בטבלאות עם CDC פעיל לא מייצאות שינויים בשורות שהועברו בסטרימינג לאחרונה, שעדיין לא הוחלו על ידי משימת רקע. כדי לייצא את הטבלה המלאה, משתמשים בהצהרת
EXPORT DATA. - אם השאילתה מפעילה מיזוג בזמן ריצה בטבלה מחולקת למחיצות, המערכת עוקפת את גיזום המחיצות וסורקת את כל הטבלה, גם אם השאילתה מוגבלת לקבוצת משנה של המחיצות. כדי לאפשר גיזום מחיצות לשאילתות שיכולות לסבול נתונים קצת מיושנים, מגדירים את האפשרות
max_stalenessשל הטבלה. - אם אתם משתמשים במהדורת Standard, אין לכם אפשרות להשתמש בהזמנות של
BACKGROUND, ולכן החלת השינויים בשורות בהמתנה מתבצעת באמצעות מודל התמחור על פי דרישה. עם זאת, אתם יכולים לשלוח שאילתות לטבלאות עם CDC פעיל בלי קשר למהדורה שלכם. - אי אפשר להריץ שאילתות על העמודות המדומות
_CHANGE_TYPEו-_CHANGE_SEQUENCE_NUMBERכשקוראים טבלה. - אין תמיכה בשילוב של שורות עם הערכים
UPSERTאוDELETEבשדה_CHANGE_TYPEעם שורות עם הערךINSERTאו ערכים לא מוגדרים בשדה_CHANGE_TYPEבאותו חיבור, והוא גורם לשגיאת האימות הבאה:The given value is not a valid CHANGE_TYPE.
תמחור הטמעת CDC ב-BigQuery
הטמעת CDC ב-BigQuery משתמשת ב-Storage Write API (gRPC) להטמעת נתונים, באחסון ב-BigQuery לאחסון נתונים וביכולות המחשוב של BigQuery לפעולות שינוי שורות. כל הפעולות האלה כרוכות בעלויות. למידע על התמחור ב-BigQuery
הערכת עלויות הטמעת CDC ב-BigQuery
בנוסף לשיטות המומלצות הכלליות להערכת עלויות ב-BigQuery, יכול להיות שיהיה חשוב להעריך את העלויות של הטמעת CDC ב-BigQuery בתהליכי עבודה עם כמויות גדולות של נתונים, הגדרה נמוכה של max_staleness או נתונים שמשתנים לעיתים קרובות.
התמחור של הטמעת נתונים ב-BigQuery והתמחור של האחסון ב-BigQuery מחושבים ישירות לפי כמות הנתונים שאתם מטמיעים ומאחסנים, כולל עמודות פסאודו. עם זאת, קשה יותר להעריך את מחירי המחשוב ב-BigQuery, כי הם קשורים לצריכת משאבי המחשוב שמשמשים להרצת משימות הטמעת CDC ב-BigQuery.
משימות הטמעת CDC ב-BigQuery מחולקות לשלוש קטגוריות:
- משימות החלה ברקע: משימות שפועלות ברקע במרווחי זמן קבועים שמוגדרים לפי הערך
max_stalenessשל הטבלה. המשימות האלה מחילות שינויים בשורות שהועברו בסטרימינג לאחרונה על טבלאות עם CDC פעיל. - משימות של שאילתות: שאילתות GoogleSQL שפועלות בחלון של
max_stalenessוקוראות רק מהבסיס של טבלה עם CDC פעיל. - משימות מיזוג בזמן ריצה: משימות שמופעלות על ידי שאילתות GoogleSQL אד-הוק שפועלות מחוץ לחלון של
max_staleness. המשימות האלה צריכות לבצע מיזוג בזמן אמת של קו הבסיס של טבלה עם CDC פעיל ושינויי השורות שהועברו בסטרימינג לאחרונה בזמן ריצת השאילתה. סוג המשימה הזה לא מקדם את חותמת הזמן שלupsert_stream_apply_watermark.
רק משימות של שאילתות מנצלות את החלוקה למחיצות ב-BigQuery. משימות של החלה ברקע ומשימות של מיזוג בזמן ריצה לא יכולות להשתמש בחלוקה למחיצות, כי כשמחילים שינויים בשורות שהועברו בסטרימינג לאחרונה, אין ערובה לאיזו מחיצת טבלה יוחלו פעולות ה-upsert שהועברו בסטרימינג לאחרונה. במילים אחרות, טבלת הבסיס המלאה נקראת במהלך משימות של החלה ברקע ומשימות של מיזוג בזמן ריצה. מאותה סיבה, רק משימות של שאילתות יכולות להפיק תועלת ממסננים בעמודות של אשכולות ב-BigQuery. כדי להעריך את העלות הכוללת, חשוב להבין את כמות הנתונים שנקראים לביצוע פעולות CDC.
אם כמות הנתונים שנקראים מהטבלה גבוהה, כדאי להשתמש במודל התמחור לפי קיבולת של BigQuery, שלא מבוסס על כמות הנתונים שעובדו.
שיטות מומלצות לעלויות של הטמעת CDC ב-BigQuery
בנוסף לשיטות המומלצות הכלליות לעלויות ב-BigQuery, השתמשו בשיטות הבאות כדי לייעל את העלויות של פעולות הטמעת CDC ב-BigQuery:
- אם אין צורך, אל תגדירו ערך נמוך מאוד לאפשרות
max_stalenessשל טבלה. הערךmax_stalenessיכול להגדיל את מספר המופעים של משימות החלה ברקע ומשימות מיזוג בזמן ריצה, שהן יקרות ואיטיות יותר ממשימות שאילתה. הנחיות מפורטות זמינות במאמר ערך מומלץ לטבלהmax_staleness. - מומלץ להגדיר הזמנה ב-BigQuery לשימוש עם טבלאות CDC.
אחרת, משימות של החלה ברקע ומשימות של מיזוג בזמן ריצה משתמשות בתמחור על פי דרישה, שיכול להיות יקר יותר בגלל עיבוד נתונים רב יותר. למידע נוסף, קראו על הזמנות ב-BigQuery ופעלו לפי ההנחיות במאמר איך לקבוע את הגודל של הזמנת
BACKGROUNDולעקוב אחריה לשימוש עם הטמעת CDC ב-BigQuery.
המאמרים הבאים
- איך מטמיעים את הסטרימינג שמוגדר כברירת מחדל ב-Storage Write API (gRPC)
- מידע ולמידה על שיטות מומלצות ל-Storage Write API (gRPC)
- איך משתמשים ב-Datastream כדי לשכפל מסדי נתונים של טרנזקציות ל-BigQuery באמצעות הטמעת CDC ב-BigQuery.