


מבוא ל-BigQuery Omni
באמצעות BigQuery Omni, אתם יכולים להריץ ניתוחים של BigQuery על נתונים שמאוחסנים ב-Amazon Simple Storage Service (Amazon S3) או ב-Azure Blob Storage באמצעות טבלאות BigLake.
הרבה ארגונים מאחסנים נתונים בכמה עננים ציבוריים. בדרך כלל הנתונים האלה מבודדים, כי קשה להפיק תובנות מכל הנתונים. אתם רוצים לנתח את הנתונים באמצעות כלי לניתוח נתונים בכמה עננים, שהוא זול, מהיר ולא יוצר עומס נוסף של משילות מידע מבוזרת. בעזרת BigQuery Omni, אנחנו מצמצמים את החיכוכים האלה באמצעות ממשק מאוחד.
כדי להריץ ניתוח של BigQuery על הנתונים החיצוניים, קודם צריך להתחבר ל-Amazon S3 או ל-Blob Storage. אם רוצים לשלוח שאילתות לנתונים חיצוניים, צריך ליצור טבלת BigLake שמפנה לנתונים ב-Amazon S3 או ב-Blob Storage.
כלים של BigQuery Omni
אתם יכולים להשתמש בכלים הבאים של BigQuery Omni כדי להריץ ניתוח של BigQuery על הנתונים החיצוניים:
- שאילתות JOIN ב-BigQuery Omni: מריצים שאילתה ישירות מאזור ב-BigQuery שיכולה לאחד נתונים מאזור ב-BigQuery Omni.
- תצוגות מהותיות ב-BigQuery Omni: אתם יכולים להשתמש ברפליקות של תצוגות מהותיות כדי לשכפל נתונים באופן רציף מאזורים של BigQuery Omni. תמיכה בסינון נתונים.
- העברה של BigQuery Omni באמצעות
SELECT: מריצים שאילתה באמצעות ההצהרהCREATE TABLE AS SELECTאוINSERT INTO SELECTבאזור של BigQuery Omni, ומעבירים את התוצאה לאזור של BigQuery. - העברה ב-BigQuery Omni באמצעות
LOAD: משתמשים בהצהרותLOAD DATAכדי לטעון נתונים ישירות מ-Amazon Simple Storage Service (Amazon S3) או מ-Azure Blob Storage ל-BigQuery.
בטבלה הבאה מפורטות התכונות והיכולות העיקריות של כל כלי ב-BigQuery Omni:
| צירופים ב-BigQuery Omni | תצוגה מהותית של BigQuery Omni | העברה של BigQuery Omni באמצעות SELECT |
העברה של BigQuery Omni באמצעות LOAD |
|
|---|---|---|---|---|
| השימוש המומלץ | להריץ שאילתות על נתונים חיצוניים לשימוש חד-פעמי, שבהן אפשר להצטרף לטבלאות מקומיות או לצרף נתונים בין שני אזורים שונים של BigQuery Omni – לדוגמה, בין אזורים של AWS ו-Azure Blob Storage. אם הנתונים לא גדולים, ואם שמירה במטמון היא לא דרישה מרכזית, השתמשו בצירופים של BigQuery Omni. | להגדיר שאילתות חוזרות או מתוזמנות כדי להעביר באופן רציף נתונים חיצוניים באופן מצטבר, כשהדרישה העיקרית היא שמירת נתונים במטמון. לדוגמה, כדי לתחזק מרכז בקרה | שאילתות על נתונים חיצוניים לשימוש חד-פעמי, מאזור BigQuery Omni לאזור BigQuery, שבהן אמצעי בקרה ידניים כמו אופטימיזציה של מטמון ושאילתות הם דרישה מרכזית, ואם אתם משתמשים בשאילתות מורכבות שלא נתמכות על ידי צירופים של BigQuery Omni או תצוגות מהותיות של BigQuery Omni. | להעביר מערכי נתונים גדולים כמו שהם בלי לסנן אותם, באמצעות שאילתות מתוזמנות להעברת נתונים גולמיים |
| תמיכה בסינון לפני העברת נתונים | כן. יש מגבלות על אופרטורים מסוימים של שאילתות. מידע נוסף זמין במאמר מגבלות על צירוף ב-BigQuery Omni. | כן. יש מגבלות על אופרטורים מסוימים של שאילתות, כמו פונקציות צבירה והאופרטור UNION |
כן. אין מגבלות על אופרטורים של שאילתות | לא |
| מגבלות על גודל ההעברה | 60GB לכל העברה (כל שאילתת משנה לאזור מרוחק יוצרת העברה אחת) | אין מגבלה | 60GB לכל העברה (כל שאילתת משנה לאזור מרוחק יוצרת העברה אחת) | אין מגבלה |
| דחיסת נתונים בהעברה | דחיסת נתונים ברשת | עמודות | דחיסת נתונים ברשת | דחיסת נתונים בהעברה בנקאית |
| שמירה במטמון | לא נתמך | נתמך בטבלאות עם מטמון מופעל ותצוגות מהותיות | לא נתמך | לא נתמך |
| תמחור של תעבורת נתונים יוצאת (egress) | עלות תעבורת הנתונים היוצאת (egress) ועלות תעבורת הנתונים בין יבשות ב-AWS | עלות תעבורת הנתונים היוצאת (egress) ובין יבשות ב-AWS | עלות תעבורת הנתונים היוצאת (egress) ובין יבשות ב-AWS | עלות תעבורת הנתונים היוצאת (egress) ועלות תעבורת הנתונים בין יבשות ב-AWS |
| חישוב השימוש בהעברת נתונים | שימוש במשבצות באזור המקור של AWS או של Azure Blob Storage (הזמנה או על פי דרישה) | צולם בלי מבזק | שימוש במשבצות באזור המקור של AWS או של Azure Blob Storage (הזמנה או על פי דרישה) | צולם בלי מבזק |
| חישוב השימוש לצורך סינון | שימוש במשבצות באזור המקור של AWS או של Azure Blob Storage (הזמנה או על פי דרישה) | שימוש במשבצות באזור המקור של AWS או של Azure Blob Storage (הזמנה או על פי דרישה) לחישוב תצוגות מהותיות מקומיות ומטא-נתונים | שימוש במשבצות באזור המקור של AWS או של Azure Blob Storage (הזמנה או על פי דרישה) | צולם בלי מבזק |
| העברה מצטברת | לא נתמך | נתמך בתצוגות מהותיות לא מצטברות | לא נתמך | לא נתמך |
אתם יכולים גם להשתמש באחת מהאפשרויות הבאות כדי להעביר נתונים מ-Amazon Simple Storage Service (Amazon S3) או מ-Azure Blob Storage אל Google Cloud:
- Storage Transfer Service: העברת נתונים בין אחסון אובייקטים וקבצים ב- Google Cloud לבין Amazon Simple Storage Service (Amazon S3) או Azure Blob Storage.
- שירות העברת הנתונים ל-BigQuery: הגדרת העברת נתונים אוטומטית ל-BigQuery באופן מתוזמן ומנוהל. הוא תומך במגוון מקורות ומתאים להעברת נתונים. שירות העברת הנתונים ל-BigQuery לא תומך בסינון.
ארכיטקטורה
הארכיטקטורה של BigQuery מפרידה בין המחשוב לאחסון, וכך מאפשרת ל-BigQuery להתרחב אופקית בהתאם לעומס (scale out) כדי לטפל בעומסי עבודה גדולים מאוד. ב-BigQuery Omni, הארכיטקטורה הזו מורחבת על ידי הפעלת מנוע השאילתות של BigQuery בעננים אחרים. כתוצאה מכך, אתם לא צריכים להעביר פיזית את הנתונים לאחסון ב-BigQuery. העיבוד מתבצע במקום שבו הנתונים כבר נמצאים.
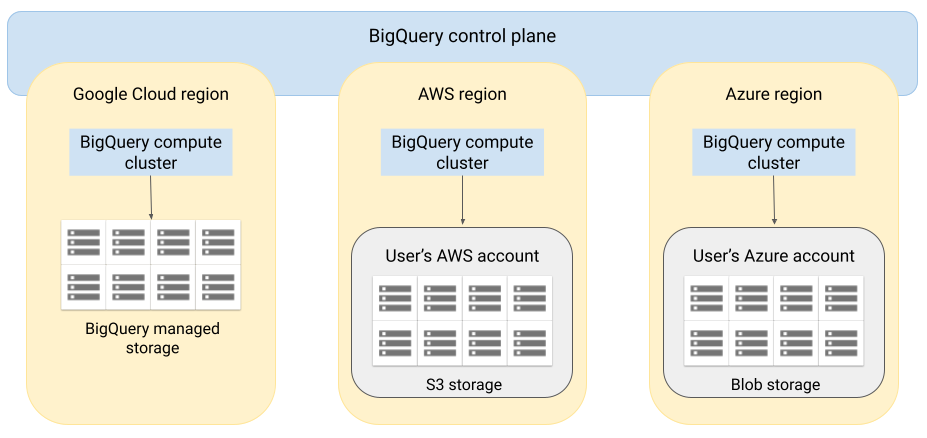
אפשר להחזיר את תוצאות השאילתה אל Google Cloud באמצעות חיבור מאובטח – לדוגמה, כדי להציג אותן במסוף Google Cloud . אפשר גם לכתוב את התוצאות ישירות לקטגוריות של Amazon S3 או ל-Blob Storage. במקרה כזה, תוצאות השאילתה לא עוברות בין עננים.
כדי לגשת לנתונים במינוי שלכם, BigQuery Omni משתמש בתפקידי AWS IAM סטנדרטיים או בחשבונות משתמשים ב-Azure Active Directory. אתם מקצים גישת קריאה או כתיבה ל-BigQuery Omni, ויכולים לבטל את הגישה בכל שלב.
זרימת הנתונים כששולחים שאילתה לגבי נתונים
בתמונה הבאה מתואר איך הנתונים עוברים בין Google Cloud לבין AWS או Azure בשאילתות הבאות:
- הצהרה של
SELECT - הצהרה של
CREATE EXTERNAL TABLE

- מישור הבקרה של BigQuery מקבל מכם משימות של שאילתות דרך מסוףGoogle Cloud , כלי שורת הפקודה של BigQuery, שיטת API או ספריית לקוח.
- מישור הבקרה של BigQuery שולח משימות של שאילתות לעיבוד במישור הנתונים של BigQuery ב-AWS או ב-Azure.
- מישור הנתונים של BigQuery מקבל את השאילתה ממישור הבקרה דרך חיבור דרך VPN.
- מישור הנתונים של BigQuery קורא את נתוני הטבלה מקטגוריית Amazon S3 או מ-Blob Storage.
- מישור הנתונים של BigQuery מריץ את משימת השאילתה על נתוני הטבלה. עיבוד נתוני הטבלה מתבצע באזור שצוין ב-AWS או ב-Azure.
- תוצאת השאילתה מועברת ממישור הנתונים למישור הבקרה דרך חיבור דרך VPN.
- מישור הבקרה של BigQuery מקבל את תוצאות משימת השאילתה כדי להציג אותן בתגובה למשימת השאילתה. הנתונים האלה נשמרים למשך עד 24 שעות.
- תוצאת השאילתה מוחזרת אליכם.
מידע נוסף זמין במאמרים שאילתות על נתונים ב-Amazon S3 ושאילתות על נתונים ב-Blob Storage.
זרימת הנתונים כשמייצאים נתונים
בתמונה הבאה מתואר איך הנתונים עוברים בין Google Cloud לבין AWS או Azure במהלך הצהרת EXPORT DATA.

- מישור הבקרה של BigQuery מקבל מכם משימות של שאילתות ייצוא דרך מסוף Google Cloud , כלי שורת הפקודה של BigQuery, שיטה של API או ספריית לקוח. השאילתה מכילה את נתיב היעד של תוצאת השאילתה בקטגוריה של Amazon S3 או ב-Blob Storage.
- מישור הבקרה של BigQuery שולח משימות של שאילתות ייצוא לעיבוד במישור הנתונים של BigQuery (ב-AWS או ב-Azure).
- מישור הנתונים של BigQuery מקבל את שאילתת הייצוא ממישור הבקרה דרך חיבור דרך VPN.
- מישור הנתונים של BigQuery קורא את נתוני הטבלה מקטגוריית Amazon S3 או מ-Blob Storage.
- מישור הנתונים של BigQuery מריץ את משימת השאילתה על נתוני הטבלה. עיבוד נתוני הטבלה מתבצע באזור שצוין ב-AWS או ב-Azure.
- BigQuery כותב את תוצאת השאילתה בנתיב היעד שצוין בקטגוריה של Amazon S3 או ב-Blob Storage.
מידע נוסף זמין במאמרים ייצוא תוצאות של שאילתות ל-Amazon S3 ו-Blob Storage.
יתרונות
ביצועים. אתם יכולים לקבל תובנות מהר יותר, כי הנתונים לא מועתקים בין עננים, והשאילתות פועלות באותו אזור שבו הנתונים נמצאים.
עלות. אתם חוסכים בעלויות של העברת נתונים יוצאים כי הנתונים לא זזים. אין חיובים נוספים בחשבון AWS או Azure שקשורים לניתוח נתונים ב-BigQuery Omni, כי השאילתות פועלות באשכולות שמנוהלים על ידי Google. החיוב הוא רק על הרצת השאילתות, לפי מודל התמחור של BigQuery.
אבטחה ומשילות מידע. אתם מנהלים את הנתונים במינוי שלכם ב-AWS או ב-Azure. אתם לא צריכים להעביר או להעתיק את הנתונים הגולמיים מהענן הציבורי. כל החישובים מתבצעים בשירות מרובה-הדיירים של BigQuery, שפועל באותו אזור שבו נמצאים הנתונים שלכם.
ארכיטקטורה ללא שרת (serverless). כמו שאר BigQuery, גם BigQuery Omni הוא שירות ללא שרת (serverless). Google פורסת ומנהלת את האשכולות שבהם פועל BigQuery Omni. לא צריך להקצות משאבים או לנהל אשכולות.
ניהול קל. ב-BigQuery Omni יש ממשק ניהול אחיד דרך Google Cloud. ב-BigQuery Omni אפשר להשתמש בחשבון Google Cloud ובפרויקטים הקיימים ב-BigQuery. אתם יכולים לכתוב שאילתת GoogleSQL במסוף Google Cloud כדי לשלוח שאילתה על נתונים ב-AWS או ב-Azure, ולראות את התוצאות במסוף Google Cloud .
העברה של BigQuery Omni. אתם יכולים לטעון נתונים לטבלאות BigQuery רגילות מקטגוריות S3 ומ-Blob Storage. מידע נוסף זמין במאמרים העברת נתונים מ-Amazon S3 והעברת נתונים מ-Blob Storage ל-BigQuery.
שמירת מטא-נתונים במטמון לשיפור הביצועים
אתם יכולים להשתמש במטא-נתונים שנשמרו במטמון כדי לשפר את ביצועי השאילתות בטבלאות BigLake שמפנות לנתונים ב-Amazon S3. היא שימושית במיוחד כשעובדים עם מספר גדול של קבצים או אם הנתונים מחולקים למחיצות ב-Apache Hive.
ב-BigQuery נעשה שימוש ב-CMETA כמערכת מטא-נתונים מבוזרת, כדי לטפל בטבלאות גדולות ביעילות. CMETA מספק מטא-נתונים מפורטים ברמת העמודה והבלוק, שאפשר לגשת אליהם דרך טבלאות המערכת. המערכת הזו עוזרת לשפר את ביצועי השאילתות על ידי אופטימיזציה של הגישה לנתונים ועיבוד הנתונים. כדי לשפר עוד יותר את ביצועי השאילתות בטבלאות גדולות, BigQuery שומר מטמון של מטא-נתונים. משימות הרענון של CMETA שומרות על עדכניות המטמון הזה.המטא-נתונים כוללים שמות קבצים, מידע על חלוקה למחיצות ומטא-נתונים פיזיים מקבצים, כמו ספירת שורות. אתם יכולים לבחור אם להפעיל או להשבית את שמירת המטא-נתונים במטמון בטבלה. שאילתות עם מספר גדול של קבצים ועם מסנני מחיצות של Apache Hive מפיקות את התועלת הרבה ביותר משמירת מטא-נתונים במטמון.
אם לא תפעילו את האפשרות לשמירת מטא-נתונים במטמון, שאילתות בטבלה יצטרכו לקרוא את מקור הנתונים החיצוני כדי לקבל מטא-נתונים של אובייקטים. קריאת הנתונים האלה מגדילה את זמן האחזור של השאילתה, ורישום של מיליוני קבצים ממקור הנתונים החיצוני יכול להימשך כמה דקות. אם מפעילים שמירת מטא-נתונים במטמון, השאילתות יכולות להימנע מיצירת רשימת קבצים ממקור הנתונים החיצוני, ולבצע חלוקה למחיצות וגיזום של קבצים מהר יותר.
שמירת המטא-נתונים במטמון משתלבת גם עם ניהול גרסאות של אובייקטים ב-Cloud Storage. כשהמטמון מתמלא או מתרענן, הוא מתעד מטא-נתונים על סמך הגרסה הפעילה של האובייקטים ב-Cloud Storage באותו זמן. כתוצאה מכך, שאילתות שמופעל בהן שמירת מטא-נתונים במטמון קוראות נתונים שתואמים לגרסת האובייקט הספציפית שנשמרה במטמון, גם אם גרסאות חדשות יותר הופכות לפעילות ב-Cloud Storage. כדי לגשת לנתונים מגרסאות של אובייקטים שעודכנו לאחר מכן ב-Cloud Storage, צריך לרענן את המטמון של המטא-נתונים.
יש שני מאפיינים ששולטים בתכונה הזו:
- התיישנות מקסימלית מציינת מתי שאילתות משתמשות במטא-נתונים שנשמרו במטמון.
- מצב המטמון של המטא-נתונים מציין איך המטא-נתונים נאספים.
כשמפעילים שמירת מטא-נתונים במטמון, מציינים את המרווח המקסימלי של מטא-נתונים לא עדכניים שאפשר לקבל בפעולות בטבלה. לדוגמה, אם מציינים מרווח של שעה, פעולות בטבלה משתמשות במטא-נתונים שנשמרו במטמון אם הם רועננו בשעה האחרונה. אם המטא-נתונים במטמון ישנים יותר, הפעולה חוזרת לאחזור מטא-נתונים מ-Amazon S3. אפשר לציין מרווח זמן של בין 30 דקות ל-7 ימים.
כשמפעילים שמירת מטא-נתונים במטמון בטבלאות BigLake או בטבלאות אובייקטים, BigQuery מפעיל משימות רענון ליצירת מטא-נתונים. אתם יכולים לבחור לרענן את המטמון באופן אוטומטי או ידני:
- ברענון אוטומטי, המטמון מתרענן במרווח זמן שמוגדר במערכת, בדרך כלל בין 30 ל-60 דקות. רענון המטמון באופן אוטומטי הוא גישה טובה אם הקבצים ב-Amazon S3 מתווספים, נמחקים או משתנים במרווחי זמן אקראיים. אם אתם צריכים לשלוט בתזמון הרענון, למשל כדי להפעיל את הרענון בסוף משימת חילוץ-טרנספורמציה-טעינה, השתמשו ברענון ידני.
כדי לרענן ידנית, מריצים את הפרוצדורה של המערכת
BQ.REFRESH_EXTERNAL_METADATA_CACHEכדי לרענן את המטמון של המטא-נתונים לפי לוח זמנים שמתאים לדרישות שלכם. רענון המטמון באופן ידני הוא גישה טובה אם הקבצים ב-Amazon S3 נוספים, נמחקים או משתנים במרווחי זמן ידועים, למשל כפלט של צינור עיבוד נתונים.אם תבצעו כמה רענונים ידניים בו-זמנית, רק אחד מהם יצליח.
אם המטמון של המטא-נתונים לא מתרענן, התוקף שלו פג אחרי 7 ימים.
רענון המטמון, גם הידני וגם האוטומטי, מתבצע בעדיפות שאילתה INTERACTIVE.
שימוש בהזמנות של BACKGROUND
אם אתם בוחרים להשתמש ברענון אוטומטי, מומלץ ליצור מקום שמור ואז ליצור הקצאה עם סוג העבודה BACKGROUND לפרויקט שמריץ את משימות הרענון של המטמון של המטא-נתונים. במערכים של BACKGROUND, משימות הרענון משתמשות במאגר משאבים ייעודי, שמונע ממשימות הרענון להתחרות בשאילתות של משתמשים, ומונע מהמשימות להיכשל אם אין מספיק משאבים זמינים בשבילן.
השימוש במאגר משבצות משותף לא כרוך בעלות נוספת, אבל השימוש בהזמנות של BACKGROUND מספק ביצועים עקביים יותר על ידי הקצאת מאגר משאבים ייעודי, ומשפר את האמינות של משימות הרענון ואת היעילות הכוללת של השאילתות ב-BigQuery.
לפני שאתם מגדירים את הערכים של מרווח הזמן להתיישנות ושל מצב שמירת המטא-נתונים במטמון, חשוב שתבינו איך הם משפיעים אחד על השני. מומלץ להביא בחשבון את הדוגמאות הבאות:
- אם אתם מרעננים באופן ידני את מטמון המטא-נתונים של טבלה, ומגדירים את מרווח הזמן של הנתונים הישנים ליומיים, אתם צריכים להריץ את הפרוצדורה של המערכת
BQ.REFRESH_EXTERNAL_METADATA_CACHEכל יומיים או פחות אם אתם רוצים שהפעולות בטבלה ישתמשו במטא-נתונים שנשמרו במטמון. - אם אתם מרעננים באופן אוטומטי את מטמון המטא-נתונים של טבלה, ומגדירים את מרווח הזמן ל-30 דקות, יכול להיות שחלק מהפעולות בטבלה יקראו מ-Amazon S3 אם הרענון של מטמון המטא-נתונים יימשך יותר זמן מהחלון הרגיל של 30 עד 60 דקות.
כדי למצוא מידע על משימות רענון של מטא-נתונים, שולחים שאילתה לתצוגה INFORMATION_SCHEMA.JOBS, כמו בדוגמה הבאה:
SELECT *
FROM `region-us.INFORMATION_SCHEMA.JOBS_BY_PROJECT`
WHERE job_id LIKE '%metadata_cache_refresh%'
AND creation_time > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 6 HOUR)
ORDER BY start_time DESC
LIMIT 10;
מידע נוסף זמין במאמר שמירת מטא-נתונים במטמון.
טבלאות עם מטמון ותצוגות מהותיות
אתם יכולים להשתמש בתצוגות מהותיות בטבלאות עם מטמון מטא-נתונים של Amazon Simple Storage Service (Amazon S3) כדי לשפר את הביצועים והיעילות כשאתם שולחים שאילתות לנתונים מובְנים שמאוחסנים ב-Amazon S3. התצוגות האלה פועלות כמו תצוגות מהותיות בטבלאות אחסון שמנוהלות על ידי BigQuery, כולל היתרונות של רענון אוטומטי וכוונון חכם.
כדי שנתוני Amazon S3 בתצוגה המהותית יהיו זמינים לצירופים באזור נתמך ב-BigQuery, צריך ליצור עותק של התצוגה המהותית. אפשר ליצור עותקים של תצוגות מהותיות רק בתצוגות מהותיות מורשות.
מגבלות
בנוסף למגבלות על טבלאות BigLake, המגבלות הבאות חלות על BigQuery Omni, שכולל טבלאות BigLake שמבוססות על נתונים מ-Amazon S3 ומ-Blob Storage:
- במהדורות Standard ו-Enterprise Plus אין תמיכה בעבודה עם נתונים באף אחד מאזורי BigQuery Omni. למידע נוסף על המהדורות, קראו את המאמר מבוא למהדורות של BigQuery.
- התצוגות של
INFORMATION_SCHEMAOBJECT_PRIVILEGES,STREAMING_TIMELINE_BY_*,TABLE_SNAPSHOTS,TABLE_STORAGE,TABLE_CONSTRAINTS,KEY_COLUMN_USAGE,CONSTRAINT_COLUMN_USAGEו-PARTITIONSלא זמינות לטבלאות BigLake שמבוססות על נתונים מ-Amazon S3 ומ-Blob Storage. - תצוגות מהותיות לא נתמכות ב-Blob Storage.
- אין תמיכה בפונקציות UDF ב-JavaScript.
אין תמיכה בהצהרות ה-SQL הבאות:
- הצהרות BigQuery ML.
- הצהרות של שפת הגדרת נתונים (DDL) שדורשות נתונים שמנוהלים ב-BigQuery. לדוגמה, יש תמיכה ב-
CREATE EXTERNAL TABLE, ב-CREATE SCHEMAאו ב-CREATE RESERVATION, אבל אין תמיכה ב-CREATE TABLE. - הצהרות של שפת טיפול בנתונים (DML).
המגבלות הבאות חלות על שאילתות וקריאה של טבלאות יעד זמניות:
- אי אפשר לשלוח שאילתות לטבלאות יעד זמניות באמצעות ההצהרה
SELECT.
- אי אפשר לשלוח שאילתות לטבלאות יעד זמניות באמצעות ההצהרה
שאילתות מתוזמנות נתמכות רק באמצעות ה-API או ה-CLI. האפשרות טבלת יעדים מושבתת בשאילתות. מותר להשתמש רק בשאילתות מסוג
EXPORT DATA.BigQuery Storage API לא זמין באזורים של BigQuery Omni.
אם השאילתה משתמשת בסעיף
ORDER BYוגודל התוצאה גדול מ-256MB, השאילתה תיכשל. כדי לפתור את הבעיה, צריך להקטין את גודל התוצאה או להסיר את הסעיףORDER BYמהשאילתה. מידע נוסף על מכסות ומגבלות ב-BigQuery Omniאי אפשר להשתמש במפתחות הצפנה בניהול הלקוח (CMEK) עם מערכי נתונים וטבלאות חיצוניות.
תמחור
למידע על תמחור ומבצעים לזמן מוגבל ב-BigQuery Omni, קראו את המאמר תמחור ב-BigQuery Omni.
מכסות ומגבלות
למידע על המכסות של BigQuery Omni, קראו את המאמר מכסות ומגבלות.
אם תוצאת השאילתה גדולה מ-20GiB, כדאי לייצא את התוצאות ל-Amazon S3 או ל-Blob Storage. במאמר BigQuery Connection API מוסבר על המכסות של BigQuery Connection API.
מיקומים
ב-BigQuery Omni, השאילתות מעובדות באותו מיקום שבו נמצא מערך הנתונים שמכיל את הטבלאות שאתם שולחים אליהן שאילתות. אחרי שיוצרים את מערך הנתונים אי אפשר לשנות את המיקום. הנתונים נמצאים בחשבון AWS או Azure. באזורים של BigQuery Omni אפשר להשתמש בקרדיטים של מהדורת Enterprise ובתמחור של מחשוב (ניתוח) על פי דרישה. למידע נוסף על המהדורות, קראו את המאמר מבוא למהדורות של BigQuery.
| תיאור האזור | שם האזור | האזור של BigQuery באותו מיקום | |
|---|---|---|---|
| AWS | |||
| AWS – מזרח ארה"ב (צפון וירג'יניה) | aws-us-east-1 |
us-east4 |
|
| AWS – מערב ארה"ב (אורגון) | aws-us-west-2 |
us-west1 |
|
| AWS – אסיה-פסיפיק (סיאול) | aws-ap-northeast-2 |
asia-northeast3 |
|
| AWS - Asia Pacific (Sydney) | aws-ap-southeast-2 |
australia-southeast1 |
|
| AWS – אירופה (אירלנד) | aws-eu-west-1 |
europe-west1 |
|
| AWS – אירופה (פרנקפורט) | aws-eu-central-1 |
europe-west3 |
|
| Azure | |||
| Azure - East US 2 | azure-eastus2 |
us-east4 |
|
המאמרים הבאים
- איך מתחברים ל-Amazon S3 ול-Blob Storage
- איך יוצרים טבלאות BigLake ב-Amazon S3 ואיך יוצרים טבלאות BigLake ב-Blob Storage
- איך שולחים שאילתות לטבלאות BigLake ב-Amazon S3 וב-Blob Storage
- איך משלבים טבלאות BigLake של Amazon S3 ו-Blob Storage עם טבלאות של Google Cloud באמצעות BigQuery Omni
- איך מייצאים תוצאות של שאילתות ל-Amazon S3 ו-Blob Storage
- איך מעבירים נתונים מ-Amazon S3 ל-BigQuery ואיך מעבירים נתונים מ-Blob Storage ל-BigQuery.
- מידע ולמידה על הגדרת היקף VPC Service Controls
- איך מציינים את המיקום