


יצירת תצוגות מהותיות
תצוגות מהותיות מאפשרות לשפר את ביצועי השאילתות ולהפחית את העלויות על ידי חישוב מראש ושמירה במטמון של תוצאות השאילתות שמופעלות לעיתים קרובות ב-BigQuery. במאמר הזה מוסבר איך ליצור תצוגות מהותיות, כולל תצוגות מהותיות מחולקות למחיצות ומקובצות, תצוגות מהותיות לא מצטברות ותצוגות מהותיות שמשתמשות באפשרות max_staleness.
לפני שמתחילים
להקצות תפקידים של ניהול זהויות והרשאות גישה (IAM) שנותנים למשתמשים את ההרשאות שנדרשות כדי לבצע כל משימה במסמך הזה.
ההרשאות הנדרשות
כדי ליצור תצוגות מהותיות, צריך את ההרשאה bigquery.tables.create ב-IAM.
כל אחד מהתפקידים הבאים שמוגדרים מראש ב-IAM כולל את ההרשאות שנדרשות כדי ליצור תצוגה מהותית:
bigquery.dataEditorbigquery.dataOwnerbigquery.admin
למידע נוסף על ניהול הזהויות והרשאות הגישה (IAM) ב-BigQuery, קראו את המאמר בקרת גישה באמצעות IAM.
יצירת תצוגות מהותיות
כדי ליצור תצוגה מהותית, בוחרים באחת מהאפשרויות הבאות:
SQL
משתמשים בהצהרה CREATE MATERIALIZED VIEW.
בדוגמה הבאה נוצרת תצוגה מהותית של מספר הקליקים לכל מזהה מוצר:
נכנסים לדף BigQuery במסוף Google Cloud .
בעורך השאילתות, מזינים את ההצהרה הבאה:
CREATE MATERIALIZED VIEW PROJECT_ID.DATASET.MATERIALIZED_VIEW_NAME AS (
  QUERY_EXPRESSION
);
מחליפים את מה שכתוב בשדות הבאים:
-
PROJECT_ID: שם הפרויקט שבו רוצים ליצור את התצוגה המהותית, לדוגמהmyproject. -
DATASET: השם של מערך הנתונים ב-BigQuery שבו רוצים ליצור את התצוגה המהותית, למשלmydataset. אם אתם יוצרים תצוגה מהותית על טבלת BigLake של Amazon Simple Storage Service (Amazon S3) (גרסת טרום-השקה (Preview)), ודאו שקבוצת הנתונים נמצאת באזור נתמך. -
MATERIALIZED_VIEW_NAME: השם של התצוגה המהותית שרוצים ליצור, לדוגמהmy_mv. -
QUERY_EXPRESSION: ביטוי השאילתה ב-GoogleSQL שמגדיר את התצוגה המהותית, לדוגמהSELECT product_id, SUM(clicks) AS sum_clicks FROM mydataset.my_source_table.
-
לוחצים על הפעלה.
מידע נוסף על הרצת שאילתות זמין במאמר הרצת שאילתה אינטראקטיבית.
דוגמה
בדוגמה הבאה נוצרת תצוגה מהותית של מספר הקליקים לכל מזהה מוצר:
CREATE MATERIALIZED VIEW myproject.mydataset.my_mv_table AS (
  SELECT
    product_id,
    SUM(clicks) AS sum_clicks
  FROM
    myproject.mydataset.my_base_table
  GROUP BY
    product_id
);
Terraform
משתמשים במשאב google_bigquery_table.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
בדוגמה הבאה נוצרת תצוגה בשם my_materialized_view:
כך מחילים את ההגדרות של Terraform בפרויקט ב- Google Cloud :
הכנת Cloud Shell
- מפעילים את Cloud Shell.
-
מגדירים את פרויקט ברירת המחדל ב- Google Cloud שבו רוצים להחיל את ההגדרות של Terraform.
תצטרכו להריץ את הפקודה הזו רק פעם אחת לכל פרויקט, ותוכלו לעשות זאת בכל ספרייה.
export GOOGLE_CLOUD_PROJECT=PROJECT_ID
אם תגדירו ערכים ספציפיים בקובץ התצורה של Terraform, הם יבטלו את ערכי ברירת המחדל של משתני הסביבה.
הכנת הספרייה
לכל קובץ תצורה של Terraform צריכה להיות ספרייה משלו (שנקראת גם מודול ברמה הבסיסית).
-
יוצרים ספרייה חדשה ב-Cloud Shell ובה יוצרים קובץ חדש. שם הקובץ חייב לכלול את הסיומת
.tf, למשלmain.tf. במדריך הזה, הקובץ נקראmain.tf.mkdir DIRECTORY && cd DIRECTORY && touch main.tf
-
אם אתם עוקבים אחרי המדריך, תוכלו להעתיק את הקוד לדוגמה בכל קטע או שלב.
מעתיקים את הקוד לדוגמה בקובץ
main.tfהחדש שיצרתם.לחלופין, אפשר גם להעתיק את הקוד מ-GitHub. כדאי לעשות את זה כשקטע הקוד של Terraform הוא חלק מפתרון מקצה לקצה.
- בודקים את הפרמטרים לדוגמה ומשנים אותם בהתאם לסביבה שלכם.
- שומרים את השינויים.
-
מפעילים את Terraform. צריך לעשות זאת רק פעם אחת לכל ספרייה.
terraform init
אופציונלי: תוכלו לכלול את האפשרות
-upgrade, כדי להשתמש בגרסה העדכנית ביותר של הספק של Google:terraform init -upgrade
החלה של השינויים
-
בודקים את ההגדרות ומוודאים שהמשאבים שמערכת Terraform תיצור או תעדכן תואמים לציפיות שלכם:
terraform plan
מתקנים את ההגדרות לפי הצורך.
-
מריצים את הפקודה הבאה ומזינים
yesבהודעה שמופיעה, כדי להחיל את הגדרות Terraform:terraform apply
ממתינים עד שב-Terraform תוצג ההודעה "Apply complete!".
- פותחים את הפרויקט ב- Google Cloud כדי להציג את התוצאות. במסוף Google Cloud , נכנסים למשאבים בממשק המשתמש כדי לוודא שהם נוצרו או עודכנו ב-Terraform.
API
מפעילים את ה-method tables.insert ומעבירים משאב Table עם שדה materializedView מוגדר:
{
  "kind": "bigquery#table",
  "tableReference": {
    "projectId": "PROJECT_ID",
    "datasetId": "DATASET",
    "tableId": "MATERIALIZED_VIEW_NAME"
  },
  "materializedView": {
    "query": "QUERY_EXPRESSION"
  }
}
מחליפים את מה שכתוב בשדות הבאים:
-
PROJECT_ID: שם הפרויקט שבו רוצים ליצור את התצוגה המהותית, לדוגמהmyproject. -
DATASET: השם של מערך הנתונים ב-BigQuery שבו רוצים ליצור את התצוגה המהותית, למשלmydataset. אם אתם יוצרים תצוגה מהותית על טבלת BigLake של Amazon Simple Storage Service (Amazon S3) (גרסת טרום-השקה (Preview)), ודאו שקבוצת הנתונים נמצאת באזור נתמך. -
MATERIALIZED_VIEW_NAME: השם של התצוגה המהותית שרוצים ליצור, לדוגמהmy_mv. -
QUERY_EXPRESSION: ביטוי השאילתה ב-GoogleSQL שמגדיר את התצוגה המהותית, לדוגמהSELECT product_id, SUM(clicks) AS sum_clicks FROM mydataset.my_source_table.
דוגמה
בדוגמה הבאה נוצרת תצוגה מהותית של מספר הקליקים לכל מזהה מוצר:
{
  "kind": "bigquery#table",
  "tableReference": {
    "projectId": "myproject",
    "datasetId": "mydataset",
    "tableId": "my_mv"
  },
  "materializedView": {
    "query": "select product_id,sum(clicks) as
                sum_clicks from myproject.mydataset.my_source_table
                group by 1"
  }
}
Java
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Java במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Java API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
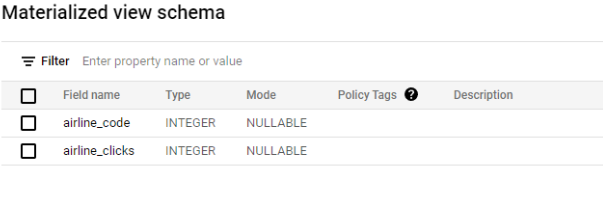
אחרי שיוצרים את התצוגה המהותית, היא מופיעה בחלונית Explorer של BigQuery במסוף Google Cloud . בדוגמה הבאה מוצגת סכימה של תצוגה מהותית:
אם לא משביתים את הרענון האוטומטי, BigQuery מתחיל רענון מלא אסינכרוני של התצוגה המהותית. השאילתה מסתיימת במהירות, אבל יכול להיות שהרענון הראשוני ימשיך לפעול.
בקרת גישה
אפשר לתת גישה לתצוגה מהותית ברמת מערך הנתונים, ברמת התצוגה או ברמת העמודה. אפשר גם להגדיר גישה ברמה גבוהה יותר בהיררכיית המשאבים של IAM.
כדי לשלוח שאילתה לתצוגה מהותית, צריך גישה לתצוגה וגם למסדי הנתונים הטבלאיים שלה. כדי לשתף תצוגה מהותית, אתם יכולים לתת הרשאות למסדי נתונים טבלאיים או להגדיר תצוגה מהותית כתצוגה מורשית. מידע נוסף זמין במאמר תצוגות מורשות.
הגבלות על בקרת הגישה
אם שאילתה של משתמש בתצוגה מהותית כוללת עמודות של מסד נתונים טבלאי שאין לו גישה אליהן בגלל אבטחה ברמת העמודה, השאילתה נכשלת ומוצגת ההודעה
Access Denied.אם משתמש שולח שאילתה לתצוגה המהותית אבל אין לו גישה מלאה לכל השורות במסד הנתונים הטבלאי של התצוגה המהותית, BigQuery מריץ את השאילתה במסד הנתונים הטבלאי במקום לקרוא את הנתונים של התצוגה המהותית. כך אפשר לוודא שהשאילתה תואמת לכל המגבלות של בקרת הגישה. המגבלה הזו חלה גם כששולחים שאילתות לטבלאות עם עמודות שמוסתרות באמצעות מסכת נתונים.
תמיכה בשאילתות של תצוגות מהותיות
בתצוגות מהותיות משתמשים בתחביר SQL מוגבל. השאילתות צריכות להיות בתבנית הבאה:
[ WITH cte [, …]]
SELECT  [{ ALL | DISTINCT }]
  expression [ [ AS ] alias ] [, ...]
FROM from_item [, ...]
[ WHERE bool_expression ]
[ GROUP BY expression [, ...] ]

from_item:
    {
      table_name [ as_alias ]
      | { join_operation | ( join_operation ) }
      | field_path
      | unnest_operator
      | cte_name [ as_alias ]
    }

as_alias:
    [ AS ] alias
מגבלות על שאילתות
לתצוגות מהותיות מצטברות יש את המגבלות הבאות.
דרישות מצטברות
הצבירות בשאילתה של התצוגה המהותית חייבות להיות פלטים. אין תמיכה בחישוב, בסינון או בצירוף על סמך ערך נצבר. לדוגמה, אי אפשר ליצור תצוגה מהשאילתה הבאה כי היא מפיקה ערך שמחושב מצבירה, COUNT(*) / 10 as cnt.
SELECT TIMESTAMP_TRUNC(ts, HOUR) AS ts_hour, COUNT(*) / 10 AS cnt
FROM mydataset.mytable
GROUP BY ts_hour;
אפשר להשתמש רק בפונקציות הצבירה הבאות:
-
ANY_VALUE(אבל לא יותר מ-STRUCT) APPROX_COUNT_DISTINCT-
ARRAY_AGG(אבל לא יותר מ-ARRAYאוSTRUCT) AVGBIT_ANDBIT_ORBIT_XORCOUNTCOUNTIFHLL_COUNT.INITLOGICAL_ANDLOGICAL_ORMAXMIN-
MAX_BY(אבל לא יותר מ-STRUCT) -
MIN_BY(אבל לא יותר מ-STRUCT) SUM
תכונות SQL שלא נתמכות
התכונות הבאות של SQL לא נתמכות בתצוגות מהותיות:
UNION ALL. (תמיכה בגרסת טרום-השקה (Preview) של )-
LEFT OUTER JOIN(תמיכה בגרסת טרום-השקה (Preview) של ) RIGHT/FULL OUTER JOIN.- Self-joins, שנקראים גם שימוש ב-
JOINבאותה טבלה יותר מפעם אחת. - פונקציות אנליטיות (window functions).
ARRAYשאילתות משנה.- פונקציות לא דטרמיניסטיות כמו
RAND(),CURRENT_DATE(),SESSION_USER()אוCURRENT_TIME(). - פונקציות בהגדרת המשתמש (UDF).
TABLESAMPLE.FOR SYSTEM_TIME AS OF.- פונקציות של AI גנרטיבי.
תמיכה ב-LEFT OUTER JOIN וב-UNION ALL
כדי לבקש משוב או תמיכה לגבי התכונה הזו, שלחו אימייל לכתובת bq-mv-help@google.com.
תצוגות מהותיות מצטברות תומכות ב-LEFT OUTER JOIN וב-UNION ALL.
לתצוגות מהותיות עם הצהרות LEFT OUTER JOIN ו-UNION ALL יש את אותן מגבלות כמו לתצוגות מהותיות מצטברות אחרות. בנוסף, כוונון חכם לא נתמך בתצוגות מהותיות עם union all או left outer join.
בתצוגות מהותיות מצטברות עם מחיצות שמשתמשות ב-UNION ALL, לכל מסדי הנתונים הטבלאיים צריכות להיות אותן הגדרות של תאריך תפוגה של המחיצה (TTL) כדי לשמור על יישור המחיצות.
אם למסדי הנתונים הטבלאיים יש תאריכי תפוגה שונים למחיצות, הרענונים המצטברים נכשלים.
דוגמאות
בדוגמה הבאה נוצרת תצוגה מהותית מצטברת עם LEFT JOIN. התצוגה הזו מתעדכנת באופן מצטבר כשנתונים מצורפים לטבלה השמאלית.
CREATE MATERIALIZED VIEW dataset.mv
AS (
  SELECT
    s_store_sk,
    s_country,
    s_zip,
    SUM(ss_net_paid) AS sum_sales,
  FROM dataset.store_sales
  LEFT JOIN dataset.store
    ON ss_store_sk = s_store_sk
  GROUP BY 1, 2, 3
);
בדוגמה הבאה נוצרת תצוגה מהותית מצטברת עם UNION ALL. התצוגה הזו מתעדכנת באופן מצטבר כשנתונים מתווספים לאחת מהטבלאות או לשתיהן. מידע נוסף על עדכונים מצטברים זמין במאמר עדכונים מצטברים.
CREATE MATERIALIZED VIEW dataset.mv PARTITION BY DATE(ts_hour)
AS (
  SELECT
    SELECT TIMESTAMP_TRUNC(ts, HOUR) AS ts_hour, SUM(sales) sum_sales
  FROM
    (SELECT ts, sales from dataset.table1 UNION ALL
     SELECT ts, sales from dataset.table2)
  GROUP BY 1
);
WITH וביטויי טבלה נפוצים (CTE)
תצוגות מהותיות תומכות בסעיפי WITH ובביטויי טבלה נפוצים.
תצוגות מהותיות עם משפטי WITH עדיין צריכות לפעול לפי הדפוס והמגבלות של תצוגות מהותיות בלי משפטי WITH.
דוגמאות
בדוגמה הבאה מוצגת תצוגה מהותית שמשתמשת בסעיף WITH:
WITH tmp AS (
  SELECT TIMESTAMP_TRUNC(ts, HOUR) AS ts_hour, *
  FROM mydataset.mytable
)
SELECT ts_hour, COUNT(*) AS cnt
FROM tmp
GROUP BY ts_hour;
בדוגמה הבאה מוצגת תצוגה מהותית שמשתמשת בסעיף WITH שלא נתמך, כי הוא מכיל שני סעיפי GROUP BY:
WITH tmp AS (
  SELECT city, COUNT(*) AS population
  FROM mydataset.mytable
  GROUP BY city
)
SELECT population, COUNT(*) AS cnt
GROUP BY population;
תצוגות מהותיות בטבלאות BigLake
כדי ליצור תצוגות מהותיות בטבלאות BigLake, צריך להפעיל את המטמון של המטא-נתונים בטבלת BigLake בנתוני Cloud Storage, וערך האפשרות max_staleness של התצוגה המהותית צריך להיות גדול יותר מזה של מסד הנתונים הטבלאי.
תצוגות מהותיות בטבלאות BigLake תומכות באותה קבוצת שאילתות כמו תצוגות מהותיות אחרות.
דוגמה
יצירת תצוגה מצטברת באמצעות מסד נתונים טבלאי של BigLake:
CREATE MATERIALIZED VIEW sample_dataset.sample_mv
    OPTIONS (max_staleness=INTERVAL "0:30:0" HOUR TO SECOND)
AS SELECT COUNT(*) cnt
FROM dataset.biglake_base_table;
לפרטים על המגבלות של תצוגות מהותיות בטבלאות BigLake, קראו את המאמר תצוגות מהותיות בטבלאות BigLake.
תצוגות מהותיות בטבלאות חיצוניות של Apache Iceberg
אתם יכולים להפנות לטבלאות Iceberg גדולות בתצוגות מהותיות, במקום להעביר את הנתונים האלה לאחסון שמנוהל על ידי BigQuery.
יצירת תצוגה מהותית בטבלת Iceberg
בדוגמה הבאה נוצרת תצוגה מהותית עם יישור מחיצות מעל טבלת Iceberg בסיסית עם מחיצות:
CREATE MATERIALIZED VIEW mydataset.myicebergmv
  PARTITION BY DATE_TRUNC(birth_month, MONTH)
AS
  SELECT * FROM mydataset.myicebergtable;
טבלת הבסיס הבסיסית של Iceberg myicebergtable חייבת לכלול מפרט חלוקה למחיצות כמו זה:
  "partition-specs" : [ {
    "spec-id" : 0,
    "fields" : [ {
    "name" : "birth_month",
    "transform" : "month",
    "source-id" : 3,
    "field-id" : 1000
    } ]
  } ]
מגבלות
בנוסף למגבלות של טבלאות Iceberg רגילות, לתצוגות המהותיות בטבלאות Iceberg יש את המגבלות הבאות:
- אתם יכולים ליצור תצוגה מהותית עם מחיצות שתואמות למחיצות של טבלת הבסיס. עם זאת, התצוגה המהותית תומכת רק בטרנספורמציה של חלוקה למחיצות שמבוססת על זמן, לדוגמה,
YEAR,MONTH,DAYו-HOUR. - רמת הפירוט של המחיצה בתצוגה המהותית לא יכולה להיות גבוהה יותר מרמת הפירוט של המחיצה במסד נתונים טבלאי. לדוגמה, אם מחלקים את מסד הנתונים הטבלאי למחיצות לפי שנה באמצעות העמודה
birth_date, אי אפשר ליצור תצוגה מהותית עםPARTITION BY DATE_TRUNC(birth_date, MONTH). - אם בטבלאות הבסיס של Iceberg יש שינויים ביותר מ-4,000 מחיצות, התצוגה המהותית מבוטלת לחלוטין בזמן הרענון, גם אם היא מחולקת למחיצות.
- יש תמיכה בשינויים במחיצות. עם זאת, אם משנים את עמודות החלוקה למחיצות של מסד נתונים טבלאי בלי ליצור מחדש את התצוגה המהותית, יכול להיות שהתצוגה המהותית תהפוך ללא חוקית באופן מלא, ואי אפשר יהיה לתקן את זה על ידי רענון התצוגה המהותית.
- במסד הנתונים הטבלאי חייבת להיות לפחות תמונת מצב אחת.
- טבלת Iceberg חייבת להיות טבלת BigLake, למשל טבלה חיצונית מורשית.
- השאילתה בתצוגה המהותית עלולה להיכשל אם קובץ ה-
metadata.jsonשל טבלת Iceberg פגום. - אם VPC Service Controls מופעל, צריך להוסיף את חשבונות השירות של הטבלה החיצונית המורשית לכללי הכניסה. אחרת, VPC Service Controls חוסם את הרענון האוטומטי ברקע של התצוגה המהותית.
קובץ ה-metadata.json של טבלת Iceberg צריך לעמוד בדרישות הבאות. בלי המפרטים האלה, השאילתות יסרקו את מסד הנתונים הטבלאי ולא ישתמשו בתוצאה המהותית.
-
current-snapshot-idcurrent-schema-idsnapshotssnapshot-log
-
-
parent-snapshot-id(אם זמין) schema-idoperation(בשדהsummary)
-
חלוקה למחיצות (של התצוגה המהותית המחולקת למחיצות)
תצוגות מהותיות מחולקות למחיצות
אפשר לחלק למחיצות תצוגות מהותיות בטבלאות מחולקות למחיצות. חלוקה למחיצות של תצוגה מהותית דומה לחלוקה למחיצות של טבלה רגילה, בכך שהיא מספקת יתרון כששאילתות ניגשות לעיתים קרובות לקבוצת משנה של המחיצות. בנוסף, חלוקה למחיצות של תצוגה מהותית יכולה לשפר את ההתנהגות של התצוגה כשמשנים או מוחקים נתונים בטבלה או בטבלאות מסד הנתונים הטבלאי. מידע נוסף זמין במאמר יישור מחיצות.
אם מסד הנתונים הטבלאי מחולק למחיצות, אפשר לחלק למחיצות גם את התצוגה המהותית באותה עמודת חלוקה למחיצות. במחיצות שמבוססות על זמן, רמת הפירוט חייבת להיות זהה (שעתית, יומית, חודשית או שנתית). במחיצות של טווח מספרים שלמים, מפרט הטווח חייב להיות זהה. אי אפשר לחלק תצוגה מהותית על מסד נתונים טבלאי שלא חולק.
אם מסד הנתונים הטבלאי מחולק למחיצות לפי זמן הטמעה, אפשר לקבץ את התצוגה המהותית לפי העמודה _PARTITIONDATE של מסד הנתונים הטבלאי, וגם לחלק אותה למחיצות לפי העמודה הזו.
אם לא מציינים במפורש חלוקה למחיצות כשיוצרים את התצוגה המהותית, היא לא מחולקת למחיצות.
אם מסד הנתונים הטבלאי מחולק למחיצות, כדאי לחלק למחיצות גם את התצוגה המהותית כדי להפחית את עלות התחזוקה של משימת הרענון ואת עלות השאילתה.
תפוגת התוקף של המחיצה
אי אפשר להגדיר תפוגת תוקף של מחיצות בתצוגות מהותיות. תצוגה מהותית יורשת באופן משתמע את זמן התפוגה של המחיצה מטבלת הבסיס. המחיצות של התצוגה המהותית תואמות למחיצות של מסד נתונים טבלאי, ולכן הן מסתיימות באופן סינכרוני.
דוגמה 1
בדוגמה הזו, מסד הנתונים הטבלאי מחולק למחיצות לפי העמודה transaction_time, עם מחיצות יומיות. התצוגה המהותית מחולקת למחיצות לפי אותה עמודה, ומקובצת לפי העמודה employee_id.
CREATE TABLE my_project.my_dataset.my_base_table(
  employee_id INT64,
  transaction_time TIMESTAMP)
  PARTITION BY DATE(transaction_time)
  OPTIONS (partition_expiration_days = 2);

CREATE MATERIALIZED VIEW my_project.my_dataset.my_mv_table
  PARTITION BY DATE(transaction_time)
  CLUSTER BY employee_id
AS (
  SELECT
    employee_id,
    transaction_time,
    COUNT(employee_id) AS cnt
  FROM
    my_dataset.my_base_table
  GROUP BY
    employee_id, transaction_time
);
דוגמה 2
בדוגמה הזו, מסד הנתונים הטבלאי מחולק למחיצות לפי זמן ההטמעה, עם מחיצות יומיות. התצוגה המהותית בוחרת את זמן הטמעת הנתונים כעמודה בשם date. התצוגה המהותית מקובצת לפי העמודה date ומחולקת למחיצות לפי אותה עמודה.
CREATE MATERIALIZED VIEW my_project.my_dataset.my_mv_table
  PARTITION BY date
  CLUSTER BY employee_id
AS (
  SELECT
    employee_id,
    _PARTITIONDATE AS date,
    COUNT(1) AS count
  FROM
    my_dataset.my_base_table
  GROUP BY
    employee_id,
    date
);
דוגמה 3
בדוגמה הזו, מסד הנתונים הטבלאי מחולק למחיצות לפי עמודת TIMESTAMP בשם transaction_time, עם מחיצות יומיות. התצוגה המהותית מגדירה עמודה בשם transaction_hour, באמצעות הפונקציה TIMESTAMP_TRUNC כדי לחתוך את הערך לשעה הקרובה. התצוגה המהותית מקובצת לפי transaction_hour וגם מחולקת למחיצות לפיו.
שימו לב לנקודות הבאות:
פונקציית החיתוך שמוחלת על עמודת החלוקה למחיצות צריכה להיות לפחות ברמת הפירוט של החלוקה למחיצות של מסד הנתונים הטבלאי. לדוגמה, אם מסד הנתונים הטבלאי משתמש במחיצות יומיות, פונקציית החיתוך לא יכולה להשתמש ברזולוציה של
MONTHאוYEAR.במפרט המחיצה של התצוגה המהותית, רמת הפירוט צריכה להתאים למסד הנתונים הטבלאי.
CREATE TABLE my_project.my_dataset.my_base_table (
  employee_id INT64,
  transaction_time TIMESTAMP)
  PARTITION BY DATE(transaction_time);

CREATE MATERIALIZED VIEW my_project.my_dataset.my_mv_table
  PARTITION BY DATE(transaction_hour)
AS (
  SELECT
    employee_id,
    TIMESTAMP_TRUNC(transaction_time, HOUR) AS transaction_hour,
    COUNT(employee_id) AS cnt
  FROM
    my_dataset.my_base_table
  GROUP BY
    employee_id,
    transaction_hour
);
תצוגות מהותיות של אשכולות
אפשר לאסוף באשכולות תצוגות מהותיות לפי עמודות הפלט שלהן, בכפוף למגבלות של טבלאות מסודרות באשכולות ב-BigQuery. אי אפשר להשתמש בעמודות פלט נצברות כעמודות אשכולות. הוספת עמודות אשכולות לתצוגות המהותיות יכולה לשפר את הביצועים של שאילתות שכוללות מסננים בעמודות האלה.
תצוגות לוגיות של קובצי עזר
כדי לבקש משוב או תמיכה לגבי התכונה הזו, שלחו אימייל לכתובת bq-mv-help@google.com.
שאילתות של תצוגות מהותיות יכולות להפנות לתצוגות לוגיות, אבל כפופות למגבלות הבאות:
- חלות מגבלות על תצוגות מהותיות.
- אם התצוגה הלוגית משתנה, התצוגה המהותית הופכת ללא חוקית וצריך לרענן אותה באופן מלא.
- אין תמיכה בכוונון חכם.
שיטות מומלצות ליצירת תצוגות מהותיות
כדאי לפעול לפי השיטות המומלצות הבאות כשיוצרים תצוגות מהותיות.
אילו תצוגות מהותיות כדאי ליצור
כשיוצרים תצוגה מהותית, חשוב לוודא שההגדרה שלה משקפת את מבני השאילתות מול מסדי הנתונים הטבלאיים. תצוגות מהותיות יעילות יותר כשהן משמשות לקבוצה רחבה של שאילתות, ולא רק למבנה שאילתה ספציפי אחד.
לדוגמה, נניח שיש שאילתה בטבלה שבה המשתמשים מסננים לעיתים קרובות לפי העמודות user_id או department. אפשר לקבץ לפי העמודות האלה, ואם רוצים גם לאשכול לפיהן, במקום להוסיף מסננים כמו user_id = 123 לתצוגה המהותית.
דוגמה נוספת: אתם יכולים להשתמש במסנני תאריכים דטרמיניסטיים, לפי תאריך ספציפי, כמו WHERE order_date = '2019-10-01', או לפי טווח תאריכים, כמו WHERE order_date BETWEEN '2019-10-01' AND '2019-10-31'. מוסיפים מסנן של טווח תאריכים בתצוגה המהותית, שמכסה את טווחי התאריכים הצפויים בשאילתה:
CREATE MATERIALIZED VIEW ...
  ...
  WHERE date > '2019-01-01'
  GROUP BY date
פעולות JOIN בתצוגות מהותיות
ההמלצות הבאות רלוונטיות לתצוגות מהותיות עם הצהרות JOIN.
הטבלה שמשתנה הכי הרבה צריכה להיות הראשונה
מוודאים שהטבלה הגדולה ביותר או הטבלה שמשתנה בתדירות הגבוהה ביותר היא הטבלה הראשונה או השמאלית ביותר שאליה מפנה השאילתה של התצוגה. תצוגות מהותיות עם צירופים תומכות בשאילתות מצטברות וברענון כשמתווספת הטבלה הראשונה או השמאלית ביותר בשאילתה, אבל שינויים בטבלאות אחרות מבטלים לחלוטין את המטמון של התצוגה. בסכימות כוכב או פתית שלג, הטבלה הראשונה או השמאלית ביותר צריכה להיות בדרך כלל טבלת העובדות.
הימנעות מצירוף במפתחות אשכולות
תצוגות מהותיות עם איחודים פועלות בצורה הטובה ביותר במקרים שבהם הנתונים נצברים בכמות גדולה, או כששאילתת האיחוד המקורית יקרה. בשאילתות סלקטיביות, BigQuery בדרך כלל כבר יכול לבצע את הצירוף ביעילות, ואין צורך בתצוגה מהותית. לדוגמה, נבחן את ההגדרות הבאות של תצוגות מהותיות.
CREATE MATERIALIZED VIEW dataset.mv
  CLUSTER BY s_market_id
AS (
  SELECT
    s_market_id,
    s_country,
    SUM(ss_net_paid) AS sum_sales,
    COUNT(*) AS cnt_sales
  FROM dataset.store_sales
  INNER JOIN dataset.store
    ON ss_store_sk = s_store_sk
  GROUP BY s_market_id, s_country
);
נניח שהטבלה store_sales מקובצת לפי ss_store_sk, ולעיתים קרובות אתם מריצים שאילתות כמו:
SELECT
  SUM(ss_net_paid)
FROM dataset.store_sales
INNER JOIN dataset.store
ON ss_store_sk = s_store_sk
WHERE s_country = 'Germany';
יכול להיות שהתצוגה המהותית לא תהיה יעילה כמו השאילתה המקורית. כדי לקבל את התוצאות הטובות ביותר, כדאי להתנסות עם קבוצה מייצגת של שאילתות, עם ובלי התצוגה המהותית.
שימוש בתצוגות מהותיות עם האפשרות max_staleness
האפשרות של תצוגה מהותית ב-max_staleness עוזרת להשיג ביצועי שאילתות גבוהים באופן עקבי, עם עלויות מבוקרות, כשמעבדים מערכי נתונים גדולים שמשתנים לעיתים קרובות. הפרמטר max_staleness מאפשר להגדיר את מרווח הזמן שבו תוצאות השאילתה יכולות להיות לא עדכניות, וכך להפחית את העלות ואת זמן האחזור של השאילתות. ההתנהגות הזו יכולה להועיל למרכזי בקרה ולדוחות שבהם תוצאות שאילתה עדכניות לחלוטין אינן חיוניות.
נתונים לא עדכניים
כששולחים שאילתה לתצוגה מהותית עם האפשרות max_staleness, BigQuery מחזיר את התוצאה על סמך הערך של max_staleness והזמן שבו בוצע הרענון האחרון.
אם הרענון האחרון התרחש בתוך המרווח של max_staleness, אז BigQuery מחזיר נתונים ישירות מהתצוגה המהותית בלי לקרוא את מסדי הנתונים הטבלאיים. לדוגמה, אם המרווח של max_staleness הוא 4 שעות, והרענון האחרון התרחש לפני שעתיים.
אם הרענון האחרון התרחש מחוץ למרווח הזמן של max_staleness, BigQuery קורא את הנתונים מהתצוגה המהותית, משלב אותם עם השינויים במסד הנתונים הטבלאי מאז הרענון האחרון ומחזיר את התוצאה המשולבת. יכול להיות שהתוצאה המשולבת הזו עדיין לא תהיה עדכנית, בהתאם למרווח הזמן של max_staleness. לדוגמה, אם המרווח של max_staleness הוא 4 שעות, והרענון האחרון התרחש לפני 7 שעות.
האפשרות "יצירה באמצעות max_staleness"
בוחרים באחת מהאפשרויות הבאות:
SQL
כדי ליצור תצוגה מהותית עם האפשרות max_staleness, מוסיפים משפט OPTIONS להצהרת ה-DDL כשיוצרים את התצוגה המהותית:
נכנסים לדף BigQuery במסוף Google Cloud .
בעורך השאילתות, מזינים את ההצהרה הבאה:
CREATE MATERIALIZED VIEW
project-id.my_dataset.my_mv_tableOPTIONS (enable_refresh = true, refresh_interval_minutes = 60, max_staleness = INTERVAL "4:0:0" HOUR TO SECOND) AS SELECT employee_id, DATE(transaction_time), COUNT(1) AS count FROMmy_dataset.my_base_tableGROUP BY 1, 2;מחליפים את מה שכתוב בשדות הבאים:
- project-id הוא מזהה הפרויקט.
- my_dataset הוא המזהה של מערך נתונים בפרויקט.
- my_mv_table הוא המזהה של התצוגה המהותית שאתם יוצרים.
- my_base_table הוא המזהה של טבלה במערך הנתונים שמשמשת כמסד הנתונים הטבלאי של התצוגה המהותית.
לוחצים על הפעלה.
מידע נוסף על הרצת שאילתות זמין במאמר הרצת שאילתה אינטראקטיבית.
API
מפעילים את השיטה tables.insert עם משאב materializedView מוגדר כחלק מבקשת ה-API. המשאב materializedView מכיל את השדה query. לדוגמה:
{
  "kind": "bigquery#table",
  "tableReference": {
    "projectId": "project-id",
    "datasetId": "my_dataset",
    "tableId": "my_mv_table"
  },
  "materializedView": {
    "query": "select product_id,sum(clicks) as
                sum_clicks from project-id.my_dataset.my_base_table
                group by 1"
  }
  "maxStaleness": "4:0:0"
}
מחליפים את מה שכתוב בשדות הבאים:
- project-id הוא מזהה הפרויקט.
- my_dataset הוא המזהה של מערך נתונים בפרויקט.
- my_mv_table הוא המזהה של התצוגה המהותית שאתם יוצרים.
- my_base_table הוא המזהה של טבלה במערך הנתונים שמשמשת כמסד הנתונים הטבלאי של התצוגה המהותית.
-
product_idהיא עמודה ממסד הנתונים הטבלאי. -
clicksהיא עמודה ממסד הנתונים הטבלאי. -
sum_clicksהיא עמודה בתצוגה המהותית שאתם יוצרים.
החלת האפשרות max_staleness
אפשר להחיל את הפרמטר הזה על תצוגות מהותיות קיימות באמצעות ההצהרה ALTER
MATERIALIZED VIEW. לדוגמה:
ALTER MATERIALIZED VIEW project-id.my_dataset.my_mv_table SET OPTIONS (enable_refresh = true, refresh_interval_minutes = 120, max_staleness = INTERVAL "8:0:0" HOUR TO SECOND);
שאילתה עם max_staleness
אתם יכולים להריץ שאילתות על תצוגות מהותיות עם האפשרות max_staleness, כמו שמריצים שאילתות על כל תצוגה מהותית, תצוגה לוגית או טבלה אחרת.
לדוגמה:
SELECT * FROM project-id.my_dataset.my_mv_table
השאילתה הזו מחזירה נתונים מהרענון האחרון אם הנתונים לא ישנים יותר מהפרמטר max_staleness. אם התצוגה המהותית לא רועננה בתוך המרווח של max_staleness, BigQuery ממזג את התוצאות של הרענון הזמין האחרון עם השינויים במסד נתונים טבלאי כדי להחזיר תוצאות בתוך המרווח של max_staleness.
סטרימינג של נתונים ותוצאות של max_staleness
אם אתם מעבירים נתונים בסטרימינג למסדי הנתונים הטבלאיים של תצוגה מהותית עם האפשרות max_staleness, יכול להיות שהשאילתה של התצוגה המהותית לא תכלול רשומות שהועברו בסטרימינג לטבלאות שלה לפני תחילת מרווח הזמן של הנתונים הישנים. כתוצאה מכך, יכול להיות שתצוגה מהותית שכוללת נתונים מכמה טבלאות ואת האפשרות max_staleness לא תייצג תמונת מצב של הטבלאות האלה בנקודת זמן מסוימת.
מגבלות על נתונים בסטרימינג ועל Time Travel
למערכי הנתונים ב-BigQuery יש חלון זמן נסיעה של 7 ימים כברירת מחדל, אבל מאגר האחסון של הסטרימינג שומר את הנתונים רק למשך 3 ימים. זה יוצר את המגבלה הבאה לתצוגות מהותיות:
כשל בשאילתה: אם בתצוגה המהותית מוגדרת האפשרות
max_stalenessוהיא לא רועננה במשך יותר מ-3 ימים, השאילתות בתצוגה נכשלות ומוצגת הודעת השגיאהStreaming data from <materialized_view_name> is temporarily unavailable.הסיבה: הכשל מתרחש כי תהליך הכתיבה מחדש של השאילתה מנסה לקרוא שינויים מצטברים (דלתות) ממאגר האחסון של הסטרימינג. אם הנתונים הנדרשים ישנים יותר מתקופת השמירה של 3 ימים, המערכת לא יכולה לאחזר את השינויים שנדרשים לשכתוב המצטבר.
כדי להימנע מהשגיאות האלה, ודאו שמדיניות הרענון מעדכנת את התצוגה המהותית לפחות פעם ב-3 ימים.
כוונון חכם והאפשרות max_staleness
הכוונון החכם משכתב באופן אוטומטי שאילתות כדי להשתמש בתצוגות מהותיות כשאפשר, בלי קשר לאפשרות max_staleness, גם אם השאילתה לא מפנה לתצוגה מהותית. האפשרות max_staleness בתצוגה המהותית לא משפיעה על התוצאות של השאילתה שנכתבה מחדש. האפשרות max_staleness משפיעה רק על שאילתות ששולחות שאילתה ישירות לתצוגה המהותית.
ניהול של תדירות הרענון והתיישנות הנתונים
צריך להגדיר את max_staleness בהתאם לדרישות שלכם. כדי להימנע מקריאת נתונים ממסדי נתונים טבלאיים, צריך להגדיר את מרווח הרענון כך שהרענון יתבצע בתוך מרווח הזמן של הנתונים הישנים. אתם יכולים להביא בחשבון את זמן הריצה הממוצע של הרענון, בתוספת מרווח לצמיחה.
לדוגמה, אם נדרשת שעה אחת כדי לרענן את התצוגה המהותית ואתם רוצים מאגר של שעה אחת לצמיחה, צריך להגדיר את מרווח הרענון לשעתיים. ההגדרה הזו מבטיחה שהרענון יתבצע בתוך ארבע שעות לכל היותר, כדי שהנתונים בדוח לא יהיו מיושנים.
CREATE MATERIALIZED VIEW project-id.my_dataset.my_mv_table
OPTIONS (enable_refresh = true, refresh_interval_minutes = 120, max_staleness =
INTERVAL "4:0:0" HOUR TO SECOND)
AS SELECT
  employee_id,
  DATE(transaction_time),
  COUNT(1) AS cnt
FROM my_dataset.my_base_table
GROUP BY 1, 2;
תצוגות מהותיות לא מצטברות
תצוגות מהותיות לא מצטברות תומכות ברוב שאילתות ה-SQL, כולל סעיפי OUTER
JOIN, UNION ו-HAVING ופונקציות ניתוח. כדי לבדוק אם נעשה שימוש בתצוגה מהותית בשאילתה, בודקים את הערכות העלות באמצעות הרצה יבשה.
בתרחישים שבהם אפשר להשתמש בנתונים לא עדכניים, למשל בעיבוד נתונים באצווה או בדיווח, תצוגות מהותיות לא מצטברות יכולות לשפר את ביצועי השאילתות ולהפחית את העלות. באמצעות האפשרות max_staleness, אתם יכולים ליצור תצוגות מהותיות מורכבות ושרירותיות שמתוחזקות באופן אוטומטי, וכוללות מגבלות מובנות על התיישנות.
שימוש בתצוגות מהותיות לא מצטברות
אפשר ליצור תצוגות מהותיות לא מצטברות באמצעות האפשרות allow_non_incremental_definition. צריך להוסיף לאפשרות הזו את האפשרות max_staleness. כדי להבטיח רענון תקופתי של התצוגה המהותית, צריך גם להגדיר מדיניות רענון.
אם לא מגדירים מדיניות רענון, צריך לרענן את התצוגה המהותית באופן ידני.
התצוגה המהותית תמיד מייצגת את המצב של מסד נתונים טבלאי בתוך המרווח של max_staleness. אם הרענון האחרון ישן מדי ולא מייצג את מסדי הנתונים הטבלאיים במרווח הזמן של max_staleness, השאילתה קוראת את מסדי הנתונים הטבלאיים. למידע נוסף על השלכות אפשריות על הביצועים, ראו נתונים לא עדכניים.
יצירה באמצעות allow_non_incremental_definition
כדי ליצור תצוגה מהותית עם האפשרות allow_non_incremental_definition, פועלים לפי השלבים הבאים. אחרי שיוצרים את התצוגה המהותית, אי אפשר לשנות את האפשרות allow_non_incremental_definition. לדוגמה, אי אפשר לשנות את הערך true ל-false, או להסיר את האפשרות allow_non_incremental_definition מהתצוגה המהותית.
SQL
מוסיפים משפט OPTIONS להצהרת ה-DDL כשיוצרים את התצוגה המהותית:
נכנסים לדף BigQuery במסוף Google Cloud .
בעורך השאילתות, מזינים את ההצהרה הבאה:
CREATE MATERIALIZED VIEW my_project.my_dataset.my_mv_table OPTIONS ( enable_refresh = true, refresh_interval_minutes = 60, max_staleness = INTERVAL "4" HOUR, allow_non_incremental_definition = true) AS
SELECTs_store_sk, SUM(ss_net_paid) AS sum_sales, APPROX_QUANTILES(ss_net_paid, 2)[safe_offset(1)] median FROM my_project.my_dataset.store LEFT OUTER JOIN my_project.my_dataset.store_sales ON ss_store_sk = s_store_sk GROUP BY s_store_sk HAVING median < 40 OR median is NULL ;מחליפים את מה שכתוב בשדות הבאים:
- my_project הוא מזהה הפרויקט.
- my_dataset הוא המזהה של מערך נתונים בפרויקט.
- my_mv_table הוא המזהה של התצוגה המהותית שאתם יוצרים.
- my_dataset.store ו-my_dataset.store_sales הם המזהים של הטבלאות במערך הנתונים, שמשמשות כמסדי הנתונים הטבלאיים של התצוגה המהותית.
לוחצים על הפעלה.
מידע נוסף על הרצת שאילתות זמין במאמר הרצת שאילתה אינטראקטיבית.
API
מפעילים את השיטה tables.insert עם משאב materializedView מוגדר כחלק מבקשת ה-API. המשאב materializedView מכיל את השדה query. לדוגמה:
{
  "kind": "bigquery#table",
  "tableReference": {
    "projectId": "my_project",
    "datasetId": "my_dataset",
    "tableId": "my_mv_table"
  },
  "materializedView": {
    "query": "`SELECT`
        s_store_sk,
        SUM(ss_net_paid) AS sum_sales,
        APPROX_QUANTILES(ss_net_paid, 2)[safe_offset(1)] median
      FROM my_project.my_dataset.store
      LEFT OUTER JOIN my_project.my_dataset.store_sales
        ON ss_store_sk = s_store_sk
      GROUP BY s_store_sk
      HAVING median < 40 OR median is NULL`",
    "allowNonIncrementalDefinition": true
  }
  "maxStaleness": "4:0:0"
}
מחליפים את מה שכתוב בשדות הבאים:
- my_project הוא מזהה הפרויקט.
- my_dataset הוא המזהה של מערך נתונים בפרויקט.
- my_mv_table הוא המזהה של התצוגה המהותית שאתם יוצרים.
- my_dataset.store ו-my_dataset.store_sales הם המזהים של הטבלאות במערך הנתונים שמשמשות כמסדי הנתונים הטבלאיים של התצוגה המהותית.
יצירת תצוגות מהותיות על מערכי נתונים חיצוניים של Spanner
לפני שממשיכים, צריך ליצור את מערך הנתונים החיצוני הבסיסי של Spanner באמצעות חיבור CLOUD_RESOURCE.
אתם יכולים ליצור תצוגות מהותיות לא מצטברות שמפנות לטבלאות של מערכי נתונים חיצוניים ב-Spanner באמצעות האפשרות allow_non_incremental_definition.
בדוגמה הבאה נעשה שימוש בטבלה בסיסית של מערך נתונים חיצוני ב-Spanner:
/*
  You must create the spanner_external_dataset with a CLOUD_RESOURCE connection.
*/
CREATE MATERIALIZED VIEW sample_dataset.sample_spanner_mv
  OPTIONS (
      enable_refresh = true, refresh_interval_minutes = 60,
      max_staleness = INTERVAL "24" HOUR,
        allow_non_incremental_definition = true)
AS
  SELECT COUNT(*) cnt FROM spanner_external_dataset.spanner_table;
שאילתה עם allow_non_incremental_definition
אתם יכולים לשלוח שאילתות לתצוגות מהותיות לא מצטברות כמו שאתם שולחים שאילתות לכל תצוגה מהותית, תצוגה לוגית או טבלה אחרת.
לדוגמה:
SELECT * FROM my_project.my_dataset.my_mv_table
אם הנתונים לא ישנים יותר מהפרמטר max_staleness, השאילתה הזו מחזירה נתונים מהרענון האחרון. לפרטים על עדכניות הנתונים, ראו עדכניות הנתונים.
מגבלות ספציפיות לתצוגות מהותיות לא מצטברות
המגבלות הבאות חלות רק על תצוגות מהותיות עם האפשרות allow_non_incremental_definition. כל המגבלות של תצוגות מהותיות עדיין חלות, למעט המגבלות על תחביר השאילתות הנתמך.
- הכוונון החכם לא חל על תצוגות מהותיות שכוללות את האפשרות
allow_non_incremental_definition. הדרך היחידה להפיק תועלת מתצוגות מהותיות עם האפשרותallow_non_incremental_definitionהיא לשלוח אליהן שאילתות ישירות. - בתצוגות מהותיות בלי האפשרות
allow_non_incremental_definition, אפשר לרענן באופן מצטבר קבוצת משנה של הנתונים. תצוגות מהותיות עם האפשרותallow_non_incremental_definitionצריך לרענן באופן מלא. - תצוגות מהותיות עם האפשרות
max_stalenessמאמתות את הנוכחות של אילוצי האבטחה ברמת העמודה במהלך הרצת השאילתה. מידע נוסף על בקרת גישה ברמת העמודה - בתצוגות מהותיות של טבלאות של מערכי נתונים חיצוניים ב-Spanner, אם הרענון האחרון של תצוגה מהותית לא מצטברת התרחש מחוץ למרווח הזמן של
max_staleness, השאילתות קוראות את טבלאות מערכי הנתונים החיצוניים הבסיסיות ב-Spanner, גם אם טבלת הבסיס לא השתנתה. לדוגמה, אם המרווח שלmax_stalenessהוא 4 שעות והרענון האחרון התרחש לפני 7 שעות, השאילתה תקרא את טבלאות מערך הנתונים החיצוניות הבסיסיות של Spanner.