


本頁面說明如何使用 AutoSxS 執行以模型為基礎的逐對評估。AutoSxS 是一項工具,可透過評估管道服務執行。我們將說明如何透過 Agent Platform API、Agent Platform SDK for Python 或 Google Cloud 控制台使用 AutoSxS。
AutoSxS
自動並排比較 (AutoSxS) 是以模型為基礎的成對評估工具,可透過評估 pipeline 服務執行。AutoSxS 可用於評估 Gemini Enterprise Agent Platform Model Registry 中生成式 AI 模型的效能,或預先生成的預測結果,因此可支援 Gemini Enterprise Agent Platform 基礎模型、經過調整的生成式 AI 模型,以及第三方語言模型。AutoSxS 會使用自動評分器,判斷哪個模型對提示詞的回覆較佳。這項服務可隨選使用,評估語言模型的成效與人工評估人員相當。
自動評分工具
概略來說,這張圖表顯示 AutoSxS 如何使用第三個模型 (自動評估工具),比較模型 A 和 B 的預測結果。
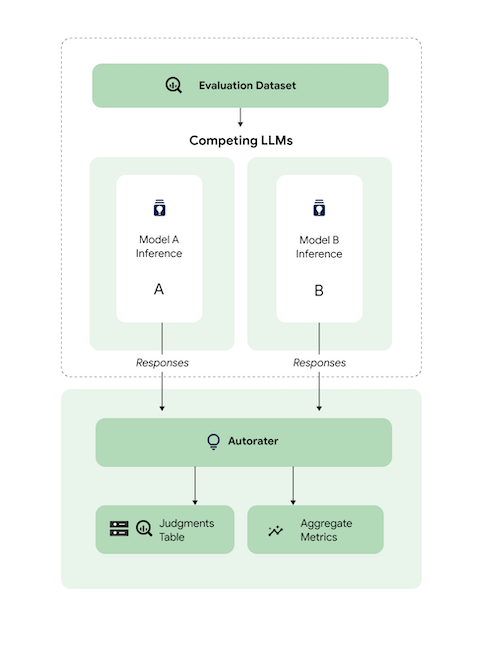
模型 A 和 B 收到輸入提示後,各自生成回覆並傳送至自動評分工具。自動評估工具與真人評估員類似,是一種語言模型,可根據原始推論提示判斷模型回覆的品質。使用 AutoSxS 時,自動評分工具會根據推論指令,使用一組條件比較兩個模型的回覆品質。系統會根據這些條件,比較模型 A 和模型 B 的結果,判斷哪個模型表現最佳。自動評分工具會將回覆偏好設定輸出為匯總指標,並輸出每個樣本的偏好設定說明和可信度分數。詳情請參閱判斷表。
支援的模型
只要提供預先生成的預測結果,AutoSxS 就能評估任何模型。AutoSxS 也支援為 Gemini Enterprise Agent Platform Model Registry 中,支援 Gemini Enterprise Agent Platform 批次預測的任何模型自動生成回覆。
如果 Gemini Enterprise Agent Platform Model Registry 不支援您的文字模型,AutoSxS 也接受以 JSONL 格式儲存在 Cloud Storage 或 BigQuery 資料表中的預先生成預測結果。如要瞭解定價,請參閱「文字生成」。
支援的工作與條件
AutoSxS 支援評估摘要和問答工作的模型。每項工作都有預先定義的評估條件,可讓語言評估更客觀,並提升回覆品質。
評分標準會依工作列出。
重點摘要
summarization 工作的輸入詞元上限為 4,096 個。
summarization 的評估條件如下:
| 條件 | |
|---|---|
| 1. 遵循指示 | 模型的回覆在多大程度上展現出對提示指令的理解? |
| 2. 有依據 | 回覆是否僅包含推論背景資訊和推論指示中的資訊? |
| 3. 完整詳盡 | 模型在摘要中擷取重要細節的程度為何? |
| 4. 簡短 | 摘要是否過於冗長?是否含有華麗的詞藻?是否過於簡短? |
問答
question_answering 任務的輸入詞元限制為 4,096 個。
question_answering 的評估條件如下:
| 條件 | |
|---|---|
| 1. 完整回答問題 | 答案完整回答問題。 |
| 2. 有依據 | 回覆是否僅包含指令背景資訊和推論指令中的資訊? |
| 3. 關聯性 | 答案內容是否與問題相關? |
| 4. 完整詳盡 | 模型在多大程度上擷取了問題中的重要細節? |
準備 AutoSxS 的評估資料集
本節將詳細說明您應在 AutoSxS 評估資料集中提供的資料,以及建構資料集的最佳做法。範例應反映模型在實際工作環境中可能遇到的真實輸入內容,並盡可能對比實際模型的行為。
資料集格式
AutoSxS 接受單一評估資料集,且結構定義可彈性調整。資料集可以是 BigQuery 資料表,也可以儲存在 Cloud Storage,格式為 JSON Lines。
評估資料集的每一列代表一個樣本,資料欄則為下列其中一項:
- ID 欄:用於識別各個不重複的樣本。
- 資料欄:用於填寫提示詞範本。請參閱「提示參數」
- 預先生成的預測結果:由相同模型使用相同提示生成的預測結果。使用預先產生的預測結果,可節省時間和資源。
- 基準真相人類偏好:如果兩個模型都提供預先產生的預測,則用於根據基準真相偏好資料設定 AutoSxS 基準。
以下是評估資料集範例,其中 context 和 question 是資料欄,model_b_response 則包含預先生成的預測。
context |
question |
model_b_response |
|---|---|---|
| 有些人可能認為鋼或鈦是最堅硬的材料,但其實鑽石才是。 | 最堅硬的材質是什麼? | 鑽石是硬度最高的材料,硬度高於鋼或鈦。 |
如要進一步瞭解如何呼叫 AutoSxS,請參閱「執行模型評估」。如要進一步瞭解權杖長度,請參閱「支援的工作和條件」。如要將資料上傳至 Cloud Storage,請參閱「將評估資料集上傳至 Cloud Storage」。
提示參數
許多語言模型會將提示參數做為輸入內容,而非單一提示字串。舉例來說,chat-bison 接受多個提示參數 (messages、examples、context),這些參數會構成提示的一部分。不過,text-bison 只有一個提示參數,名為 prompt,其中包含整個提示。
我們會說明如何在推論和評估時,靈活指定模型提示詞參數。AutoSxS 可讓您透過範本化提示參數,彈性呼叫具有不同預期輸入內容的語言模型。
推論
如果任何模型沒有預先生成的預測,AutoSxS 會使用 Gemini Enterprise Agent Platform 批次預測生成回覆。必須指定每個模型的提示參數。
在 AutoSxS 中,您可以將評估資料集中的單一資料欄做為提示參數。
{'some_parameter': {'column': 'my_column'}}
或者,您也可以定義範本,並使用評估資料集的資料欄做為變數,指定提示參數:
{'some_parameter': {'template': 'Summarize the following: {{ my_column }}.'}}
提供模型提示詞參數進行推論時,使用者可以使用受保護的 default_instruction 關鍵字做為範本引數,系統會將其替換為指定任務的預設推論指令:
model_prompt_parameters = {
        'prompt': {'template': '{{ default_instruction }}: {{ context }}'},
}
如要生成預測結果,請提供模型提示參數和輸出資料欄。請參閱以下例子:
Gemini
如果是 Gemini 模型,模型提示參數的鍵為 contents (必要) 和 system_instruction (選用),與 Gemini 要求主體結構定義一致。
model_a_prompt_parameters={
    'contents': {
        'column': 'context'
    },
    'system_instruction': {'template': '{{ default_instruction }}'},
},
text-bison
舉例來說,text-bison 使用「prompt」做為輸入內容,並使用「content」做為輸出內容。步驟如下:
- 找出待評估模型所需的輸入和輸出內容。
- 將輸入內容定義為模型提示詞參數。
- 將輸出內容傳遞至回應欄。
model_a_prompt_parameters={
    'prompt': {
        'template': {
            'Answer the following question from the point of view of a college professor: {{ context }}\n{{ question }}'
        },
    },
},
response_column_a='content',  # Column in Model A response.
response_column_b='model_b_response',  # Column in eval dataset.
評估
就像您必須提供推論的提示參數一樣,您也必須提供評估的提示參數。自動評分工具需要下列提示參數:
| 自動評分工具提示詞參數 | 使用者是否可設定? | 說明 | 範例 |
|---|---|---|---|
| 自動評分工具指令 | 否 | 校正後的指令,說明自動評分器應依據哪些條件判斷指定回覆。 | 請選出能回答問題且最符合指示的回覆。 |
| 推論指令 | 是 | 各候選模型應執行工作的說明。 | 正確回答此問題:下列哪一個是最硬的材質? |
| 推論背景資訊 | 是 | 執行中工作的額外脈絡資訊。 | 雖然鈦和鑽石都比銅還要硬,但鑽石的硬度評分是 98,而鈦是 36。評分較高表示硬度較高。 |
| 回應 | 否1 | 一組要評估的回覆,分別來自兩個候選模型。 | 菱形 |
1您只能透過預先產生的回覆設定提示參數。
使用參數的程式碼範例:
autorater_prompt_parameters={
    'inference_instruction': {
        'template': 'Answer the following question from the point of view of a college professor: {{ question }}.'
    },
    'inference_context': {
        'column': 'context'
    }
}
無論是否提供相同資訊,模型 A 和 B 的推論指令和情境格式都可以不同。也就是說,自動評估工具會採用獨立但單一的推論指令和背景資訊。
評估資料集範例
本節提供問答工作評估資料集的範例,包括預先產生的模型 B 預測。在這個範例中,AutoSxS 只會對模型 A 執行推論。我們提供 id 欄,用於區分問題和背景資訊相同的樣本。
{
  "id": 1,
  "question": "What is the hardest material?",
  "context": "Some might think that steel is the hardest material, or even titanium. However, diamond is actually the hardest material.",
  "model_b_response": "Diamond is the hardest material. It is harder than steel or titanium."
}
{
  "id": 2,
  "question": "What is the highest mountain in the world?",
  "context": "K2 and Everest are the two tallest mountains, with K2 being just over 28k feet and Everest being 29k feet tall.",
  "model_b_response": "Mount Everest is the tallest mountain, with a height of 29k feet."
}
{
  "id": 3,
  "question": "Who directed The Godfather?",
  "context": "Mario Puzo and Francis Ford Coppola co-wrote the screenplay for The Godfather, and the latter directed it as well.",
  "model_b_response": "Francis Ford Coppola directed The Godfather."
}
{
  "id": 4,
  "question": "Who directed The Godfather?",
  "context": "Mario Puzo and Francis Ford Coppola co-wrote the screenplay for The Godfather, and the latter directed it as well.",
  "model_b_response": "John Smith."
}
最佳做法
定義評估資料集時,請遵循下列最佳做法:
- 提供範例,說明模型在正式環境中處理的輸入類型。
- 資料集必須至少包含一個評估範例。建議您提供約 100 個範例,確保匯總指標品質良好。如果提供的樣本超過 400 個,匯總指標品質的提升速度往往會降低。
- 如需提示詞撰寫指南,請參閱「設計文字提示詞」。
- 如果您為任一模型使用預先產生的預測,請將預先產生的預測加入評估資料集的資料欄。提供預先產生的預測結果相當實用,因為您可以比較不在 Vertex Model Registry 中的模型輸出內容,並重複使用回覆。
評估模型
您可以使用 REST API、Agent Platform SDK for Python 或Google Cloud 控制台評估模型。
請使用下列語法指定模型路徑:
- 發布端模型:
publishers/PUBLISHER/models/MODEL範例:publishers/google/models/text-bison 調整後的模型:
projects/PROJECT_NUMBER/locations/LOCATION/models/MODEL@VERSION範例:projects/123456789012/locations/us-central1/models/1234567890123456789
REST
如要建立模型評估工作,請使用 pipelineJobs 方法傳送 POST 要求。
使用任何要求資料之前,請先替換下列項目:
- PIPELINEJOB_DISPLAYNAME:
pipelineJob的顯示名稱。 - PROJECT_ID:執行 pipeline 元件的 Google Cloud 專案。
- LOCATION:執行管道元件的區域。支援
us-central1。 - OUTPUT_DIR:用於儲存評估輸出的 Cloud Storage URI。
- EVALUATION_DATASET:BigQuery 資料表,或以逗號分隔的 Cloud Storage 路徑清單,指向含有評估樣本的 JSONL 資料集。
- TASK:評估工作,可以是
[summarization, question_answering]的其中一項。 - ID_COLUMNS:區分不重複評估樣本的資料欄。
- AUTORATER_PROMPT_PARAMETERS:對應至資料欄或範本的自動評分提示參數。預期參數為:
inference_instruction(執行任務的詳細說明) 和inference_context(執行任務時要參考的內容)。舉例來說,{'inference_context': {'column': 'my_prompt'}}會使用評估資料集的「my_prompt」資料欄,做為自動評分工具的背景資訊。 - RESPONSE_COLUMN_A:含有預先定義預測資料的評估用資料集內的資料欄名稱,或含有預測資料的模型 A 輸出內容中的資料欄名稱。如未提供任何值,系統會嘗試推論出正確的模型輸出內容資料欄名稱。
- RESPONSE_COLUMN_B:含有預先定義預測資料的評估用資料集內的資料欄名稱,或含有預測資料的模型 B 輸出內容中的資料欄名稱。如未提供任何值,系統會嘗試推論出正確的模型輸出內容資料欄名稱。
- MODEL_A (選用):完整模型資源名稱 (
projects/{project}/locations/{location}/models/{model}@{version}) 或發布者模型資源名稱 (publishers/{publisher}/models/{model})。如果指定了模型 A 回覆,則不應提供這個參數。 - MODEL_B (選用):完整模型資源名稱 (
projects/{project}/locations/{location}/models/{model}@{version}) 或發布者模型資源名稱 (publishers/{publisher}/models/{model})。如果指定了模型 B 回覆,則不應提供這個參數。 - MODEL_A_PROMPT_PARAMETERS (選用):模型 A 的提示詞範本參數,對應至資料欄或範本。如果模型 A 的回覆是預先定義,則不應提供這個參數。範例:
{'prompt': {'column': 'my_prompt'}}會使用評估資料集的my_prompt欄,做為名為prompt的提示參數。 - MODEL_B_PROMPT_PARAMETERS (選用):模型 B 的提示詞範本參數,對應至資料欄或範本。如果模型 B 的回覆是預先定義,則不應提供這個參數。範例:
{'prompt': {'column': 'my_prompt'}}會使用評估資料集的my_prompt欄,做為名為prompt的提示參數。 - JUDGMENTS_FORMAT
(選用):寫入判斷結果的格式。可以是
jsonl(預設值)、json或bigquery。 - BIGQUERY_DESTINATION_PREFIX:如果指定格式為
bigquery,則為要寫入判斷結果的 BigQuery 資料表。
JSON 要求主體
  {
    "displayName": "PIPELINEJOB_DISPLAYNAME",
    "runtimeConfig": {
        "gcsOutputDirectory": "gs://OUTPUT_DIR",
        "parameterValues": {
            "evaluation_dataset": "EVALUATION_DATASET",
            "id_columns": ["ID_COLUMNS"],
            "task": "TASK",
            "autorater_prompt_parameters": AUTORATER_PROMPT_PARAMETERS,
            "response_column_a": "RESPONSE_COLUMN_A",
            "response_column_b": "RESPONSE_COLUMN_B",
            "model_a": "MODEL_A",
            "model_a_prompt_parameters": MODEL_A_PROMPT_PARAMETERS,
            "model_b": "MODEL_B",
            "model_b_prompt_parameters": MODEL_B_PROMPT_PARAMETERS,
            "judgments_format": "JUDGMENTS_FORMAT",
            "bigquery_destination_prefix":BIGQUERY_DESTINATION_PREFIX,
        },
    },
    "templateUri": "https://us-kfp.pkg.dev/ml-pipeline/google-cloud-registry/autosxs-template/default"
  }
使用 curl 傳送要求。
curl -X POST \
    -H "Authorization: Bearer $(gcloud auth print-access-token)" \
    -H "Content-Type: application/json; charset=utf-8" \
    -d @request.json \
    "https://LOCATION-aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/LOCATION/pipelineJobs"
回應
  "state": "PIPELINE_STATE_PENDING",
  "labels": {
    "vertex-ai-pipelines-run-billing-id": "1234567890123456789"
  },
  "runtimeConfig": {
    "gcsOutputDirectory": "gs://my-evaluation-bucket/output",
    "parameterValues": {
      "evaluation_dataset": "gs://my-evaluation-bucket/output/data.json",
      "id_columns": [
        "context"
      ],
      "task": "question_answering",
      "autorater_prompt_parameters": {
        "inference_instruction": {
          "template": "Answer the following question: {{ question }} }."
        },
        "inference_context": {
          "column": "context"
        }
      },
      "response_column_a": "",
      "response_column_b": "response_b",
      "model_a": "publishers/google/models/text-bison@002",
      "model_a_prompt_parameters": {
        "prompt": {
          "template": "Answer the following question from the point of view of a college professor: {{ question }}\n{{ context }} }"
        }
      },
      "model_b": "",
      "model_b_prompt_parameters": {}
    }
  },
  "serviceAccount": "123456789012-compute@developer.gserviceaccount.com",
  "templateUri": "https://us-kfp.pkg.dev/ml-pipeline/google-cloud-registry/autosxs-template/default",
  "templateMetadata": {
    "version": "sha256:7366b784205551ed28f2c076e841c0dbeec4111b6df16743fc5605daa2da8f8a"
  }
}
Agent Platform SDK for Python
如要瞭解如何安裝或更新 Agent Platform SDK for Python,請參閱「安裝 Agent Platform SDK for Python」。如要進一步瞭解 Python API,請參閱「Agent Platform SDK for Python API」。
如要進一步瞭解管道參數,請參閱 Google Cloud Pipeline Components 參考文件。
使用任何要求資料之前,請先替換下列項目:
- PIPELINEJOB_DISPLAYNAME:
pipelineJob的顯示名稱。 - PROJECT_ID:執行 pipeline 元件的 Google Cloud 專案。
- LOCATION:執行管道元件的區域。支援
us-central1。 - OUTPUT_DIR:用於儲存評估輸出的 Cloud Storage URI。
- EVALUATION_DATASET:BigQuery 資料表,或以逗號分隔的 Cloud Storage 路徑清單,指向含有評估樣本的 JSONL 資料集。
- TASK:評估工作,可以是
[summarization, question_answering]的其中一項。 - ID_COLUMNS:區分不重複評估樣本的資料欄。
- AUTORATER_PROMPT_PARAMETERS:對應至資料欄或範本的自動評分提示參數。預期參數為:
inference_instruction(執行任務的詳細說明) 和inference_context(執行任務時要參考的內容)。舉例來說,{'inference_context': {'column': 'my_prompt'}}會使用評估資料集的「my_prompt」資料欄,做為自動評分工具的背景資訊。 - RESPONSE_COLUMN_A:含有預先定義預測資料的評估用資料集內的資料欄名稱,或含有預測資料的模型 A 輸出內容中的資料欄名稱。如未提供任何值,系統會嘗試推論出正確的模型輸出內容資料欄名稱。
- RESPONSE_COLUMN_B:含有預先定義預測資料的評估用資料集內的資料欄名稱,或含有預測資料的模型 B 輸出內容中的資料欄名稱。如未提供任何值,系統會嘗試推論出正確的模型輸出內容資料欄名稱。
- MODEL_A (選用):完整模型資源名稱 (
projects/{project}/locations/{location}/models/{model}@{version}) 或發布者模型資源名稱 (publishers/{publisher}/models/{model})。如果已指定模型 A 回覆,則不應提供這個參數。 - MODEL_B (選用):完整模型資源名稱 (
projects/{project}/locations/{location}/models/{model}@{version}) 或發布者模型資源名稱 (publishers/{publisher}/models/{model})。如果指定了模型 B 回覆,則不應提供這個參數。 - MODEL_A_PROMPT_PARAMETERS (選用):模型 A 的提示詞範本參數,對應至資料欄或範本。如果模型 A 的回覆是預先定義,則不應提供這個參數。範例:
{'prompt': {'column': 'my_prompt'}}會使用評估資料集的my_prompt欄,做為名為prompt的提示參數。 - MODEL_B_PROMPT_PARAMETERS (選用):模型 B 的提示詞範本參數,對應至資料欄或範本。如果模型 B 的回覆是預先定義,則不應提供這個參數。範例:
{'prompt': {'column': 'my_prompt'}}會使用評估資料集的my_prompt欄,做為名為prompt的提示參數。 - JUDGMENTS_FORMAT
(選用):寫入判斷結果的格式。可以是
jsonl(預設值)、json或bigquery。 - BIGQUERY_DESTINATION_PREFIX:如果指定格式為
bigquery,則為要寫入判斷結果的 BigQuery 資料表。
import os
from google.cloud import aiplatform
parameters = {
    'evaluation_dataset': 'EVALUATION_DATASET',
    'id_columns': ['ID_COLUMNS'],
    'task': 'TASK',
    'autorater_prompt_parameters': AUTORATER_PROMPT_PARAMETERS,
    'response_column_a': 'RESPONSE_COLUMN_A',
    'response_column_b': 'RESPONSE_COLUMN_B',
    'model_a': 'MODEL_A',
    'model_a_prompt_parameters': MODEL_A_PROMPT_PARAMETERS,
    'model_b': 'MODEL_B',
    'model_b_prompt_parameters': MODEL_B_PROMPT_PARAMETERS,
    'judgments_format': 'JUDGMENTS_FORMAT',
    'bigquery_destination_prefix':
    BIGQUERY_DESTINATION_PREFIX,
}
aiplatform.init(project='PROJECT_ID', location='LOCATION', staging_bucket='gs://OUTPUT_DIR')
aiplatform.PipelineJob(
    display_name='PIPELINEJOB_DISPLAYNAME',
    pipeline_root=os.path.join('gs://OUTPUT_DIR', 'PIPELINEJOB_DISPLAYNAME'),
    template_path=(
      'https://us-kfp.pkg.dev/ml-pipeline/google-cloud-registry/autosxs-template/default'),
    parameter_values=parameters,
).run()
控制台
如要使用 Google Cloud 控制台建立成對模型評估工作,請按照下列步驟操作:
從 Google 基礎模型開始,或使用 Gemini Enterprise Agent Platform Model Registry 中現有的模型:
如要評估 Google 基礎模型,請按照下列步驟操作:
前往 Gemini Enterprise Agent Platform 的 Model Garden,選取支援成對評估的模型,例如
text-bison。按一下「Evaluate」(評估)。
在隨即顯示的選單中,按一下「Select」(選取),選取模型版本。
如果您尚未儲存模型副本,系統可能會在「Save model」(儲存模型) 窗格中,要求您將模型副本儲存至 Gemini Enterprise Agent Platform Model Registry。輸入模型名稱,然後按一下「儲存」。
「Create Evaluation」(建立評估作業) 頁面隨即顯示。在「Evaluate Method」(評估方法) 步驟中,選取「Evaluate this model against another model」(將此模型與另一個模型並列評估)。
按一下「繼續」。
如要評估 Gemini Enterprise Agent Platform Model Registry 中的現有模型,請按照下列步驟操作:
前往 Gemini Enterprise Agent Platform 的「Model Registry」頁面:
按一下要評估的模型名稱。請確認模型類型支援成對評估。例如:
text-bison。在「評估」分頁中,點選「SxS」。
按一下「Create SxS Evaluation」(建立並排評估)。
在評估作業建立頁面的每個步驟中,輸入必要資訊,然後按一下「Continue」(繼續):
在「Evaluation dataset」(評估資料集) 步驟中,選取評估目標和要與所選模型比較的模型。選取評估資料集,然後輸入ID 欄 (回應欄)。
在「Model settings」(模型設定) 步驟中,指定要使用資料集內現有的模型回覆,還是要透過 Gemini Enterprise Agent Platform 批次預測功能生成回覆。指定兩個模型的回覆資料欄。如果選取 Gemini Enterprise Agent Platform 批次預測選項,可以指定推論模型提示參數。
在「Autorater settings」(自動評估工具設定) 步驟中,輸入自動評估工具提示參數和評估結果的輸出位置。
按一下「Start Evaluation」(開始評估)。
查看評估結果
您可以檢查 AutoSxS 管道產生的下列構件,在 Agent Platform Pipelines 中查看評估結果:
判斷結果
AutoSxS 會輸出判斷結果 (樣本層級指標),協助使用者瞭解樣本層級的模型效能。判斷結果包含下列資訊:
- 推論提示
- 模型回覆
- 自動評分工具決策
- 評分說明
- 可信度分數
判斷結果可以 JSONL 格式寫入 Cloud Storage,或寫入具有下列資料欄的 BigQuery 資料表:
| 欄 | 說明 |
|---|---|
| ID 欄 | 這類資料欄可以區分出不重複的評估範例。 |
inference_instruction |
用於生成模型回覆的指令。 |
inference_context |
用於生成模型回覆的背景資訊。 |
response_a |
模型 A 根據推論指令和情境提供的回覆。 |
response_b |
模型 B 根據推論指令和情境提供的回覆。 |
choice |
回覆較佳的模型。可能的值為 Model A、Model B 或 Error。Error:發生錯誤,導致自動評分工具無法判斷模型 A 或模型 B 的回覆較佳。 |
confidence |
分數介於 0 到 1 之間,代表自動標註工具對其選擇的信心程度。 |
explanation |
自動評分工具選擇該選項的原因。 |
匯總指標
AutoSxS 會使用判斷表計算匯總 (勝率) 指標。如果未提供人類偏好資料,系統會產生下列匯總指標:
| 指標 | 說明 |
|---|---|
| AutoRater 模型 A 勝出率 | 自動評分工具判定模型 A 回覆較佳的次數百分比。 |
| AutoRater 模型 B 勝出率 | 自動評分工具判定模型 B 回覆較佳的次數百分比。 |
如要進一步瞭解勝率,請查看逐列結果和自動評估工具的說明,判斷結果和說明是否符合預期。
人類偏好對齊指標
如果提供人類偏好資料,AutoSxS 會輸出下列指標:
| 指標 | 說明 | ||||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| AutoRater 模型 A 勝出率 | 自動評分工具判定模型 A 回覆較佳的次數百分比。 | ||||||||||||||
| AutoRater 模型 B 勝出率 | 自動評分工具判定模型 B 回覆較佳的次數百分比。 | ||||||||||||||
| 人類偏好模型 A 勝出率 | 資料標註人員判定模型 A 回應較佳的時間百分比。 | ||||||||||||||
| 人類偏好模型 B 勝出率 | 資料標註人員判定模型 B 回應較佳的時間百分比。 | ||||||||||||||
| TP | 自動標註工具與資料標註人員都判定模型 A 回應較佳的範例數。 | ||||||||||||||
| FP | 自動標註工具判定模型 A 回應較佳,而資料標註人員認為模型 B 回應較佳的範例數。 | ||||||||||||||
| TN | 自動標註工具與資料標註人員都判定模型 B 回應較佳的範例數。 | ||||||||||||||
| FN | 自動標註工具判定模型 B 回應較佳,而資料標註人員認為模型 A 回應較佳的範例數。 | ||||||||||||||
| 準確率 | 自動標註工具與資料標註人員判定一致的時間百分比。 | ||||||||||||||
| 精確度 | 在自動標註工具判定模型 A 回應較佳的所有案例當中,自動標註工具與資料標註人員都判定模型 A 回應較佳的時間百分比。 | ||||||||||||||
| 喚回度 | 在資料標註人員判定模型 A 回應較佳的所有案例當中,自動標註工具與資料標註人員都判定模型 A 回應較佳的時間百分比。 | ||||||||||||||
| F1 | 精確度與喚回度的調和平均數。 | ||||||||||||||
| 科恩卡帕係數 | 這項指標可以測量自動標註工具與資料標註人員判定一致的程度,會將隨機出現一致情形的可能性納入考量。科恩卡帕係數的建議解讀方式如下:
|
AutoSxS 用途
您可以透過三種用途情境,瞭解如何使用 AutoSxS。
比較模型
將調整後的第一方 (1p) 模型與參考 1p 模型進行比較。
您可以指定同時在兩個模型上執行推論。
這個程式碼範例會依據 Vertex Model Registry 中的參考模型,評估同一個 Registry 中的調整後模型。
# Evaluation dataset schema:
#   my_question: str
#   my_context: str
parameters = {
    'evaluation_dataset': DATASET,
    'id_columns': ['my_context'],
    'task': 'question_answering',
    'autorater_prompt_parameters': {
      'inference_instruction': {'column': 'my_question'},
      'inference_context': {'column': 'my_context'},
  },
    'model_a': 'publishers/google/models/text-bison@002',
    'model_a_prompt_parameters': {QUESTION: {'template': '{{my_question}}\nCONTEXT: {{my_context}}'}},
  'response_column_a': 'content',
    'model_b': 'projects/abc/locations/abc/models/tuned_bison',
    'model_b_prompt_parameters': {'prompt': {'template': '{{my_context}}\n{{my_question}}'}},
  'response_column_b': 'content',
}
比較預測結果
依據參考第三方模型,評估調整過的第三方模型。
您可以直接提供模型回覆,略過推論。
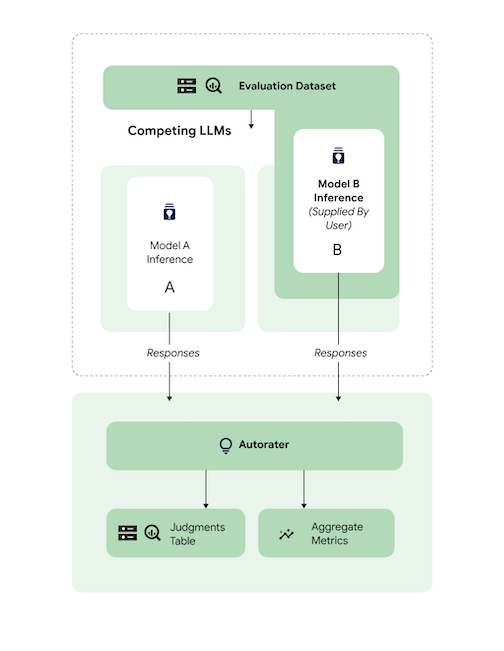
這個程式碼範例會依據參考第三方模型,評估經過調整的第三方模型。
# Evaluation dataset schema:
#   my_question: str
#   my_context: str
#   response_b: str

parameters = {
    'evaluation_dataset': DATASET,
    'id_columns': ['my_context'],
    'task': 'question_answering',
    'autorater_prompt_parameters':
        'inference_instruction': {'column': 'my_question'},
        'inference_context': {'column': 'my_context'},
    },
    'response_column_a': 'content',
    'response_column_b': 'response_b',
}
檢查對齊
所有支援的工作都已使用人工評估者資料進行基準測試,確保自動評估者的回覆符合人類偏好。如要根據用途設定 AutoSxS 基準,請直接將人類偏好資料提供給 AutoSxS,系統會輸出經過校正的匯總統計資料。
如要根據人類偏好資料集檢查校正情形,您可以將這兩項輸出內容 (預測結果) 指定給自動評估工具。您也可以提供推論結果。
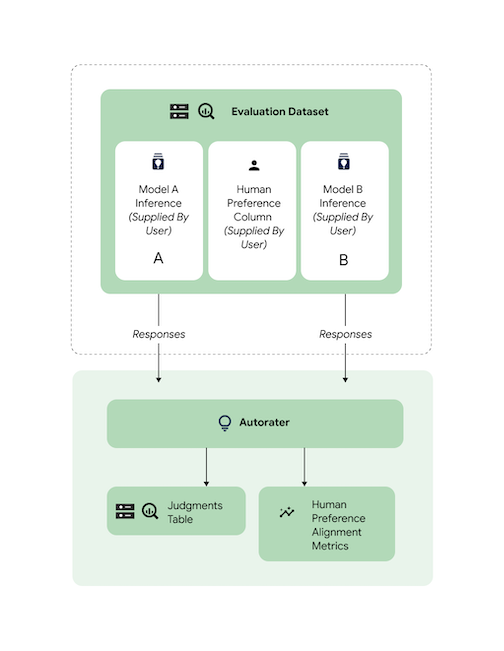
這個程式碼範例會驗證自動評分工具的結果和說明是否符合預期。
# Evaluation dataset schema:
#  my_question: str
#  my_context: str
#   response_a: str
#   response_b: str
#   actual: str
parameters = {
    'evaluation_dataset': DATASET,
    'id_columns': ['my_context'],
    'task': 'question_answering',
    'autorater_prompt_parameters': {
      'inference_instruction': {'column': 'my_question'},
      'inference_context': {'column': 'my_context'},
  },
  'response_column_a': 'response_a',
  'response_column_b': 'response_b',
  'human_preference_column': 'actual',
}
後續步驟
- 瞭解生成式 AI 評估。
- 瞭解如何使用 Gen AI Evaluation Service 進行線上評估。
- 瞭解如何調整語言基礎模型。