


בדף הזה מוסבר איך לבצע הערכה מבוססת-מודל של השוואה בין זוגות באמצעות AutoSxS, כלי שפועל דרך שירות צינור עיבוד הנתונים להערכה. אנחנו מסבירים איך משתמשים ב-AutoSxS באמצעות Agent Platform API, Agent Platform SDK for Python או מסוף Google Cloud .
AutoSxS
השוואה אוטומטית (AutoSxS) היא כלי להערכה שמבוססת על מודל של השוואה בין זוגות, שפועל דרך שירות צינור עיבוד הנתונים להערכה. אפשר להשתמש ב-AutoSxS כדי להעריך את הביצועים של מודלים של AI גנרטיבי במרשם המודלים של Gemini Enterprise Agent Platform או של חיזויים שנוצרו מראש. כך הוא יכול לתמוך במודלים בסיסיים של Gemini Enterprise Agent Platform, במודלים מכווננים של AI גנרטיבי ובמודלים של שפה של צד שלישי. ב-AutoSxS נעשה שימוש במדרג אוטומטי כדי להחליט איזה מודל נותן את התשובה הטובה יותר להנחיה. הוא זמין לפי דרישה ומעריך מודלים של שפה עם ביצועים דומים לאלה של מעריכים אנושיים.
הכלי לדירוג אוטומטי
ברמה הכללית, התרשים מראה איך AutoSxS משווה בין החיזויים של מודלים א' וב' לבין מודל שלישי, המדרג האוטומטי.
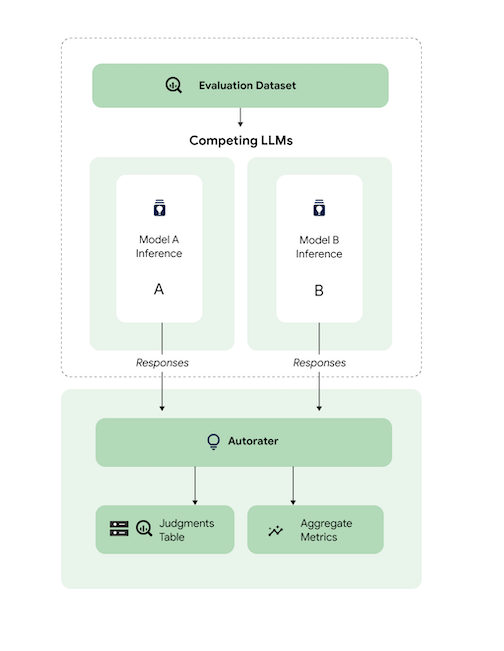
מודלים א' וב' מקבלים הנחיות קלט, וכל מודל יוצר תשובות שנשלחות למדרג האוטומטי. בדומה לבודק אנושי, בודק אוטומטי הוא מודל שפה שמעריך את איכות התשובות של המודל בהתאם להנחיה המקורית להסקת מסקנות. ב-AutoSxS, המעריך האוטומטי משווה בין האיכות של שתי תשובות של מודלים בהתאם להוראות ההסקה שלהן, באמצעות קבוצת קריטריונים. הקריטריונים משמשים כדי לקבוע איזה מודל הניב את הביצועים הכי טובים, על ידי השוואה בין התוצאות של מודל א' לתוצאות של מודל ב'. הכלי האוטומטי לדירוג מציג את ההעדפות לגבי התשובות כמדדים מצטברים, וגם הסברים להעדפות וציוני מהימנות לכל דוגמה. למידע נוסף, עיינו בטבלת ההחלטות.
מודלים נתמכים
ב-AutoSxS אפשר להעריך כל מודל אם מספקים תחזיות שנוצרו מראש. בנוסף, AutoSxS תומך ביצירת תשובות אוטומטיות לכל מודל במרשם המודלים של Gemini Enterprise Agent Platform שתומך בחיזוי באצ' ב-Gemini Enterprise Agent Platform.
אם מודל הטקסט שלכם לא נתמך במרשם המודלים של Gemini Enterprise Agent Platform, AutoSxS מקבל גם חיזויים שנוצרו מראש ומאוחסנים כ-JSONL ב-Cloud Storage או בטבלה ב-BigQuery. למידע על התמחור, ראו יצירת טקסט.
משימות וקריטריונים נתמכים
AutoSxS תומך בהערכת מודלים למשימות סיכום ומענה על שאלות. הקריטריונים להערכה מוגדרים מראש לכל משימה, מה שהופך את הערכת השפה לאובייקטיבית יותר ומשפר את איכות התשובות.
הקריטריונים מפורטים לפי משימה.
סיכום
במשימה summarization יש מגבלה של 4,096 טוקנים לקלט.
רשימת הקריטריונים להערכה של summarization:
| קריטריונים | |
|---|---|
| 1. פועל לפי ההוראות | באיזו מידה התשובה של המודל מראה שהוא הבין את ההוראה שבהנחיה? |
| 2. מבוסס-עובדות | האם התשובה כוללת רק מידע מההקשר ומההוראה להסקת המסקנות? |
| 3. מקיפה | באיזו מידה המודל כולל פרטים חשובים בסיכום? |
| 4. תקציר | האם הסיכום מפורט? האם הוא כולל שפה מליצית? האם הוא תמציתי מדי? |
תשובה לשאלה
במשימה question_answering יש מגבלת טוקנים של 4,096 לקלט.
רשימת הקריטריונים להערכה של question_answering:
| קריטריונים | |
|---|---|
| 1. עונה על השאלה באופן מלא | התשובה עונה על השאלה באופן מלא. |
| 2. מבוסס-עובדות | האם התשובה כוללת רק מידע מההקשר של ההוראה ומההוראה להסקת מסקנות? |
| 3. רלוונטיות | האם התוכן של התשובה קשור לשאלה? |
| 4. מקיפה | באיזו מידה המודל כולל את הפרטים העיקריים בשאלה? |
הכנת מערך נתונים להערכה ב-AutoSxS
בקטע הזה מפורטים הנתונים שצריך לספק במערך הנתונים להערכה של AutoSxS, ושיטות מומלצות ליצירת מערך נתונים. הדוגמאות צריכות לשקף קלט מהעולם האמיתי שהמודלים שלכם עשויים להיתקל בו בסביבת הייצור, ולהדגיש את ההבדלים בהתנהגות של המודלים הפעילים.
פורמט של מערך נתונים
AutoSxS מקבל מערך נתונים אחד להערכה עם סכימה גמישה. מערך הנתונים יכול להיות טבלה ב-BigQuery או קובץ JSON Lines שמאוחסן ב-Cloud Storage.
כל שורה בקבוצת הנתונים להערכה מייצגת דוגמה אחת, והעמודות הן אחת מהאפשרויות הבאות:
- עמודות מזהים: משמשות לזיהוי כל דוגמה ייחודית.
- עמודות נתונים: משמשות למילוי תבניות לפרומפטים. פרמטרים של הנחיות
- תחזיות שנוצרו מראש: תחזיות שנוצרו על ידי אותו מודל באמצעות אותו פרומפט. שימוש בתחזיות שנוצרו מראש חוסך זמן ומשאבים.
- העדפות אנושיות של אמת קרקע (ground truth): משמשות להשוואה בין AutoSxS לבין נתוני ההעדפות של אמת קרקע (ground truth) כשמספקים תחזיות שנוצרו מראש לשני המודלים.
הנה דוגמה לקבוצת נתונים להערכה, שבה context ו-question הן עמודות נתונים, ו-model_b_response מכילה תחזיות שנוצרו מראש.
context |
question |
model_b_response |
|---|---|---|
| יש אנשים שחושבים שפלדה או טיטניום הם החומרים הכי קשים, אבל למעשה יהלום הוא החומר הכי קשה. | מה החומר הכי קשה? | יהלום הוא החומר הכי קשה. הוא קשה יותר מפלדה או מטיטניום. |
מידע נוסף על אופן הקריאה ל-AutoSxS זמין במאמר ביצוע הערכת מודל. לפרטים על אורך הטוקן, קראו את המאמר משימות וקריטריונים נתמכים. כדי להעלות את הנתונים ל-Cloud Storage, קראו את המאמר העלאת מערך נתונים להערכה ל-Cloud Storage.
פרמטרים של הנחיות
הרבה מודלי שפה מקבלים פרמטרים של הנחיות כקלט, במקום מחרוזת הנחיה אחת. לדוגמה, chat-bison מקבל כמה פרמטרים של הנחיות (הודעות, דוגמאות, הקשר), שמרכיבים חלקים מההנחיה. לעומת זאת, ל-text-bison יש רק פרמטר אחד של הנחיה, שנקרא prompt, והוא מכיל את כל ההנחיה.
אנחנו מסבירים איך אפשר להגדיר באופן גמיש את הפרמטרים של ההנחיות למודל בזמן ההסקה וההערכה. AutoSxS מאפשר לכם להפעיל מודלים של שפה עם קלטים צפויים שונים באמצעות פרמטרים של הנחיות בתבנית.
הסקה
אם לאחד מהמודלים אין חיזויים שנוצרו מראש, AutoSxS משתמש בחיזוי באצווה של Gemini Enterprise Agent Platform כדי ליצור תשובות. צריך לציין את הפרמטרים של ההנחיה לכל מודל.
ב-AutoSxS, אתם יכולים לספק עמודה אחת במערך הנתונים להערכה כפרמטר של הנחיה.
{'some_parameter': {'column': 'my_column'}}
אפשר גם להגדיר תבניות באמצעות עמודות ממערך הנתונים להערכה כמשתנים, כדי לציין פרמטרים של הנחיות:
{'some_parameter': {'template': 'Summarize the following: {{ my_column }}.'}}
כשמציינים פרמטרים של הנחיות למודל לצורך הסקת מסקנות, המשתמשים יכולים להשתמש במילת המפתח המוגנת default_instruction כארגומנט של תבנית, שמוחלף בהוראת ברירת המחדל להסקת מסקנות במשימה הנתונה:
model_prompt_parameters = {
        'prompt': {'template': '{{ default_instruction }}: {{ context }}'},
}
אם יוצרים חיזויים, צריך לספק פרמטרים של הנחיות למודל ועמודת פלט. לדוגמה:
Gemini
במודלים של Gemini, המפתחות לפרמטרים של הנחיות למודל הם contents (חובה) ו-system_instruction (אופציונלי), שתואמים לסכימה של גוף הבקשה של Gemini.
model_a_prompt_parameters={
    'contents': {
        'column': 'context'
    },
    'system_instruction': {'template': '{{ default_instruction }}'},
},
text-bison
לדוגמה, text-bison משתמש ב-"prompt" לקלט וב-"content" לפלט. כך עושים את זה:
- מזהים את הקלט והפלט שנדרשים למודלים שרוצים להעריך.
- מגדירים את הקלטים כפרמטרים של הנחיות למודל.
- מעבירים את הפלט לעמודת התשובה.
model_a_prompt_parameters={
    'prompt': {
        'template': {
            'Answer the following question from the point of view of a college professor: {{ context }}\n{{ question }}'
        },
    },
},
response_column_a='content',  # Column in Model A response.
response_column_b='model_b_response',  # Column in eval dataset.
הערכה
כמו שצריך לספק פרמטרים של הנחיות להסקה, צריך גם לספק פרמטרים של הנחיות להערכה. כדי להשתמש ב-autorater, צריך להגדיר את הפרמטרים הבאים בהנחיה:
| פרמטר של הנחיה לדירוג אוטומטי | האם המשתמש יכול להגדיר? | תיאור | דוגמה |
|---|---|---|---|
| הוראה למדרג האוטומטי | לא | הוראה מכוילת שמתארת את הקריטריונים שבהם מערכת הדירוג האוטומטי צריכה להשתמש כדי לשפוט את התשובות שניתנו. | בוחרים את התשובה שעונה על השאלה ופועלת לפי ההוראות בצורה הטובה ביותר. |
| הוראה להסקת מסקנות | כן | תיאור המשימה שכל מודל מועמד צריך לבצע. | ענה על השאלה בצורה מדויקת: מהו החומר הקשה ביותר? |
| הקשר ההסקה | כן | הקשר נוסף למשימה שמבוצעת. | למרות שגם טיטניום וגם יהלום קשים יותר מנחושת, ליהלום יש דירוג קשיות של 98 ולטיטניום יש דירוג של 36. ככל שהדירוג גבוה יותר, כך הקשיחות גבוהה יותר. |
| תשובות | לא1 | זוג תשובות להערכה, אחת מכל מודל מועמד. | יהלום |
1אפשר להגדיר את הפרמטר prompt רק באמצעות תשובות שנוצרו מראש.
קוד לדוגמה שמשתמש בפרמטרים:
autorater_prompt_parameters={
    'inference_instruction': {
        'template': 'Answer the following question from the point of view of a college professor: {{ question }}.'
    },
    'inference_context': {
        'column': 'context'
    }
}
למודלים א' וב' יכולות להיות הוראות הסקה והקשר בפורמט שונה, גם אם מספקים את אותו המידע. כלומר, מערכת הדירוג האוטומטי מקבלת הקשר והוראת הסקה נפרדת, אבל יחידה.
דוגמה למערך נתונים להערכה
בקטע הזה מוצגת דוגמה לקבוצת נתונים להערכה של משימת שאלות ותשובות, כולל חיזויים שנוצרו מראש למודל B. בדוגמה הזו, AutoSxS מבצע הסקה רק למודל א'. אנחנו מספקים עמודה של id כדי להבדיל בין דוגמאות עם אותה שאלה ואותו הקשר.
{
  "id": 1,
  "question": "What is the hardest material?",
  "context": "Some might think that steel is the hardest material, or even titanium. However, diamond is actually the hardest material.",
  "model_b_response": "Diamond is the hardest material. It is harder than steel or titanium."
}
{
  "id": 2,
  "question": "What is the highest mountain in the world?",
  "context": "K2 and Everest are the two tallest mountains, with K2 being just over 28k feet and Everest being 29k feet tall.",
  "model_b_response": "Mount Everest is the tallest mountain, with a height of 29k feet."
}
{
  "id": 3,
  "question": "Who directed The Godfather?",
  "context": "Mario Puzo and Francis Ford Coppola co-wrote the screenplay for The Godfather, and the latter directed it as well.",
  "model_b_response": "Francis Ford Coppola directed The Godfather."
}
{
  "id": 4,
  "question": "Who directed The Godfather?",
  "context": "Mario Puzo and Francis Ford Coppola co-wrote the screenplay for The Godfather, and the latter directed it as well.",
  "model_b_response": "John Smith."
}
שיטות מומלצות
כדאי לפעול לפי השיטות המומלצות הבאות כשמגדירים את קבוצת הנתונים להערכה:
- לספק דוגמאות שמייצגות את סוגי הקלט שהמודלים מעבדים בסביבת הייצור.
- מערך הנתונים חייב לכלול לפחות דוגמה אחת להערכה. כדי להבטיח מדדים מצטברים באיכות גבוהה, מומלץ להשתמש בכ-100 דוגמאות. קצב השיפור באיכות של המדדים המצטברים נוטה לרדת כשמספקים יותר מ-400 דוגמאות.
- במאמר עיצוב פרומפטים טקסטואליים מוסבר איך לכתוב פרומפטים.
- אם אתם משתמשים בתחזיות שנוצרו מראש לאחד מהמודלים, צריך לכלול את התחזיות שנוצרו מראש בעמודה של קבוצת נתוני ההערכה. האפשרות לספק תחזיות שנוצרו מראש היא שימושית, כי היא מאפשרת להשוות את הפלט של מודלים שלא נמצאים ב-Vertex Model Registry, ולהשתמש בתשובות שוב.
הערכת המודל
אפשר להעריך מודלים באמצעות API בארכיטקטורת REST, Agent Platform SDK ל-Python או מסוףGoogle Cloud .
כדי לציין את הנתיב למודל, משתמשים בתחביר הבא:
- מודל בעל התוכן הדיגיטלי:
publishers/PUBLISHER/models/MODELדוגמה:publishers/google/models/text-bison מודל מכוונן:
projects/PROJECT_NUMBER/locations/LOCATION/models/MODEL@VERSIONדוגמה:projects/123456789012/locations/us-central1/models/1234567890123456789
REST
כדי ליצור משימה להערכת מודל, שולחים בקשת POST באמצעות השיטה pipelineJobs.
לפני שמשתמשים בנתוני הבקשה, צריך להחליף את הערכים בשדות הבאים:
- PIPELINEJOB_DISPLAYNAME : השם המוצג של
pipelineJob. - PROJECT_ID: הפרויקט ב- Google Cloud שמריץ את רכיבי צינור עיבוד הנתונים.
- LOCATION : האזור שבו יופעלו רכיבי צינור עיבוד הנתונים. יש תמיכה ב-
us-central1. - OUTPUT_DIR : ה-URI של Cloud Storage שבו יישמר פלט ההערכה.
- EVALUATION_DATASET : טבלה ב-BigQuery או רשימה מופרדת בפסיקים של נתיבים ב-Cloud Storage למערך נתונים בפורמט JSONL שמכיל דוגמאות להערכה.
- TASK: משימת ההערכה, שיכולה להיות אחת מהאפשרויות הבאות:
[summarization, question_answering]. - ID_COLUMNS : עמודות שמבדילות בין דוגמאות הערכה ייחודיות.
- AUTORATER_PROMPT_PARAMETERS : פרמטרים של הנחיות ל-Autorater שממופים לעמודות או לתבניות. הפרמטרים הצפויים הם:
inference_instruction(פרטים על אופן ביצוע המשימה) ו-inference_context(תוכן שצריך להתייחס אליו כדי לבצע את המשימה). לדוגמה,{'inference_context': {'column': 'my_prompt'}}משתמש בעמודה `my_prompt` של מערך הנתונים להערכה בשביל ההקשר של המעריך האוטומטי. - RESPONSE_COLUMN_A : השם של עמודה בקבוצת הנתונים להערכה שמכילה חיזויים מוגדרים מראש, או השם של העמודה בפלט של מודל א' שמכילה חיזויים. אם לא מציינים ערך, המערכת תנסה להסיק את השם הנכון של עמודת הפלט מהמודל.
- RESPONSE_COLUMN_B : השם של עמודה בקבוצת הנתונים להערכה שמכילה תחזיות מוגדרות מראש, או השם של העמודה בפלט של מודל ב' שמכילה תחזיות. אם לא מציינים ערך, המערכת תנסה להסיק את השם הנכון של עמודת הפלט מהמודל.
- MODEL_A (אופציונלי): שם משאב מלא של מודל (
projects/{project}/locations/{location}/models/{model}@{version}) או שם משאב של מודל של בעל תוכן דיגיטלי (publishers/{publisher}/models/{model}). אם צוינו תשובות של מודל א', אין לספק את הפרמטר הזה. - MODEL_B (אופציונלי): שם משאב מלא של מודל (
projects/{project}/locations/{location}/models/{model}@{version}) או שם משאב של מודל של בעל תוכן דיגיטלי (publishers/{publisher}/models/{model}). אם מציינים את התשובות של מודל ב', לא צריך לציין את הפרמטר הזה. - MODEL_A_PROMPT_PARAMETERS (אופציונלי): הפרמטרים של התבנית לפרומפט של מודל א' ממופים לעמודות או לתבניות. אם התשובות של מודל א' מוגדרות מראש, אין צורך לציין את הפרמטר הזה. דוגמה:
{'prompt': {'column': 'my_prompt'}}משתמש בעמודהmy_promptשל מערך נתוני ההערכה בשביל פרמטר ההנחיה שנקראprompt. - MODEL_B_PROMPT_PARAMETERS (אופציונלי): הפרמטרים של התבנית לפרומפט של מודל ב' ממופים לעמודות או לתבניות. אם התשובות של מודל ב' מוגדרות מראש, אין צורך לציין את הפרמטר הזה. דוגמה:
{'prompt': {'column': 'my_prompt'}}משתמש בעמודהmy_promptשל מערך נתוני ההערכה בשביל פרמטר ההנחיה שנקראprompt. - JUDGMENTS_FORMAT
(אופציונלי): הפורמט שבו ייכתבו ההחלטות. יכול להיות
jsonl(ברירת מחדל),jsonאוbigquery. - BIGQUERY_DESTINATION_PREFIX: טבלה ב-BigQuery שבה ייכתבו ההערכות אם הפורמט שצוין הוא
bigquery.
גוף בקשת JSON
  {
    "displayName": "PIPELINEJOB_DISPLAYNAME",
    "runtimeConfig": {
        "gcsOutputDirectory": "gs://OUTPUT_DIR",
        "parameterValues": {
            "evaluation_dataset": "EVALUATION_DATASET",
            "id_columns": ["ID_COLUMNS"],
            "task": "TASK",
            "autorater_prompt_parameters": AUTORATER_PROMPT_PARAMETERS,
            "response_column_a": "RESPONSE_COLUMN_A",
            "response_column_b": "RESPONSE_COLUMN_B",
            "model_a": "MODEL_A",
            "model_a_prompt_parameters": MODEL_A_PROMPT_PARAMETERS,
            "model_b": "MODEL_B",
            "model_b_prompt_parameters": MODEL_B_PROMPT_PARAMETERS,
            "judgments_format": "JUDGMENTS_FORMAT",
            "bigquery_destination_prefix":BIGQUERY_DESTINATION_PREFIX,
        },
    },
    "templateUri": "https://us-kfp.pkg.dev/ml-pipeline/google-cloud-registry/autosxs-template/default"
  }
משתמשים ב-curl כדי לשלוח את הבקשה.
curl -X POST \
    -H "Authorization: Bearer $(gcloud auth print-access-token)" \
    -H "Content-Type: application/json; charset=utf-8" \
    -d @request.json \
    "https://LOCATION-aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/LOCATION/pipelineJobs"
תשובה
  "state": "PIPELINE_STATE_PENDING",
  "labels": {
    "vertex-ai-pipelines-run-billing-id": "1234567890123456789"
  },
  "runtimeConfig": {
    "gcsOutputDirectory": "gs://my-evaluation-bucket/output",
    "parameterValues": {
      "evaluation_dataset": "gs://my-evaluation-bucket/output/data.json",
      "id_columns": [
        "context"
      ],
      "task": "question_answering",
      "autorater_prompt_parameters": {
        "inference_instruction": {
          "template": "Answer the following question: {{ question }} }."
        },
        "inference_context": {
          "column": "context"
        }
      },
      "response_column_a": "",
      "response_column_b": "response_b",
      "model_a": "publishers/google/models/text-bison@002",
      "model_a_prompt_parameters": {
        "prompt": {
          "template": "Answer the following question from the point of view of a college professor: {{ question }}\n{{ context }} }"
        }
      },
      "model_b": "",
      "model_b_prompt_parameters": {}
    }
  },
  "serviceAccount": "123456789012-compute@developer.gserviceaccount.com",
  "templateUri": "https://us-kfp.pkg.dev/ml-pipeline/google-cloud-registry/autosxs-template/default",
  "templateMetadata": {
    "version": "sha256:7366b784205551ed28f2c076e841c0dbeec4111b6df16743fc5605daa2da8f8a"
  }
}
Agent Platform SDK for Python
במאמר התקנת Agent Platform SDK ל-Python מוסבר איך להתקין או לעדכן את Agent Platform SDK ל-Python. מידע נוסף על API בשפת Python מופיע במאמר Agent Platform SDK ל-API בשפת Python.
מידע נוסף על הפרמטרים של צינורות עיבוד נתונים זמין במאמרי העזרה של רכיבי צינורות עיבוד נתונים ב-Google Cloud.
לפני שמשתמשים בנתוני הבקשה, צריך להחליף את הערכים בשדות הבאים:
- PIPELINEJOB_DISPLAYNAME : השם המוצג של
pipelineJob. - PROJECT_ID: הפרויקט ב- Google Cloud שמריץ את רכיבי צינור עיבוד הנתונים.
- LOCATION : האזור שבו יופעלו רכיבי צינור עיבוד הנתונים. יש תמיכה ב-
us-central1. - OUTPUT_DIR : ה-URI של Cloud Storage שבו יישמר פלט ההערכה.
- EVALUATION_DATASET : טבלה ב-BigQuery או רשימה מופרדת בפסיקים של נתיבים ב-Cloud Storage למערך נתונים בפורמט JSONL שמכיל דוגמאות להערכה.
- TASK: משימת ההערכה, שיכולה להיות אחת מהאפשרויות הבאות:
[summarization, question_answering]. - ID_COLUMNS : עמודות שמבדילות בין דוגמאות הערכה ייחודיות.
- AUTORATER_PROMPT_PARAMETERS : פרמטרים של הנחיות ל-Autorater שממופים לעמודות או לתבניות. הפרמטרים הצפויים הם:
inference_instruction(פרטים על אופן ביצוע המשימה) ו-inference_context(תוכן שצריך להתייחס אליו כדי לבצע את המשימה). לדוגמה,{'inference_context': {'column': 'my_prompt'}}משתמש בעמודה `my_prompt` של מערך הנתונים להערכה בשביל ההקשר של המעריך האוטומטי. - RESPONSE_COLUMN_A : השם של עמודה בקבוצת הנתונים להערכה שמכילה חיזויים מוגדרים מראש, או השם של העמודה בפלט של מודל א' שמכילה חיזויים. אם לא מציינים ערך, המערכת תנסה להסיק את השם הנכון של עמודת הפלט מהמודל.
- RESPONSE_COLUMN_B : השם של עמודה בקבוצת הנתונים להערכה שמכילה תחזיות מוגדרות מראש, או השם של העמודה בפלט של מודל ב' שמכילה תחזיות. אם לא מציינים ערך, המערכת תנסה להסיק את השם הנכון של עמודת הפלט מהמודל.
- MODEL_A (אופציונלי): שם משאב מלא של מודל (
projects/{project}/locations/{location}/models/{model}@{version}) או שם משאב של מודל של בעל תוכן דיגיטלי (publishers/{publisher}/models/{model}). אם צוינו תשובות של מודל א', אין לספק את הפרמטר הזה. - MODEL_B (אופציונלי): שם משאב מלא של מודל (
projects/{project}/locations/{location}/models/{model}@{version}) או שם משאב של מודל של בעל תוכן דיגיטלי (publishers/{publisher}/models/{model}). אם צוינו תשובות של מודל B, אין לספק את הפרמטר הזה. - MODEL_A_PROMPT_PARAMETERS (אופציונלי): הפרמטרים של התבנית לפרומפט של מודל א' ממופים לעמודות או לתבניות. אם התשובות של מודל א' מוגדרות מראש, אין צורך לציין את הפרמטר הזה. דוגמה:
{'prompt': {'column': 'my_prompt'}}משתמש בעמודהmy_promptשל מערך נתוני ההערכה בשביל פרמטר ההנחיה שנקראprompt. - MODEL_B_PROMPT_PARAMETERS (אופציונלי): הפרמטרים של התבנית לפרומפט של מודל ב' ממופים לעמודות או לתבניות. אם התשובות של מודל ב' מוגדרות מראש, אין צורך לציין את הפרמטר הזה. דוגמה:
{'prompt': {'column': 'my_prompt'}}משתמש בעמודהmy_promptשל מערך נתוני ההערכה בשביל פרמטר ההנחיה שנקראprompt. - JUDGMENTS_FORMAT
(אופציונלי): הפורמט שבו ייכתבו ההחלטות. יכול להיות
jsonl(ברירת מחדל),jsonאוbigquery. - BIGQUERY_DESTINATION_PREFIX: טבלה ב-BigQuery שבה ייכתבו ההערכות אם הפורמט שצוין הוא
bigquery.
import os
from google.cloud import aiplatform
parameters = {
    'evaluation_dataset': 'EVALUATION_DATASET',
    'id_columns': ['ID_COLUMNS'],
    'task': 'TASK',
    'autorater_prompt_parameters': AUTORATER_PROMPT_PARAMETERS,
    'response_column_a': 'RESPONSE_COLUMN_A',
    'response_column_b': 'RESPONSE_COLUMN_B',
    'model_a': 'MODEL_A',
    'model_a_prompt_parameters': MODEL_A_PROMPT_PARAMETERS,
    'model_b': 'MODEL_B',
    'model_b_prompt_parameters': MODEL_B_PROMPT_PARAMETERS,
    'judgments_format': 'JUDGMENTS_FORMAT',
    'bigquery_destination_prefix':
    BIGQUERY_DESTINATION_PREFIX,
}
aiplatform.init(project='PROJECT_ID', location='LOCATION', staging_bucket='gs://OUTPUT_DIR')
aiplatform.PipelineJob(
    display_name='PIPELINEJOB_DISPLAYNAME',
    pipeline_root=os.path.join('gs://OUTPUT_DIR', 'PIPELINEJOB_DISPLAYNAME'),
    template_path=(
      'https://us-kfp.pkg.dev/ml-pipeline/google-cloud-registry/autosxs-template/default'),
    parameter_values=parameters,
).run()
המסוף
כדי ליצור משימה להערכת מודלים בהשוואה בין צמדים באמצעות מסוף Google Cloud :
מתחילים עם מודל בסיסי של Google, או משתמשים במודל שכבר קיים במרשם המודלים ב-Gemini Enterprise Agent Platform:
כדי להעריך מודל בסיס של Google:
נכנסים ל-Model Garden ב-Gemini Enterprise Agent Platform ובוחרים מודל שתומך בהערכה בזוגות, כמו
text-bison.לוחצים על הערכה.
בתפריט שמופיע, לוחצים על Select כדי לבחור גרסת מודל.
אם אין לכם עדיין עותק של המודל, יכול להיות שתופיע החלונית Save model ותתבקשו לשמור עותק של המודל ב-Gemini Enterprise Agent Platform Model Registry. מזינים שם מודל ולוחצים על שמירה.
מופיע הדף Create Evaluation. בשלב Evaluate Method, בוחרים באפשרות Evaluate this model against another model.
לוחצים על Continue.
כדי להעריך מודל קיים ב-מרשם המודלים של Gemini Enterprise Agent Platform:
נכנסים לדף Gemini Enterprise Agent Platform Model Registry:
לוחצים על שם המודל שרוצים להעריך. חשוב לוודא שסוג המודל תומך בהערכה בהשוואה בין מודלים. לדוגמה,
text-bison.בכרטיסייה Evaluate, לוחצים על SxS.
לוחצים על Create SxS Evaluation.
בכל שלב בדף ליצירת הערכה, מזינים את המידע הנדרש ולוחצים על Continue:
בשלב Evaluation dataset, בוחרים את יעד ההערכה ואת המודל שרוצים להשוות למודל שנבחר. בוחרים קבוצת נתונים להערכה ומזינים את עמודות המזהה (עמודות התגובה).
בשלב Model settings, מציינים אם רוצים להשתמש בתשובות של המודל שכבר קיימות במערך הנתונים, או אם רוצים להשתמש ב-Gemini Enterprise Agent Platform Batch Prediction כדי ליצור את התשובות. מציינים את עמודות התגובה של שני המודלים. באפשרות Gemini Enterprise Agent Platform Batch Prediction, אתם יכולים לציין את הפרמטרים של ההנחיות למודל ההסקה.
בשלב Autorater settings, מזינים את הפרמטרים של ההנחיה למעריך האוטומטי ואת מיקום הפלט של ההערכות.
לוחצים על התחלת ההערכה.
הצגת תוצאות הבדיקה
תוצאות ההערכה מופיעות בצינורות עיבוד הנתונים של פלטפורמת הסוכנים. כדי לראות אותן, בודקים את פריטי המידע שנוצרו על ידי צינור עיבוד הנתונים של AutoSxS:
- הטבלה judgments נוצרת על ידי הבורר של AutoSxS.
- מדדים נצברים נוצרים על ידי רכיב המדדים של AutoSxS.
- מדדי התאמה להעדפות אנושיות נוצרים על ידי רכיב המדדים של AutoSxS.
פסקי דין
AutoSxS מפיק הערכות (מדדים ברמת הדוגמה) שעוזרות למשתמשים להבין את ביצועי המודל ברמת הדוגמה. ההחלטות כוללות את הפרטים הבאים:
- הנחיות להסקת מסקנות
- תשובות מהמודל
- החלטות של מערכת הדירוג האוטומטית
- הסברים על הדירוגים
- ציוני מהימנות
אפשר לכתוב את ההערכות ל-Cloud Storage בפורמט JSONL או לטבלה ב-BigQuery עם העמודות הבאות:
| עמודה | תיאור |
|---|---|
| עמודות מזהים | עמודות שמבדילות בין דוגמאות הערכה ייחודיות. |
inference_instruction |
ההוראה ששימשה ליצירת התשובות של המודל. |
inference_context |
ההקשר ששימש ליצירת התשובות של המודל. |
response_a |
התשובה של מודל א', בהתאם להוראות ההסקה ולהקשר. |
response_b |
התשובה של מודל ב', בהתאם להוראת ההסקה ולהקשר. |
choice |
המודל עם התשובה הטובה יותר. הערכים האפשריים הם Model A, Model B או Error. Error פירושו ששגיאה מנעה ממערכת הדירוג האוטומטי לקבוע אם התשובה של מודל א' או התשובה של מודל ב' הייתה הטובה ביותר. |
confidence |
ציון בין 0 ל-1, שמציין את רמת הסמך של המדרג האוטומטי לגבי הבחירה שלו. |
explanation |
הסיבה לבחירה של המדרג האוטומטי. |
מדדים מצטברים
AutoSxS מחשב מדדים נצברים (שיעור זכייה) באמצעות טבלת ההערכות. אם לא מספקים נתונים על העדפות אנושיות, המערכת יוצרת את המדדים המצטברים הבאים:
| מדד | תיאור |
|---|---|
| שיעור הזכייה של מודל AutoRater א' | אחוז הפעמים שבהן מערכת הדירוג האוטומטי קבעה שהתשובה של מודל א' הייתה טובה יותר. |
| שיעור הזכייה של מודל ב' ב-AutoRater | אחוז הפעמים שבהן מערכת הדירוג האוטומטי קבעה שהתשובה של מודל ב' הייתה טובה יותר. |
כדי להבין טוב יותר את שיעור הזכייה, כדאי לבדוק את התוצאות לפי שורות ואת ההסברים של המדרג האוטומטי, ולקבוע אם התוצאות וההסברים תואמים לציפיות שלכם.
מדדי התאמה להעדפות אנושיות
אם מספקים נתונים של העדפות אנושיות, AutoSxS מפיק את המדדים הבאים:
| מדד | תיאור | ||||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| שיעור הזכייה של מודל AutoRater א' | אחוז הפעמים שבהן מערכת הדירוג האוטומטי קבעה שהתשובה של מודל א' הייתה טובה יותר. | ||||||||||||||
| שיעור הזכייה של מודל ב' ב-AutoRater | אחוז הפעמים שבהן המדרג האוטומטי קבע שהתשובה של מודל ב' הייתה טובה יותר. | ||||||||||||||
| שיעור הזכייה של מודל א' לפי העדפות אנושיות | אחוז הפעמים שבהן בודקים אנושיים החליטו שהתשובה של מודל א' הייתה טובה יותר. | ||||||||||||||
| שיעור הזכייה של מודל B לפי העדפות אנושיות | אחוז הפעמים שבהן בודקים אנושיים החליטו שהתשובה של מודל ב' הייתה טובה יותר. | ||||||||||||||
| TP | מספר הדוגמאות שבהן גם מערכת הדירוג האוטומטי וגם הבודקים האנושיים העדיפו את התשובה של מודל א'. | ||||||||||||||
| FP | מספר הדוגמאות שבהן מערכת הדירוג האוטומטי בחרה במודל א' כתשובה הטובה יותר, אבל ההעדפה האנושית הייתה שהתשובה של מודל ב' טובה יותר. | ||||||||||||||
| TN | מספר הדוגמאות שבהן גם מערכת הדירוג האוטומטי וגם הבודקים האנושיים העדיפו את התשובה של מודל ב'. | ||||||||||||||
| FN | מספר הדוגמאות שבהן מערכת הדירוג האוטומטי בחרה במודל ב' כתשובה הטובה יותר, אבל ההעדפה האנושית הייתה שהתשובה של מודל א' הייתה טובה יותר. | ||||||||||||||
| דיוק | אחוז הזמן שבו המדרג האוטומטי הסכים עם המדרגים האנושיים. | ||||||||||||||
| דיוק | אחוז המקרים שבהם גם מערכת הדירוג האוטומטי וגם הבודקים האנושיים חשבו שהתשובה של מודל א' הייתה טובה יותר, מתוך כל המקרים שבהם מערכת הדירוג האוטומטי חשבה שהתשובה של מודל א' הייתה טובה יותר. | ||||||||||||||
| Recall | אחוז המקרים שבהם גם המדרג האוטומטי וגם הבודקים האנושיים חשבו שהתשובה של מודל א' הייתה טובה יותר, מתוך כל המקרים שבהם הבודקים האנושיים חשבו שהתשובה של מודל א' הייתה טובה יותר. | ||||||||||||||
| F1 | ממוצע הרמוני של דיוק וזכירה. | ||||||||||||||
| מדד קאפה של כהן | מדד של הסכמה בין המדרג האוטומטי למדרגים אנושיים, שמביא בחשבון את הסבירות להסכמה אקראית. כהן מציע את הפרשנות הבאה:
|
תרחישים לדוגמה לשימוש ב-AutoSxS
אתם יכולים ללמוד איך להשתמש ב-AutoSxS באמצעות שלושה תרחישים לדוגמה.
השוואה בין מודלים
הערכת מודל צד ראשון (1p) שעבר כוונון בהשוואה למודל 1p לדוגמה.
אפשר לציין שההסקה תפעל בשני המודלים בו-זמנית.
דוגמת הקוד הזו מעריכה מודל מכוונן מ-Vertex Model Registry בהשוואה למודל עזר מאותו מרשם.
# Evaluation dataset schema:
#   my_question: str
#   my_context: str
parameters = {
    'evaluation_dataset': DATASET,
    'id_columns': ['my_context'],
    'task': 'question_answering',
    'autorater_prompt_parameters': {
      'inference_instruction': {'column': 'my_question'},
      'inference_context': {'column': 'my_context'},
  },
    'model_a': 'publishers/google/models/text-bison@002',
    'model_a_prompt_parameters': {QUESTION: {'template': '{{my_question}}\nCONTEXT: {{my_context}}'}},
  'response_column_a': 'content',
    'model_b': 'projects/abc/locations/abc/models/tuned_bison',
    'model_b_prompt_parameters': {'prompt': {'template': '{{my_context}}\n{{my_question}}'}},
  'response_column_b': 'content',
}
השוואה בין תחזיות
הערכת מודל מכוונן של צד שלישי (3p) בהשוואה למודל עזר של צד שלישי.
אפשר לדלג על ההסקה על ידי אספקת תשובות ישירות מהמודל.
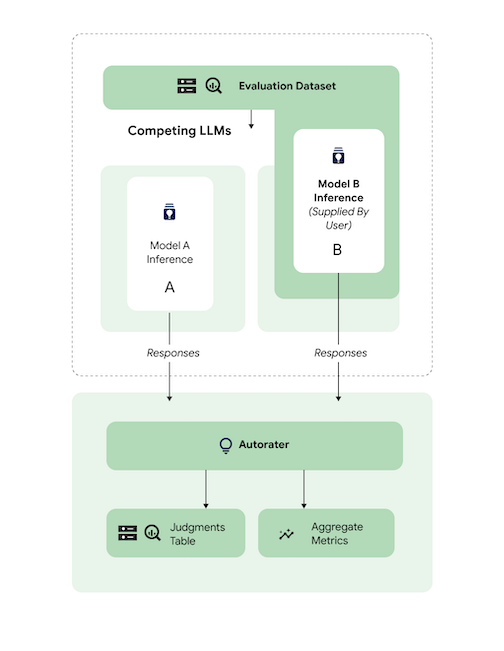
דוגמת הקוד הזו מעריכה מודל צד שלישי מכוונן בהשוואה למודל צד שלישי לדוגמה.
# Evaluation dataset schema:
#   my_question: str
#   my_context: str
#   response_b: str

parameters = {
    'evaluation_dataset': DATASET,
    'id_columns': ['my_context'],
    'task': 'question_answering',
    'autorater_prompt_parameters':
        'inference_instruction': {'column': 'my_question'},
        'inference_context': {'column': 'my_context'},
    },
    'response_column_a': 'content',
    'response_column_b': 'response_b',
}
בדיקת היישור
כל המשימות הנתמכות נבדקו באמצעות נתונים של בודקים אנושיים כדי לוודא שהתשובות של המערכת האוטומטית תואמות להעדפות של בני אדם. אם אתם רוצים להשוות את AutoSxS לתרחישים לדוגמה שלכם, אתם יכולים לספק נתונים על העדפות אנושיות ישירות ל-AutoSxS, שמפיק נתונים סטטיסטיים מצטברים של התאמה.
כדי לבדוק את ההתאמה לקבוצת נתונים של העדפות אנושיות, אפשר לציין את שני הפלטים (תוצאות החיזוי) למערכת הדירוג האוטומטי. אתם יכולים גם לספק את תוצאות ההסקה שלכם.
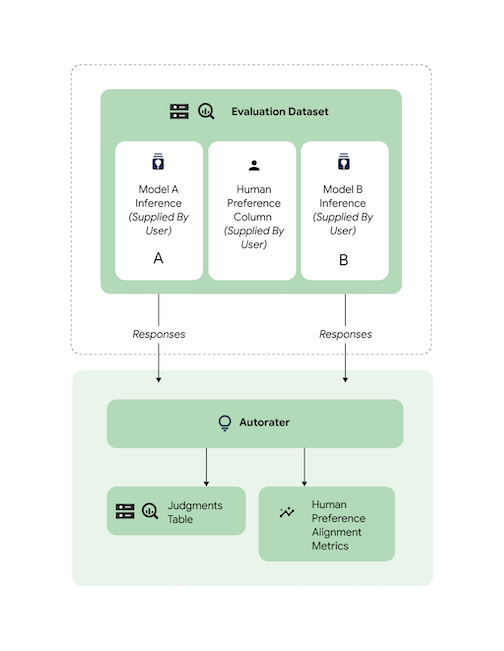
דוגמת הקוד הזו מאמתת שהתוצאות וההסברים של הדירוג האוטומטי תואמים לציפיות שלכם.
# Evaluation dataset schema:
#  my_question: str
#  my_context: str
#   response_a: str
#   response_b: str
#   actual: str
parameters = {
    'evaluation_dataset': DATASET,
    'id_columns': ['my_context'],
    'task': 'question_answering',
    'autorater_prompt_parameters': {
      'inference_instruction': {'column': 'my_question'},
      'inference_context': {'column': 'my_context'},
  },
  'response_column_a': 'response_a',
  'response_column_b': 'response_b',
  'human_preference_column': 'actual',
}
המאמרים הבאים
- מידע על הערכת AI גנרטיבי
- מידע ולמידה על הערכה אונליין באמצעות שירות הערכה ל-AI גנרטיבי
- איך מכווננים מודלים בסיסיים של שפה