


Il modello di incorporamenti multimodali genera vettori multidimensionali in base all'input che fornisci, che può includere una combinazione di dati di immagini, testo e video. I vettori di incorporamento possono quindi essere utilizzati per attività successive come la classificazione delle immagini o la moderazione dei contenuti video.
I vettori di incorporamento di immagini e text embedding si trovano nello stesso spazio semantico con la stessa dimensionalità. Di conseguenza, questi vettori possono essere utilizzati in modo intercambiabile per casi d'uso come la ricerca di immagini per testo o di video per immagine.
Per i casi d'uso di text embedding, ti consigliamo di utilizzare l'API di text embedding di Gemini Enterprise Agent Platform. Ad esempio, l'API Text Embedding potrebbe essere più adatta per la ricerca semantica basata su testo, il clustering, l'analisi di documenti in formato lungo e altri casi d'uso di recupero di testo o question answering. Per saperne di più, consulta Recuperare gli incorporamenti di testo.
Modelli supportati
Puoi ottenere incorporamenti multimodali utilizzando i seguenti modelli:
gemini-embedding-2multimodalembedding@001
Best practice
Quando utilizzi il modello di incorporamenti multimodali, considera i seguenti aspetti dell'input:
- Testo nelle immagini: il modello è in grado di distinguere il testo nelle immagini, in modo simile al riconoscimento ottico dei caratteri (OCR). Se devi distinguere tra una
descrizione dei contenuti dell'immagine e il testo all'interno di un'immagine, valuta la possibilità di
utilizzare il prompt engineering per specificare i contenuti di destinazione.
Ad esempio, invece di "gatto", specifica "foto di un gatto" o
"il testo 'gatto'", a seconda del caso d'uso.
il testo "gatto"
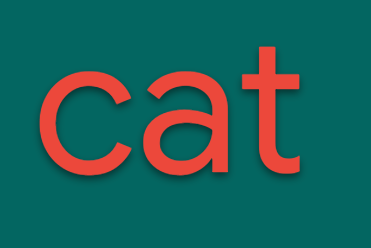
La parola "gatto" visualizzata con un carattere grande e in grassetto.
immagine di un gatto
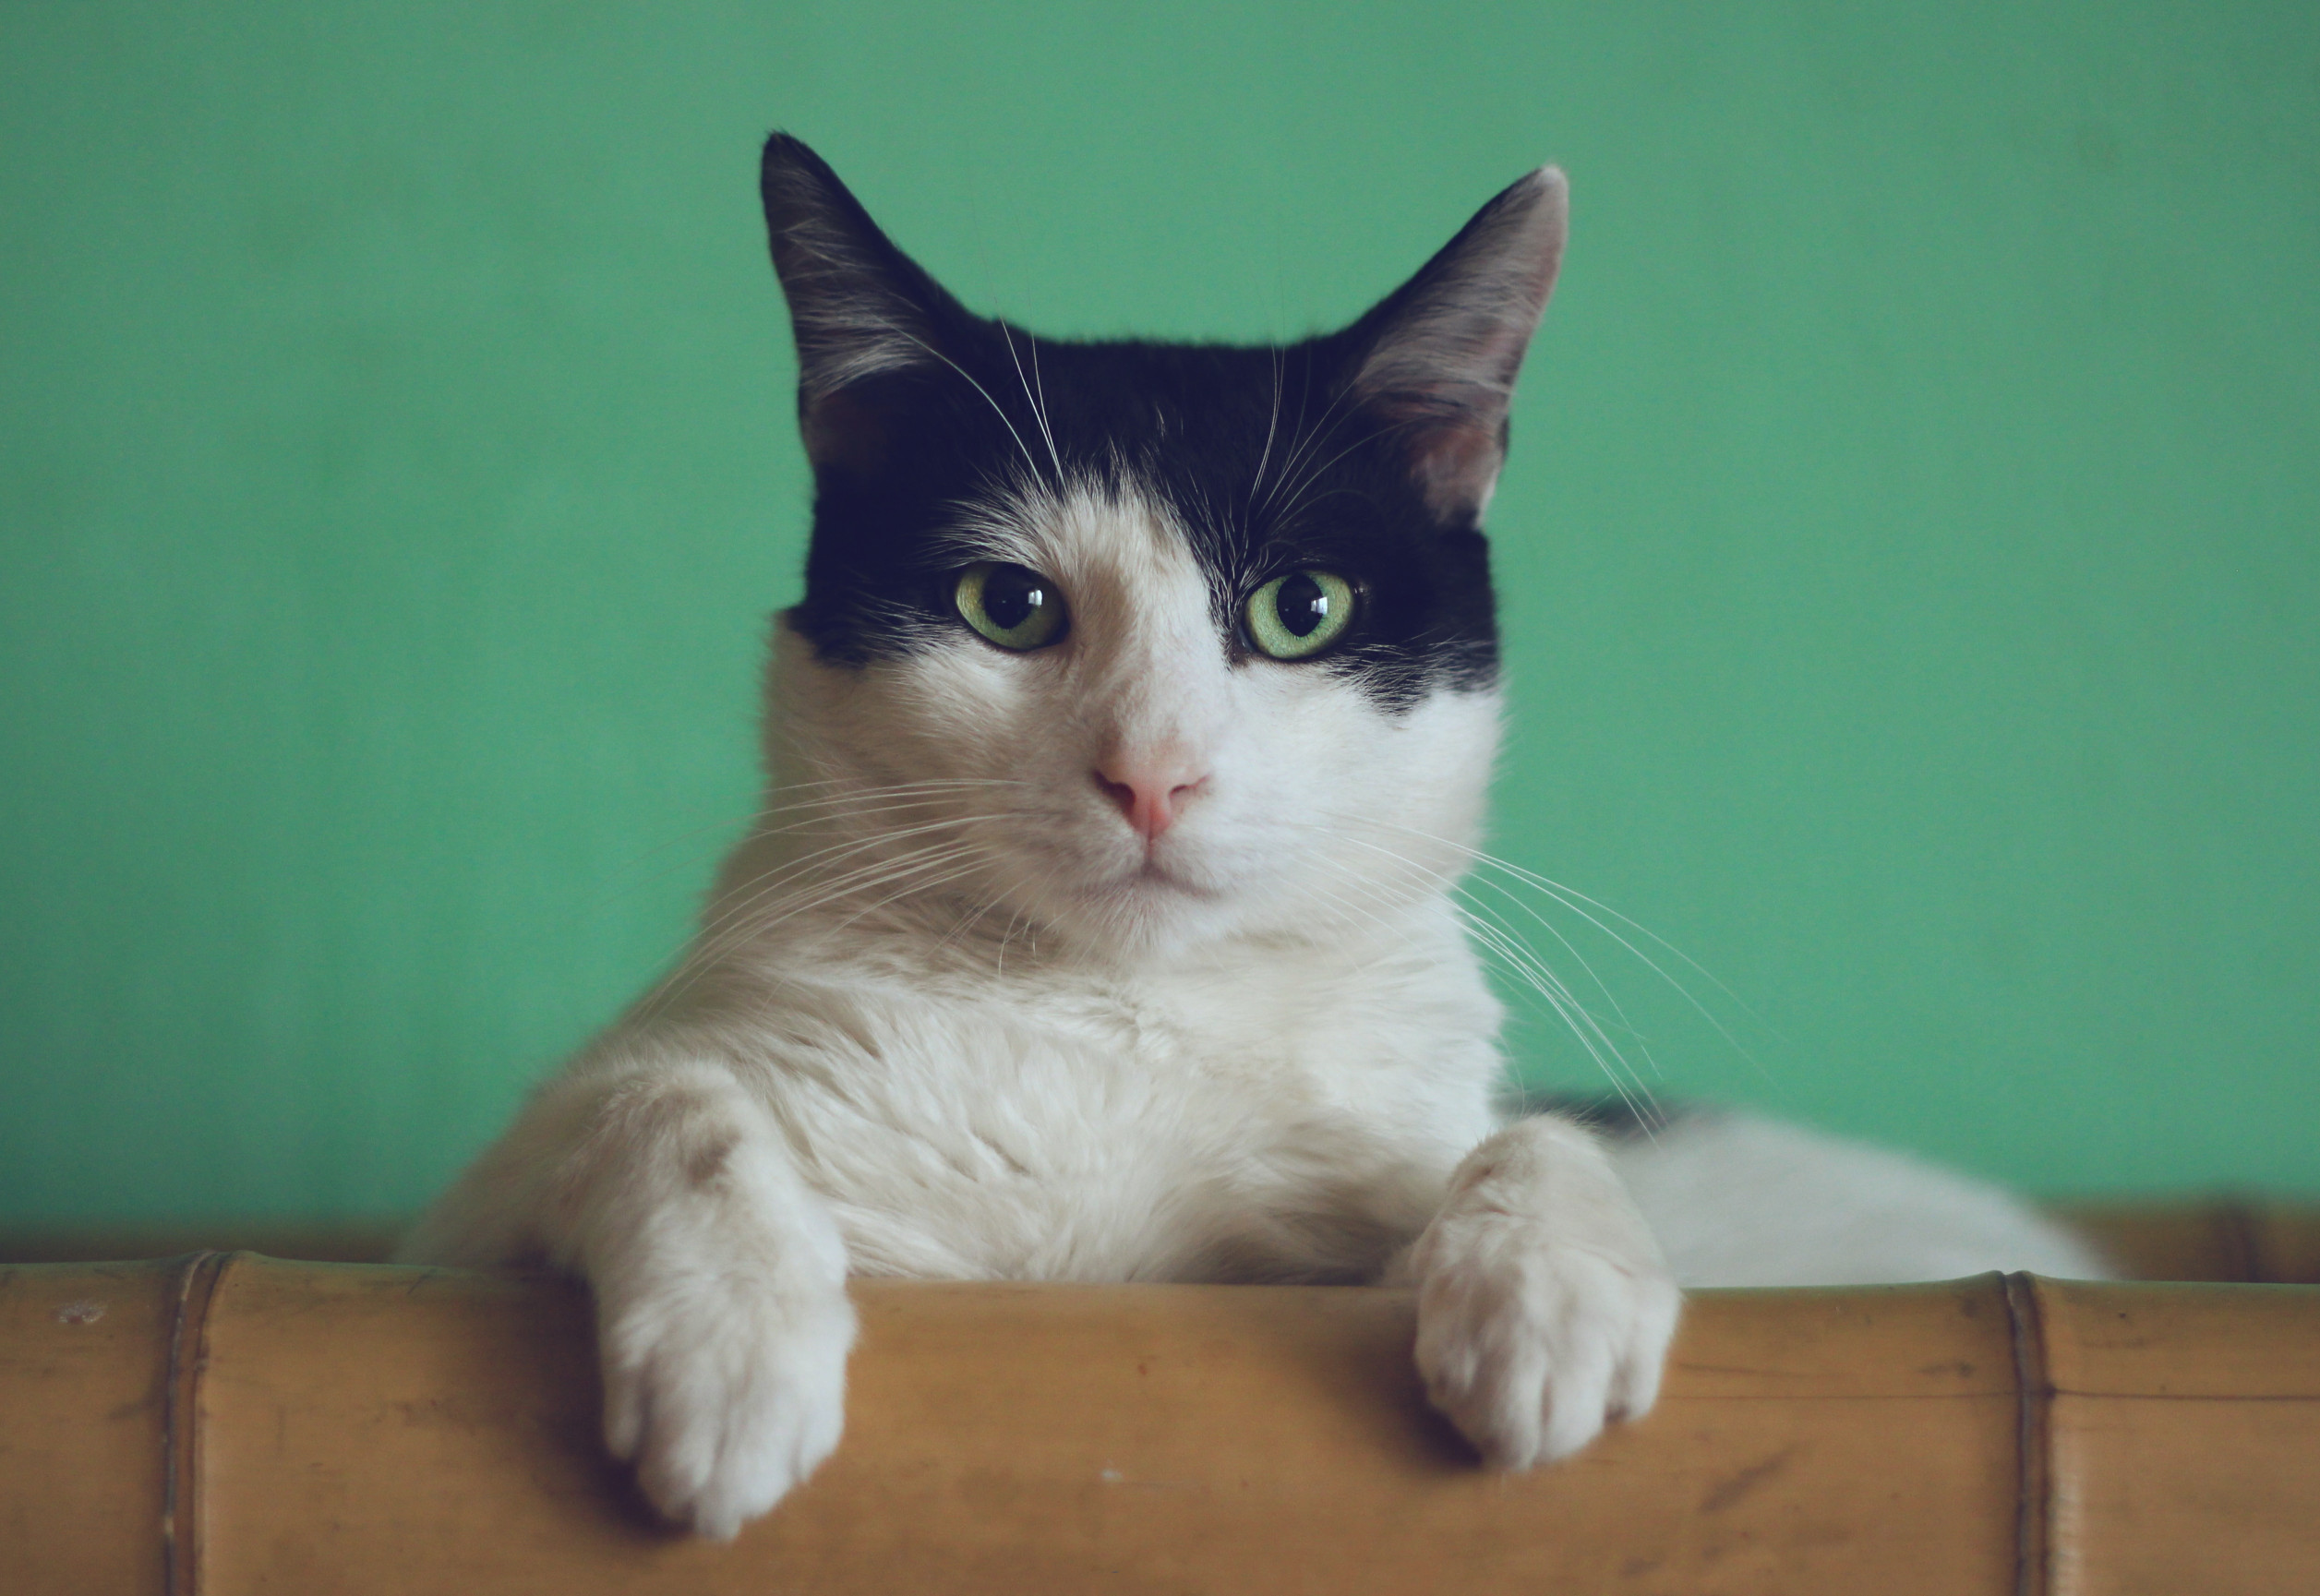
Crediti immagine: Manja Vitolic su Unsplash. - Somiglianze di incorporamento: il prodotto scalare degli incorporamenti non è una probabilità calibrata. Il prodotto scalare è una metrica di similarità e potrebbe avere distribuzioni di punteggio diverse per casi d'uso diversi. Di conseguenza, evita di utilizzare una soglia di valore fissa per misurare la qualità. Utilizza invece approcci di ranking per il recupero o la funzione sigmoidea per la classificazione.
Utilizza gemini-embedding-2
Il modello gemini-embedding-2 accetta input intercalati in modalità immagine, testo, documento, audio e video.
Specificare le istruzioni per l'attività per migliorare il rendimento
Puoi utilizzare gli incorporamenti per un'ampia gamma di attività, dalla classificazione alla ricerca di documenti. Specificare l'istruzione dell'attività corretta aiuta a ottimizzare gli incorporamenti per le relazioni previste, massimizzando l'accuratezza e l'efficienza.
Le tabelle seguenti mostrano esempi di formattazione di query e documenti per casi d'uso simmetrici e asimmetrici utilizzando il modello gemini-embedding-2.
Casi d'uso per il recupero (formato asimmetrico)
| Caso d'uso | Struttura della query | Struttura del documento |
|---|---|---|
| Query di ricerca | task: search result | query: {content} |
title: {title} | text: {content}Se non è presente un titolo, utilizza title: none. |
| Question answering | task: question answering | query: {content} |
title: {title} | text: {content} |
| Fact checking | task: fact checking | query: {content} |
title: {title} | text: {content} |
| Recupero del codice | task: code retrieval | query: {content} |
title: {title} | text: {content} |
Casi d'uso con un solo input (formato simmetrico)
| Caso d'uso | Struttura dell'input |
|---|---|
| Classificazione | task: classification | query: {content} |
| Clustering | task: clustering | query: {content} |
| Similarità semantica | task: sentence similarity | query: {content}Non utilizzare questo valore per la ricerca o il recupero. È destinato alla similarità semantica del testo. |
Esempio di utilizzo in Python
Python
# Generate embedding for a search query
def prepare_query(query):
    return f"task: search result | query: {query}"

# Generate embedding for a search document
def prepare_document(content, title=None):
    if title is None:
        title = "none"
    return f"title: {title} | text: {content}"

# Generate embedding for classification
def prepare_classification_input(content):
    return f"task: classification | query: {content}"
Utilizzo delle API
Limiti dell'API
Quando utilizzi il modello gemini-embedding-2, si applicano i seguenti limiti.
| Limite | Valore e descrizione |
|---|---|
| Dati di testo, immagini, documenti, video e audio | |
| Limite di token di input | 8192 token Gli input più lunghi di 8192 token vengono troncati automaticamente. Tutte le modalità condividono la finestra contestuale totale di 8192 token. I token vengono conteggiati nel modo seguente per modalità:
|
| Dimensionalità dell'output | 3072 (valore predefinito, configurabile utilizzando il parametro output_dimensionality) |
| Limiti per le immagini | 6 immagini per richiesta |
| Formati immagine | JPEG, PNG, WebP, BMP, HEIC, HEIF, AVIF |
| Dimensioni dell'immagine | Massimo 16384 x 16384 pixel per immagine |
| Limiti dei documenti | 1 file per richiesta, fino a 6 pagine Consigliamo vivamente 1 pagina per PDF per una qualità ottimale. |
| Formati dei documenti | |
| Dati video e audio | |
| Limiti per i video | 1 video per richiesta, fino a 120 frame Il limite di 120 secondi si basa sull'impostazione predefinita di 1 FPS. La durata varia quando imposti FPS diversi: Durata = 120 / FPS. Per impostazione predefinita, l'estrazione dell'audio è disattivata per il video. Quando l'opzione di estrazione della traccia audio è abilitata, la durata è soggetta alla durata audio massima di 180 secondi e la durata totale del video è limitata sia dal limite audio sia dalla finestra contestuale dei token (8192 token). |
| Formati video | Container: MOV, MP4. Codec: AV1, H264, H265, VP9. |
| Limiti audio | 180 secondi per richiesta Il supporto audio è ottimizzato per il parlato. L'audio ambientale e la musica potrebbero non essere riprodotti alla massima qualità. |
| Formati audio | MP3, WAV |
Durata del video con estrazione dell'audio
Poiché tutte le modalità condividono la finestra contestuale di 8192 token, la durata massima del video varia quando attivi audio_track_extraction:
| Modalità | Conteggio dei token |
|---|---|
| Audio | 25 token al secondo |
| Fotogramma video | 66 token per frame |
| Timestamp | 10 token al secondo (due timestamp al secondo formattati come "mm:ss") |
| FPS | Determinato dall'impostazione FPS (il valore predefinito è 1) |
La durata totale del video è limitata sia dal supporto audio massimo di 180 secondi sia dalla finestra contestuale di 8192 token.
Esempio di calcolo:
Se elabori un video con una frequenza di campionamento predefinita di 1 FPS e attivi l'estrazione audio:
- Tasso di consumo: ogni secondo di video consuma 66 token (1 frame) + 25 token (1 secondo di audio) + 10 token (timestamp) = 101 token.
- Durata massima: con un limite di 8192 token, la durata massima è circa 8192 / 101 ≈ 81 secondi.
Se l'input supera la finestra contestuale, la parte eccedente verrà troncata senza alcuna segnalazione.
Ottenere embedding multimodali
REST
PROJECT_ID="YOUR_PROJECT_ID"
LOCATION="us"

curl -X POST \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://aiplatform.${LOCATION}.rep.googleapis.com/v1/projects/${PROJECT_ID}/locations/${LOCATION}/publishers/google/models/gemini-embedding-2:embedContent" \
  -d '{
  "content": {
    "parts": [
      {
        "text": "Whats this"
      },
      {
        "file_data": {
          "mime_type": "video/mp4",
          "file_uri": "gs://cloud-samples-data/generative-ai/video/pixel8.mp4"
        }
      }
    ]
  }
}'
Python
from google import genai
from google.genai import types

# Initialize the client.
client = genai.Client(vertexai=True, project="YOUR_PROJECT_ID", location="us")

content = types.Content(
    parts=[
        types.Part.from_text(text="Audio AI"),
        types.Part.from_uri(
            file_uri="gs://cloud-samples-data/generative-ai/audio/Chirp-3-Docs-Dive.mp3",
            mime_type="audio/mpeg",
        ),
    ],
)

response = client.models.embed_content(
    model="gemini-embedding-2",
    contents=[content]
)

print(response.embeddings[0].values)
Località
Una località è una regione che puoi specificare in una richiesta per controllare dove vengono archiviati i dati a riposo. Per un elenco delle regioni disponibili, consulta Località di Agent Platform.
Quote
Per controllare il limite di quota per gemini-embedding-2, consulta Quote e limiti di sistema dell'AI generativa su Gemini Enterprise Agent Platform.
Dimensioni
Quando utilizzi il modello gemini-embedding-2, puoi specificare dimensioni inferiori utilizzando il parametro output_dimensionality in EmbedContentConfig.
L'esempio seguente restituisce un vettore 128-dimensionale. Per
gemini-embedding-2, gli incorporamenti di output sono già normalizzati L2
per le dimensioni non predefinite (a differenza di gemini-embedding-001).
Python
import numpy as np
from google import genai
from google.genai import types

# Initialize the client.
client = genai.Client(vertexai=True, project="YOUR_PROJECT_ID", location="us")

content = types.Content(
    parts=[
        types.Part.from_uri(
            file_uri="gs://cloud-samples-data/generative-ai/audio/Chirp-3-Docs-Dive.mp3",
            mime_type="audio/mpeg",
        ),
    ],
)

response = client.models.embed_content(
    model="gemini-embedding-2",
    contents=[content],
    config=types.EmbedContentConfig(output_dimensionality=128),
)

embedding_values_np = np.array(response.embeddings[0].values)

print(f"Embedding length: {len(embedding_values_np)}")
print(f"Norm of embedding: {np.linalg.norm(embedding_values_np):.6f}") # Should be very close to 1
Parametri
La frequenza di campionamento video predefinita è di 1 frame al secondo (FPS). È possibile aggiungere parametri
aggiuntivi utilizzando video_metadata:
Python
from google import genai
from google.genai import types

# Initialize the client.
client = genai.Client(vertexai=True, project="YOUR_PROJECT_ID", location="us")

content = types.Content(
    parts=[
        types.Part(
            file_data=types.FileData(
                file_uri="gs://cloud-samples-data/generative-ai/video/pixel8.mp4",
                mime_type="video/mp4",
            ),
            video_metadata=types.VideoMetadata(
                fps=0.5,
                start_offset="10s",
                end_offset="20s",
            ),
        ),
    ]
)

response = client.models.embed_content(
    model="gemini-embedding-2",
    contents=[content]
)

print(response.embeddings[0].values)
In EmbedContentConfig sono disponibili altre opzioni.
| Opzione | Tipo | Descrizione |
|---|---|---|
output_dimensionality |
int |
Ridurre la dimensionalità dell'incorporamento dell'output. |
document_ocr |
bool |
Attiva l'OCR per l'input dei documenti. |
audio_track_extraction |
bool |
Estrai l'audio dall'input video. |
Utilizza multimodalembedding@001
Quando utilizzi il modello multimodalembedding@001
per gli incorporamenti di testo e immagini, si applicano i seguenti limiti:
| Limite | Valore e descrizione |
|---|---|
| Dati di testo e immagini | |
| Numero massimo di richieste API al minuto per progetto | 120-600 a seconda della regione |
| Lunghezza massima del testo | 32 token (~32 parole) La lunghezza massima del testo è di 32 token (circa 32 parole). Se l'input supera i 32 token, il modello lo accorcia internamente a questa lunghezza. |
| Lingua | Inglese |
| Formati immagine | BMP, GIF, JPG, PNG |
| Dimensioni dell'immagine | Immagini con codifica base64: 20 MB (dopo la transcodifica in PNG) Immagini di Cloud Storage: 20 MB (formato file originale) La dimensione massima dell'immagine accettata è 20 MB. Per evitare un aumento della latenza di rete, utilizza immagini più piccole. Inoltre, il modello ridimensiona le immagini a una risoluzione di 512 x 512 pixel. Di conseguenza, non è necessario fornire immagini a risoluzione più elevata. |
| Dati video | |
| Audio supportato | N/A: il modello non prende in considerazione i contenuti audio durante la generazione degli incorporamenti video |
| Formati video | AVI, FLV, MKV, MOV, MP4, MPEG, MPG, WEBM e WMV |
| Durata massima del video (Cloud Storage) | Nessun limite. Tuttavia, è possibile analizzare solo 2 minuti di contenuti alla volta. |
Prima di iniziare
- Accedi al tuo account Google Cloud . Se non conosci Google Cloud, crea un account per valutare le prestazioni dei nostri prodotti in scenari reali. I nuovi clienti ricevono anche 300 $di crediti senza costi per l'esecuzione, il test e il deployment dei carichi di lavoro.
-
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
-
Verify that billing is enabled for your Google Cloud project.
Enable the Gemini Enterprise Agent Platform API.
Roles required to enable APIs
To enable APIs, you need the
serviceusage.services.enablepermission. If you created the project, then you likely already have this permission through the Owner role (roles/owner). Otherwise, you can get this permission through the Service Usage Admin role (roles/serviceusage.serviceUsageAdmin). Learn how to grant roles.-
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
-
Verify that billing is enabled for your Google Cloud project.
Enable the Gemini Enterprise Agent Platform API.
Roles required to enable APIs
To enable APIs, you need the
serviceusage.services.enablepermission. If you created the project, then you likely already have this permission through the Owner role (roles/owner). Otherwise, you can get this permission through the Service Usage Admin role (roles/serviceusage.serviceUsageAdmin). Learn how to grant roles.-
Configura l'autenticazione per il tuo ambiente.
Seleziona la scheda relativa a come prevedi di utilizzare gli esempi in questa pagina:
Java
Per utilizzare gli esempi Java in questa pagina in un ambiente di sviluppo locale, installa e inizializza gcloud CLI, quindi configura Credenziali predefinite dell'applicazione con le tue credenziali utente.
-
Installa Google Cloud CLI.
-
Se utilizzi un provider di identità (IdP) esterno, devi prima accedere a gcloud CLI con la tua identità federata.
-
Dopo aver inizializzato gcloud CLI, aggiornala e installa i componenti richiesti:
gcloud components update
gcloud components install beta
-
Se utilizzi una shell locale, crea le credenziali di autenticazione locali per il tuo account utente:
gcloud auth application-default login
Non è necessario eseguire questa operazione se utilizzi Cloud Shell.
Se viene restituito un errore di autenticazione e utilizzi un provider di identità (IdP) esterno, verifica di aver acceduto a gcloud CLI con la tua identità federata.
Per saperne di più, consulta Configura ADC per un ambiente di sviluppo locale nella documentazione sull'autenticazione di Google Cloud .
Node.js
Per utilizzare gli esempi di Node.js in questa pagina in un ambiente di sviluppo locale, installa e inizializza gcloud CLI, quindi configura Credenziali predefinite dell'applicazione con le tue credenziali utente.
-
Installa Google Cloud CLI.
-
Se utilizzi un provider di identità (IdP) esterno, devi prima accedere a gcloud CLI con la tua identità federata.
-
Dopo aver inizializzato gcloud CLI, aggiornala e installa i componenti richiesti:
gcloud components update
gcloud components install beta
-
Se utilizzi una shell locale, crea le credenziali di autenticazione locali per il tuo account utente:
gcloud auth application-default login
Non è necessario eseguire questa operazione se utilizzi Cloud Shell.
Se viene restituito un errore di autenticazione e utilizzi un provider di identità (IdP) esterno, verifica di aver acceduto a gcloud CLI con la tua identità federata.
Per saperne di più, consulta Configura ADC per un ambiente di sviluppo locale nella documentazione sull'autenticazione di Google Cloud .
Python
Per utilizzare gli esempi di Python in questa pagina in un ambiente di sviluppo locale, installa e inizializza gcloud CLI, quindi configura Credenziali predefinite dell'applicazione con le tue credenziali utente.
-
Installa Google Cloud CLI.
-
Se utilizzi un provider di identità (IdP) esterno, devi prima accedere a gcloud CLI con la tua identità federata.
-
Dopo aver inizializzato gcloud CLI, aggiornala e installa i componenti richiesti:
gcloud components update
gcloud components install beta
-
Se utilizzi una shell locale, crea le credenziali di autenticazione locali per il tuo account utente:
gcloud auth application-default login
Non è necessario eseguire questa operazione se utilizzi Cloud Shell.
Se viene restituito un errore di autenticazione e utilizzi un provider di identità (IdP) esterno, verifica di aver acceduto a gcloud CLI con la tua identità federata.
Per saperne di più, consulta Configura ADC per un ambiente di sviluppo locale nella documentazione sull'autenticazione di Google Cloud .
REST
Per utilizzare gli esempi di API REST in questa pagina in un ambiente di sviluppo locale, utilizzi le credenziali che fornisci a gcloud CLI.
-
Installa Google Cloud CLI.
-
Se utilizzi un provider di identità (IdP) esterno, devi prima accedere a gcloud CLI con la tua identità federata.
-
Dopo aver inizializzato gcloud CLI, aggiornala e installa i componenti richiesti:
gcloud components update
gcloud components install beta
Per saperne di più, consulta Autenticati per usare REST nella documentazione sull'autenticazione di Google Cloud .
-
- Per utilizzare l'SDK Python, segui le istruzioni riportate in Installare l'SDK Agent Platform per Python. Per saperne di più, consulta la documentazione di riferimento dell'API Python dell'SDK Agent Platform.
- Facoltativo. Consulta i prezzi di questa funzionalità. I prezzi per gli incorporamenti dipendono dal tipo di dati che invii (ad esempio immagini o testo) e anche dalla modalità che utilizzi per determinati tipi di dati (ad esempio Video Plus, Video Standard o Video Essential).
Località
Una località è una regione che puoi specificare in una richiesta per controllare dove vengono archiviati i dati a riposo. Per un elenco delle regioni disponibili, consulta Località di Agent Platform.
Messaggi di errore
Questa sezione descrive i messaggi di errore comuni che potresti riscontrare.
Errore di superamento della quota
google.api_core.exceptions.ResourceExhausted: 429 Quota exceeded for
aiplatform.googleapis.com/online_prediction_requests_per_base_model with base
model: multimodalembedding. Please submit a quota increase request.
Se è la prima volta che ricevi questo errore, utilizza la console Google Cloud per richiedere una modifica della quota per il tuo progetto. Utilizza i seguenti filtri prima di richiedere l'aggiustamento:
Service ID: aiplatform.googleapis.commetric: aiplatform.googleapis.com/online_prediction_requests_per_base_modelbase_model:multimodalembedding
Se hai già inviato una richiesta di aggiustamento della quota, attendi prima di inviarne un'altra. Se devi aumentare ulteriormente la quota, ripeti la richiesta di aggiustamento della quota con la giustificazione per un aggiustamento della quota sostenuto.
Specifica gli embedding a dimensioni inferiori
A seconda del modello utilizzato, una richiesta di embedding restituisce un vettore float di 1408 o un vettore float di 3072. Puoi specificare incorporamenti di dimensioni inferiori per i dati di testo e immagine per ottimizzare la latenza e l'archiviazione o la qualità. Gli incorporamenti di dimensioni inferiori riducono le esigenze di archiviazione e forniscono una latenza inferiore per le successive attività di incorporamento (come la ricerca o i suggerimenti). Gli incorporamenti con più dimensioni offrono una maggiore precisione per queste attività, ma con esigenze di archiviazione e latenza più elevate.
La tabella seguente mostra le dimensioni predefinite e quelle inferiori disponibili per ogni modello:
| Modello | Dimensioni predefinite (priorità più alta) | Dimensioni supportate (intervallo) | Dimensioni inferiori consigliate |
|---|---|---|---|
gemini-embedding-2 |
3072 | 128-3072 | 128, 768 o 1536 |
multimodalembedding@001 |
1408 | 128-1408 | 128, 256 o 512 |
Utilizza i seguenti esempi per generare incorporamenti con dimensioni inferiori:
REST
È possibile accedere alle dimensioni inferiori aggiungendo il campo parameters.dimension.
Il parametro accetta uno qualsiasi dei valori di dimensione disponibili per il modello.
Ad esempio, puoi specificare 128, 256, 512 o 1408 quando utilizzi
il modello multimodalembedding@001. La risposta include l'incorporamento della dimensione specificata.
Prima di utilizzare i dati della richiesta, apporta le sostituzioni seguenti:
- PROJECT_ID: il tuo Google Cloud ID progetto.
-
IMAGE_URI: l'URI Cloud Storage dell'immagine di destinazione per cui ottenere
gli incorporamenti. Ad esempio,
gs://my-bucket/embeddings/supermarket-img.png.Puoi anche fornire l'immagine come stringa di byte con codifica base64:
[...] "image": { "bytesBase64Encoded": "B64_ENCODED_IMAGE" } [...] -
TEXT: il testo di destinazione per cui ottenere gli embedding. Ad esempio,
a
      cat
. -
EMBEDDING_DIMENSION: Il numero di dimensioni dell'incorporamento. Valori
più bassi offrono una latenza ridotta quando questi incorporamenti vengono utilizzati per attività
successive, mentre valori più alti offrono una maggiore precisione. Valori disponibili:
128,256,512e1408(impostazione predefinita).
Metodo HTTP e URL:
POST https://LOCATION-aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/LOCATION/publishers/google/models/multimodalembedding@001:predict
Corpo JSON della richiesta:
{
  "instances": [
    {
      "image": {
        "gcsUri": "IMAGE_URI"
      },
      "text": "TEXT"
    }
  ],
  "parameters": {
    "dimension": EMBEDDING_DIMENSION
  }
}
Per inviare la richiesta, scegli una di queste opzioni:
curl
Salva il corpo della richiesta in un file denominato request.json,
quindi esegui il comando seguente:
curl -X POST \
     -H "Authorization: Bearer $(gcloud auth print-access-token)" \
     -H "Content-Type: application/json; charset=utf-8" \
     -d @request.json \
     "https://LOCATION-aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/LOCATION/publishers/google/models/multimodalembedding@001:predict"
PowerShell
Salva il corpo della richiesta in un file denominato request.json,
quindi esegui il comando seguente:
$cred = gcloud auth print-access-token
$headers = @{ "Authorization" = "Bearer $cred" }

Invoke-WebRequest `
    -Method POST `
    -Headers $headers `
    -ContentType: "application/json; charset=utf-8" `
    -InFile request.json `
    -Uri "https://LOCATION-aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/LOCATION/publishers/google/models/multimodalembedding@001:predict" | Select-Object -Expand Content
Dimensioni 128:
{
  "predictions": [
    {
      "imageEmbedding": [
        0.0279239565,
        [...128 dimension vector...]
        0.00403284049
      ],
      "textEmbedding": [
        0.202921599,
        [...128 dimension vector...]
        -0.0365431122
      ]
    }
  ],
  "deployedModelId": "DEPLOYED_MODEL_ID"
}
256 dimensioni:
{
  "predictions": [
    {
      "imageEmbedding": [
        0.248620048,
        [...256 dimension vector...]
        -0.0646447465
      ],
      "textEmbedding": [
        0.0757875815,
        [...256 dimension vector...]
        -0.02749932
      ]
    }
  ],
  "deployedModelId": "DEPLOYED_MODEL_ID"
}
Dimensioni 512:
{
  "predictions": [
    {
      "imageEmbedding": [
        -0.0523675755,
        [...512 dimension vector...]
        -0.0444030389
      ],
      "textEmbedding": [
        -0.0592851527,
        [...512 dimension vector...]
        0.0350437127
      ]
    }
  ],
  "deployedModelId": "DEPLOYED_MODEL_ID"
}
Python
Go
Recuperare gli embedding di immagini e testo (multimodalembedding@001)
Utilizza i seguenti esempi di codice per inviare una richiesta di incorporamento con dati di immagini e testo. Gli esempi mostrano come inviare una richiesta con entrambi i tipi di dati, ma puoi utilizzare il servizio anche con un singolo tipo di dati.
Ottenere incorporamenti di testo e immagini
REST
Prima di utilizzare i dati della richiesta, apporta le sostituzioni seguenti:
- PROJECT_ID: il tuo Google Cloud ID progetto.
-
TEXT: il testo di destinazione per cui ottenere gli embedding. Ad esempio,
a
      cat
. - B64_ENCODED_IMG: L'immagine di destinazione per cui ottenere gli incorporamenti. L'immagine deve essere specificata come stringa di byte con codifica base64.
Metodo HTTP e URL:
POST https://LOCATION-aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/LOCATION/publishers/google/models/multimodalembedding@001:predict
Corpo JSON della richiesta:
{
  "instances": [
    {
      "text": "TEXT",
      "image": {
        "bytesBase64Encoded": "B64_ENCODED_IMG"
      }
    }
  ]
}
Per inviare la richiesta, scegli una di queste opzioni:
curl
Salva il corpo della richiesta in un file denominato request.json,
quindi esegui il comando seguente:
curl -X POST \
     -H "Authorization: Bearer $(gcloud auth print-access-token)" \
     -H "Content-Type: application/json; charset=utf-8" \
     -d @request.json \
     "https://LOCATION-aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/LOCATION/publishers/google/models/multimodalembedding@001:predict"
PowerShell
Salva il corpo della richiesta in un file denominato request.json,
quindi esegui il comando seguente:
$cred = gcloud auth print-access-token
$headers = @{ "Authorization" = "Bearer $cred" }

Invoke-WebRequest `
    -Method POST `
    -Headers $headers `
    -ContentType: "application/json; charset=utf-8" `
    -InFile request.json `
    -Uri "https://LOCATION-aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/LOCATION/publishers/google/models/multimodalembedding@001:predict" | Select-Object -Expand Content
{
  "predictions": [
    {
      "textEmbedding": [
        0.010477379,
        -0.00399621,
        0.00576670747,
        [...]
        -0.00823613815,
        -0.0169572588,
        -0.00472954148
      ],
      "imageEmbedding": [
        0.00262696808,
        -0.00198890246,
        0.0152047109,
        -0.0103145819,
        [...]
        0.0324628279,
        0.0284924973,
        0.011650892,
        -0.00452344026
      ]
    }
  ],
  "deployedModelId": "DEPLOYED_MODEL_ID"
}
Python
Per scoprire come installare o aggiornare l'SDK Vertex AI Python, consulta Installare l'SDK Vertex AI Python. Per saperne di più, consulta la Python documentazione di riferimento dell'API.
Node.js
Prima di provare questo esempio, segui le istruzioni di configurazione di Node.js nella guida rapida di Agent Platform per l'utilizzo delle librerie client. Per saperne di più, consulta la documentazione di riferimento dell'API Agent Platform Node.js.
Per eseguire l'autenticazione in Agent Platform, configura le Credenziali predefinite dell'applicazione. Per saperne di più, consulta Configura l'autenticazione per un ambiente di sviluppo locale.
Java
Prima di provare questo esempio, segui le istruzioni di configurazione di Java nella guida rapida di Agent Platform per l'utilizzo delle librerie client. Per saperne di più, consulta la documentazione di riferimento dell'API Agent Platform Java.
Per eseguire l'autenticazione in Agent Platform, configura le Credenziali predefinite dell'applicazione. Per saperne di più, consulta Configura l'autenticazione per un ambiente di sviluppo locale.
Go
Prima di provare questo esempio, segui le istruzioni di configurazione di Go nella guida rapida di Agent Platform per l'utilizzo delle librerie client. Per saperne di più, consulta la documentazione di riferimento dell'API Agent Platform Go.
Per eseguire l'autenticazione in Agent Platform, configura le Credenziali predefinite dell'applicazione. Per saperne di più, consulta Configura l'autenticazione per un ambiente di sviluppo locale.
Recuperare gli embedding di video, immagini o testo (multimodalembedding@001)
Quando invii una richiesta di incorporamento, puoi specificare un solo video di input oppure una combinazione di dati video, immagine e testo.
Modalità di incorporamento dei video
Esistono tre modalità che puoi utilizzare con gli incorporamenti video: Essenziale, Standard o
Plus. La modalità corrisponde alla densità degli incorporamenti generati, che può essere specificata dalla configurazione interval_sec nella richiesta. Per ogni intervallo
video di lunghezza interval_sec, viene generato un incorporamento. La durata minima
dell'intervallo tra i video è di 4 secondi. Durate dell'intervallo superiori a 120 secondi
potrebbero influire negativamente sulla qualità degli incorporamenti generati.
Il prezzo per l'incorporamento dei video dipende dalla modalità utilizzata. Per ulteriori informazioni, consulta la sezione Prezzi.
La seguente tabella riassume le tre modalità che puoi utilizzare per l'incorporamento dei video:
| Modalità | Numero massimo di incorporamenti al minuto | Intervallo di incorporamento video (valore minimo) |
|---|---|---|
| Essential | 4 | 15 Corrisponde a: intervalSec >= 15 |
| Standard | 8 | 8 Corrisponde a: 8 <= intervalSec < 15 |
| Plus | 15 | 4 Corrisponde a: 4 <= intervalSec < 8 |
Best practice per gli incorporamenti video
Quando invii richieste di incorporamento di video, tieni presente quanto segue:
Per generare un singolo embedding per i primi due minuti di un video di input di qualsiasi durata, utilizza la seguente impostazione
videoSegmentConfig:request.json:// other request body content "videoSegmentConfig": { "intervalSec": 120 } // other request body contentPer generare l'incorporamento di un video di durata superiore a due minuti, puoi inviare più richieste che specificano l'ora di inizio e di fine in
videoSegmentConfig:request1.json:// other request body content "videoSegmentConfig": { "startOffsetSec": 0, "endOffsetSec": 120 } // other request body contentrequest2.json:// other request body content "videoSegmentConfig": { "startOffsetSec": 120, "endOffsetSec": 240 } // other request body contentOttenere gli incorporamenti dei video
Utilizza il seguente esempio per ottenere gli incorporamenti solo per i contenuti video.
REST
L'esempio seguente utilizza un video archiviato in Cloud Storage. Puoi anche utilizzare il campo video.bytesBase64Encoded per fornire una rappresentazione di stringa con codifica Base64 del video.
Prima di utilizzare i dati della richiesta, apporta le sostituzioni seguenti:
- PROJECT_ID: il tuo Google Cloud ID progetto.
-
VIDEO_URI: l'URI Cloud Storage del video di destinazione per cui ottenere
i contenuti incorporati. Ad esempio,
gs://my-bucket/embeddings/supermarket-video.mp4.Puoi anche fornire il video come stringa di byte con codifica base64:
[...] "video": { "bytesBase64Encoded": "B64_ENCODED_VIDEO" } [...] -
videoSegmentConfig(START_SECOND, END_SECOND, INTERVAL_SECONDS). Facoltativo. I segmenti video specifici (in secondi) per cui vengono generati gli incorporamenti.Ad esempio:
[...]
"videoSegmentConfig": {
  "startOffsetSec": 10,
  "endOffsetSec": 60,
  "intervalSec": 10
}
[...]
L'utilizzo di questa configurazione specifica i dati video da 10 a 60 secondi e genera incorporamenti per i seguenti intervalli video di 10 secondi: [10, 20), [20, 30), [30, 40), [40, 50), [50, 60). Questo intervallo video (
"intervalSec": 10) rientra nella modalità di incorporamento video standard e ti viene addebitata la tariffa della modalità Standard.Se ometti
videoSegmentConfig, il servizio utilizza i seguenti valori predefiniti:"videoSegmentConfig": { "startOffsetSec": 0, "endOffsetSec": 120, "intervalSec": 16 }. Questo intervallo video ("intervalSec": 16) rientra nella modalità di incorporamento video essenziale e all'utente viene addebitata la tariffa della modalità essenziale.
Metodo HTTP e URL:
POST https://LOCATION-aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/LOCATION/publishers/google/models/multimodalembedding@001:predict
Corpo JSON della richiesta:
{
  "instances": [
    {
      "video": {
        "gcsUri": "VIDEO_URI",
        "videoSegmentConfig": {
          "startOffsetSec": START_SECOND,
          "endOffsetSec": END_SECOND,
          "intervalSec": INTERVAL_SECONDS
        }
      }
    }
  ]
}
Per inviare la richiesta, scegli una di queste opzioni:
curl
Salva il corpo della richiesta in un file denominato request.json,
quindi esegui il comando seguente:
curl -X POST \
     -H "Authorization: Bearer $(gcloud auth print-access-token)" \
     -H "Content-Type: application/json; charset=utf-8" \
     -d @request.json \
     "https://LOCATION-aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/LOCATION/publishers/google/models/multimodalembedding@001:predict"
PowerShell
Salva il corpo della richiesta in un file denominato request.json,
quindi esegui il comando seguente:
$cred = gcloud auth print-access-token
$headers = @{ "Authorization" = "Bearer $cred" }

Invoke-WebRequest `
    -Method POST `
    -Headers $headers `
    -ContentType: "application/json; charset=utf-8" `
    -InFile request.json `
    -Uri "https://LOCATION-aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/LOCATION/publishers/google/models/multimodalembedding@001:predict" | Select-Object -Expand Content
Risposta (video di 7 secondi, nessun videoSegmentConfig specificato):
{
  "predictions": [
    {
      "videoEmbeddings": [
        {
          "endOffsetSec": 7,
          "embedding": [
            -0.0045467657,
            0.0258095954,
            0.0146885719,
            0.00945400633,
            [...]
            -0.0023291884,
            -0.00493789,
            0.00975185353,
            0.0168156829
          ],
          "startOffsetSec": 0
        }
      ]
    }
  ],
  "deployedModelId": "DEPLOYED_MODEL_ID"
}
Risposta (video di 59 secondi, con la seguente configurazione del segmento video: "videoSegmentConfig": { "startOffsetSec": 0, "endOffsetSec": 60, "intervalSec": 10 }):
{
  "predictions": [
    {
      "videoEmbeddings": [
        {
          "endOffsetSec": 10,
          "startOffsetSec": 0,
          "embedding": [
            -0.00683252793,
            0.0390476175,
            [...]
            0.00657121744,
            0.013023301
          ]
        },
        {
          "startOffsetSec": 10,
          "endOffsetSec": 20,
          "embedding": [
            -0.0104404651,
            0.0357737206,
            [...]
            0.00509833824,
            0.0131902946
          ]
        },
        {
          "startOffsetSec": 20,
          "embedding": [
            -0.0113538112,
            0.0305239167,
            [...]
            -0.00195809244,
            0.00941874553
          ],
          "endOffsetSec": 30
        },
        {
          "embedding": [
            -0.00299320649,
            0.0322436653,
            [...]
            -0.00993082579,
            0.00968887936
          ],
          "startOffsetSec": 30,
          "endOffsetSec": 40
        },
        {
          "endOffsetSec": 50,
          "startOffsetSec": 40,
          "embedding": [
            -0.00591270532,
            0.0368893594,
            [...]
            -0.00219071587,
            0.0042470959
          ]
        },
        {
          "embedding": [
            -0.00458270218,
            0.0368121453,
            [...]
            -0.00317760976,
            0.00595594104
          ],
          "endOffsetSec": 59,
          "startOffsetSec": 50
        }
      ]
    }
  ],
  "deployedModelId": "DEPLOYED_MODEL_ID"
}
Python
Per scoprire come installare o aggiornare l'SDK Vertex AI Python, consulta Installare l'SDK Vertex AI Python. Per saperne di più, consulta la Python documentazione di riferimento dell'API.
Go
Prima di provare questo esempio, segui le istruzioni di configurazione di Go nella guida rapida di Agent Platform per l'utilizzo delle librerie client. Per saperne di più, consulta la documentazione di riferimento dell'API Agent Platform Go.
Per eseguire l'autenticazione in Agent Platform, configura le Credenziali predefinite dell'applicazione. Per saperne di più, consulta Configura l'autenticazione per un ambiente di sviluppo locale.
Ottenere incorporamenti di immagini, testo e video
Utilizza il seguente esempio per ottenere gli embedding per i contenuti video, di testo e delle immagini.
REST
L'esempio seguente utilizza dati di immagine, testo e video. Puoi utilizzare qualsiasi combinazione di questi tipi di dati nel corpo della richiesta.
Inoltre, questo
esempio utilizza un video archiviato in Cloud Storage. Puoi anche utilizzare il campo video.bytesBase64Encoded per fornire una rappresentazione di stringa con codifica Base64 del video.
Prima di utilizzare i dati della richiesta, apporta le sostituzioni seguenti:
- PROJECT_ID: il tuo Google Cloud ID progetto.
-
TEXT: il testo di destinazione per cui ottenere gli embedding. Ad esempio,
a
      cat
. -
IMAGE_URI: l'URI Cloud Storage dell'immagine di destinazione per cui ottenere
gli incorporamenti. Ad esempio,
gs://my-bucket/embeddings/supermarket-img.png.Puoi anche fornire l'immagine come stringa di byte con codifica base64:
[...] "image": { "bytesBase64Encoded": "B64_ENCODED_IMAGE" } [...] -
VIDEO_URI: l'URI Cloud Storage del video di destinazione per cui ottenere
i contenuti incorporati. Ad esempio,
gs://my-bucket/embeddings/supermarket-video.mp4.Puoi anche fornire il video come stringa di byte con codifica base64:
[...] "video": { "bytesBase64Encoded": "B64_ENCODED_VIDEO" } [...] -
videoSegmentConfig(START_SECOND, END_SECOND, INTERVAL_SECONDS). Facoltativo. I segmenti video specifici (in secondi) per cui vengono generati gli incorporamenti.Ad esempio:
[...]
  "videoSegmentConfig": {
    "startOffsetSec": 10,
    "endOffsetSec": 60,
    "intervalSec": 10
  }
  [...]
L'utilizzo di questa configurazione specifica i dati video da 10 a 60 secondi e genera incorporamenti per i seguenti intervalli video di 10 secondi: [10, 20), [20, 30), [30, 40), [40, 50), [50, 60). Questo intervallo video (
"intervalSec": 10) rientra nella modalità di incorporamento video Standard e ti viene addebitata la tariffa della modalità Standard.Se ometti
videoSegmentConfig, il servizio utilizza i seguenti valori predefiniti:"videoSegmentConfig": { "startOffsetSec": 0, "endOffsetSec": 120, "intervalSec": 16 }. Questo intervallo video ("intervalSec": 16) rientra nella modalità di incorporamento video essenziale e all'utente viene addebitata la tariffa della modalità essenziale.
Metodo HTTP e URL:
POST https://LOCATION-aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/LOCATION/publishers/google/models/multimodalembedding@001:predict
Corpo JSON della richiesta:
{
  "instances": [
    {
      "text": "TEXT",
      "image": {
        "gcsUri": "IMAGE_URI"
      },
      "video": {
        "gcsUri": "VIDEO_URI",
        "videoSegmentConfig": {
          "startOffsetSec": START_SECOND,
          "endOffsetSec": END_SECOND,
          "intervalSec": INTERVAL_SECONDS
        }
      }
    }
  ]
}
Per inviare la richiesta, scegli una di queste opzioni:
curl
Salva il corpo della richiesta in un file denominato request.json,
quindi esegui il comando seguente:
curl -X POST \
     -H "Authorization: Bearer $(gcloud auth print-access-token)" \
     -H "Content-Type: application/json; charset=utf-8" \
     -d @request.json \
     "https://LOCATION-aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/LOCATION/publishers/google/models/multimodalembedding@001:predict"
PowerShell
Salva il corpo della richiesta in un file denominato request.json,
quindi esegui il comando seguente:
$cred = gcloud auth print-access-token
$headers = @{ "Authorization" = "Bearer $cred" }

Invoke-WebRequest `
    -Method POST `
    -Headers $headers `
    -ContentType: "application/json; charset=utf-8" `
    -InFile request.json `
    -Uri "https://LOCATION-aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/LOCATION/publishers/google/models/multimodalembedding@001:predict" | Select-Object -Expand Content
{
  "predictions": [
    {
      "textEmbedding": [
        0.0105433334,
        -0.00302835181,
        0.00656806398,
        0.00603460241,
        [...]
        0.00445805816,
        0.0139605571,
        -0.00170318608,
        -0.00490092579
      ],
      "videoEmbeddings": [
        {
          "startOffsetSec": 0,
          "endOffsetSec": 7,
          "embedding": [
            -0.00673126569,
            0.0248149596,
            0.0128901172,
            0.0107588246,
            [...]
            -0.00180952181,
            -0.0054573305,
            0.0117037306,
            0.0169312079
          ]
        }
      ],
      "imageEmbedding": [
        -0.00728622358,
        0.031021487,
        -0.00206603738,
        0.0273937676,
        [...]
        -0.00204976718,
        0.00321615417,
        0.0121978866,
        0.0193375275
      ]
    }
  ],
  "deployedModelId": "DEPLOYED_MODEL_ID"
}
Python
Per scoprire come installare o aggiornare l'SDK Vertex AI Python, consulta Installare l'SDK Vertex AI Python. Per saperne di più, consulta la Python documentazione di riferimento dell'API.
Go
Prima di provare questo esempio, segui le istruzioni di configurazione di Go nella guida rapida di Agent Platform per l'utilizzo delle librerie client. Per saperne di più, consulta la documentazione di riferimento dell'API Agent Platform Go.
Per eseguire l'autenticazione in Agent Platform, configura le Credenziali predefinite dell'applicazione. Per saperne di più, consulta Configura l'autenticazione per un ambiente di sviluppo locale.
Passaggi successivi
- Leggi il post del blog "Che cos'è la ricerca multimodale: le "LLM con visione" cambiano le attività".
- Per informazioni sui casi d'uso solo di testo (ricerca semantica basata su testo, clustering, analisi di documenti in formato lungo e altri casi d'uso di recupero di testo o di domande e risposte), consulta Ottieni embedding di testo.
- Esplora altri modelli preaddestrati in Model Garden.
- Scopri di più sulle best practice per l'AI responsabile e sui filtri di sicurezza in Gemini Enterprise Agent Platform.