


Reinforcement learning adalah teknik yang efektif untuk menyesuaikan model bahasa besar (LLM) guna memaksimalkan reward masukan yang diberikan oleh fungsi reward yang ditentukan pengguna. Model ini mengeksplorasi banyak kemungkinan jawaban, mengamati reward numerik untuk setiap jawaban, dan secara bertahap mengubah perilakunya sehingga jawaban dengan reward tinggi menjadi lebih mungkin dan jawaban dengan reward rendah menjadi lebih kecil kemungkinannya. Pendekatan ini unggul dalam skenario yang memerlukan penalaran multi-langkah, pengambilan keputusan yang rumit, atau pemahaman nuansa halus dalam perintah.
Penyesuaian reinforcement learning untuk Gemini memungkinkan Anda menyesuaikan Gemini menggunakan perintah Anda sendiri dan fungsi reward yang ditentukan sendiri. Anda dapat menggunakannya untuk meningkatkan kemampuan penalaran dan kualitas output model Gemini untuk kasus penggunaan dan alur kerja agentic Anda sendiri.
Cara kerjanya
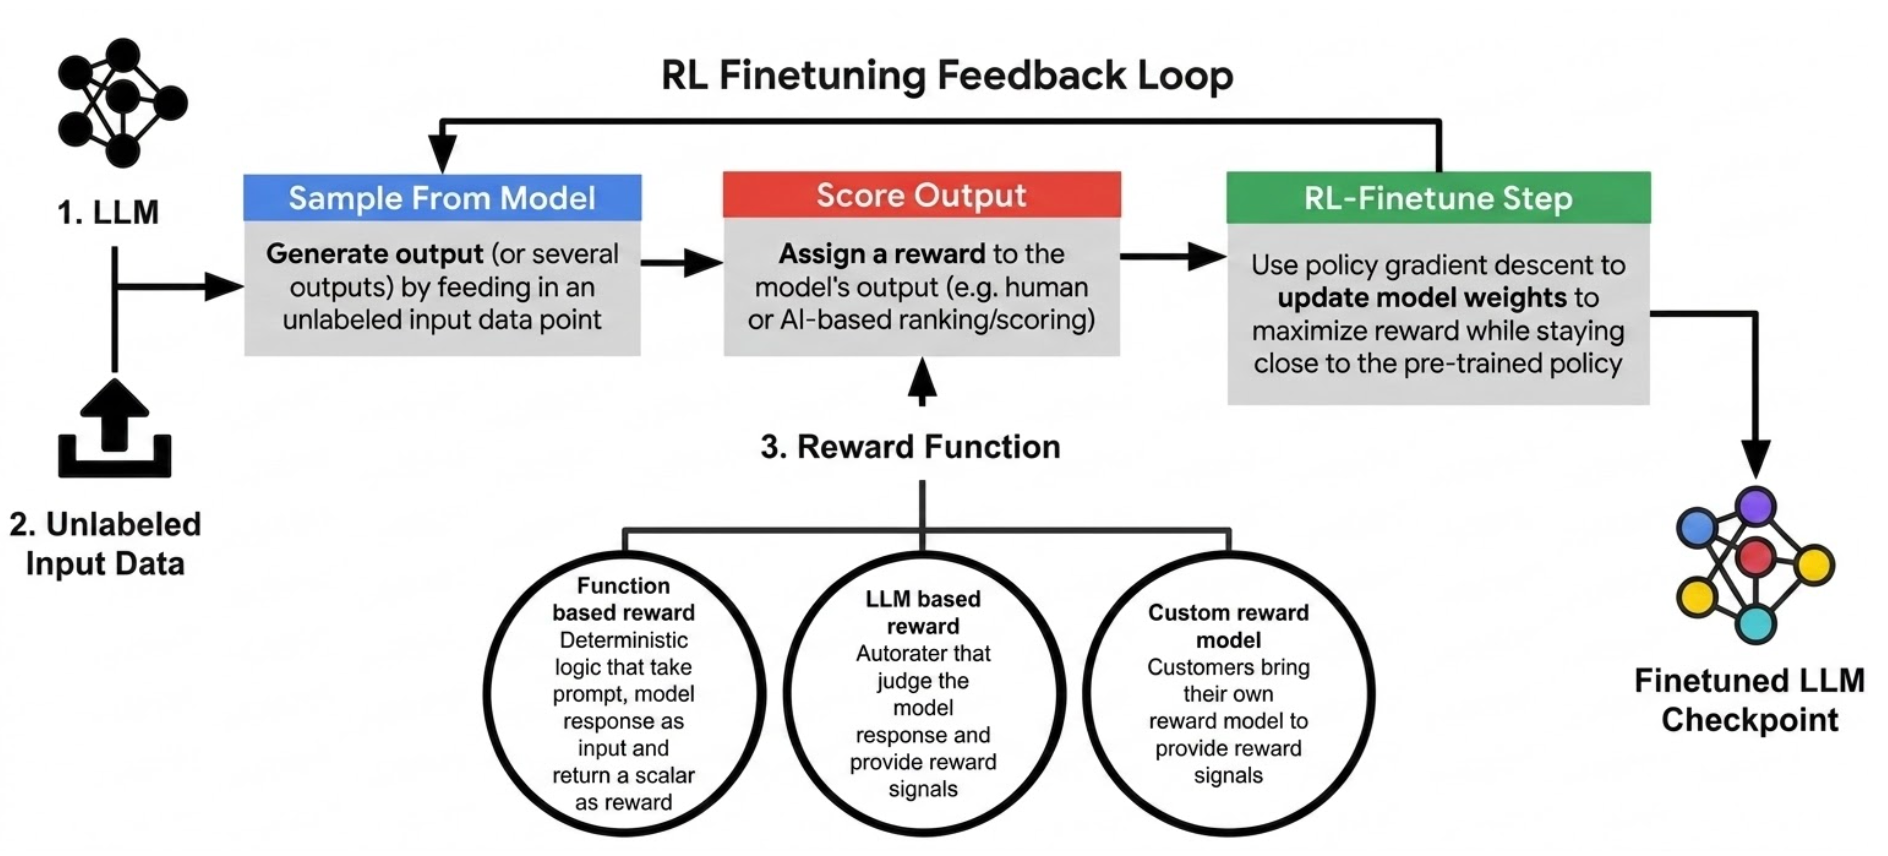
Penyesuaian reinforcement learning beroperasi secara iteratif untuk menyempurnakan perilaku LLM. Selama setiap iterasi, model menghasilkan respons terhadap sekumpulan perintah. Respons ini kemudian dievaluasi oleh fungsi reward yang ditentukan pengguna, yang mengukur kualitas output yang dihasilkan berdasarkan kriteria target Anda. Layanan ini menggunakan sinyal reward ini untuk memperbarui parameter model melalui algoritma reinforcement learning, guna mendorong perilaku yang menghasilkan reward lebih tinggi. Proses pembuatan, evaluasi, dan pembaruan parameter yang berulang ini menyesuaikan model dengan kasus penggunaan spesifik Anda.
Diagram berikut menunjukkan keseluruhan alur kerja penyesuaian reinforcement learning:
Fitur utama
Penyesuaian reinforcement learning mencakup fitur utama berikut:
Fungsi reward yang dapat disesuaikan: Tentukan fungsi reward Anda sendiri untuk mengoptimalkan berbagai kasus penggunaan kustom secara akurat dan menyelaraskan perilaku model dengan tujuan tertentu. Untuk mengetahui detail tentang jenis reward yang didukung, lihat halaman Fungsi reward.
Adaptor untuk penyesuaian yang efisien: Penyesuaian reinforcement learning menggunakan adaptor, yang memungkinkan adaptasi efektif sekaligus menggunakan kembali infrastruktur inferensi yang ada.
Beberapa tingkat penalaran: Layanan ini mendukung penyesuaian pada dua tingkat penalaran,
MINIMALdanHIGH(penalaran dinamis), sehingga Anda dapat memilih pendekatan yang paling sesuai dengan tujuan pengoptimalan dan target pola pembuatan respons. Untuk mengetahui detailnya, lihat halaman Hyperparameter.Penyesuaian berkelanjutan: Sempurnakan lebih lanjut model yang telah disesuaikan sebelumnya dengan memasukkan contoh atau epoch pelatihan tambahan. Menggunakan model atau checkpoint yang telah disesuaikan sebagai fondasi akan memungkinkan proses yang lebih efisien untuk eksperimen penyesuaian. Untuk mengetahui detailnya, lihat halaman Penyesuaian berkelanjutan.
Set data multimodal: Mendukung modalitas data teks, gambar, video (khusus Gemini 3.5 Flash), dan audio.
Kapan harus menggunakan penyesuaian reinforcement learning
Penyesuaian reinforcement learning lebih disukai untuk menyesuaikan LLM dalam situasi ketika strategi yang optimal tidak terlihat jelas melalui supervised learning. Hal ini mencakup tugas yang tujuannya adalah mengoptimalkan metrik tertentu tanpa label kebenaran nyata yang tersedia, yang penyelarasannya dengan preferensi manusia sangat penting (dan ada metode penilaian), serta untuk tugas yang memerlukan penalaran berat yang diuntungkan dari peningkatan dan eksplorasi berulang.
Berikut adalah beberapa skenario yang lebih cocok menggunakan penyesuaian reinforcement learning:
Mengikuti petunjuk yang kompleks: Saat model perlu mengikuti petunjuk yang rumit, di mana output yang "benar" bukanlah satu jawaban, melainkan memerlukan serangkaian pemeriksaan. Reinforcement learning dapat menyesuaikan model untuk menavigasi kumpulan petunjuk yang kompleks ini.
Pembuatan konten kreatif: Untuk tugas seperti membuat tulisan kreatif, puisi, atau kode yang sangat khusus, yang metrik objektifnya sulit ditentukan. Reinforcement learning, dengan fungsi reward yang dirancang dengan baik (berpotensi melibatkan masukan manusia atau evaluasi pakar), dapat memandu model menuju output yang lebih efektif dan inovatif.
Tugas penalaran: Untuk tugas yang memerlukan penalaran berat, seperti memecahkan teka-teki kata atau soal matematika, reinforcement learning dapat mendorong model untuk mengeksplorasi berbagai urutan penalaran guna mengidentifikasi pola mana yang paling efektif dalam memecahkan masalah.
Model dan region yang didukung
Model Gemini berikut mendukung penyesuaian reinforcement learning:
Gemini 3.5 Flash
| Spesifikasi | Nilai |
|---|---|
| Endpoint yang didukung untuk penyesuaian model |
|
| Endpoint yang didukung untuk penyajian model yang telah disesuaikan |
|
| Versi API | Khusus v1beta1 |
Gemini 3.1 Flash-Lite
| Spesifikasi | Nilai |
|---|---|
| Endpoint yang didukung untuk penyesuaian model |
|
| Endpoint yang didukung untuk penyajian model yang telah disesuaikan |
|
| Versi API | Khusus v1beta1 |
Modalitas penyesuaian yang didukung
Penyesuaian reinforcement learning mendukung modalitas data berikut dalam set data penyesuaian Anda:
- Teks
- Audio
- Gambar
- Video (hanya didukung untuk Gemini 3.5 Flash)
Untuk mengetahui batas set data per modalitas (seperti jumlah maksimum file per perintah, ukuran file maksimum, dan panjang total maksimum), lihat halaman Set data penyesuaian.
Penyesuaian berkelanjutan
Anda dapat menggunakan output tugas penyesuaian sebelumnya sebagai dasar untuk tugas penyesuaian reinforcement learning yang baru. Pola penyesuaian berkelanjutan berikut didukung:
- Supervised fine-tuning → Reinforcement learning fine-tuning
- Penyesuaian reinforcement learning → Penyesuaian reinforcement learning
Untuk mengetahui detail konfigurasi, lihat halaman Penyesuaian berkelanjutan.
Menyajikan model yang telah disesuaikan
Setelah tugas penyesuaian reinforcement learning berhasil pada model Gemini dasar, model yang disesuaikan berdasarkan checkpoint terakhir akan di-deploy ke endpoint di project Anda. Model yang disesuaikan menggunakan strategi endpoint inferensi yang sama dengan model dasar. Misalnya, jika Anda menjalankan tugas penyesuaian di
us-central1, model yang disesuaikan akan di-deploy ke endpoint multi-region (mREP)
us.
Untuk mengambil endpoint model yang telah disesuaikan dan di-deploy di konsol Google Cloud atau dengan menggunakan API dan menjalankan inferensi terhadapnya, lihat panduan memulai konsolGoogle Cloud atau panduan memulai API.
Harga
Harga penyesuaian
Penyesuaian reinforcement learning untuk Gemini menghasilkan token dalam dua fase: fase pengambilan sampel dan fase pelatihan. Token yang dihasilkan selama fase pelatihan dikenai biaya sesuai dengan bagian "Penyesuaian Model" di halaman harga Gemini Enterprise Agent Platform.
Harga inferensi
Setelah penyesuaian, biaya inferensi (permintaan prediksi) untuk model yang disesuaikan masih berlaku. Untuk model Gemini 3 dan yang lebih baru, harga prediksi endpoint model yang disesuaikan adalah 1,5 kali harga model dasar. Untuk mengetahui informasi selengkapnya, lihat Versi model stabil Gemini yang tersedia.
Jika Anda mengonfigurasi layanan evaluasi AI generatif untuk berjalan secara otomatis selama penyesuaian, evaluasi akan dikenai biaya sebagai tugas prediksi batch. Untuk mengetahui informasi selengkapnya, lihat bagian "Penyesuaian Model" di halaman harga Agent Platform.
Langkah berikutnya
- Ikuti panduan memulai konsolGoogle Cloud atau panduan memulai API untuk membuat tugas penyesuaian reinforcement learning pertama Anda.
- Pelajari cara menyiapkan set data penyesuaian dan mengonfigurasi fungsi reward.
- Pelajari cara men-deploy model Gemini yang telah disesuaikan.