


O AlphaFold 3 é um modelo de aprendizado profundo desenvolvido pelo Google DeepMind e pela Isomorphic Labs. Ele foi projetado para prever as estruturas 3D e as interações de proteínas, DNA, RNA, ligantes e íons. Neste documento, descrevemos como implantar e usar o modelo AlphaFold 3 com o Model Garden na Gemini Enterprise Agent Platform.
Principais recursos
A implantação do AlphaFold 3 na Agent Platform oferece os seguintes recursos necessários para pesquisa e desenvolvimento (P&D) avançados e fluxos de trabalho comerciais de descoberta de medicamentos:
Uso comercial: o AlphaFold 3 no Model Garden está disponível para uso comercial.
Ligantes personalizados arbitrários: o AlphaFold 3 é compatível com o co-dobramento unificado de proteínas, DNA e RNA, além de ligantes personalizados definidos usando strings SMILES ou códigos do Dicionário de Componentes Químicos (CCD) do CIF.
Flexibilidade do fluxo de trabalho: o AlphaFold 3 no Model Garden oferece suporte a um pipeline de dobramento completo de ponta a ponta (combinando pesquisa de banco de dados e previsão de modelo) ou um modo somente de inferência em que é possível fornecer alinhamentos de MSA pré-calculados para otimizar o tempo de execução e o uso da GPU.
Considerações
Ao avaliar o AlphaFold 3 para cargas de trabalho, considere as seguintes restrições:
Simultaneidade: o endpoint do AlphaFold 3 tem um limite de simultaneidade de um por nó. Para maior simultaneidade, os endpoints podem ser escalonados para vários nós. Se uma solicitação de previsão for enviada enquanto outra previsão estiver em execução, o endpoint rejeitará a nova solicitação com um erro
HTTP 429 Too Many
Requests
se o número de solicitações for maior que o número de nós.Limites de tokens: a duração máxima da previsão nos endpoints da plataforma de agentes é de 60 minutos. Devido à sobrecarga variável de pesquisa de MSA, o tamanho máximo de sequência compatível com as GPUs A3 é de aproximadamente 4.500 tokens biológicos (como aminoácidos, nucleotídeos ou átomos de ligantes). O fornecimento de alinhamentos pré-calculados ignora a execução da pesquisa de MSA, o que permite o dobramento complexo até o limite de hardware de aproximadamente 5.400 tokens.
Limites de payload: as solicitações REST de previsão padrão têm um limite de tamanho de 8 MB. Se você usar o modo somente inferência, os alinhamentos pré-computados grandes (arquivos
.a3m) precisarão ser referenciados usando URIs do Cloud Storage, em vez de incorporados como strings inline para evitar a rejeição do payload.Configuração de rede: como as previsões são operações de longa duração que podem levar até 60 minutos para serem concluídas, implante o endpoint apenas com o Private Service Connect (PSC) para ignorar os limites de tempo limite padrão de 10 minutos.
Instruções de implantação
Nesta seção, detalhamos a implantação do AlphaFold 3 em um endpoint fornecido pela Agent Platform em um projeto do Google Cloud .
Antes de começar
Antes de implantar o AlphaFold 3, você precisa:
- Solicitar acesso ao modelo.
- Adquira recursos de GPU.
- Configure as permissões necessárias do Identity and Access Management (IAM):
- Crie uma conta de serviço com o papel do IAM de Administrador da Agent Platform.
- Verifique se o principal do IAM tem o
papel
roles/iam.serviceAccountCreatorpara atuar como a conta de serviço ao implantar o modelo.
- Verifique suas cotas de recursos.
Recursos necessários
O AlphaFold 3 requer uma máquina virtual (VM) a3-highgpu-1g.
Antes da implantação, verifique se o projeto do Google Cloud tem cota suficiente na região de implantação de destino para os seguintes recursos:
Aceleradores: pelo menos um tipo de máquina
a3-highgpu-1g.SSD local: a VM A3 é provisionada com 750 GB de espaço em SSD local. Isso é necessário para armazenar em cache de forma persistente os bancos de dados de sequência de referência (UniProt, MGnify, Rfam), permitindo leituras de baixa latência durante pesquisas em bancos de dados genéticos (Jackhmmer/Nhmmer) em todas as solicitações de previsão.
Bucket do Cloud Storage
O AlphaFold 3 requer um bucket do Cloud Storage para armazenar os arquivos de MSA fornecidos e exportar as saídas de previsão completas. Para evitar transferências entre regiões, recomendamos que você use um bucket do Cloud Storage na mesma região do endpoint ou um bucket multirregional.
Papéis do Identity and Access Management
Configure os seguintes papéis nas identidades participantes:
Implantador de modelos (também conhecido como administrador de TI): a identidade que implanta o modelo precisa da permissão
roles/aiplatform.adminpara criar endpoints e gerenciar implantações.Identidade de exibição: ao executar a inferência, os endpoints do AlphaFold 3 gravam estruturas de saída diretamente no Cloud Storage usando a conta de serviço do projeto de locatário. A conta de serviço correspondente requer o
roles/storage.objectUserno bucket de destino do Cloud Storage.Usuários do modelo: as contas que iniciam as previsões precisam do seguinte:
roles/aiplatform.userpara enviar solicitações de previsão ao endpoint.roles/storage.objectUserpara acessar as saídas de previsão no bucket do Cloud Storage.
Implantar o AlphaFold 3
Implante o AlphaFold 3 de forma programática usando o SDK da Agent Platform como um endpoint do Google Cloud Dedicated ou apenas como um endpoint do Private Service Connect. Pode levar de 10 a 15 minutos para que o endpoint esteja pronto para inferência, dependendo da disponibilidade da GPU.
Confira a seguir um exemplo de snippet em Python que mostra como implantar o modelo em um projeto do Google Cloud , incluindo uma extensão do tempo limite de inferência:
import google.auth
from google.auth.transport.requests import AuthorizedSession
import vertexai
from vertexai import model_garden

PROJECT_ID = "YOUR_PROJECT_ID"
LOCATION = "us-west1"
MODEL_ID = "google/alphafold3@v3_0_4"
MACHINE_TYPE = "a3-highgpu-1g"

vertexai.init(project=PROJECT_ID, location=LOCATION)

# 1. Deploy Model Garden OpenModel to Dedicated Endpoint
af3_model = model_garden.OpenModel(MODEL_ID)
endpoint = af3_model.deploy(
    endpoint_display_name="af3-dedicated-ep",
    model_display_name="af3-on-mg",
    machine_type=MACHINE_TYPE,
    accelerator_type="NVIDIA_H100_80GB",
    accelerator_count=1,
    reservation_affinity_type="ANY_RESERVATION",
    use_dedicated_endpoint=True,
    accept_eula=True,
    min_replica_count=1,
    max_replica_count=1,
    serving_container_deployment_timeout=3600,
)

# 2. Update inference timeout to 3,600 seconds
credentials, _ = google.auth.default(
    scopes=["https://www.googleapis.com/auth/cloud-platform"]
)
session = AuthorizedSession(credentials)
url = f"https://{LOCATION}-aiplatform.googleapis.com/v1/{endpoint.resource_name}:update"
payload = {
    "endpoint": {
        "name": endpoint.resource_name,
        "clientConnectionConfig": {
            "inferenceTimeout": {
                "seconds": 3600
            }
        }
    }
}
response = session.post(url, json=payload)
response.raise_for_status()
print(f"Endpoint Resource Name: {endpoint.resource_name}")
Referência da API
Nesta seção, descrevemos o local do endpoint, o formato do URL, os parâmetros de caminho e o esquema de payload da solicitação.
Solicitação HTTP
POST https://HOST/v1/projects/PROJECT_ID/locations/LOCATION/endpoints/ENDPOINT_ID:predict
Substitua:
HOST: o host do endpoint de serviço. Isso depende se o tipo de implantação é um endpoint público dedicado ou usa o Private Service Connect.PROJECT_ID: o ID do projeto do Google Cloud que hospeda o endpoint implantado.LOCATION: a região do Google Cloud em que o endpoint está implantado (comous-central1).ENDPOINT_ID: o identificador exclusivo do endpoint implantado da Agent Platform.
Corpo da solicitação
O corpo da solicitação contém dados com a seguinte estrutura JSON:
{
  "instances": [
    {
      # The AlphaFold 3 input JSON - see the input documentation at
      # https://github.com/google-deepmind/alphafold3/blob/main/docs/input.md
    }
  ],
  "parameters": {
    "output_dir": "string",
    "dry_run": boolean,
    "run_data_pipeline": boolean,
    "force_output_dir": boolean,
    "resolve_msa_overlaps": boolean,
    "max_template_date": "string",
    "conformer_max_iterations": integer,
    "fix_standalone_glycans": boolean,
    "flash_attention_implementation": "string",
    "num_recycles": integer,
    "num_diffusion_samples": integer,
    "save_embeddings": boolean,
    "save_distogram": boolean,
    "compress_large_output_files": boolean,
    "num_seeds": integer
  }
}
Campos de solicitação de nível superior
| Campo | Tipo | Descrição |
|---|---|---|
instances |
array |
Obrigatório. A lista de configurações de sequência biológica a serem previstas. Essa lista precisa conter exatamente um elemento. Transmitir zero
ou mais de um elemento resulta em um erro HTTP 422 Unprocessable
Entity. O corpo de instances precisa especificar
as entradas de acordo com a especificação publicada na
documentação do AlphaFold 3.
|
parameters |
object |
Opcional. Um objeto que contém parâmetros de execução para configurar a
execução da previsão (como dry_run, output_dir).
|
Parâmetros
Configure as flags de execução para a execução do AlphaFold 3.
| Campo | Tipo | Valor padrão | Descrição |
|---|---|---|---|
dry_run |
boolean |
false |
Opcional. Se for true, a API vai executar a validação da solicitação, mas vai ignorar a execução do modelo e retornar uma resposta vazia imediatamente. Útil para verificações de conectividade e sintaxe.
|
run_data_pipeline |
boolean |
true |
Opcional. Se for true, executa o pipeline completo (pesquisa e inferência de MSA). Se for false, executa apenas a inferência (ignora
a pesquisa no banco de dados; requer MSAs pré-calculados). Consulte a
documentação no GitHub para mais detalhes.
|
output_dir |
string |
null |
Opcional. O URI do Cloud Storage (como gs://bucket/path) em que
os arquivos de saída brutos completos (incluindo estruturas CIF, PAE e CSVs
de classificação) são enviados após a execução bem-sucedida.
|
force_output_dir |
boolean |
false |
Opcional. Se for true, permite substituir os arquivos atuais
no output_dir especificado. Se for false, a API
vai retornar um erro HTTP 400 Bad Request imediatamente se o
caminho do Cloud Storage não estiver vazio para evitar a perda acidental
de dados.
|
resolve_msa_overlaps |
boolean |
true |
Opcional. Se é preciso eliminar a duplicação de MSAs não pareadas em relação às MSAs pareadas. Consulte as diretrizes na documentação do GitHub do AlphaFold 3 para conhecer as práticas recomendadas. |
max_template_date |
string |
null |
Opcional. Data máxima de lançamento do modelo a ser considerada no formato YYYY-MM-DD (como "2024-05-15"). A validação falha com um erro HTTP 422 se a formatação estiver incorreta.
|
conformer_max_iterations |
integer |
null |
Opcional. Substituição do número máximo de iterações a serem executadas
para a pesquisa de conformador do RDKit. Precisa ser um número inteiro não negativo (maior
ou igual a zero). Falha na validação com um erro HTTP 422 para valores negativos.
|
fix_standalone_glycans |
boolean |
false |
Opcional. Permite a correção independente da posição do glicano. |
flash_attention_implementation |
string |
null |
Opcional. Implementação de back-end do Flash Attention a ser usada. Os valores
permitidos são "triton", "cudnn",
"xla".
|
num_recycles |
integer |
10 |
Opcional. Número de iterações de reciclagem a serem usadas durante a inferência. Precisa ser um número inteiro positivo (maior que zero). Consulte a seção de práticas recomendadas para saber mais sobre as vantagens e desvantagens. |
num_diffusion_samples |
integer |
5 |
Opcional. Número de amostras de difusão a serem geradas. Precisa ser um número inteiro positivo (maior que zero). Consulte a seção de práticas recomendadas para saber mais sobre as vantagens e desvantagens. |
save_embeddings |
boolean |
false |
Opcional. Se os embeddings finais de tronco único e de par
serão salvos no local output_dir. Se
true, os embeddings serão gravados como arquivos .npz
em uma subpasta chamada seed-{SEED}_embeddings/ (por
exemplo, outputs_config_job_seed-50_embeddings.npz).
|
save_distogram |
boolean |
false |
Opcional. Se o distograma previsto final deve ser salvo no
local output_dir. Se true, os embeddings serão
gravados como arquivos .npz em uma subpasta chamada
seed-{SEED}_embeddings/ (por exemplo,
outputs_config_job_seed-50_embeddings.npz).
|
compress_large_output_files |
boolean |
false |
Opcional. Se for true, compacta os arquivos de saída grandes
(estruturas mmCIF e JSON de confiabilidade) usando o zstandard. Isso gera
arquivos com as extensões .cif.zst e .json.zst,
em vez de .cif e .json. Arquivos pequenos (como
ranking_scores.csv) não são compactados.
|
num_seeds |
integer |
null |
Opcional. Número de sementes aleatórias a serem usadas para inferência. Em geral, é recomendável definir sementes no campo instances.modelSeeds para garantir a reprodutibilidade. Consulte a
seção de práticas recomendadas para saber mais sobre as
vantagens e desvantagens.
|
Resposta (saída)
Nesta seção, descrevemos os campos retornados na resposta da API após a execução bem-sucedida.
Corpo da resposta
Após a execução, o endpoint retorna a resposta no formato de esquema de previsão on-line padrão da Agent Platform:
{
  "deployedModelId": "string",
  "model": "string",
  "modelDisplayName": "string",
  "modelVersionId": "string",
  "predictions": [
    {
      "structure_cif": "string",
      "plddt": [
        number
      ],
      "pae": [
        [
          number
        ]
      ],
      "summary": {
        "ptm": number,
        "iptm": number,
        "fraction_disordered": number,
        "has_clash": boolean,
        "ranking_score": number,
        "chain_pair_pae_min": [
          [
            number
          ]
        ],
        "chain_pair_iptm": [
          [
            number
          ]
        ],
        "chain_ptm": [
          number
        ],
        "chain_iptm": [
          number
        ],
        "chain_ids": [
          string
        ]
      },
      "output_dir": "string"
    }
  ]
}
Campos de resposta de nível superior
| Campo | Tipo | Descrição |
|---|---|---|
deployedModelId |
string |
O ID do modelo implantado no endpoint da Agent Platform. |
model |
string |
O nome do recurso totalmente qualificado do modelo. |
modelDisplayName |
string |
O nome de exibição do modelo implantado (sempre
"alphafold3").
|
modelVersionId |
string |
O ID da versão do modelo implantado. |
predictions |
array |
A lista de resultados da previsão. Para o AlphaFold 3, essa matriz contém exatamente um objeto de resultado de previsão. |
Detalhes do resultado da Prediction (predictions[])
O endpoint de previsão do AlphaFold 3 retorna uma resposta JSON HTTP 200
que contém uma matriz predictions com coordenadas estruturais e métricas de confiança
para o candidato mais bem classificado. Para definições de campo abrangentes e
especificações de arquivo de saída, consulte a documentação oficial do AlphaFold 3
no
GitHub.
Dependendo se parameters.output_dir é fornecido na solicitação, a
estrutura de saída na resposta da API pode variar:
Previsão na resposta HTTP: a resposta inline retorna métricas de resumo global (
summary), coordenadas de estrutura 3D (structure_cif), pontuações de confiança por átomo (plddt) e a matriz de erro alinhado previsto em 2D (pae) diretamente no corpo do payload da resposta JSON HTTP. Quando um diretório de saída é especificado, os campos de payload grandes (structure_cif,plddtepae) são omitidos (nulos) do payload de resposta HTTP para evitar gargalos de serialização. Em vez disso, todas as saídas brutas do modelo são exportadas de forma assíncrona para o bucket especificado do Cloud Storage.Artefato salvo no bucket do Cloud Storage: quando um diretório de saída (
parameters.output_dir) é especificado, os resultados abrangentes da previsão são enviados para o Cloud Storage. A pasta de saída contém dados de acordo com a especificação publicada na documentação do AlphaFold 3 no GitHub.
Faça previsões
A implantação do Model Garden simplifica a execução do pipeline de previsão de ponta a ponta, incluindo o pipeline de dados e a inferência de modelo em uma única chamada de API. O diagrama a seguir mostra a arquitetura de alto nível das previsões do AlphaFold 3:
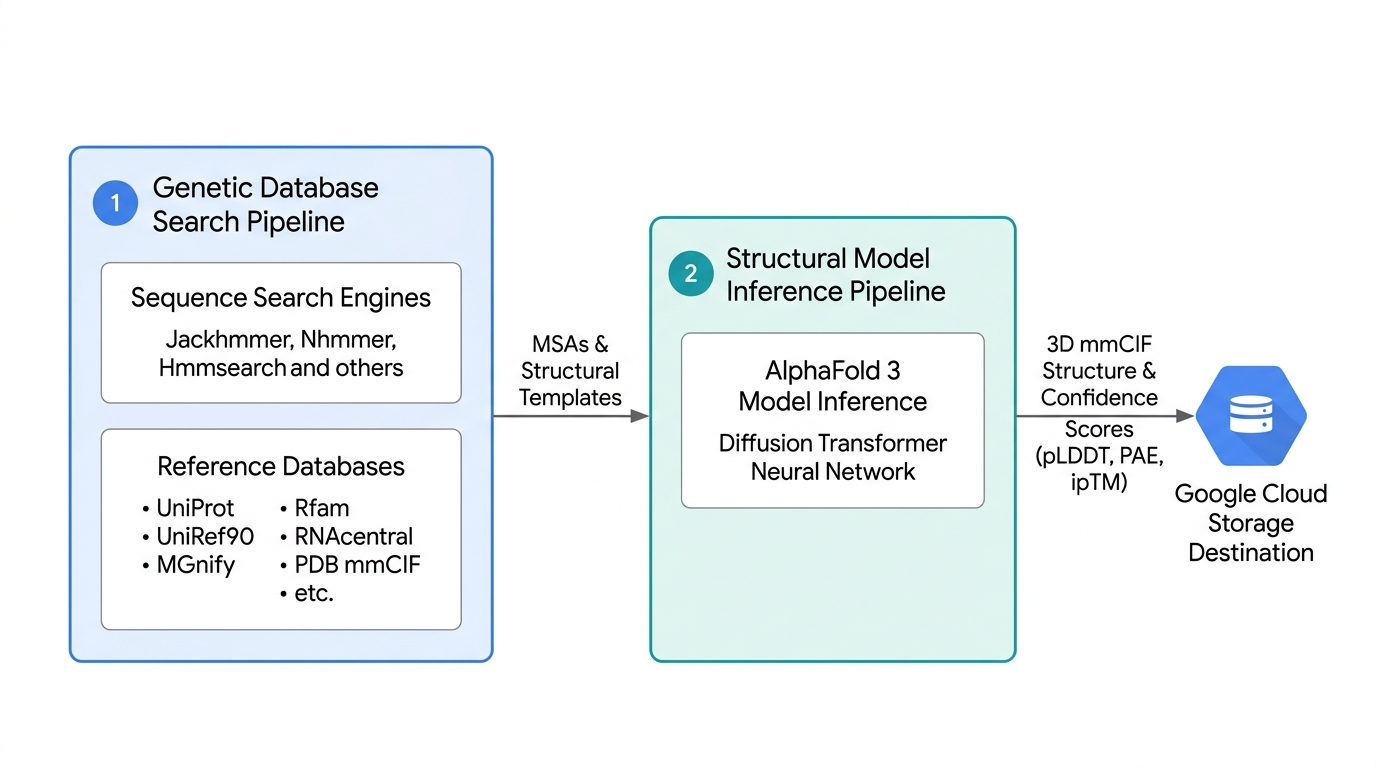
Fig. 1. Pipeline de previsão completo
Ao executar previsões, é altamente recomendável fornecer um bucket do Cloud Storage diretamente nos parâmetros para exportar o conjunto de dados brutos completo, incluindo subdiretórios por amostra, manifestos de classificação e saídas brutas. Para uma análise completa de todos os campos de solicitação configuráveis, incluindo o ajuste de parâmetros para amostragem de várias sementes, reciclagem neural, trajetórias de difusão e ligações covalentes personalizadas, consulte a seção de referência da API.
Antes de iniciar jobs de dobramento de longa duração ou pipelines em lote, faça uma simulação para verificar rapidamente sua autenticação, as permissões do IAM e a conectividade de rede do endpoint.
Opções de previsão
Dependendo do fluxo de trabalho, o processamento do AlphaFold 3 pode ser organizado em quatro modos de execução distintos:
- Modo de teste
- Modo de previsão de ponta a ponta
- Somente inferência com MSAs e modelos pré-calculados
- Execução sem MSA e sem modelo
Modo de teste
Para verificar a conectividade da API, a autenticação, a rede e os esquemas JSON sem
iniciar o pipeline de previsão, envie uma solicitação com "dry_run":
true no objeto parameters. O endpoint executa todas as rotinas de validação (incluindo a verificação das permissões de gravação do bucket do Cloud Storage e a validação de caracteres de sequência), mas ignora a execução, retornando imediatamente uma resposta de previsão vazia.
Veja a seguir um exemplo de script Python para o modo de teste:
from google.cloud import aiplatform

PROJECT_ID = "YOUR_PROJECT_ID"
LOCATION = "us-west1"
ENDPOINT_ID = "YOUR_ENDPOINT_ID"

# Initialize AI Platform SDK
aiplatform.init(project=PROJECT_ID, location=LOCATION)

# Connect to Dedicated Endpoint
endpoint = aiplatform.Endpoint(ENDPOINT_ID)

# Define prediction payload
instances = [
    {
        "name": "preflight_check",
        "dialect": "alphafold3",
        "version": 4,
        "modelSeeds": [1],
        "sequences": [
            {
                "protein": {
                    "id": "A",
                    "sequence": "PVLSCGEWQL",
                }
            }
        ],
    }
]

parameters = {
    "dry_run": True,
}

# Execute prediction request
response = endpoint.predict(
    instances=instances,
    parameters=parameters
)
print(response.predictions)
Modo de previsão de ponta a ponta
Para executar a previsão de ponta a ponta, envie sequências biológicas brutas (proteínas, DNA, RNA, ligantes e PTMs) em uma única solicitação. O endpoint executa automaticamente uma pesquisa no banco de dados genético, seguida imediatamente pela inferência do modelo. Isso é recomendado para jobs de dobramento sem alinhamentos preexistentes.
Veja a seguir um exemplo de script Python para o modo de previsão de ponta a ponta:
from google.cloud import aiplatform

# Configuration
PROJECT_ID = "YOUR_PROJECT_ID"
LOCATION = "us-west1"
ENDPOINT_ID = "YOUR_ENDPOINT_ID"
STORAGE_OUTPUT_DIR = "gs://YOUR_BUCKET_NAME/alphafold_output/"

# Initialize AI Platform SDK
aiplatform.init(project=PROJECT_ID, location=LOCATION)

# Instantiate Endpoint reference
endpoint = aiplatform.Endpoint(ENDPOINT_ID)

# Define Prediction Payload
instances = [
    {
        "name": "e2e_protein_ligand_complex",
        "dialect": "alphafold3",
        "version": 4,
        "modelSeeds": [1],
        "sequences": [
            {
                "protein": {
                    "id": "A",
                    "sequence": "PVLSCGEWQL",
                    "modifications": [
                        {"ptmType": "HY3", "ptmPosition": 1}
                    ],
                }
            },
            {
                "ligand": {
                    "id": "B",
                    "ccdCodes": ["MG"],
                }
            },
        ],
    }
]

parameters = {
    "output_dir": STORAGE_OUTPUT_DIR,
}

# Execute Prediction
response = endpoint.predict(
    instances=instances,
    parameters=parameters
)

print(response.predictions)
Somente inferência com MSAs e modelos pré-calculados
Talvez você já tenha modelos de MSAs e mmCIF pré-calculados de uma execução anterior ou gerados fora do endpoint do modelo. Nesses cenários, a pesquisa no banco de dados genético pode ser totalmente ignorada fornecendo os alinhamentos e modelos, roteando a solicitação diretamente para a previsão de estrutura. Isso também pode reduzir significativamente o tempo de resposta da inferência. Esse é o caminho recomendado nos seguintes cenários:
- Ao acoplar vários ligantes de pequenas moléculas diferentes a um único alvo de proteína estática, os MSAs podem ser reutilizados.
- Executar a mesma sequência de moléculas em várias sementes aleatórias, de forma iterativa, para mapear a flexibilidade estrutural.
- Alinhamento de sequências off-line com bancos de dados genômicos privados e não públicos.
- Otimização dos recursos de GPU para o AlphaFold 3, para focar apenas na geração de estruturas.
Veja a seguir um exemplo de script Python para o modo somente inferência:
from google.cloud import aiplatform

# Configuration
PROJECT_ID = "YOUR_PROJECT_ID"
LOCATION = "us-west1"
ENDPOINT_ID = "YOUR_ENDPOINT_ID"
STORAGE_OUTPUT_DIR = "gs://YOUR_BUCKET_NAME/af3_results/inference_only"

# Initialize AI Platform SDK
aiplatform.init(project=PROJECT_ID, location=LOCATION)

# Instantiate Endpoint reference
endpoint = aiplatform.Endpoint(ENDPOINT_ID)

# Define Prediction Payload
instances = [
    {
        "name": "inference_protein_ligand_complex",
        "dialect": "alphafold3",
        "version": 4,
        "modelSeeds": [1],
        "sequences": [
            {
                "protein": {
                    "id": "A",
                    "sequence": "PVLSCGEWQL",
                    "modifications": [
                        {"ptmType": "HY3", "ptmPosition": 1}
                    ],
                    "unpairedMsaPath": "gs://YOUR_BUCKET_NAME/path/to/unpaired.a3m",
                    "pairedMsa": "",
                    "templates": [],
                }
            },
            {
                "ligand": {
                    "id": "B",
                    "ccdCodes": ["MG"],
                }
            },
        ],
    }
]

parameters = {
    "run_data_pipeline": False,
    "output_dir": STORAGE_OUTPUT_DIR,
    "force_output_dir": True,
}

# Execute Prediction
response = endpoint.predict(
    instances=instances,
    parameters=parameters
)

print(response.predictions)
Execução sem MSA e sem modelo
Também é possível ignorar totalmente a pesquisa no banco de dados genético e a correspondência de modelos. O modelo prevê a estrutura 3D usando apenas a sequência de consulta, sem sequências homólogas ou informações coevolutivas. Para
acionar esse modo, forneça strings vazias para os parâmetros de MSA unpairedMsa e
pairedMsa e uma lista vazia para templates na instância, além de definir
run_data_pipeline como false nos parâmetros. Isso pode ser útil para
o design de moléculas sintéticas ou modificadas ou para testar previsões estruturais na
ausência de contexto evolutivo.
Veja a seguir um exemplo de script Python para executar o AlphaFold 3 sem MSA e sem modelo:
from google.cloud import aiplatform

# Configuration
PROJECT_ID = "YOUR_PROJECT_ID"
LOCATION = "us-west1"
ENDPOINT_ID = "YOUR_ENDPOINT_ID"
STORAGE_OUTPUT_DIR = "gs://YOUR_BUCKET_NAME/af3_results/inference_only_gcs_job"

# Initialize AI Platform SDK
aiplatform.init(project=PROJECT_ID, location=LOCATION)

# Instantiate Endpoint reference
endpoint = aiplatform.Endpoint(ENDPOINT_ID)

# Define Prediction Payload
instances = [
    {
        "name": "inference_only_gcs_job",
        "dialect": "alphafold3",
        "version": 4,
        "modelSeeds": [1, 2, 3],
        "sequences": [
            {
                "protein": {
                    "id": "A",
                    "sequence": "PVLSCGEWQL",
                    "unpairedMsa": "",
                    "pairedMsa": "",
                    "templates": [],
                }
            }
        ],
    }
]

parameters = {
    "output_dir": STORAGE_OUTPUT_DIR,
    "run_data_pipeline": False,
}

# Execute Prediction
response = endpoint.predict(
    instances=instances,
    parameters=parameters,
    timeout=3600.0,
)

print(response.predictions)
Para especificações detalhadas, parâmetros de entidade e métricas de confiança de saída, consulte a documentação do AlphaFold 3 no GitHub.
Saídas de Prediction
O serviço de previsão do AlphaFold 3 oferece dois mecanismos complementares de entrega para recuperar saídas de previsão. Por padrão, a resposta da API retorna os resultados da previsão inline de forma síncrona para o candidato mais bem classificado. Se quiser, especifique um diretório do Cloud Storage.
A seção a seguir apresenta uma visão geral da saída da previsão. Para mais detalhes, consulte a documentação do AlphaFold 3 no GitHub.
Resposta inline x artefatos salvos
O serviço de previsões do AlphaFold 3 é compatível com dois padrões de saída principais:
- Resposta inline: retorna as coordenadas da estrutura 3D e as métricas de confiança apenas para o candidato mais bem classificado diretamente no payload de resposta HTTP REST. Isso é ideal para prototipagem interativa rápida ou consultas de sequência única.
- Artefatos salvos (Cloud Storage): especificar um diretório de saída exporta o conjunto de dados de várias amostras completo para o Cloud Storage. Isso inclui arquivos de coordenadas individuais, JSONs de confiança, distogramas, embeddings e métricas de resumo para cada semente aleatória e amostra de difusão geradas. O uso do Cloud Storage é recomendado para cargas de trabalho de produção, mapeamento de conjuntos conformacionais e para ignorar o limite de tamanho do payload da solicitação.
Veja a seguir um exemplo em Python de como recuperar artefatos salvos do Cloud Storage para análise downstream:
from google.cloud import storage

BUCKET_NAME = "your-bucket-name"
JOB_NAME = "my_alphafold_job"
STORAGE_PREFIX = f"af3_results/my_folder/{JOB_NAME}"

# Initialize Cloud Storage client
client = storage.Client(project="your-project-id")
bucket = client.bucket(BUCKET_NAME)

# Download the top-ranked 3D structure and global ranking ledger
bucket.blob(f"{STORAGE_PREFIX}/{JOB_NAME}_model.cif").download_to_filename("model.cif")
bucket.blob(f"{STORAGE_PREFIX}/{JOB_NAME}_ranking_scores.csv").download_to_filename("ranking_scores.csv")
bucket.blob(f"{STORAGE_PREFIX}/{JOB_NAME}_summary_confidences.json").download_to_filename("summary.json")
Como o AlphaFold 3 usa um modelo de difusão generativa, cada execução de previsão gera um conjunto de estruturas 3D candidatas em sementes e trajetórias de amostragem. Avaliar e comparar essas execuções candidatas pode ajudar a interpretar as saídas de previsão antes de realizar uma análise estrutural detalhada.
É possível investigar o conjunto de dados completo de artefatos de várias amostras usando três arquivos principais:
ranking_scores.csv: o livro-razão principal que lista todos os pares de trajetórias gerados e oranking_scorecomposto deles. As linhas são salvas na ordem de execução da trajetória (classificadas por semente crescente e, em seguida, por índice de amostra crescente), não pré-classificadas por pontuação. Os usuários precisam classificar porranking_scoreem ordem decrescente para identificar as classificações candidatas.summary_confidences.json: contém métricas de qualidade globais (pTM,ipTM,has_clash,fraction_disordered) para o principal candidato.Por amostra
summary_confidences.json: localizado dentro de pastas individuaisseed-{SEED}_sample-{INDEX}/, permitindo que você inspecione matrizes de pTM e ipTM no nível da cadeia para execuções de candidatos específicos que não estão no topo, se necessário.
O exemplo em Python a seguir analisa ranking_scores.csv e summary_confidences.json para classificar amostras de candidatos e validar a qualidade dos principais candidatos:
import csv
import json

print("=== Candidate Samples Ledger (ranking_scores.csv) ===")
with open("ranking_scores.csv", "r", newline="", encoding="utf-8") as f:
    rows = sorted(
        csv.DictReader(f), key=lambda x: float(x["ranking_score"]), reverse=True
    )

# Calculate column widths cleanly and readably
headers = list(rows[0].keys())
widths = {}
for col in headers:
    lengths = [len(col)] + [len(r[col]) for r in rows]
    widths[col] = max(lengths)

print("  ".join(col.rjust(widths[col]) for col in headers))
for r in rows:
    print("  ".join(r[col].rjust(widths[col]) for col in headers))

top = rows[0]
print(
    f"\nPromoted Top Candidate: Seed {int(top['seed'])}, Sample"
    f" {int(top['sample'])} (Score: {float(top['ranking_score']):.4f})"
)

print("\n=== Top Candidate Quality Validation (summary.json) ===")
with open("summary.json", "r", encoding="utf-8") as f:
    summary = json.load(f)

clash_str = (
    "DETECTED (FAIL)" if summary.get("has_clash") else "None Detected (PASS)"
)
print("Top Candidate Metrics:")
print(f"  • Ranking Score : {summary.get('ranking_score', 'N/A')}")
print(f"  • Global pTM    : {summary.get('ptm', 'N/A')}")
print(f"  • Interface ipTM: {summary.get('iptm', 'N/A')}")
print(f"  • Steric Clash  : {clash_str}")
Para especificações de esquema completas dos arquivos salvos e dos atributos mmCIF, consulte a documentação do AlphaFold 3 no GitHub. Além disso, consulte o guia Como avaliar a qualidade das previsões do AlphaFold 3 no EMBL-EBI para entender como avaliar a qualidade das previsões.
Práticas recomendadas
As seções a seguir descrevem as práticas recomendadas ao usar o AlphaFold 3 na plataforma de agentes:
Mitigar tempos limite de solicitação
Os endpoints na Agent Platform aplicam um tempo limite de execução máximo padrão de 60 minutos por solicitação. Para garantir que as previsões sejam concluídas sem tempo limite, siga estas diretrizes:
- Evite a amostragem excessiva em uma única solicitação: inicializar uma ampla varredura de sementes ou parâmetros de difusão reversa excessivamente altos em uma única chamada de API pode fazer com que o tempo de execução exceda o limite de 60 minutos.
- Desconstrua grandes varreduras: para estudos em grande escala, divida as sementes e as varreduras de parâmetros em vários payloads de previsão menores e envie-os como jobs separados. Isso também aproveita as capacidades de escalonamento automático do endpoint.
Ignorar pesquisa de MSA
O pipeline de pesquisa de banco de dados genético é a fase mais demorada do pipeline do AlphaFold. Ao executar previsões iterativas na mesma sequência (como executar varreduras de triagem de ligantes em um alvo de proteína fixo), é possível otimizar drasticamente os tempos de execução ignorando completamente a pesquisa no banco de dados:
- Extrair o MSA: execute uma previsão inicial de ponta a ponta com um
diretório de saída do Cloud Storage (
output_dir) especificado. Faça o download do arquivo{JOB_NAME}_data.jsongerado no bucket de saída do Cloud Storage. - Enviar previsões somente de inferência: localize os campos
unpairedMsaepairedMsano arquivo JSON. Extraia essas strings de MSA e transmita-as para solicitações de previsão subsequentes usandounpairedMsaPathepairedMsaPathapontando para URIs do Cloud Storage.
Como alternativa, é possível executar a pesquisa de MSA na sua própria infraestrutura e inserir os modelos de MSA pré-computados na solicitação de previsão.
Processar execuções de baixa confiança
Quando as saídas de previsão geram métricas de baixa confiança, em vez de tratá-las como falhas de previsão irrecuperáveis, é possível tentar uma correção direcionada. Ao otimizar parâmetros específicos, é possível analisar trajetórias latentes alternativas. Nesta seção, listamos algumas abordagens para recuperação em caso de previsões de baixa confiança.
Usar amostragem de várias sementes
O AlphaFold 3 inicializa a geração de coordenadas 3D a partir de ruído aleatório no espaço latente. Quando uma previsão é enviada com uma única semente, a trajetória de difusão pode seguir um caminho diferente em comparação com outra semente. Transmitir uma matriz de sementes força o modelo a amostrar trajetórias que começam em estados diferentes.
A amostragem de várias sementes oferece duas vantagens essenciais: ela verifica a consistência estrutural em execuções independentes e investiga a dinâmica conformacional funcional. Se, por exemplo, todas as cinco sementes convergirem para coordenadas 3D idênticas, você poderá ter alta confiança na dobra global. Por outro lado, se sementes diferentes produzirem poses de ligação distintas e de alta confiança, o conjunto pode estar revelando estados conformacionais biologicamente significativos, como loops de sítio ativo abertos versus fechados ou dímeros alternativos com troca de domínio.
Expandir trajetórias de difusão
Enquanto modelSeeds altera o estado de ruído inicial no espaço latente, o parâmetro num_diffusion_samples (padrão 5) controla quantas estruturas 3D candidatas são geradas por semente durante o processo de difusão reversa. Para
regiões de loop flexíveis ou bolsões de ligação rasos, aumentar a amostragem expande
o pool de candidatos para cada semente. Isso é particularmente eficaz quando as pontuações de confiança local caem em loops específicos (pLDDT < 70), enquanto a dobra geral do domínio permanece confiável (pTM > 0,80). Isso pode ajudar a descobrir estruturas candidatas de alta confiança que não foram detectadas na execução inicial.
Aumentar as iterações de reciclagem
Antes que o módulo de difusão gere coordenadas 3D, o AlphaFold 3
processa sequências e recursos de pares. O parâmetro num_recycles determina
quantas vezes as representações de estrutura intermediária e as incorporações espaciais
em pares são alimentadas iterativamente de volta pela rede.
Para moléculas grandes e complexas ou alvos com sinais coevolutivos fracos,
aumentar num_recycles dá à rede de tronco mais iterações para
resolver relações espaciais entre cadeias distantes antes de transmitir entradas para
o módulo de difusão. Essa abordagem pode ser tentada quando as matrizes de PAE fora da diagonal mostram alta incerteza entre as cadeias (> 15 Å), apesar de as cadeias individuais mostrarem alta confiança de dobra local (pLDDT > 70). O aumento das reciclagens
aumenta linearmente o tempo de execução da previsão, então deve ser reservado para alvos de interface
difíceis.
Usar um pipeline de alinhamento personalizado
O AlphaFold 3 executa automaticamente o pipeline de pesquisa do banco de dados genético
para gerar modelos de MSA. Os usuários também podem fornecer alinhamentos personalizados, pré-calculados e particulares no formato .a3m usando URIs do Cloud Storage com unpairedMsaPath e pairedMsaPath. O fornecimento de MSAs profundos oferece restrições coevolutivas
fortes, frequentemente convertendo previsões de baixa confiança em
modelos de alta confiança.