


Gemini Robotics ER הוא מודל ראייה-שפה (VLM) שמאפשר לרובוטים להבין את העולם הפיזי בצורה מתקדמת. המודל מפרש נתונים חזותיים, מבצע חשיבה מרחבית וזמנית, מתכנן משימות מרובות שלבים ומתזמר רובוטים וכלים.
מודלים
Gemini Robotics ER 2 הוא עדכון למודל החשיבה הרציונלית שלנו, שמאפשר חשיבה רציונלית מדויקת לגבי הסביבה הפיזית של הרובוט. הוא מתמחה ביכולות של חשיבה מגולמת, כמו תזמור של סוכני רובוטים (לדוגמה, באמצעות מודלים של ראייה-שפה-פעולה (VLA)), הבנת סרטונים של רובוטים (כולל הבנת ההתקדמות וזיהוי הצלחה), קריאת מכשירים, הצבעה וחשיבה מרחבית.
המודל הבא זמין בגרסת טרום-השקה (Preview):
-
gemini-robotics-er-2-preview: מבוסס על Gemini 3.5 Flash, עם יכולות משופרות של חשיבה מרחבית, איתור רגעים בסרטונים, סיווג התקדמות בסרטונים, תזמור של כמה רובוטים ושימוש בכלים בכמה שלבים. בדף המידע על המודל Gemini Robotics ER 2 מפורטים המפרט הטכני, מגבלות האסימונים והמכסות, היכולות הנתמכות, הזמינות לפי אזור והתמחור.
במדריך הזה נשתמש ב-Google Gen AI SDK עם Gemini Enterprise Agent Platform. בכל דוגמה, הלקוח מאותחל באמצעות enterprise=True ומאומת באמצעות פרטי הכניסה של Google Cloud, כדי שתוכלו לקרוא למודל באמצעות פרויקט Google Cloud משלכם.
יכולות רובוטיקה
בטבלה הבאה מפורטות היכולות העיקריות של Gemini Robotics ER 2:
| יכולת | תיאור | מדריך |
|---|---|---|
| חשיבה מרחבית | להצביע על אובייקטים, לעקוב אחריהם בסרטון, לזהות אותם באמצעות תיבות תוחמות (bounding box) ולתכנן מסלולים. | חשיבה מרחבית |
| הרצת קוד באמצעות סוכן | אפשר להשתמש בהרצת קוד כדי להגדיל או לחתוך תמונות, לקרוא מכשירים ולהוסיף הערות לסצנות. | יכולות אג'נטיות |
| תזמור משימות | לשלב חשיבה מרחבית עם ממשקי API מותאמים אישית לרובוטים כדי להשלים משימות ארוכות טווח. | תזמור משימות |
| הבנת סרטונים | איתור רגעים וסיווג התקדמות מפידים של סרטונים רציפים. | הבנת סרטונים |
לפני שמתחילים
פלטפורמת הסוכנים מבצעת אימות באמצעות פרטי הכניסה של Google Cloud, ולא באמצעות מפתח Gemini API. לפני שמריצים את הדוגמאות, צריך לבצע את ההגדרות הבאות:
מתקינים את Google Gen AI SDK.
pip install --upgrade google-genaiמפעילים את ה-API בפרויקט ב- Google Cloud ומוודאים שיש לכם מזהה פרויקט. אפשר להשתמש בפרויקט קיים או ליצור פרויקט חדש.
אימות באמצעות Application Default Credentials (ADC). לפיתוח מקומי, מריצים את הפקודה:
gcloud auth application-default loginמפעילים את הלקוח באמצעות הקצה העורפי של Agent Platform. כל הדוגמאות של Python בדף הזה משתמשות בלקוח הבא, לכן צריך להגדיר מזהה פרויקט משלכם:
from google import genai

client = genai.Client(
    enterprise=True,
    project="your-project-id",
    location="global",
)
לחלופין, אפשר להגדיר את משתנה הסביבה
GOOGLE_GENAI_USE_ENTERPRISE=Trueבמקום להעביר אתenterprise=Trueללקוח.
קדימה, מתחילים
בדוגמה הבאה, המערכת מוצאת אובייקטים בתמונה ומחזירה את הקואורדינטות הדו-ממדיות המנורמלות ואת התוויות שלהם. אתם יכולים להעביר את הפלט הזה ישירות ל-API של רובוטיקה או למודל ראייה-שפה-פעולה (VLA) כדי ליצור פעולות של רובוט.
Python
from google import genai
from google.genai import types

PROMPT = """
          Point to no more than 10 items in the image. The label returned
          should be an identifying name for the object detected.
          The answer should follow the json format: [{"point": <point>,
          "label": <label1>}, ...]. The points are in [y, x] format
          normalized to 0-1000.
        """
client = genai.Client(
    enterprise=True,
    project="your-project-id",
    location="global",
)

# Load your image
with open("my-image.png", 'rb') as f:
    image_bytes = f.read()

image_response = client.models.generate_content(
    model="gemini-robotics-er-2-preview",
    contents=[
        types.Part.from_bytes(
            data=image_bytes,
            mime_type='image/png',
        ),
        PROMPT
    ],
    config = types.GenerateContentConfig(
        temperature=1.0,
        thinking_config=types.ThinkingConfig(
            thinking_level=types.ThinkingLevel.HIGH
        ),
    )
)

print(image_response.text)
REST
# First, ensure you have the image file locally.
# Encode the image to base64
IMAGE_BASE64=$(base64 -w 0 my-image.png)

# Set your Google Cloud project and location.
export PROJECT_ID="your-project-id"
export LOCATION="global"
export MODEL="gemini-robotics-er-2-preview"

# For the "global" location, use the aiplatform.googleapis.com host.
# For a regional location, prefix the host with the region, for example:
# https://us-central1-aiplatform.googleapis.com

curl -X POST \
  "https://aiplatform.googleapis.com/v1/projects/${PROJECT_ID}/locations/${LOCATION}/publishers/google/models/${MODEL}:generateContent" \
  -H "Authorization: Bearer $(gcloud auth application-default print-access-token)" \
  -H "Content-Type: application/json" \
  -d '{
    "contents": [
      {
        "parts": [
          {
            "inlineData": {
              "mimeType": "image/png",
              "data": "'"${IMAGE_BASE64}"'"
            }
          },
          {
            "text": "Point to no more than 10 items in the image. The label returned should be an identifying name for the object detected. The answer should follow the json format: [{\"point\": [y, x], \"label\": <label1>}, ...]. The points are in [y, x] format normalized to 0-1000."
          }
        ]
      }
    ],
    "generationConfig": {
      "temperature": 1.0,
      "thinkingConfig": {
        "thinkingLevel": "HIGH"
      }
    }
  }'
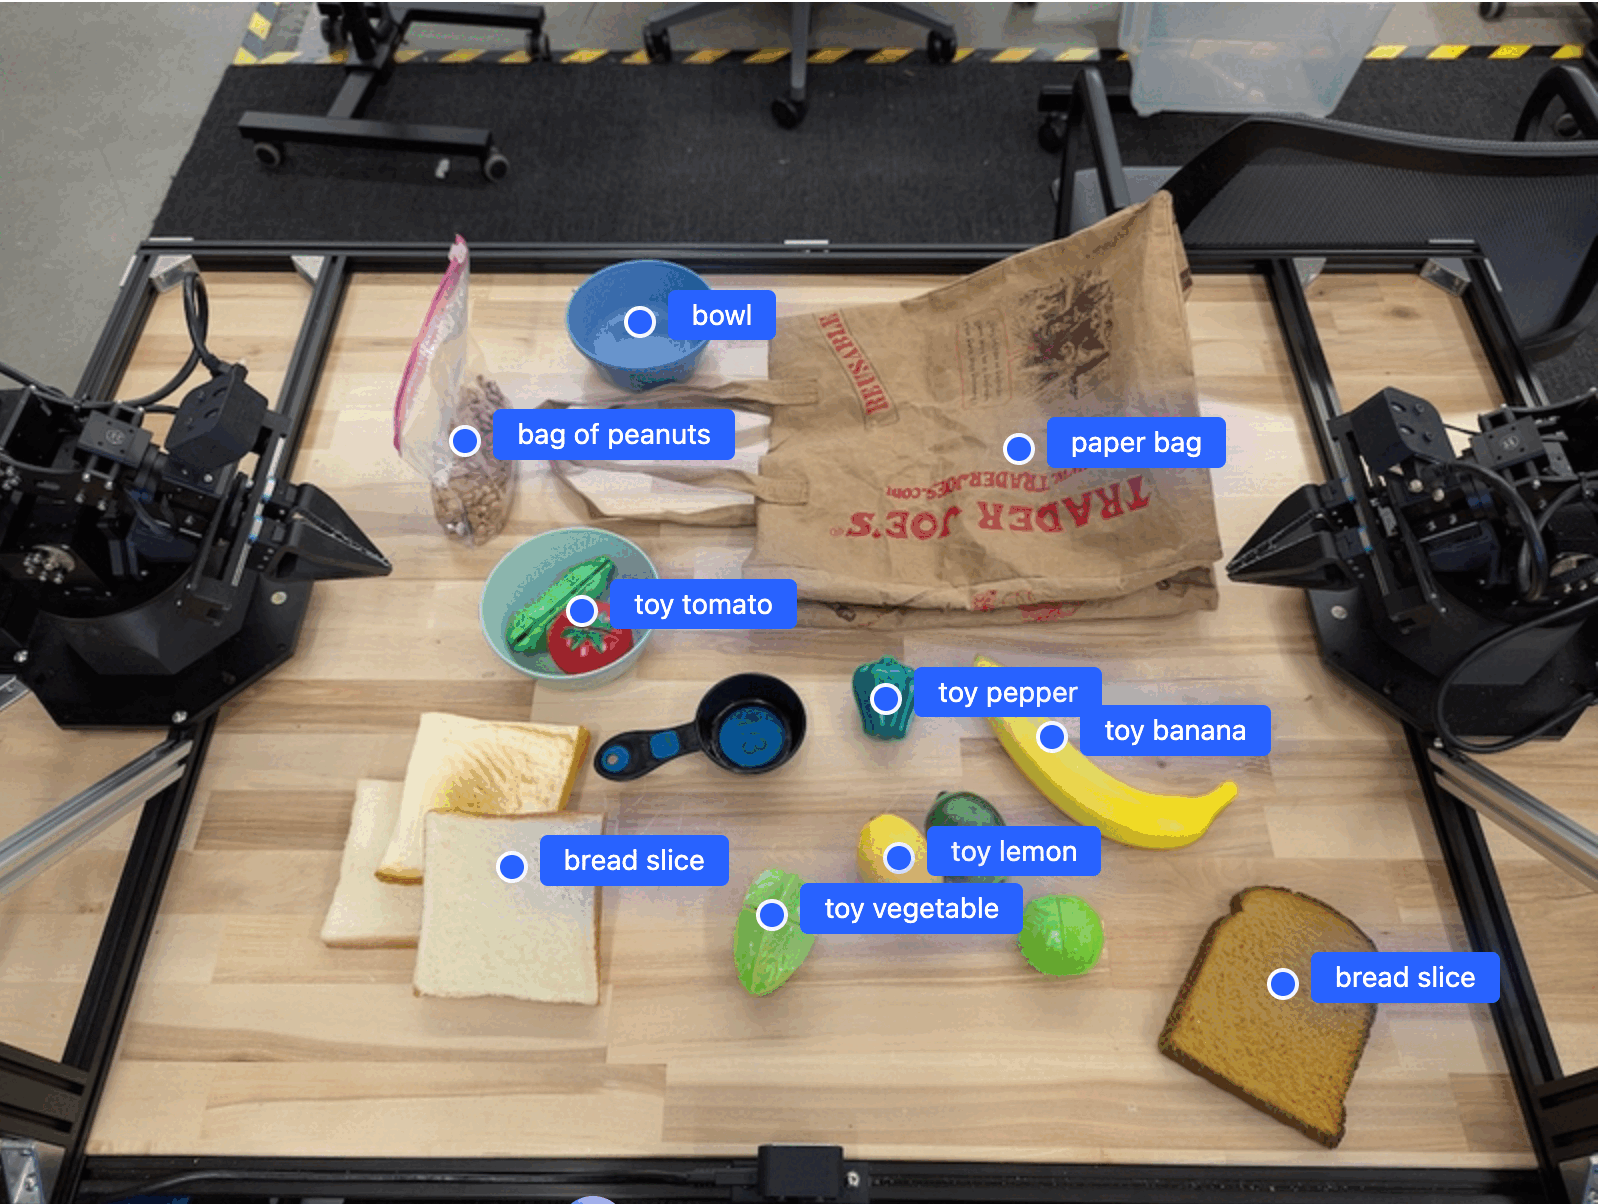
הפלט יהיה מערך JSON שמכיל אובייקטים, כל אחד עם point (קואורדינטות [y, x] מנורמלות) ו-label שמזהה את האובייקט.
JSON
[
  {"point": [376, 508], "label": "small banana"},
  {"point": [287, 609], "label": "larger banana"},
  {"point": [223, 303], "label": "pink starfruit"},
  {"point": [435, 172], "label": "paper bag"},
  {"point": [270, 786], "label": "green plastic bowl"},
  {"point": [488, 775], "label": "metal measuring cup"},
  {"point": [673, 580], "label": "dark blue bowl"},
  {"point": [471, 353], "label": "light blue bowl"},
  {"point": [492, 497], "label": "bread"},
  {"point": [525, 429], "label": "lime"}
]
בתמונה הבאה מוצגת דוגמה לאופן שבו הנקודות האלה יכולות להופיע:
איך זה עובד
Gemini Robotics ER 2 מקבל קלט של תמונות, סרטונים או אודיו באמצעות הנחיות בשפה טבעית. הוא מזהה אובייקטים, מסיק מסקנות לגבי ההקשר של הסצנה והיחסים המרחביים, ומחזיר פלט מובנה כמו קואורדינטות או תיבות תוחמות (bounding box).
הוא גם פועל כסוכן: הוא מפרק משימות מורכבות למשימות משנה ומבצע אותן על ידי קריאה לפונקציות של הרובוט או הפעלת קוד שנוצר. לדוגמה, "שים את התפוח בקערה" הופך לרצף של שלבי איתור, אחיזה והנחה.
בדף קריאה להפעלת פונקציות מוסבר איך פועלת קריאה להפעלת פונקציות ב-Gemini.
בטיחות
Gemini Robotics ER 2 פותח תוך התחשבות בבטיחות, אבל אתם אחראים לשמור על סביבה בטוחה סביב הרובוט. מודלים של AI גנרטיבי עלולים לטעות, ורובוטים פיזיים עלולים לגרום נזק. הבטיחות היא בעדיפות עליונה, והפיכת מודלים של AI גנרטיבי לבטוחים לשימוש עם רובוטיקה בעולם האמיתי היא תחום מחקר פעיל וקריטי שלנו. מידע נוסף זמין בדף הבטיחות של Google DeepMind בנושא רובוטיקה.
שיטות מומלצות
כדי לקבל את התוצאות הכי טובות מ-Gemini Robotics ER 2, כדאי לפעול לפי השיטות המומלצות הבאות:
השתמשו בשפה פשוטה וטבעית. תארו מה אתם רוצים שהרובוט יעשה, כמו שהייתם מסבירים לאדם. אם מונח מסוים לא עובד, נסו מילה נרדפת נפוצה.
אופטימיזציה של הקלט החזותי. לפני ששולחים את התמונה, חותכים אותה או מתקרבים לאובייקטים קטנים או לא ברורים. תאורה וניגודיות צבעים נמוכה יכולות להשפיע על הזיהוי.
לפצל משימות מורכבות לשלבים. כדי לשפר את הדיוק בכל משימת משנה, שלחו כל שלב כהנחיה נפרדת.
למשימות שדורשות דיוק גבוה, כדאי לשלוח שאילתות כמה פעמים ולחשב את ממוצע התוצאות. הגישה הזו, שמבוססת על קונצנזוס, מצמצמת את השונות בפלטים המרחביים.
מגבלות
כשמפתחים עם Gemini Robotics ER 2, חשוב להביא בחשבון את המגבלות הבאות:
- זמן אחזור לעומת ביצועים: שאילתות מורכבות, קלט ברזולוציה גבוהה או
thinking_level.HIGHיכולים להאריך את זמני העיבוד. כדאי להשתמש ב-thinking_level.MEDIUMכדי להשיג איזון טוב בין זמן האחזור לביצועים. - הזיות: כמו כל המודלים הגדולים של שפה (LLM), לפעמים Gemini Robotics ER 2 עלול "להזות" או לספק מידע שגוי, במיוחד אם ההנחיות לא ברורות או שהקלט לא תואם להתפלגות.
- תלות באיכות ההנחיה: איכות הפלט של המודל תלויה מאוד בבהירות ובספציפיות של הנחיית הקלט. הנחיות מעורפלות או לא מובנות עלולות להוביל לתוצאות לא אופטימליות.
- משאבי מחשוב: הפעלת המודל, במיוחד עם קלט של וידאו או
thinking_level.HIGH, צורכת משאבי מחשוב נוספים. לפרטים נוספים, עיינו בדף Thinking. סוגי קלט: בנושאים הבאים מפורטות המגבלות של כל מודל:
הודעת פרטיות
אתם מאשרים שהמודלים שמוזכרים במסמך הזה ("המודלים הרובוטיים") משתמשים בנתוני וידאו ואודיו כדי להפעיל ולהזיז את החומרה שלכם בהתאם להוראות שלכם. לכן, יכול להיות שתפעילו את המודלים לרובוטיקה כך שהם יאספו נתונים מאנשים שניתן לזהות, כמו נתוני קול, תמונות ודמיון ("מידע אישי"). אם בחרת להפעיל את המודלים לרובוטיקה באופן שבו נאסף מידע אישי, הסכמת שלא לאפשר לאנשים שניתן לזהות אותם ליצור אינטראקציה עם המודלים לרובוטיקה או להיות נוכחים באזור שסביבם, אלא אם האנשים האלה קיבלו הודעה מספקת על איסוף המידע האישי שלהם והשימוש בו, והסכימו לכך, כפי שמפורט בתנאים ובהגבלות הרלוונטיים של פלטפורמת הסוכן. עליך לוודא שההודעה הזו מאפשרת לאסוף מידע אישי ולהשתמש בו כפי שמפורט בתנאים האלה, ולהשקיע מאמצים סבירים מבחינה מסחרית כדי לצמצם את האיסוף וההפצה של מידע אישי באמצעות שיטות כמו טשטוש פנים והפעלת המודלים הרובוטיים באזורים שאין בהם אנשים שניתן לזהות, ככל שניתן.
המאמרים הבאים
מידע נוסף על Gemini Robotics ER 2 זמין במקורות המידע הבאים:
- מידע על המודל Gemini Robotics ER 2: מפרט טכני, מגבלות טוקנים ויכולות נתמכות.
- התמחור של Gemini Robotics ER: פרטי התמחור ב-Agent Platform.
- חשיבה מרחבית: הצבעה, מעקב, תיבות תוחמות (bounding box) ומסלולים.
- יכולות אג'נטיות: הרצת קוד, קריאת מכשירים והוספת הערות לתמונות.
- תזמור משימות: משימות ארוכות טווח עם ממשקי API מותאמים אישית לרובוטים.
- הבנת הסרטון: איתור רגעים וסיווג ההתקדמות.
- כרטיס המודל Gemini Robotics ER 2: נקודות השוואה להערכה, ארכיטקטורה ופרטי אימון.
- פוסט בבלוג של Gemini Robotics ER 2: הכרזה וסקירה כללית מ-Google DeepMind.
- בטיחות הרובוטיקה של Google DeepMind: מחקר הבטיחות שמאחורי משפחת המודלים.