


Gemini Robotics ER ist ein Vision-Language-Modell (VLM), das fortschrittliches logisches Schlussfolgern über die physische Welt in die Robotik einbringt. Das Modell interpretiert visuelle Daten, führt räumliche und zeitliche Schlussfolgerungen durch, plant mehrstufige Aufgaben und orchestriert Roboter und Tools.
Modelle
Gemini Robotics ER 2 ist ein Update unseres Reasoning-Modells, das präzise Schlussfolgerungen über die physische Umgebung eines Roboters ermöglicht. Es ist auf verkörpertes Denken spezialisiert, z. B. auf die agentische Orchestrierung von Robotern (z. B. mit Vision-Language-Action-Modellen (VLA)), das Verständnis von Robotervideos (einschließlich Fortschrittsverständnis und Erfolgserkennung), das Ablesen von Instrumenten, das Zeigen und das räumliche Denken.
Das folgende Modell ist in der Vorabversion verfügbar:
gemini-robotics-er-2-preview: Basiert auf Gemini 3.5 Flash und bietet verbessertes räumliches Denken, die Möglichkeit, bestimmte Momente in Videos zu finden, die Klassifizierung des Videofortschritts, die Orchestrierung mehrerer Roboter und die Verwendung von Tools in mehreren Schritten. Technische Daten, Token- und Kontingentlimits, unterstützte Funktionen, regionale Verfügbarkeit und Preise finden Sie auf der Seite mit Informationen zum Gemini Robotics ER 2-Modell.
In diesem Leitfaden wird das Google Gen AI SDK mit der Gemini Enterprise Agent Platform verwendet. In jedem Beispiel wird der Client mit enterprise=True initialisiert und mit Google Cloud-Anmeldedaten authentifiziert, sodass Sie das Modell mit Ihrem eigenen Google Cloud -Projekt aufrufen können.
Robotikfunktionen
In der folgenden Tabelle sind die wichtigsten Funktionen von Gemini Robotics ER 2 zusammengefasst:
| Funktion | Beschreibung | Leitfaden |
|---|---|---|
| Räumliches Denken | Auf Objekte zeigen, sie in Videos verfolgen, mit Begrenzungsrahmen erkennen und Trajektorien planen. | Räumliches Denken |
| Agentische Code-Ausführung | Verwenden Sie die Codeausführung, um Bilder zu zoomen oder zuzuschneiden, Instrumente abzulesen und Szenen zu annotieren. | Agentische KI-Funktionen |
| Aufgabenorchestrierung | Kombinieren Sie räumliches Denken mit benutzerdefinierten Roboter-APIs, um langfristige Aufgaben zu erledigen. | Aufgabenorchestrierung |
| Videos verstehen | Momentfindung und Fortschrittsklassifizierung aus kontinuierlichen Videofeeds. | Video-Understanding |
Hinweis
Die Agent Platform authentifiziert sich mit Google Cloud-Anmeldedaten, nicht mit einem Gemini API-Schlüssel. Führen Sie die folgende Einrichtung aus, bevor Sie die Beispiele ausführen:
Installieren Sie das Google Gen AI SDK.
pip install --upgrade google-genaiAktivieren Sie die API in Ihrem Google Cloud -Projekt und achten Sie darauf, dass Sie eine Projekt-ID haben. Sie können ein vorhandenes Projekt verwenden oder ein neues erstellen.
Authentifizieren Sie sich mit Standardanmeldedaten für Anwendungen (Application Default Credentials, ADC). Führen Sie für die lokale Entwicklung Folgendes aus:
gcloud auth application-default loginInitialisieren Sie den Client mit dem Agent Platform-Backend. In allen Python-Beispielen auf dieser Seite wird der folgende Client verwendet. Legen Sie daher Ihre eigene Projekt-ID fest:
from google import genai

client = genai.Client(
    enterprise=True,
    project="your-project-id",
    location="global",
)
Alternativ können Sie die Umgebungsvariable
GOOGLE_GENAI_USE_ENTERPRISE=Truefestlegen, anstattenterprise=Truean den Client zu übergeben.
Jetzt starten
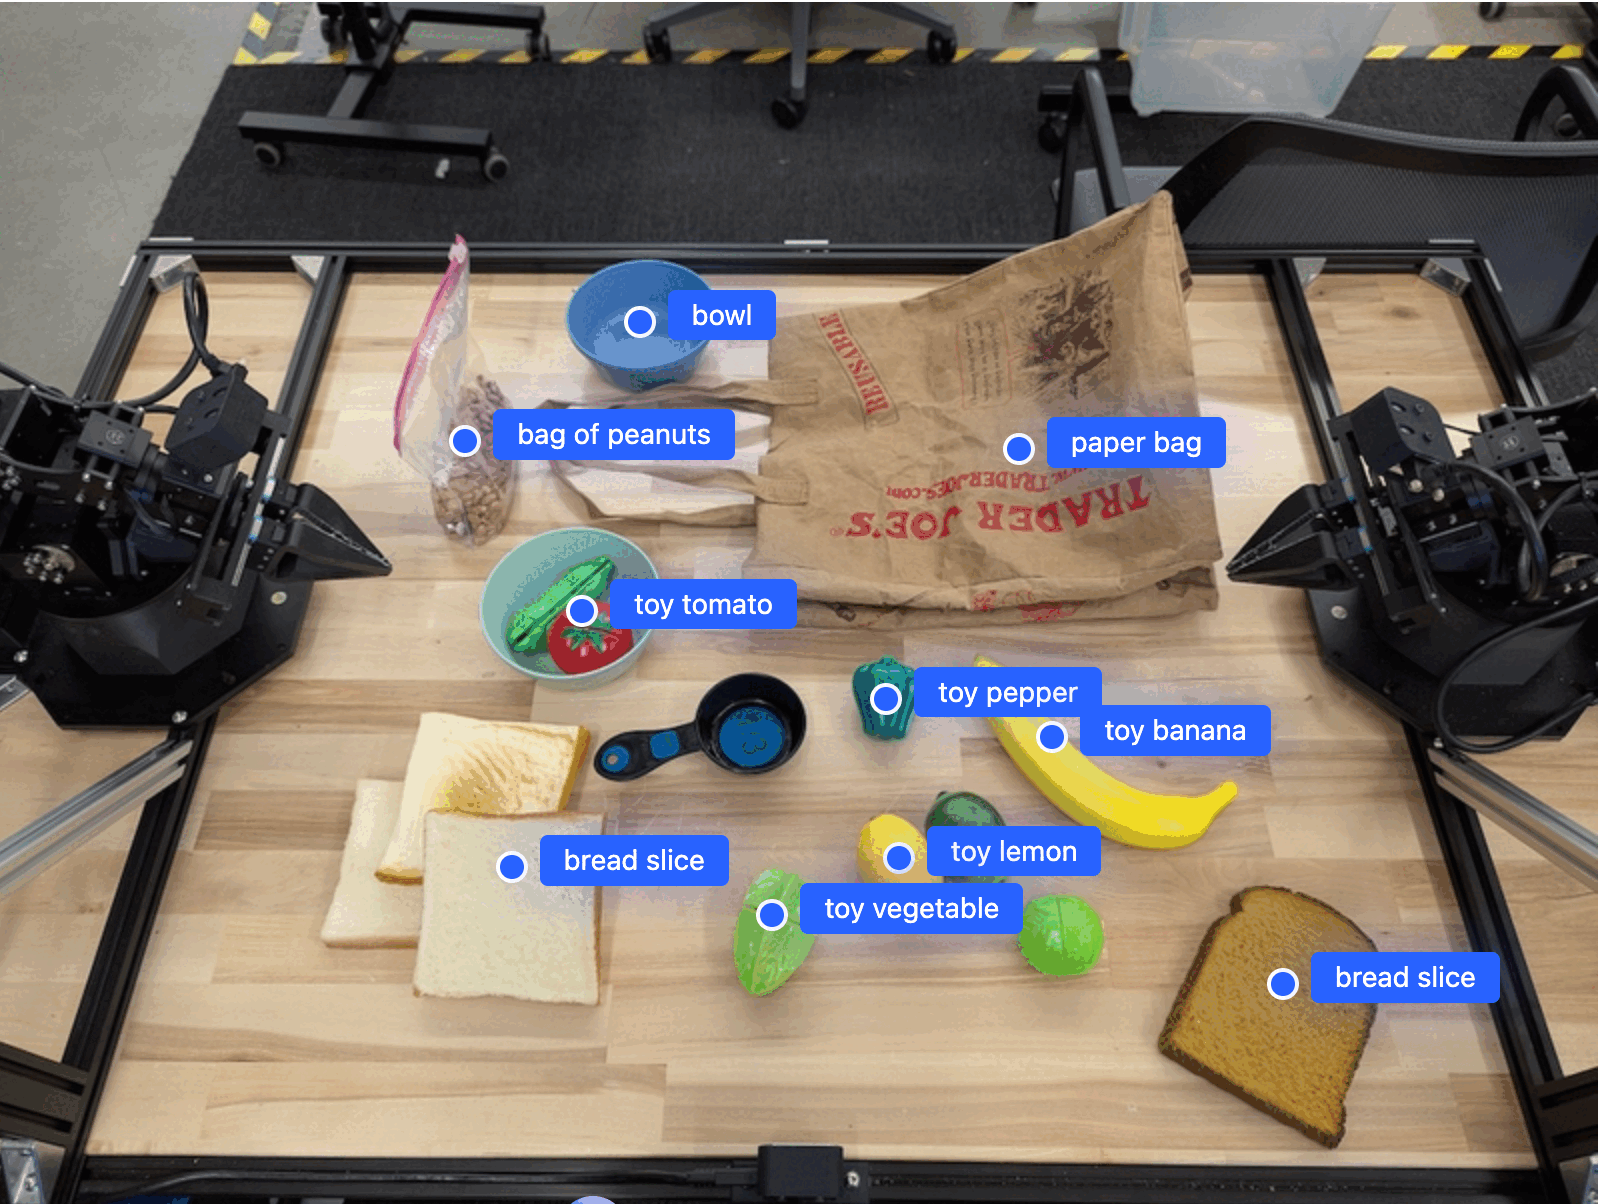
Im folgenden Beispiel werden Objekte in einem Bild gefunden und ihre normalisierten 2D-Koordinaten und Labels zurückgegeben. Sie können diese Ausgabe direkt an eine Robotik-API oder ein Vision-Language-Action-Modell (VLA) übergeben, um Roboteraktionen zu generieren.
Python
from google import genai
from google.genai import types

PROMPT = """
          Point to no more than 10 items in the image. The label returned
          should be an identifying name for the object detected.
          The answer should follow the json format: [{"point": <point>,
          "label": <label1>}, ...]. The points are in [y, x] format
          normalized to 0-1000.
        """
client = genai.Client(
    enterprise=True,
    project="your-project-id",
    location="global",
)

# Load your image
with open("my-image.png", 'rb') as f:
    image_bytes = f.read()

image_response = client.models.generate_content(
    model="gemini-robotics-er-2-preview",
    contents=[
        types.Part.from_bytes(
            data=image_bytes,
            mime_type='image/png',
        ),
        PROMPT
    ],
    config = types.GenerateContentConfig(
        temperature=1.0,
        thinking_config=types.ThinkingConfig(
            thinking_level=types.ThinkingLevel.HIGH
        ),
    )
)

print(image_response.text)
REST
# First, ensure you have the image file locally.
# Encode the image to base64
IMAGE_BASE64=$(base64 -w 0 my-image.png)

# Set your Google Cloud project and location.
export PROJECT_ID="your-project-id"
export LOCATION="global"
export MODEL="gemini-robotics-er-2-preview"

# For the "global" location, use the aiplatform.googleapis.com host.
# For a regional location, prefix the host with the region, for example:
# https://us-central1-aiplatform.googleapis.com

curl -X POST \
  "https://aiplatform.googleapis.com/v1/projects/${PROJECT_ID}/locations/${LOCATION}/publishers/google/models/${MODEL}:generateContent" \
  -H "Authorization: Bearer $(gcloud auth application-default print-access-token)" \
  -H "Content-Type: application/json" \
  -d '{
    "contents": [
      {
        "parts": [
          {
            "inlineData": {
              "mimeType": "image/png",
              "data": "'"${IMAGE_BASE64}"'"
            }
          },
          {
            "text": "Point to no more than 10 items in the image. The label returned should be an identifying name for the object detected. The answer should follow the json format: [{\"point\": [y, x], \"label\": <label1>}, ...]. The points are in [y, x] format normalized to 0-1000."
          }
        ]
      }
    ],
    "generationConfig": {
      "temperature": 1.0,
      "thinkingConfig": {
        "thinkingLevel": "HIGH"
      }
    }
  }'
Die Ausgabe ist ein JSON-Array mit Objekten, die jeweils einen point (normalisierte [y, x]-Koordinaten) und eine label zur Identifizierung des Objekts enthalten.
JSON
[
  {"point": [376, 508], "label": "small banana"},
  {"point": [287, 609], "label": "larger banana"},
  {"point": [223, 303], "label": "pink starfruit"},
  {"point": [435, 172], "label": "paper bag"},
  {"point": [270, 786], "label": "green plastic bowl"},
  {"point": [488, 775], "label": "metal measuring cup"},
  {"point": [673, 580], "label": "dark blue bowl"},
  {"point": [471, 353], "label": "light blue bowl"},
  {"point": [492, 497], "label": "bread"},
  {"point": [525, 429], "label": "lime"}
]
Die folgende Abbildung zeigt ein Beispiel dafür, wie diese Punkte dargestellt werden können:
Funktionsweise
Gemini Robotics ER 2 akzeptiert Bild-, Video- oder Audioeingaben mit Prompts in natürlicher Sprache. Es identifiziert Objekte, zieht Schlussfolgerungen zum Szenenkontext und zu räumlichen Beziehungen und gibt strukturierte Ausgaben wie Koordinaten oder Begrenzungsrahmen zurück.
Es ist auch agentisch: Es zerlegt komplexe Aufgaben in Unteraufgaben und führt sie aus, indem es Ihre Roboterfunktionen aufruft oder generierten Code ausführt. Beispiel: „Lege den Apfel in die Schüssel“ wird zu einer Abfolge von Schritten zum Lokalisieren, Greifen und Platzieren.
Weitere Informationen zu Funktionsaufrufen mit Gemini finden Sie auf der Seite Funktionsaufrufe.
Sicherheit
Gemini Robotics ER 2 wurde mit Blick auf die Sicherheit entwickelt. Es liegt jedoch in Ihrer Verantwortung, für eine sichere Umgebung um den Roboter herum zu sorgen. Generative KI-Modelle können Fehler machen und physische Roboter können Schäden verursachen. Sicherheit hat Priorität. Die Sicherheit generativer KI-Modelle bei der Verwendung mit realen Robotern ist ein aktiver und wichtiger Bereich unserer Forschung. Weitere Informationen finden Sie auf der Google DeepMind-Seite zur Robotersicherheit.
Best Practices
Beachten Sie die folgenden Best Practices, um die besten Ergebnisse mit Gemini Robotics ER 2 zu erzielen:
Verwenden Sie eine einfache, natürliche Sprache. Beschreiben Sie, was der Roboter tun soll, so, wie Sie es einer Person erklären würden. Wenn ein Begriff nicht funktioniert, versuchen Sie es mit einem gängigen Synonym.
Visuelle Eingaben optimieren Schneiden Sie kleine oder unklare Objekte aus oder zoomen Sie heran, bevor Sie das Bild senden. Die Beleuchtung und ein geringer Farbkontrast können die Erkennung beeinträchtigen.
Teilen Sie komplexe Aufgaben in Schritte auf. Senden Sie jeden Schritt als separaten Prompt, um die Genauigkeit bei jeder Teilaufgabe zu verbessern.
Führen Sie bei Aufgaben, die eine hohe Präzision erfordern, mehrere Abfragen durch und bilden Sie den Durchschnitt der Ergebnisse. Dieser Konsensansatz reduziert die Varianz bei räumlichen Ausgaben.
Beschränkungen
Beachten Sie bei der Entwicklung mit Gemini Robotics ER 2 die folgenden Einschränkungen:
- Latenz im Vergleich zur Leistung: Komplexe Abfragen, hochauflösende Eingaben oder
thinking_level.HIGHkönnen zu längeren Verarbeitungszeiten führen. Verwenden Siethinking_level.MEDIUMfür ein ausgewogenes Verhältnis zwischen Latenz und Leistung. - Halluzinationen: Wie alle Large Language Models kann Gemini Robotics ER 2 gelegentlich „halluzinieren“ oder falsche Informationen liefern, insbesondere bei mehrdeutigen Prompts oder Eingaben, die nicht im Trainingsdatensatz enthalten sind.
- Abhängigkeit von der Prompt-Qualität: Die Qualität der Modellausgabe hängt stark von der Klarheit und Spezifität des Eingabe-Prompts ab. Vage oder schlecht strukturierte Prompts können zu suboptimalen Ergebnissen führen.
- Rechenressourcen: Das Ausführen des Modells, insbesondere mit Videoeingaben oder
thinking_level.HIGH, verbraucht zusätzliche Rechenressourcen. Weitere Informationen finden Sie auf der Seite Thinking. Eingabetypen: In den folgenden Themen finden Sie Details zu den Einschränkungen für die einzelnen Modalitäten:
Anmerkung zum Datenschutz
Sie erkennen an, dass die in diesem Dokument genannten Modelle (die „Robotermodelle“) Video- und Audiodaten nutzen, um Ihre Hardware gemäß Ihren Anweisungen zu betreiben und zu bewegen. Sie können die Robotikmodelle daher so betreiben, dass Daten von identifizierbaren Personen, z. B. Sprach-, Bild- und Ähnlichkeitsdaten („personenbezogene Daten“), von den Robotikmodellen erhoben werden. Wenn Sie die Robotikmodelle so betreiben, dass personenbezogene Daten erhoben werden, verpflichten Sie sich, identifizierbaren Personen die Interaktion mit den Robotikmodellen oder den Aufenthalt in deren Umgebung nur dann zu gestatten, wenn diese identifizierbaren Personen ausreichend über die Erhebung und Verwendung ihrer personenbezogenen Daten gemäß den geltenden Nutzungsbedingungen der Agent Platform informiert wurden und dem zugestimmt haben. Sie müssen dafür sorgen, dass diese Mitteilung die Erhebung und Verwendung personenbezogener Daten gemäß diesen Bedingungen zulässt. Außerdem müssen Sie sich in wirtschaftlich angemessener Weise bemühen, die Erhebung und Weitergabe personenbezogener Daten zu minimieren, indem Sie Techniken wie die Unkenntlichmachung von Gesichtern verwenden und die Robotermodelle nach Möglichkeit in Bereichen betreiben, in denen sich keine identifizierbaren Personen befinden.
Nächste Schritte
Weitere Informationen zu Gemini Robotics ER 2 finden Sie in den folgenden Ressourcen:
- Informationen zum Gemini Robotics ER 2-Modell: technische Daten, Tokenlimits und unterstützte Funktionen.
- Preise für Gemini Robotics ER: Preisdetails für die Agent Platform.
- Räumliches Denken: Zeigen, Tracking, Begrenzungsrahmen und Trajektorien.
- Agentische Funktionen: Code-Ausführung, Instrumentenablesung und Bildannotation.
- Aufgabenorchestrierung: Langfristige Aufgaben mit benutzerdefinierten Roboter-APIs.
- Videoverständnis: Momentfindung und Fortschrittsklassifizierung.
- Modellkarte für Gemini Robotics ER 2: Bewertungsbenchmarks, Architektur und Trainingsdetails.
- Blogpost zu Gemini Robotics ER 2: Ankündigung und Übersicht von Google DeepMind.
- Google DeepMind-Robotiksicherheit: Sicherheitsforschung hinter der Modellfamilie.