


Agent Platform 可為專案處理的每項推論要求,寫入一筆結構化記錄項目。每筆記錄都會記錄要求的相關中繼資料:模型、區域、詞元數量 (包括輸入詞元、輸出詞元、快取詞元、思考詞元)、佈建輸送量消耗、端對端要求延遲時間、錯誤代碼,以及您附加的任何標頭標籤或要求標籤。項目會傳送至 Cloud Logging,您可以在可觀測性分析中使用 SQL 查詢。如要啟用記錄功能,請參閱「啟用推論要求中繼資料記錄」。
推論要求記錄功能只會記錄中繼資料,不會記錄提示或回覆。如果需要提示和回覆內容,請改用要求-回覆記錄。
本頁面說明如何啟用推論要求中繼資料記錄、各項目的內容,以及如何查詢這些項目。
用途
推論要求中繼資料記錄可回答匯總指標無法回答的問題:
- 將自己的標頭標籤、要求標籤或兩者附加至各項要求,即可將權杖支出歸因於團隊、應用程式或租戶。
- 查看哪些個別要求計入佈建輸送量配額,哪些是依需求提供。
- 依標頭標籤或要求標籤細分處理量、延遲時間和錯誤率。
- 評估每個要求的快取行為,而非匯總評估。
- 掌握第二層的使用情形,例如專案收到 429 錯誤的原因,或佈建輸送量溢出的原因。如要瞭解如何解決 429 錯誤,請參閱「排解錯誤代碼 429」。如要找出收到這些錯誤的秒數,請參閱「各區域的錯誤率和延遲時間」。
支援的記錄 API 方法
推論要求中繼資料記錄支援下列項目:
- 使用
generateContent或streamGenerateContent的 Gemini 模型,包括透過這些方法生成圖像。 - 使用
rawPredict或streamRawPredict的 Claude 模型。其他合作夥伴模型不會記錄。如要瞭解 Claude 欄位名稱,請參閱「Claude 模型的詞元數量」。
支援佈建輸送量和所有即付即用選項。
不支援以下項目:
chatCompletions。embedContent、predict和countTokens。透過predict生成圖像的模型 (例如 Imagen) 不會記錄。- 對微調模型 (包括以監督式微調技術調整的 Gemini 模型) 提出的要求。
- 調整工作、批次推論和任何其他長時間執行的作業。
- 您在自訂容器中自行部署的模型。
啟用推論要求中繼資料記錄
您可以為整個專案,或特定區域中的特定模型,設定推論要求中繼資料記錄。如需在組織層級啟用,請與帳戶團隊聯絡。記錄設定可能需要幾分鐘才會生效。
事前準備
- 請確認您具備專案的下列 IAM 權限:
aiplatform.endpoints.setPublisherModelConfig和aiplatform.endpoints.fetchPublisherModelConfig,用於變更及讀取設定;logging.buckets.get、logging.buckets.list、logging.buckets.update和logging.operations.get,用於升級記錄檔 bucket。如要瞭解包含這些權限的預先定義角色,請參閱「存取控管」和「Logging 的存取控管」。 - 決定是否要將
_Default記錄檔 bucket 升級為 Observability Analytics。您必須升級,才能使用 SQL 查詢項目,或在 Google Cloud 控制台查看詳細指標。升級作業會在幾分鐘內完成,而且無法復原。升級前寫入的項目,在升級後無法使用 SQL 查詢。 - 查看 Cloud Logging 定價。項目會儲存至值區的保留期限 (預設為 30 天),並須支付 Cloud Logging 擷取和儲存費用。如要估算費用,請參閱「定價」。
在控制台中啟用
在控制台啟用這項功能後,專案中所有模型 (Gemini 和 Claude) 的記錄功能都會開啟,包括佈建輸送量和記錄支援的所有即付即用選項。如果 _Default 記錄檔 bucket 尚未升級,系統也會一併升級。這項設定會套用「設定優先順序」一節所述的專案層級預設值。開始前,請先查看權限和 bucket 升級。
前往 Google Cloud 控制台的「Provisioned Throughput」(佈建輸送量) 頁面。
執行下列其中一個步驟:
- 在「Gemini Enterprise Agent Platform is upgrading observability」(Gemini Enterprise Agent Platform 正在升級觀測功能) 橫幅中,按一下「Enable」(啟用)。
- 在工具列中,按一下「指標設定」。選取「Enable detailed metrics」(啟用詳細指標),然後按一下「Save」(儲存)。

圖 1. 「佈建輸送量」頁面上的觀測能力升級橫幅。 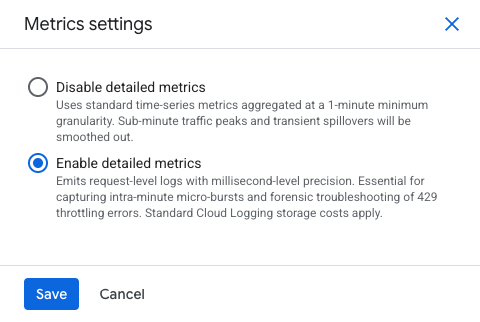
圖 2. 「指標設定」面板,已選取「啟用詳細指標」。 在「Enable detailed metrics?」(要啟用詳細指標嗎?) 對話方塊中,查看記錄和 bucket 升級詳細資料,然後按一下「Enable」(啟用)。
開啟記錄功能後,對話方塊就會立即關閉。bucket 升級作業會在背景繼續執行,可能需要幾分鐘才能完成。執行期間,橫幅會顯示「詳細指標已啟用,這項專案的記錄檔 bucket『_Default』正在升級為使用 Observability Analytics」。
如果橫幅顯示 bucket 尚未升級,請按一下「Upgrade」(升級) 重試。如果系統回報 bucket 無法升級,就無法查詢個別要求的記錄。按一下「Metrics settings」(指標設定),然後選取「Disable detailed metrics」(停用詳細指標),即可停止計費。
設定優先順序
Agent Platform 會按照下列順序解析每項要求的設定:
- 個別模型和區域的設定 (如有設定)。
- 如果未設定個別模型,則會套用專案層級的預設值。
- 如果兩者皆未設定,則不會記錄。
個別模型設定的優先順序高於專案預設值。您可以啟用整個專案的記錄功能,並關閉某個區域中高用量模型的記錄功能,反之亦然。
透過 REST API 啟用
您可以使用 setPublisherModelConfig 方法設定推論要求中繼資料記錄,並將 inferenceEventLoggingConfig.state 設為 ENABLED。
如要設定專案層級的預設值,請指定專案:
curl -X POST \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://aiplatform.googleapis.com/v1beta1/projects/PROJECT_ID:setPublisherModelConfig" \
  -d '{
        "publisherModelConfig": {
          "inferenceEventLoggingConfig": {"state": "ENABLED"}
        },
        "updateMask": "inferenceEventLoggingConfig"
      }'
如要覆寫某個區域中的一個模型,請指定發布者模型:
curl -X POST \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://aiplatform.googleapis.com/v1beta1/projects/PROJECT_ID/locations/LOCATION/publishers/PUBLISHER/models/MODEL:setPublisherModelConfig" \
  -d '{
        "publisherModelConfig": {
          "inferenceEventLoggingConfig": {"state": "ENABLED"}
        },
        "updateMask": "inferenceEventLoggingConfig"
      }'
Gemini 模型請將 PUBLISHER 設為 google,Claude 模型則設為 anthropic。舉例來說,如要為全域端點上的 Claude Sonnet 4.5 啟用記錄功能,請使用 publishers/anthropic/models/claude-sonnet-4-5,並將 LOCATION 設為 global。如要查看 Claude 模型 ID,請參閱「Claude 模型」。
這個方法會傳回長時間執行的作業。
取得記錄設定
使用 fetchPublisherModelConfig 方法讀取目前的設定。使用專案可讀取專案層級的預設值,使用發布者模型則可讀取覆寫值。
curl -X GET \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  "https://aiplatform.googleapis.com/v1beta1/projects/PROJECT_ID:fetchPublisherModelConfig"
curl -X GET \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  "https://aiplatform.googleapis.com/v1beta1/projects/PROJECT_ID/locations/LOCATION/publishers/PUBLISHER/models/MODEL:fetchPublisherModelConfig"
回應會包含該資源的設定:
{
  "inferenceEventLoggingConfig": {
    "state": "ENABLED"
  }
}
確認記錄功能正常運作
- 向已啟用的模型傳送一項要求。
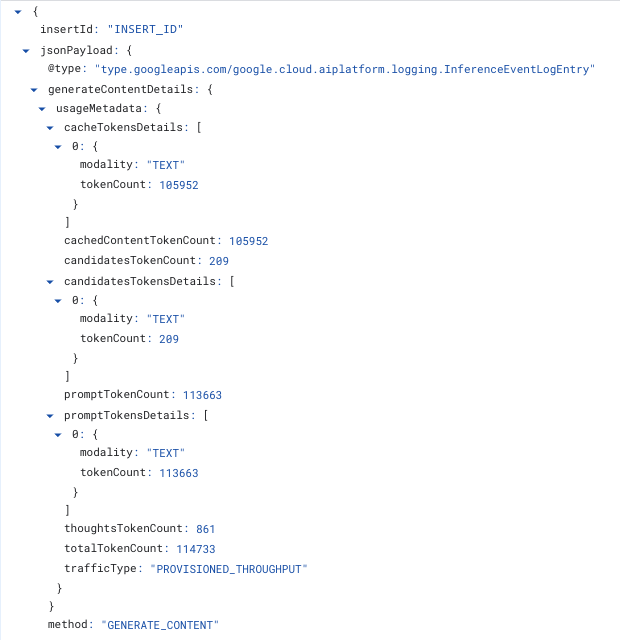
在Logs Explorer中執行下列查詢。大多數項目會在 12 秒內顯示,最多可能需要 5 分鐘。
logName="projects/PROJECT_ID/logs/aiplatform.googleapis.com%2Finference_request"如要確認 SQL 是否正常運作,請開啟 Observability Analytics,並執行任何範例查詢。如果查詢回報找不到資料集,表示記錄檔 bucket 升級尚未完成。
停用記錄
在 Google Cloud 控制台,前往「Provisioned Throughput」(佈建輸送量) 頁面,按一下「Metrics settings」(指標設定),選取「Disable detailed metrics」(停用詳細指標),然後按一下「Save」(儲存)。這會撤銷在控制台中啟用。
如要使用 REST API,請按照下列步驟操作。
在啟用記錄功能的資源上,將 inferenceEventLoggingConfig.state 設為 DISABLED,即可停用記錄功能。
curl -X POST \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://aiplatform.googleapis.com/v1beta1/projects/PROJECT_ID:setPublisherModelConfig" \
  -d '{
        "publisherModelConfig": {
          "inferenceEventLoggingConfig": {"state": "DISABLED"}
        },
        "updateMask": "inferenceEventLoggingConfig"
      }'
由於個別模型設定的優先順序高於專案預設值,因此在專案層級停用模型,並不會關閉明確啟用的模型。同時清除或停用個別模型設定。
記錄寫入位置
項目會寫入下列記錄:
projects/PROJECT_NUMBER/logs/aiplatform.googleapis.com%2Finference_request
接著,您會看到標準 Cloud Logging 目的地:
- Observability Analytics:在Google Cloud 控制台的 Observability Analytics 中,使用 SQL 查詢項目。
- 連結的 BigQuery 資料集:連結資料集,從 BigQuery 讀取相同資料。詳情請參閱「查詢連結的 BigQuery 資料集」。
- 匯總接收器:使用單一接收器,收集資料夾或組織下每個專案的項目。依「
logName="projects/*/logs/aiplatform.googleapis.com%2Finference_request"」篩選。
如要從資料夾或組織中的每個專案收集項目,請參閱「匯總接收器總覽」。
要求完成後,很快就能查詢項目。大多數項目可在 12 秒內查詢,最多可能需要 5 分鐘。
記錄項目結構定義
每個項目都有兩個部分,可分別查詢:受監控資源及其標籤 (用於識別處理要求的項目),以及 JSON 酬載 (用於記錄要求執行的動作)。以下各節將說明這兩種方法。
資源標籤
如果是共用發布者模型,受監控資源類型為 aiplatform.googleapis.com/PublisherModel,並具有下列標籤。
| 標籤 | 類型 | 附註 |
|---|---|---|
resource_container |
STRING |
提供要求的專案。 |
location |
STRING |
提供要求的區域,例如 us-central1。傳送至全域端點的要求會回報 global。 |
publisher |
STRING |
模型發布者,例如 google 或 anthropic。 |
model_user_id |
STRING |
模型,例如 gemini-2.5-pro。 |
酬載欄位
| 欄位名稱 | 類型 | 附註 |
|---|---|---|
method |
ENUM |
GENERATE_CONTENT、STREAM_GENERATE_CONTENT、RAW_PREDICT 或 STREAM_RAW_PREDICT。 |
trafficType |
ENUM |
提供要求的計費模式。目前的值為 PROVISIONED_THROUGHPUT、ON_DEMAND、ON_DEMAND_FLEX 和 ON_DEMAND_PRIORITY。如果要求失敗,則不會顯示。 |
requestStartTime |
TIMESTAMP |
提供服務的前端接受要求的時間。 |
requestDuration |
STRING |
端對端服務延遲時間,格式為時間長度字串,例如 3.53s。 |
generateContentDetails.usageMetadata |
JSON |
generateContent 和 streamGenerateContent 的詞元數量,包括各模態的細目。圖片輸出內容會以 candidatesTokensDetails 中的 IMAGE 項目顯示。 |
rawPredictDetails.usageMetadata |
JSON |
rawPredict 和 streamRawPredict 的詞元數量,包括合作夥伴模型。 |
provisionedThroughput |
JSON |
佈建輸送量流量會顯示。 |
httpHeaders |
JSON |
擷取的要求標頭。 |
error |
JSON |
只有在嚴重程度為 ERROR 時才會顯示。 |
principal |
JSON |
發出要求的服務帳戶 (如有)。 |
LogEntry.labels 欄位包含 gen_ai.operation.name,遵循 OpenTelemetry GenAI 語意慣例。generateContent 和 streamGenerateContent 都會回報 generate_content。rawPredict 和 streamRawPredict 都會回報 raw_predict。
佈建輸送量欄位
| 欄位名稱 | 類型 | 附註 |
|---|---|---|
ptChargedInputTokenCount |
INT64 |
套用消耗率後,計入佈建輸送量配額的輸入權杖。 |
ptChargedOutputTokenCount |
INT64 |
套用消耗率後,輸出詞元會計入佈建輸送量配額。 |
accountingResource |
STRING |
要求使用的佈建輸送量承諾使用合約所屬專案。 |
找出溢出請求
如果要求符合佈建輸送量的條件,但因輸送量用盡而改以隨需方式提供,就會溢出。溢出項目具有 ON_DEMAND 的 trafficType,且沒有 provisionedThroughput 物件。一般即付即用要求看起來相同,因此請使用下列規則來區分:
- 如果您傳送的
X-Vertex-AI-LLM-Request-Type值為shared,代表您刻意將要求轉送至即付即用。這不是溢出。 - 如果您未傳送
X-Vertex-AI-LLM-Request-Type標頭,或傳送的值不是dedicated或shared,且項目回報ON_DEMAND,則要求會溢出,前提是您在該區域有該模型的佈建輸送量。 - 如果沒有模型的佈建輸送量,則每個
ON_DEMAND項目都是一般的即付即用。
如要瞭解標頭值,請參閱「使用佈建輸送量」。
如要查詢溢出要求數,請參閱「每分鐘溢出量」。
找出降級的要求
如果您要求某個即付即用選項,但系統以另一個選項提供服務,要求就會降級。比較您傳送的 X-Vertex-AI-LLM-Shared-Request-Type 標頭與提供要求的 trafficType:
| 您傳送的標頭值 | trafficType (依要求放送) |
|---|---|
priority |
ON_DEMAND_PRIORITY |
flex |
ON_DEMAND_FLEX |
如果成功項目有任何其他 trafficType,表示要求已降級,或模型不提供您要求的選項。如需查詢,請參閱「依模型降級」。
錯誤代碼
失敗的要求會以 ERROR 的嚴重性寫入,並包含一個 error 物件,其中含有 gRPC 狀態碼和標準原因。原因為固定字串。絕不會包含提示文字、回覆文字或標頭值。
| 程式碼 | 狀態 | 常見的 HTTP 狀態 |
|---|---|---|
8 |
資源已用盡,例如配額限制。 | 429 |
4 |
作業完成前已過期。 | 504 |
14 |
服務無法使用。 | 503 |
13 |
發生內部錯誤。 | 500 |
3 |
要求含有無效引數。 | 400 |
7 |
呼叫端沒有權限。 | 403 |
5 |
找不到要求的實體。 | 404 |
附加自訂標頭標籤
如要將用量歸因於您自己的維度 (例如團隊、應用程式或租戶),請傳送前置字元為 x-goog-agent-platform-observability-label- 的要求標頭:
x-goog-agent-platform-observability-label-team: payments
x-goog-agent-platform-observability-label-application: invoice-ocr
每個標頭都會顯示在 jsonPayload.httpHeaders 下方的項目中。標頭標籤適用於 Gemini 模型的 generateContent 和 streamGenerateContent,以及 Claude 模型的 rawPredict 和 streamRawPredict,並支援佈建輸送量和所有即付即用選項。
如需標頭標籤的 API 呼叫範例、產生的記錄項目、支援的模型、限制,以及標頭標籤與要求標籤的比較,請參閱「自訂中繼資料標籤」。如要查詢,請參閱「依自訂標頭標籤查看用量」。
使用 Logs Explorer 查詢記錄
使用 Logs Explorer 尋找及檢查個別推論要求。只要啟用記錄功能,不需額外設定,系統就會直接讀取記錄,因此項目一送達就會顯示。
前往 Google Cloud 控制台的「Logs Explorer」頁面,使用 Logging 查詢語言在查詢編輯器欄位中輸入查詢。如要進一步瞭解窗格和控制項,請參閱「Logs Explorer 介面」。
從記錄名稱開始,選取專案中的每個推論要求項目:
logName="projects/PROJECT_ID/logs/aiplatform.googleapis.com%2Finference_request"
新增字詞可縮小結果範圍。不同行的字詞會以 AND 結合。
- 如要選取從某個區域提供的要求,請新增
resource.labels.location="us-central1"。 - 如要選取一個 API 方法,請新增
jsonPayload.method="GENERATE_CONTENT"。 - 如要僅選取佈建輸送量流量,請新增
jsonPayload.trafficType="PROVISIONED_THROUGHPUT"。 - 如要只選取配額錯誤,請新增
severity=ERROR和jsonPayload.error.code=8。 - 如要選取一個自訂標頭標籤值,請新增
jsonPayload.httpHeaders."x-goog-agent-platform-observability-label-team".values="payments"。
Logs Explorer 會篩選並顯示項目。不會進行匯總。如要計算、分組或繪製項目圖表,請使用 Observability Analytics。在「Query results」(查詢結果) 工具列中,點選「Analyze results」(分析結果),即可將目前的查詢帶到新分頁。升級記錄檔 bucket 後,才會顯示這個按鈕。
使用 Observability Analytics 查詢及分析記錄
您可以使用 Observability Analytics 查詢及分析記錄。
事前準備
Observability Analytics 可回答記錄檔探索工具無法回答的問題。Logs Explorer 會尋找並顯示個別項目,這在您追蹤單一要求時非常實用。Observability Analytics 會對整個資料集執行 SQL,因此可以計算、分組、彙整及計算百分位數。本節中的每個問題都需要匯總:每個團隊的支出、每個專案的燃盡圖,以及每個區域的 p95 延遲時間,都無法一次回答一個項目。
這項操作需要將專案中的 _Default 記錄檔 bucket 升級,才能使用 Observability Analytics。詳情請參閱「設定記錄檔 bucket」。
下列範例會在 Observability Analytics 中執行。將 PROJECT_ID 替換為您的專案。
處理量 (依區域和模型分組)
SELECT
  JSON_VALUE(resource.labels.location)      AS region,
  JSON_VALUE(resource.labels.model_user_id) AS model,
  JSON_VALUE(json_payload.trafficType)      AS traffic_type,
  COUNT(*)                                  AS requests,
  SUM(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.promptTokenCount) AS INT64))     AS input_tokens,
  SUM(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.candidatesTokenCount) AS INT64)) AS output_tokens
FROM `PROJECT_ID.global._Default._Default`
WHERE log_id = "aiplatform.googleapis.com/inference_request"
  AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 24 HOUR)
GROUP BY region, model, traffic_type
ORDER BY requests DESC
各專案的佈建輸送量消耗情形
SELECT
  JSON_VALUE(resource.labels.location) AS region,
  JSON_VALUE(json_payload.provisionedThroughput.accountingResource) AS pt_project,
  COUNTIF(JSON_VALUE(json_payload.trafficType) = "PROVISIONED_THROUGHPUT") AS pt_requests,
  COUNTIF(JSON_VALUE(json_payload.trafficType) = "ON_DEMAND")              AS on_demand_requests,
  SUM(CAST(JSON_VALUE(json_payload.provisionedThroughput.ptChargedInputTokenCount)  AS INT64)) AS pt_input_tokens,
  SUM(CAST(JSON_VALUE(json_payload.provisionedThroughput.ptChargedOutputTokenCount) AS INT64)) AS pt_output_tokens
FROM `PROJECT_ID.global._Default._Default`
WHERE log_id = "aiplatform.googleapis.com/inference_request"
  AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 24 HOUR)
GROUP BY region, pt_project
ORDER BY pt_input_tokens DESC
依自訂標頭標籤區分的使用量
SELECT
  JSON_VALUE(json_payload.httpHeaders
    ["x-goog-agent-platform-observability-label-team"].values[0]) AS team,
  COUNT(*) AS requests,
  SUM(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.totalTokenCount) AS INT64)) AS total_tokens
FROM `PROJECT_ID.global._Default._Default`
WHERE log_id = "aiplatform.googleapis.com/inference_request"
  AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 7 DAY)
GROUP BY team
ORDER BY total_tokens DESC
Gemini 和 Claude 每分鐘使用的權杖數量並列比較
這項查詢會依發布商分欄,回報每分鐘使用的權杖數量。每個資料欄對權杖類型的加權方式,與 publisher/online_serving/consumed_token_throughput 指標對該發布者的加權方式相同,因此每個資料欄都與 Cloud Monitoring 相符。Gemini 和 Claude 對輸出和快取權杖的權重不同,因此請勿將這兩欄相加。如需 Claude 欄位,請參閱「Claude 模型的詞元數量」。
SELECT
  TIMESTAMP_TRUNC(timestamp, MINUTE) AS minute_ts,
  SUM(IF(JSON_VALUE(resource.labels.publisher) = "google",
    IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.promptTokenCount) AS INT64), 0)
      + IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.toolUsePromptTokenCount) AS INT64), 0)
      - 0.9 * IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.cachedContentTokenCount) AS INT64), 0)
      + IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.candidatesTokenCount) AS INT64), 0)
      + IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.thoughtsTokenCount) AS INT64), 0), 0)) AS gemini_consumed_tokens,
  SUM(IF(JSON_VALUE(resource.labels.publisher) = "anthropic",
    IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.input_tokens) AS INT64), 0)
      + 0.1  * IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.cache_read_input_tokens) AS INT64), 0)
      + 1.25 * IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.cache_creation_input_tokens) AS INT64), 0)
      + 0.75 * IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.cache_creation.ephemeral_1h_input_tokens) AS INT64), 0)
      + 5    * IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.output_tokens) AS INT64), 0), 0)) AS claude_consumed_tokens
FROM `PROJECT_ID.global._Default._Default`
WHERE log_id = "aiplatform.googleapis.com/inference_request"
  AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 24 HOUR)
GROUP BY minute_ts
ORDER BY minute_ts DESC
Gemini 和 Claude 的快取命中率
快取命中率的計算方式,是將快取輸入詞元數除以輸入詞元總數。Gemini 輸入內容包含工具使用權杖,因為快取可以涵蓋這些權杖。Claude 輸入內容包含未快取的輸入內容、快取讀取和快取寫入。如要瞭解各發布商的快取方式,請參閱「脈絡快取總覽」和「Claude 提示快取」。
SELECT
  JSON_VALUE(resource.labels.model_user_id) AS model,
  JSON_VALUE(json_payload.trafficType)      AS traffic_type,
  ROUND(100 * SAFE_DIVIDE(
    SUM(IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.cachedContentTokenCount) AS INT64), 0)
      + IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.cache_read_input_tokens) AS INT64), 0)),
    SUM(GREATEST(
          IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.promptTokenCount) AS INT64), 0)
          + IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.toolUsePromptTokenCount) AS INT64), 0),
          IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.cachedContentTokenCount) AS INT64), 0))
      + IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.input_tokens) AS INT64), 0)
      + IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.cache_read_input_tokens) AS INT64), 0)
      + IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.cache_creation_input_tokens) AS INT64), 0))), 1) AS cache_hit_rate_pct
FROM `PROJECT_ID.global._Default._Default`
WHERE log_id = "aiplatform.googleapis.com/inference_request"
  AND JSON_VALUE(json_payload.trafficType) IS NOT NULL
  AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 7 DAY)
GROUP BY model, traffic_type
ORDER BY model, traffic_type
各型號的降級項目
這項查詢會比較各項要求指定的即付即用選項,以及實際提供服務的選項。如要瞭解如何識別降級,請參閱「識別降級要求」。
WITH entries AS (
  SELECT
    JSON_VALUE(resource.labels.model_user_id) AS model,
    severity,
    JSON_VALUE(json_payload.trafficType)      AS served,
    (SELECT LOWER(v)
     FROM UNNEST(JSON_VALUE_ARRAY(json_payload.httpHeaders["x-vertex-ai-llm-shared-request-type"].values)) AS v
     WHERE LOWER(v) IN ("priority", "flex")
     LIMIT 1)                                 AS requested
  FROM `PROJECT_ID.global._Default._Default`
  WHERE log_id = "aiplatform.googleapis.com/inference_request"
    AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 7 DAY)
)
SELECT
  model,
  requested,
  COUNTIF(served = CONCAT("ON_DEMAND_", UPPER(requested))) AS served_as_requested,
  COUNTIF(served IS NOT NULL
          AND served != CONCAT("ON_DEMAND_", UPPER(requested))) AS downgraded,
  COUNTIF(severity = "ERROR")                              AS failed
FROM entries
WHERE requested IS NOT NULL
GROUP BY model, requested
ORDER BY downgraded DESC
每分鐘溢出量
這項查詢會計算在指定時間範圍內,有佈建輸送量流量的各個模型,每分鐘的溢出要求數。如要瞭解如何識別溢出,請參閱「識別溢出要求」。
WITH entries AS (
  SELECT
    timestamp,
    JSON_VALUE(resource.labels.location)      AS region,
    JSON_VALUE(resource.labels.model_user_id) AS model,
    JSON_VALUE(json_payload.trafficType)      AS traffic_type,
    EXISTS(
      SELECT 1
      FROM UNNEST(JSON_VALUE_ARRAY(json_payload.httpHeaders["x-vertex-ai-llm-request-type"].values)) AS v
      WHERE LOWER(v) IN ("dedicated", "shared")) AS routed_by_header
  FROM `PROJECT_ID.global._Default._Default`
  WHERE log_id = "aiplatform.googleapis.com/inference_request"
    AND severity = "INFO"
    AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 24 HOUR)
),
pt_models AS (
  SELECT DISTINCT region, model FROM entries WHERE traffic_type = "PROVISIONED_THROUGHPUT"
)
SELECT
  TIMESTAMP_TRUNC(e.timestamp, MINUTE) AS minute_ts,
  e.region,
  e.model,
  COUNTIF(e.traffic_type = "PROVISIONED_THROUGHPUT")              AS pt_requests,
  COUNTIF(e.traffic_type = "ON_DEMAND" AND NOT e.routed_by_header) AS spillover_requests
FROM entries AS e
JOIN pt_models USING (region, model)
GROUP BY minute_ts, e.region, e.model
HAVING spillover_requests > 0
ORDER BY minute_ts DESC
各區域的錯誤率和延遲時間
SELECT
  JSON_VALUE(resource.labels.location) AS region,
  TIMESTAMP_TRUNC(timestamp, MINUTE)   AS minute_ts,
  COUNT(*)                             AS total,
  COUNTIF(severity = "ERROR")          AS errors,
  COUNTIF(CAST(JSON_VALUE(json_payload.error.code) AS INT64) = 8) AS resource_exhausted,
  APPROX_QUANTILES(
    CAST(REGEXP_REPLACE(JSON_VALUE(json_payload.requestDuration), r"s$", "") AS FLOAT64),
    100)[OFFSET(95)] AS p95_latency_seconds
FROM `PROJECT_ID.global._Default._Default`
WHERE log_id = "aiplatform.googleapis.com/inference_request"
  AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 6 HOUR)
GROUP BY region, minute_ts
ORDER BY minute_ts DESC
Claude 模型的詞元數量
Claude 模型會使用 Claude API 欄位名稱,在 rawPredictDetails.usageMetadata 下方回報用量。rawPredict 和 streamRawPredict 都會寫入相同的欄位;如果是串流,記錄會合併串流中回報的用量。
| 欄位 | 計算項目 |
|---|---|
input_tokens |
未從快取讀取或寫入快取的輸入詞元。 |
cache_read_input_tokens |
從提示快取讀取的輸入詞元。 |
cache_creation_input_tokens |
寫入提示快取的輸入詞元,包含兩個存留時間。 |
cache_creation.ephemeral_5m_input_tokens |
快取寫入作業的存留時間為 5 分鐘。 |
cache_creation.ephemeral_1h_input_tokens |
快取寫入作業的存留時間為 1 小時。 |
output_tokens |
輸出內容詞元,包括延伸思考。請勿另外新增思考詞元。 |
Claude 輸入總量為 input_tokens + cache_read_input_tokens + cache_creation_input_tokens。Gemini 則不同:promptTokenCount已包含快取詞元。
Claude 項目沒有模態細目。Gemini 和 Claude 的標頭標籤運作方式相同,請參閱「附加自訂標頭標籤」。
定價
推論要求中繼資料記錄會寫入 Cloud Logging,並以 Cloud Logging 擷取和儲存費用計費。透過 Observability Analytics 查詢會計入 Cloud Monitoring 用量。連結 BigQuery 資料集不會產生 BigQuery 儲存費用。
項目大小取決於要求,例如要求攜帶的標頭標籤數量。如要估算費用,請啟用代表性工作負載的記錄功能一天,使用記錄量分析測量擷取量,然後在 Google Cloud Pricing Calculator 中預估每月用量。
後續步驟
- 瞭解如何使用指標監控模型。
- 瞭解如何使用自訂中繼資料標籤監控費用。
- 如需提示和回覆內容,請使用要求-回覆記錄。
- 瞭解佈建輸送量。
- 在 Google Cloud 控制台查看佈建輸送量的詳細指標。
- 疑難排解 429 錯誤。
- 使用匯總接收器,收集資料夾或組織中每個專案的項目。