


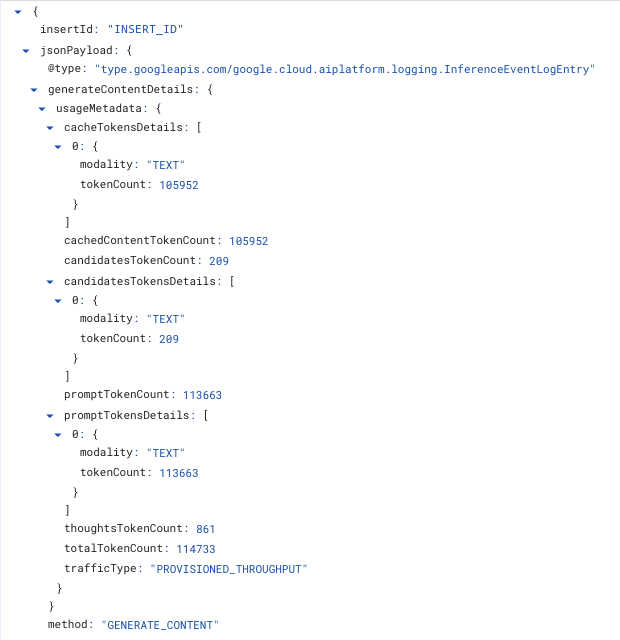
A Plataforma de Agentes pode gravar uma entrada de registro estruturada para cada solicitação de inferência que seu projeto processa. Cada entrada registra metadados sobre a solicitação: o modelo, a região, as contagens de tokens (incluindo tokens de entrada, de saída, em cache e de pensamento), as reduções da capacidade de processamento provisionada, a latência de solicitação de ponta a ponta, o código do erro e todos os rótulos de cabeçalho ou de solicitação que você anexar. As entradas vão para o Cloud Logging, e você pode consultá-las com SQL na Análise de Observabilidade. Para ativar a geração de registros, consulte Ativar registros de metadados de solicitação de inferência.
A geração de registros de solicitações de inferência registra apenas metadados. Ele não grava comandos nem respostas. Se você precisar de conteúdo de comando e resposta, use a geração de registros de solicitação-resposta.
Nesta página, descrevemos como ativar os registros de metadados de solicitação de inferência, o que cada entrada contém e como consultá-los.
Casos de uso
Os registros de metadados de solicitação de inferência respondem a perguntas que as métricas agregadas não conseguem:
- Atribua o gasto de tokens a uma equipe, um aplicativo ou um locatário anexando seus próprios rótulos de cabeçalho, rótulos de solicitação ou ambos a cada solicitação.
- Veja quais solicitações individuais foram contabilizadas na sua cota de capacidade de processamento provisionada e quais foram atendidas sob demanda.
- Divida a capacidade, a latência e a taxa de erros por rótulos de cabeçalho ou de solicitação.
- Meça o comportamento de armazenamento em cache por solicitação, em vez de em conjunto.
- Tenha visibilidade do uso no segundo nível, por exemplo, por que um projeto recebeu erros 429 ou por que a capacidade de processamento provisionada transbordou. Para saber como resolver erros 429, consulte Resolver o código do erro 429. Para encontrar os segundos em que eles foram recebidos, consulte Taxa de erro e latência por região.
Métodos de API compatíveis para geração de registros
Os registros de metadados de solicitação de inferência são compatíveis com o seguinte:
- Modelos do Gemini que usam
generateContentoustreamGenerateContent, incluindo a geração de imagens por esses métodos. - Modelos do Claude que usam
rawPredictoustreamRawPredict. Outros modelos de parceiros não são registrados. Para nomes de campos do Claude, consulte Contagens de tokens para modelos do Claude.
A Capacidade de Processamento Provisionada e todas as opções de pagamento por uso são aceitas.
Não há compatibilidade com os seguintes recursos:
chatCompletions.embedContent,predictecountTokens. Os modelos que geram imagens compredict, como o Imagen, não são registrados.- Solicitações para modelos ajustados, incluindo modelos do Gemini ajustados com ajuste supervisionado.
- Jobs de ajuste, inferência em lote e qualquer outra operação de longa duração.
- Modelos que você implanta em um contêiner personalizado.
Ativar registros de metadados de solicitação de inferência
É possível configurar registros de metadados de solicitação de inferência para um projeto inteiro ou para um modelo específico em uma região específica. Se precisar ativar no nível da organização, entre em contato com a equipe de conta. As configurações de geração de registros podem levar alguns minutos para entrar em vigor.
Antes de começar
- Verifique se você tem as seguintes permissões do IAM no projeto:
aiplatform.endpoints.setPublisherModelConfigeaiplatform.endpoints.fetchPublisherModelConfigpara alterar e ler a configuração, elogging.buckets.get,logging.buckets.list,logging.buckets.updateelogging.operations.getpara fazer upgrade do bucket de registro. Para papéis predefinidos que incluem essas permissões, consulte Controle de acesso e Controle de acesso para o Logging. - Decida se quer
fazer upgrade do bucket de registros
_Defaultpara a Análise de Observabilidade. Você precisa do upgrade para consultar entradas com SQL ou para ver métricas detalhadas no console do Google Cloud . O upgrade leva vários minutos e não pode ser desfeito. As entradas gravadas antes do upgrade não podem ser consultadas com SQL depois. - Consulte os preços do Cloud Logging. As entradas são armazenadas pelo período de armazenamento do bucket, 30 dias por padrão, e as cobranças de processamento e armazenamento do Cloud Logging são aplicadas. Para estimar o custo, consulte Preços.
Ativar no console
A ativação no console ativa a geração de registros para todos os modelos no projeto, tanto
o Gemini quanto o Claude, na Capacidade de Processamento Provisionada e em todas as
opções de pagamento por uso compatíveis com os registros. Ele também faz upgrade do bucket de registros _Default,
caso ainda não tenha sido feito. Ele define o padrão para todo o projeto descrito
em Precedência de configuração. Antes de começar, verifique as
permissões e o upgrade do bucket.
No console do Google Cloud , acesse a página Capacidade de Processamento Provisionada.
Escolha uma destas opções:
- No banner que diz A Gemini Enterprise Agent Platform está atualizando a observabilidade, clique em Ativar.
- Na barra de ferramentas, clique em Configurações de métricas. Selecione Ativar métricas detalhadas e clique em Salvar.

Figura 1. O banner de upgrade de observabilidade na página Capacidade de Processamento Provisionada. 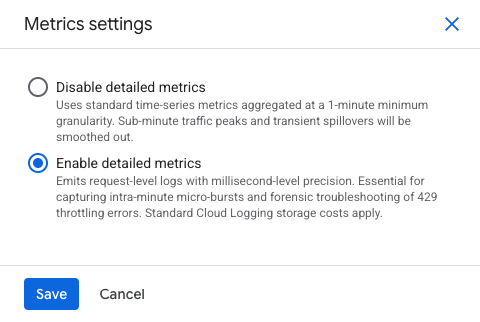
Figura 2. O painel de configurações de métricas, com a opção "Ativar métricas detalhadas" selecionada. Na caixa de diálogo Ativar métricas detalhadas?, revise os detalhes de upgrade de bucket e geração de registros e clique em Ativar.
A caixa de diálogo é fechada assim que o registro é ativado. O upgrade do bucket continua em segundo plano e pode levar vários minutos. Enquanto ele é executado, o banner mostra
"As métricas detalhadas estão ativadas, e o bucket de registros _Default deste projeto está sendo
atualizado para a Análise de Observabilidade".
Se o banner informar que o bucket não foi atualizado, clique em Fazer upgrade para tentar novamente. Se ele informar que não é possível fazer upgrade do bucket, os registros por solicitação não poderão ser consultados. Clique em Configurações de métricas e selecione Desativar métricas detalhadas para interromper as cobranças.
Precedência de configuração
A Agent Platform resolve a configuração de cada solicitação nesta ordem:
- A configuração por modelo e por região, se houver.
- O padrão para todo o projeto, se a configuração por modelo não estiver definida.
- Se nenhum deles estiver definido, a geração de registros estará desativada.
A configuração por modelo tem precedência sobre o padrão do projeto. É possível ativar a geração de registros em todo o projeto e desativá-la para um modelo de alto volume em uma região ou vice-versa.
Ativar com a API REST
Configure os registros de metadados de solicitação de inferência com o método setPublisherModelConfig, definindo inferenceEventLoggingConfig.state como ENABLED.
Para definir o padrão para todo o projeto, use o projeto:
curl -X POST \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://aiplatform.googleapis.com/v1beta1/projects/PROJECT_ID:setPublisherModelConfig" \
  -d '{
        "publisherModelConfig": {
          "inferenceEventLoggingConfig": {"state": "ENABLED"}
        },
        "updateMask": "inferenceEventLoggingConfig"
      }'
Para substituir um modelo em uma região, use o modelo do editor:
curl -X POST \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://aiplatform.googleapis.com/v1beta1/projects/PROJECT_ID/locations/LOCATION/publishers/PUBLISHER/models/MODEL:setPublisherModelConfig" \
  -d '{
        "publisherModelConfig": {
          "inferenceEventLoggingConfig": {"state": "ENABLED"}
        },
        "updateMask": "inferenceEventLoggingConfig"
      }'
Defina PUBLISHER como google para modelos do Gemini e como anthropic para
modelos do Claude. Por exemplo, para ativar a geração de registros para o Claude Sonnet 4.5 no
endpoint global, use publishers/anthropic/models/claude-sonnet-4-5 com
LOCATION definido como global. Para IDs de modelo do Claude, consulte
Modelos do Claude.
O método retorna uma operação de longa duração.
Receber configuração de geração de registros
Leia a configuração atual com o método fetchPublisherModelConfig. Use
o projeto para ler o padrão do projeto ou um modelo de editor para ler a
substituição.
curl -X GET \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  "https://aiplatform.googleapis.com/v1beta1/projects/PROJECT_ID:fetchPublisherModelConfig"
curl -X GET \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  "https://aiplatform.googleapis.com/v1beta1/projects/PROJECT_ID/locations/LOCATION/publishers/PUBLISHER/models/MODEL:fetchPublisherModelConfig"
A resposta contém as configurações definidas nesse recurso:
{
  "inferenceEventLoggingConfig": {
    "state": "ENABLED"
  }
}
Verificar se a geração de registros funciona
- Envie uma solicitação para um modelo que você ativou.
Na Análise de registros, execute a consulta a seguir. A maioria das entradas aparece em até 12 segundos, mas pode levar até 5 minutos.
logName="projects/PROJECT_ID/logs/aiplatform.googleapis.com%2Finference_request"Para confirmar que o SQL funciona, abra a Análise de Observabilidade e execute qualquer consulta de exemplo. Se a consulta informar que o conjunto de dados não foi encontrado, o upgrade do bucket de registros ainda não foi concluído.
Desative a geração de registros
No console do Google Cloud , acesse a página Capacidade de Processamento Provisionada, clique em Configurações de métricas, selecione Desativar métricas detalhadas e clique em Salvar. Isso reverte a opção Ativar no console.
Com a API REST, siga estas etapas.
Desative a geração de registros definindo inferenceEventLoggingConfig.state como DISABLED no
mesmo recurso em que ela foi ativada.
curl -X POST \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://aiplatform.googleapis.com/v1beta1/projects/PROJECT_ID:setPublisherModelConfig" \
  -d '{
        "publisherModelConfig": {
          "inferenceEventLoggingConfig": {"state": "DISABLED"}
        },
        "updateMask": "inferenceEventLoggingConfig"
      }'
Como uma configuração por modelo tem precedência sobre o padrão do projeto, desativar no nível do projeto não desativa um modelo que está explicitamente ativado. Limpe ou desative também a configuração por modelo.
Onde os registros são gravados
As entradas são gravadas no seguinte registro:
projects/PROJECT_NUMBER/logs/aiplatform.googleapis.com%2Finference_request
A partir daí, você tem os destinos padrão do Cloud Logging:
- Análise de Observabilidade: consulte as entradas com SQL na Análise de Observabilidade no console doGoogle Cloud .
- Conjunto de dados vinculado do BigQuery: vincule um conjunto de dados para ler os mesmos dados do BigQuery. Para mais detalhes, consulte Consultar um conjunto de dados vinculado do BigQuery.
- Coletores agregados: colete entradas de todos os projetos em uma pasta ou organização com um único coletor. Filtrar em
logName="projects/*/logs/aiplatform.googleapis.com%2Finference_request".
Para coletar entradas de todos os projetos em uma pasta ou organização, consulte Visão geral dos coletores agregados.
As entradas se tornam consultáveis logo após a conclusão da solicitação. A maioria das entradas pode ser consultada em até 12 segundos, mas pode levar até 5 minutos.
Esquema de entrada de registro
Cada entrada tem duas partes que você consulta separadamente: o recurso monitorado e os rótulos dele, que identificam o que atendeu à solicitação, e o payload JSON, que registra o que a solicitação fez. As seções a seguir descrevem as duas.
Rótulos de recursos
Para modelos de editor compartilhados, o tipo de recurso monitorado é
aiplatform.googleapis.com/PublisherModel, com os rótulos a seguir.
| Rótulo | Tipo | Observações |
|---|---|---|
resource_container |
STRING |
O projeto que atendeu à solicitação. |
location |
STRING |
A região que atendeu à solicitação, por exemplo, us-central1. As solicitações enviadas ao endpoint global informam global. |
publisher |
STRING |
O editor do modelo, por exemplo, google ou anthropic. |
model_user_id |
STRING |
O modelo, por exemplo, gemini-2.5-pro. |
Campos de payload
| Nome do campo | Tipo | Observações |
|---|---|---|
method |
ENUM |
GENERATE_CONTENT, STREAM_GENERATE_CONTENT, RAW_PREDICT ou STREAM_RAW_PREDICT. |
trafficType |
ENUM |
A opção de consumo que atendeu à solicitação. Os valores atuais são PROVISIONED_THROUGHPUT, ON_DEMAND, ON_DEMAND_FLEX e ON_DEMAND_PRIORITY. Ausente em solicitações com falha. |
requestStartTime |
TIMESTAMP |
O horário em que o front-end de exibição aceitou a solicitação. |
requestDuration |
STRING |
Latência de veiculação de ponta a ponta, formatada como uma string de duração, como 3.53s. |
generateContentDetails.usageMetadata |
JSON |
Contagens de tokens para generateContent e streamGenerateContent, incluindo detalhamentos por modalidade. A saída de imagem aparece aqui como uma entrada IMAGE em candidatesTokensDetails. |
rawPredictDetails.usageMetadata |
JSON |
Contagens de tokens para rawPredict e streamRawPredict, incluindo modelos de parceiros. |
provisionedThroughput |
JSON |
Presente para o tráfego da Capacidade de Processamento Provisionada. |
httpHeaders |
JSON |
Cabeçalhos da solicitação capturados. |
error |
JSON |
Presente apenas quando a gravidade é ERROR. |
principal |
JSON |
A conta de serviço que emitiu a solicitação, quando disponível. |
O campo LogEntry.labels contém gen_ai.operation.name, que segue as
convenções semânticas de IA generativa do OpenTelemetry. generateContent e streamGenerateContent informam generate_content. rawPredict e streamRawPredict informam raw_predict.
Campos de capacidade de processamento provisionada
| Nome do campo | Tipo | Observações |
|---|---|---|
ptChargedInputTokenCount |
INT64 |
Tokens de entrada contabilizados na sua cota de capacidade de processamento provisionada, após a aplicação das taxas de burndown. |
ptChargedOutputTokenCount |
INT64 |
Tokens de saída contabilizados na sua cota de capacidade de processamento provisionada, após a aplicação das taxas de burndown. |
accountingResource |
STRING |
O projeto em que o compromisso de Capacidade de Processamento Provisionada foi usado pela solicitação. |
Identificar solicitações de transbordamento
Uma solicitação é transferida quando é qualificada para a Capacidade de Processamento Provisionada, mas
é atendida sob demanda porque sua capacidade de processamento foi esgotada. Uma entrada de transbordamento tem
um trafficType de ON_DEMAND e nenhum objeto provisionedThroughput. Uma
solicitação comum de pagamento por uso é igual. Portanto, use as seguintes regras para
distingui-las:
- Se você enviou
X-Vertex-AI-LLM-Request-Typecom um valor deshared, você encaminhou a solicitação para pagamento por uso de propósito. Não é transbordamento. - Se você não enviou um cabeçalho
X-Vertex-AI-LLM-Request-Typeou um valor diferente dededicatedoushared, e a entrada informaON_DEMAND, a solicitação foi transferida, desde que você tenha capacidade de processamento provisionada para esse modelo nessa região. - Se você não tiver a capacidade de processamento provisionada para o modelo, cada entrada
ON_DEMANDserá um pagamento por uso comum.
Para os valores do cabeçalho, consulte Usar a capacidade de processamento provisionada.
Para uma consulta que conta solicitações de transbordamento, consulte Transbordamento por minuto.
Identificar solicitações rebaixadas
Uma solicitação é rebaixada quando você pede uma opção de pagamento por uso e ela é
atendida em outra. Compare o cabeçalho X-Vertex-AI-LLM-Shared-Request-Type que você
enviou com o trafficType que atendeu à solicitação:
| Valor do cabeçalho que você enviou | trafficType quando veiculado conforme solicitado |
|---|---|
priority |
ON_DEMAND_PRIORITY |
flex |
ON_DEMAND_FLEX |
Qualquer outro trafficType em uma entrada bem-sucedida significa que a solicitação foi rebaixada
ou que o modelo não oferece a opção solicitada. Para uma consulta, consulte
Downgrades por modelo.
Códigos de erro
As solicitações com falha são gravadas com uma gravidade de ERROR e carregam um objeto error
com um código de status gRPC e um motivo canônico. O motivo é uma string
fixa. Ele nunca contém texto de comando, texto de resposta ou valores de cabeçalho.
| Código | Status | Status HTTP típico |
|---|---|---|
8 |
O recurso foi esgotado, por exemplo, um limite de cota. | 429 |
4 |
O prazo expirou antes que a operação fosse concluída. | 504 |
14 |
O serviço está indisponível. | 503 |
13 |
Erro interno encontrado. | 500 |
3 |
A solicitação contém um argumento inválido. | 400 |
7 |
O autor da chamada não tem permissão. | 403 |
5 |
A entidade solicitada não foi encontrada. | 404 |
Anexar rótulos de cabeçalho personalizados
Para atribuir o uso às suas próprias dimensões, como uma equipe, um aplicativo ou um
locatário, envie cabeçalhos de solicitação com o prefixo
x-goog-agent-platform-observability-label-:
x-goog-agent-platform-observability-label-team: payments
x-goog-agent-platform-observability-label-application: invoice-ocr
Cada cabeçalho aparece na entrada em jsonPayload.httpHeaders. Os rótulos de cabeçalho
funcionam em modelos do Gemini com generateContent e
streamGenerateContent, e em modelos do Claude com rawPredict e
streamRawPredict, na Capacidade de Processamento Provisionada e em todas as opções de
pagamento por uso.
Para conferir exemplos de chamadas de API com rótulos de cabeçalho, as entradas de registro que elas produzem, os modelos compatíveis, os limites e como os rótulos de cabeçalho se comparam aos rótulos de solicitação, consulte Rótulos de metadados personalizados. Para consultar esses dados, consulte Uso por rótulo de cabeçalho personalizado.
Consultar registros com a Análise de Registros
Use a Análise de Registros para encontrar e inspecionar solicitações de inferência individuais. Ele não precisa de configuração além de ter a geração de registros ativada e lê o registro diretamente, para que as entradas fiquem visíveis assim que chegarem.
No console do Google Cloud , acesse a página Análise de registros e insira uma consulta no campo do editor de consultas usando a linguagem de consulta do Logging. Para mais informações sobre os painéis e controles, consulte Interface da Análise de registros.
Comece com o nome do registro, que seleciona todas as entradas de solicitação de inferência no projeto:
logName="projects/PROJECT_ID/logs/aiplatform.googleapis.com%2Finference_request"
Adicione termos para restringir os resultados. Os termos em linhas separadas são combinados com AND.
- Para selecionar solicitações atendidas em uma região, adicione
resource.labels.location="us-central1". - Para selecionar um método de API, adicione
jsonPayload.method="GENERATE_CONTENT". - Para selecionar apenas o tráfego da Capacidade de Processamento Provisionada, adicione
jsonPayload.trafficType="PROVISIONED_THROUGHPUT". - Para selecionar apenas erros de cota, adicione
severity=ERRORejsonPayload.error.code=8. - Para selecionar um valor de rótulo de cabeçalho personalizado, adicione
jsonPayload.httpHeaders."x-goog-agent-platform-observability-label-team".values="payments".
A Análise de Registros filtra e exibe entradas. Ele não os agrega. Para contar, agrupar ou criar gráficos com as entradas, use a Análise de Observabilidade. Na barra de ferramentas Resultados da consulta, clique em Analisar resultados para transferir a consulta atual. Esse botão só aparece depois que o bucket de registros é atualizado.
Consultar e analisar registros com a Análise de Observabilidade
Use a Análise de Observabilidade para consultar e analisar registros.
Antes de começar
A Análise de Observabilidade responde a perguntas que a Análise de Registros não consegue. A Análise de registros encontra e exibe entradas individuais, o que é útil quando você está procurando uma solicitação. A Análise de Observabilidade executa o SQL em todo o conjunto, para que possa contar, agrupar, mesclar e calcular percentis. Todas as perguntas nesta seção precisam de agregação: gasto por equipe, burndown por projeto e latência p95 por região não podem ser respondidos uma entrada por vez.
Para isso, é necessário fazer upgrade do bucket de registros _Default no projeto para usar a
Análise de Observabilidade. Para mais
informações, consulte Configurar buckets de registros.
Os exemplos a seguir são executados na Análise de Observabilidade. Substitua PROJECT_ID
pelo seu projeto.
Capacidade de processamento por região e modelo
SELECT
  JSON_VALUE(resource.labels.location)      AS region,
  JSON_VALUE(resource.labels.model_user_id) AS model,
  JSON_VALUE(json_payload.trafficType)      AS traffic_type,
  COUNT(*)                                  AS requests,
  SUM(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.promptTokenCount) AS INT64))     AS input_tokens,
  SUM(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.candidatesTokenCount) AS INT64)) AS output_tokens
FROM `PROJECT_ID.global._Default._Default`
WHERE log_id = "aiplatform.googleapis.com/inference_request"
  AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 24 HOUR)
GROUP BY region, model, traffic_type
ORDER BY requests DESC
Redução da capacidade de processamento provisionada por projeto
SELECT
  JSON_VALUE(resource.labels.location) AS region,
  JSON_VALUE(json_payload.provisionedThroughput.accountingResource) AS pt_project,
  COUNTIF(JSON_VALUE(json_payload.trafficType) = "PROVISIONED_THROUGHPUT") AS pt_requests,
  COUNTIF(JSON_VALUE(json_payload.trafficType) = "ON_DEMAND")              AS on_demand_requests,
  SUM(CAST(JSON_VALUE(json_payload.provisionedThroughput.ptChargedInputTokenCount)  AS INT64)) AS pt_input_tokens,
  SUM(CAST(JSON_VALUE(json_payload.provisionedThroughput.ptChargedOutputTokenCount) AS INT64)) AS pt_output_tokens
FROM `PROJECT_ID.global._Default._Default`
WHERE log_id = "aiplatform.googleapis.com/inference_request"
  AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 24 HOUR)
GROUP BY region, pt_project
ORDER BY pt_input_tokens DESC
Uso por rótulo de cabeçalho personalizado
SELECT
  JSON_VALUE(json_payload.httpHeaders
    ["x-goog-agent-platform-observability-label-team"].values[0]) AS team,
  COUNT(*) AS requests,
  SUM(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.totalTokenCount) AS INT64)) AS total_tokens
FROM `PROJECT_ID.global._Default._Default`
WHERE log_id = "aiplatform.googleapis.com/inference_request"
  AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 7 DAY)
GROUP BY team
ORDER BY total_tokens DESC
Tokens consumidos por minuto, Gemini e Claude lado a lado
Essa consulta informa os tokens consumidos por minuto em uma coluna por editor. Cada
coluna pondera os tipos de token da mesma forma que a
métrica publisher/online_serving/consumed_token_throughput faz para esse
editor, de modo que cada coluna corresponda ao Cloud Monitoring. O Gemini e o
Claude ponderam os tokens de saída e de cache de maneira diferente. Por isso, não some as duas
colunas. Para os campos do Claude, consulte
Contagens de tokens para modelos do Claude.
SELECT
  TIMESTAMP_TRUNC(timestamp, MINUTE) AS minute_ts,
  SUM(IF(JSON_VALUE(resource.labels.publisher) = "google",
    IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.promptTokenCount) AS INT64), 0)
      + IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.toolUsePromptTokenCount) AS INT64), 0)
      - 0.9 * IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.cachedContentTokenCount) AS INT64), 0)
      + IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.candidatesTokenCount) AS INT64), 0)
      + IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.thoughtsTokenCount) AS INT64), 0), 0)) AS gemini_consumed_tokens,
  SUM(IF(JSON_VALUE(resource.labels.publisher) = "anthropic",
    IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.input_tokens) AS INT64), 0)
      + 0.1  * IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.cache_read_input_tokens) AS INT64), 0)
      + 1.25 * IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.cache_creation_input_tokens) AS INT64), 0)
      + 0.75 * IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.cache_creation.ephemeral_1h_input_tokens) AS INT64), 0)
      + 5    * IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.output_tokens) AS INT64), 0), 0)) AS claude_consumed_tokens
FROM `PROJECT_ID.global._Default._Default`
WHERE log_id = "aiplatform.googleapis.com/inference_request"
  AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 24 HOUR)
GROUP BY minute_ts
ORDER BY minute_ts DESC
Taxa de ocorrências em cache no Gemini e no Claude
A taxa de ocorrências em cache é o número de tokens de entrada em cache dividido pelo total de tokens de entrada. A entrada do Gemini inclui tokens de uso de ferramentas, porque o cache pode cobri-los. A entrada do Claude é a entrada não armazenada em cache mais as leituras e gravações em cache. Para saber como cada editor armazena em cache, consulte Visão geral do armazenamento em cache de contexto e Armazenamento em cache de comandos do Claude.
SELECT
  JSON_VALUE(resource.labels.model_user_id) AS model,
  JSON_VALUE(json_payload.trafficType)      AS traffic_type,
  ROUND(100 * SAFE_DIVIDE(
    SUM(IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.cachedContentTokenCount) AS INT64), 0)
      + IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.cache_read_input_tokens) AS INT64), 0)),
    SUM(GREATEST(
          IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.promptTokenCount) AS INT64), 0)
          + IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.toolUsePromptTokenCount) AS INT64), 0),
          IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.cachedContentTokenCount) AS INT64), 0))
      + IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.input_tokens) AS INT64), 0)
      + IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.cache_read_input_tokens) AS INT64), 0)
      + IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.cache_creation_input_tokens) AS INT64), 0))), 1) AS cache_hit_rate_pct
FROM `PROJECT_ID.global._Default._Default`
WHERE log_id = "aiplatform.googleapis.com/inference_request"
  AND JSON_VALUE(json_payload.trafficType) IS NOT NULL
  AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 7 DAY)
GROUP BY model, traffic_type
ORDER BY model, traffic_type
Downgrades por modelo
Essa consulta compara a opção de pagamento por uso solicitada por cada solicitação com a opção que a atendeu. Para saber como os downgrades são identificados, consulte Identificar solicitações de downgrade.
WITH entries AS (
  SELECT
    JSON_VALUE(resource.labels.model_user_id) AS model,
    severity,
    JSON_VALUE(json_payload.trafficType)      AS served,
    (SELECT LOWER(v)
     FROM UNNEST(JSON_VALUE_ARRAY(json_payload.httpHeaders["x-vertex-ai-llm-shared-request-type"].values)) AS v
     WHERE LOWER(v) IN ("priority", "flex")
     LIMIT 1)                                 AS requested
  FROM `PROJECT_ID.global._Default._Default`
  WHERE log_id = "aiplatform.googleapis.com/inference_request"
    AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 7 DAY)
)
SELECT
  model,
  requested,
  COUNTIF(served = CONCAT("ON_DEMAND_", UPPER(requested))) AS served_as_requested,
  COUNTIF(served IS NOT NULL
          AND served != CONCAT("ON_DEMAND_", UPPER(requested))) AS downgraded,
  COUNTIF(severity = "ERROR")                              AS failed
FROM entries
WHERE requested IS NOT NULL
GROUP BY model, requested
ORDER BY downgraded DESC
Spillover por minuto
Essa consulta conta as solicitações de transbordamento por minuto para cada modelo que teve tráfego de capacidade de processamento provisionada na janela. Para saber como o spillover é identificado, consulte Identificar solicitações de spillover.
WITH entries AS (
  SELECT
    timestamp,
    JSON_VALUE(resource.labels.location)      AS region,
    JSON_VALUE(resource.labels.model_user_id) AS model,
    JSON_VALUE(json_payload.trafficType)      AS traffic_type,
    EXISTS(
      SELECT 1
      FROM UNNEST(JSON_VALUE_ARRAY(json_payload.httpHeaders["x-vertex-ai-llm-request-type"].values)) AS v
      WHERE LOWER(v) IN ("dedicated", "shared")) AS routed_by_header
  FROM `PROJECT_ID.global._Default._Default`
  WHERE log_id = "aiplatform.googleapis.com/inference_request"
    AND severity = "INFO"
    AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 24 HOUR)
),
pt_models AS (
  SELECT DISTINCT region, model FROM entries WHERE traffic_type = "PROVISIONED_THROUGHPUT"
)
SELECT
  TIMESTAMP_TRUNC(e.timestamp, MINUTE) AS minute_ts,
  e.region,
  e.model,
  COUNTIF(e.traffic_type = "PROVISIONED_THROUGHPUT")              AS pt_requests,
  COUNTIF(e.traffic_type = "ON_DEMAND" AND NOT e.routed_by_header) AS spillover_requests
FROM entries AS e
JOIN pt_models USING (region, model)
GROUP BY minute_ts, e.region, e.model
HAVING spillover_requests > 0
ORDER BY minute_ts DESC
Taxa de erros e latência por região
SELECT
  JSON_VALUE(resource.labels.location) AS region,
  TIMESTAMP_TRUNC(timestamp, MINUTE)   AS minute_ts,
  COUNT(*)                             AS total,
  COUNTIF(severity = "ERROR")          AS errors,
  COUNTIF(CAST(JSON_VALUE(json_payload.error.code) AS INT64) = 8) AS resource_exhausted,
  APPROX_QUANTILES(
    CAST(REGEXP_REPLACE(JSON_VALUE(json_payload.requestDuration), r"s$", "") AS FLOAT64),
    100)[OFFSET(95)] AS p95_latency_seconds
FROM `PROJECT_ID.global._Default._Default`
WHERE log_id = "aiplatform.googleapis.com/inference_request"
  AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 6 HOUR)
GROUP BY region, minute_ts
ORDER BY minute_ts DESC
Contagens de tokens para modelos do Claude
Os modelos do Claude informam o uso em rawPredictDetails.usageMetadata, com os
nomes de campo da API Claude. Tanto rawPredict quanto streamRawPredict gravam os mesmos campos. Para streaming, o registro mescla o relatório de uso informado no stream.
| Campo | O que ele conta |
|---|---|
input_tokens |
Tokens de entrada que não foram lidos ou gravados no cache. |
cache_read_input_tokens |
Tokens de entrada lidos do cache de comandos. |
cache_creation_input_tokens |
Tokens de entrada gravados no cache de comandos, com os dois TTLs combinados. |
cache_creation.ephemeral_5m_input_tokens |
Gravações em cache com um TTL de 5 minutos. |
cache_creation.ephemeral_1h_input_tokens |
Gravações em cache com um TTL de 1 hora. |
output_tokens |
Tokens de saída, incluindo raciocínio complexo. Não adicione tokens de raciocínio separadamente. |
A entrada total do Claude é input_tokens mais cache_read_input_tokens mais
cache_creation_input_tokens. O Gemini é diferente: o promptTokenCount
já inclui tokens em cache.
As entradas do Claude não têm detalhamento de modalidade. Os rótulos de cabeçalho funcionam da mesma forma para o Gemini e o Claude. Consulte Anexar rótulos de cabeçalho personalizados.
Preços
A geração de registros de metadados de solicitação de inferência grava no Cloud Logging e é cobrada como ingestão e armazenamento do Cloud Logging. As consultas feitas pela Análise de Observabilidade são cobradas como uso do Cloud Monitoring. A vinculação de um conjunto de dados do BigQuery não adiciona cobranças de armazenamento do BigQuery.
O tamanho da entrada depende das solicitações, por exemplo, de quantos rótulos de cabeçalho elas carregam. Para estimar o custo, ative a geração de registros para uma carga de trabalho representativa por um dia, meça o volume ingerido com a Análise de volume de registros e projete o volume mensal na calculadora de preços doGoogle Cloud .
A seguir
- Saiba como monitorar modelos com métricas.
- Saiba como monitorar custos usando rótulos de metadados personalizados.
- Use a geração de registros de solicitação-resposta se precisar de conteúdo de comando e resposta.
- Leia sobre a Capacidade de Processamento Provisionada.
- Confira as métricas detalhadas da Capacidade de Processamento Provisionada no console do Google Cloud .
- Resolver problemas de erros 429.
- Coletar entradas de todos os projetos em uma pasta ou organização com coletores agregados.