


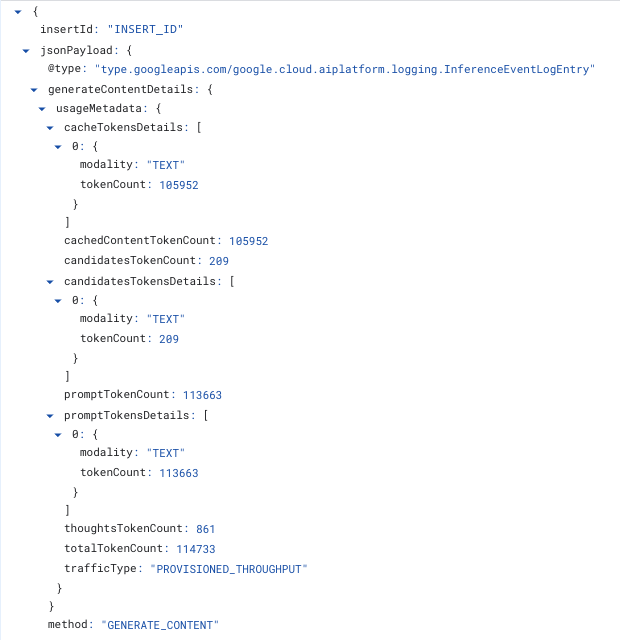
Agent Platform può scrivere una voce di log strutturata per ogni richiesta di inferenza gestita dal tuo progetto. Ogni voce registra i metadati relativi alla richiesta: il modello, la regione, i conteggi dei token (inclusi token di input, token di output, token memorizzati nella cache, token di pensiero), i burndown del throughput riservato, la latenza della richiesta end-to-end, il codice di errore ed eventuali etichette di intestazione o di richiesta allegate. Le voci vengono inviate a Cloud Logging e puoi eseguirvi query con SQL in Observability Analytics. Per attivare il logging, consulta Abilita i log dei metadati delle richieste di inferenza.
Il logging delle richieste di inferenza registra solo i metadati. Non registra prompt o risposte. Se hai bisogno dei contenuti dei prompt e delle risposte, utilizza invece il logging di richieste e risposte.
Questa pagina descrive come abilitare i log dei metadati delle richieste di inferenza, cosa contiene ogni voce e come eseguirne query.
Casi d'uso
I log dei metadati delle richieste di inferenza rispondono a domande a cui le metriche aggregate non possono rispondere:
- Attribuisci la spesa per i token a un team, un'applicazione o un tenant allegando le tue etichette di intestazione, le etichette di richiesta o entrambe a ogni richiesta.
- Scopri quali singole richieste sono state conteggiate ai fini della quota di throughput riservato e quali sono state gestite on demand.
- Suddividi la velocità effettiva, la latenza e il tasso di errore in base alle etichette delle intestazioni o delle richieste.
- Misura il comportamento di memorizzazione nella cache per richiesta anziché in forma aggregata.
- Ottenere visibilità sull'utilizzo a livello di secondo, ad esempio perché un progetto ha ricevuto errori 429 o perché il throughput riservato è stato superato. Per i passaggi per risolvere gli errori 429, consulta Risolvi i problemi relativi al codice di errore 429. Per trovare i secondi in cui sono stati ricevuti, consulta Tasso di errore e latenza per regione.
Metodi API supportati per il logging
I log dei metadati delle richieste di inferenza sono supportati per:
- Modelli Gemini che utilizzano
generateContentostreamGenerateContent, inclusa la generazione di immagini tramite questi metodi. - Modelli Claude che utilizzano
rawPredictostreamRawPredict. Gli altri modelli di partner non vengono registrati. Per i nomi dei campi di Claude, consulta Conteggi dei token per i modelli Claude.
Sono supportati il throughput riservato e tutte le opzioni di pagamento a consumo.
Le seguenti funzionalità non sono supportate:
chatCompletions.embedContent,predictecountTokens. I modelli che generano immagini tramitepredict, come Imagen, non vengono registrati.- Richieste ai modelli ottimizzati, inclusi i modelli Gemini ottimizzati con il fine-tuning supervisionato.
- Job di ottimizzazione, inferenza batch e qualsiasi altra operazione a lunga esecuzione.
- Modelli di cui esegui il deployment in un container personalizzato.
Abilita i log dei metadati delle richieste di inferenza
Puoi configurare i log dei metadati delle richieste di inferenza per un intero progetto o per un modello specifico in una regione specifica. Se devi attivarlo a livello di organizzazione, contatta il team dedicato all'account. L'applicazione delle configurazioni di logging può richiedere alcuni minuti.
Prima di iniziare
- Assicurati di disporre delle seguenti autorizzazioni IAM sul progetto:
aiplatform.endpoints.setPublisherModelConfigeaiplatform.endpoints.fetchPublisherModelConfigper modificare e leggere l'impostazione, elogging.buckets.get,logging.buckets.list,logging.buckets.updateelogging.operations.getper eseguire l'upgrade del bucket di log. Per i ruoli predefiniti che includono queste autorizzazioni, consulta Controllo degli accessi e Controllo degli accessi per Logging. - Decidi se eseguire l'upgrade del bucket di log
_Defaulta Observability Analytics. L'upgrade è necessario per eseguire query sulle voci con SQL o per visualizzare metriche dettagliate nella console Google Cloud . L'upgrade richiede diversi minuti e non può essere annullato. Le voci scritte prima dell'upgrade non possono essere interrogate con SQL in un secondo momento. - Esamina i prezzi di Cloud Logging. Le voci vengono archiviate per il periodo di conservazione del bucket, per impostazione predefinita 30 giorni, e si applicano i costi di importazione e archiviazione di Cloud Logging. Per stimare il costo, consulta Prezzi.
Abilita nella console
L'attivazione nella console attiva il logging per ogni modello del progetto, sia Gemini che Claude, su Throughput riservato e su ogni opzione con pagamento a consumo supportata dai log. Esegue anche l'upgrade del bucket di log _Default se non è stato eseguito. Imposta il valore predefinito a livello di progetto descritto in Precedenza della configurazione. Prima di iniziare, controlla le
autorizzazioni e l'upgrade del bucket.
Nella console Google Cloud , vai alla pagina Throughput riservato.
Esegui una delle seguenti operazioni:
- Nel banner con la dicitura Gemini Enterprise Agent Platform sta facendo l'upgrade dell'osservabilità, fai clic su Abilita.
- Nella barra degli strumenti, fai clic su Impostazioni metriche. Seleziona Attiva metriche dettagliate e poi fai clic su Salva.

Figura 1. Il banner di upgrade dell'osservabilità nella pagina Throughput riservato. 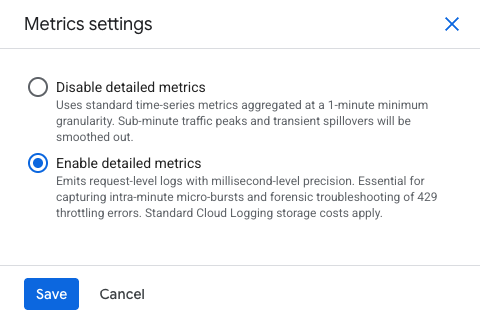
Figura 2. Il riquadro delle impostazioni delle metriche, con l'opzione Abilita metriche dettagliate selezionata. Nella finestra di dialogo Attivare le metriche dettagliate?, esamina i dettagli dell'upgrade del bucket e del logging, quindi fai clic su Attiva.
La finestra di dialogo si chiude non appena il logging viene attivato. L'upgrade del bucket continua in background e può richiedere diversi minuti. Durante l'esecuzione, il banner indica "Le metriche dettagliate sono attive ed è in corso l'upgrade del bucket di log _Default di questo progetto a Observability Analytics."
Se invece il banner indica che non è stato eseguito l'upgrade del bucket, fai clic su Esegui l'upgrade per riprovare. Se viene segnalato che non è possibile eseguire l'upgrade del bucket, non è possibile eseguire query sui log per richiesta. Fai clic su Impostazioni metriche e seleziona Disattiva metriche dettagliate per interrompere gli addebiti.
Precedenza della configurazione
La piattaforma dell'agente risolve l'impostazione per ogni richiesta in questo ordine:
- L'impostazione per modello e per regione, se configurata.
- L'impostazione predefinita a livello di progetto, se l'impostazione per modello non è configurata.
- Se non è impostato nessuno dei due, il logging è disattivato.
L'impostazione per modello ha la precedenza sull'impostazione predefinita del progetto. Puoi attivare il logging per l'intero progetto e disattivarlo per un modello con un volume elevato in una regione o viceversa.
Abilita con l'API REST
Puoi configurare i log dei metadati delle richieste di inferenza con il metodo setPublisherModelConfig, impostando inferenceEventLoggingConfig.state su ENABLED.
Per impostare il valore predefinito a livello di progetto, indirizza il progetto:
curl -X POST \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://aiplatform.googleapis.com/v1beta1/projects/PROJECT_ID:setPublisherModelConfig" \
  -d '{
        "publisherModelConfig": {
          "inferenceEventLoggingConfig": {"state": "ENABLED"}
        },
        "updateMask": "inferenceEventLoggingConfig"
      }'
Per eseguire l'override di un modello in una regione, indirizza il modello del publisher:
curl -X POST \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://aiplatform.googleapis.com/v1beta1/projects/PROJECT_ID/locations/LOCATION/publishers/PUBLISHER/models/MODEL:setPublisherModelConfig" \
  -d '{
        "publisherModelConfig": {
          "inferenceEventLoggingConfig": {"state": "ENABLED"}
        },
        "updateMask": "inferenceEventLoggingConfig"
      }'
Imposta PUBLISHER su google per i modelli Gemini e su anthropic per i modelli Claude. Ad esempio, per attivare il logging per Claude Sonnet 4.5 sull'endpoint globale, utilizza publishers/anthropic/models/claude-sonnet-4-5 con LOCATION impostato su global. Per gli ID dei modelli Claude, consulta Modelli Claude.
Il metodo restituisce un'operazione a lunga esecuzione.
Ottieni la configurazione del logging
Leggi la configurazione attuale con il metodo fetchPublisherModelConfig. Utilizza il progetto per leggere l'impostazione predefinita a livello di progetto o un modello del publisher per leggere l'override.
curl -X GET \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  "https://aiplatform.googleapis.com/v1beta1/projects/PROJECT_ID:fetchPublisherModelConfig"
curl -X GET \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  "https://aiplatform.googleapis.com/v1beta1/projects/PROJECT_ID/locations/LOCATION/publishers/PUBLISHER/models/MODEL:fetchPublisherModelConfig"
La risposta contiene le impostazioni configurate per la risorsa:
{
  "inferenceEventLoggingConfig": {
    "state": "ENABLED"
  }
}
Verifica che il logging funzioni
- Invia una richiesta a un modello che hai attivato.
In Esplora log, esegui la seguente query. La maggior parte delle voci viene visualizzata entro 12 secondi; attendi fino a 5 minuti.
logName="projects/PROJECT_ID/logs/aiplatform.googleapis.com%2Finference_request"Per verificare che SQL funzioni, apri Observability Analytics ed esegui una query di esempio. Se la query segnala che il set di dati non è stato trovato, l'upgrade del bucket di log non è stato completato.
Disabilita logging
Nella console Google Cloud , vai alla pagina Throughput riservato, fai clic su Impostazioni metriche, seleziona Disattiva metriche dettagliate e poi fai clic su Salva. Questa operazione annulla l'azione Abilita nella console.
Con l'API REST, segui questi passaggi.
Disattiva il logging impostando inferenceEventLoggingConfig.state su DISABLED sulla stessa risorsa su cui lo hai attivato.
curl -X POST \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://aiplatform.googleapis.com/v1beta1/projects/PROJECT_ID:setPublisherModelConfig" \
  -d '{
        "publisherModelConfig": {
          "inferenceEventLoggingConfig": {"state": "DISABLED"}
        },
        "updateMask": "inferenceEventLoggingConfig"
      }'
Poiché un'impostazione per modello ha la precedenza sull'impostazione predefinita del progetto, la disattivazione a livello di progetto non disattiva un modello abilitato esplicitamente. Cancella o disattiva anche l'impostazione per modello.
Dove vengono scritti i log
Le voci vengono scritte nel seguente log:
projects/PROJECT_NUMBER/logs/aiplatform.googleapis.com%2Finference_request
Da qui, hai le destinazioni standard di Cloud Logging:
- Observability Analytics: esegui query sulle voci con SQL in Observability Analytics nella consoleGoogle Cloud .
- Set di dati BigQuery collegato: collega un set di dati per leggere gli stessi dati da BigQuery. Per maggiori dettagli, consulta Esegui query su un set di dati BigQuery collegato.
- Sink aggregati: raccogli le voci di ogni progetto in una cartella o un'organizzazione con un unico sink. Filtra in base a
logName="projects/*/logs/aiplatform.googleapis.com%2Finference_request".
Per raccogliere le voci di ogni progetto in una cartella o un'organizzazione, consulta la panoramica dei sink aggregati.
Le voci diventano disponibili per le query poco dopo il completamento della richiesta. La maggior parte delle voci è disponibile per le query entro 12 secondi; attendi fino a 5 minuti.
Schema della voce di log
Ogni voce è composta da due parti su cui esegui query separatamente: la risorsa monitorata e le relative etichette, che identificano l'elemento che ha gestito la richiesta, e il payload JSON, che registra l'azione della richiesta. Nelle sezioni seguenti vengono descritti entrambi.
Etichette risorse
Per i modelli di publisher condivisi, il tipo di risorsa monitorata è
aiplatform.googleapis.com/PublisherModel, con le seguenti etichette.
| Etichetta | Tipo | Note |
|---|---|---|
resource_container |
STRING |
Il progetto che ha gestito la richiesta. |
location |
STRING |
La regione che ha gestito la richiesta, ad esempio us-central1. Le richieste inviate all'endpoint globale segnalano global. |
publisher |
STRING |
Il publisher del modello, ad esempio google o anthropic. |
model_user_id |
STRING |
Il modello, ad esempio gemini-2.5-pro. |
Campi del payload
| Nome campo | Tipo | Note |
|---|---|---|
method |
ENUM |
GENERATE_CONTENT, STREAM_GENERATE_CONTENT, RAW_PREDICT o STREAM_RAW_PREDICT. |
trafficType |
ENUM |
L'opzione di consumo che ha gestito la richiesta. I valori attuali sono PROVISIONED_THROUGHPUT, ON_DEMAND, ON_DEMAND_FLEX e ON_DEMAND_PRIORITY. Assente per le richieste non riuscite. |
requestStartTime |
TIMESTAMP |
L'ora in cui il frontend di gestione ha ammesso la richiesta. |
requestDuration |
STRING |
Latenza di pubblicazione end-to-end, formattata come stringa di durata, ad esempio 3.53s. |
generateContentDetails.usageMetadata |
JSON |
Conteggi dei token per generateContent e streamGenerateContent, incluse le suddivisioni per modalità. L'output dell'immagine viene visualizzato qui come voce IMAGE in candidatesTokensDetails. |
rawPredictDetails.usageMetadata |
JSON |
Conteggi dei token per rawPredict e streamRawPredict, inclusi i modelli dei partner. |
provisionedThroughput |
JSON |
Presente per il traffico del throughput riservato. |
httpHeaders |
JSON |
Intestazioni delle richieste acquisite. |
error |
JSON |
Presente solo quando la gravità è ERROR. |
principal |
JSON |
Il account di servizio che ha emesso la richiesta, se disponibile. |
Il campo LogEntry.labels contiene gen_ai.operation.name, che segue le convenzioni semantiche di OpenTelemetry GenAI. Sia generateContent che streamGenerateContent segnalano generate_content. Sia rawPredict che streamRawPredict segnalano raw_predict.
Campi del throughput riservato
| Nome campo | Tipo | Note |
|---|---|---|
ptChargedInputTokenCount |
INT64 |
Token di input conteggiati ai fini della quota di throughput riservato, dopo l'applicazione dei tassi di consumo. |
ptChargedOutputTokenCount |
INT64 |
Token di output conteggiati ai fini della quota di throughput riservato, dopo l'applicazione dei tassi di burndown. |
accountingResource |
STRING |
Il progetto il cui impegno di Throughput riservato è stato utilizzato dalla richiesta. |
Identifica le richieste di spillover
Una richiesta viene trasferita quando era idonea per il throughput riservato, ma è stata gestita on demand perché il throughput era esaurito. Una voce di spillover ha un trafficType di ON_DEMAND e nessun oggetto provisionedThroughput. Una richiesta pagamento a consumo ordinaria ha lo stesso aspetto, quindi utilizza le seguenti regole per distinguerle:
- Se hai inviato
X-Vertex-AI-LLM-Request-Typecon un valore dishared, hai indirizzato intenzionalmente la richiesta al pagamento a consumo. Non si tratta di spillover. - Se non hai inviato un'intestazione
X-Vertex-AI-LLM-Request-Typeo un valore diverso dadedicatedosharede la voce riportaON_DEMAND, la richiesta è stata trasferita, a condizione che tu abbia un throughput riservato per quel modello in quella regione. - Se non disponi di throughput riservato per il modello, ogni voce
ON_DEMANDè un normale pagamento a consumo.
Per i valori dell'intestazione, consulta Utilizza il throughput riservato.
Per una query che conteggia le richieste di spillover, consulta Spillover per minuto.
Identifica le richieste sottoposte a downgrade
Un downgrade di una richiesta si verifica quando hai richiesto un'opzione di pagamento a consumo e ne è stata fornita un'altra. Confronta l'intestazione X-Vertex-AI-LLM-Shared-Request-Type che hai inviato con l'intestazione trafficType che ha gestito la richiesta:
| Valore dell'intestazione inviato | trafficType se pubblicati come richiesto |
|---|---|
priority |
ON_DEMAND_PRIORITY |
flex |
ON_DEMAND_FLEX |
Qualsiasi altro trafficType in una voce riuscita indica che è stato eseguito il downgrade della richiesta o che il modello non offre l'opzione richiesta. Per una query, consulta Downgrade per modello.
Codici di errore
Le richieste non riuscite vengono scritte con una gravità di ERROR e contengono un oggetto error con un codice di stato gRPC e un motivo canonico. Il motivo è una stringa fissa. Non contiene mai il testo del prompt, il testo della risposta o i valori dell'intestazione.
| Codice | Stato | Stato HTTP tipico |
|---|---|---|
8 |
La risorsa è stata esaurita, ad esempio un limite di quota. | 429 |
4 |
La scadenza è stata superata prima del completamento dell'operazione. | 504 |
14 |
Il servizio non è disponibile. | 503 |
13 |
Si è verificato un errore interno. | 500 |
3 |
La richiesta contiene un argomento non valido. | 400 |
7 |
Il chiamante non dispone dell'autorizzazione necessaria. | 403 |
5 |
Impossibile trovare l'entità richiesta. | 404 |
Allega etichette di intestazione personalizzate
Per attribuire l'utilizzo alle tue dimensioni, ad esempio un team, un'applicazione o un tenant, invia le intestazioni della richiesta con il prefisso x-goog-agent-platform-observability-label-:
x-goog-agent-platform-observability-label-team: payments
x-goog-agent-platform-observability-label-application: invoice-ocr
Ogni intestazione viene visualizzata nella voce sotto jsonPayload.httpHeaders. Le etichette delle intestazioni funzionano sui modelli Gemini con generateContent e streamGenerateContent e sui modelli Claude con rawPredict e streamRawPredict, sul throughput riservato e su ogni opzione di pagamento a consumo.
Per esempi di chiamate API con etichette di intestazione, le voci di log che producono, i modelli supportati, i limiti e il confronto tra le etichette di intestazione e le etichette di richiesta, consulta Etichette dei metadati personalizzati. Per eseguire query su questi dati, consulta Utilizzo per etichetta di intestazione personalizzata.
Esegui query sui log con Esplora log
Utilizza Esplora log per trovare e ispezionare le singole richieste di inferenza. Non richiede alcuna configurazione oltre all'abilitazione del logging e legge direttamente il log, quindi le voci sono visibili non appena arrivano.
Nella console Google Cloud , vai alla pagina Esplora log e inserisci una query nel campo dell'editor di query utilizzando il linguaggio di query di Logging. Per saperne di più sui riquadri e sui controlli, consulta Interfaccia di Esplora log.
Inizia dal nome del log, che seleziona ogni voce di richiesta di inferenza nel progetto:
logName="projects/PROJECT_ID/logs/aiplatform.googleapis.com%2Finference_request"
Aggiungi termini per restringere i risultati. I termini su righe separate vengono combinati con AND.
- Per selezionare le richieste gestite da una regione, aggiungi
resource.labels.location="us-central1". - Per selezionare un metodo API, aggiungi
jsonPayload.method="GENERATE_CONTENT". - Per selezionare solo il traffico con Throughput riservato, aggiungi
jsonPayload.trafficType="PROVISIONED_THROUGHPUT". - Per selezionare solo gli errori relativi alla quota, aggiungi
severity=ERRORejsonPayload.error.code=8. - Per selezionare un valore dell'etichetta dell'intestazione personalizzata, aggiungi
jsonPayload.httpHeaders."x-goog-agent-platform-observability-label-team".values="payments".
Esplora log filtra e visualizza le voci. Non li aggrega. Per conteggiare, raggruppare o tracciare le voci, utilizza Observability Analytics. Nella barra degli strumenti Risultati delle query, fai clic su Analizza risultati per trasferire la query corrente. Questo pulsante viene visualizzato solo dopo l'upgrade del bucket di log.
Esegui query e analizza i log con Observability Analytics
Puoi utilizzare Observability Analytics per eseguire query e analizzare i log.
Prima di iniziare
Observability Analytics risponde a domande a cui Esplora log non può rispondere. Esplora log trova e visualizza singole voci, il che è utile quando stai cercando una richiesta. Observability Analytics esegue l'SQL sull'intero set, in modo da poter contare, raggruppare, unire e calcolare i percentili. Ogni domanda in questa sezione richiede l'aggregazione: la spesa per team, il burndown per progetto e la latenza p95 per regione non possono essere risposti una voce alla volta.
Ciò richiede l'upgrade del bucket di log _Default nel progetto per utilizzare Observability Analytics. Per saperne di più, consulta Configura i bucket di log.
Gli esempi seguenti vengono eseguiti in Observability Analytics. Sostituisci PROJECT_ID con il tuo progetto.
Throughput per regione e modello
SELECT
  JSON_VALUE(resource.labels.location)      AS region,
  JSON_VALUE(resource.labels.model_user_id) AS model,
  JSON_VALUE(json_payload.trafficType)      AS traffic_type,
  COUNT(*)                                  AS requests,
  SUM(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.promptTokenCount) AS INT64))     AS input_tokens,
  SUM(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.candidatesTokenCount) AS INT64)) AS output_tokens
FROM `PROJECT_ID.global._Default._Default`
WHERE log_id = "aiplatform.googleapis.com/inference_request"
  AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 24 HOUR)
GROUP BY region, model, traffic_type
ORDER BY requests DESC
Consumo del throughput riservato per progetto
SELECT
  JSON_VALUE(resource.labels.location) AS region,
  JSON_VALUE(json_payload.provisionedThroughput.accountingResource) AS pt_project,
  COUNTIF(JSON_VALUE(json_payload.trafficType) = "PROVISIONED_THROUGHPUT") AS pt_requests,
  COUNTIF(JSON_VALUE(json_payload.trafficType) = "ON_DEMAND")              AS on_demand_requests,
  SUM(CAST(JSON_VALUE(json_payload.provisionedThroughput.ptChargedInputTokenCount)  AS INT64)) AS pt_input_tokens,
  SUM(CAST(JSON_VALUE(json_payload.provisionedThroughput.ptChargedOutputTokenCount) AS INT64)) AS pt_output_tokens
FROM `PROJECT_ID.global._Default._Default`
WHERE log_id = "aiplatform.googleapis.com/inference_request"
  AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 24 HOUR)
GROUP BY region, pt_project
ORDER BY pt_input_tokens DESC
Utilizzo per etichetta di intestazione personalizzata
SELECT
  JSON_VALUE(json_payload.httpHeaders
    ["x-goog-agent-platform-observability-label-team"].values[0]) AS team,
  COUNT(*) AS requests,
  SUM(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.totalTokenCount) AS INT64)) AS total_tokens
FROM `PROJECT_ID.global._Default._Default`
WHERE log_id = "aiplatform.googleapis.com/inference_request"
  AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 7 DAY)
GROUP BY team
ORDER BY total_tokens DESC
Token consumati al minuto, Gemini e Claude affiancati
Questa query genera i token consumati al minuto in una colonna per publisher. Ogni colonna pondera i tipi di token nello stesso modo in cui la metrica publisher/online_serving/consumed_token_throughput lo fa per quel publisher, quindi ogni colonna corrisponde a Cloud Monitoring. Gemini e Claude ponderano i token di output e di cache in modo diverso, quindi non sommare le due colonne. Per i campi Claude, consulta
Conteggi dei token per i modelli Claude.
SELECT
  TIMESTAMP_TRUNC(timestamp, MINUTE) AS minute_ts,
  SUM(IF(JSON_VALUE(resource.labels.publisher) = "google",
    IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.promptTokenCount) AS INT64), 0)
      + IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.toolUsePromptTokenCount) AS INT64), 0)
      - 0.9 * IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.cachedContentTokenCount) AS INT64), 0)
      + IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.candidatesTokenCount) AS INT64), 0)
      + IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.thoughtsTokenCount) AS INT64), 0), 0)) AS gemini_consumed_tokens,
  SUM(IF(JSON_VALUE(resource.labels.publisher) = "anthropic",
    IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.input_tokens) AS INT64), 0)
      + 0.1  * IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.cache_read_input_tokens) AS INT64), 0)
      + 1.25 * IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.cache_creation_input_tokens) AS INT64), 0)
      + 0.75 * IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.cache_creation.ephemeral_1h_input_tokens) AS INT64), 0)
      + 5    * IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.output_tokens) AS INT64), 0), 0)) AS claude_consumed_tokens
FROM `PROJECT_ID.global._Default._Default`
WHERE log_id = "aiplatform.googleapis.com/inference_request"
  AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 24 HOUR)
GROUP BY minute_ts
ORDER BY minute_ts DESC
Percentuale di successi della cache in Gemini e Claude
La percentuale di successi della cache è data dai token di input memorizzati nella cache divisi per i token di input totali. L'input di Gemini include i token di utilizzo degli strumenti, perché la cache può coprirli. L'input di Claude è l'input non memorizzato nella cache più le letture e le scritture della cache. Per sapere come ogni publisher memorizza nella cache, consulta Panoramica della memorizzazione nella cache del contesto e Memorizzazione nella cache dei prompt di Claude.
SELECT
  JSON_VALUE(resource.labels.model_user_id) AS model,
  JSON_VALUE(json_payload.trafficType)      AS traffic_type,
  ROUND(100 * SAFE_DIVIDE(
    SUM(IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.cachedContentTokenCount) AS INT64), 0)
      + IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.cache_read_input_tokens) AS INT64), 0)),
    SUM(GREATEST(
          IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.promptTokenCount) AS INT64), 0)
          + IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.toolUsePromptTokenCount) AS INT64), 0),
          IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.cachedContentTokenCount) AS INT64), 0))
      + IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.input_tokens) AS INT64), 0)
      + IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.cache_read_input_tokens) AS INT64), 0)
      + IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.cache_creation_input_tokens) AS INT64), 0))), 1) AS cache_hit_rate_pct
FROM `PROJECT_ID.global._Default._Default`
WHERE log_id = "aiplatform.googleapis.com/inference_request"
  AND JSON_VALUE(json_payload.trafficType) IS NOT NULL
  AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 7 DAY)
GROUP BY model, traffic_type
ORDER BY model, traffic_type
Downgrade per modello
Questa query confronta l'opzione con pagamento a consumo richiesta da ogni richiesta con l'opzione che l'ha gestita. Per informazioni su come vengono identificati i downgrade, consulta Identifica le richieste di downgrade.
WITH entries AS (
  SELECT
    JSON_VALUE(resource.labels.model_user_id) AS model,
    severity,
    JSON_VALUE(json_payload.trafficType)      AS served,
    (SELECT LOWER(v)
     FROM UNNEST(JSON_VALUE_ARRAY(json_payload.httpHeaders["x-vertex-ai-llm-shared-request-type"].values)) AS v
     WHERE LOWER(v) IN ("priority", "flex")
     LIMIT 1)                                 AS requested
  FROM `PROJECT_ID.global._Default._Default`
  WHERE log_id = "aiplatform.googleapis.com/inference_request"
    AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 7 DAY)
)
SELECT
  model,
  requested,
  COUNTIF(served = CONCAT("ON_DEMAND_", UPPER(requested))) AS served_as_requested,
  COUNTIF(served IS NOT NULL
          AND served != CONCAT("ON_DEMAND_", UPPER(requested))) AS downgraded,
  COUNTIF(severity = "ERROR")                              AS failed
FROM entries
WHERE requested IS NOT NULL
GROUP BY model, requested
ORDER BY downgraded DESC
Spillover per minuto
Questa query conteggia le richieste di spillover al minuto per ogni modello che ha avuto traffico di throughput riservato nella finestra. Per scoprire come viene identificato lo spillover, consulta Identifica le richieste di spillover.
WITH entries AS (
  SELECT
    timestamp,
    JSON_VALUE(resource.labels.location)      AS region,
    JSON_VALUE(resource.labels.model_user_id) AS model,
    JSON_VALUE(json_payload.trafficType)      AS traffic_type,
    EXISTS(
      SELECT 1
      FROM UNNEST(JSON_VALUE_ARRAY(json_payload.httpHeaders["x-vertex-ai-llm-request-type"].values)) AS v
      WHERE LOWER(v) IN ("dedicated", "shared")) AS routed_by_header
  FROM `PROJECT_ID.global._Default._Default`
  WHERE log_id = "aiplatform.googleapis.com/inference_request"
    AND severity = "INFO"
    AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 24 HOUR)
),
pt_models AS (
  SELECT DISTINCT region, model FROM entries WHERE traffic_type = "PROVISIONED_THROUGHPUT"
)
SELECT
  TIMESTAMP_TRUNC(e.timestamp, MINUTE) AS minute_ts,
  e.region,
  e.model,
  COUNTIF(e.traffic_type = "PROVISIONED_THROUGHPUT")              AS pt_requests,
  COUNTIF(e.traffic_type = "ON_DEMAND" AND NOT e.routed_by_header) AS spillover_requests
FROM entries AS e
JOIN pt_models USING (region, model)
GROUP BY minute_ts, e.region, e.model
HAVING spillover_requests > 0
ORDER BY minute_ts DESC
Percentuale di errori e latenza per regione
SELECT
  JSON_VALUE(resource.labels.location) AS region,
  TIMESTAMP_TRUNC(timestamp, MINUTE)   AS minute_ts,
  COUNT(*)                             AS total,
  COUNTIF(severity = "ERROR")          AS errors,
  COUNTIF(CAST(JSON_VALUE(json_payload.error.code) AS INT64) = 8) AS resource_exhausted,
  APPROX_QUANTILES(
    CAST(REGEXP_REPLACE(JSON_VALUE(json_payload.requestDuration), r"s$", "") AS FLOAT64),
    100)[OFFSET(95)] AS p95_latency_seconds
FROM `PROJECT_ID.global._Default._Default`
WHERE log_id = "aiplatform.googleapis.com/inference_request"
  AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 6 HOUR)
GROUP BY region, minute_ts
ORDER BY minute_ts DESC
Conteggi dei token per i modelli Claude
I modelli Claude segnalano l'utilizzo in rawPredictDetails.usageMetadata, con i nomi dei campi dell'API Claude. Sia rawPredict che streamRawPredict scrivono gli stessi campi; per lo streaming, il log unisce il report sull'utilizzo segnalato nello stream.
| Campo | Che cosa conteggia |
|---|---|
input_tokens |
Token di input che non sono stati letti o scritti nella cache. |
cache_read_input_tokens |
Token di input letti dalla cache dei prompt. |
cache_creation_input_tokens |
Token di input scritti nella cache dei prompt, con entrambi i TTL combinati. |
cache_creation.ephemeral_5m_input_tokens |
Scritture nella cache con un TTL di 5 minuti. |
cache_creation.ephemeral_1h_input_tokens |
Scritture nella cache con un TTL di 1 ora. |
output_tokens |
Token di output, incluso il ragionamento esteso. Non aggiungere i token di ragionamento separatamente. |
L'input totale di Claude è input_tokens più cache_read_input_tokens più cache_creation_input_tokens. Gemini è diverso: promptTokenCount
include già i token memorizzati nella cache.
Le voci di Claude non contengono una suddivisione per modalità. Le etichette delle intestazioni funzionano allo stesso modo per Gemini e Claude; consulta Allega etichette delle intestazioni personalizzate.
Prezzi
Il logging dei metadati delle richieste di inferenza scrive in Cloud Logging e viene fatturato come importazione e archiviazione di Cloud Logging. Le query tramite Observability Analytics vengono fatturate in base all'utilizzo di Cloud Monitoring. Il collegamento di un set di dati BigQuery non comporta l'aggiunta di costi di archiviazione di BigQuery.
La dimensione della voce dipende dalle richieste, ad esempio dal numero di etichette di intestazione che contengono. Per stimare il costo, abilita il logging per un workload rappresentativo per un giorno, misura il volume importato con l'analisi del volume dei log e poi proietta il volume mensile nel Calcolatore prezzi diGoogle Cloud .
Passaggi successivi
- Scopri come monitorare i modelli con le metriche.
- Scopri come monitorare i costi utilizzando le etichette dei metadati personalizzati.
- Utilizza il logging di richieste e risposte se hai bisogno dei contenuti di prompt e risposte.
- Scopri di più sul throughput riservato.
- Visualizza le metriche dettagliate per il throughput riservato nella console Google Cloud .
- Risolvi gli errori 429.
- Raccogli le voci di ogni progetto in una cartella o un'organizzazione con i sink aggregati.