


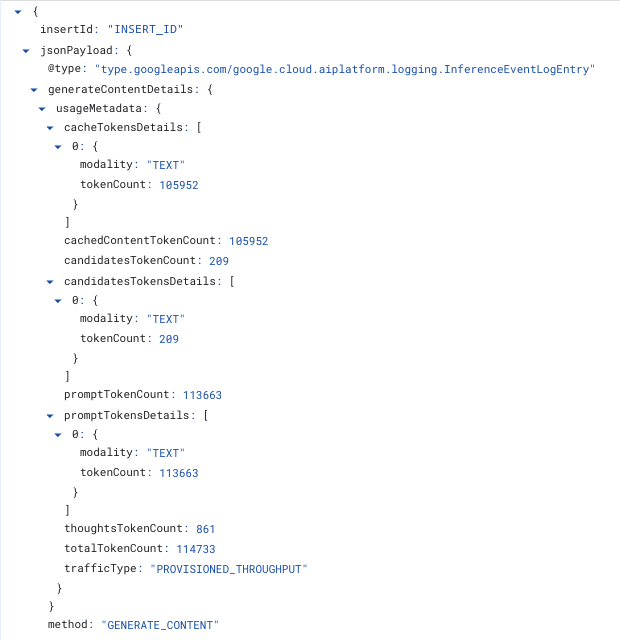
Agent Platform peut écrire une entrée de journal structurée pour chaque requête d'inférence diffusée par votre projet. Chaque entrée enregistre des métadonnées sur la requête : le modèle, la région, le nombre de jetons (y compris les jetons d'entrée, les jetons de sortie, les jetons mis en cache, les jetons de pensée), les consommations de débit provisionné, la latence de la requête de bout en bout, le code d'erreur et les étiquettes d'en-tête ou de requête que vous associez. Les entrées sont envoyées à Cloud Logging, et vous pouvez les interroger avec SQL dans l'Analyse de l'observabilité. Pour activer la journalisation, consultez Activer les journaux de métadonnées des requêtes d'inférence.
La journalisation des requêtes d'inférence n'enregistre que les métadonnées. Il n'enregistre pas les requêtes ni les réponses. Si vous avez besoin du contenu de la requête et de la réponse, utilisez plutôt la journalisation des requêtes-réponses.
Cette page explique comment activer les journaux de métadonnées des requêtes d'inférence, ce que contient chaque entrée et comment les interroger.
Cas d'utilisation
Les journaux de métadonnées des requêtes d'inférence répondent à des questions auxquelles les métriques agrégées ne peuvent pas répondre :
- Attribuez la consommation de jetons à une équipe, une application ou un locataire en associant vos propres libellés d'en-tête, libellés de requête ou les deux à chaque requête.
- Découvrez quelles requêtes individuelles ont été comptabilisées dans votre quota de débit provisionné et lesquelles ont été diffusées à la demande.
- Décomposez le débit, la latence et le taux d'erreur par étiquettes d'en-tête ou de requête.
- Mesurez le comportement de mise en cache par requête plutôt que de manière agrégée.
- Obtenez une visibilité sur l'utilisation au niveau de la seconde, par exemple pour savoir pourquoi un projet a reçu des erreurs 429 ou pourquoi le débit provisionné a été dépassé. Pour connaître la procédure de résolution des erreurs 429, consultez Résoudre le code d'erreur 429. Pour identifier les secondes au cours desquelles elles ont été reçues, consultez Taux d'erreur et latence par région.
Méthodes d'API compatibles pour la journalisation
Les journaux de métadonnées des requêtes d'inférence sont compatibles avec les éléments suivants :
- Modèles Gemini qui utilisent
generateContentoustreamGenerateContent, y compris la génération d'images via ces méthodes. - Modèles Claude qui utilisent
rawPredictoustreamRawPredict. Les autres modèles partenaires ne sont pas consignés. Pour connaître les noms des champs Claude, consultez Nombre de jetons pour les modèles Claude.
Le débit provisionné et toutes les options de paiement à l'usage sont acceptés.
Les éléments suivants ne sont pas acceptés :
chatCompletions.embedContent,predictetcountTokens. Les modèles qui génèrent des images viapredict, comme Imagen, ne sont pas enregistrés.- Requêtes adressées à des modèles affinés, y compris les modèles Gemini affinés avec l'affinage supervisé.
- Jobs de réglage, inférence par lot et toute autre opération de longue durée.
- Modèles que vous déployez vous-même dans un conteneur personnalisé.
Activer les journaux de métadonnées des requêtes d'inférence
Vous pouvez configurer les journaux de métadonnées des requêtes d'inférence pour un projet entier ou pour un modèle spécifique dans une région spécifique. Si vous devez l'activer au niveau de l'organisation, veuillez contacter l'équipe chargée de votre compte. L'application des configurations de journalisation peut prendre quelques minutes.
Avant de commencer
- Assurez-vous de disposer des autorisations IAM suivantes sur le projet :
aiplatform.endpoints.setPublisherModelConfigetaiplatform.endpoints.fetchPublisherModelConfigpour modifier et lire le paramètre, etlogging.buckets.get,logging.buckets.list,logging.buckets.updateetlogging.operations.getpour mettre à niveau le bucket de journaux. Pour connaître les rôles prédéfinis qui incluent ces autorisations, consultez Contrôle des accès et Contrôle des accès pour Logging. - Décidez si vous souhaitez mettre à niveau le bucket de journaux
_Defaultvers Analyse de l'observabilité. Vous devez effectuer la mise à niveau pour interroger les entrées avec SQL ou pour afficher les métriques détaillées dans la console Google Cloud . La mise à niveau prend plusieurs minutes et est irréversible. Les entrées écrites avant la mise à niveau ne peuvent pas être interrogées avec SQL par la suite. - Consultez les tarifs de Cloud Logging. Les entrées sont stockées pendant la durée de conservation du bucket (30 jours par défaut), et des frais d'ingestion et de stockage Cloud Logging s'appliquent. Pour estimer vos coûts, consultez la section Tarifs.
Activer dans la console
L'activation dans la console active la journalisation pour chaque modèle du projet, Gemini et Claude, sur le débit provisionné et chaque option de paiement à l'usage compatible avec les journaux. Il met également à niveau le bucket de journaux _Default s'il n'a pas encore été mis à niveau. Il définit la valeur par défaut à l'échelle du projet décrite dans Priorité de configuration. Avant de commencer, vérifiez les autorisations et la mise à niveau du bucket.
Dans la console Google Cloud , accédez à la page Débit provisionné.
Effectuez l'une des opérations suivantes :
- Dans la bannière Gemini Enterprise Agent Platform améliore l'observabilité, cliquez sur Activer.
- Dans la barre d'outils, cliquez sur Paramètres des métriques. Sélectionnez Activer les métriques détaillées, puis cliquez sur Enregistrer.

Figure 1. Bannière de mise à niveau de l'observabilité sur la page "Débit provisionné". 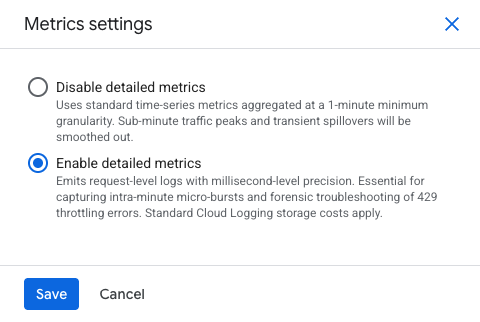
Figure 2. Le panneau des paramètres des métriques, avec l'option "Activer les métriques détaillées" sélectionnée. Dans la boîte de dialogue Activer les métriques détaillées ?, examinez les détails de la journalisation et de la mise à niveau du bucket, puis cliquez sur Activer.
La boîte de dialogue se ferme dès que la journalisation est activée. La mise à niveau du bucket se poursuit en arrière-plan et peut prendre plusieurs minutes. Pendant l'exécution, la bannière indique "Les métriques détaillées sont activées et le bucket de journaux _Default de ce projet est en cours de mise à niveau vers Analyse de l'observabilité".
Si la bannière indique que le bucket n'a pas été mis à niveau, cliquez sur Mettre à niveau pour réessayer. S'il indique que le bucket ne peut pas être mis à niveau, les journaux par requête ne peuvent pas être interrogés. Cliquez sur Paramètres des métriques, puis sélectionnez Désactiver les métriques détaillées pour arrêter les frais.
Priorité de configuration
Agent Platform résout le paramètre pour chaque requête dans l'ordre suivant :
- Le paramètre par modèle et par région, s'il est défini.
- La valeur par défaut à l'échelle du projet, si le paramètre par modèle n'est pas défini.
- Si aucune de ces valeurs n'est définie, la journalisation est désactivée.
Le paramètre par modèle prévaut sur le paramètre par défaut du projet. Vous pouvez activer la journalisation dans l'ensemble du projet et la désactiver pour un modèle à volume élevé dans une région, ou l'inverse.
Activer avec l'API REST
Vous configurez les journaux de métadonnées des requêtes d'inférence avec la méthode setPublisherModelConfig, en définissant inferenceEventLoggingConfig.state sur ENABLED.
Pour définir la valeur par défaut à l'échelle du projet, adressez-vous au projet :
curl -X POST \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://aiplatform.googleapis.com/v1beta1/projects/PROJECT_ID:setPublisherModelConfig" \
  -d '{
        "publisherModelConfig": {
          "inferenceEventLoggingConfig": {"state": "ENABLED"}
        },
        "updateMask": "inferenceEventLoggingConfig"
      }'
Pour remplacer un modèle dans une région, adressez-vous au modèle d'éditeur :
curl -X POST \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://aiplatform.googleapis.com/v1beta1/projects/PROJECT_ID/locations/LOCATION/publishers/PUBLISHER/models/MODEL:setPublisherModelConfig" \
  -d '{
        "publisherModelConfig": {
          "inferenceEventLoggingConfig": {"state": "ENABLED"}
        },
        "updateMask": "inferenceEventLoggingConfig"
      }'
Définissez PUBLISHER sur google pour les modèles Gemini et sur anthropic pour les modèles Claude. Par exemple, pour activer la journalisation pour Claude Sonnet 4.5 sur le point de terminaison global, utilisez publishers/anthropic/models/claude-sonnet-4-5 avec LOCATION défini sur global. Pour connaître les ID des modèles Claude, consultez Modèles Claude.
La méthode renvoie une opération de longue durée.
Obtenir la configuration de journalisation
Lisez la configuration actuelle à l'aide de la méthode fetchPublisherModelConfig. Utilisez le projet pour lire la valeur par défaut à l'échelle du projet, ou un modèle d'éditeur pour lire son remplacement.
curl -X GET \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  "https://aiplatform.googleapis.com/v1beta1/projects/PROJECT_ID:fetchPublisherModelConfig"
curl -X GET \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  "https://aiplatform.googleapis.com/v1beta1/projects/PROJECT_ID/locations/LOCATION/publishers/PUBLISHER/models/MODEL:fetchPublisherModelConfig"
La réponse contient les paramètres définis sur cette ressource :
{
  "inferenceEventLoggingConfig": {
    "state": "ENABLED"
  }
}
Vérifier que la journalisation fonctionne
- Envoyez une requête à un modèle que vous avez activé.
Dans l'explorateur de journaux, exécutez la requête suivante. La plupart des entrées s'affichent en 12 secondes, mais cela peut prendre jusqu'à cinq minutes.
logName="projects/PROJECT_ID/logs/aiplatform.googleapis.com%2Finference_request"Pour vérifier que SQL fonctionne, ouvrez Analyse de l'observabilité et exécutez n'importe quel exemple de requête. Si la requête indique que l'ensemble de données est introuvable, cela signifie que la mise à niveau du bucket de journaux n'est pas terminée.
Désactiver la journalisation
Dans la console Google Cloud , accédez à la page Débit provisionné, cliquez sur Paramètres des métriques, sélectionnez Désactiver les métriques détaillées, puis cliquez sur Enregistrer. Cette opération annule l'activation dans la console.
Avec l'API REST, procédez comme suit.
Désactivez la journalisation en définissant inferenceEventLoggingConfig.state sur DISABLED sur la même ressource que celle sur laquelle vous l'avez activée.
curl -X POST \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://aiplatform.googleapis.com/v1beta1/projects/PROJECT_ID:setPublisherModelConfig" \
  -d '{
        "publisherModelConfig": {
          "inferenceEventLoggingConfig": {"state": "DISABLED"}
        },
        "updateMask": "inferenceEventLoggingConfig"
      }'
Étant donné qu'un paramètre par modèle prévaut sur le paramètre par défaut du projet, la désactivation au niveau du projet ne désactive pas un modèle explicitement activé. Effacez ou désactivez également le paramètre par modèle.
Emplacement d'écriture des journaux
Les entrées sont écrites dans le journal suivant :
projects/PROJECT_NUMBER/logs/aiplatform.googleapis.com%2Finference_request
À partir de là, vous disposez des destinations Cloud Logging standards :
- Analyse de l'observabilité : interrogez les entrées avec SQL dans l'Analyse de l'observabilité de la consoleGoogle Cloud .
- Ensemble de données BigQuery associé : associez un ensemble de données pour lire les mêmes données depuis BigQuery. Pour en savoir plus, consultez Interroger un ensemble de données BigQuery associé.
- Récepteurs agrégés : collectez les entrées de chaque projet d'un dossier ou d'une organisation à l'aide d'un seul récepteur. Filtrer sur
logName="projects/*/logs/aiplatform.googleapis.com%2Finference_request".
Pour collecter les entrées de chaque projet d'un dossier ou d'une organisation, consultez la page Présentation des récepteurs agrégés.
Les entrées peuvent être interrogées peu de temps après la fin de la requête. La plupart des entrées sont interrogeables dans un délai de 12 secondes, mais cela peut prendre jusqu'à cinq minutes.
Schéma d'entrée de journal
Chaque entrée comporte deux parties que vous interrogez séparément : la ressource surveillée et ses étiquettes, qui identifient ce qui a traité la requête, et la charge utile JSON, qui enregistre ce que la requête a fait. Les sections suivantes décrivent ces deux méthodes.
Étiquettes de ressource
Pour les modèles d'éditeur partagés, le type de ressource surveillée est aiplatform.googleapis.com/PublisherModel, avec les étiquettes suivantes.
| Libellé | Type | Remarques |
|---|---|---|
resource_container |
STRING |
Projet qui a diffusé la requête. |
location |
STRING |
Région qui a diffusé la requête, par exemple us-central1. Les requêtes envoyées au point de terminaison global signalent global. |
publisher |
STRING |
Éditeur du modèle, par exemple google ou anthropic. |
model_user_id |
STRING |
Le modèle, par exemple gemini-2.5-pro. |
Champs de la charge utile
| Nom du champ | Type | Remarques |
|---|---|---|
method |
ENUM |
GENERATE_CONTENT, STREAM_GENERATE_CONTENT, RAW_PREDICT ou STREAM_RAW_PREDICT. |
trafficType |
ENUM |
Option de consommation qui a diffusé la requête. Les valeurs actuelles sont PROVISIONED_THROUGHPUT, ON_DEMAND, ON_DEMAND_FLEX et ON_DEMAND_PRIORITY. Absent pour les requêtes ayant échoué. |
requestStartTime |
TIMESTAMP |
Heure à laquelle l'interface de diffusion a accepté la requête. |
requestDuration |
STRING |
Latence de diffusion de bout en bout, formatée sous forme de chaîne de durée telle que 3.53s. |
generateContentDetails.usageMetadata |
JSON |
Nombre de jetons pour generateContent et streamGenerateContent, y compris les répartitions par modalité. La sortie d'image s'affiche ici en tant qu'entrée IMAGE dans candidatesTokensDetails. |
rawPredictDetails.usageMetadata |
JSON |
Nombre de jetons pour rawPredict et streamRawPredict, y compris les modèles partenaires. |
provisionedThroughput |
JSON |
Présent pour le trafic du débit provisionné. |
httpHeaders |
JSON |
En-têtes de requête capturés. |
error |
JSON |
Présent uniquement lorsque la gravité est ERROR. |
principal |
JSON |
Compte de service ayant envoyé la requête, le cas échéant. |
Le champ LogEntry.labels contient gen_ai.operation.name, qui suit les conventions sémantiques OpenTelemetry GenAI. generateContent et streamGenerateContent signalent generate_content. rawPredict et streamRawPredict signalent raw_predict.
Champs de débit provisionné
| Nom du champ | Type | Remarques |
|---|---|---|
ptChargedInputTokenCount |
INT64 |
Jetons d'entrée comptabilisés dans votre quota de débit provisionné, après application des taux d'utilisation. |
ptChargedOutputTokenCount |
INT64 |
Jetons de sortie décomptés de votre quota de débit provisionné, après application des taux d'utilisation. |
accountingResource |
STRING |
Projet dont l'engagement de débit provisionné a été utilisé par la requête. |
Identifier les requêtes de débordement
Une requête est considérée comme un dépassement lorsqu'elle était éligible au débit provisionné, mais qu'elle a été traitée à la demande, car votre débit était épuisé. Une entrée de débordement comporte un trafficType de ON_DEMAND et aucun objet provisionedThroughput. Une requête de paiement à l'usage ordinaire est identique. Utilisez donc les règles suivantes pour les distinguer :
- Si vous avez envoyé
X-Vertex-AI-LLM-Request-Typeavec la valeurshared, vous avez intentionnellement acheminé la requête vers le paiement à l'usage. Il ne s'agit pas d'un débordement. - Si vous n'avez pas envoyé d'en-tête
X-Vertex-AI-LLM-Request-Typeou si vous avez envoyé une valeur autre quededicatedoushared, et que l'entrée indiqueON_DEMAND, la requête a débordé, à condition que vous disposiez d'un débit provisionné pour ce modèle dans cette région. - Si vous ne disposez pas d'un débit provisionné pour le modèle, chaque entrée
ON_DEMANDest un paiement à l'usage ordinaire.
Pour connaître les valeurs d'en-tête, consultez Utiliser le débit provisionné.
Pour obtenir une requête qui compte les requêtes de débordement, consultez Débordement par minute.
Identifier les requêtes dégradées
Une requête est rétrogradée lorsque vous avez demandé une option de paiement à l'usage et qu'elle a été diffusée sur une autre. Comparez l'en-tête X-Vertex-AI-LLM-Shared-Request-Type que vous avez envoyé avec l'en-tête trafficType qui a traité la requête :
| Valeur d'en-tête que vous avez envoyée | trafficType lorsqu'elle est diffusée comme demandé |
|---|---|
priority |
ON_DEMAND_PRIORITY |
flex |
ON_DEMAND_FLEX |
Toute autre valeur de trafficType sur une entrée réussie signifie que la requête a été rétrogradée ou que le modèle ne propose pas l'option que vous avez demandée. Pour une requête, consultez Rétrogradations par modèle.
Codes d'erreur
Les requêtes ayant échoué sont écrites avec un niveau de gravité ERROR et comportent un objet error avec un code d'état gRPC et un motif canonique. La raison est une chaîne fixe. Il ne contient jamais de texte de requête, de texte de réponse ni de valeurs d'en-tête.
| Code | État | État HTTP habituel |
|---|---|---|
8 |
La ressource a été épuisée (par exemple, une limite de quota). | 429 |
4 |
Le délai a expiré avant la fin de l'opération. | 504 |
14 |
Le service est indisponible. | 503 |
13 |
Une erreur interne s'est produite. | 500 |
3 |
La requête contient un argument non valide. | 400 |
7 |
L'appelant ne dispose pas de l'autorisation requise. | 403 |
5 |
L'entité demandée est introuvable. | 404 |
Associer des libellés d'en-tête personnalisés
Pour attribuer l'utilisation à vos propres dimensions, telles qu'une équipe, une application ou un locataire, envoyez des en-têtes de requête avec le préfixe x-goog-agent-platform-observability-label- :
x-goog-agent-platform-observability-label-team: payments
x-goog-agent-platform-observability-label-application: invoice-ocr
Chaque en-tête apparaît dans l'entrée sous jsonPayload.httpHeaders. Les étiquettes d'en-tête fonctionnent sur les modèles Gemini avec generateContent et streamGenerateContent, et sur les modèles Claude avec rawPredict et streamRawPredict, sur le débit provisionné et sur toutes les options de paiement à l'usage.
Pour obtenir des exemples d'appels d'API avec des étiquettes d'en-tête, les entrées de journal qu'ils produisent, les modèles compatibles, les limites et la comparaison entre les étiquettes d'en-tête et les étiquettes de requête, consultez Étiquettes de métadonnées personnalisées. Pour les interroger, consultez Utilisation par étiquette d'en-tête personnalisée.
Interroger les journaux avec l'explorateur de journaux
Utilisez l'explorateur de journaux pour rechercher et inspecter des requêtes d'inférence individuelles. Il ne nécessite aucune configuration autre que l'activation de la journalisation et lit directement le journal. Les entrées sont donc visibles dès leur arrivée.
Dans la console Google Cloud , accédez à la page Explorateur de journaux et saisissez une requête dans le champ de l'éditeur de requête à l'aide du langage de requête Logging. Pour en savoir plus sur les volets et les commandes, consultez Interface de l'explorateur de journaux.
Commencez par le nom du journal, qui sélectionne chaque entrée de requête d'inférence dans le projet :
logName="projects/PROJECT_ID/logs/aiplatform.googleapis.com%2Finference_request"
Ajoutez des termes pour affiner les résultats. Les termes sur des lignes distinctes sont combinés avec l'opérateur AND.
- Pour sélectionner les requêtes diffusées à partir d'une région, ajoutez
resource.labels.location="us-central1". - Pour sélectionner une méthode d'API, ajoutez
jsonPayload.method="GENERATE_CONTENT". - Pour sélectionner uniquement le trafic du débit provisionné, ajoutez
jsonPayload.trafficType="PROVISIONED_THROUGHPUT". - Pour sélectionner uniquement les erreurs de quota, ajoutez
severity=ERRORetjsonPayload.error.code=8. - Pour sélectionner une valeur d'étiquette d'en-tête personnalisée, ajoutez
jsonPayload.httpHeaders."x-goog-agent-platform-observability-label-team".values="payments".
L'explorateur de journaux filtre et affiche les entrées. Il ne les agrège pas. Pour compter, regrouper ou représenter graphiquement vos entrées, utilisez l'Analyse de l'observabilité. Dans la barre d'outils Résultats de la requête, cliquez sur Analyser les résultats pour transférer votre requête actuelle. Ce bouton n'apparaît qu'après la mise à niveau du bucket de journaux.
Interroger et analyser des journaux avec Analyse de l'observabilité
Vous pouvez utiliser l'Analyse de l'observabilité pour interroger et analyser les journaux.
Avant de commencer
L'analyse de l'observabilité répond aux questions auxquelles l'explorateur de journaux ne peut pas répondre. L'explorateur de journaux recherche et affiche des entrées individuelles, ce qui est utile lorsque vous recherchez une requête spécifique. Analyse de l'observabilité exécute SQL sur l'ensemble des données, ce qui lui permet de compter, de regrouper, de joindre et de calculer des centiles. Chaque question de cette section nécessite une agrégation : les dépenses par équipe, le burndown par projet et la latence p95 par région ne peuvent pas être traités une entrée à la fois.
Pour ce faire, vous devez mettre à niveau le bucket de journaux _Default de votre projet pour utiliser l'Analyse de l'observabilité. Pour en savoir plus, consultez Configurer des buckets de journaux.
Les exemples suivants s'exécutent dans Observability Analytics. Remplacez PROJECT_ID par votre projet.
Débit par région et par modèle
SELECT
  JSON_VALUE(resource.labels.location)      AS region,
  JSON_VALUE(resource.labels.model_user_id) AS model,
  JSON_VALUE(json_payload.trafficType)      AS traffic_type,
  COUNT(*)                                  AS requests,
  SUM(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.promptTokenCount) AS INT64))     AS input_tokens,
  SUM(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.candidatesTokenCount) AS INT64)) AS output_tokens
FROM `PROJECT_ID.global._Default._Default`
WHERE log_id = "aiplatform.googleapis.com/inference_request"
  AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 24 HOUR)
GROUP BY region, model, traffic_type
ORDER BY requests DESC
Consommation du débit provisionné par projet
SELECT
  JSON_VALUE(resource.labels.location) AS region,
  JSON_VALUE(json_payload.provisionedThroughput.accountingResource) AS pt_project,
  COUNTIF(JSON_VALUE(json_payload.trafficType) = "PROVISIONED_THROUGHPUT") AS pt_requests,
  COUNTIF(JSON_VALUE(json_payload.trafficType) = "ON_DEMAND")              AS on_demand_requests,
  SUM(CAST(JSON_VALUE(json_payload.provisionedThroughput.ptChargedInputTokenCount)  AS INT64)) AS pt_input_tokens,
  SUM(CAST(JSON_VALUE(json_payload.provisionedThroughput.ptChargedOutputTokenCount) AS INT64)) AS pt_output_tokens
FROM `PROJECT_ID.global._Default._Default`
WHERE log_id = "aiplatform.googleapis.com/inference_request"
  AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 24 HOUR)
GROUP BY region, pt_project
ORDER BY pt_input_tokens DESC
Utilisation par libellé d'en-tête personnalisé
SELECT
  JSON_VALUE(json_payload.httpHeaders
    ["x-goog-agent-platform-observability-label-team"].values[0]) AS team,
  COUNT(*) AS requests,
  SUM(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.totalTokenCount) AS INT64)) AS total_tokens
FROM `PROJECT_ID.global._Default._Default`
WHERE log_id = "aiplatform.googleapis.com/inference_request"
  AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 7 DAY)
GROUP BY team
ORDER BY total_tokens DESC
Jetons consommés par minute, Gemini et Claude côte à côte
Cette requête indique les jetons consommés par minute dans une colonne par éditeur. Chaque colonne pondère les types de jetons de la même manière que la métrique publisher/online_serving/consumed_token_throughput pour cet éditeur. Chaque colonne correspond donc à Cloud Monitoring. Gemini et Claude pondèrent différemment les jetons de sortie et de cache. N'additionnez donc pas les deux colonnes. Pour les champs Claude, consultez Nombre de jetons pour les modèles Claude.
SELECT
  TIMESTAMP_TRUNC(timestamp, MINUTE) AS minute_ts,
  SUM(IF(JSON_VALUE(resource.labels.publisher) = "google",
    IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.promptTokenCount) AS INT64), 0)
      + IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.toolUsePromptTokenCount) AS INT64), 0)
      - 0.9 * IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.cachedContentTokenCount) AS INT64), 0)
      + IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.candidatesTokenCount) AS INT64), 0)
      + IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.thoughtsTokenCount) AS INT64), 0), 0)) AS gemini_consumed_tokens,
  SUM(IF(JSON_VALUE(resource.labels.publisher) = "anthropic",
    IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.input_tokens) AS INT64), 0)
      + 0.1  * IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.cache_read_input_tokens) AS INT64), 0)
      + 1.25 * IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.cache_creation_input_tokens) AS INT64), 0)
      + 0.75 * IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.cache_creation.ephemeral_1h_input_tokens) AS INT64), 0)
      + 5    * IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.output_tokens) AS INT64), 0), 0)) AS claude_consumed_tokens
FROM `PROJECT_ID.global._Default._Default`
WHERE log_id = "aiplatform.googleapis.com/inference_request"
  AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 24 HOUR)
GROUP BY minute_ts
ORDER BY minute_ts DESC
Taux de succès de cache pour Gemini et Claude
Le taux de succès de cache correspond au nombre de jetons d'entrée mis en cache divisé par le nombre total de jetons d'entrée. L'entrée Gemini inclut des jetons d'utilisation des outils, car le cache peut les couvrir. L'entrée Claude correspond à l'entrée non mise en cache, plus les lectures du cache, plus les écritures du cache. Pour savoir comment chaque éditeur met en cache, consultez Présentation de la mise en cache de contexte et Mise en cache des requêtes Claude.
SELECT
  JSON_VALUE(resource.labels.model_user_id) AS model,
  JSON_VALUE(json_payload.trafficType)      AS traffic_type,
  ROUND(100 * SAFE_DIVIDE(
    SUM(IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.cachedContentTokenCount) AS INT64), 0)
      + IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.cache_read_input_tokens) AS INT64), 0)),
    SUM(GREATEST(
          IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.promptTokenCount) AS INT64), 0)
          + IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.toolUsePromptTokenCount) AS INT64), 0),
          IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.cachedContentTokenCount) AS INT64), 0))
      + IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.input_tokens) AS INT64), 0)
      + IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.cache_read_input_tokens) AS INT64), 0)
      + IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.cache_creation_input_tokens) AS INT64), 0))), 1) AS cache_hit_rate_pct
FROM `PROJECT_ID.global._Default._Default`
WHERE log_id = "aiplatform.googleapis.com/inference_request"
  AND JSON_VALUE(json_payload.trafficType) IS NOT NULL
  AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 7 DAY)
GROUP BY model, traffic_type
ORDER BY model, traffic_type
Rétrogradations par modèle
Cette requête compare l'option de paiement à l'usage demandée par chaque requête à l'option qui l'a diffusée. Pour savoir comment les rétrogradations sont identifiées, consultez Identifier les requêtes rétrogradées.
WITH entries AS (
  SELECT
    JSON_VALUE(resource.labels.model_user_id) AS model,
    severity,
    JSON_VALUE(json_payload.trafficType)      AS served,
    (SELECT LOWER(v)
     FROM UNNEST(JSON_VALUE_ARRAY(json_payload.httpHeaders["x-vertex-ai-llm-shared-request-type"].values)) AS v
     WHERE LOWER(v) IN ("priority", "flex")
     LIMIT 1)                                 AS requested
  FROM `PROJECT_ID.global._Default._Default`
  WHERE log_id = "aiplatform.googleapis.com/inference_request"
    AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 7 DAY)
)
SELECT
  model,
  requested,
  COUNTIF(served = CONCAT("ON_DEMAND_", UPPER(requested))) AS served_as_requested,
  COUNTIF(served IS NOT NULL
          AND served != CONCAT("ON_DEMAND_", UPPER(requested))) AS downgraded,
  COUNTIF(severity = "ERROR")                              AS failed
FROM entries
WHERE requested IS NOT NULL
GROUP BY model, requested
ORDER BY downgraded DESC
Basculement par minute
Cette requête compte les requêtes de débordement par minute pour chaque modèle ayant enregistré du trafic de débit provisionné au cours de la période. Pour savoir comment identifier les débordements, consultez Identifier les requêtes de débordement.
WITH entries AS (
  SELECT
    timestamp,
    JSON_VALUE(resource.labels.location)      AS region,
    JSON_VALUE(resource.labels.model_user_id) AS model,
    JSON_VALUE(json_payload.trafficType)      AS traffic_type,
    EXISTS(
      SELECT 1
      FROM UNNEST(JSON_VALUE_ARRAY(json_payload.httpHeaders["x-vertex-ai-llm-request-type"].values)) AS v
      WHERE LOWER(v) IN ("dedicated", "shared")) AS routed_by_header
  FROM `PROJECT_ID.global._Default._Default`
  WHERE log_id = "aiplatform.googleapis.com/inference_request"
    AND severity = "INFO"
    AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 24 HOUR)
),
pt_models AS (
  SELECT DISTINCT region, model FROM entries WHERE traffic_type = "PROVISIONED_THROUGHPUT"
)
SELECT
  TIMESTAMP_TRUNC(e.timestamp, MINUTE) AS minute_ts,
  e.region,
  e.model,
  COUNTIF(e.traffic_type = "PROVISIONED_THROUGHPUT")              AS pt_requests,
  COUNTIF(e.traffic_type = "ON_DEMAND" AND NOT e.routed_by_header) AS spillover_requests
FROM entries AS e
JOIN pt_models USING (region, model)
GROUP BY minute_ts, e.region, e.model
HAVING spillover_requests > 0
ORDER BY minute_ts DESC
Taux d'erreur et latence par région
SELECT
  JSON_VALUE(resource.labels.location) AS region,
  TIMESTAMP_TRUNC(timestamp, MINUTE)   AS minute_ts,
  COUNT(*)                             AS total,
  COUNTIF(severity = "ERROR")          AS errors,
  COUNTIF(CAST(JSON_VALUE(json_payload.error.code) AS INT64) = 8) AS resource_exhausted,
  APPROX_QUANTILES(
    CAST(REGEXP_REPLACE(JSON_VALUE(json_payload.requestDuration), r"s$", "") AS FLOAT64),
    100)[OFFSET(95)] AS p95_latency_seconds
FROM `PROJECT_ID.global._Default._Default`
WHERE log_id = "aiplatform.googleapis.com/inference_request"
  AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 6 HOUR)
GROUP BY region, minute_ts
ORDER BY minute_ts DESC
Nombre de jetons pour les modèles Claude
Les modèles Claude signalent l'utilisation sous rawPredictDetails.usageMetadata, avec les noms de champs de l'API Claude. rawPredict et streamRawPredict écrivent les mêmes champs. Pour le streaming, le journal fusionne l'utilisation signalée dans le flux.
| Champ | Ce qu'il compte |
|---|---|
input_tokens |
Jetons d'entrée qui n'ont pas été lus à partir du cache ni écrits dans celui-ci. |
cache_read_input_tokens |
Jetons d'entrée lus à partir du cache de requêtes. |
cache_creation_input_tokens |
Jetons d'entrée écrits dans le cache de requêtes, les deux TTL combinés. |
cache_creation.ephemeral_5m_input_tokens |
Écritures dans le cache avec une valeur TTL de 5 minutes. |
cache_creation.ephemeral_1h_input_tokens |
Écritures dans le cache avec une valeur TTL d'une heure. |
output_tokens |
Jetons de sortie, y compris le raisonnement étendu. N'ajoutez pas de jetons de raisonnement séparément. |
Le total des entrées Claude est de input_tokens plus cache_read_input_tokens plus cache_creation_input_tokens. Gemini est différent : promptTokenCount inclut déjà des jetons mis en cache.
Les entrées Claude ne comportent pas de répartition par modalité. Les libellés d'en-tête fonctionnent de la même manière pour Gemini et Claude. Consultez Associer des libellés d'en-tête personnalisés.
Tarifs
La journalisation des métadonnées des requêtes d'inférence écrit dans Cloud Logging et est facturée en tant qu'ingestion et stockage Cloud Logging. Les requêtes effectuées via l'analyse de l'observabilité sont facturées en tant qu'utilisation de Cloud Monitoring. L'association d'un ensemble de données BigQuery n'entraîne pas de frais de stockage BigQuery.
La taille de l'entrée dépend de vos requêtes, par exemple du nombre d'étiquettes d'en-tête qu'elles contiennent. Pour estimer votre coût, activez la journalisation pour une charge de travail représentative pendant une journée, mesurez le volume ingéré avec l'analyse du volume de journaux, puis projetez votre volume mensuel dans le simulateur de coûtGoogle Cloud .
Étapes suivantes
- Découvrez comment surveiller des modèles avec des métriques.
- Découvrez comment surveiller les coûts à l'aide d'étiquettes de métadonnées personnalisées.
- Utilisez la journalisation des requêtes-réponses si vous avez besoin du contenu des requêtes et des réponses.
- Apprenez-en plus sur le débit provisionné.
- Affichez les métriques détaillées du débit provisionné dans la console Google Cloud .
- Résolvez les erreurs 429.
- Collectez les entrées de chaque projet d'un dossier ou d'une organisation à l'aide de récepteurs agrégés.