


AlphaFold 3 adalah model deep learning yang dikembangkan oleh Google DeepMind dan Isomorphic Labs. Model ini dirancang untuk memprediksi struktur dan interaksi 3D protein, DNA, RNA, ligan, dan ion. Dokumen ini menjelaskan cara men-deploy dan menggunakan model AlphaFold 3 menggunakan Model Garden di Gemini Enterprise Agent Platform.
Kemampuan utama
Men-deploy AlphaFold 3 di Agent Platform memberikan kemampuan berikut yang diperlukan untuk riset dan pengembangan (R&D) lanjutan serta alur kerja penemuan obat komersial:
Penggunaan komersial: AlphaFold 3 di Model Garden tersedia untuk penggunaan komersial.
Ligan kustom arbitrer: AlphaFold 3 mendukung pelipatan bersama protein, DNA, dan RNA yang terpadu bersama ligan kustom yang ditentukan menggunakan string SMILES atau kode Chemical Component Dictionary (CCD) CIF.
Fleksibilitas alur kerja: AlphaFold 3 di Model Garden mendukung pipeline pelipatan menyeluruh yang lengkap (menggabungkan penelusuran database dan prediksi model) atau mode khusus inferensi tempat Anda dapat menyediakan penyelarasan MSA yang telah dihitung sebelumnya untuk mengoptimalkan waktu eksekusi dan pemanfaatan GPU.
Pertimbangan
Saat mengevaluasi AlphaFold 3 untuk workload, perhatikan batasan berikut:
Konkurensi: Endpoint AlphaFold 3 memiliki batas konkurensi satu per node. Untuk konkurensi yang lebih tinggi, endpoint dapat diskalakan ke beberapa node. Jika permintaan prediksi dikirim saat prediksi lain sedang berjalan, endpoint akan menolak permintaan baru dengan error
HTTP 429 Too Many
Requests
jika jumlah permintaan lebih banyak daripada jumlah node.Batas token: Durasi prediksi maksimum di endpoint Agent Platform adalah 60 menit. Karena overhead penelusuran MSA yang bervariasi, ukuran urutan maksimum yang didukung pada GPU A3 adalah sekitar 4.500 token biologis (seperti asam amino, nukleotida, atau atom ligan). Menyediakan penyelarasan yang telah dihitung sebelumnya akan mengabaikan eksekusi penelusuran MSA, sehingga memungkinkan pelipatan kompleks hingga batas hardware sekitar 5.400 token.
Batas payload: Permintaan REST prediksi standar memiliki batas ukuran 8 MB. Jika Anda menggunakan mode khusus inferensi, penyelarasan besar yang telah dihitung sebelumnya (file
.a3m) harus direferensikan menggunakan Cloud Storage URI, bukan disematkan sebagai string inline untuk menghindari penolakan payload.Konfigurasi jaringan: Karena prediksi adalah operasi yang berjalan lama yang dapat memerlukan waktu hingga 60 menit untuk diselesaikan, Anda hanya boleh men-deploy endpoint dengan Private Service Connect (PSC) untuk mengabaikan batas waktu endpoint standar selama 10 menit.
Petunjuk deployment
Bagian ini menjelaskan cara men-deploy AlphaFold 3 ke endpoint yang disediakan oleh Agent Platform dalam project Google Cloud .
Sebelum memulai
Sebelum men-deploy AlphaFold 3, Anda harus:
- Minta akses model.
- Mendapatkan resource GPU.
- Konfigurasikan izin Identity and Access Management (IAM) yang diperlukan:
- Buat akun layanan dengan peran IAM Agent Platform Administrator.
- Pastikan akun utama IAM Anda memiliki peran
roles/iam.serviceAccountCreatoruntuk bertindak sebagai akun layanan saat men-deploy model.
- Verifikasi kuota resource Anda.
Persyaratan resource
AlphaFold 3 memerlukan virtual machine (VM) a3-highgpu-1g.
Sebelum deployment, pastikan project Google Cloud Anda memiliki kuota yang cukup di region deployment target untuk resource berikut:
Akselerator: Setidaknya satu jenis mesin
a3-highgpu-1g.SSD Lokal: VM A3 disediakan dengan ruang SSD Lokal sebesar 750 GB. Hal ini diperlukan untuk menyimpan database urutan referensi (UniProt, MGnify, Rfam) secara persisten dalam cache, sehingga memungkinkan pembacaan latensi rendah selama penelusuran database genetik (Jackhmmer/Nhmmer) di semua permintaan prediksi.
Bucket Cloud Storage
AlphaFold 3 memerlukan bucket Cloud Storage untuk menyimpan file MSA yang disediakan, dan untuk mengekspor output prediksi lengkap. Untuk menghindari transfer lintas region, sebaiknya gunakan bucket Cloud Storage di region yang sama dengan endpoint Anda, atau gunakan bucket multi-region.
Peran Identity and Access Management
Konfigurasikan peran berikut di seluruh identitas yang berpartisipasi:
Deployer model (juga dikenal sebagai admin IT): Identitas yang men-deploy model memerlukan izin
roles/aiplatform.adminuntuk membuat endpoint dan mengelola deployment.Identitas inferensi: Saat menjalankan inferensi, endpoint AlphaFold 3 menulis struktur output langsung ke Cloud Storage menggunakan akun layanan project tenant. Akun layanan yang sesuai memerlukan
roles/storage.objectUserdi bucket Cloud Storage target.Pengguna model: Akun yang memulai prediksi memerlukan hal berikut:
roles/aiplatform.useruntuk mengirim permintaan prediksi ke endpoint.roles/storage.objectUseruntuk mengakses output prediksi di bucket Cloud Storage.
Men-deploy AlphaFold 3
Deploy AlphaFold 3 secara terprogram menggunakan Agent Platform SDK sebagai endpoint Google Cloud Dedicated atau hanya sebagai endpoint Private Service Connect. Diperlukan waktu 10-15 menit agar endpoint siap untuk inferensi, bergantung pada ketersediaan GPU Anda.
Berikut adalah contoh cuplikan Python yang menunjukkan cara men-deploy model dalam project Google Cloud , termasuk perpanjangan waktu tunggu inferensi:
import google.auth
from google.auth.transport.requests import AuthorizedSession
import vertexai
from vertexai import model_garden

PROJECT_ID = "YOUR_PROJECT_ID"
LOCATION = "us-west1"
MODEL_ID = "google/alphafold3@v3_0_4"
MACHINE_TYPE = "a3-highgpu-1g"

vertexai.init(project=PROJECT_ID, location=LOCATION)

# 1. Deploy Model Garden OpenModel to Dedicated Endpoint
af3_model = model_garden.OpenModel(MODEL_ID)
endpoint = af3_model.deploy(
    endpoint_display_name="af3-dedicated-ep",
    model_display_name="af3-on-mg",
    machine_type=MACHINE_TYPE,
    accelerator_type="NVIDIA_H100_80GB",
    accelerator_count=1,
    reservation_affinity_type="ANY_RESERVATION",
    use_dedicated_endpoint=True,
    accept_eula=True,
    min_replica_count=1,
    max_replica_count=1,
    serving_container_deployment_timeout=3600,
)

# 2. Update inference timeout to 3,600 seconds
credentials, _ = google.auth.default(
    scopes=["https://www.googleapis.com/auth/cloud-platform"]
)
session = AuthorizedSession(credentials)
url = f"https://{LOCATION}-aiplatform.googleapis.com/v1/{endpoint.resource_name}:update"
payload = {
    "endpoint": {
        "name": endpoint.resource_name,
        "clientConnectionConfig": {
            "inferenceTimeout": {
                "seconds": 3600
            }
        }
    }
}
response = session.post(url, json=payload)
response.raise_for_status()
print(f"Endpoint Resource Name: {endpoint.resource_name}")
Referensi API
Bagian ini menjelaskan lokasi endpoint, format URL, parameter jalur, dan skema payload permintaan.
Permintaan HTTP
POST https://HOST/v1/projects/PROJECT_ID/locations/LOCATION/endpoints/ENDPOINT_ID:predict
Ganti kode berikut:
HOST: host endpoint layanan. Hal ini bergantung pada apakah jenis deployment adalah endpoint publik khusus atau menggunakan Private Service Connect.PROJECT_ID: project ID Google Cloud yang menghosting endpoint yang di-deploy.LOCATION: region Google Cloud tempat endpoint di-deploy (sepertius-central1).ENDPOINT_ID: ID unik endpoint Agent Platform yang di-deploy.
Isi permintaan
Isi permintaan berisi data dengan struktur JSON berikut:
{
  "instances": [
    {
      # The AlphaFold 3 input JSON - see the input documentation at
      # https://github.com/google-deepmind/alphafold3/blob/main/docs/input.md
    }
  ],
  "parameters": {
    "output_dir": "string",
    "dry_run": boolean,
    "run_data_pipeline": boolean,
    "force_output_dir": boolean,
    "resolve_msa_overlaps": boolean,
    "max_template_date": "string",
    "conformer_max_iterations": integer,
    "fix_standalone_glycans": boolean,
    "flash_attention_implementation": "string",
    "num_recycles": integer,
    "num_diffusion_samples": integer,
    "save_embeddings": boolean,
    "save_distogram": boolean,
    "compress_large_output_files": boolean,
    "num_seeds": integer
  }
}
Kolom permintaan level teratas
| Kolom | Jenis | Deskripsi |
|---|---|---|
instances |
array |
Wajib. Daftar konfigurasi urutan biologis yang akan diprediksi. Daftar ini harus berisi tepat satu elemen. Meneruskan nol atau lebih dari satu elemen akan menghasilkan error HTTP 422 Unprocessable
Entity. Isi instances harus menentukan
input sesuai dengan spesifikasi yang dipublikasikan dalam
dokumentasi AlphaFold 3.
|
parameters |
object |
Opsional. Objek yang berisi parameter eksekusi untuk mengonfigurasi
operasi prediksi (seperti dry_run, output_dir).
|
Parameter
Konfigurasikan flag eksekusi untuk eksekusi AlphaFold 3.
| Kolom | Jenis | Nilai default | Deskripsi |
|---|---|---|---|
dry_run |
boolean |
false |
Opsional. Jika true, API akan menjalankan validasi permintaan, tetapi mengabaikan eksekusi model dan langsung menampilkan respons kosong. Berguna untuk pemeriksaan konektivitas dan sintaksis.
|
run_data_pipeline |
boolean |
true |
Opsional. Jika true, menjalankan pipeline lengkap (penelusuran dan inferensi MSA). Jika false, jalankan inferensi saja (lewati
penelusuran database; memerlukan MSA yang telah dihitung sebelumnya). Lihat
dokumentasi di GitHub untuk mengetahui detail tambahan.
|
output_dir |
string |
null |
Opsional. URI Cloud Storage (seperti gs://bucket/path) tempat
file output mentah lengkap (termasuk struktur CIF, PAE, dan CSV
peringkat) diupload setelah eksekusi berhasil.
|
force_output_dir |
boolean |
false |
Opsional. Jika true, mengizinkan penimpaan file yang ada di output_dir yang ditentukan. Jika false, API akan segera menampilkan error HTTP 400 Bad Request jika jalur Cloud Storage tidak kosong untuk mencegah kehilangan data yang tidak disengaja.
|
resolve_msa_overlaps |
boolean |
true |
Opsional. Apakah akan menghapus duplikat MSA yang tidak dipasangkan terhadap MSA yang dipasangkan. Lihat panduan di dokumentasi GitHub AlphaFold 3 untuk mengetahui praktik terbaik. |
max_template_date |
string |
null |
Opsional. Tanggal rilis template maksimum yang akan dipertimbangkan dalam
format YYYY-MM-DD (seperti, "2024-05-15").
Validasi gagal dengan error HTTP 422 jika formatnya
salah.
|
conformer_max_iterations |
integer |
null |
Opsional. Penggantian untuk jumlah iterasi maksimum yang akan dijalankan
untuk penelusuran konformer RDKit. Harus berupa bilangan bulat non-negatif (lebih besar dari atau sama dengan nol). Gagal divalidasi dengan error HTTP 422
untuk nilai negatif.
|
fix_standalone_glycans |
boolean |
false |
Opsional. Memungkinkan perbaikan posisi glikan mandiri. |
flash_attention_implementation |
string |
null |
Opsional. Implementasi backend flash attention yang akan digunakan. Nilai yang diizinkan adalah "triton", "cudnn", "xla".
|
num_recycles |
integer |
10 |
Opsional. Jumlah iterasi daur ulang yang akan digunakan selama inferensi. Harus berupa bilangan bulat positif (lebih besar dari nol). Lihat bagian praktik terbaik untuk mempelajari komprominya. |
num_diffusion_samples |
integer |
5 |
Opsional. Jumlah sampel difusi yang akan dibuat. Harus berupa bilangan bulat positif (lebih besar dari nol). Lihat bagian praktik terbaik untuk mempelajari komprominya. |
save_embeddings |
boolean |
false |
Opsional. Apakah akan menyimpan embedding tunggal dan pasangan trunk akhir di lokasi output_dir. Jika
true, embedding ditulis sebagai file .npz
di subfolder bernama seed-{SEED}_embeddings/ (misalnya, outputs_config_job_seed-50_embeddings.npz).
|
save_distogram |
boolean |
false |
Opsional. Apakah akan menyimpan distogram prediksi akhir di lokasi output_dir. Jika true, embedding akan ditulis sebagai file .npz di subfolder bernama seed-{SEED}_embeddings/ (misalnya, outputs_config_job_seed-50_embeddings.npz).
|
compress_large_output_files |
boolean |
false |
Opsional. Jika true, kompresi file output besar
(struktur mmCIF dan JSON keyakinan) menggunakan zstandard. Tindakan ini akan menghasilkan
file dengan ekstensi .cif.zst dan .json.zst,
bukan .cif dan .json. File kecil (seperti
ranking_scores.csv) tetap tidak dikompresi.
|
num_seeds |
integer |
null |
Opsional. Jumlah seed acak yang akan digunakan untuk inferensi. Secara umum, Anda harus menetapkan seed di dalam kolom instances.modelSeeds untuk reproduksibilitas. Lihat
bagian praktik terbaik untuk mempelajari
komprominya.
|
Respons (output)
Bagian ini menjelaskan kolom yang ditampilkan dalam respons API setelah eksekusi berhasil.
Isi respons
Setelah berhasil dieksekusi, endpoint akan menampilkan respons dalam format skema prediksi online Agent Platform standar:
{
  "deployedModelId": "string",
  "model": "string",
  "modelDisplayName": "string",
  "modelVersionId": "string",
  "predictions": [
    {
      "structure_cif": "string",
      "plddt": [
        number
      ],
      "pae": [
        [
          number
        ]
      ],
      "summary": {
        "ptm": number,
        "iptm": number,
        "fraction_disordered": number,
        "has_clash": boolean,
        "ranking_score": number,
        "chain_pair_pae_min": [
          [
            number
          ]
        ],
        "chain_pair_iptm": [
          [
            number
          ]
        ],
        "chain_ptm": [
          number
        ],
        "chain_iptm": [
          number
        ],
        "chain_ids": [
          string
        ]
      },
      "output_dir": "string"
    }
  ]
}
Kolom respons level teratas
| Kolom | Jenis | Deskripsi |
|---|---|---|
deployedModelId |
string |
ID model yang di-deploy di endpoint Agent Platform. |
model |
string |
Nama resource yang sepenuhnya memenuhi syarat dari model. |
modelDisplayName |
string |
Nama tampilan model yang di-deploy (selalu
"alphafold3").
|
modelVersionId |
string |
ID versi model yang di-deploy. |
predictions |
array |
Daftar hasil prediksi. Untuk AlphaFold 3, array ini berisi tepat satu objek hasil prediksi. |
Detail hasil prediksi (predictions[])
Endpoint prediksi AlphaFold 3 menampilkan respons JSON HTTP 200 yang berisi array predictions dengan koordinat struktural dan metrik keyakinan untuk kandidat peringkat teratas. Untuk mengetahui definisi kolom dan spesifikasi file output yang komprehensif, lihat dokumentasi AlphaFold 3 resmi di GitHub.
Bergantung pada apakah parameters.output_dir disediakan dalam permintaan, struktur output dalam respons API dapat bervariasi:
Prediksi dalam respons HTTP: Respons inline menampilkan metrik ringkasan global (
summary), koordinat struktur 3D (structure_cif), skor keyakinan per atom (plddt), dan matriks Predicted Aligned Error 2D (pae) langsung dalam isi payload respons JSON HTTP. Jika direktori output ditentukan, kolom payload besar (structure_cif,plddt, danpae) akan dihilangkan (null) dari payload respons HTTP untuk mencegah bottleneck serialisasi. Sebagai gantinya, semua output model mentah diekspor secara asinkron ke bucket Cloud Storage yang ditentukan.Artefak yang disimpan di bucket Cloud Storage: Jika direktori output (
parameters.output_dir) ditentukan, hasil prediksi yang komprehensif akan diupload ke Cloud Storage. Folder output berisi data sesuai dengan spesifikasi yang dipublikasikan dalam dokumentasi AlphaFold 3 di GitHub.
Membuat prediksi
Deployment Model Garden menyederhanakan eksekusi pipeline prediksi end-to-end, termasuk pipeline data dan inferensi model dalam satu panggilan API. Diagram berikut menunjukkan arsitektur tingkat tinggi prediksi AlphaFold 3:
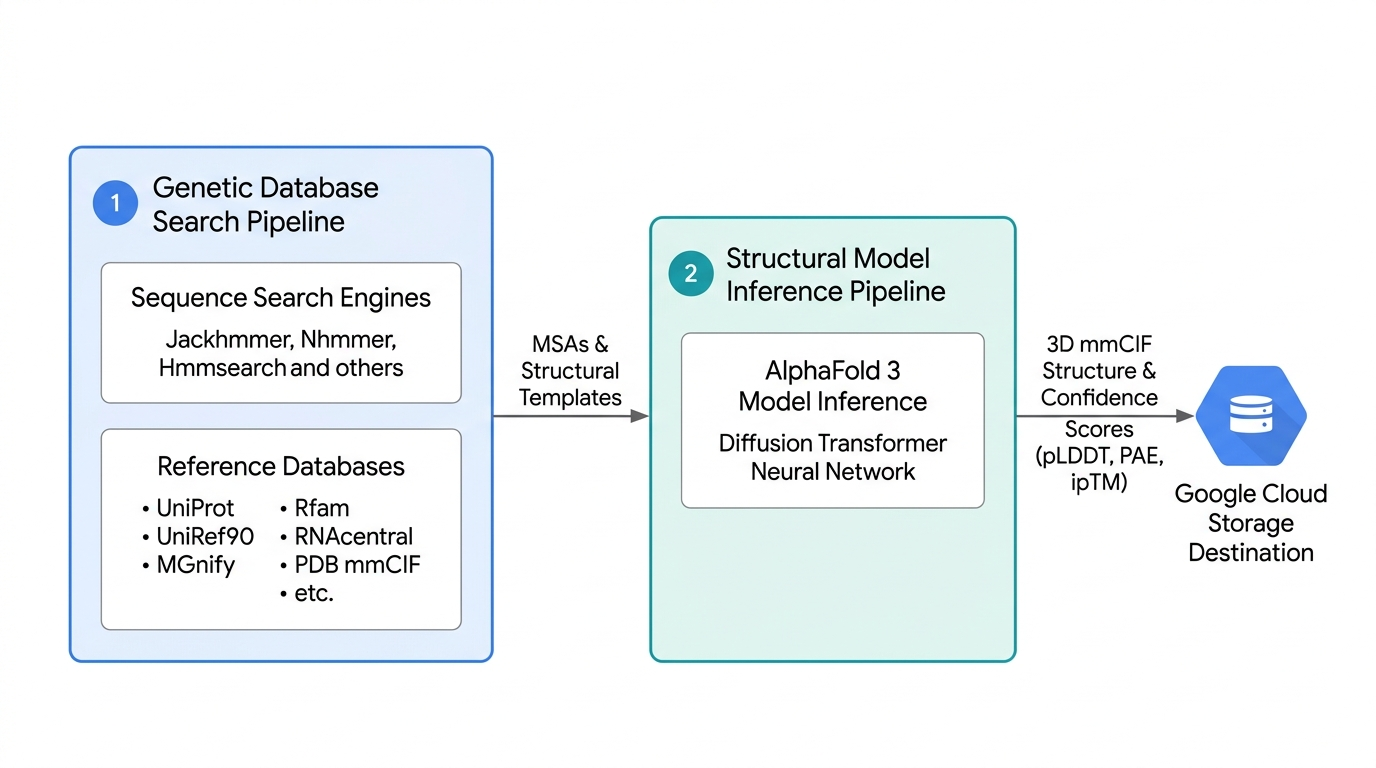
Gambar 1. Pipeline prediksi lengkap
Saat menjalankan prediksi, sangat disarankan untuk menyediakan bucket Cloud Storage langsung dalam parameter untuk mengekspor set data mentah lengkap, termasuk subdirektori per sampel, manifes peringkat, dan output mentah. Untuk perincian lengkap semua kolom permintaan yang dapat dikonfigurasi, termasuk penyesuaian parameter untuk pengambilan sampel multi-seed, daur ulang neural, lintasan difusi, dan ikatan kovalen kustom, lihat bagian referensi API.
Sebelum meluncurkan tugas pelipatan yang berjalan lama atau pipeline batch, Anda dapat menjalankan uji coba untuk memverifikasi autentikasi, izin IAM, dan konektivitas jaringan endpoint dengan cepat.
Opsi prediksi
Bergantung pada alur kerja, pemrosesan AlphaFold 3 dapat diatur ke dalam empat mode eksekusi yang berbeda:
- Mode uji coba
- Mode prediksi menyeluruh
- Hanya inferensi dengan MSA dan template yang telah dihitung sebelumnya
- Menjalankan tanpa MSA dan template
Mode uji coba
Untuk memverifikasi konektivitas API, autentikasi, jaringan, dan skema JSON tanpa
memulai pipeline prediksi, Anda dapat mengirimkan permintaan dengan "dry_run":
true di objek parameters. Endpoint menjalankan semua rutinitas validasi (termasuk memeriksa izin tulis bucket Cloud Storage dan memvalidasi karakter urutan), tetapi melewati eksekusi, dan langsung menampilkan respons prediksi kosong.
Berikut adalah contoh skrip Python untuk mode uji coba:
from google.cloud import aiplatform

PROJECT_ID = "YOUR_PROJECT_ID"
LOCATION = "us-west1"
ENDPOINT_ID = "YOUR_ENDPOINT_ID"

# Initialize AI Platform SDK
aiplatform.init(project=PROJECT_ID, location=LOCATION)

# Connect to Dedicated Endpoint
endpoint = aiplatform.Endpoint(ENDPOINT_ID)

# Define prediction payload
instances = [
    {
        "name": "preflight_check",
        "dialect": "alphafold3",
        "version": 4,
        "modelSeeds": [1],
        "sequences": [
            {
                "protein": {
                    "id": "A",
                    "sequence": "PVLSCGEWQL",
                }
            }
        ],
    }
]

parameters = {
    "dry_run": True,
}

# Execute prediction request
response = endpoint.predict(
    instances=instances,
    parameters=parameters
)
print(response.predictions)
Mode prediksi menyeluruh
Untuk menjalankan prediksi menyeluruh, kirimkan urutan biologis mentah (protein, DNA, RNA, ligan, dan PTM) dalam satu permintaan. Endpoint akan otomatis menjalankan penelusuran database genetik, yang segera diikuti dengan inferensi model. Hal ini direkomendasikan untuk tugas pelipatan tanpa penyelarasan yang sudah ada sebelumnya.
Berikut adalah contoh skrip Python untuk mode prediksi end-to-end:
from google.cloud import aiplatform

# Configuration
PROJECT_ID = "YOUR_PROJECT_ID"
LOCATION = "us-west1"
ENDPOINT_ID = "YOUR_ENDPOINT_ID"
STORAGE_OUTPUT_DIR = "gs://YOUR_BUCKET_NAME/alphafold_output/"

# Initialize AI Platform SDK
aiplatform.init(project=PROJECT_ID, location=LOCATION)

# Instantiate Endpoint reference
endpoint = aiplatform.Endpoint(ENDPOINT_ID)

# Define Prediction Payload
instances = [
    {
        "name": "e2e_protein_ligand_complex",
        "dialect": "alphafold3",
        "version": 4,
        "modelSeeds": [1],
        "sequences": [
            {
                "protein": {
                    "id": "A",
                    "sequence": "PVLSCGEWQL",
                    "modifications": [
                        {"ptmType": "HY3", "ptmPosition": 1}
                    ],
                }
            },
            {
                "ligand": {
                    "id": "B",
                    "ccdCodes": ["MG"],
                }
            },
        ],
    }
]

parameters = {
    "output_dir": STORAGE_OUTPUT_DIR,
}

# Execute Prediction
response = endpoint.predict(
    instances=instances,
    parameters=parameters
)

print(response.predictions)
Khusus inferensi dengan MSA dan template yang telah dihitung sebelumnya
Anda mungkin sudah memiliki MSA dan template mmCIF yang telah dihitung sebelumnya, baik dari eksekusi sebelumnya atau yang dihasilkan di luar endpoint model. Dalam skenario tersebut, penelusuran database genetik dapat dilewati sepenuhnya dengan menyediakan penyelarasan dan template, sehingga mengarahkan permintaan langsung untuk prediksi struktur. Hal ini juga dapat mengurangi waktu respons inferensi secara signifikan. Ini adalah jalur yang direkomendasikan dalam skenario berikut:
- Saat melakukan docking beberapa ligan molekul kecil yang berbeda terhadap satu target protein statis, MSA dapat digunakan kembali.
- Menjalankan urutan molekul yang sama di beberapa seed acak, secara iteratif, untuk memetakan fleksibilitas struktural.
- Menyelaraskan urutan secara offline dengan database genomik pribadi non-publik.
- Mengoptimalkan resource GPU untuk AlphaFold 3, agar hanya berfokus pada pembuatan struktur.
Berikut adalah contoh skrip Python untuk mode khusus inferensi:
from google.cloud import aiplatform

# Configuration
PROJECT_ID = "YOUR_PROJECT_ID"
LOCATION = "us-west1"
ENDPOINT_ID = "YOUR_ENDPOINT_ID"
STORAGE_OUTPUT_DIR = "gs://YOUR_BUCKET_NAME/af3_results/inference_only"

# Initialize AI Platform SDK
aiplatform.init(project=PROJECT_ID, location=LOCATION)

# Instantiate Endpoint reference
endpoint = aiplatform.Endpoint(ENDPOINT_ID)

# Define Prediction Payload
instances = [
    {
        "name": "inference_protein_ligand_complex",
        "dialect": "alphafold3",
        "version": 4,
        "modelSeeds": [1],
        "sequences": [
            {
                "protein": {
                    "id": "A",
                    "sequence": "PVLSCGEWQL",
                    "modifications": [
                        {"ptmType": "HY3", "ptmPosition": 1}
                    ],
                    "unpairedMsaPath": "gs://YOUR_BUCKET_NAME/path/to/unpaired.a3m",
                    "pairedMsa": "",
                    "templates": [],
                }
            },
            {
                "ligand": {
                    "id": "B",
                    "ccdCodes": ["MG"],
                }
            },
        ],
    }
]

parameters = {
    "run_data_pipeline": False,
    "output_dir": STORAGE_OUTPUT_DIR,
    "force_output_dir": True,
}

# Execute Prediction
response = endpoint.predict(
    instances=instances,
    parameters=parameters
)

print(response.predictions)
Menjalankan MSA dan bebas template
Ada juga opsi yang memungkinkan penelusuran database genetik dan pencocokan template
dilewati sepenuhnya. Model ini memprediksi struktur 3D hanya menggunakan urutan kueri, tanpa urutan homolog atau informasi ko-evolusi. Untuk
memicu mode ini, berikan string kosong untuk parameter MSA unpairedMsa dan
pairedMsa serta daftar kosong untuk templates dalam instance, dan tetapkan
run_data_pipeline ke false dalam parameter. Hal ini dapat berguna untuk
desain molekul sintetis atau rekayasa atau menguji prediksi struktural tanpa
konteks evolusi.
Berikut adalah contoh skrip Python untuk menjalankan AlphaFold 3 tanpa MSA dan template:
from google.cloud import aiplatform

# Configuration
PROJECT_ID = "YOUR_PROJECT_ID"
LOCATION = "us-west1"
ENDPOINT_ID = "YOUR_ENDPOINT_ID"
STORAGE_OUTPUT_DIR = "gs://YOUR_BUCKET_NAME/af3_results/inference_only_gcs_job"

# Initialize AI Platform SDK
aiplatform.init(project=PROJECT_ID, location=LOCATION)

# Instantiate Endpoint reference
endpoint = aiplatform.Endpoint(ENDPOINT_ID)

# Define Prediction Payload
instances = [
    {
        "name": "inference_only_gcs_job",
        "dialect": "alphafold3",
        "version": 4,
        "modelSeeds": [1, 2, 3],
        "sequences": [
            {
                "protein": {
                    "id": "A",
                    "sequence": "PVLSCGEWQL",
                    "unpairedMsa": "",
                    "pairedMsa": "",
                    "templates": [],
                }
            }
        ],
    }
]

parameters = {
    "output_dir": STORAGE_OUTPUT_DIR,
    "run_data_pipeline": False,
}

# Execute Prediction
response = endpoint.predict(
    instances=instances,
    parameters=parameters,
    timeout=3600.0,
)

print(response.predictions)
Untuk mengetahui spesifikasi mendetail, parameter entity, dan metrik keyakinan output, lihat dokumentasi AlphaFold 3 di GitHub.
Output prediksi
Layanan prediksi AlphaFold 3 menyediakan dua mekanisme pengiriman pelengkap untuk mengambil output prediksi. Secara default, respons API menampilkan hasil prediksi secara inline dan sinkron, untuk kandidat dengan peringkat teratas. Secara opsional, Anda dapat menentukan direktori Cloud Storage.
Bagian berikut memberikan ringkasan output prediksi. Untuk detail tambahan, lihat dokumentasi AlphaFold 3 di GitHub untuk mengetahui detail tambahan.
Respons inline versus artefak tersimpan
Layanan prediksi AlphaFold 3 mendukung dua pola output utama:
- Respons inline: Menampilkan koordinat struktur 3D dan metrik keyakinan hanya untuk kandidat peringkat teratas langsung dalam payload respons HTTP REST. Hal ini ideal untuk pembuatan prototipe interaktif cepat atau kueri urutan tunggal.
- Artefak Tersimpan (Cloud Storage): Menentukan direktori output akan mengekspor set data multisampel lengkap ke Cloud Storage. Ini mencakup file koordinat individual, JSON keyakinan, distogram, embedding, dan metrik ringkasan untuk setiap seed acak dan sampel difusi yang dihasilkan. Penggunaan Cloud Storage direkomendasikan untuk workload produksi, pemetaan ensemble konformasi, dan mengabaikan batas ukuran payload permintaan.
Berikut adalah contoh Python tentang cara mengambil artefak yang disimpan dari Cloud Storage untuk analisis downstream:
from google.cloud import storage

BUCKET_NAME = "your-bucket-name"
JOB_NAME = "my_alphafold_job"
STORAGE_PREFIX = f"af3_results/my_folder/{JOB_NAME}"

# Initialize Cloud Storage client
client = storage.Client(project="your-project-id")
bucket = client.bucket(BUCKET_NAME)

# Download the top-ranked 3D structure and global ranking ledger
bucket.blob(f"{STORAGE_PREFIX}/{JOB_NAME}_model.cif").download_to_filename("model.cif")
bucket.blob(f"{STORAGE_PREFIX}/{JOB_NAME}_ranking_scores.csv").download_to_filename("ranking_scores.csv")
bucket.blob(f"{STORAGE_PREFIX}/{JOB_NAME}_summary_confidences.json").download_to_filename("summary.json")
Karena AlphaFold 3 menggunakan model difusi generatif, setiap eksekusi prediksi menghasilkan ansambel struktur 3D kandidat di seluruh seed dan lintasan pengambilan sampel. Mengevaluasi dan membandingkan kandidat eksekusi ini dapat membantu menafsirkan output prediksi sebelum melakukan analisis struktural yang mendetail.
Anda dapat menyelidiki set data artefak multi-sampel lengkap menggunakan tiga file inti:
ranking_scores.csv: Ledger utama yang mencantumkan setiap pasangan lintasan yang dihasilkan danranking_scorekompositnya. Baris disimpan dalam urutan eksekusi lintasan (diurutkan berdasarkan seed menaik, lalu indeks sampel menaik), bukan diurutkan terlebih dahulu berdasarkan skor. Pengguna harus mengurutkan berdasarkanranking_scoresecara menurun untuk mengidentifikasi peringkat kandidat.summary_confidences.json: Berisi metrik kualitas global (pTM,ipTM,has_clash,fraction_disordered) untuk kandidat teratas.summary_confidences.jsonPer Sampel: Terletak di dalam setiap folderseed-{SEED}_sample-{INDEX}/, sehingga Anda dapat memeriksa matriks pTM dan ipTM tingkat rantai untuk operasi kandidat non-teratas tertentu jika diperlukan.
Contoh Python berikut mengurai ranking_scores.csv dan
summary_confidences.json untuk memberi peringkat sampel kandidat dan memvalidasi kualitas kandidat
teratas:
import csv
import json

print("=== Candidate Samples Ledger (ranking_scores.csv) ===")
with open("ranking_scores.csv", "r", newline="", encoding="utf-8") as f:
    rows = sorted(
        csv.DictReader(f), key=lambda x: float(x["ranking_score"]), reverse=True
    )

# Calculate column widths cleanly and readably
headers = list(rows[0].keys())
widths = {}
for col in headers:
    lengths = [len(col)] + [len(r[col]) for r in rows]
    widths[col] = max(lengths)

print("  ".join(col.rjust(widths[col]) for col in headers))
for r in rows:
    print("  ".join(r[col].rjust(widths[col]) for col in headers))

top = rows[0]
print(
    f"\nPromoted Top Candidate: Seed {int(top['seed'])}, Sample"
    f" {int(top['sample'])} (Score: {float(top['ranking_score']):.4f})"
)

print("\n=== Top Candidate Quality Validation (summary.json) ===")
with open("summary.json", "r", encoding="utf-8") as f:
    summary = json.load(f)

clash_str = (
    "DETECTED (FAIL)" if summary.get("has_clash") else "None Detected (PASS)"
)
print("Top Candidate Metrics:")
print(f"  • Ranking Score : {summary.get('ranking_score', 'N/A')}")
print(f"  • Global pTM    : {summary.get('ptm', 'N/A')}")
print(f"  • Interface ipTM: {summary.get('iptm', 'N/A')}")
print(f"  • Steric Clash  : {clash_str}")
Untuk mengetahui spesifikasi skema lengkap file yang disimpan dan atribut mmCIF, lihat dokumentasi AlphaFold 3 di GitHub. Selain itu, lihat panduan Cara menilai kualitas prediksi AlphaFold 3 di EMBL-EBI untuk memahami cara menilai kualitas prediksi.
Praktik terbaik
Bagian berikut menjelaskan praktik terbaik saat menggunakan AlphaFold 3 di Agent Platform:
Mengurangi waktu tunggu permintaan
Endpoint di Agent Platform menerapkan waktu tunggu eksekusi maksimum default selama 60 menit per permintaan. Untuk memastikan prediksi Anda berhasil diselesaikan tanpa waktu tunggu habis, patuhi panduan berikut:
- Hindari pengambilan sampel berlebihan dalam satu permintaan: Melakukan inisialisasi berbagai seed atau parameter difusi terbalik yang terlalu tinggi dalam satu panggilan API dapat menyebabkan waktu eksekusi melebihi batas 60 menit.
- Dekonstruksi sweep besar: Untuk studi berskala besar, bagi seed dan sweep parameter Anda menjadi beberapa payload prediksi yang lebih kecil dan kirimkan sebagai tugas terpisah. Hal ini juga memanfaatkan kapasitas penskalaan otomatis endpoint Anda.
Mengabaikan penelusuran MSA
Pipeline penelusuran database genetik adalah fase yang paling memakan waktu dalam pipeline AlphaFold. Saat menjalankan prediksi iteratif pada urutan yang sama (seperti, menjalankan pemindaian skrining ligan pada target protein tetap), Anda dapat mengoptimalkan waktu eksekusi secara signifikan dengan mengabaikan penelusuran database sepenuhnya:
- Ekstrak MSA: Jalankan prediksi end-to-end awal dengan direktori output Cloud Storage (
output_dir) yang ditentukan. Download file{JOB_NAME}_data.jsonyang dihasilkan dari bucket Cloud Storage output. - Mengirimkan prediksi khusus inferensi: Temukan kolom
unpairedMsadanpairedMsadi dalam file JSON. Ekstrak string MSA ini dan teruskan ke permintaan prediksi berikutnya menggunakanunpairedMsaPathdanpairedMsaPathyang mengarah ke URI Cloud Storage.
Atau, Anda dapat menjalankan penelusuran MSA di infrastruktur Anda sendiri dan memasukkan template MSA yang telah dihitung sebelumnya dalam permintaan prediksi.
Menangani eksekusi dengan keyakinan rendah
Jika output prediksi menghasilkan metrik keyakinan rendah, Anda dapat mencoba melakukan perbaikan yang ditargetkan, alih-alih menganggapnya sebagai kegagalan prediksi yang tidak dapat dipulihkan. Mengoptimalkan parameter tertentu memungkinkan Anda menyelidiki lintasan laten alternatif. Bagian ini mencantumkan beberapa pendekatan untuk memulihkan jika prediksi memiliki keyakinan rendah.
Menggunakan pengambilan sampel multi-seed
AlphaFold 3 menginisialisasi pembuatan koordinat 3D dari derau acak di ruang laten. Saat prediksi dikirimkan dengan satu seed tertentu, lintasan difusi mungkin mengikuti jalur yang berbeda dibandingkan dengan seed lain. Meneruskan array seed akan memaksa model untuk mengambil sampel lintasan yang dimulai dari status yang berbeda.
Pengambilan sampel multi-seed memberikan dua keuntungan penting: memverifikasi konsistensi struktural di seluruh eksekusi independen dan menyelidiki dinamika konformasi fungsional. Misalnya, jika kelima seed konvergen ke koordinat 3D yang identik, Anda dapat memiliki keyakinan tinggi pada lipatan global. Sebaliknya, jika seed yang berbeda menghasilkan pose pengikatan yang berbeda dan sangat meyakinkan, ansambel tersebut mungkin mengungkapkan status konformasi yang bermakna secara biologis, seperti loop situs aktif terbuka versus tertutup atau dimer yang ditukar domain alternatif.
Memperluas lintasan difusi
Meskipun modelSeeds mengubah status derau awal di ruang laten, parameter
num_diffusion_samples (default 5) mengontrol jumlah struktur 3D kandidat
yang dihasilkan per seed selama proses difusi terbalik. Untuk
region loop fleksibel atau kantong pengikatan dangkal, peningkatan pengambilan sampel akan memperluas
kumpulan kandidat untuk setiap seed. Hal ini sangat efektif jika skor keyakinan lokal menurun dalam loop tertentu (pLDDT < 70), sementara lipatan domain secara keseluruhan tetap meyakinkan (pTM > 0,80). Hal ini dapat membantu menemukan struktur kandidat dengan keyakinan tinggi yang mungkin terlewat dalam proses awal.
Meningkatkan iterasi daur ulang
Sebelum modul difusi menghasilkan koordinat 3D, AlphaFold 3
memproses fitur urutan dan berpasangan. Parameter num_recycles menentukan
berapa kali representasi struktur perantara dan embedding spasial berpasangan
dimasukkan secara berulang kembali melalui jaringan.
Untuk molekul kompleks yang besar, atau target dengan sinyal ko-evolusi yang lemah,
peningkatan num_recycles memberikan iterasi tambahan pada jaringan trunk untuk
menyelesaikan hubungan spasial antara rantai yang jauh sebelum meneruskan input ke
modul difusi. Pendekatan ini dapat dicoba saat matriks PAE di luar diagonal
menunjukkan ketidakpastian antar-rantai yang tinggi (> 15 Å) meskipun rantai individual
menunjukkan keyakinan lipatan lokal yang tinggi (pLDDT > 70). Perhatikan bahwa meningkatkan daur ulang akan meningkatkan runtime prediksi secara linear, sehingga harus disediakan untuk target antarmuka yang sulit.
Menggunakan pipeline penyelarasan kustom
AlphaFold 3 secara otomatis menjalankan pipeline penelusuran database genetik
untuk menghasilkan template MSA. Pengguna juga dapat menyediakan penyelarasan kustom, pribadi, dan yang telah dihitung sebelumnya dalam format .a3m menggunakan Cloud Storage URI menggunakan unpairedMsaPath dan pairedMsaPath. Menyediakan MSA yang mendalam memberikan batasan ko-evolusi yang kuat, yang sering kali mengubah prediksi dengan keyakinan rendah menjadi model dengan keyakinan tinggi.