


AlphaFold 3 הוא מודל למידה עמוקה שפותח על ידי Google DeepMind ו-Isomorphic Labs. הוא נועד לחזות את המבנים התלת-ממדיים ואת האינטראקציות של חלבונים, DNA, RNA, ליגנדים ויונים. במאמר הזה מוסבר איך לפרוס את המודל AlphaFold 3 ולהשתמש בו באמצעות Model Garden ב-Gemini Enterprise Agent Platform.
יכולות עיקריות
פריסת AlphaFold 3 ב-Agent Platform מספקת את היכולות הבאות, שנדרשות לתהליכי עבודה מתקדמים של מחקר ופיתוח (מו"פ) וגילוי תרופות מסחריות:
שימוש מסחרי: אפשר להשתמש ב-AlphaFold 3 ב-Model Garden למטרות מסחריות.
ליגנדים שרירותיים בהתאמה אישית: מודל AlphaFold 3 תומך בקיפול משותף מאוחד של חלבונים, דנ"א ורנ"א, לצד ליגנדים בהתאמה אישית שמוגדרים באמצעות מחרוזות SMILES או קודים של CIF Chemical Component Dictionary (CCD).
גמישות בתהליך העבודה: AlphaFold 3 ב-Model Garden תומך בתהליך קיפול מלא מקצה לקצה (שמשלב חיפוש במסד נתונים וחיזוי מודלים) או במצב של הסקת מסקנות בלבד, שבו אתם יכולים לספק התאמות MSA שחושבו מראש כדי לשפר את זמן הביצוע ואת השימוש ב-GPU.
לתשומת ליבכם
כשאתם בודקים את AlphaFold 3 לעומסי עבודה, חשוב לזכור את המגבלות הבאות:
בו-זמניות: נקודת הקצה של AlphaFold 3 מוגבלת לחישוב אחד בו-זמנית לכל צומת. כדי להגדיל את מספר הפעולות בו-זמנית, אפשר להרחיב את נקודות הקצה לכמה צמתים. אם נשלחת בקשת חיזוי בזמן שחיזוי אחר פועל, נקודת הקצה דוחה את הבקשה החדשה עם שגיאת
HTTP 429 Too Many
Requests
אם מספר הבקשות גדול ממספר הצמתים.מגבלות טוקנים: משך החיזוי המקסימלי בנקודות הקצה של Agent Platform הוא 60 דקות. בגלל התקורה המשתנה של חיפוש MSA, גודל הרצף המקסימלי שנתמך ב-GPU מסוג A3 הוא בערך 4,500 טוקנים ביולוגיים (כמו חומצות אמינו, נוקלאוטידים או אטומי ליגנד). כשמספקים מערכים שחושבו מראש, המערכת עוקפת את החיפוש ב-MSA, מה שמאפשר קיפול מורכב עד למגבלת החומרה של כ-5,400 טוקנים.
מגבלות על המטען הייעודי (payload): בקשות REST רגילות לחיזוי מוגבלות לגודל של 8MB. אם אתם משתמשים במצב הסקה בלבד, צריך להפנות למערכים גדולים שחושבו מראש (קובצי
.a3m) באמצעות מזהי URI של Cloud Storage, במקום להטמיע אותם כמחרוזות מוטבעות, כדי למנוע דחייה של המטען הייעודי (payload).הגדרת הרשת: מכיוון שחיזויים הם פעולות ארוכות שיכולות להימשך עד 60 דקות, כדאי לפרוס את נקודת הקצה רק באמצעות Private Service Connect (PSC) כדי לעקוף את מגבלות הזמן הקצוב לתפוגה של נקודת קצה רגילה (10 דקות).
הוראות פריסה
בקטע הזה מוסבר איך פורסים את AlphaFold 3 בנקודת קצה (endpoint) שסופקה על ידי Agent Platform בפרויקט ב- Google Cloud .
לפני שמתחילים
לפני שפורסים את AlphaFold 3, צריך:
- בקשת גישה למודל.
- לרכוש משאבי GPU.
- מגדירים את ההרשאות הנדרשות לניהול זהויות והרשאות גישה (IAM):
- יוצרים חשבון שירות עם התפקיד אדמין של פלטפורמת הסוכנים ב-IAM.
- מוודאים שלחשבון המשתמש ב-IAM יש את התפקיד
roles/iam.serviceAccountCreatorכדי לפעול כחשבון השירות בזמן פריסת המודל.
- בודקים את מכסות המשאבים.
משאבים נדרשים
כדי להשתמש ב-AlphaFold 3 צריך מכונה וירטואלית (VM) מסוג a3-highgpu-1g.
לפני הפריסה, ודאו שבפרויקט ב- Google Cloud יש מספיק מכסה באזור היעד של הפריסה למשאבים הבאים:
מאיצים: לפחות סוג מכונה אחד של
a3-highgpu-1g.SSD מקומי: המכונה הווירטואלית מסוג A3 מוקצית עם שטח של 750GB ב-SSD מקומי. הוא נדרש כדי לשמור במטמון באופן קבוע את מסדי הנתונים של רצפי העזר (UniProt, MGnify, Rfam), וכך לאפשר קריאות עם זמן אחזור קצר במהלך חיפושים במסדי נתונים גנטיים (Jackhmmer/Nhmmer) בכל בקשות החיזוי.
קטגוריה של Cloud Storage
כדי להשתמש ב-AlphaFold 3, צריך קטגוריה של Cloud Storage שבה מאוחסנים קובצי ה-MSA שסופקו, ושאליה אפשר לייצא את הפלטים המלאים של החיזויים. כדי להימנע מהעברות בין אזורים, מומלץ להשתמש בקטגוריה של Cloud Storage באותו אזור של נקודת הקצה, או להשתמש בקטגוריה במספר אזורים.
תפקידים בניהול זהויות והרשאות גישה (IAM)
מגדירים את התפקידים הבאים בזהויות המשתתפות:
מנהל פריסת המודל (נקרא גם אדמין ממחלקת IT): הזהות שפורסת את המודל צריכה את ההרשאה
roles/aiplatform.adminכדי ליצור נקודות קצה ולנהל את הפריסות.זהות להצגה: כשמריצים הסקה, נקודות הקצה של AlphaFold 3 כותבות מבני פלט ישירות ל-Cloud Storage באמצעות חשבון השירות של פרויקט הדייר (tenant). לחשבון השירות התואם נדרשת ההרשאה
roles/storage.objectUserבקטגוריית היעד של Cloud Storage.משתמשי מודלים: החשבונות שמתחילים תחזיות צריכים לעמוד בדרישות הבאות:
-
roles/aiplatform.userכדי לשלוח בקשות חיזוי לנקודת הקצה. roles/storage.objectUserכדי לגשת לפלטים של החיזוי בקטגוריה של Cloud Storage.
-
פריסת AlphaFold 3
פורסים את AlphaFold 3 באופן פרוגרמטי באמצעות Agent Platform SDK, כסביבה ייעודית ל-Google Cloud או כנקודת קצה של Private Service Connect בלבד. יכול להיות שיעברו 10-15 דקות עד שנקודת הקצה תהיה מוכנה להסקה, בהתאם לזמינות של ה-GPU.
הדוגמה הבאה היא קטע קוד ב-Python שמראה איך לפרוס את המודל בפרויקט Google Cloud , כולל הארכה של זמן הקצוב לתפוגה של ההסקה:
import google.auth
from google.auth.transport.requests import AuthorizedSession
import vertexai
from vertexai import model_garden

PROJECT_ID = "YOUR_PROJECT_ID"
LOCATION = "us-west1"
MODEL_ID = "google/alphafold3@v3_0_4"
MACHINE_TYPE = "a3-highgpu-1g"

vertexai.init(project=PROJECT_ID, location=LOCATION)

# 1. Deploy Model Garden OpenModel to Dedicated Endpoint
af3_model = model_garden.OpenModel(MODEL_ID)
endpoint = af3_model.deploy(
    endpoint_display_name="af3-dedicated-ep",
    model_display_name="af3-on-mg",
    machine_type=MACHINE_TYPE,
    accelerator_type="NVIDIA_H100_80GB",
    accelerator_count=1,
    reservation_affinity_type="ANY_RESERVATION",
    use_dedicated_endpoint=True,
    accept_eula=True,
    min_replica_count=1,
    max_replica_count=1,
    serving_container_deployment_timeout=3600,
)

# 2. Update inference timeout to 3,600 seconds
credentials, _ = google.auth.default(
    scopes=["https://www.googleapis.com/auth/cloud-platform"]
)
session = AuthorizedSession(credentials)
url = f"https://{LOCATION}-aiplatform.googleapis.com/v1/{endpoint.resource_name}:update"
payload = {
    "endpoint": {
        "name": endpoint.resource_name,
        "clientConnectionConfig": {
            "inferenceTimeout": {
                "seconds": 3600
            }
        }
    }
}
response = session.post(url, json=payload)
response.raise_for_status()
print(f"Endpoint Resource Name: {endpoint.resource_name}")
מאמרי העזרה של ה-API
בקטע הזה מתוארים מיקום נקודת הקצה, פורמט כתובת ה-URL, הפרמטרים של הנתיב והסכימה של המטען הייעודי (payload) של הבקשה.
בקשת HTTP
POST https://HOST/v1/projects/PROJECT_ID/locations/LOCATION/endpoints/ENDPOINT_ID:predict
מחליפים את מה שכתוב בשדות הבאים:
HOST: המארח של נקודת הקצה של השירות. זה תלוי בסוג הפריסה: נקודת קצה ציבורית ייעודית או Private Service Connect.
PROJECT_ID: מזהה הפרויקט ב- Google Cloud שמארח את נקודת הקצה שנפרסה.
LOCATION: האזור ב- Google Cloud שבו נפרסה נקודת הקצה (למשלus-central1).
ENDPOINT_ID: המזהה הייחודי של נקודת הקצה שנפרסה ב-Agent Platform.
גוף הבקשה
גוף הבקשה מכיל נתונים במבנה ה-JSON הבא:
{
  "instances": [
    {
      # The AlphaFold 3 input JSON - see the input documentation at
      # https://github.com/google-deepmind/alphafold3/blob/main/docs/input.md
    }
  ],
  "parameters": {
    "output_dir": "string",
    "dry_run": boolean,
    "run_data_pipeline": boolean,
    "force_output_dir": boolean,
    "resolve_msa_overlaps": boolean,
    "max_template_date": "string",
    "conformer_max_iterations": integer,
    "fix_standalone_glycans": boolean,
    "flash_attention_implementation": "string",
    "num_recycles": integer,
    "num_diffusion_samples": integer,
    "save_embeddings": boolean,
    "save_distogram": boolean,
    "compress_large_output_files": boolean,
    "num_seeds": integer
  }
}
שדות של בקשה ברמה העליונה
| שדה | סוג | תיאור |
|---|---|---|
instances |
array |
חובה. רשימת ההגדרות של הרצפים הביולוגיים לחיזוי. הרשימה הזו חייבת להכיל רכיב אחד בדיוק. אם מעבירים אפס רכיבים או יותר מרכיב אחד, מתקבלת שגיאת HTTP 422 Unprocessable
Entity. גוף הבקשה instances צריך לציין את הקלט בהתאם למפרט שפורסם ב
מסמכי התיעוד של AlphaFold 3.
|
parameters |
object |
אופציונלי. אובייקט שמכיל פרמטרים של הפעלה כדי להגדיר את הפעלת החיזוי (למשל dry_run, output_dir).
|
פרמטרים
מגדירים את דגלי ההפעלה של AlphaFold 3.
| שדה | סוג | ערך ברירת המחדל | תיאור |
|---|---|---|---|
dry_run |
boolean |
false |
אופציונלי. אם הערך הוא true, ה-API מבצע אימות של הבקשה אבל מדלג על הפעלת המודל ומחזיר מיד תשובה ריקה. הוא שימושי לבדיקות קישוריות ותחביר.
|
run_data_pipeline |
boolean |
true |
אופציונלי. אם הערך הוא true, מפעיל את כל הצינור (חיפוש MSA והסקה). אם הערך הוא false, המערכת מריצה רק הסקה (מדלגת על חיפוש במסד הנתונים, נדרשים MSA שחושבו מראש). פרטים נוספים זמינים ב
מאמרי העזרה ב-GitHub.
|
output_dir |
string |
null |
אופציונלי. ה-URI של Cloud Storage (למשל gs://bucket/path) שאליו מועלים קובצי הפלט הגולמיים המלאים (כולל מבני CIF, PAE וקובצי CSV של דירוג) אחרי שההרצה מסתיימת בהצלחה.
|
force_output_dir |
boolean |
false |
אופציונלי. אם הערך הוא true, אפשר להחליף קבצים קיימים ב-output_dir שצוין. אם false, ה-API מחזיר מיד שגיאת HTTP 400 Bad Request אם הנתיב של Cloud Storage לא ריק, כדי למנוע אובדן נתונים מקרי.
|
resolve_msa_overlaps |
boolean |
true |
אופציונלי. אם לבטל כפילויות של הסכמי MSA לא משויכים לעומת הסכמי MSA משויכים. כדי לקבל מידע על השיטות המומלצות, כדאי לעיין בהנחיות במסמכי התיעוד של AlphaFold 3 ב-GitHub. |
max_template_date |
string |
null |
אופציונלי. תאריך ההשקה המקסימלי של התבנית שצריך להביא בחשבון, בפורמט YYYY-MM-DD (למשל, "2024-05-15"). אם הפורמט שגוי, האימות נכשל ומוצגת השגיאה HTTP 422.
|
conformer_max_iterations |
integer |
null |
אופציונלי. שינוי של המספר המקסימלי של איטרציות להרצה בחיפוש הקונפורמר של RDKit. הערך חייב להיות מספר שלם לא שלילי (גדול מ-0 או שווה לו). האימות נכשל עם השגיאה HTTP 422 אם הערכים שליליים.
|
fix_standalone_glycans |
boolean |
false |
אופציונלי. הפעלת תיקון מיקום עצמאי של גליקן. |
flash_attention_implementation |
string |
null |
אופציונלי. הטמעת הקצה העורפי של Flash Attention לשימוש. הערכים המותרים הם "triton", "cudnn", "xla".
|
num_recycles |
integer |
10 |
אופציונלי. מספר חזרות המיחזור שבהן צריך להשתמש במהלך ההסקה. הערך חייב להיות מספר שלם חיובי (גדול מאפס). בקטע בנושא שיטות מומלצות מוסבר על היתרונות והחסרונות. |
num_diffusion_samples |
integer |
5 |
אופציונלי. מספר דגימות הדיפוזיה שייווצרו. הערך חייב להיות מספר שלם חיובי (גדול מאפס). בקטע בנושא שיטות מומלצות מוסבר על היתרונות והחסרונות. |
save_embeddings |
boolean |
false |
אופציונלי. אם לשמור את ההטמעות הסופיות של זוגות ושל פריטים בודדים במיקום של output_dir. אם true, ההטמעות נכתבות כקובצי .npz בתיקיית משנה בשם seed-{SEED}_embeddings/ (לדוגמה, outputs_config_job_seed-50_embeddings.npz).
|
save_distogram |
boolean |
false |
אופציונלי. האם לשמור את הדיסטוגרמה החזויה הסופית במיקום output_dir. אם הערך הוא true, ההטמעות נכתבות כקובצי .npz בתיקיית משנה בשם seed-{SEED}_embeddings/ (לדוגמה, outputs_config_job_seed-50_embeddings.npz).
|
compress_large_output_files |
boolean |
false |
אופציונלי. אם הערך הוא true, קובצי הפלט הגדולים (מבני mmCIF וקובצי JSON של רמות סמך) נדחסים באמצעות zstandard. הפקודה הזו יוצרת קבצים עם הסיומות .cif.zst ו-.json.zst במקום .cif ו-.json. קבצים קטנים (כמו
ranking_scores.csv) לא נדחסים.
|
num_seeds |
integer |
null |
אופציונלי. מספר ה-seeds האקראיים שבהם צריך להשתמש להסקת מסקנות. באופן כללי, כדאי להגדיר ערכי seed בשדה instances.modelSeeds כדי לאפשר שחזור. בקטע בנושא שיטות מומלצות מוסבר על היתרונות והחסרונות.
|
תשובה (פלט)
בקטע הזה מתוארים השדות שמוחזרים בתגובה מה-API אחרי הפעלה מוצלחת.
גוף התשובה
אם הפעולה בוצעה בהצלחה, נקודת הקצה מחזירה את התשובה בפורמט הסכימה הרגיל של Agent Platform לחיזוי אונליין:
{
  "deployedModelId": "string",
  "model": "string",
  "modelDisplayName": "string",
  "modelVersionId": "string",
  "predictions": [
    {
      "structure_cif": "string",
      "plddt": [
        number
      ],
      "pae": [
        [
          number
        ]
      ],
      "summary": {
        "ptm": number,
        "iptm": number,
        "fraction_disordered": number,
        "has_clash": boolean,
        "ranking_score": number,
        "chain_pair_pae_min": [
          [
            number
          ]
        ],
        "chain_pair_iptm": [
          [
            number
          ]
        ],
        "chain_ptm": [
          number
        ],
        "chain_iptm": [
          number
        ],
        "chain_ids": [
          string
        ]
      },
      "output_dir": "string"
    }
  ]
}
שדות תגובה ברמה העליונה
| שדה | סוג | תיאור |
|---|---|---|
deployedModelId |
string |
המזהה של המודל שנפרס בנקודת הקצה של Agent Platform. |
model |
string |
שם המשאב המלא של המודל. |
modelDisplayName |
string |
השם המוצג של המודל שנפרס (תמיד "alphafold3").
|
modelVersionId |
string |
מזהה הגרסה של המודל שנפרס. |
predictions |
array |
רשימת תוצאות החיזוי. ב-AlphaFold 3, המערך הזה מכיל בדיוק אובייקט אחד של תוצאת חיזוי. |
פרטי תוצאות החיזוי (predictions[])
נקודת הקצה (endpoint) לחיזוי של AlphaFold 3 מחזירה תשובת JSON מסוג HTTP 200 שמכילה מערך predictions עם קואורדינטות מבניות ומדדי סמך למועמד שקיבל את הדירוג הגבוה ביותר. הגדרות מקיפות של השדות ומפרטים של קובצי הפלט מופיעים במסמכי התיעוד הרשמיים של AlphaFold 3 ב-GitHub.
מבנה הפלט בתגובה מה-API יכול להשתנות בהתאם לערך של parameters.output_dir בבקשה:
חיזוי בתגובת HTTP: התגובה שמוטמעת בקוד מחזירה מדדי סיכום גלובליים (
summary), קואורדינטות של מבנה תלת-ממדי (structure_cif), ציוני מהימנות לכל אטום (plddt) ומטריצת Predicted Aligned Error דו-ממדית (pae) ישירות בתוך גוף המטען הייעודי (payload) של תגובת ה-JSON ב-HTTP. כשמציינים ספריית פלט, שדות גדולים של מטען ייעודי (structure_cif,plddtו-pae) מושמטים (null) מהמטען הייעודי של תגובת ה-HTTP כדי למנוע צווארי בקבוק בסריאליזציה. במקום זאת, כל הפלט הגולמי של המודל מיוצא באופן אסינכרוני לקטגוריה של Cloud Storage שצוינה.פריט מידע שנוצר ונשמר בקטגוריה של Cloud Storage: כשמציינים ספריית פלט (
parameters.output_dir), תוצאות החיזוי המקיפות מועלות ל-Cloud Storage. תיקיית הפלט מכילה נתונים בהתאם למפרט שפורסם במסמכי התיעוד של AlphaFold 3 ב-GitHub.
יצירת תחזיות
הפריסה של Model Garden מפשטת את ההפעלה של צינור עיבוד נתונים מקצה לקצה לחיזוי, כולל צינור עיבוד נתונים והסקת מסקנות מהמודל בקריאה אחת ל-API. בתרשים הבא מוצגת הארכיטקטורה הכללית של החיזויים ב-AlphaFold 3:
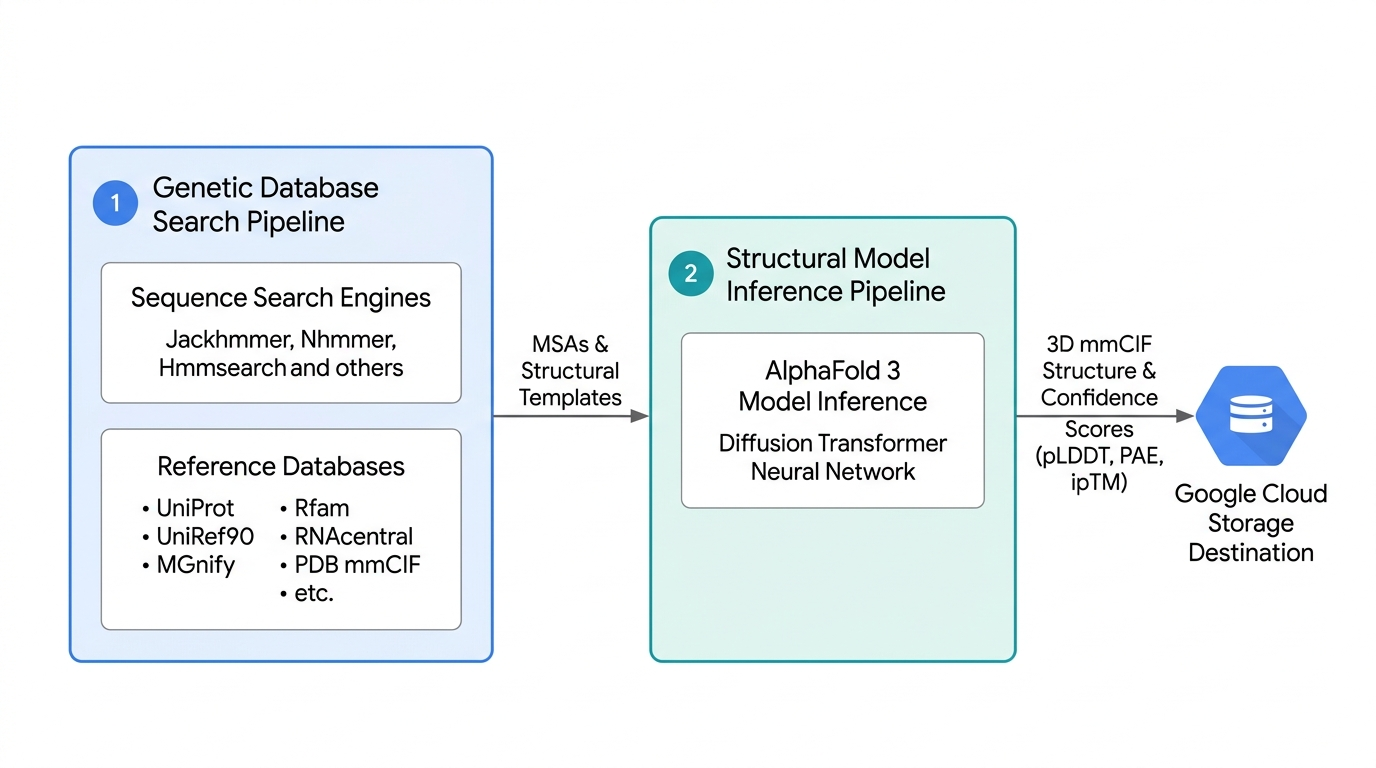
איור 1. תהליך חיזוי מלא
כשמריצים חיזויים, מומלץ מאוד לספק קטגוריה של Cloud Storage ישירות בפרמטרים כדי לייצא את מערך הנתונים הגולמי המלא, כולל ספריות משנה לכל דגימה, מניפסטים של דירוג ופלט גולמי. במאמרי העזרה של ה-API מפורטים כל השדות שאפשר להגדיר בבקשה, כולל כוונון פרמטרים לדגימה מרובת-זרעים, מיחזור עצבי, מסלולי דיפוזיה וקשרים קוולנטיים בהתאמה אישית.
לפני שמתחילים משימות קיפול או צינורות עיבוד נתונים באצווה שנמשכים זמן רב, אפשר לבצע הרצה על יבש כדי לאמת במהירות את האימות, את הרשאות ה-IAM ואת הקישוריות של נקודת הקצה לרשת.
אפשרויות חיזוי
בהתאם לתהליך העבודה, אפשר לארגן את העיבוד של AlphaFold 3 בארבעה מצבי הפעלה נפרדים:
- מצב פרימטר לבדיקות
- מצב חיזוי מקצה לקצה
- הסקה בלבד עם תבניות ו-MSA שחושבו מראש
- הפעלת קמפיינים ללא הסכם MSA וללא תבניות
מצב פרימטר לבדיקות
כדי לאמת את הקישוריות ל-API, האימות, הרשת והסכימות של JSON בלי להפעיל את צינור עיבוד הנתונים של החיזוי, אפשר לשלוח בקשה עם "dry_run":
true באובייקט parameters. נקודת הקצה מבצעת את כל שגרות האימות (כולל בדיקת הרשאות הכתיבה בקטגוריה של Cloud Storage ואימות תווי הרצף), אבל מדלגת על הביצוע ומחזירה מיד תגובת חיזוי ריקה.
הסקריפט הבא ב-Python הוא דוגמה למצב פרימטר לבדיקות:
from google.cloud import aiplatform

PROJECT_ID = "YOUR_PROJECT_ID"
LOCATION = "us-west1"
ENDPOINT_ID = "YOUR_ENDPOINT_ID"

# Initialize AI Platform SDK
aiplatform.init(project=PROJECT_ID, location=LOCATION)

# Connect to Dedicated Endpoint
endpoint = aiplatform.Endpoint(ENDPOINT_ID)

# Define prediction payload
instances = [
    {
        "name": "preflight_check",
        "dialect": "alphafold3",
        "version": 4,
        "modelSeeds": [1],
        "sequences": [
            {
                "protein": {
                    "id": "A",
                    "sequence": "PVLSCGEWQL",
                }
            }
        ],
    }
]

parameters = {
    "dry_run": True,
}

# Execute prediction request
response = endpoint.predict(
    instances=instances,
    parameters=parameters
)
print(response.predictions)
מצב חיזוי מקצה לקצה
כדי להריץ חיזוי מקצה לקצה, שולחים רצפים ביולוגיים גולמיים (חלבונים, DNA, RNA, ליגנדים ו-PTM) בבקשה אחת. נקודת הקצה מבצעת באופן אוטומטי חיפוש במסד נתונים גנטי, ומיד אחריו הסקת מסקנות מהמודל. מומלץ להשתמש באפשרות הזו למשימות קיפול ללא התאמות קיימות.
הסקריפט הבא ב-Python הוא דוגמה למצב חיזוי מקצה לקצה:
from google.cloud import aiplatform

# Configuration
PROJECT_ID = "YOUR_PROJECT_ID"
LOCATION = "us-west1"
ENDPOINT_ID = "YOUR_ENDPOINT_ID"
STORAGE_OUTPUT_DIR = "gs://YOUR_BUCKET_NAME/alphafold_output/"

# Initialize AI Platform SDK
aiplatform.init(project=PROJECT_ID, location=LOCATION)

# Instantiate Endpoint reference
endpoint = aiplatform.Endpoint(ENDPOINT_ID)

# Define Prediction Payload
instances = [
    {
        "name": "e2e_protein_ligand_complex",
        "dialect": "alphafold3",
        "version": 4,
        "modelSeeds": [1],
        "sequences": [
            {
                "protein": {
                    "id": "A",
                    "sequence": "PVLSCGEWQL",
                    "modifications": [
                        {"ptmType": "HY3", "ptmPosition": 1}
                    ],
                }
            },
            {
                "ligand": {
                    "id": "B",
                    "ccdCodes": ["MG"],
                }
            },
        ],
    }
]

parameters = {
    "output_dir": STORAGE_OUTPUT_DIR,
}

# Execute Prediction
response = endpoint.predict(
    instances=instances,
    parameters=parameters
)

print(response.predictions)
הסקה בלבד עם תבניות ו-MSA שחושבו מראש
יכול להיות שכבר יש לכם תבניות MSA ו-mmCIF שחושבו מראש, מהרצה קודמת או שנוצרו מחוץ לנקודת הקצה של המודל. בתרחישים כאלה, אפשר לעקוף לגמרי את החיפוש במסד הנתונים הגנטי על ידי אספקת ההתאמות והתבניות, וניתוב הבקשה ישירות לחיזוי המבנה. זה גם יכול לקצר משמעותית את זמן התגובה של ההסקה. מומלץ להשתמש בנתיב הזה בתרחישים הבאים:
- כשמבצעים עגינה של כמה ליגנדים שונים של מולקולות קטנות כנגד מטרה סטטית של חלבון יחיד, אפשר להשתמש שוב ב-MSA.
- הרצת אותו רצף מולקולות על פני כמה גרעינים אקראיים, באופן איטרטיבי, כדי למפות את הגמישות המבנית.
- התאמת רצפים אופליין למאגרי מידע גנומיים פרטיים, שאינם ציבוריים.
- אופטימיזציה של משאבי ה-GPU ל-AlphaFold 3, כדי להתמקד רק ביצירת מבנים.
הסקריפט הבא ב-Python הוא דוגמה למצב הסקה בלבד:
from google.cloud import aiplatform

# Configuration
PROJECT_ID = "YOUR_PROJECT_ID"
LOCATION = "us-west1"
ENDPOINT_ID = "YOUR_ENDPOINT_ID"
STORAGE_OUTPUT_DIR = "gs://YOUR_BUCKET_NAME/af3_results/inference_only"

# Initialize AI Platform SDK
aiplatform.init(project=PROJECT_ID, location=LOCATION)

# Instantiate Endpoint reference
endpoint = aiplatform.Endpoint(ENDPOINT_ID)

# Define Prediction Payload
instances = [
    {
        "name": "inference_protein_ligand_complex",
        "dialect": "alphafold3",
        "version": 4,
        "modelSeeds": [1],
        "sequences": [
            {
                "protein": {
                    "id": "A",
                    "sequence": "PVLSCGEWQL",
                    "modifications": [
                        {"ptmType": "HY3", "ptmPosition": 1}
                    ],
                    "unpairedMsaPath": "gs://YOUR_BUCKET_NAME/path/to/unpaired.a3m",
                    "pairedMsa": "",
                    "templates": [],
                }
            },
            {
                "ligand": {
                    "id": "B",
                    "ccdCodes": ["MG"],
                }
            },
        ],
    }
]

parameters = {
    "run_data_pipeline": False,
    "output_dir": STORAGE_OUTPUT_DIR,
    "force_output_dir": True,
}

# Execute Prediction
response = endpoint.predict(
    instances=instances,
    parameters=parameters
)

print(response.predictions)
הפעלת קמפיינים ללא MSA וללא תבניות
יש גם אפשרות לעקוף לגמרי את החיפוש במאגר הנתונים הגנטי ואת ההתאמה לתבנית. המודל חוזה את המבנה התלת-ממדי רק באמצעות רצף השאילתה, בלי רצפים הומולוגיים או מידע על אבולוציה משותפת. כדי להפעיל את המצב הזה, צריך לספק מחרוזות ריקות לפרמטרים של MSA unpairedMsa ו-pairedMsa ורשימה ריקה ל-templates במופע, ולהגדיר את run_data_pipeline ל-false בפרמטרים. האפשרות הזו יכולה להיות שימושית לתכנון מולקולות סינתטיות או מהונדסות, או לבדיקת תחזיות מבניות בהיעדר הקשר אבולוציוני.
הנה דוגמה לסקריפט Python להרצת AlphaFold 3 ללא MSA וללא תבנית:
from google.cloud import aiplatform

# Configuration
PROJECT_ID = "YOUR_PROJECT_ID"
LOCATION = "us-west1"
ENDPOINT_ID = "YOUR_ENDPOINT_ID"
STORAGE_OUTPUT_DIR = "gs://YOUR_BUCKET_NAME/af3_results/inference_only_gcs_job"

# Initialize AI Platform SDK
aiplatform.init(project=PROJECT_ID, location=LOCATION)

# Instantiate Endpoint reference
endpoint = aiplatform.Endpoint(ENDPOINT_ID)

# Define Prediction Payload
instances = [
    {
        "name": "inference_only_gcs_job",
        "dialect": "alphafold3",
        "version": 4,
        "modelSeeds": [1, 2, 3],
        "sequences": [
            {
                "protein": {
                    "id": "A",
                    "sequence": "PVLSCGEWQL",
                    "unpairedMsa": "",
                    "pairedMsa": "",
                    "templates": [],
                }
            }
        ],
    }
]

parameters = {
    "output_dir": STORAGE_OUTPUT_DIR,
    "run_data_pipeline": False,
}

# Execute Prediction
response = endpoint.predict(
    instances=instances,
    parameters=parameters,
    timeout=3600.0,
)

print(response.predictions)
מפרטים מפורטים, פרמטרים של ישויות ומדדי מהימנות של פלט מופיעים במסמכי התיעוד של AlphaFold 3 ב-GitHub.
פלטים של חיזויים
שירות החיזוי של AlphaFold 3 מספק שני מנגנוני מסירה משלימים לאחזור פלטים של חיזוי. כברירת מחדל, התגובה מה-API מחזירה תוצאות חיזוי באופן סינכרוני, למועמד שקיבל את הדירוג הגבוה ביותר. אפשר גם לציין ספרייה ב-Cloud Storage.
בקטע הבא מופיעה סקירה כללית של פלט החיזוי. פרטים נוספים זמינים במסמכי התיעוד של AlphaFold 3 ב-GitHub.
תשובה בתוך השורה לעומת פריטים שנשמרו
שירות החיזוי של AlphaFold 3 תומך בשני דפוסי פלט עיקריים:
- תשובה מוטבעת: מחזירה את הקואורדינטות של המבנה התלת-ממדי ואת מדדי הסמך רק למועמד בדירוג הגבוה ביותר, ישירות בתוך המטען הייעודי (payload) של התשובה ב-HTTP REST. האפשרות הזו אידיאלית ליצירת אב טיפוס אינטראקטיבי מהיר או לשאילתות עם רצף יחיד.
- Saved Artifacts (Cloud Storage): אם מציינים ספריית פלט, מערך הנתונים המלא של כמה דגימות מיוצא ל-Cloud Storage. הנתונים האלה כוללים קובצי קואורדינטות נפרדים, קובצי JSON של רמת סמך, דיסטוגרמות, הטמעות ומדדי סיכום לכל דגימת דיפוזיה וערך אקראי שנוצר. מומלץ להשתמש ב-Cloud Storage לעומסי עבודה בסביבת ייצור, למיפוי של קבוצות קונפורמציה ולעקיפת המגבלה על גודל המטען הייעודי (payload) של הבקשה.
הדוגמה הבאה ב-Python מראה איך לאחזר פריטי מידע שנוצרו בתהליך הפיתוח (Artifact) שנשמרו ב-Cloud Storage, לצורך ניתוח במורד הזרם:
from google.cloud import storage

BUCKET_NAME = "your-bucket-name"
JOB_NAME = "my_alphafold_job"
STORAGE_PREFIX = f"af3_results/my_folder/{JOB_NAME}"

# Initialize Cloud Storage client
client = storage.Client(project="your-project-id")
bucket = client.bucket(BUCKET_NAME)

# Download the top-ranked 3D structure and global ranking ledger
bucket.blob(f"{STORAGE_PREFIX}/{JOB_NAME}_model.cif").download_to_filename("model.cif")
bucket.blob(f"{STORAGE_PREFIX}/{JOB_NAME}_ranking_scores.csv").download_to_filename("ranking_scores.csv")
bucket.blob(f"{STORAGE_PREFIX}/{JOB_NAME}_summary_confidences.json").download_to_filename("summary.json")
AlphaFold 3 משתמש במודל דיפוזיה גנרטיבי, ולכן כל הרצה של חיזוי יוצרת קבוצה של מבנים תלת-ממדיים אפשריים על פני גרעינים ומסלולי דגימה. הערכה והשוואה של הרצות המועמדים האלה יכולות לעזור לפרש את פלטי החיזוי לפני ביצוע ניתוח מבני מפורט.
אתם יכולים לחקור את מערך הנתונים המלא של פריטי המידע שנוצרו על ידי מספר דוגמיות באמצעות שלושה קובצי ליבה:
ranking_scores.csv: ספר החשבונות הראשי שבו מפורטים כל זוגות המסלולים שנוצרו וציון ה-ranking_scoreהמשולב שלהם. השורות נשמרות לפי סדר ההרצה של המסלול (ממוינות לפי ערך Seed בסדר עולה, ואז לפי אינדקס הדגימה בסדר עולה), ולא ממוינות מראש לפי הניקוד. כדי לזהות את הדירוגים של המועמדים, המשתמשים צריכים למיין לפיranking_scoreבסדר יורד.
summary_confidences.json: מכיל מדדי איכות גלובליים (pTM,ipTM,has_clash,fraction_disordered) למועמד המוביל.Per-Sample
summary_confidences.json: נמצא בתוך תיקיותseed-{SEED}_sample-{INDEX}/נפרדות, ומאפשר לבדוק מטריצות pTM ו-ipTM ברמת השרשרת להרצות ספציפיות של מועמדים שלא נמצאים בראש הרשימה, אם צריך.
בדוגמה הבאה ב-Python, מתבצע ניתוח של ranking_scores.csv ו-summary_confidences.json כדי לדרג דוגמאות של מועמדים ולאמת את האיכות של המועמד המוביל:
import csv
import json

print("=== Candidate Samples Ledger (ranking_scores.csv) ===")
with open("ranking_scores.csv", "r", newline="", encoding="utf-8") as f:
    rows = sorted(
        csv.DictReader(f), key=lambda x: float(x["ranking_score"]), reverse=True
    )

# Calculate column widths cleanly and readably
headers = list(rows[0].keys())
widths = {}
for col in headers:
    lengths = [len(col)] + [len(r[col]) for r in rows]
    widths[col] = max(lengths)

print("  ".join(col.rjust(widths[col]) for col in headers))
for r in rows:
    print("  ".join(r[col].rjust(widths[col]) for col in headers))

top = rows[0]
print(
    f"\nPromoted Top Candidate: Seed {int(top['seed'])}, Sample"
    f" {int(top['sample'])} (Score: {float(top['ranking_score']):.4f})"
)

print("\n=== Top Candidate Quality Validation (summary.json) ===")
with open("summary.json", "r", encoding="utf-8") as f:
    summary = json.load(f)

clash_str = (
    "DETECTED (FAIL)" if summary.get("has_clash") else "None Detected (PASS)"
)
print("Top Candidate Metrics:")
print(f"  • Ranking Score : {summary.get('ranking_score', 'N/A')}")
print(f"  • Global pTM    : {summary.get('ptm', 'N/A')}")
print(f"  • Interface ipTM: {summary.get('iptm', 'N/A')}")
print(f"  • Steric Clash  : {clash_str}")
מפרטי סכימה מקיפים של הקבצים השמורים ומאפייני mmCIF מפורטים במסמכי התיעוד של AlphaFold 3 ב-GitHub. כדי להבין איך להעריך את איכות החיזויים, כדאי גם לעיין במדריך How to assess the quality of AlphaFold 3 predictions ב-EMBL-EBI.
שיטות מומלצות
בקטעים הבאים מתוארות שיטות מומלצות לשימוש ב-AlphaFold 3 ב-Agent Platform:
הפחתת הזמן הקצוב לתפוגת הבקשה
בנקודות הקצה ב-Agent Platform, זמן הקצוב המקסימלי לביצוע בקשה הוא 60 דקות כברירת מחדל. כדי לוודא שהחיזויים יושלמו בהצלחה בלי שתחול חריגה מהזמן הקצוב לתפוגה, צריך לפעול לפי ההנחיות הבאות:
- הימנעו מדגימת יתר בבקשה אחת: הפעלת טווח רחב של ערכי seed או פרמטרים גבוהים מדי של דיפוזיה הפוכה בקריאה אחת ל-API עלולה לגרום לכך שזמן הביצוע יחרוג מהמגבלה של 60 דקות.
- פירוק של סריקות גדולות: במחקרים בקנה מידה גדול, פצלו את ה-seeds ואת סריקות הפרמטרים לכמה מטענים ייעודיים (payloads) קטנים יותר של חיזוי, ושלחו אותם כמשימות נפרדות. כך גם אפשר לנצל את יכולות ההתאמה האוטומטית לעומס (autoscaling) של נקודת הקצה.
חיפוש מעקף של MSA
החיפוש בצינור עיבוד הנתונים של מסד הנתונים הגנטי הוא השלב הכי ארוך בצינור עיבוד הנתונים של AlphaFold. כשמריצים חיזויים איטרטיביים על אותו רצף (למשל, הרצת סריקות של ליגנדים על חלבון מטרה קבוע), אפשר לשפר משמעותית את זמני ההרצה על ידי עקיפת החיפוש במסד הנתונים:
- חילוץ ה-MSA: מריצים חיזוי מקצה לקצה עם ספריית פלט של Cloud Storage (
output_dir). מורידים את קובץ ה-{JOB_NAME}_data.jsonשנוצר מקטגוריית הפלט ב-Cloud Storage. - שליחת תחזיות להסקה בלבד: מאתרים את השדות
unpairedMsaו-pairedMsaבקובץ ה-JSON. מחלצים את מחרוזות ה-MSA האלה ומעבירים אותן לבקשות החיזוי הבאות באמצעותunpairedMsaPathו-pairedMsaPathשמצביעים על מזהי ה-URI של Cloud Storage.
לחלופין, אתם יכולים לבצע חיפוש MSA בתשתית שלכם ולהזין את תבניות ה-MSA שחושבו מראש בבקשת החיזוי.
טיפול בהפעלות עם רמת סמך נמוכה
כשהפלט של החיזוי מניב מדדי סמך נמוכים, במקום להתייחס אליו כאל כשל חיזוי שלא ניתן לשחזור, אפשר לנסות לבצע תיקון ממוקד. אופטימיזציה של פרמטרים ספציפיים מאפשרת לכם לבחון מסלולים חלופיים. בקטע הזה מפורטות כמה גישות להתאוששות במקרה של חיזויים ברמת סמך נמוכה.
שימוש בדגימה מכמה מקורות
AlphaFold 3 מתחיל ליצור קואורדינטות תלת-ממדיות מרעש אקראי במרחב לטנטי. כששולחים חיזוי עם גרעין מסוים, מסלול הדיפוזיה עשוי להיות שונה בהשוואה לגרעין אחר. העברת מערך של ערכי seed מאלצת את המודל לדגום מסלולים שמתחילים ממצבים שונים.
לדגימה עם כמה ערכי seed יש שני יתרונות חשובים: היא מאמתת את העקביות המבנית בין הרצות בלתי תלויות, ובוחנת את הדינמיקה של הקונפורמציה הפונקציונלית. לדוגמה, אם כל חמשת הזרעים מתכנסים לקואורדינטות תלת-ממדיות זהות, אז אתם יכולים להיות בטוחים בקיפול הגלובלי. לעומת זאת, אם ערכי Seed שונים מייצרים תנוחות קישור מובחנות ברמת סמך גבוהה, יכול להיות שהאנסמבל חושף מצבים קונפורמטיביים בעלי משמעות ביולוגית, כמו לולאות של אתרים פעילים פתוחים לעומת סגורים או דימרים חלופיים עם החלפת דומיינים.
הרחבת מסלולי הדיפוזיה
הפרמטר modelSeeds משנה את מצב הרעש ההתחלתי במרחב הלטנטי, והפרמטר num_diffusion_samples (ברירת המחדל היא 5) קובע כמה מבנים תלת-ממדיים מועמדים נוצרים לכל ערך seed במהלך תהליך הדיפוזיה ההפוכה. באזורים של לולאות גמישות או כיסי קישור רדודים, הגדלת הדגימה מרחיבה את מאגר המועמדים לכל זרע. השיטה הזו יעילה במיוחד כשציוני המהימנות המקומיים יורדים בלולאות ספציפיות (pLDDT < 70), אבל הקיפול הכולל של הדומיין נשאר מהימן (pTM > 0.80). כך אפשר לגלות מבנים מועמדים ברמת סבירות גבוהה, שאולי פוספסו בהרצה הראשונית.
הגדלת מספר החזרות על המיחזור
לפני שמודול הדיפוזיה יוצר קואורדינטות תלת-ממדיות, AlphaFold 3 מעבד את הרצף ואת המאפיינים של הזוגות. הפרמטר num_recycles קובע כמה פעמים ייצוגים של מבני ביניים והטמעות מרחביות של זוגות מוזנים באופן איטרטיבי בחזרה דרך הרשת.
במולקולות גדולות ומורכבות, או במטרות עם אותות אבולוציוניים חלשים, הגדלת הערך של num_recycles נותנת לרשת הראשית איטרציות נוספות כדי לפתור את היחסים המרחביים בין שרשראות מרוחקות לפני שהיא מעבירה את הקלט למודול הדיפוזיה. אפשר לנסות את הגישה הזו כשמטריצות PAE מחוץ לאלכסון מראות אי-ודאות גבוהה בין השרשראות (> 15 Å), למרות ששרשראות בודדות מראות מהימנות גבוהה של קיפול מקומי (pLDDT > 70). חשוב לזכור שהגדלת מספר המחזורים מאריכה באופן לינארי את זמן הריצה של החיזוי, ולכן כדאי להשתמש בה רק למטרות ממשק קשות.
שימוש בצינור עיבוד נתונים מותאם אישית ליישור
AlphaFold 3 מפעיל באופן אוטומטי את צינור עיבוד הנתונים של החיפוש במסד הנתונים הגנטי כדי ליצור תבניות MSA. המשתמשים יכולים גם לספק מערכים פרטיים, מותאמים אישית ומחושבים מראש בפורמט .a3m באמצעות מזהי URI של Cloud Storage באמצעות unpairedMsaPath ו-pairedMsaPath. הוספת MSA מפורטים מספקת אילוצים חזקים של אבולוציה משותפת, ולעיתים קרובות הופכת תחזיות ברמת סבירות נמוכה למודלים ברמת סבירות גבוהה.