


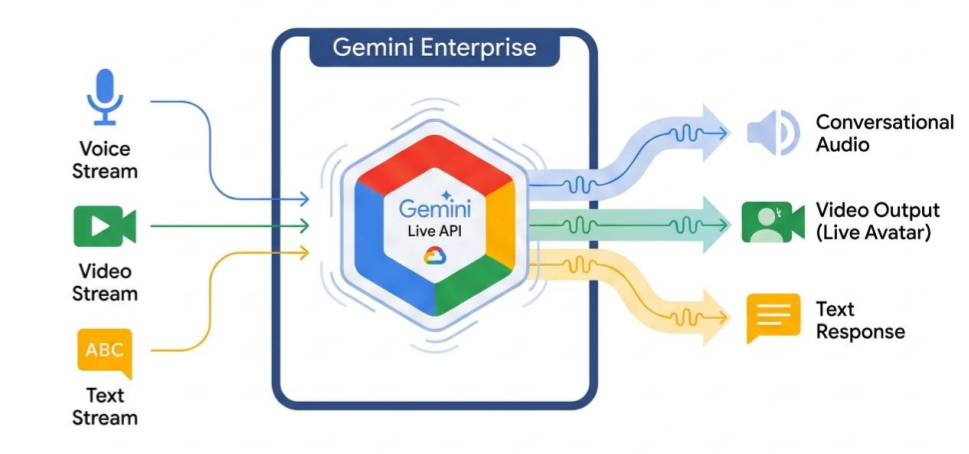
Die Gemini Live API ermöglicht Sprach- und Videointeraktionen mit Gemini in Echtzeit und mit geringer Latenz. Die Funktion verarbeitet kontinuierliche Audio-, Video- oder Textstreams und liefert sofortige, menschenähnliche gesprochene Antworten. So entsteht eine natürliche Konversationserfahrung für Ihre Nutzer. Mit Live-Avataren können Sie mit einem menschenähnlichen Symbol interagieren, das mit den Sprachantworten synchronisiert wird. Das sorgt für eine bessere und persönlichere Nutzererfahrung.
Gemini Live API in Agent Studio testen
Beispielanwendungsfälle
Mit der Gemini Live API können Echtzeit-Sprach- und Video-KI-Agenten für eine Vielzahl von Branchen erstellt werden, darunter:
Markenbotschafter für Unternehmen: Interaktive Markenvertreter, die auf Unternehmens-Web-Properties oder in mobilen Anwendungen eingesetzt werden und auf der Grundlage von autorisierten Mitarbeiterbildern oder bezahlten Talenten mit unterzeichneten Freigabeerklärungen generiert wurden.
E-Commerce und Einzelhandel: Einkaufsassistenten, die personalisierte Empfehlungen geben, und Support-Agenten, die Kundenprobleme lösen.
Gaming: Interaktive Nicht-Spieler-Charaktere (NPCs), In-Game-Hilfeassistenten und Echtzeitübersetzung von In-Game-Inhalten.
Schnittstellen der nächsten Generation: Sprach- und videofähige Funktionen in der Robotik, bei Smart Glasses und in Fahrzeugen.
Gesundheitswesen: Navigationshilfen, die bei der Logistik von Einrichtungen und Pflege unterstützen.
Finanzdienstleistungen: Konversations-Agenten, die alltägliche Bankanfragen bearbeiten.
Bildung: KI-Mentoren und Lernbegleiter, die personalisierte Anleitungen und Feedback geben.
Wichtige Features
Die Gemini Live API bietet eine umfassende Reihe von Funktionen zum Erstellen robuster Sprach- und Video-Agents:
Hohe Audioqualität: Die Gemini Live API bietet natürliche, realistisch klingende Sprache in mehreren Sprachen.
Mehrsprachige Unterstützung: Sie können sich in 24 unterstützten Sprachen unterhalten.
Unterbrechen: Nutzer können das Modell jederzeit unterbrechen, um eine schnelle Antwort zu erhalten.
Empathischer Dialog: Passt den Antwortstil und den Tonfall an die Ausdrucksweise der Nutzereingabe an.
Toolnutzung: Integriert Tools wie Funktionsaufrufe und die Google Suche für dynamische Interaktionen.
Audiotranskriptionen: Stellt Texttranskripte sowohl der Nutzereingabe als auch der Modellausgabe bereit. Wenn Sie die Transkription als Endziel und nicht als Nebenkanal einer Unterhaltung verwenden möchten, finden Sie weitere Informationen unter Gemini 3.5 Transcribe.
Proaktive Audioeingabe: Damit können Sie steuern, wann und in welchen Kontexten das Modell antwortet.
Technische Daten
In der folgenden Tabelle sind die technischen Spezifikationen für die Gemini Live API aufgeführt:
| Kategorie | Details |
|---|---|
| Eingabemodalitäten | Audio (unbearbeitetes 16-Bit-PCM-Audio, 16 kHz, Little Endian), Bilder/Video (JPEG 1 FPS), Text |
| Ausgabemodalitäten | Audio (unverarbeitetes 16-Bit-PCM-Audio, 24 kHz, Little Endian), Text |
| Video (Live-Avatare) | Video (mp4) |
| Protokoll | Zustandsorientierte WebSocket-Verbindung (WSS) |
Unterstützte Modelle
Die folgenden Modelle unterstützen die Gemini Live API. Wählen Sie das passende Modell basierend auf Ihren Interaktionsanforderungen aus.
| Modell-ID | Verfügbarkeit | Anwendungsfall | Wichtige Features |
|---|---|---|---|
gemini-3.8-live |
Allgemein verfügbar | Empfohlen. Sprachagenten mit niedriger Latenz. Unterstützt den nahtlosen Wechsel zwischen mehreren Sprachen. |
|
gemini-live-2.5-flash-native-audio |
Allgemein verfügbar | Empfohlen. Sprachagenten mit niedriger Latenz. Unterstützt den nahtlosen Wechsel zwischen Sprachen und emotionalen Tönen. |
|
gemini-3.5-transcribe-live-preview |
Vorschau | Nur Sprache-zu-Text. Untertitel, Diktat und Anruftranskription in Echtzeit. Gibt Text und kein Audio zurück, sodass keine Unterhaltung geführt wird. |
|
Jetzt starten
Wählen Sie den Leitfaden aus, der Ihrer Entwicklungsumgebung entspricht:
Anleitung zum Gen AI SDK
Stellen Sie mit dem Gen AI SDK eine Verbindung zur Gemini Live API her, um eine multimodale Echtzeitanwendung mit einem Python-Backend zu erstellen.
WebSocket-Anleitung
Stellen Sie über WebSockets eine Verbindung zur Gemini Live API her, um eine multimodale Echtzeitanwendung mit einem JavaScript-Frontend und einem Python-Backend zu erstellen.
ADK-Tutorial
Agenten erstellen und mit dem Agent Development Kit (ADK) Streaming die Sprach- und Videokommunikation ermöglichen
Einbindung in Partnerlösungen
Wenn Sie sich mit einigen unserer Partner integrieren möchten, haben diese Plattformen die Gemini Live API bereits über das WebRTC-Protokoll integriert, um die Entwicklung von Echtzeit-Audio- und ‑Videoanwendungen zu optimieren.
LiveKit- und ADK-Referenzarchitektur
Für fortschrittliche, produktionsreife Sprachassistenten, die eine komplexe Sitzungsorchestrierung, Routing und Multi-Agenten-Delegation erfordern, können Sie eine bidirektionale Integration mit geringer Latenz erstellen. Verwenden Sie dazu LiveKit (WebRTC) mit der Gemini Live API über das Agent Development Kit (ADK).
Mit dieser Architektur können Sie einen Orchestrator-Agenten bereitstellen, der die erste Kundeninteraktion übernimmt und Anfragen dynamisch an spezialisierte Sub-Agenten weiterleitet (z. B. Delegieren des Kontexts an einen Flugbuchungs- oder Hotelbuchungs-Agenten mithilfe der transferAgent-Orchestrierung).
Informationen zum Erkunden und Bereitstellen dieses Referenzdesigns finden Sie in der offiziellen Referenz-Codebasis-Implementierung auf GitHub.