


O Gemini Robotics ER é um modelo de visão-linguagem (VLM) que traz o raciocínio avançado sobre o mundo físico para a robótica. O modelo interpreta dados visuais, realiza raciocínio espacial e temporal, planeja tarefas de várias etapas e orquestra robôs e ferramentas.
Modelos
O Gemini Robotics ER 2 é uma atualização do nosso modelo de raciocínio que oferece um raciocínio preciso sobre o ambiente físico de um robô. Ele é especializado em recursos de raciocínio incorporado, como a orquestração agêntica de robôs (por exemplo, usando modelos de visão-linguagem-ação (VLA)), compreensão de vídeo de robôs (incluindo compreensão de progresso e detecção de sucesso), leitura de instrumentos, apontamento e raciocínio espacial.
O modelo a seguir está disponível em pré-lançamento:
gemini-robotics-er-2-preview: baseado no Gemini 3.5 Flash, com melhorias no raciocínio espacial, na localização de momentos em vídeos, na classificação de progresso em vídeos, na orquestração de vários robôs e no uso de ferramentas em várias etapas. Para especificações técnicas, limites de tokens e cotas, recursos compatíveis, disponibilidade regional e preços, consulte a página de informações do modelo Gemini Robotics ER 2.
Este guia usa o SDK de IA generativa do Google com a
Gemini Enterprise Agent Platform. Cada exemplo inicializa o
cliente com enterprise=True e faz a autenticação com as credenciais do Google Cloud, para que você possa chamar o modelo usando seu próprio projeto do Google Cloud .
Recursos de robótica
A tabela a seguir resume os principais recursos do Gemini Robotics ER 2:
| Capacidade | Descrição | Guia |
|---|---|---|
| Raciocínio espacial | Aponte para objetos, rastreie-os em vídeos, detecte-os com caixas delimitadoras, planeje trajetórias. | Raciocínio espacial |
| Execução de código agêntica | Use a execução de código para ampliar/cortar imagens, ler instrumentos e anotar cenas. | Recursos agênticos |
| Orquestração de tarefas | Combine o raciocínio espacial com APIs de robôs personalizadas para concluir tarefas de longo alcance. | Orquestração de tarefas |
| Compreensão de vídeo | Descoberta de momentos e classificação de progresso em feeds de vídeo contínuos. | Compreensão do vídeo |
Antes de começar
A Agent Platform é autenticada com credenciais do Google Cloud, não com uma chave de API Gemini. Conclua a configuração a seguir antes de executar os exemplos:
Instale o SDK de IA generativa do Google.
pip install --upgrade google-genaiAtive a API no projeto do Google Cloud e verifique se você tem um ID do projeto. Use um projeto atual ou crie um novo.
Faça a autenticação com o Application Default Credentials (ADC). Para desenvolvimento local, execute:
gcloud auth application-default loginInicialize o cliente com o back-end da Agent Platform. Todos os exemplos de Python nesta página usam o seguinte cliente, portanto, defina seu próprio ID do projeto:
from google import genai

client = genai.Client(
    enterprise=True,
    project="your-project-id",
    location="global",
)
Como alternativa, é possível definir a variável de ambiente
GOOGLE_GENAI_USE_ENTERPRISE=Trueem vez de transmitirenterprise=Truepara o cliente.
Primeiros passos
O exemplo a seguir encontra objetos em uma imagem e retorna as coordenadas 2D normalizadas e os rótulos deles. É possível transmitir essa saída diretamente para uma API de robótica ou um modelo de visão-linguagem-ação (VLA) para gerar ações de robô.
Python
from google import genai
from google.genai import types

PROMPT = """
          Point to no more than 10 items in the image. The label returned
          should be an identifying name for the object detected.
          The answer should follow the json format: [{"point": <point>,
          "label": <label1>}, ...]. The points are in [y, x] format
          normalized to 0-1000.
        """
client = genai.Client(
    enterprise=True,
    project="your-project-id",
    location="global",
)

# Load your image
with open("my-image.png", 'rb') as f:
    image_bytes = f.read()

image_response = client.models.generate_content(
    model="gemini-robotics-er-2-preview",
    contents=[
        types.Part.from_bytes(
            data=image_bytes,
            mime_type='image/png',
        ),
        PROMPT
    ],
    config = types.GenerateContentConfig(
        temperature=1.0,
        thinking_config=types.ThinkingConfig(
            thinking_level=types.ThinkingLevel.HIGH
        ),
    )
)

print(image_response.text)
REST
# First, ensure you have the image file locally.
# Encode the image to base64
IMAGE_BASE64=$(base64 -w 0 my-image.png)

# Set your Google Cloud project and location.
export PROJECT_ID="your-project-id"
export LOCATION="global"
export MODEL="gemini-robotics-er-2-preview"

# For the "global" location, use the aiplatform.googleapis.com host.
# For a regional location, prefix the host with the region, for example:
# https://us-central1-aiplatform.googleapis.com

curl -X POST \
  "https://aiplatform.googleapis.com/v1/projects/${PROJECT_ID}/locations/${LOCATION}/publishers/google/models/${MODEL}:generateContent" \
  -H "Authorization: Bearer $(gcloud auth application-default print-access-token)" \
  -H "Content-Type: application/json" \
  -d '{
    "contents": [
      {
        "parts": [
          {
            "inlineData": {
              "mimeType": "image/png",
              "data": "'"${IMAGE_BASE64}"'"
            }
          },
          {
            "text": "Point to no more than 10 items in the image. The label returned should be an identifying name for the object detected. The answer should follow the json format: [{\"point\": [y, x], \"label\": <label1>}, ...]. The points are in [y, x] format normalized to 0-1000."
          }
        ]
      }
    ],
    "generationConfig": {
      "temperature": 1.0,
      "thinkingConfig": {
        "thinkingLevel": "HIGH"
      }
    }
  }'
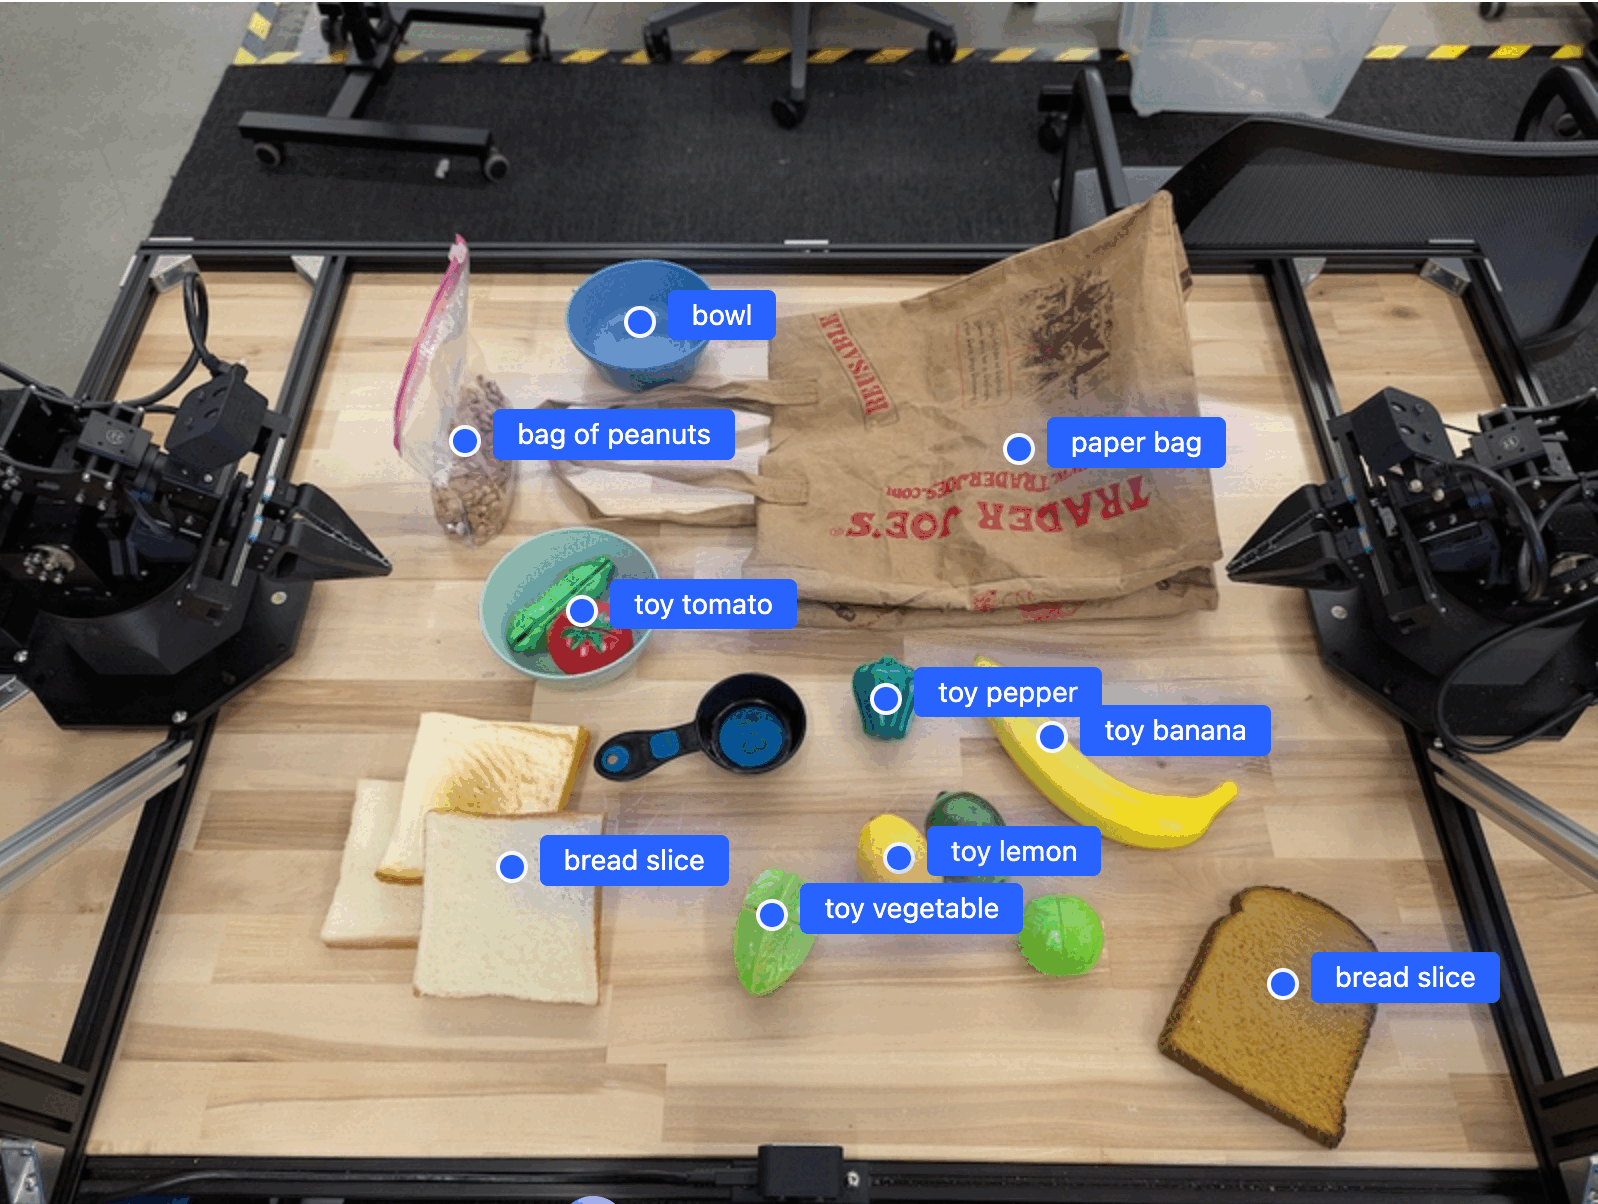
A saída será uma matriz JSON com objetos, cada um com um point
(coordenadas [y, x] normalizadas) e um label que identifica o objeto.
JSON
[
  {"point": [376, 508], "label": "small banana"},
  {"point": [287, 609], "label": "larger banana"},
  {"point": [223, 303], "label": "pink starfruit"},
  {"point": [435, 172], "label": "paper bag"},
  {"point": [270, 786], "label": "green plastic bowl"},
  {"point": [488, 775], "label": "metal measuring cup"},
  {"point": [673, 580], "label": "dark blue bowl"},
  {"point": [471, 353], "label": "light blue bowl"},
  {"point": [492, 497], "label": "bread"},
  {"point": [525, 429], "label": "lime"}
]
A imagem a seguir é um exemplo de como esses pontos podem ser exibidos:
Como funciona
O Gemini Robotics ER 2 recebe entradas de imagem, vídeo ou áudio com comandos de linguagem natural. Ele identifica objetos, raciocina sobre o contexto da cena e as relações espaciais e retorna uma saída estruturada, como coordenadas ou caixas delimitadoras.
Ele também é agêntico: divide tarefas complexas em subtarefas e as executa chamando as funções do robô ou executando o código gerado. Por exemplo, "colocar a maçã na tigela" se torna uma sequência de etapas de localização, captura e posicionamento.
Leia mais sobre como funciona a chamada de função com o Gemini na página Chamada de função.
Segurança
O Gemini Robotics ER 2 foi criado pensando na segurança, mas é sua responsabilidade manter um ambiente seguro ao redor do robô. Os modelos de IA generativa podem cometer erros, e os robôs físicos podem causar danos. A segurança é uma prioridade, e tornar os modelos de IA generativa seguros quando usados com robótica do mundo real é uma área ativa e crítica da nossa pesquisa. Para saber mais, acesse a página de segurança de robótica do Google DeepMind.
Práticas recomendadas
Siga estas práticas recomendadas para ter os melhores resultados com o Gemini Robotics ER 2:
Use uma linguagem simples e natural. Descreva o que você quer que o robô faça como se estivesse falando com uma pessoa. Se um termo não funcionar, tente um sinônimo comum.
Otimize a entrada visual. Corte ou amplie objetos pequenos ou pouco nítidos antes de enviar a imagem. A iluminação e o baixo contraste de cores podem afetar a detecção.
Divida tarefas complexas em etapas. Envie cada etapa como um comando separado para melhorar a precisão em cada subtarefa.
Faça várias consultas e calcule a média dos resultados para tarefas de alta precisão. Essa abordagem de consenso reduz a variância nas saídas espaciais.
Limitações
Considere as seguintes limitações ao desenvolver com o Gemini Robotics ER 2:
- Latência x desempenho:consultas complexas, entradas de alta resolução ou
thinking_level.HIGHpodem aumentar os tempos de processamento. Usethinking_level.MEDIUMpara um bom equilíbrio entre latência e desempenho. - Alucinações:como todos os modelos de linguagem grandes, o Gemini Robotics ER 2 pode, às vezes, "alucinar" ou fornecer informações incorretas, especialmente para comandos ambíguos ou entradas fora da distribuição.
- Dependência da qualidade do comando:a qualidade da saída do modelo depende muito da clareza e da especificidade do comando de entrada. Comandos vagos ou mal estruturados podem levar a resultados abaixo do ideal.
- Recursos computacionais:a execução do modelo, especialmente com entradas de vídeo
ou
thinking_level.HIGH, consome mais recursos computacionais. Consulte a página Raciocínio para mais detalhes. Tipos de entrada:consulte os tópicos a seguir para saber mais sobre as limitações de cada modalidade:
Aviso de privacidade
Você reconhece que os modelos mencionados neste documento (os "Modelos de Robótica") usam dados de vídeo e áudio para operar e mover seu hardware de acordo com suas instruções. Portanto, você pode operar os Modelos de Robótica de modo que dados de pessoas identificáveis, como voz, imagens e dados de semelhança ("Dados Pessoais"), sejam coletados pelos Modelos de Robótica. Se você optar por operar os Modelos de Robótica de uma maneira que colete Dados Pessoais, concorda que não vai permitir que pessoas identificáveis interajam com os Modelos de Robótica ou estejam presentes na área ao redor deles, a menos que essas pessoas identificáveis tenham sido suficientemente notificadas e tenham consentido com a coleta e o uso dos Dados Pessoais delas, conforme descrito nos termos de serviço aplicáveis da Plataforma de Agentes. Você vai garantir que esse aviso permita a coleta e o uso de Dados Pessoais, conforme descrito nesses termos, e vai empregar esforços comercialmente razoáveis para minimizar a coleta e a distribuição de Dados Pessoais usando técnicas como desfoque de rosto e operação dos Modelos de Robótica em áreas que não contenham pessoas identificáveis, na medida do possível.
A seguir
Para saber mais sobre o Gemini Robotics ER 2, consulte os seguintes recursos:
- Informações do modelo Gemini Robotics ER 2: especificações técnicas, limites de tokens e recursos compatíveis.
- Preços do Gemini Robotics ER: detalhes sobre os preços na Agent Platform.
- Raciocínio espacial: apontamento, rastreamento, caixas delimitadoras e trajetórias.
- Recursos agênticos: execução de código, leitura de instrumentos e anotação de imagens.
- Orquestração de tarefas: tarefas de longo alcance com APIs de robô personalizadas.
- Compreensão de vídeo: localização de momentos e classificação de progresso.
- Card de modelo do Gemini Robotics ER 2: benchmarks de avaliação, arquitetura e detalhes de treinamento.
- Post do blog sobre o Gemini Robotics ER 2: anúncio e visão geral do Google DeepMind.
- Segurança de robótica do Google DeepMind: pesquisa de segurança por trás da família de modelos.