


Gemini Robotics ER은 로봇공학에 실제 세계에 대한 고급 추론을 제공하는 비전 언어 모델 (VLM)입니다. 이 모델은 시각적 데이터를 해석하고, 공간 및 시간 추론을 수행하고, 다단계 작업을 계획하고, 로봇과 도구를 조정합니다.
모델
Gemini Robotics ER 2는 로봇의 물리적 환경에 대한 정확한 추론을 제공하는 추론 모델의 업데이트 버전입니다. 이 모델은 로봇의 에이전트형 조정 (예: 시각-언어-동작 (VLA) 모델 사용), 로봇 동영상 이해 (진행 상황 이해 및 성공 감지 포함), 계측기 판독, 포인팅, 공간 추론과 같은 체화된 추론 기능에 특화되어 있습니다.
다음 모델은 프리뷰로 제공됩니다.
gemini-robotics-er-2-preview: Gemini 3.5 Flash를 기반으로 공간 추론, 동영상 순간 찾기, 동영상 진행 상황 분류, 멀티 로봇 조정, 다단계 도구 사용이 개선되었습니다. 기술 사양, 토큰 및 할당량 한도, 지원되는 기능, 리전별 가용성, 가격 책정은 Gemini Robotics ER 2 모델 정보 페이지를 참조하세요.
이 가이드에서는 Gemini Enterprise Agent Platform과 함께 Google 생성형 AI SDK를 사용합니다. 모든 예시는 enterprise=True로 클라이언트를 초기화하고 Google Cloud사용자 인증 정보로 인증하므로 자체 Google Cloud 프로젝트를 사용하여 모델을 호출할 수 있습니다.
로봇 공학 기능
다음 표에는 Gemini Robotics ER 2의 핵심 기능이 요약되어 있습니다.
| 기능 | 설명 | 가이드 |
|---|---|---|
| 공간 추론 | 객체를 가리키고, 동영상에서 추적하고, 경계 상자로 감지하고, 궤적을 계획합니다. | 공간 추론 |
| 에이전트형 코드 실행 | 코드 실행을 사용하여 이미지를 확대/축소/자르고, 계측기를 읽고, 장면에 주석을 추가합니다. | 에이전트형 기능 |
| 태스크 조정 | 공간 추론을 커스텀 로봇 API와 결합하여 장기 작업을 완료합니다. | 태스크 조정 |
| 동영상 이해 | 연속 동영상 피드에서 순간 찾기 및 진행 상황 분류 | 동영상 이해 |
시작하기 전에
Agent Platform은 Gemini API 키가 아닌 Google Cloud사용자 인증 정보로 인증합니다. 예시를 실행하기 전에 다음 설정을 완료합니다.
Google 생성형 AI SDK를 설치합니다.
pip install --upgrade google-genaiGoogle Cloud 프로젝트에서 API를 사용 설정하고 프로젝트 ID가 있는지 확인합니다. 기존 프로젝트를 사용하거나 새 프로젝트를 만들 수 있습니다.
애플리케이션 기본 사용자 인증 정보 (ADC)로 인증합니다. 로컬 개발의 경우 다음을 실행합니다.
gcloud auth application-default loginAgent Platform 백엔드로 클라이언트를 초기화합니다. 이 페이지의 모든 Python 예시는 다음 클라이언트를 사용하므로 자체 프로젝트 ID를 설정합니다.
from google import genai

client = genai.Client(
    enterprise=True,
    project="your-project-id",
    location="global",
)
또는
enterprise=True를 클라이언트에 전달하는 대신GOOGLE_GENAI_USE_ENTERPRISE=True환경 변수를 설정할 수 있습니다.
시작하기
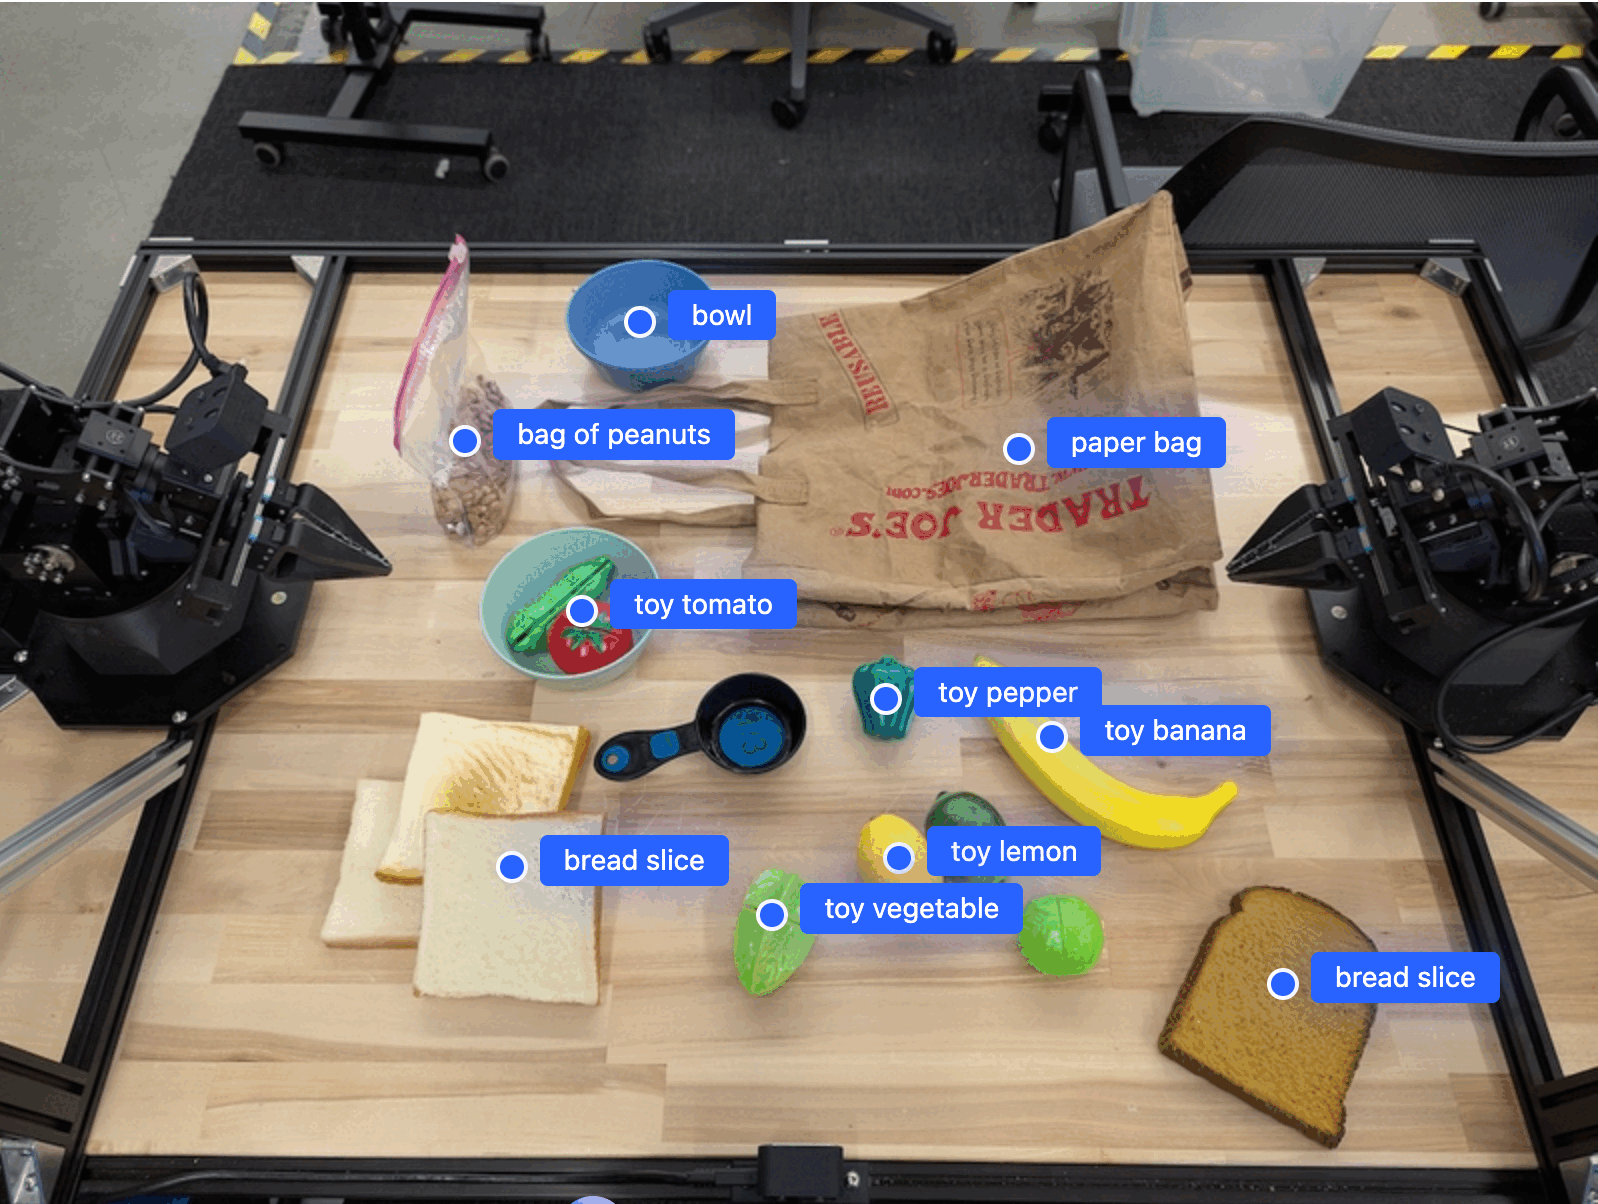
다음 예시에서는 이미지에서 객체를 찾고 정규화된 2D 좌표와 라벨을 반환합니다. 이 출력을 로봇공학 API 또는 시각 언어 작업 (VLA) 모델에 직접 전달하여 로봇 작업을 생성할 수 있습니다.
Python
from google import genai
from google.genai import types

PROMPT = """
          Point to no more than 10 items in the image. The label returned
          should be an identifying name for the object detected.
          The answer should follow the json format: [{"point": <point>,
          "label": <label1>}, ...]. The points are in [y, x] format
          normalized to 0-1000.
        """
client = genai.Client(
    enterprise=True,
    project="your-project-id",
    location="global",
)

# Load your image
with open("my-image.png", 'rb') as f:
    image_bytes = f.read()

image_response = client.models.generate_content(
    model="gemini-robotics-er-2-preview",
    contents=[
        types.Part.from_bytes(
            data=image_bytes,
            mime_type='image/png',
        ),
        PROMPT
    ],
    config = types.GenerateContentConfig(
        temperature=1.0,
        thinking_config=types.ThinkingConfig(
            thinking_level=types.ThinkingLevel.HIGH
        ),
    )
)

print(image_response.text)
REST
# First, ensure you have the image file locally.
# Encode the image to base64
IMAGE_BASE64=$(base64 -w 0 my-image.png)

# Set your Google Cloud project and location.
export PROJECT_ID="your-project-id"
export LOCATION="global"
export MODEL="gemini-robotics-er-2-preview"

# For the "global" location, use the aiplatform.googleapis.com host.
# For a regional location, prefix the host with the region, for example:
# https://us-central1-aiplatform.googleapis.com

curl -X POST \
  "https://aiplatform.googleapis.com/v1/projects/${PROJECT_ID}/locations/${LOCATION}/publishers/google/models/${MODEL}:generateContent" \
  -H "Authorization: Bearer $(gcloud auth application-default print-access-token)" \
  -H "Content-Type: application/json" \
  -d '{
    "contents": [
      {
        "parts": [
          {
            "inlineData": {
              "mimeType": "image/png",
              "data": "'"${IMAGE_BASE64}"'"
            }
          },
          {
            "text": "Point to no more than 10 items in the image. The label returned should be an identifying name for the object detected. The answer should follow the json format: [{\"point\": [y, x], \"label\": <label1>}, ...]. The points are in [y, x] format normalized to 0-1000."
          }
        ]
      }
    ],
    "generationConfig": {
      "temperature": 1.0,
      "thinkingConfig": {
        "thinkingLevel": "HIGH"
      }
    }
  }'
출력은 객체를 포함하는 JSON 배열이며, 각 객체에는 point(정규화된 [y, x] 좌표)와 객체를 식별하는 label가 있습니다.
JSON
[
  {"point": [376, 508], "label": "small banana"},
  {"point": [287, 609], "label": "larger banana"},
  {"point": [223, 303], "label": "pink starfruit"},
  {"point": [435, 172], "label": "paper bag"},
  {"point": [270, 786], "label": "green plastic bowl"},
  {"point": [488, 775], "label": "metal measuring cup"},
  {"point": [673, 580], "label": "dark blue bowl"},
  {"point": [471, 353], "label": "light blue bowl"},
  {"point": [492, 497], "label": "bread"},
  {"point": [525, 429], "label": "lime"}
]
다음 이미지는 이러한 포인트가 표시되는 방식의 예입니다.
작동 방식
Gemini Robotics ER 2는 자연어 프롬프트와 함께 이미지, 동영상 또는 오디오 입력을 사용합니다. 객체를 식별하고 장면 컨텍스트와 공간 관계를 추론하며 좌표 또는 경계 상자와 같은 구조화된 출력을 반환합니다.
또한 에이전트형입니다. 복잡한 작업을 하위 작업으로 세분화하고 로봇 함수를 호출하거나 생성된 코드를 실행하여 이를 실행합니다. 예를 들어 '사과를 그릇에 담기'는 위치 찾기, 잡기, 놓기 단계의 시퀀스가 됩니다.
함수 호출 페이지에서 Gemini를 사용한 함수 호출의 작동 방식을 자세히 알아보세요.
안전
Gemini Robotics ER 2는 안전을 고려하여 제작되었지만 로봇 주변의 안전한 환경을 유지하는 것은 사용자의 책임입니다. 생성형 AI 모델은 실수를 할 수 있으며 실제 로봇은 손상을 일으킬 수 있습니다. 안전은 최우선 과제이며, 실제 로봇 공학에 생성형 AI 모델을 사용할 때 안전을 확보하는 것은 Google 연구의 활발하고 중요한 영역입니다. 자세한 내용은 Google DeepMind 로봇 안전 페이지를 참고하세요.
권장사항
Gemini Robotics ER 2에서 최상의 결과를 얻으려면 다음 권장사항을 따르세요.
평이하고 자연스러운 언어를 사용합니다. 사람에게 설명하듯이 로봇이 수행할 작업을 설명합니다. 검색어가 작동하지 않으면 일반적인 동의어를 사용해 보세요.
시각적 입력을 최적화합니다. 이미지를 전송하기 전에 작거나 불분명한 객체를 자르거나 확대합니다. 조명과 낮은 색상 대비는 감지에 영향을 미칠 수 있습니다.
복잡한 작업을 여러 단계로 나눕니다. 각 단계를 별도의 프롬프트로 전송하여 각 하위 작업의 정확성을 개선합니다.
고정밀 작업의 경우 여러 번 쿼리하고 결과를 평균화합니다. 이 합의 접근 방식은 공간 출력의 편차를 줄입니다.
제한사항
Gemini Robotics ER 2로 개발할 때는 다음 제한사항을 고려하세요.
- 지연 시간과 성능: 복잡한 쿼리, 고해상도 입력 또는
thinking_level.HIGH로 인해 처리 시간이 늘어날 수 있습니다. 지연 시간과 성능 간의 균형을 맞추려면thinking_level.MEDIUM를 사용합니다. - 할루시네이션: 모든 대규모 언어 모델과 마찬가지로 Gemini Robotics ER 2는 특히 모호한 프롬프트나 분포 외 입력에 대해 때때로 '할루시네이션'을 일으키거나 잘못된 정보를 제공할 수 있습니다.
- 프롬프트 품질에 대한 의존성: 모델 출력의 품질은 입력 프롬프트의 명확성과 구체성에 따라 크게 달라집니다. 모호하거나 구조가 잘못된 프롬프트는 최적의 결과를 얻지 못할 수 있습니다.
- 컴퓨팅 리소스: 모델을 실행하면, 특히 동영상 입력 또는
thinking_level.HIGH을 사용하는 경우 추가 컴퓨팅 리소스가 소비됩니다. 자세한 내용은 사고 페이지를 참고하세요. 입력 유형: 각 형식의 제한사항에 대한 자세한 내용은 다음 주제를 참조하세요.
개인정보처리방침
귀하는 이 문서에 언급된 모델('로봇 모델')이 귀하의 지침에 따라 하드웨어를 작동하고 이동하기 위해 동영상 및 오디오 데이터를 활용한다는 사실을 인정합니다. 따라서 귀하는 음성, 이미지, 초상 데이터 ('개인 정보')와 같은 식별 가능한 개인의 데이터가 로보틱스 모델에 의해 수집되도록 로보틱스 모델을 운영할 수 있습니다. '개인 정보'를 수집하는 방식으로 '로보틱스 모델'을 운영하기로 선택하는 경우, 식별 가능한 개인이 관련 '에이전트 플랫폼' 서비스 약관에 설명된 대로 자신의 '개인 정보' 수집 및 사용에 대해 충분히 통지받고 동의하지 않는 한, 식별 가능한 개인이 '로보틱스 모델'과 상호작용하거나 '로보틱스 모델' 주변 영역에 있는 것을 허용하지 않는다는 데 동의합니다. '귀하'는 해당 고지가 해당 약관에 설명된 대로 '개인 정보'의 수집 및 사용을 허용하도록 보장하고, 얼굴 흐리게 처리와 같은 기술을 사용하고 식별 가능한 개인이 포함되지 않은 영역에서 '로보틱스 모델'을 운영하여 '개인 정보'의 수집 및 배포를 최소화하기 위해 상업적으로 합당한 노력을 기울여야 합니다.
다음 단계
Gemini Robotics ER 2에 대해 자세히 알아보려면 다음 리소스를 참고하세요.
- Gemini Robotics ER 2 모델 정보: 기술 사양, 토큰 한도, 지원되는 기능
- Gemini Robotics ER 가격 책정: Agent Platform의 가격 책정 세부정보입니다.
- 공간 추론: 가리키기, 추적, 경계 상자, 궤적
- 에이전트 기능: 코드 실행, 계측기 읽기, 이미지 주석
- 작업 조정: 맞춤 로봇 API를 사용하는 장기 작업
- 동영상 이해: 순간 찾기 및 진행 상황 분류
- Gemini Robotics ER 2 모델 카드: 평가 벤치마크, 아키텍처, 학습 세부정보
- Gemini Robotics ER 2 블로그 게시물: Google DeepMind의 공지사항 및 개요
- Google DeepMind 로봇 공학 안전: 모델 제품군에 대한 안전 연구입니다.