


Gemini Robotics ER adalah model bahasa-visi (VLM) yang menghadirkan penalaran canggih tentang dunia fisik ke robotika. Model ini menafsirkan data visual, melakukan penalaran spasial dan temporal, merencanakan tugas multilangkah, serta mengorkestrasi robot dan alat.
Model
Gemini Robotics ER 2 adalah update pada model penalaran kami yang memberikan penalaran akurat tentang lingkungan fisik robot. Model ini mengkhususkan diri dalam kemampuan penalaran yang diwujudkan, seperti orkestrasi agentic robot (misalnya, menggunakan model vision-language-action (VLA)), pemahaman video robot (termasuk pemahaman progres dan deteksi keberhasilan), pembacaan instrumen, penunjukan, dan penalaran spasial.
Model berikut tersedia dalam Pratinjau:
gemini-robotics-er-2-preview: Dibangun di atas Gemini 3.5 Flash dengan peningkatan penalaran spasial, penemuan momen video, klasifikasi progres video, orkestrasi multi-robot, dan penggunaan alat multilangkah. Untuk mengetahui spesifikasi teknis, batas token dan kuota, kemampuan yang didukung, ketersediaan regional, dan harga, lihat halaman Informasi model Gemini Robotics ER 2.
Panduan ini menggunakan Google Gen AI SDK dengan
Gemini Enterprise Agent Platform. Setiap contoh menginisialisasi klien dengan enterprise=True dan melakukan autentikasi dengan kredensial Google Cloud, sehingga Anda dapat memanggil model menggunakan project Google Cloud Anda sendiri.
Kemampuan robotika
Tabel berikut merangkum kemampuan inti Gemini Robotics ER 2:
| Kemampuan | Deskripsi | Panduan |
|---|---|---|
| Penalaran spasial | Menunjuk ke objek, melacaknya dalam video, mendeteksi dengan kotak pembatas, merencanakan lintasan. | Penalaran spasial |
| Eksekusi kode agentic | Gunakan eksekusi kode untuk memperbesar/memangkas gambar, membaca instrumen, dan memberi anotasi pada adegan. | Kemampuan agentic |
| Orkestrasi tugas | Menggabungkan penalaran spasial dengan API robot kustom untuk menyelesaikan tugas jangka panjang. | Orkestrasi tugas |
| Pemahaman video | Penemuan momen dan klasifikasi progres dari feed video berkelanjutan. | Pemahaman video |
Sebelum memulai
Agent Platform melakukan autentikasi dengan kredensial Google Cloud, bukan kunci Gemini API. Selesaikan penyiapan berikut sebelum Anda menjalankan contoh:
Instal Google Gen AI SDK.
pip install --upgrade google-genaiAktifkan API di project Google Cloud Anda dan pastikan Anda memiliki project ID. Anda dapat menggunakan project yang sudah ada atau membuat project baru.
Melakukan autentikasi dengan Kredensial Default Aplikasi (ADC). Untuk pengembangan lokal, jalankan:
gcloud auth application-default loginLakukan inisialisasi klien dengan backend Agent Platform. Semua contoh Python di halaman ini menggunakan klien berikut, jadi tetapkan project ID Anda sendiri:
from google import genai

client = genai.Client(
    enterprise=True,
    project="your-project-id",
    location="global",
)
Atau, Anda dapat menetapkan variabel lingkungan
GOOGLE_GENAI_USE_ENTERPRISE=True, bukan meneruskanenterprise=Trueke klien.
Mulai
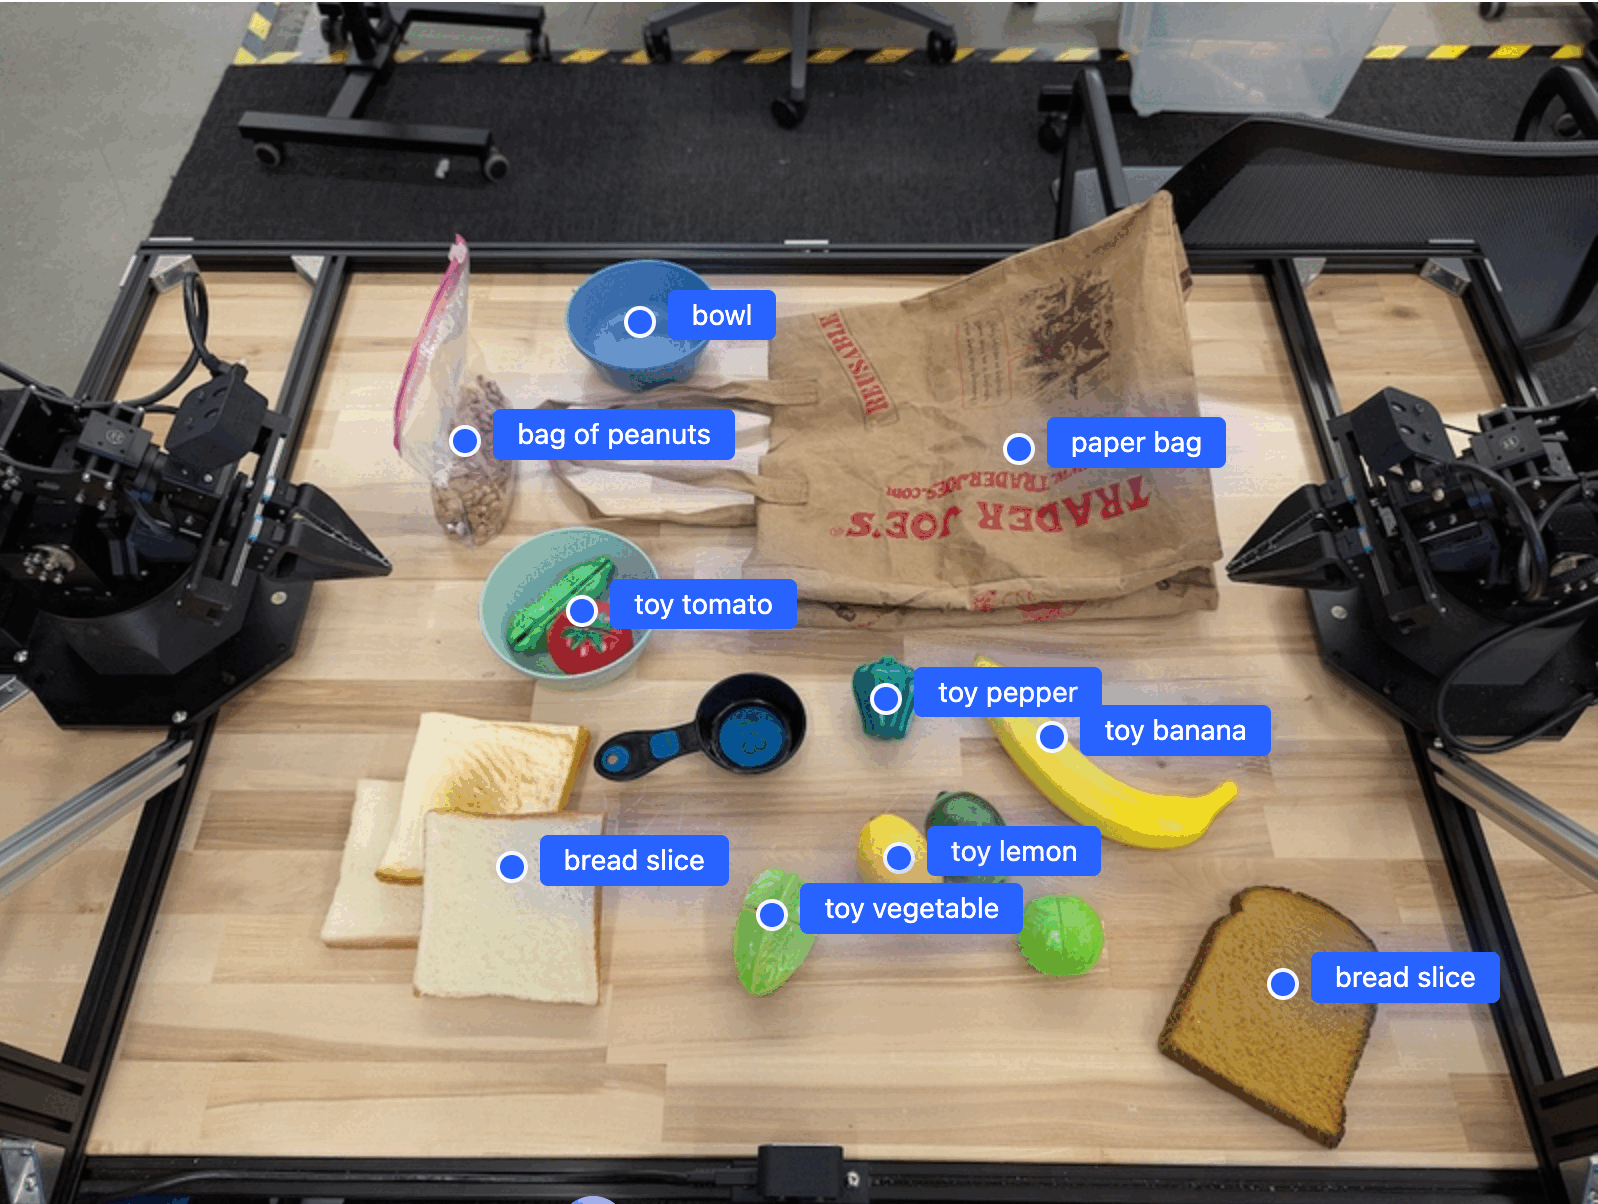
Contoh berikut menemukan objek dalam gambar dan menampilkan koordinat dan label 2D yang dinormalisasi. Anda dapat meneruskan output ini langsung ke API robotika atau model vision-language-action (VLA) untuk menghasilkan tindakan robot.
Python
from google import genai
from google.genai import types

PROMPT = """
          Point to no more than 10 items in the image. The label returned
          should be an identifying name for the object detected.
          The answer should follow the json format: [{"point": <point>,
          "label": <label1>}, ...]. The points are in [y, x] format
          normalized to 0-1000.
        """
client = genai.Client(
    enterprise=True,
    project="your-project-id",
    location="global",
)

# Load your image
with open("my-image.png", 'rb') as f:
    image_bytes = f.read()

image_response = client.models.generate_content(
    model="gemini-robotics-er-2-preview",
    contents=[
        types.Part.from_bytes(
            data=image_bytes,
            mime_type='image/png',
        ),
        PROMPT
    ],
    config = types.GenerateContentConfig(
        temperature=1.0,
        thinking_config=types.ThinkingConfig(
            thinking_level=types.ThinkingLevel.HIGH
        ),
    )
)

print(image_response.text)
REST
# First, ensure you have the image file locally.
# Encode the image to base64
IMAGE_BASE64=$(base64 -w 0 my-image.png)

# Set your Google Cloud project and location.
export PROJECT_ID="your-project-id"
export LOCATION="global"
export MODEL="gemini-robotics-er-2-preview"

# For the "global" location, use the aiplatform.googleapis.com host.
# For a regional location, prefix the host with the region, for example:
# https://us-central1-aiplatform.googleapis.com

curl -X POST \
  "https://aiplatform.googleapis.com/v1/projects/${PROJECT_ID}/locations/${LOCATION}/publishers/google/models/${MODEL}:generateContent" \
  -H "Authorization: Bearer $(gcloud auth application-default print-access-token)" \
  -H "Content-Type: application/json" \
  -d '{
    "contents": [
      {
        "parts": [
          {
            "inlineData": {
              "mimeType": "image/png",
              "data": "'"${IMAGE_BASE64}"'"
            }
          },
          {
            "text": "Point to no more than 10 items in the image. The label returned should be an identifying name for the object detected. The answer should follow the json format: [{\"point\": [y, x], \"label\": <label1>}, ...]. The points are in [y, x] format normalized to 0-1000."
          }
        ]
      }
    ],
    "generationConfig": {
      "temperature": 1.0,
      "thinkingConfig": {
        "thinkingLevel": "HIGH"
      }
    }
  }'
Outputnya akan berupa array JSON yang berisi objek, masing-masing dengan point
(koordinat [y, x] yang dinormalisasi) dan label yang mengidentifikasi objek.
JSON
[
  {"point": [376, 508], "label": "small banana"},
  {"point": [287, 609], "label": "larger banana"},
  {"point": [223, 303], "label": "pink starfruit"},
  {"point": [435, 172], "label": "paper bag"},
  {"point": [270, 786], "label": "green plastic bowl"},
  {"point": [488, 775], "label": "metal measuring cup"},
  {"point": [673, 580], "label": "dark blue bowl"},
  {"point": [471, 353], "label": "light blue bowl"},
  {"point": [492, 497], "label": "bread"},
  {"point": [525, 429], "label": "lime"}
]
Gambar berikut adalah contoh cara menampilkan titik-titik ini:
Cara kerjanya
Gemini Robotics ER 2 menerima input gambar, video, atau audio dengan perintah bahasa alami. Model ini mengidentifikasi objek, mempertimbangkan konteks adegan dan hubungan spasial, serta menampilkan output terstruktur seperti koordinat atau kotak pembatas.
Model ini juga bersifat agentic: memecah tugas kompleks menjadi subtugas dan menjalankannya dengan memanggil fungsi robot Anda atau menjalankan kode yang dihasilkan. Misalnya, "letakkan apel di mangkuk" menjadi urutan langkah menemukan, menggenggam, dan menempatkan.
Baca selengkapnya tentang cara kerja panggilan fungsi dengan Gemini di halaman Panggilan fungsi.
Keamanan
Gemini Robotics ER 2 dibuat dengan mengutamakan keselamatan, tetapi Anda bertanggung jawab untuk menjaga lingkungan yang aman di sekitar robot. Model AI generatif dapat membuat kesalahan, dan robot fisik dapat menyebabkan kerusakan. Keamanan adalah prioritas, dan membuat model AI generatif aman saat digunakan dengan robotika dunia nyata adalah area penelitian kami yang aktif dan penting. Untuk mempelajari lebih lanjut, buka halaman keamanan robotika Google DeepMind.
Praktik terbaik
Ikuti praktik terbaik berikut untuk mendapatkan hasil terbaik dari Gemini Robotics ER 2:
Gunakan bahasa yang sederhana dan alami. Jelaskan tindakan yang Anda inginkan dari robot seperti yang Anda lakukan kepada seseorang. Jika istilah tidak berfungsi, coba sinonim yang umum.
Mengoptimalkan input visual. Pangkas atau perbesar objek kecil atau tidak jelas sebelum mengirim gambar. Pencahayaan dan kontras warna yang rendah dapat memengaruhi deteksi.
Uraikan tugas yang kompleks menjadi beberapa langkah. Kirim setiap langkah sebagai perintah terpisah untuk meningkatkan akurasi pada setiap sub-tugas.
Buat kueri beberapa kali dan hitung rata-rata hasilnya untuk tugas yang memerlukan presisi tinggi. Pendekatan konsensus ini mengurangi varians pada output spasial.
Batasan
Pertimbangkan batasan berikut saat mengembangkan dengan Gemini Robotics ER 2:
- Latensi versus performa: Kueri yang kompleks, input resolusi tinggi, atau
thinking_level.HIGHdapat menyebabkan peningkatan waktu pemrosesan. Gunakanthinking_level.MEDIUMuntuk mendapatkan keseimbangan yang baik antara latensi dan performa. - Halusinasi: Seperti semua model bahasa besar, Gemini Robotics ER 2 terkadang dapat "berhalusinasi" atau memberikan informasi yang salah, terutama untuk perintah yang ambigu atau input di luar distribusi.
- Ketergantungan pada kualitas perintah: Kualitas output model sangat bergantung pada kejelasan dan spesifisitas perintah input. Perintah yang tidak jelas atau tidak terstruktur dengan baik dapat memberikan hasil yang kurang optimal.
- Resource komputasi: Menjalankan model, terutama dengan input video atau
thinking_level.HIGH, akan menggunakan resource komputasi tambahan. Lihat halaman Penalaran untuk mengetahui detail selengkapnya. Jenis input: Lihat topik berikut untuk mengetahui detail tentang batasan untuk setiap modalitas:
Pemberitahuan privasi
Anda memahami bahwa model yang dirujuk dalam dokumen ini ("Model Robotika") memanfaatkan data video dan audio untuk mengoperasikan dan menggerakkan hardware Anda sesuai dengan petunjuk Anda. Oleh karena itu, Anda dapat mengoperasikan Model Robotika sedemikian rupa sehingga data dari orang yang dapat diidentifikasi, seperti data suara, gambar, dan kemiripan ("Data Pribadi"), akan dikumpulkan oleh Model Robotika. Jika Anda memilih untuk mengoperasikan Model Robotika dengan cara yang mengumpulkan Data Pribadi, Anda setuju bahwa Anda tidak akan mengizinkan orang yang dapat diidentifikasi untuk berinteraksi dengan, atau berada di area sekitar, Model Robotika, kecuali dan hingga orang yang dapat diidentifikasi tersebut telah diberi tahu secara memadai tentang dan menyetujui pengumpulan dan penggunaan Data Pribadi mereka sebagaimana diuraikan dalam persyaratan layanan Platform Agen yang berlaku. Anda akan memastikan bahwa pemberitahuan tersebut mengizinkan pengumpulan dan penggunaan Data Pribadi sebagaimana diuraikan dalam persyaratan tersebut, dan Anda akan menggunakan upaya yang wajar secara komersial untuk meminimalkan pengumpulan dan distribusi Data Pribadi dengan menggunakan teknik seperti pemburaman wajah dan mengoperasikan Model Robotika di area yang tidak berisi orang yang dapat diidentifikasi sejauh yang dapat dilakukan.
Langkah berikutnya
Untuk mempelajari lebih lanjut Gemini Robotics ER 2, lihat referensi berikut:
- Informasi model Gemini Robotics ER 2: spesifikasi teknis, batas token, dan kemampuan yang didukung.
- Harga ER Gemini Robotics: detail harga di Agent Platform.
- Penalaran spasial: penunjukan, pelacakan, kotak pembatas, dan lintasan.
- Kemampuan agentic: eksekusi kode, pembacaan instrumen, dan anotasi gambar.
- Orkestrasi tugas: tugas jangka panjang dengan API robot kustom.
- Pemahaman video: penemuan momen dan klasifikasi progres.
- Kartu model Gemini Robotics ER 2: benchmark evaluasi, arsitektur, dan detail pelatihan.
- Postingan blog Gemini Robotics ER 2: pengumuman dan ringkasan dari Google DeepMind.
- Keamanan robotika Google DeepMind: riset keamanan di balik rangkaian model.