


Gemini Robotics ER est un modèle de vision-langage (VLM) qui dote la robotique de capacités de raisonnement avancé sur le monde physique. Le modèle interprète les données visuelles, effectue un raisonnement spatial et temporel, planifie des tâches en plusieurs étapes, et orchestre les robots et les outils.
Modèles
Gemini Robotics ER 2 est une mise à jour de notre modèle de raisonnement qui fournit un raisonnement précis sur l'environnement physique d'un robot. Il est spécialisé dans les capacités de raisonnement incarné, telles que l'orchestration agentique de robots (par exemple, à l'aide de modèles vision-langage-action (VLA)), la compréhension de vidéos de robots (y compris la compréhension de la progression et la détection de la réussite), la lecture d'instruments, le pointage et le raisonnement spatial.
Le modèle suivant est disponible en version preview :
gemini-robotics-er-2-preview: s'appuie sur Gemini 3.5 Flash avec un raisonnement spatial amélioré, la recherche de moments dans les vidéos, la classification de la progression des vidéos, l'orchestration multi-robot et l'utilisation d'outils en plusieurs étapes. Pour connaître les caractéristiques techniques, les limites de jetons et de quotas, les fonctionnalités compatibles, la disponibilité régionale et les tarifs, consultez la page Informations sur le modèle Gemini Robotics ER 2.
Ce guide utilise le SDK Google Gen AI avec Gemini Enterprise Agent Platform. Chaque exemple initialise le client avec enterprise=True et s'authentifie avec les identifiants Google Cloud, ce qui vous permet d'appeler le modèle à l'aide de votre propre projet Google Cloud .
Fonctionnalités de robotique
Le tableau suivant récapitule les principales fonctionnalités de Gemini Robotics ER 2 :
| Capacité | Description | Guide |
|---|---|---|
| Raisonnement spatial | Pointez sur des objets, suivez-les dans une vidéo, détectez-les avec des cadres de délimitation et planifiez des trajectoires. | Raisonnement spatial |
| Exécution de code agentique | Utilisez l'exécution de code pour zoomer/recadrer des images, lire des instruments et annoter des scènes. | Capacités agentives |
| Orchestration des tâches | Combinez le raisonnement spatial avec des API de robot personnalisées pour effectuer des tâches à long horizon. | Orchestration des tâches |
| Compréhension des vidéos | Détection de moments et classification de la progression à partir de flux vidéo continus. | Compréhension des vidéos |
Avant de commencer
Agent Platform s'authentifie avec des identifiants Google Cloud, et non avec une clé API Gemini. Effectuez la configuration suivante avant d'exécuter les exemples :
Installez le SDK Google Gen AI.
pip install --upgrade google-genaiActivez l'API dans votre projet Google Cloud et assurez-vous de disposer d'un ID de projet. Vous pouvez utiliser un projet existant ou en créer un.
Authentifiez-vous avec les Identifiants par défaut de l'application (ADC). Pour le développement local, exécutez :
gcloud auth application-default loginInitialisez le client avec le backend Agent Platform. Tous les exemples Python de cette page utilisent le client suivant. Définissez donc l'ID de votre projet :
from google import genai

client = genai.Client(
    enterprise=True,
    project="your-project-id",
    location="global",
)
Vous pouvez également définir la variable d'environnement
GOOGLE_GENAI_USE_ENTERPRISE=Trueau lieu de transmettreenterprise=Trueau client.
Commencer
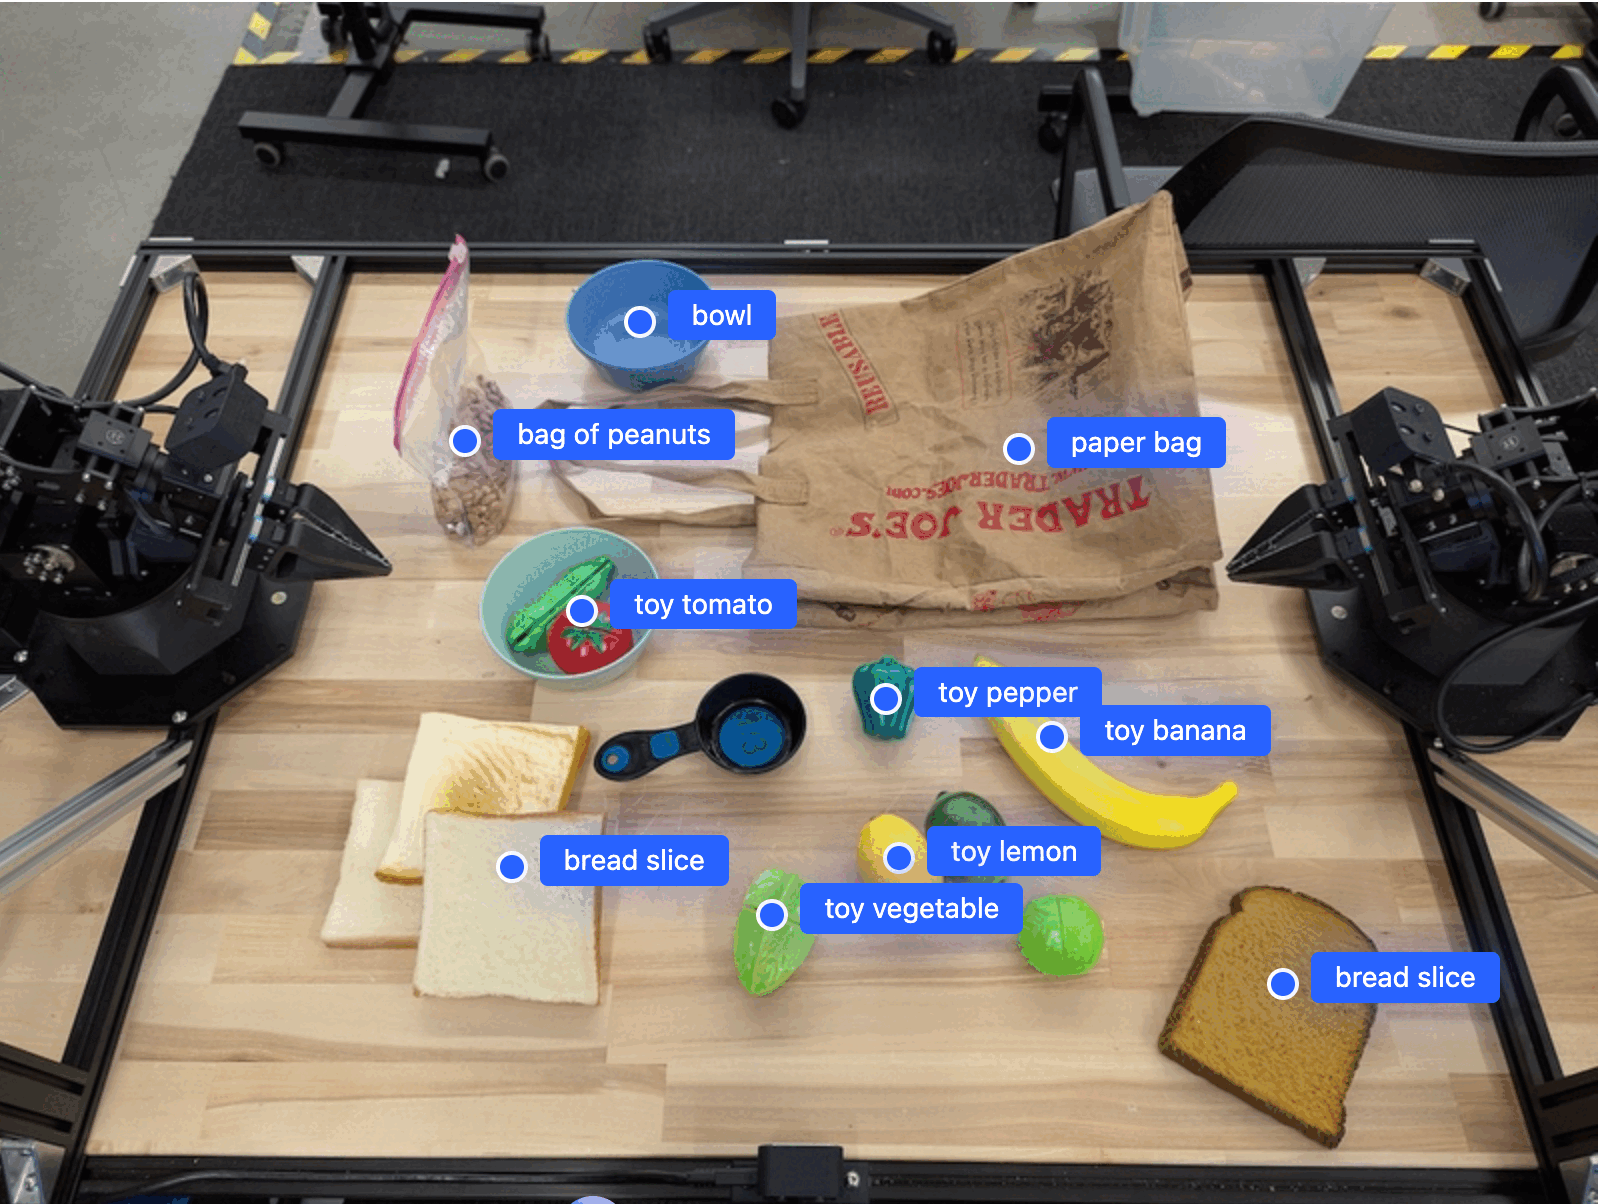
L'exemple suivant recherche des objets dans une image et renvoie leurs coordonnées 2D normalisées et leurs étiquettes. Vous pouvez transmettre ce résultat directement à une API de robotique ou à un modèle vision-langage-action (VLA) pour générer des actions de robot.
Python
from google import genai
from google.genai import types

PROMPT = """
          Point to no more than 10 items in the image. The label returned
          should be an identifying name for the object detected.
          The answer should follow the json format: [{"point": <point>,
          "label": <label1>}, ...]. The points are in [y, x] format
          normalized to 0-1000.
        """
client = genai.Client(
    enterprise=True,
    project="your-project-id",
    location="global",
)

# Load your image
with open("my-image.png", 'rb') as f:
    image_bytes = f.read()

image_response = client.models.generate_content(
    model="gemini-robotics-er-2-preview",
    contents=[
        types.Part.from_bytes(
            data=image_bytes,
            mime_type='image/png',
        ),
        PROMPT
    ],
    config = types.GenerateContentConfig(
        temperature=1.0,
        thinking_config=types.ThinkingConfig(
            thinking_level=types.ThinkingLevel.HIGH
        ),
    )
)

print(image_response.text)
REST
# First, ensure you have the image file locally.
# Encode the image to base64
IMAGE_BASE64=$(base64 -w 0 my-image.png)

# Set your Google Cloud project and location.
export PROJECT_ID="your-project-id"
export LOCATION="global"
export MODEL="gemini-robotics-er-2-preview"

# For the "global" location, use the aiplatform.googleapis.com host.
# For a regional location, prefix the host with the region, for example:
# https://us-central1-aiplatform.googleapis.com

curl -X POST \
  "https://aiplatform.googleapis.com/v1/projects/${PROJECT_ID}/locations/${LOCATION}/publishers/google/models/${MODEL}:generateContent" \
  -H "Authorization: Bearer $(gcloud auth application-default print-access-token)" \
  -H "Content-Type: application/json" \
  -d '{
    "contents": [
      {
        "parts": [
          {
            "inlineData": {
              "mimeType": "image/png",
              "data": "'"${IMAGE_BASE64}"'"
            }
          },
          {
            "text": "Point to no more than 10 items in the image. The label returned should be an identifying name for the object detected. The answer should follow the json format: [{\"point\": [y, x], \"label\": <label1>}, ...]. The points are in [y, x] format normalized to 0-1000."
          }
        ]
      }
    ],
    "generationConfig": {
      "temperature": 1.0,
      "thinkingConfig": {
        "thinkingLevel": "HIGH"
      }
    }
  }'
Le résultat sera un tableau JSON contenant des objets, chacun avec un point (coordonnées [y, x] normalisées) et un label identifiant l'objet.
JSON
[
  {"point": [376, 508], "label": "small banana"},
  {"point": [287, 609], "label": "larger banana"},
  {"point": [223, 303], "label": "pink starfruit"},
  {"point": [435, 172], "label": "paper bag"},
  {"point": [270, 786], "label": "green plastic bowl"},
  {"point": [488, 775], "label": "metal measuring cup"},
  {"point": [673, 580], "label": "dark blue bowl"},
  {"point": [471, 353], "label": "light blue bowl"},
  {"point": [492, 497], "label": "bread"},
  {"point": [525, 429], "label": "lime"}
]
L'image suivante montre un exemple d'affichage de ces points :
Fonctionnement
Gemini Robotics ER 2 accepte des images, des vidéos ou des fichiers audio en entrée avec des requêtes en langage naturel. Il identifie les objets, raisonne sur le contexte de la scène et les relations spatiales, et renvoie une sortie structurée, comme des coordonnées ou des cadres de délimitation.
Il est également agentique : il décompose les tâches complexes en sous-tâches et les exécute en appelant vos fonctions de robot ou en exécutant le code généré. Par exemple, "mettre la pomme dans le bol" devient une séquence d'étapes de localisation, de saisie et de placement.
Pour en savoir plus sur le fonctionnement de l'appel de fonction avec Gemini, consultez la page Appel de fonction.
Sécurité
Gemini Robotics ER 2 est conçu pour être sûr, mais il est de votre responsabilité de maintenir un environnement sécurisé autour du robot. Les modèles d'IA générative peuvent faire des erreurs, et les robots physiques peuvent causer des dommages. La sécurité est une priorité, et rendre les modèles d'IA générative sûrs lorsqu'ils sont utilisés avec la robotique réelle est un domaine actif et essentiel de nos recherches. Pour en savoir plus, consultez la page sur la sécurité de la robotique de Google DeepMind.
Bonnes pratiques
Suivez ces bonnes pratiques pour obtenir les meilleurs résultats avec Gemini Robotics ER 2 :
Utilisez un langage simple et naturel. Décrivez ce que vous voulez que le robot fasse, comme vous le feriez avec une personne. Si un terme ne fonctionne pas, essayez un synonyme courant.
Optimisez l'entrée visuelle. Recadrez ou zoomez sur les objets petits ou peu clairs avant d'envoyer l'image. La luminosité et un faible contraste des couleurs peuvent affecter la détection.
Décomposez les tâches complexes en étapes. Envoyez chaque étape sous la forme d'une requête distincte pour améliorer la précision de chaque sous-tâche.
Interrogez plusieurs fois et calculez la moyenne des résultats pour les tâches de haute précision. Cette approche consensuelle réduit la variance des résultats spatiaux.
Limites
Tenez compte des limites suivantes lorsque vous développez avec Gemini Robotics ER 2 :
- Latence et performances : les requêtes complexes, les entrées haute résolution ou
thinking_level.HIGHpeuvent entraîner des temps de traitement plus longs. Utilisezthinking_level.MEDIUMpour un bon équilibre entre latence et performances. - Hallucinations : comme tous les grands modèles de langage, Gemini Robotics ER 2 peut parfois "halluciner" ou fournir des informations incorrectes, en particulier pour les requêtes ambiguës ou les entrées hors distribution.
- Dépendance à la qualité de la requête : la qualité de la sortie du modèle dépend fortement de la clarté et de la spécificité de la requête d'entrée. Des prompts vagues ou mal structurés peuvent donner des résultats non optimaux.
- Ressources de calcul : l'exécution du modèle, en particulier avec des entrées vidéo ou
thinking_level.HIGH, consomme des ressources de calcul supplémentaires. Pour en savoir plus, consultez la page Réflexion. Types d'entrées : consultez les rubriques suivantes pour en savoir plus sur les limites de chaque modalité :
Avis de confidentialité
Vous reconnaissez que les modèles référencés dans ce document (les "modèles robotiques") exploitent des données vidéo et audio pour faire fonctionner et déplacer votre matériel conformément à vos instructions. Vous pouvez donc utiliser les Modèles robotiques de manière à ce que des données de personnes identifiables, telles que des données vocales, des images et des données de ressemblance ("Données à caractère personnel"), soient collectées par les Modèles robotiques. Si vous choisissez d'utiliser les Modèles robotiques d'une manière qui collecte des Données à caractère personnel, vous acceptez de ne pas autoriser les personnes identifiables à interagir avec les Modèles robotiques ou à être présentes dans la zone qui les entoure, sauf si ces personnes identifiables ont été suffisamment informées de la collecte et de l'utilisation de leurs Données à caractère personnel et y ont consenti, comme indiqué dans les conditions d'utilisation de la Plate-forme d'agent applicables. Vous devez vous assurer que cet avis autorise la collecte et l'utilisation des Données à caractère personnel comme indiqué dans ces conditions, et vous devez déployer des efforts commercialement raisonnables pour minimiser la collecte et la distribution des Données à caractère personnel en utilisant des techniques telles que le floutage des visages et l'utilisation des Modèles robotiques dans des zones ne contenant pas de personnes identifiables, dans la mesure du possible.
Étapes suivantes
Pour en savoir plus sur Gemini Robotics ER 2, consultez les ressources suivantes :
- Informations sur le modèle Gemini Robotics ER 2 : caractéristiques techniques, limites de jetons et fonctionnalités compatibles.
- Tarifs de Gemini Robotics ER : détails des tarifs sur Agent Platform.
- Raisonnement spatial : pointage, suivi, cadres de délimitation et trajectoires.
- Capacités agentiques : exécution de code, lecture d'instruments et annotation d'images.
- Orchestration des tâches : tâches à long horizon avec des API de robot personnalisées.
- Compréhension des vidéos : recherche de moments et classification de la progression.
- Fiche du modèle Gemini Robotics ER 2 : benchmarks d'évaluation, architecture et détails de l'entraînement.
- Article de blog sur Gemini Robotics ER 2 : annonce et présentation par Google DeepMind.
- Sécurité de la robotique Google DeepMind : recherche sur la sécurité derrière la famille de modèles.