


Gemini Robotics ER es un modelo de lenguaje de visión (VLM) que aporta un razonamiento avanzado sobre el mundo físico a la robótica. El modelo interpreta datos visuales, realiza razonamientos espaciales y temporales, planifica tareas de varios pasos y organiza robots y herramientas.
Modelos
Gemini Robotics ER 2 es una actualización de nuestro modelo de razonamiento que ofrece un razonamiento preciso sobre el entorno físico de un robot. Se especializa en capacidades de razonamiento incorporado, como la organización de agentes de robots (por ejemplo, con modelos de visión, lenguaje y acción [VLA]), la comprensión de videos de robots (incluida la comprensión del progreso y la detección de éxito), la lectura de instrumentos, la señalización y el razonamiento espacial.
El siguiente modelo está disponible en versión preliminar:
gemini-robotics-er-2-preview: Se basa en Gemini 3.5 Flash con un razonamiento espacial mejorado, búsqueda de momentos en videos, clasificación del progreso de videos, organización de varios robots y uso de herramientas de varios pasos. Para conocer las especificaciones técnicas, los límites de tokens y cuotas, las capacidades admitidas, la disponibilidad regional y los precios, consulta la página Información del modelo Gemini Robotics ER 2.
En esta guía, se usa el SDK de IA generativa de Google con
Gemini Enterprise Agent Platform. Cada ejemplo inicializa el
cliente con enterprise=True y se autentica con las credenciales de Google Cloud, para que puedas llamar al modelo con tu propio proyecto de Google Cloud .
Capacidades de robótica
En la siguiente tabla, se resumen las capacidades principales de Gemini Robotics ER 2:
| Función | Descripción | Guía |
|---|---|---|
| Razonamiento espacial | Señala objetos, haz un seguimiento de ellos en videos, detecta con cuadros delimitadores y planifica trayectorias. | Razonamiento espacial |
| Ejecución de código de agentes | Usa la ejecución de código para acercar o recortar imágenes, leer instrumentos y anotar escenas. | Capacidades de agente |
| Organización de tareas | Combina el razonamiento espacial con APIs de robots personalizadas para completar tareas de largo horizonte. | Organización de tareas |
| Comprensión de videos | Búsqueda de momentos y clasificación del progreso a partir de feeds de video continuos | Comprensión de videos |
Antes de comenzar
Agent Platform se autentica con credenciales de Google Cloud, no con una clave de API de Gemini. Completa la siguiente configuración antes de ejecutar los ejemplos:
Instala el SDK de IA generativa de Google.
pip install --upgrade google-genaiHabilita la API en tu proyecto de Google Cloud y asegúrate de tener un ID del proyecto. Puedes usar un proyecto existente o crear uno nuevo.
Autentica con las credenciales predeterminadas de la aplicación (ADC). Para el desarrollo local, ejecuta lo siguiente:
gcloud auth application-default loginInicializa el cliente con el backend de Agent Platform. Todos los ejemplos de Python de esta página usan el siguiente cliente, por lo que debes establecer tu propio ID del proyecto:
from google import genai

client = genai.Client(
    enterprise=True,
    project="your-project-id",
    location="global",
)
Como alternativa, puedes establecer la variable de entorno
GOOGLE_GENAI_USE_ENTERPRISE=Trueen lugar de pasarenterprise=Trueal cliente.
Comenzar
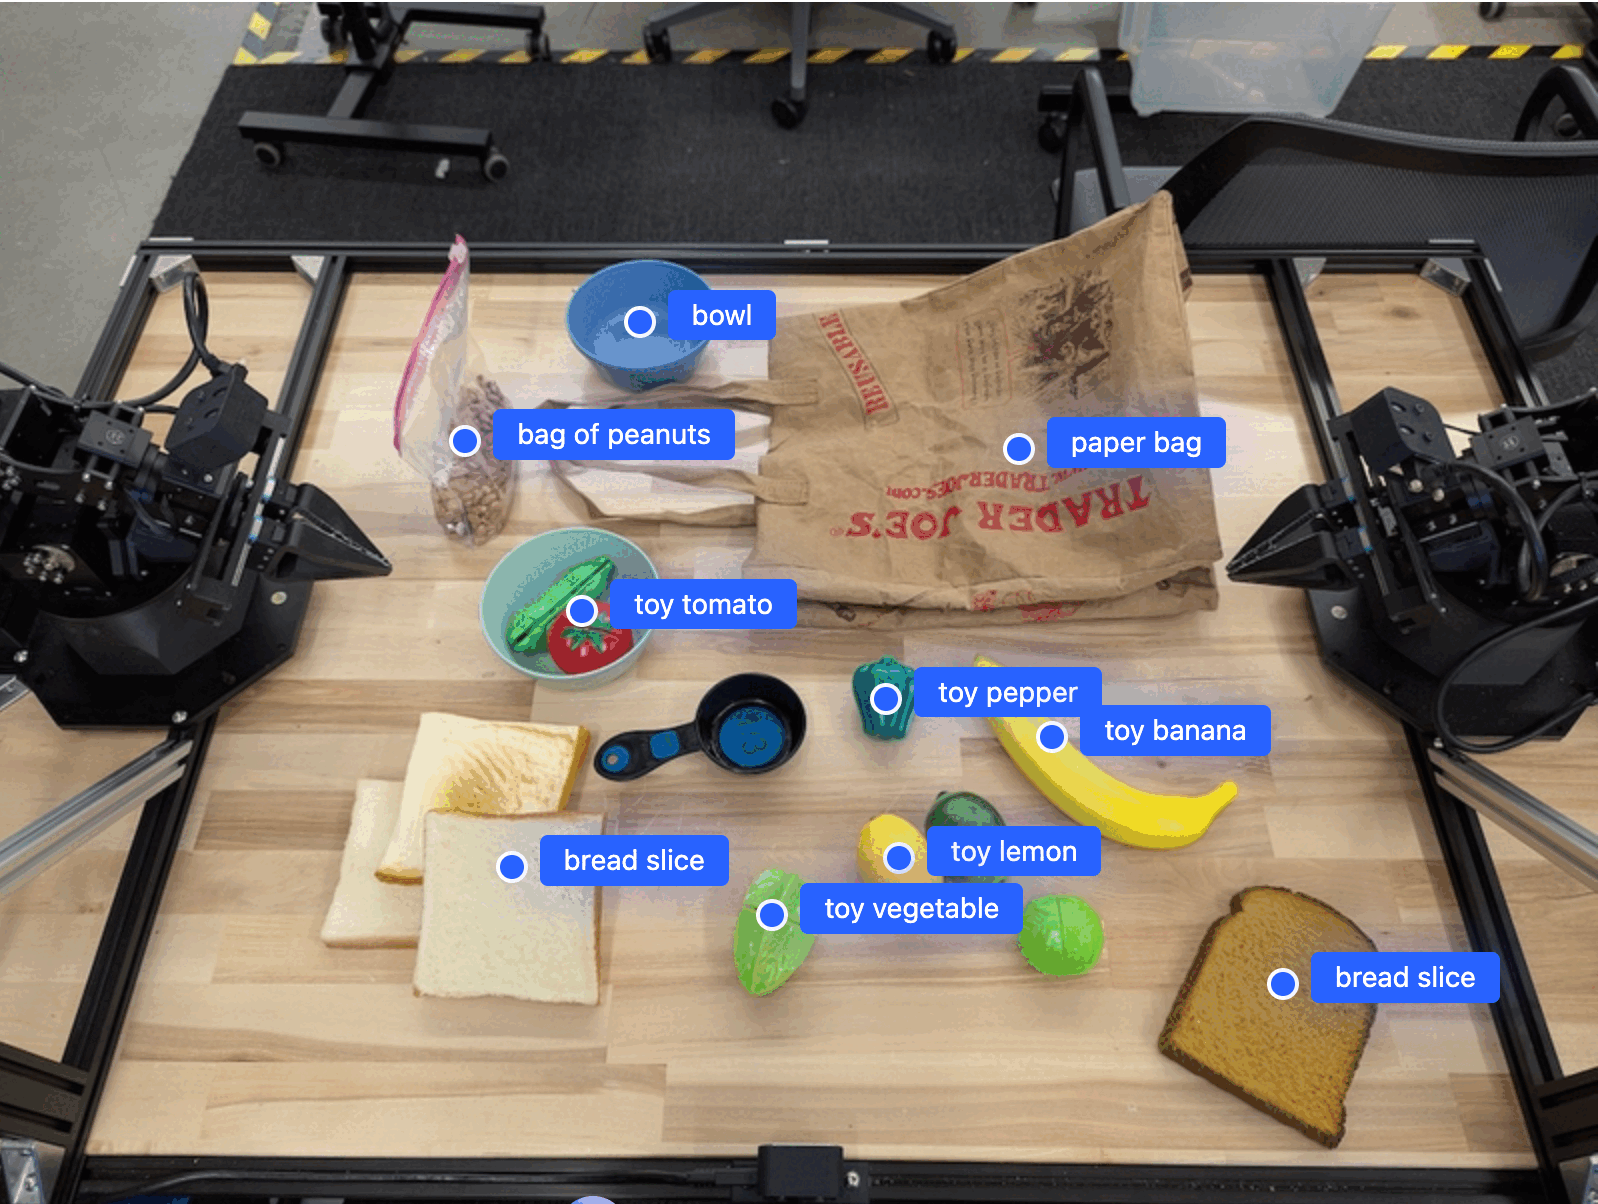
En el siguiente ejemplo, se encuentran objetos en una imagen y se devuelven sus etiquetas y coordenadas 2D normalizadas. Puedes pasar este resultado directamente a una API de robótica o a un modelo de visión, lenguaje y acción (VLA) para generar acciones de robots.
Python
from google import genai
from google.genai import types

PROMPT = """
          Point to no more than 10 items in the image. The label returned
          should be an identifying name for the object detected.
          The answer should follow the json format: [{"point": <point>,
          "label": <label1>}, ...]. The points are in [y, x] format
          normalized to 0-1000.
        """
client = genai.Client(
    enterprise=True,
    project="your-project-id",
    location="global",
)

# Load your image
with open("my-image.png", 'rb') as f:
    image_bytes = f.read()

image_response = client.models.generate_content(
    model="gemini-robotics-er-2-preview",
    contents=[
        types.Part.from_bytes(
            data=image_bytes,
            mime_type='image/png',
        ),
        PROMPT
    ],
    config = types.GenerateContentConfig(
        temperature=1.0,
        thinking_config=types.ThinkingConfig(
            thinking_level=types.ThinkingLevel.HIGH
        ),
    )
)

print(image_response.text)
REST
# First, ensure you have the image file locally.
# Encode the image to base64
IMAGE_BASE64=$(base64 -w 0 my-image.png)

# Set your Google Cloud project and location.
export PROJECT_ID="your-project-id"
export LOCATION="global"
export MODEL="gemini-robotics-er-2-preview"

# For the "global" location, use the aiplatform.googleapis.com host.
# For a regional location, prefix the host with the region, for example:
# https://us-central1-aiplatform.googleapis.com

curl -X POST \
  "https://aiplatform.googleapis.com/v1/projects/${PROJECT_ID}/locations/${LOCATION}/publishers/google/models/${MODEL}:generateContent" \
  -H "Authorization: Bearer $(gcloud auth application-default print-access-token)" \
  -H "Content-Type: application/json" \
  -d '{
    "contents": [
      {
        "parts": [
          {
            "inlineData": {
              "mimeType": "image/png",
              "data": "'"${IMAGE_BASE64}"'"
            }
          },
          {
            "text": "Point to no more than 10 items in the image. The label returned should be an identifying name for the object detected. The answer should follow the json format: [{\"point\": [y, x], \"label\": <label1>}, ...]. The points are in [y, x] format normalized to 0-1000."
          }
        ]
      }
    ],
    "generationConfig": {
      "temperature": 1.0,
      "thinkingConfig": {
        "thinkingLevel": "HIGH"
      }
    }
  }'
El resultado será un array JSON que contendrá objetos, cada uno con un point
(coordenadas [y, x] normalizadas) y un label que identificará el objeto.
JSON
[
  {"point": [376, 508], "label": "small banana"},
  {"point": [287, 609], "label": "larger banana"},
  {"point": [223, 303], "label": "pink starfruit"},
  {"point": [435, 172], "label": "paper bag"},
  {"point": [270, 786], "label": "green plastic bowl"},
  {"point": [488, 775], "label": "metal measuring cup"},
  {"point": [673, 580], "label": "dark blue bowl"},
  {"point": [471, 353], "label": "light blue bowl"},
  {"point": [492, 497], "label": "bread"},
  {"point": [525, 429], "label": "lime"}
]
En la siguiente imagen, se muestra un ejemplo de cómo se pueden mostrar estos puntos:
Cómo funciona
Gemini Robotics ER 2 toma entradas de imagen, video o audio con instrucciones en lenguaje natural. Identifica objetos, razona sobre el contexto de la escena y las relaciones espaciales, y devuelve un resultado estructurado, como coordenadas o cuadros delimitadores.
También es agéntico: desglosa tareas complejas en subtareas y las ejecuta llamando a tus funciones de robot o ejecutando el código generado. Por ejemplo, "coloca la manzana en el tazón" se convierte en una secuencia de pasos de ubicación, agarre y colocación.
Obtén más información sobre cómo funciona la llamada a funciones con Gemini en la página Llamada a funciones.
Seguridad
Gemini Robotics ER 2 se diseñó pensando en la seguridad, pero es tu responsabilidad mantener un entorno seguro alrededor del robot. Los modelos de IA generativa pueden cometer errores, y los robots físicos pueden causar daños. La seguridad es una prioridad, y hacer que los modelos de IA generativa sean seguros cuando se usan con robótica del mundo real es un área activa y fundamental de nuestra investigación. Para obtener más información, visita la página de seguridad de la robótica de Google DeepMind.
Prácticas recomendadas
Sigue estas prácticas recomendadas para obtener los mejores resultados de Gemini Robotics ER 2:
Usa un lenguaje sencillo y natural. Describe lo que quieres que haga el robot como lo harías con una persona. Si un término no funciona, prueba con un sinónimo común.
Optimizar la entrada visual Recorta o acerca los objetos pequeños o poco claros antes de enviar la imagen. La iluminación y el contraste de color bajo pueden afectar la detección.
Divide las tareas complejas en pasos. Envía cada paso como una instrucción independiente para mejorar la precisión en cada subtarea.
Realiza consultas varias veces y promedia los resultados para las tareas de alta precisión. Este enfoque de consenso reduce la varianza en los resultados espaciales.
Limitaciones
Ten en cuenta las siguientes limitaciones cuando desarrolles con Gemini Robotics ER 2:
- Latencia frente a rendimiento: Las consultas complejas, las entradas de alta resolución o
thinking_level.HIGHpueden aumentar los tiempos de procesamiento. Usathinking_level.MEDIUMpara lograr un buen equilibrio entre la latencia y el rendimiento. - Alucinaciones: Al igual que todos los modelos de lenguaje grandes, Gemini Robotics ER 2 puede, en ocasiones, "alucinar" o proporcionar información incorrecta, en especial en el caso de instrucciones ambiguas o entradas fuera de distribución.
- Dependencia de la calidad de la instrucción: La calidad del resultado del modelo depende en gran medida de la claridad y especificidad de la instrucción de entrada. Las instrucciones vagas o mal estructuradas pueden generar resultados deficientes.
- Recursos de procesamiento: Ejecutar el modelo, en especial con entradas de video
o
thinking_level.HIGH, consume recursos de procesamiento adicionales. Consulta la página Pensamiento para obtener más detalles. Tipos de entrada: Consulta los siguientes temas para obtener detalles sobre las limitaciones de cada modalidad:
Aviso de privacidad
Reconoces que los modelos a los que se hace referencia en este documento (los "Modelos de Robótica") aprovechan los datos de video y audio para operar y mover tu hardware de acuerdo con tus instrucciones. Por lo tanto, puedes operar los Modelos de Robótica de modo que los datos de personas identificables, como los datos de voz, imágenes y semejanza ("Datos Personales"), se recopilen con los Modelos de Robótica. Si decides operar los Modelos de Robótica de una manera que recopile Datos Personales, aceptas que no permitirás que ninguna persona identificable interactúe con los Modelos de Robótica ni esté presente en el área circundante, a menos que esas personas identificables hayan recibido una notificación suficiente y hayan dado su consentimiento para la recopilación y el uso de sus Datos Personales, como se describe en las condiciones del servicio aplicables de la Plataforma de Agentes. Te asegurarás de que dicho aviso permita la recopilación y el uso de Datos Personales, tal como se describe en esas condiciones, y realizarás esfuerzos comercialmente razonables para minimizar la recopilación y distribución de Datos Personales mediante el uso de técnicas como el desenfoque de rostros y el funcionamiento de los Modelos de Robótica en áreas que no contengan personas identificables en la medida de lo posible.
¿Qué sigue?
Para obtener más información sobre Gemini Robotics ER 2, consulta los siguientes recursos:
- Información del modelo Gemini Robotics ER 2: especificaciones técnicas, límites de tokens y capacidades compatibles.
- Precios de Gemini Robotics ER: Detalles de precios en Agent Platform.
- Razonamiento espacial: señalamiento, seguimiento, cuadros delimitadores y trayectorias.
- Capacidades de agente: ejecución de código, lectura de instrumentos y anotación de imágenes.
- Organización de tareas: Tareas de largo horizonte con APIs de robots personalizadas.
- Comprensión de videos: búsqueda de momentos y clasificación del progreso.
- Tarjeta de modelo de Gemini Robotics ER 2: comparativas de evaluación, arquitectura y detalles de entrenamiento.
- Entrada de blog de Gemini Robotics ER 2: anuncio y descripción general de Google DeepMind.
- Seguridad de la robótica de Google DeepMind: Investigación de seguridad detrás de la familia de modelos.