


Agent Platform은 프로젝트에서 제공하는 모든 추론 요청에 대해 하나의 구조화된 로그 항목을 작성할 수 있습니다. 각 항목은 모델, 리전, 토큰 수 (입력 토큰, 출력 토큰, 캐시된 토큰, 사고 토큰 포함), 프로비저닝된 처리량 소진, 엔드 투 엔드 요청 지연 시간, 오류 코드, 연결하는 헤더 라벨 또는 요청 라벨 등 요청에 대한 메타데이터를 기록합니다. 항목은 Cloud Logging으로 이동하며 Observability Analytics에서 SQL을 사용하여 쿼리할 수 있습니다. 로깅을 사용 설정하려면 추론 요청 메타데이터 로그 사용 설정을 참조하세요.
추론 요청 로깅은 메타데이터만 기록합니다. 프롬프트나 대답을 기록하지 않습니다. 프롬프트 및 응답 콘텐츠가 필요한 경우 대신 요청-응답 로깅을 사용하세요.
이 페이지에서는 추론 요청 메타데이터 로그를 사용 설정하는 방법, 각 항목에 포함된 내용, 쿼리 방법을 설명합니다.
사용 사례
추론 요청 메타데이터 로그는 집계 측정항목으로 답할 수 없는 질문에 답합니다.
- 각 요청에 자체 헤더 라벨, 요청 라벨 또는 둘 다를 연결하여 토큰 지출을 팀, 애플리케이션 또는 테넌트에 할당합니다.
- 프로비저닝된 처리량 할당량에 포함된 개별 요청과 주문형으로 제공된 요청을 확인합니다.
- 헤더 라벨 또는 요청 라벨별로 처리량, 지연 시간, 오류율을 세분화합니다.
- 집계가 아닌 요청별로 캐싱 동작을 측정합니다.
- 프로젝트에서 429 오류가 발생한 이유 또는 프로비저닝된 처리량이 초과된 이유와 같은 두 번째 수준의 사용량에 대한 가시성을 확보합니다. 429 오류를 해결하는 단계는 오류 코드 429 문제 해결을 참조하세요. 오류가 발생한 초를 확인하려면 리전별 오류율 및 지연 시간을 참고하세요.
로깅에 지원되는 API 메서드
추론 요청 메타데이터 로그는 다음에 대해 지원됩니다.
generateContent또는streamGenerateContent를 사용하는 Gemini 모델(해당 메서드를 통한 이미지 생성 포함)rawPredict또는streamRawPredict를 사용하는 Claude 모델 다른 파트너 모델은 로깅되지 않습니다. Claude 필드 이름은 Claude 모델의 토큰 수를 참조하세요.
프로비저닝된 처리량과 모든 사용한 만큼만 지불 옵션이 지원됩니다.
다음은 지원되지 않습니다.
chatCompletions개embedContent,predict,countTokensImagen과 같이predict를 통해 이미지를 생성하는 모델은 로깅되지 않습니다.- 지도 미세 조정을 사용하여 조정된 Gemini 모델을 포함하여 미세 조정된 모델에 대한 요청
- 조정 작업, 일괄 추론, 기타 장기 실행 작업
- 커스텀 컨테이너에 직접 배포하는 모델
추론 요청 메타데이터 로그 사용 설정
전체 프로젝트 또는 특정 리전의 특정 모델에 대해 추론 요청 메타데이터 로그를 구성할 수 있습니다. 조직 수준에서 사용 설정해야 하는 경우 계정팀에 문의하세요. 로깅 구성이 적용되는 데 몇 분 정도 걸릴 수 있습니다.
시작하기 전에
- 프로젝트에 다음 IAM 권한이 있는지 확인합니다. 설정을 변경하고 읽을 수 있는
aiplatform.endpoints.setPublisherModelConfig및aiplatform.endpoints.fetchPublisherModelConfig, 로그 버킷을 업그레이드할 수 있는logging.buckets.get,logging.buckets.list,logging.buckets.update,logging.operations.get. 이러한 권한이 포함된 사전 정의된 역할은 액세스 제어 및 Logging 액세스 제어를 참조하세요. _Default로그 버킷을 Observability Analytics로 업그레이드할지 여부를 결정합니다. SQL로 항목을 쿼리하거나 Google Cloud 콘솔에서 세부 측정항목을 보려면 업그레이드해야 합니다. 업그레이드하는 데 몇 분 정도 걸리며 실행취소할 수 없습니다. 업그레이드 전에 작성된 항목은 나중에 SQL로 쿼리할 수 없습니다.- Cloud Logging 가격 책정을 검토하세요. 항목은 버킷의 보관 기간(기본값: 30일) 동안 저장되며 Cloud Logging 수집 및 스토리지 요금이 적용됩니다. 비용을 추정하려면 가격 책정을 참조하세요.
콘솔에서 사용 설정
콘솔에서 사용 설정하면 프로젝트의 모든 모델(Gemini 및 Claude)에 대해 프로비저닝된 처리량과 로그가 지원하는 모든 사용한 만큼만 지불 옵션에서 로깅이 사용 설정됩니다. 또한 _Default 로그 버킷이 업그레이드되지 않은 경우 업그레이드합니다. 구성 우선순위에 설명된 프로젝트 전체 기본값을 설정합니다. 시작하기 전에 권한 및 버킷 업그레이드를 확인하세요.
Google Cloud 콘솔에서 프로비저닝된 처리량 페이지로 이동합니다.
다음 중 하나를 수행합니다.
- Gemini Enterprise Agent Platform에서 모니터링 가능성을 업그레이드하고 있습니다라는 배너에서 사용 설정을 클릭합니다.
- 툴바에서 측정항목 설정을 클릭합니다. 상세 측정항목 사용 설정을 선택한 후 저장을 클릭합니다.

그림 1. 프로비저닝된 처리량 페이지의 모니터링 가능성 업그레이드 배너 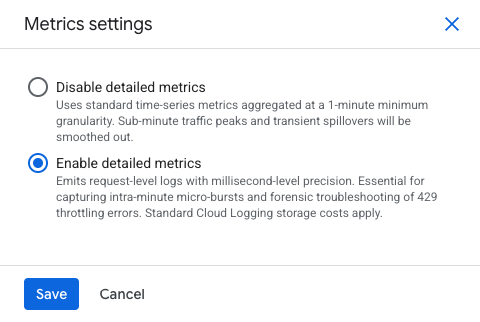
그림 2. 세부 측정항목 사용 설정이 선택된 측정항목 설정 패널 상세 측정항목을 사용 설정하시겠어요? 대화상자에서 로깅 및 버킷 업그레이드 세부정보를 검토한 후 사용 설정을 클릭합니다.
로깅이 사용 설정되면 대화상자가 닫힙니다. 버킷 업그레이드는 백그라운드에서 계속되며 몇 분 정도 걸릴 수 있습니다. 실행되는 동안 배너에 '세부 측정항목이 사용 설정되었으며 이 프로젝트의 _Default 로그 버킷을 Observability Analytics로 업그레이드 중입니다.'라는 메시지가 표시됩니다.
대신 배너에 버킷이 업그레이드되지 않았다고 표시되면 업그레이드를 클릭하여 다시 시도합니다. 버킷을 업그레이드할 수 없다고 보고되면 요청별 로그를 쿼리할 수 없습니다. 측정항목 설정을 클릭하고 세부 측정항목 사용 중지를 선택하여 요금 청구를 중지합니다.
구성 우선순위
Agent Platform은 다음 순서로 각 요청의 설정을 확인합니다.
- 모델별 및 리전별 설정(설정된 경우)
- 모델별 설정이 설정되지 않은 경우 프로젝트 전체 기본값입니다.
- 둘 다 설정되어 있지 않으면 로깅이 사용 중지됩니다.
모델별 설정이 프로젝트 기본값보다 우선 적용됩니다. 프로젝트 전체에서 로깅을 사용 설정하고 한 리전의 대용량 모델 하나에 대해 로깅을 사용 중지하거나 그 반대로 할 수 있습니다.
REST API를 사용하여 사용 설정
setPublisherModelConfig 메서드를 사용하여 추론 요청 메타데이터 로그를 구성하고 inferenceEventLoggingConfig.state를 ENABLED로 설정합니다.
프로젝트 전체 기본값을 설정하려면 프로젝트를 지정합니다.
curl -X POST \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://aiplatform.googleapis.com/v1beta1/projects/PROJECT_ID:setPublisherModelConfig" \
  -d '{
        "publisherModelConfig": {
          "inferenceEventLoggingConfig": {"state": "ENABLED"}
        },
        "updateMask": "inferenceEventLoggingConfig"
      }'
한 리전에서 하나의 모델을 재정의하려면 게시자 모델을 지정합니다.
curl -X POST \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://aiplatform.googleapis.com/v1beta1/projects/PROJECT_ID/locations/LOCATION/publishers/PUBLISHER/models/MODEL:setPublisherModelConfig" \
  -d '{
        "publisherModelConfig": {
          "inferenceEventLoggingConfig": {"state": "ENABLED"}
        },
        "updateMask": "inferenceEventLoggingConfig"
      }'
Gemini 모델의 경우 PUBLISHER를 google로, Claude 모델의 경우 anthropic로 설정합니다. 예를 들어 전역 엔드포인트에서 Claude Sonnet 4.5에 대한 로깅을 사용 설정하려면 LOCATION를 global로 설정하여 publishers/anthropic/models/claude-sonnet-4-5를 사용합니다. Claude 모델 ID는 Claude 모델을 참조하세요.
이 메서드는 장기 실행 작업을 반환합니다.
로깅 구성 가져오기
fetchPublisherModelConfig 메서드로 현재 구성을 읽습니다. 프로젝트를 사용하여 프로젝트 전체 기본값을 읽거나 게시자 모델을 사용하여 재정의를 읽습니다.
curl -X GET \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  "https://aiplatform.googleapis.com/v1beta1/projects/PROJECT_ID:fetchPublisherModelConfig"
curl -X GET \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  "https://aiplatform.googleapis.com/v1beta1/projects/PROJECT_ID/locations/LOCATION/publishers/PUBLISHER/models/MODEL:fetchPublisherModelConfig"
응답에는 해당 리소스에 설정된 설정이 포함됩니다.
{
  "inferenceEventLoggingConfig": {
    "state": "ENABLED"
  }
}
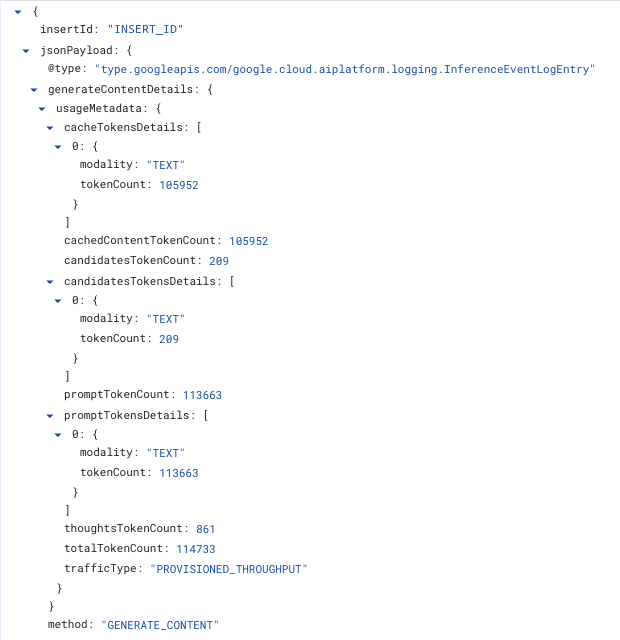
로깅이 작동하는지 확인
- 사용 설정한 모델에 요청을 하나 보냅니다.
로그 탐색기에서 다음 쿼리를 실행합니다. 대부분의 항목은 12초 이내에 표시되지만 최대 5분까지 걸릴 수 있습니다.
logName="projects/PROJECT_ID/logs/aiplatform.googleapis.com%2Finference_request"SQL이 작동하는지 확인하려면 Observability Analytics를 열고 예시 쿼리를 실행합니다. 쿼리에서 데이터 세트를 찾을 수 없다고 보고하면 로그 버킷 업그레이드가 완료되지 않은 것입니다.
로깅 중지
Google Cloud 콘솔에서 프로비저닝된 처리량 페이지로 이동하고 측정항목 설정을 클릭하고 상세 측정항목 사용 중지를 선택한 후 저장을 클릭합니다. 이렇게 하면 콘솔에서 사용 설정이 취소됩니다.
REST API를 사용하는 경우 다음 단계를 따르세요.
로깅을 사용 설정한 동일한 리소스에서 inferenceEventLoggingConfig.state를 DISABLED로 설정하여 로깅을 사용 중지합니다.
curl -X POST \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://aiplatform.googleapis.com/v1beta1/projects/PROJECT_ID:setPublisherModelConfig" \
  -d '{
        "publisherModelConfig": {
          "inferenceEventLoggingConfig": {"state": "DISABLED"}
        },
        "updateMask": "inferenceEventLoggingConfig"
      }'
모델별 설정이 프로젝트 기본값보다 우선 적용되므로 프로젝트 수준에서 사용 중지해도 명시적으로 사용 설정된 모델은 사용 중지되지 않습니다. 모델별 설정도 삭제하거나 사용 중지합니다.
로그가 작성되는 위치
항목은 다음 로그에 기록됩니다.
projects/PROJECT_NUMBER/logs/aiplatform.googleapis.com%2Finference_request
여기에서 표준 Cloud Logging 대상을 사용할 수 있습니다.
- Observability Analytics:Google Cloud 콘솔의 Observability Analytics에서 SQL을 사용하여 항목을 쿼리합니다.
- 연결된 BigQuery 데이터 세트: BigQuery에서 동일한 데이터를 읽도록 데이터 세트를 연결합니다. 자세한 내용은 연결된 BigQuery 데이터 세트 쿼리를 참조하세요.
- 집계 싱크: 단일 싱크를 사용하여 폴더 또는 조직의 모든 프로젝트에서 항목을 수집합니다.
logName="projects/*/logs/aiplatform.googleapis.com%2Finference_request"필터링
폴더 또는 조직의 모든 프로젝트에서 항목을 수집하려면 집계 싱크 개요를 참조하세요.
요청이 완료된 후 잠시 후에 항목을 쿼리할 수 있습니다. 대부분의 항목은 12초 이내에 쿼리할 수 있습니다. 최대 5분까지 허용됩니다.
로그 항목 스키마
각 항목에는 별도로 쿼리하는 두 부분이 있습니다. 요청을 처리한 항목을 식별하는 모니터링 리소스 및 해당 라벨과 요청이 수행한 작업을 기록하는 JSON 페이로드입니다. 다음 섹션에서는 두 가지를 모두 설명합니다.
리소스 라벨
공유 게시자 모델의 경우 모니터링 리소스 유형은 aiplatform.googleapis.com/PublisherModel이며 다음 라벨이 있습니다.
| 라벨 | 유형 | 참고 |
|---|---|---|
resource_container |
STRING |
요청을 제공한 프로젝트입니다. |
location |
STRING |
요청을 제공한 리전입니다(예: us-central1). 전역 엔드포인트로 전송된 요청은 global를 보고합니다. |
publisher |
STRING |
모델 게시자입니다(예: google 또는 anthropic). |
model_user_id |
STRING |
모델(예: gemini-2.5-pro) |
페이로드 필드
| 필드 이름 | 유형 | 참고 |
|---|---|---|
method |
ENUM |
GENERATE_CONTENT, STREAM_GENERATE_CONTENT, RAW_PREDICT 또는 STREAM_RAW_PREDICT |
trafficType |
ENUM |
요청을 처리한 소비 옵션입니다. 현재 값은 PROVISIONED_THROUGHPUT, ON_DEMAND, ON_DEMAND_FLEX, ON_DEMAND_PRIORITY입니다. 실패한 요청에는 없습니다. |
requestStartTime |
TIMESTAMP |
서빙 프런트엔드가 요청을 허용한 시간입니다. |
requestDuration |
STRING |
3.53s와 같은 기간 문자열 형식의 엔드 투 엔드 서빙 지연 시간입니다. |
generateContentDetails.usageMetadata |
JSON |
generateContent 및 streamGenerateContent의 토큰 수(형식별 분류 포함) 이미지 출력은 candidatesTokensDetails의 IMAGE 항목으로 여기에 표시됩니다. |
rawPredictDetails.usageMetadata |
JSON |
파트너 모델을 포함한 rawPredict 및 streamRawPredict의 토큰 수입니다. |
provisionedThroughput |
JSON |
프로비저닝된 처리량 트래픽에 표시됩니다. |
httpHeaders |
JSON |
캡처된 요청 헤더입니다. |
error |
JSON |
심각도가 ERROR인 경우에만 표시됩니다. |
principal |
JSON |
요청을 실행한 서비스 계정입니다(사용 가능한 경우). |
LogEntry.labels 필드에는 OpenTelemetry 생성형 AI 시맨틱 규칙을 따르는 gen_ai.operation.name가 포함됩니다. generateContent 및 streamGenerateContent 모두 generate_content를 보고합니다. rawPredict 및 streamRawPredict 모두 raw_predict를 보고합니다.
프로비저닝된 처리량 필드
| 필드 이름 | 유형 | 참고 |
|---|---|---|
ptChargedInputTokenCount |
INT64 |
소진율이 적용된 후 프로비저닝된 처리량 할당량에 반영되는 입력 토큰입니다. |
ptChargedOutputTokenCount |
INT64 |
소진율이 적용된 후 프로비저닝된 처리량 할당량에 반영되는 출력 토큰입니다. |
accountingResource |
STRING |
요청이 사용한 프로비저닝된 처리량 약정이 있는 프로젝트입니다. |
오버플로 요청 식별
프로비저닝된 처리량에 적합하지만 처리량이 소진되어 온디맨드로 제공된 경우 요청이 초과됩니다. 오버플로 항목에는 ON_DEMAND의 trafficType가 있고 provisionedThroughput 객체가 없습니다. 일반적인 사용한 만큼만 지불 요청도 동일하게 표시되므로 다음 규칙을 사용하여 구분하세요.
shared값으로X-Vertex-AI-LLM-Request-Type를 전송한 경우 요청을 사용한 만큼만 지불로 의도적으로 라우팅한 것입니다. 스필오버가 아닙니다.X-Vertex-AI-LLM-Request-Type헤더를 전송하지 않았거나dedicated또는shared이외의 값을 전송했고 항목이ON_DEMAND를 보고하는 경우 해당 리전의 해당 모델에 프로비저닝된 처리량이 있으면 요청이 오버플로된 것입니다.- 모델에 프로비저닝된 처리량이 없으면 모든
ON_DEMAND항목은 일반적인 사용한 만큼만 지불입니다.
헤더 값은 프로비저닝된 처리량 사용을 참조하세요.
오버플로 요청을 계산하는 쿼리는 분당 오버플로를 참조하세요.
다운그레이드된 요청 식별
사용한 만큼만 지불하는 옵션 하나를 요청했는데 다른 옵션으로 제공된 경우 요청이 다운그레이드됩니다. 전송한 X-Vertex-AI-LLM-Shared-Request-Type 헤더를 요청을 처리한 trafficType와 비교합니다.
| 전송한 헤더 값 | 요청에 따라 게재되는 경우 trafficType |
|---|---|
priority |
ON_DEMAND_PRIORITY |
flex |
ON_DEMAND_FLEX |
성공적인 항목에 다른 trafficType가 있으면 요청이 다운그레이드되었거나 모델에서 요청한 옵션을 제공하지 않는다는 의미입니다. 쿼리는 모델별 다운그레이드를 참조하세요.
오류 코드
실패한 요청은 ERROR 심각도로 작성되며 gRPC 상태 코드와 표준 이유가 있는 error 객체를 전달합니다. 이유는 고정 문자열입니다. 프롬프트 텍스트, 대답 텍스트 또는 헤더 값은 포함되지 않습니다.
| 코드 | 상태 | 일반적인 HTTP 상태 |
|---|---|---|
8 |
리소스가 소진되었습니다(예: 할당량 한도). | 429 |
4 |
작업이 완료되기 전에 기한이 지났습니다. | 504 |
14 |
서비스를 사용할 수 없습니다. | 503 |
13 |
내부 오류가 발생함 | 500 |
3 |
요청에 잘못된 인수가 포함되어 있습니다. | 400 |
7 |
호출자에게 권한이 없습니다. | 403 |
5 |
요청된 항목을 찾을 수 없습니다. | 404 |
커스텀 헤더 라벨 연결
팀, 애플리케이션 또는 테넌트와 같은 자체 측정기준에 사용량을 기여 분석하려면 x-goog-agent-platform-observability-label- 프리픽스가 있는 요청 헤더를 전송합니다.
x-goog-agent-platform-observability-label-team: payments
x-goog-agent-platform-observability-label-application: invoice-ocr
각 헤더는 jsonPayload.httpHeaders 아래의 항목에 표시됩니다. 헤더 라벨은 generateContent 및 streamGenerateContent가 있는 Gemini 모델과 rawPredict 및 streamRawPredict가 있는 Claude 모델, 프로비저닝된 처리량 및 모든 사용한 만큼만 지불 옵션에서 작동합니다.
헤더 라벨이 있는 API 호출, 생성되는 로그 항목, 지원되는 모델, 한도, 헤더 라벨과 요청 라벨의 비교 예시는 커스텀 메타데이터 라벨을 참조하세요. 쿼리하려면 커스텀 헤더 라벨별 사용량을 참고하세요.
로그 탐색기로 로그 쿼리
로그 탐색기를 사용하여 개별 추론 요청을 찾고 검사합니다. 로깅을 사용 설정하는 것 외에는 설정이 필요하지 않으며 로그를 직접 읽으므로 항목이 도착하는 즉시 표시됩니다.
Google Cloud 콘솔에서 로그 탐색기 페이지로 이동하고 Logging 쿼리 언어를 사용하여 쿼리 편집기 필드에 쿼리를 입력합니다. 창 및 컨트롤에 대한 자세한 내용은 로그 탐색기 인터페이스를 참조하세요.
프로젝트의 모든 추론 요청 항목을 선택하는 로그 이름부터 시작합니다.
logName="projects/PROJECT_ID/logs/aiplatform.googleapis.com%2Finference_request"
검색어를 추가하여 결과 범위를 좁힙니다. 별도의 줄에 있는 용어는 AND로 결합됩니다.
- 한 리전에서 제공되는 요청을 선택하려면
resource.labels.location="us-central1"를 추가합니다. - API 메서드 하나를 선택하려면
jsonPayload.method="GENERATE_CONTENT"를 추가합니다. - 프로비저닝된 처리량 트래픽만 선택하려면
jsonPayload.trafficType="PROVISIONED_THROUGHPUT"를 추가합니다. - 할당량 오류만 선택하려면
severity=ERROR및jsonPayload.error.code=8를 추가합니다. - 커스텀 헤더 라벨 값 하나를 선택하려면
jsonPayload.httpHeaders."x-goog-agent-platform-observability-label-team".values="payments"를 추가합니다.
로그 탐색기에서 항목을 필터링하고 표시합니다. 집계하지 않습니다. 항목을 집계, 그룹화 또는 차트화하려면 Observability Analytics를 사용하세요. 쿼리 결과 툴바에서 결과 분석을 클릭하여 현재 쿼리를 전달합니다. 이 버튼은 로그 버킷이 업그레이드된 후에만 표시됩니다.
Observability Analytics로 로그 쿼리 및 분석
Observability Analytics를 사용하여 로그를 쿼리하고 분석할 수 있습니다.
시작하기 전에
Observability Analytics는 로그 탐색기에서 답할 수 없는 질문에 답합니다. 로그 탐색기는 개별 항목을 찾아 표시하므로 하나의 요청을 추적할 때 유용합니다. Observability Analytics는 전체 세트에서 SQL을 실행하므로 백분위수를 계산, 그룹화, 조인, 연산할 수 있습니다. 이 섹션의 모든 질문에는 집계가 필요합니다. 팀별 지출, 프로젝트별 번다운, 리전별 p95 지연 시간은 한 번에 하나의 항목으로 답변할 수 없습니다.
이렇게 하려면 프로젝트의 _Default 로그 버킷을 업그레이드하여 Observability Analytics를 사용해야 합니다. 자세한 내용은 로그 버킷 구성을 참조하세요.
다음 예시는 Observability Analytics에서 실행됩니다. PROJECT_ID를 프로젝트로 바꿉니다.
리전 및 모델별 처리량
SELECT
  JSON_VALUE(resource.labels.location)      AS region,
  JSON_VALUE(resource.labels.model_user_id) AS model,
  JSON_VALUE(json_payload.trafficType)      AS traffic_type,
  COUNT(*)                                  AS requests,
  SUM(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.promptTokenCount) AS INT64))     AS input_tokens,
  SUM(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.candidatesTokenCount) AS INT64)) AS output_tokens
FROM `PROJECT_ID.global._Default._Default`
WHERE log_id = "aiplatform.googleapis.com/inference_request"
  AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 24 HOUR)
GROUP BY region, model, traffic_type
ORDER BY requests DESC
프로젝트별 프로비저닝된 처리량 소진
SELECT
  JSON_VALUE(resource.labels.location) AS region,
  JSON_VALUE(json_payload.provisionedThroughput.accountingResource) AS pt_project,
  COUNTIF(JSON_VALUE(json_payload.trafficType) = "PROVISIONED_THROUGHPUT") AS pt_requests,
  COUNTIF(JSON_VALUE(json_payload.trafficType) = "ON_DEMAND")              AS on_demand_requests,
  SUM(CAST(JSON_VALUE(json_payload.provisionedThroughput.ptChargedInputTokenCount)  AS INT64)) AS pt_input_tokens,
  SUM(CAST(JSON_VALUE(json_payload.provisionedThroughput.ptChargedOutputTokenCount) AS INT64)) AS pt_output_tokens
FROM `PROJECT_ID.global._Default._Default`
WHERE log_id = "aiplatform.googleapis.com/inference_request"
  AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 24 HOUR)
GROUP BY region, pt_project
ORDER BY pt_input_tokens DESC
커스텀 헤더 라벨별 사용량
SELECT
  JSON_VALUE(json_payload.httpHeaders
    ["x-goog-agent-platform-observability-label-team"].values[0]) AS team,
  COUNT(*) AS requests,
  SUM(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.totalTokenCount) AS INT64)) AS total_tokens
FROM `PROJECT_ID.global._Default._Default`
WHERE log_id = "aiplatform.googleapis.com/inference_request"
  AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 7 DAY)
GROUP BY team
ORDER BY total_tokens DESC
Gemini와 Claude의 분당 사용 토큰 수 비교
이 쿼리는 게시자당 하나의 열에 분당 소비된 토큰을 보고합니다. 각 열은 publisher/online_serving/consumed_token_throughput 측정항목이 해당 게시자에 대해 수행하는 것과 동일한 방식으로 토큰 유형에 가중치를 부여하므로 각 열은 Cloud Monitoring과 일치합니다. Gemini와 Claude는 출력 및 캐시 토큰에 가중치를 다르게 적용하므로 두 열을 함께 추가하지 마세요. Claude 필드는 Claude 모델의 토큰 수를 참조하세요.
SELECT
  TIMESTAMP_TRUNC(timestamp, MINUTE) AS minute_ts,
  SUM(IF(JSON_VALUE(resource.labels.publisher) = "google",
    IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.promptTokenCount) AS INT64), 0)
      + IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.toolUsePromptTokenCount) AS INT64), 0)
      - 0.9 * IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.cachedContentTokenCount) AS INT64), 0)
      + IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.candidatesTokenCount) AS INT64), 0)
      + IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.thoughtsTokenCount) AS INT64), 0), 0)) AS gemini_consumed_tokens,
  SUM(IF(JSON_VALUE(resource.labels.publisher) = "anthropic",
    IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.input_tokens) AS INT64), 0)
      + 0.1  * IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.cache_read_input_tokens) AS INT64), 0)
      + 1.25 * IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.cache_creation_input_tokens) AS INT64), 0)
      + 0.75 * IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.cache_creation.ephemeral_1h_input_tokens) AS INT64), 0)
      + 5    * IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.output_tokens) AS INT64), 0), 0)) AS claude_consumed_tokens
FROM `PROJECT_ID.global._Default._Default`
WHERE log_id = "aiplatform.googleapis.com/inference_request"
  AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 24 HOUR)
GROUP BY minute_ts
ORDER BY minute_ts DESC
Gemini 및 Claude의 캐시 적중률
캐시 적중률은 캐시된 입력 토큰을 총 입력 토큰으로 나눈 값입니다. Gemini 입력에는 캐시가 포함할 수 있는 도구 사용 토큰이 포함됩니다. Claude 입력은 캐시되지 않은 입력에 캐시 읽기와 캐시 쓰기를 더한 값입니다. 각 게시자가 캐시하는 방법은 컨텍스트 캐싱 개요 및 Claude 프롬프트 캐싱을 참조하세요.
SELECT
  JSON_VALUE(resource.labels.model_user_id) AS model,
  JSON_VALUE(json_payload.trafficType)      AS traffic_type,
  ROUND(100 * SAFE_DIVIDE(
    SUM(IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.cachedContentTokenCount) AS INT64), 0)
      + IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.cache_read_input_tokens) AS INT64), 0)),
    SUM(GREATEST(
          IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.promptTokenCount) AS INT64), 0)
          + IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.toolUsePromptTokenCount) AS INT64), 0),
          IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.cachedContentTokenCount) AS INT64), 0))
      + IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.input_tokens) AS INT64), 0)
      + IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.cache_read_input_tokens) AS INT64), 0)
      + IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.cache_creation_input_tokens) AS INT64), 0))), 1) AS cache_hit_rate_pct
FROM `PROJECT_ID.global._Default._Default`
WHERE log_id = "aiplatform.googleapis.com/inference_request"
  AND JSON_VALUE(json_payload.trafficType) IS NOT NULL
  AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 7 DAY)
GROUP BY model, traffic_type
ORDER BY model, traffic_type
모델별 다운그레이드
이 쿼리는 각 요청에서 요청한 사용한 만큼만 지불 옵션을 제공된 옵션과 비교합니다. 다운그레이드가 식별되는 방법은 다운그레이드된 요청 식별을 참조하세요.
WITH entries AS (
  SELECT
    JSON_VALUE(resource.labels.model_user_id) AS model,
    severity,
    JSON_VALUE(json_payload.trafficType)      AS served,
    (SELECT LOWER(v)
     FROM UNNEST(JSON_VALUE_ARRAY(json_payload.httpHeaders["x-vertex-ai-llm-shared-request-type"].values)) AS v
     WHERE LOWER(v) IN ("priority", "flex")
     LIMIT 1)                                 AS requested
  FROM `PROJECT_ID.global._Default._Default`
  WHERE log_id = "aiplatform.googleapis.com/inference_request"
    AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 7 DAY)
)
SELECT
  model,
  requested,
  COUNTIF(served = CONCAT("ON_DEMAND_", UPPER(requested))) AS served_as_requested,
  COUNTIF(served IS NOT NULL
          AND served != CONCAT("ON_DEMAND_", UPPER(requested))) AS downgraded,
  COUNTIF(severity = "ERROR")                              AS failed
FROM entries
WHERE requested IS NOT NULL
GROUP BY model, requested
ORDER BY downgraded DESC
분 단위 스필오버
이 쿼리는 기간 내에 프로비저닝된 처리량 트래픽이 있는 각 모델의 분당 오버플로 요청 수를 계산합니다. 오버플로가 식별되는 방법은 오버플로 요청 식별을 참조하세요.
WITH entries AS (
  SELECT
    timestamp,
    JSON_VALUE(resource.labels.location)      AS region,
    JSON_VALUE(resource.labels.model_user_id) AS model,
    JSON_VALUE(json_payload.trafficType)      AS traffic_type,
    EXISTS(
      SELECT 1
      FROM UNNEST(JSON_VALUE_ARRAY(json_payload.httpHeaders["x-vertex-ai-llm-request-type"].values)) AS v
      WHERE LOWER(v) IN ("dedicated", "shared")) AS routed_by_header
  FROM `PROJECT_ID.global._Default._Default`
  WHERE log_id = "aiplatform.googleapis.com/inference_request"
    AND severity = "INFO"
    AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 24 HOUR)
),
pt_models AS (
  SELECT DISTINCT region, model FROM entries WHERE traffic_type = "PROVISIONED_THROUGHPUT"
)
SELECT
  TIMESTAMP_TRUNC(e.timestamp, MINUTE) AS minute_ts,
  e.region,
  e.model,
  COUNTIF(e.traffic_type = "PROVISIONED_THROUGHPUT")              AS pt_requests,
  COUNTIF(e.traffic_type = "ON_DEMAND" AND NOT e.routed_by_header) AS spillover_requests
FROM entries AS e
JOIN pt_models USING (region, model)
GROUP BY minute_ts, e.region, e.model
HAVING spillover_requests > 0
ORDER BY minute_ts DESC
리전별 오류율 및 지연 시간
SELECT
  JSON_VALUE(resource.labels.location) AS region,
  TIMESTAMP_TRUNC(timestamp, MINUTE)   AS minute_ts,
  COUNT(*)                             AS total,
  COUNTIF(severity = "ERROR")          AS errors,
  COUNTIF(CAST(JSON_VALUE(json_payload.error.code) AS INT64) = 8) AS resource_exhausted,
  APPROX_QUANTILES(
    CAST(REGEXP_REPLACE(JSON_VALUE(json_payload.requestDuration), r"s$", "") AS FLOAT64),
    100)[OFFSET(95)] AS p95_latency_seconds
FROM `PROJECT_ID.global._Default._Default`
WHERE log_id = "aiplatform.googleapis.com/inference_request"
  AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 6 HOUR)
GROUP BY region, minute_ts
ORDER BY minute_ts DESC
Claude 모델의 토큰 수
Claude 모델은 Claude API 필드 이름과 함께 rawPredictDetails.usageMetadata에서 사용량을 보고합니다. rawPredict 및 streamRawPredict 모두 동일한 필드를 작성합니다. 스트리밍의 경우 로그는 스트림에 보고된 사용량을 병합합니다.
| 필드 | 집계 대상 |
|---|---|
input_tokens |
캐시에서 읽거나 캐시에 쓰지 않은 입력 토큰입니다. |
cache_read_input_tokens |
프롬프트 캐시에서 읽은 입력 토큰입니다. |
cache_creation_input_tokens |
프롬프트 캐시에 기록된 입력 토큰(두 TTL 모두 결합)입니다. |
cache_creation.ephemeral_5m_input_tokens |
TTL이 5분인 캐시 쓰기 |
cache_creation.ephemeral_1h_input_tokens |
TTL이 1시간인 캐시 쓰기 |
output_tokens |
확장된 사고를 포함한 출력 토큰입니다. 사고 토큰을 별도로 추가하지 마세요. |
총 Claude 입력은 input_tokens에 cache_read_input_tokens 및 cache_creation_input_tokens를 더한 값입니다. Gemini는 다릅니다. promptTokenCount에는 이미 캐시된 토큰이 포함되어 있습니다.
Claude 항목에는 형식 분류가 없습니다. 헤더 라벨은 Gemini 및 Claude에서 동일한 방식으로 작동합니다. 커스텀 헤더 라벨 연결을 참조하세요.
가격 책정
추론 요청 메타데이터 로깅은 Cloud Logging에 기록되며 Cloud Logging 수집 및 스토리지로 청구됩니다. Observability Analytics를 통한 쿼리는 Cloud Monitoring 사용량으로 청구됩니다. BigQuery 데이터 세트를 연결해도 BigQuery 스토리지 요금이 추가되지 않습니다.
항목 크기는 요청에 따라 달라집니다(예: 전달하는 헤더 라벨 수). 비용을 추정하려면 하루 동안 대표 워크로드에 대한 로깅을 사용 설정하고 로그 볼륨 분석으로 수집된 볼륨을 측정한 다음 Google Cloud 가격 계산기에서 월간 볼륨을 예측합니다.
다음 단계
- 측정항목으로 모델을 모니터링하는 방법 알아보기
- 커스텀 메타데이터 라벨을 사용하여 비용을 모니터링하는 방법 알아보기
- 프롬프트 및 응답 콘텐츠가 필요한 경우 요청-응답 로깅을 사용합니다.
- 프로비저닝된 처리량에 대해 알아보기
- Google Cloud 콘솔에서 프로비저닝된 처리량의 상세 측정항목을 확인합니다.
- 429 오류 문제 해결
- 집계 싱크를 사용하여 폴더 또는 조직의 모든 프로젝트에서 항목을 수집합니다.