


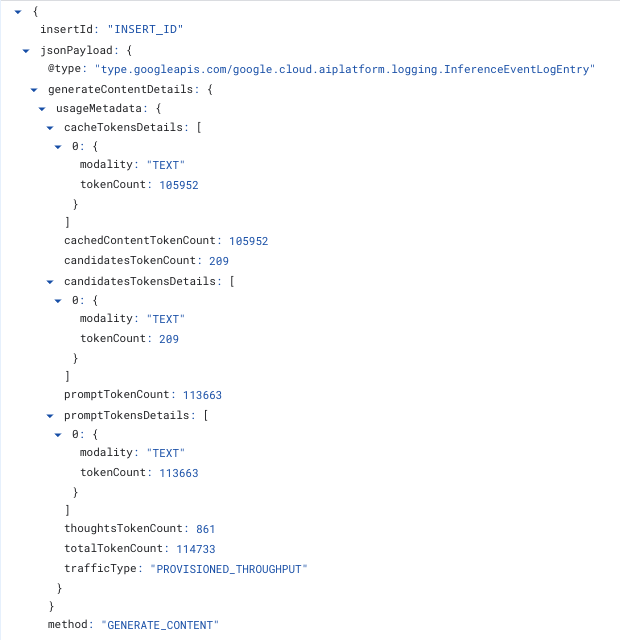
Agent Platform は、プロジェクトが処理する推論リクエストごとに 1 つの構造化ログエントリを書き込むことができます。各エントリには、リクエストに関するメタデータ(モデル、リージョン、トークン数(入力トークン、出力トークン、キャッシュに保存されたトークン、思考トークンなど)、プロビジョンド スループットのバーンダウン、エンドツーエンドのリクエスト レイテンシ、エラーコード、添付したヘッダーラベルまたはリクエストラベル)が記録されます。エントリは Cloud Logging に送信され、オブザーバビリティ分析で SQL を使用してクエリできます。ロギングを有効にするには、推論リクエストのメタデータログを有効にするをご覧ください。
推論リクエスト ロギングでは、メタデータのみが記録されます。プロンプトやレスポンスは記録されません。プロンプトとレスポンスのコンテンツが必要な場合は、代わりにリクエスト / レスポンス ロギングを使用します。
このページでは、推論リクエストのメタデータログを有効にする方法、各エントリの内容、クエリ方法について説明します。
ユースケース
推論リクエスト メタデータ ログは、集計指標では回答できない次のような質問に答えます。
- 各リクエストに独自のヘッダーラベル、リクエストラベル、またはその両方を添付して、トークンの費用をチーム、アプリケーション、テナントに割り当てます。
- プロビジョンド スループットの割り当てにカウントされた個々のリクエストと、オンデマンドで処理されたリクエストを確認します。
- スループット、レイテンシ、エラー率をヘッダーラベルまたはリクエストラベルで分類します。
- キャッシュの動作を、集計ではなくリクエストごとに測定します。
- プロジェクトで 429 エラーが発生した理由や、プロビジョンド スループットがオーバーフローした理由など、使用状況を秒単位で可視化できます。429 エラーを解決する手順については、エラーコード 429 のトラブルシューティングをご覧ください。それらを受信した秒数を確認するには、リージョン別のエラー率とレイテンシをご覧ください。
ロギングでサポートされている API メソッド
推論リクエストのメタデータログは、以下でサポートされています。
generateContentまたはstreamGenerateContentを使用する Gemini モデル(これらのメソッドによる画像生成を含む)。rawPredictまたはstreamRawPredictを使用する Claude モデル。他のパートナー モデルはログに記録されません。Claude のフィールド名については、Claude モデルのトークン数をご覧ください。
プロビジョンド スループットとすべての従量課金制オプションがサポートされています。
以下のことはサポートされていません。
chatCompletions。embedContent、predict、countTokens。predictを介して画像を生成するモデル(Imagen など)はログに記録されません。- ファインチューニングされたモデル(教師ありファインチューニングでチューニングされた Gemini モデルなど)へのリクエスト。
- チューニング ジョブ、バッチ推論、その他の長時間実行オペレーション。
- カスタム コンテナに自分でデプロイするモデル。
推論リクエストのメタデータログを有効にする
推論リクエストのメタデータログは、プロジェクト全体、または特定のリージョンの特定のモデルに対して構成できます。組織レベルで有効にする必要がある場合は、アカウント チームにお問い合わせください。ロギング構成が有効になるまでに数分かかることがあります。
始める前に
- プロジェクトに次の IAM 権限があることを確認します。設定を変更して読み取るための
aiplatform.endpoints.setPublisherModelConfigとaiplatform.endpoints.fetchPublisherModelConfig、ログバケットをアップグレードするためのlogging.buckets.get、logging.buckets.list、logging.buckets.update、logging.operations.get。これらの権限を含む事前定義ロールについては、アクセス制御と Logging のアクセス制御をご覧ください。 _Defaultログバケットをオブザーバビリティ分析にアップグレードするかどうかを決定します。SQL でエントリをクエリする場合や、 Google Cloud コンソールで詳細な指標を表示する場合は、アップグレードが必要です。アップグレードには数分かかります。この操作は元に戻せません。アップグレード前に書き込まれたエントリは、アップグレード後に SQL でクエリできません。- Cloud Logging の料金を確認します。エントリはバケットの保持期間(デフォルトでは 30 日間)保存され、Cloud Logging の取り込みとストレージの料金が適用されます。費用の見積もりについては、料金をご覧ください。
コンソールで有効にする
コンソールで有効にすると、プロジェクト内のすべてのモデル(Gemini と Claude の両方)のロギングが、プロビジョンド スループットと、ログがサポートするすべての従量課金制オプションで有効になります。また、_Default ログバケットがアップグレードされていない場合は、アップグレードされます。構成の優先順位で説明されているプロジェクト全体のデフォルトを設定します。始める前に、権限とバケットのアップグレードを確認してください。
Google Cloud コンソールで、[プロビジョンド スループット] ページに移動します。
次のいずれかを行います。
- 「Gemini Enterprise Agent Platform はオブザーバビリティをアップグレードしています」というバナーで、[有効にする] をクリックします。
- ツールバーで [指標の設定] をクリックします。[詳細な指標を有効にする] を選択し、[保存] をクリックします。

図 1. [プロビジョンド スループット] ページのオブザーバビリティ アップグレード バナー。 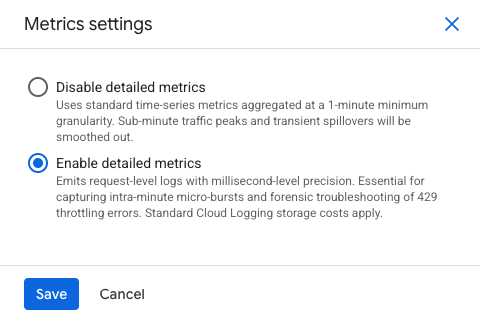
図 2.[指標の設定] パネルで、[詳細な指標を有効にする] が選択されています。 [詳細な指標を有効にしますか?] ダイアログで、ロギングとバケットのアップグレードの詳細を確認し、[有効にする] をクリックします。
ログ記録がオンになると、ダイアログが閉じます。バケットのアップグレードはバックグラウンドで続行され、数分かかることがあります。実行中は、バナーに「詳細な指標が有効になっており、このプロジェクトの _Default ログバケットはオブザーバビリティ分析にアップグレードされています。」と表示されます。
バケットがアップグレードされていないことがバナーに表示された場合は、[アップグレード] をクリックして再試行します。バケットをアップグレードできないことが報告された場合、リクエストごとのログに対してクエリを実行することはできません。[指標の設定] をクリックし、[詳細な指標を無効にする] を選択して、課金を停止します。
構成の優先順位
Agent Platform は、各リクエストの設定を次の順序で解決します。
- モデルごとおよびリージョンごとの設定(設定されている場合)。
- モデルごとの設定が未設定の場合のプロジェクト全体のデフォルト。
- どちらも設定されていない場合、ロギングはオフになります。
モデルごとの設定は、プロジェクトのデフォルトよりも優先されます。プロジェクト全体でロギングを有効にして、1 つのリージョンで 1 つの大容量モデルに対してロギングを無効にすることも、その逆も可能です。
REST API を使用して有効にする
推論リクエストのメタデータ ログを構成するには、setPublisherModelConfig メソッドを使用して inferenceEventLoggingConfig.state を ENABLED に設定します。
プロジェクト全体のデフォルトを設定するには、プロジェクトを指定します。
curl -X POST \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://aiplatform.googleapis.com/v1beta1/projects/PROJECT_ID:setPublisherModelConfig" \
  -d '{
        "publisherModelConfig": {
          "inferenceEventLoggingConfig": {"state": "ENABLED"}
        },
        "updateMask": "inferenceEventLoggingConfig"
      }'
1 つのリージョンで 1 つのモデルをオーバーライドするには、パブリッシャー モデルを指定します。
curl -X POST \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://aiplatform.googleapis.com/v1beta1/projects/PROJECT_ID/locations/LOCATION/publishers/PUBLISHER/models/MODEL:setPublisherModelConfig" \
  -d '{
        "publisherModelConfig": {
          "inferenceEventLoggingConfig": {"state": "ENABLED"}
        },
        "updateMask": "inferenceEventLoggingConfig"
      }'
PUBLISHER は、Gemini モデルの場合は google に、Claude モデルの場合は anthropic に設定します。たとえば、グローバル エンドポイントで Claude Sonnet 4.5 のロギングを有効にするには、LOCATION を global に設定して publishers/anthropic/models/claude-sonnet-4-5 を使用します。Claude モデル ID については、Claude モデルをご覧ください。
このメソッドは、長時間実行オペレーションを返します。
ロギング構成を取得する
fetchPublisherModelConfig メソッドを使用して現在の構成を読み取ります。プロジェクトを使用してプロジェクト全体のデフォルトを読み取るか、パブリッシャー モデルを使用してそのオーバーライドを読み取ります。
curl -X GET \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  "https://aiplatform.googleapis.com/v1beta1/projects/PROJECT_ID:fetchPublisherModelConfig"
curl -X GET \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  "https://aiplatform.googleapis.com/v1beta1/projects/PROJECT_ID/locations/LOCATION/publishers/PUBLISHER/models/MODEL:fetchPublisherModelConfig"
レスポンスには、そのリソースに設定されている設定が含まれます。
{
  "inferenceEventLoggingConfig": {
    "state": "ENABLED"
  }
}
ロギングが機能することを確認する
- 有効にしたモデルにリクエストを 1 件送信します。
ログ エクスプローラで、次のクエリを実行します。ほとんどのエントリは 12 秒以内に表示されます。最大 5 分かかることがあります。
logName="projects/PROJECT_ID/logs/aiplatform.googleapis.com%2Finference_request"SQL が機能することを確認するには、オブザーバビリティ分析を開き、サンプルクエリを実行します。データセットが見つからなかったことがクエリで報告された場合、ログバケットのアップグレードは完了していません。
ロギングを無効にする
Google Cloud コンソールで、[プロビジョンド スループット] ページに移動し、[指標の設定] をクリックして、[詳細な指標を無効にする] を選択し、[保存] をクリックします。これは、コンソールで有効にするを元に戻します。
REST API を使用する場合は、次の手順に沿って操作します。
ロギングを有効にしたリソースで inferenceEventLoggingConfig.state を DISABLED に設定して、ロギングを無効にします。
curl -X POST \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://aiplatform.googleapis.com/v1beta1/projects/PROJECT_ID:setPublisherModelConfig" \
  -d '{
        "publisherModelConfig": {
          "inferenceEventLoggingConfig": {"state": "DISABLED"}
        },
        "updateMask": "inferenceEventLoggingConfig"
      }'
モデルごとの設定はプロジェクトのデフォルトよりも優先されるため、プロジェクト レベルで無効にしても、明示的に有効にされているモデルはオフになりません。モデルごとの設定もクリアまたは無効にします。
ログの書き込み先
エントリは次のログに書き込まれます。
projects/PROJECT_NUMBER/logs/aiplatform.googleapis.com%2Finference_request
そこから、標準の Cloud Logging の宛先(
- オブザーバビリティ分析:Google Cloud コンソールの オブザーバビリティ分析 で SQL を使用してエントリをクエリします。
- リンクされた BigQuery データセット: データセットをリンクして、BigQuery から同じデータを読み取ります。詳細については、リンクされた BigQuery データセットに対してクエリを実行するをご覧ください。
- 集約シンク: 1 つのシンクを使用して、フォルダまたは組織内のすべてのプロジェクトからエントリを収集します。
logName="projects/*/logs/aiplatform.googleapis.com%2Finference_request"でフィルタします。
フォルダまたは組織内のすべてのプロジェクトからエントリを収集するには、集約シンクの概要をご覧ください。
エントリは、リクエストが完了してからしばらくするとクエリ可能になります。ほとんどのエントリは 12 秒以内にクエリ可能になります。最大 5 分かかります。
ログエントリのスキーマ
各エントリには、個別にクエリする 2 つの部分があります。モニタリング対象リソースとそのラベル(リクエストを処理したものを識別する)と、JSON ペイロード(リクエストの処理内容を記録する)です。以降のセクションでは、この両方について説明します。
リソースラベル
共有パブリッシャー モデルの場合、モニタリング対象リソースタイプは aiplatform.googleapis.com/PublisherModel で、次のラベルが付けられます。
| ラベル | 種類 | メモ |
|---|---|---|
resource_container |
STRING |
リクエストを処理したプロジェクト。 |
location |
STRING |
リクエストを処理したリージョン(例: us-central1)。グローバル エンドポイントに送信されたリクエストは global を報告します。 |
publisher |
STRING |
モデルのパブリッシャー(google、anthropic など)。 |
model_user_id |
STRING |
モデル(例: gemini-2.5-pro)。 |
ペイロード フィールド
| フィールド名 | タイプ | メモ |
|---|---|---|
method |
ENUM |
GENERATE_CONTENT、STREAM_GENERATE_CONTENT、RAW_PREDICT、STREAM_RAW_PREDICT。 |
trafficType |
ENUM |
リクエストを処理した使用オプション。現在の値は PROVISIONED_THROUGHPUT、ON_DEMAND、ON_DEMAND_FLEX、ON_DEMAND_PRIORITY です。失敗したリクエストには存在しません。 |
requestStartTime |
TIMESTAMP |
サービス提供フロントエンドがリクエストを承認した時刻。 |
requestDuration |
STRING |
エンドツーエンドのサービング レイテンシ。3.53s などの期間文字列としてフォーマットされます。 |
generateContentDetails.usageMetadata |
JSON |
generateContent と streamGenerateContent のトークン数(モダリティごとの内訳を含む)。画像出力は、candidatesTokensDetails の IMAGE エントリとしてここに表示されます。 |
rawPredictDetails.usageMetadata |
JSON |
rawPredict と streamRawPredict のトークン数(パートナー モデルを含む)。 |
provisionedThroughput |
JSON |
プロビジョンド スループット トラフィックに存在します。 |
httpHeaders |
JSON |
キャプチャされたリクエスト ヘッダー。 |
error |
JSON |
重大度が ERROR の場合にのみ存在します。 |
principal |
JSON |
リクエストを発行したサービス アカウント(利用可能な場合)。 |
LogEntry.labels フィールドには、OpenTelemetry GenAI セマンティック規則に準拠した gen_ai.operation.name が含まれます。generateContent と streamGenerateContent の両方が generate_content を報告します。rawPredict と streamRawPredict の両方が raw_predict を報告します。
プロビジョンド スループットのフィールド
| フィールド名 | タイプ | メモ |
|---|---|---|
ptChargedInputTokenCount |
INT64 |
バーンダウン率が適用された後に、プロビジョンド スループットの割り当てにカウントされる入力トークン。 |
ptChargedOutputTokenCount |
INT64 |
バーンダウン率が適用された後に、プロビジョンド スループットの割り当てにカウントされる出力トークン。 |
accountingResource |
STRING |
リクエストが引き出されたプロビジョンド スループット コミットメントのプロジェクト。 |
スピルオーバー リクエストを特定する
リクエストがプロビジョンド スループットの対象であったにもかかわらず、スループットが使い果たされたためにオンデマンドで処理された場合、リクエストはスピルオーバーされます。スピルオーバー エントリには ON_DEMAND の trafficType があり、provisionedThroughput オブジェクトはありません。通常の従量課金制リクエストも同じように見えるため、次のルールを使用して区別します。
X-Vertex-AI-LLM-Request-Typeをsharedの値で送信した場合、リクエストは意図的に従量課金制にルーティングされています。これはスピルオーバーではありません。X-Vertex-AI-LLM-Request-Typeヘッダーを送信しなかった場合、またはdedicatedまたはshared以外の値を送信し、エントリがON_DEMANDを報告した場合、そのリージョンでそのモデルのプロビジョンド スループットが設定されていれば、リクエストはスピルオーバーしています。- モデルにプロビジョンド スループットがない場合、すべての
ON_DEMANDエントリは通常の従量課金制になります。
ヘッダー値については、プロビジョンド スループットを使用するをご覧ください。
スピルオーバー リクエストをカウントするクエリについては、1 分あたりのスピルオーバーをご覧ください。
ダウングレードされたリクエストを特定する
リクエストがダウングレードされるのは、1 つの従量課金制オプションをリクエストしたときに、別のオプションで処理された場合です。送信した X-Vertex-AI-LLM-Shared-Request-Type ヘッダーと、リクエストを処理した trafficType を比較します。
| 送信したヘッダー値 | trafficType(リクエストどおりに配信された場合) |
|---|---|
priority |
ON_DEMAND_PRIORITY |
flex |
ON_DEMAND_FLEX |
成功したエントリに他の trafficType がある場合は、リクエストがダウングレードされたか、モデルがリクエストされたオプションを提供していないことを意味します。クエリについては、モデル別のダウングレードをご覧ください。
エラーコード
失敗したリクエストは、重大度 ERROR で書き込まれ、gRPC ステータス コードと正規の理由を含む error オブジェクトを保持します。理由は固定文字列です。プロンプト テキスト、レスポンス テキスト、ヘッダー値は含まれません。
| コード | ステータス | 一般的な HTTP ステータス |
|---|---|---|
8 |
リソースが枯渇しています(割り当て上限など)。 | 429 |
4 |
オペレーションが完了する前に期限が切れました。 | 504 |
14 |
サービスを利用できません。 | 503 |
13 |
内部エラーが発生しました。 | 500 |
3 |
リクエストに無効な引数が含まれています。 | 400 |
7 |
呼び出し元に権限がない。 | 403 |
5 |
リクエストされたエンティティが見つかりませんでした。 | 404 |
カスタム ヘッダーラベルを添付する
チーム、アプリケーション、テナントなどの独自のディメンションに使用状況を関連付けるには、接頭辞 x-goog-agent-platform-observability-label- を含むリクエスト ヘッダーを送信します。
x-goog-agent-platform-observability-label-team: payments
x-goog-agent-platform-observability-label-application: invoice-ocr
各ヘッダーは、jsonPayload.httpHeaders のエントリに表示されます。ヘッダーラベルは、generateContent と streamGenerateContent を使用する Gemini モデル、rawPredict と streamRawPredict を使用する Claude モデル、プロビジョンド スループット、すべての従量課金制オプションで機能します。
ヘッダーラベルを含む API 呼び出しの例、生成されるログエントリ、サポートされているモデル、制限、ヘッダーラベルとリクエストラベルの比較については、カスタム メタデータ ラベルをご覧ください。クエリを実行するには、カスタム ヘッダーラベル別の使用量をご覧ください。
ログ エクスプローラを使用してログをクエリする
ログ エクスプローラを使用して、個々の推論リクエストを検索して検査します。ロギングを有効にする以外に設定は必要ありません。ログを直接読み取るため、エントリは到着するとすぐに表示されます。
Google Cloud コンソールで、[ログ エクスプローラ] ページに移動し、Logging のクエリ言語を使用してクエリエディタ フィールドにクエリを入力します。ペインとコントロールの詳細については、ログ エクスプローラのインターフェースをご覧ください。
ログ名から始めて、プロジェクト内のすべての推論リクエスト エントリを選択します。
logName="projects/PROJECT_ID/logs/aiplatform.googleapis.com%2Finference_request"
検索キーワードを追加して結果を絞り込みます。別々の行にあるキーワードは AND で結合されます。
- 1 つのリージョンから処理されたリクエストを選択するには、
resource.labels.location="us-central1"を追加します。 - 1 つの API メソッドを選択するには、
jsonPayload.method="GENERATE_CONTENT"を追加します。 - プロビジョンド スループット トラフィックのみを選択するには、
jsonPayload.trafficType="PROVISIONED_THROUGHPUT"を追加します。 - 割り当てエラーのみを選択するには、
severity=ERRORとjsonPayload.error.code=8を追加します。 - 1 つのカスタム ヘッダーラベル値を選択するには、
jsonPayload.httpHeaders."x-goog-agent-platform-observability-label-team".values="payments"を追加します。
ログ エクスプローラはエントリをフィルタして表示します。集計は行いません。エントリをカウント、グループ化、グラフ化するには、オブザーバビリティ分析を使用します。[クエリ結果] ツールバーで、[結果を分析] をクリックして、現在のクエリを移行します。このボタンは、ログバケットがアップグレードされた後にのみ表示されます。
オブザーバビリティ分析でログをクエリして分析する
オブザーバビリティ分析を使用して、ログのクエリと分析を行うことができます。
始める前に
オブザーバビリティ分析は、ログ エクスプローラでは回答できない質問に回答します。ログ エクスプローラでは、個々のエントリが検索されて表示されます。これは、1 つのリクエストを追跡する場合に便利です。オブザーバビリティ分析では、セット全体で SQL が実行されるため、カウント、グループ化、結合、パーセンタイルの計算が可能です。このセクションのすべての質問には、集計が必要です。チームごとの費用、プロジェクトごとのバーンダウン、リージョンごとの p95 レイテンシは、一度に 1 つのエントリに回答することはできません。
これを行うには、プロジェクトの _Default ログバケットをアップグレードして、オブザーバビリティ分析を使用する必要があります。詳細については、ログバケットを構成するをご覧ください。
次の例は、オブザーバビリティ分析で実行されます。PROJECT_ID は、実際のプロジェクトに置き換えます。
リージョンとモデル別のスループット
SELECT
  JSON_VALUE(resource.labels.location)      AS region,
  JSON_VALUE(resource.labels.model_user_id) AS model,
  JSON_VALUE(json_payload.trafficType)      AS traffic_type,
  COUNT(*)                                  AS requests,
  SUM(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.promptTokenCount) AS INT64))     AS input_tokens,
  SUM(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.candidatesTokenCount) AS INT64)) AS output_tokens
FROM `PROJECT_ID.global._Default._Default`
WHERE log_id = "aiplatform.googleapis.com/inference_request"
  AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 24 HOUR)
GROUP BY region, model, traffic_type
ORDER BY requests DESC
プロジェクト別のプロビジョンド スループットのバーンダウン
SELECT
  JSON_VALUE(resource.labels.location) AS region,
  JSON_VALUE(json_payload.provisionedThroughput.accountingResource) AS pt_project,
  COUNTIF(JSON_VALUE(json_payload.trafficType) = "PROVISIONED_THROUGHPUT") AS pt_requests,
  COUNTIF(JSON_VALUE(json_payload.trafficType) = "ON_DEMAND")              AS on_demand_requests,
  SUM(CAST(JSON_VALUE(json_payload.provisionedThroughput.ptChargedInputTokenCount)  AS INT64)) AS pt_input_tokens,
  SUM(CAST(JSON_VALUE(json_payload.provisionedThroughput.ptChargedOutputTokenCount) AS INT64)) AS pt_output_tokens
FROM `PROJECT_ID.global._Default._Default`
WHERE log_id = "aiplatform.googleapis.com/inference_request"
  AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 24 HOUR)
GROUP BY region, pt_project
ORDER BY pt_input_tokens DESC
カスタム ヘッダーラベル別の使用量
SELECT
  JSON_VALUE(json_payload.httpHeaders
    ["x-goog-agent-platform-observability-label-team"].values[0]) AS team,
  COUNT(*) AS requests,
  SUM(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.totalTokenCount) AS INT64)) AS total_tokens
FROM `PROJECT_ID.global._Default._Default`
WHERE log_id = "aiplatform.googleapis.com/inference_request"
  AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 7 DAY)
GROUP BY team
ORDER BY total_tokens DESC
1 分あたりの消費トークン数(Gemini と Claude の比較)
このクエリは、1 分あたりの消費トークン数をパブリッシャーごとに 1 つの列に表示します。各列は、そのパブリッシャーの publisher/online_serving/consumed_token_throughput 指標と同じ方法でトークンタイプに重み付けされるため、各列は Cloud Monitoring と一致します。Gemini と Claude では、出力トークンとキャッシュ トークンの重み付けが異なるため、2 つの列を合計しないでください。Claude フィールドについては、Claude モデルのトークン数をご覧ください。
SELECT
  TIMESTAMP_TRUNC(timestamp, MINUTE) AS minute_ts,
  SUM(IF(JSON_VALUE(resource.labels.publisher) = "google",
    IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.promptTokenCount) AS INT64), 0)
      + IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.toolUsePromptTokenCount) AS INT64), 0)
      - 0.9 * IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.cachedContentTokenCount) AS INT64), 0)
      + IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.candidatesTokenCount) AS INT64), 0)
      + IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.thoughtsTokenCount) AS INT64), 0), 0)) AS gemini_consumed_tokens,
  SUM(IF(JSON_VALUE(resource.labels.publisher) = "anthropic",
    IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.input_tokens) AS INT64), 0)
      + 0.1  * IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.cache_read_input_tokens) AS INT64), 0)
      + 1.25 * IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.cache_creation_input_tokens) AS INT64), 0)
      + 0.75 * IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.cache_creation.ephemeral_1h_input_tokens) AS INT64), 0)
      + 5    * IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.output_tokens) AS INT64), 0), 0)) AS claude_consumed_tokens
FROM `PROJECT_ID.global._Default._Default`
WHERE log_id = "aiplatform.googleapis.com/inference_request"
  AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 24 HOUR)
GROUP BY minute_ts
ORDER BY minute_ts DESC
Gemini と Claude のキャッシュ ヒット率
キャッシュ ヒット率は、キャッシュされた入力トークン数を入力トークンの総数で割った値です。Gemini の入力には、キャッシュでカバーできるため、ツール使用トークンが含まれます。Claude の入力は、キャッシュに保存されていない入力、キャッシュ読み取り、キャッシュ書き込みの合計です。各パブリッシャーのキャッシュ保存方法については、コンテキスト キャッシュ保存の概要と Claude プロンプト キャッシュ保存をご覧ください。
SELECT
  JSON_VALUE(resource.labels.model_user_id) AS model,
  JSON_VALUE(json_payload.trafficType)      AS traffic_type,
  ROUND(100 * SAFE_DIVIDE(
    SUM(IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.cachedContentTokenCount) AS INT64), 0)
      + IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.cache_read_input_tokens) AS INT64), 0)),
    SUM(GREATEST(
          IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.promptTokenCount) AS INT64), 0)
          + IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.toolUsePromptTokenCount) AS INT64), 0),
          IFNULL(CAST(JSON_VALUE(json_payload.generateContentDetails.usageMetadata.cachedContentTokenCount) AS INT64), 0))
      + IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.input_tokens) AS INT64), 0)
      + IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.cache_read_input_tokens) AS INT64), 0)
      + IFNULL(CAST(JSON_VALUE(json_payload.rawPredictDetails.usageMetadata.cache_creation_input_tokens) AS INT64), 0))), 1) AS cache_hit_rate_pct
FROM `PROJECT_ID.global._Default._Default`
WHERE log_id = "aiplatform.googleapis.com/inference_request"
  AND JSON_VALUE(json_payload.trafficType) IS NOT NULL
  AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 7 DAY)
GROUP BY model, traffic_type
ORDER BY model, traffic_type
モデル別のダウングレード
このクエリは、各リクエストで要求された従量課金制オプションと、そのリクエストを処理したオプションを比較します。ダウングレードの識別方法については、ダウングレードされたリクエストを識別するをご覧ください。
WITH entries AS (
  SELECT
    JSON_VALUE(resource.labels.model_user_id) AS model,
    severity,
    JSON_VALUE(json_payload.trafficType)      AS served,
    (SELECT LOWER(v)
     FROM UNNEST(JSON_VALUE_ARRAY(json_payload.httpHeaders["x-vertex-ai-llm-shared-request-type"].values)) AS v
     WHERE LOWER(v) IN ("priority", "flex")
     LIMIT 1)                                 AS requested
  FROM `PROJECT_ID.global._Default._Default`
  WHERE log_id = "aiplatform.googleapis.com/inference_request"
    AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 7 DAY)
)
SELECT
  model,
  requested,
  COUNTIF(served = CONCAT("ON_DEMAND_", UPPER(requested))) AS served_as_requested,
  COUNTIF(served IS NOT NULL
          AND served != CONCAT("ON_DEMAND_", UPPER(requested))) AS downgraded,
  COUNTIF(severity = "ERROR")                              AS failed
FROM entries
WHERE requested IS NOT NULL
GROUP BY model, requested
ORDER BY downgraded DESC
分単位のスピルオーバー
このクエリは、ウィンドウでプロビジョンド スループット トラフィックがあった各モデルの 1 分あたりのスピルオーバー リクエスト数をカウントします。スピルオーバーの識別方法については、スピルオーバー リクエストを識別するをご覧ください。
WITH entries AS (
  SELECT
    timestamp,
    JSON_VALUE(resource.labels.location)      AS region,
    JSON_VALUE(resource.labels.model_user_id) AS model,
    JSON_VALUE(json_payload.trafficType)      AS traffic_type,
    EXISTS(
      SELECT 1
      FROM UNNEST(JSON_VALUE_ARRAY(json_payload.httpHeaders["x-vertex-ai-llm-request-type"].values)) AS v
      WHERE LOWER(v) IN ("dedicated", "shared")) AS routed_by_header
  FROM `PROJECT_ID.global._Default._Default`
  WHERE log_id = "aiplatform.googleapis.com/inference_request"
    AND severity = "INFO"
    AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 24 HOUR)
),
pt_models AS (
  SELECT DISTINCT region, model FROM entries WHERE traffic_type = "PROVISIONED_THROUGHPUT"
)
SELECT
  TIMESTAMP_TRUNC(e.timestamp, MINUTE) AS minute_ts,
  e.region,
  e.model,
  COUNTIF(e.traffic_type = "PROVISIONED_THROUGHPUT")              AS pt_requests,
  COUNTIF(e.traffic_type = "ON_DEMAND" AND NOT e.routed_by_header) AS spillover_requests
FROM entries AS e
JOIN pt_models USING (region, model)
GROUP BY minute_ts, e.region, e.model
HAVING spillover_requests > 0
ORDER BY minute_ts DESC
リージョン別のエラー率とレイテンシ
SELECT
  JSON_VALUE(resource.labels.location) AS region,
  TIMESTAMP_TRUNC(timestamp, MINUTE)   AS minute_ts,
  COUNT(*)                             AS total,
  COUNTIF(severity = "ERROR")          AS errors,
  COUNTIF(CAST(JSON_VALUE(json_payload.error.code) AS INT64) = 8) AS resource_exhausted,
  APPROX_QUANTILES(
    CAST(REGEXP_REPLACE(JSON_VALUE(json_payload.requestDuration), r"s$", "") AS FLOAT64),
    100)[OFFSET(95)] AS p95_latency_seconds
FROM `PROJECT_ID.global._Default._Default`
WHERE log_id = "aiplatform.googleapis.com/inference_request"
  AND timestamp > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 6 HOUR)
GROUP BY region, minute_ts
ORDER BY minute_ts DESC
Claude モデルのトークン数
Claude モデルは、Claude API フィールド名を使用して rawPredictDetails.usageMetadata で使用状況を報告します。rawPredict と streamRawPredict の両方が同じフィールドを書き込みます。ストリーミングの場合、ログはストリームで報告された使用状況レポートを統合します。
| フィールド | カウント対象 |
|---|---|
input_tokens |
キャッシュから読み取られなかった、またはキャッシュに書き込まれなかった入力トークン。 |
cache_read_input_tokens |
プロンプト キャッシュから読み取られた入力トークン。 |
cache_creation_input_tokens |
プロンプト キャッシュに書き込まれた入力トークン(両方の TTL の合計)。 |
cache_creation.ephemeral_5m_input_tokens |
TTL が 5 分のキャッシュ書き込み。 |
cache_creation.ephemeral_1h_input_tokens |
キャッシュ書き込みの TTL は 1 時間です。 |
output_tokens |
出力トークン(拡張思考を含む)。思考トークンを個別に追加しないでください。 |
Claude の入力の合計は、input_tokens + cache_read_input_tokens + cache_creation_input_tokens です。Gemini の違い: promptTokenCount には、キャッシュに保存されたトークンがすでに含まれています。
Claude のエントリにはモダリティの内訳がありません。ヘッダーラベルは Gemini と Claude で同じように機能します。カスタム ヘッダーラベルを添付するをご覧ください。
料金
推論リクエストのメタデータ ロギングは Cloud Logging に書き込まれ、Cloud Logging の取り込みとストレージとして課金されます。Observability Analytics を介したクエリは、Cloud Monitoring の使用量として課金されます。BigQuery データセットをリンクしても、BigQuery のストレージ料金は追加されません。
エントリのサイズは、リクエスト(たとえば、リクエストに含まれるヘッダーラベルの数)によって異なります。費用を見積もるには、代表的なワークロードのロギングを 1 日有効にし、ログ量分析で取り込まれた量を測定してから、Google Cloud 料金計算ツールで月間量を予測します。
次のステップ
- 指標を使用してモデルをモニタリングする方法を確認する。
- カスタム メタデータ ラベルを使用して費用をモニタリングする方法を確認する。
- プロンプトとレスポンスのコンテンツが必要な場合は、リクエスト / レスポンス ロギングを使用します。
- プロビジョンド スループットについて確認する。
- Google Cloud コンソールでプロビジョンド スループットの詳細な指標を表示する。
- 429 エラーのトラブルシューティングを行う。
- 集約シンクを使用して、フォルダまたは組織内のすべてのプロジェクトからエントリを収集します。