


에어갭 환경에서 운영되는 조직은 대규모 언어 모델 (LLM)의 혁신적인 기능이 필요하지만 엄격한 보안 프로토콜로 인해 외부 클라우드 기반 API에 연결하는 것이 엄격히 금지되어 있다는 심각한 문제에 직면해 있습니다. 이러한 격차를 해소하기 위해 이러한 고객은 Google Distributed Cloud (GDC) 에어 갭 인프라에서 직접 오픈 웨이트 모델을 호스팅하고 관리할 수 있는 강력한 자체 포함 생태계가 필요합니다. 이 현지화된 배포는 절대적인 데이터 주권을 유지하고 민감한 정보가 물리적 위치를 벗어나지 않도록 하는 데 필수적입니다. 보안 실행 환경을 로컬 추론 엔진과 통합함으로써 사용자는 데이터, 모델 가중치, 내부 보안 상황에 대한 완전한 관리 제어 권한을 유지하면서 고급 AI 기능을 활용할 수 있습니다.
GDC의 Gemini는 강력한 관리형 최첨단 기능을 제공하지만 고객은 더 높은 세부사항과 제어를 위해 Gemma 4 또는 Llama 4와 같은 오픈 가중치 모델을 배포하는 경우가 많습니다. 에어갭 GDC 환경에 개방형 가중치 모델을 배포하면 관리형 독점 서비스에 비해 상당한 비용 이점이 있습니다. 모델 가중치를 소유함으로써 조직은 반복되는 토큰당 API 요금을 없앨 수 있으며, 이는 대량의 자동화된 워크로드에 대해 금지될 수 있습니다. 또한 오픈소스 모델을 사용하면 양자화 (예: 4비트 또는 8비트)가 가능하므로 고성능 추론을 에지에서 더 작고 저렴한 하드웨어 공간에서 실행할 수 있습니다. 이러한 수직 최적화는 추가 라이선스 비용 없이 여러 내부 애플리케이션 간에 인프라를 공유할 수 있는 기능과 결합되어 지속적인 대규모 추론 작업의 총소유비용 (TCO)을 크게 절감합니다.
제안된 해결 방법
이 문서에서는 Google Distributed Cloud (GDC) 에어 갭 환경에서 오픈 가중치 대규모 언어 모델 (LLM)을 배포하고 관리하기 위한 참조 아키텍처를 간략하게 설명합니다. 많은 고객, 특히 규제가 심한 분야의 고객은 엄격한 데이터 주권 및 보안 요구사항으로 인해 클라우드 기반 LLM API를 사용할 수 없습니다. 이 아키텍처는 자체 보안 GDC 인스턴스 내에서 강력한 LLM을 로컬로 실행해야 하는 요구사항을 해결합니다.
포함되는 내용: 이 아키텍처는 vLLM 또는 Ollama 서빙 백엔드를 사용하여 오픈소스 LLM (예: Gemma, Llama, DeepSeek)의 배포를 다룹니다. 여기에는 오케스트레이션을 위한 Kubernetes, 아티팩트 스토리지를 위한 Harbor, 모델 가중치를 위한 영구 볼륨, 네트워크 보안을 위한 프로젝트 네트워크 정책의 사용이 포함됩니다.
포함되지 않는 항목: 이 아키텍처는 관리형 AI 게이트웨이 서비스, Google의 Gemini와 같은 독점 모델, 모델 미세 조정 프로세스, 이미지 생성과 같은 기타 모달리티용 생성형 AI 모델을 다루지 않습니다. 이러한 기능은 별도의 가이드에서 다룹니다.
대상: 이 문서의 주요 대상은 GDC에서 서비스를 배포하고 관리하는 플랫폼 관리자와 에어 갭 적용 환경 내에서 AI 솔루션을 설계하는 기술 설계자입니다. 배포된 모델과 상호작용하는 최종 사용자와 개발자는 기본 구조를 이해함으로써 이점을 얻는 보조 잠재고객입니다.
참조 아키텍처
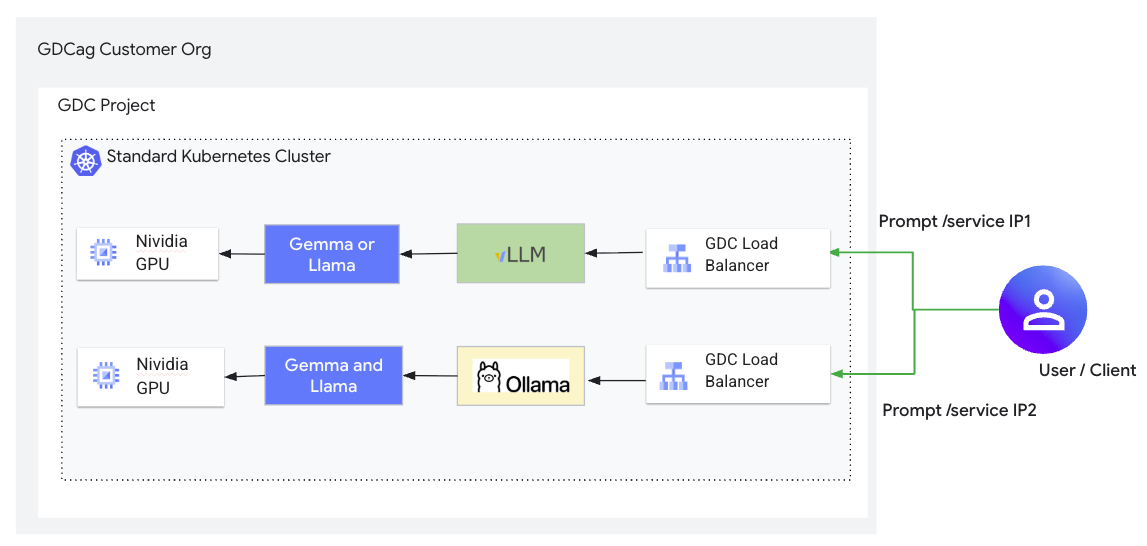
솔루션 구성요소
이 솔루션은 다음 구성요소를 활용합니다.
| 솔루션 구성요소 | 책임 | 데이터 흐름 | 인터페이스 |
|---|---|---|---|
| GDC 에어 갭 적용 고객 영역 | Kubernetes 클러스터, 네트워킹, 스토리지 인프라를 호스팅합니다. | 기본 플랫폼 | IO의 인프라 관리 인터페이스 플랫폼 관리자 및 사용자를 위한 Kubernetes API |
| 부하 분산기 | Kubernetes 클러스터 외부의 트래픽에 LLM 제공 포드 (vLLM, Ollama)를 노출하여 안정적인 IP 주소를 제공합니다. | 외부 클라이언트 요청은 LoadBalancer의 외부 IP로 전송됩니다. LoadBalancer는 서비스의 선택기를 기반으로 정상 백엔드 포드 (vLLM 또는 Ollama)에 요청을 분산합니다. | Kubernetes 서비스 API입니다. GDC 환경 내에서 네트워크 부하 분산기를 자동으로 프로비저닝합니다. |
| vLLM | 높은 처리량의 LLM 추론 서빙 PagedAttention과 같은 기술을 사용하여 짧은 지연 시간으로 최적화되었습니다. 일반적으로 인스턴스당 하나의 모델을 제공합니다. | 클라이언트로부터 HTTP 추론 요청을 수신합니다. 마운트된 PVC에서 모델 가중치를 로드합니다. 연결된 GPU에서 계산을 실행합니다. 생성된 텍스트가 포함된 HTTP 응답을 반환합니다. | 추론을 위한 OpenAI 호환 RESTful API입니다. JSON 요청을 허용합니다. |
| Ollama | 사용 편의성과 단일 인스턴스 내에서 여러 모델 관리 (한 번에 하나만 활성화됨)를 위해 설계된 LLM 추론 서빙 | HTTP 추론 요청을 수신합니다. 모델을 로드합니다 (컨테이너 이미지 내에 번들로 제공되거나 에어갭이 아닌 경우 처음 사용할 때 가져옴). GPU에서 연산을 실행합니다. HTTP 응답을 반환합니다. 일정 기간 동안 활동이 없으면 모델이 언로드됩니다. | Ollama RESTful API는 JSON 요청을 허용합니다. CLI도 있습니다. |
| Nvidia GPU / MIG | LLM 추론을 위한 하드웨어 가속을 제공합니다. | LLM 백엔드 (vLLM, Ollama)는 집약적인 모델 계산 (행렬 곱셈 등)을 GPU로 오프로드하여 추론을 가속화합니다. MIG를 사용하면 여러 소규모 모델 인스턴스에서 사용할 수 있도록 단일 GPU를 파티셔닝할 수 있습니다. | Kubernetes에서 리소스 유형 (예: nvidia.com/gpu)으로 노출됩니다. 포드는 이러한 리소스를 요청합니다. |
| Harbor | vLLM, Ollama, 도우미 포드 (예: busybox)의 컨테이너 이미지를 안전하게 저장하고 관리합니다. | 컨테이너 이미지가 빌드 환경 (예: 인터넷 액세스가 가능한 워크스테이션)에서 Harbor로 푸시됩니다. Kubernetes 노드는 컨테이너를 실행하기 위해 Harbor에서 이러한 이미지를 가져옵니다. | Docker Registry API입니다. Kubernetes 노드는 포드 생성 중에 이미지를 가져오기 위해 Harbor와 인터페이스합니다. 사용자는 Docker CLI 또는 Harbor UI와 상호작용하여 이미지를 푸시합니다. |
| 영구 볼륨 클레임 | 포드 수명 주기와 분리된 LLM 모델 가중치를 위한 영구 스토리지를 제공합니다. | 모델 파일이 영구 볼륨에 복사됩니다 (예: 헬퍼 포드 및 kubectl cp 사용). vLLM 서버는 시작 시 이 마운트된 볼륨에서 모델 가중치를 읽습니다. Ollama는 일반적으로 이미지 내에 모델을 번들로 제공하므로 이 설정에서는 Ollama 모델 저장소에 PVC가 덜 일반적입니다. |
Kubernetes 스토리지 API입니다. YAML로 정의되고 포드에 볼륨으로 마운트됩니다. |
| 프로젝트 네트워크 정책 | 프로젝트/네임스페이스 수준에서 네트워크 격리를 적용하고 트래픽 흐름을 제어합니다. 승인된 트래픽만 LLM 서비스에 도달할 수 있도록 합니다. | 네임스페이스 내 포드와 주고받는 네트워크 트래픽이 검사됩니다. 정책 규칙은 일반적으로 소스 IP 범위 또는 기타 라벨을 기반으로 LLM 서비스 포트 (예: vLLM의 경우 8000, Ollama의 경우 11434)에 대한 연결이 허용되는지 여부를 지정합니다. | Kubernetes networking.gdc.goog/v1 API YAML에 정의됩니다. |
특징 및 기능
이 참조 아키텍처는 다음과 같은 핵심 기능을 제공합니다.
- 개방형 가중치 LLM 서빙: 다양한 개방형 가중치 모델 (예: Gemma, Llama, DeepSeek)의 호스팅 및 추론을 지원합니다.
- 구성요소: LLM 서빙 백엔드 (vLLM, Ollama), Kubernetes 배포/포드
- 책임: 모델 가중치 로드, 추론 프로세스 관리, 하드웨어 가속기에서 모델 실행, 엔드포인트 노출
- 인터페이스: 추론 요청을 위한 REST API (vLLM용 OpenAI 호환, Ollama용 내장 API), 일반적으로 JSON 사용
- Bring Your Own Model (BYOM): 사용자는 선택한 공개 가중치 LLM을 에어갭 환경으로 가져와 배포할 수 있습니다.
- 구성요소: Harbor, 영구 볼륨 클레임, Kubernetes
- 책임: 컨테이너 이미지 및 모델 가중치의 안전한 저장 모델을 환경으로 전송하고 서빙 엔진에서 액세스할 수 있도록 하는 메커니즘
- 인터페이스: Docker Registry API (Harbor용), Kubernetes API (PVC 및 볼륨 마운트용)
- 하드웨어 가속 추론: GDC 클러스터 내에서 NVIDIA GPU를 활용하여 LLM 추론을 효율적으로 실행합니다.
- 구성요소: NVIDIA GPU, Kubernetes, 기기 플러그인
- 책임: GPU 리소스가 있는 노드에 포드 예약 GPU 하드웨어를 LLM 백엔드 컨테이너에 노출합니다. 파티셔닝을 위한 멀티 인스턴스 GPU(MIG)를 지원합니다.
- 인터페이스: Kubernetes API (
nvidia.com/gpu와 같은 GPU 리소스 요청용)
- 네트워크 제어 액세스: LLM 추론 엔드포인트에 대한 액세스가 GDC 환경 내에서 제어되고 격리되도록 합니다.
- 구성요소: Kubernetes 서비스 (LoadBalancer), ProjectNetworkPolicy
- 책임: 안정적인 IP를 사용하여 추론 서비스를 노출합니다. 소스, 대상, 포트를 기반으로 LLM 백엔드로의 트래픽을 허용하거나 거부하는 네트워크 규칙을 정의하고 적용합니다.
- 인터페이스: Kubernetes API (서비스 및 ProjectNetworkPolicy용)
- 확장 가능한 서빙: 수요에 따라 용량을 조정할 수 있습니다.
- 구성요소: Kubernetes 배포
- 책임: LLM 백엔드 포드의 복제본 수를 늘려 수평 확장을 지원합니다. 리소스 요청/한도를 조정하여 수직 확장
- 인터페이스: Kubernetes API (배포 복제본 및 리소스 관리용)
아키텍처 원칙
- 보안 우선: 모든 구성요소와 데이터가 GDC 에어갭 경계 내에 있어 데이터 보안과 관리 기능을 최대한 보장합니다. 네트워크 액세스가 ProjectNetworkPolicies를 사용하여 제한됩니다.
- 데이터 주권: 고객은 모델과 데이터를 완전히 제어하며, 작동에 외부 연결이 필요하지 않습니다.
- 개방적이고 유연함: 아키텍처는 오픈소스 서빙 백엔드(vLLM, Ollama)를 활용하고 다양한 오픈 가중치 LLM을 지원하므로 고객이 추론 엔진을 선택할 수 있고 공급업체 종속을 방지할 수 있습니다.
- 구성요소 분리: 모델 저장소 (PVC), 이미지 관리 (Harbor), 추론 제공 (vLLM/Ollama 포드)과 같은 주요 기능은 별도의 구성요소이므로 독립적인 관리와 업데이트가 가능합니다.
- 확장성 및 성능: 포드 복제본 수를 늘려 수평으로 확장하고 CPU/GPU 리소스를 조정하여 성능 요구사항을 충족하도록 수직으로 확장하도록 설계되었습니다. vLLM은 높은 처리량, 낮은 지연 시간 시나리오에 적합합니다.
- 리소스 최적화: 소규모 모델이 GPU 리소스를 효율적으로 공유하여 하드웨어 사용률을 극대화할 수 있도록 NVIDIA 멀티 인스턴스 GPU (MIG)를 지원합니다.
- 표준 인터페이스: 조정, 배포, 서비스 노출을 위한 Kubernetes 표준을 기반으로 빌드됩니다. 추론 엔드포인트는 REST API를 제공하며 vLLM은 OpenAI 호환성을 제공합니다.
- 복원력: Kubernetes 상태 점검 및 복제를 활용하여 서비스 가용성을 보장합니다.
고려사항
- 확장성 및 성능:
- 수평 확장은 vLLM과 Ollama 모두에 대해 Kubernetes 배포의 복제본 수를 늘려 달성됩니다.
- 수직 확장은 최대 전체 GPU까지 더 많은 CPU/메모리 및 더 큰 GPU 슬라이스를 할당하는 것을 의미합니다.
- vLLM은 인스턴스당 하나의 모델을 제공하므로 추가 모델에는 새 배포가 필요합니다. Ollama는 여러 모델을 관리할 수 있지만 한 번에 하나만 실행합니다.
- PVC 크기는 모델 로드 시간에 큰 영향을 미치므로 IOPS가 높은 경우 500GiB 이상을 사용하는 것이 좋습니다.
- 리소스 관리:
- GPU 리소스를 신중하게 계획해야 합니다. NVIDIA MIG를 사용하여 소규모 모델용 GPU를 파티셔닝하여 사용률을 개선할 수 있습니다.
- 추론과 모델 관리 오버헤드를 모두 처리할 수 있도록 적절한 CPU와 메모리가 할당되어야 합니다.
- 모델 크기를 수용하고 성능을 보장하기 위해 PVC에 충분한 스토리지가 프로비저닝되어야 합니다.
- 가용성 및 안정성:
- Kubernetes 배포는 자체 복구 및 순차적 업데이트 기능을 제공합니다.
- LoadBalancer 서비스는 정상 포드 간에 트래픽을 분산하여 개별 포드 장애를 마스킹합니다.
- PVC에 모델 가중치를 저장하면 포드 재시작 시 지속성이 보장됩니다.
- 운영 복잡성:
- Harbor에서 다양한 백엔드와 버전의 컨테이너 이미지 관리
- 모델 가중치를 오프라인 환경으로 안전하게 전송하는 절차
- 각 모델 및 백엔드에 대한 Kubernetes 매니페스트 (배포, 서비스, PVC, 네트워크 정책)를 만들고 관리합니다.
- GPU 사용률, 추론 지연 시간, 오류율 모니터링
- 보안 및 규정 준수:
- 전체 솔루션은 GDC 에어갭 보안 경계 내에서 작동합니다.
- 엄격한 네트워크 격리를 적용하고 LLM 엔드포인트에 대한 액세스를 제어하려면 ProjectNetworkPolicies가 필수입니다.
- Harbor 로봇 계정 및 Kubernetes 이미지 가져오기 비밀을 사용하면 컨테이너 이미지에 안전하게 액세스할 수 있습니다.
- 전송 중인 데이터는 Kubernetes 네트워크 정책과 플랫폼 수준 암호화로 보호할 수 있습니다. PVC의 저장 데이터는 GDC 스토리지 암호화를 사용합니다.
설계 결정
이 참조 아키텍처에 대해 다음과 같은 주요 설계 결정이 내려졌습니다.
결정 1: vLLM과 Ollama를 모두 제공하는 것과 하나의 추론 모델만 제공하는 것의 차이
| 컨텍스트 | 주요 결정 | 근거 |
|---|---|---|
| 추론 레이어에 VLLM과 Ollama 중 하나만 제공하거나 둘 다 제공합니다. | 성능, API 호환성, 모델 관리 용이성에 대한 요구사항이 사용자 및 사용 사례에 따라 다르기 때문에 두 모델을 모두 제공하기로 했습니다. | vLLM은 프로덕션 애플리케이션에 적합한 높은 처리량, 짧은 지연 시간 서빙, OpenAI API 호환성을 제공합니다. Ollama는 더 간단한 설정, 여러 모델의 더 쉬운 관리, 사용자 친화적인 인터페이스를 제공하므로 개발 및 실험에 더 적합합니다. 두 가지를 모두 지원하면 유연성이 제공됩니다. |
결정 2: vLLM 모델 스토리지를 위해 영구 스토리지와 객체 스토리지 중 무엇을 사용할지
| 컨텍스트 | 주요 결정 | 근거 |
|---|---|---|
| vLLM에는 런타임에 파일 시스템에 모델 가중치가 있어야 합니다. 오프라인 환경에서는 모델을 요청 시 다운로드할 수 없습니다. | 영구 볼륨 클레임을 사용하면 모델 가용성이 보장되고 초기 로드 후 시작 시간이 개선되지만, PVC를 채우는 초기 단계가 필요하며 일반적으로 헬퍼 포드가 포함됩니다. | 영구 볼륨 클레임은 vLLM 포드 수명 주기와 분리된 대규모 모델 파일에 탄력적이고 영구적인 스토리지 레이어를 제공합니다. 이를 통해 포드 시작 시 모델을 빠르게 로드할 수 있습니다. |
결정 3: Ollama Docker 이미지 내 모델 번들링과 독립형 이미지
| 컨텍스트 | 주요 결정 | 근거 |
|---|---|---|
| Ollama는 모델을 다운로드할 수 있지만 에어 갭 환경에서는 사용할 수 없는 인터넷 액세스가 필요합니다. | 외부 호출이 필요하지 않아 오프라인 환경에서 런타임 작업을 간소화하기 위해 이미지를 번들로 묶기로 결정했습니다. 하지만 모델을 업데이트하거나 추가하려면 Docker 이미지를 다시 빌드하고 Harbor로 다시 푸시해야 합니다. | 모델이 미리 다운로드된 Docker 이미지를 빌드하면 Ollama가 오프라인에서 사용할 수 있는 필수 모델로 시작됩니다. |
결정 4: 부하 분산기 서비스로 vLLM 및 Ollama 노출 vs 부하 분산기 없음
| 컨텍스트 | 주요 결정 | 근거 |
|---|---|---|
| LLM API는 GDC 환경 내의 애플리케이션에서 액세스할 수 있어야 합니다. | 서비스 노출을 위한 표준 Kubernetes 접근 방식이므로 부하 분산기를 사용하여 서비스를 노출하기로 결정했지만 이 접근 방식은 GDC 플랫폼의 LoadBalancer 프로비저닝에 의존합니다. | LoadBalancer 유형의 Kubernetes 서비스는 LLM 백엔드를 노출하는 안정적인 표준 방법을 제공하여 안정적인 IP 주소를 제공하고 부하를 분산합니다. |
결정 5: 필수 ProjectNetworkPolicy 시행
| 컨텍스트 | 주요 결정 | 근거 |
|---|---|---|
| 보안과 격리는 GDC 오프라인 배포에서 매우 중요합니다. | 네트워크 정책을 신중하게 정의해야 하지만 배포된 LLM 서비스의 보안 상태를 크게 향상하므로 ProjectNetworkPolicy를 적용하기로 결정했습니다. | ProjectNetworkPolicies는 승인된 트래픽만 LLM 서비스에 도달할 수 있도록 네임스페이스 수준에서 네트워크 격리를 적용하는 Kubernetes 네이티브 방식을 제공합니다. |
가정 및 제한사항
- GDC 에어 갭 적용 1.15.1 이상 환경을 사용할 수 있음
- 표준 클러스터에 충분한 하드웨어 리소스 (특히 GPU)가 있습니다.
- Harbor 인스턴스가 설정되어 액세스할 수 있습니다.
- 사용자에게 필요한 권한 (네임스페이스 관리자, 클러스터 개발자)이 있습니다.
- 모델이 선택한 서빙 백엔드 (vLLM/Ollama)와 호환됩니다.
사용자 흐름 (전체 단계)
다음은 Google Distributed Cloud (GDC) 에어갭 환경에 개방형 가중치 대규모 언어 모델 (LLM)을 배포하기 위한 포괄적인 사용자 흐름입니다. 흐름은 일반 설정, 두 가지 배포 경로 (vLLM 및 Ollama), 최종 검증으로 나뉩니다.
1. 일반적인 설정: 이미지 관리
LLM을 배포하기 전에 GDC 환경에서 비공개 Harbor 레지스트리에서 컨테이너 이미지를 가져오는 방법을 구성해야 합니다.
- Harbor 로봇 계정 만들기: Harbor UI에서 로봇 계정을 생성하고 'pull' 권한을 부여합니다.
- Docker 인증: 네트워크 액세스 권한이 있는 머신에서 로봇 계정 사용자 인증 정보를 사용하여 Harbor에 로그인합니다.
- Kubernetes 보안 비밀 만들기:
kubectl를 사용하여 GDC 프로젝트 네임스페이스에 docker-registry 보안 비밀을 만들어 클러스터에서 사용할 Harbor 사용자 인증 정보를 저장합니다.
2. 배포 경로 A: vLLM (높은 처리량)
이 경로는 Gemma-3과 같은 성능 지향 모델을 제공하는 데 권장됩니다.
- 이미지 획득: 인터넷에서 vLLM Docker 이미지를 가져오고, 로컬 Harbor 레지스트리에 태그를 지정하고, Harbor로 푸시합니다.
- 모델 스토리지 준비:
- 모델 가중치를 저장할 500GiB 영구 볼륨 신청 (PVC)을 만듭니다.
- 인터넷에 연결된 머신에서 Hugging Face의 가중치를 다운로드합니다.
- 임시 '헬퍼 포드'와
kubectl cp를 사용하여 이러한 가중치를 GDC 환경 내 PVC로 전송합니다.
- 백엔드 배포: vLLM 이미지를 참조하고 모델 가중치 PVC를 마운트하는 Kubernetes 배포 매니페스트를 적용합니다.
- 서비스 노출: vLLM API의 외부 IP를 제공하는
LoadBalancer서비스를 만듭니다. - 보안 네트워크:
ProjectNetworkPolicy를 적용하여 서비스 포트 (일반적으로 8000)에서 인그레스 트래픽을 허용합니다.
3. 배포 경로 B: Ollama (사용 편의성)
이 경로는 모델 가중치가 번들로 제공되거나 이미지에 미리 로드되는 간소화된 설정에 중점을 둡니다.
- 맞춤 이미지 빌드: Ollama를 설치하고
RUN명령어를 사용하여 특정 모델 (예:gemma3)을 이미지 레이어로 '사전 풀'하는 Dockerfile을 만듭니다. - Harbor로 푸시: 이미지를 로컬로 빌드하고 비공개 Harbor 레지스트리로 푸시합니다.
- 배포 및 노출: Ollama 배포 및
LoadBalancer서비스를 만듭니다. - 보안 네트워크: Ollama 포트 (11434)에
ProjectNetworkPolicy를 적용합니다.
4. 유효성 검사 및 테스트
배포가 완료되면 서비스가 작동하는지 확인하는 최종 단계가 진행됩니다.
- 상태 확인: 포드가 '실행 중'이고 서비스에 외부 IP 주소가 할당되었는지 확인합니다.
- 추론 테스트:
- vLLM: OpenAI 호환
/v1/chat/completions엔드포인트를 사용하여 vLLMLoadBalancerIP 주소에curl요청을 보냅니다. - Ollama: Ollama
LoadBalancerIP 주소의/v1/completions엔드포인트에curl요청을 보냅니다.
- vLLM: OpenAI 호환
5. 운영 및 확장
- 수직 확장: 더 큰 모델의 경우 GPU 슬라이스를 늘리거나 다중 GPU 구성으로 이동합니다.
- 수평 확장: 더 많은 동시 사용자 요청을 처리하기 위해 배포의 복제본 수를 늘립니다.
- 문제 해결:
kubectl logs를 사용하여 로그를 모니터링하고 FIPS 자체 테스트 실패 또는 네트워크 정책 제한과 같은 일반적인 문제를 확인합니다.