


개요
이 문서에서는 Google Distributed Cloud (GDC) 오프라인 환경에 Gemma, Llama, DeepSeek와 같은 공개 가중치 대규모 언어 모델 (LLM)을 배포하는 방법을 단계별로 설명합니다. 여기에서는 높은 처리량 서빙을 위해 vLLM을 사용하고 사용 편의성을 위해 Ollama를 사용하여 Kubernetes, Harbor, GPU 리소스를 비롯한 GDC 플랫폼의 기능을 활용하는 방법을 다룹니다.
아키텍처
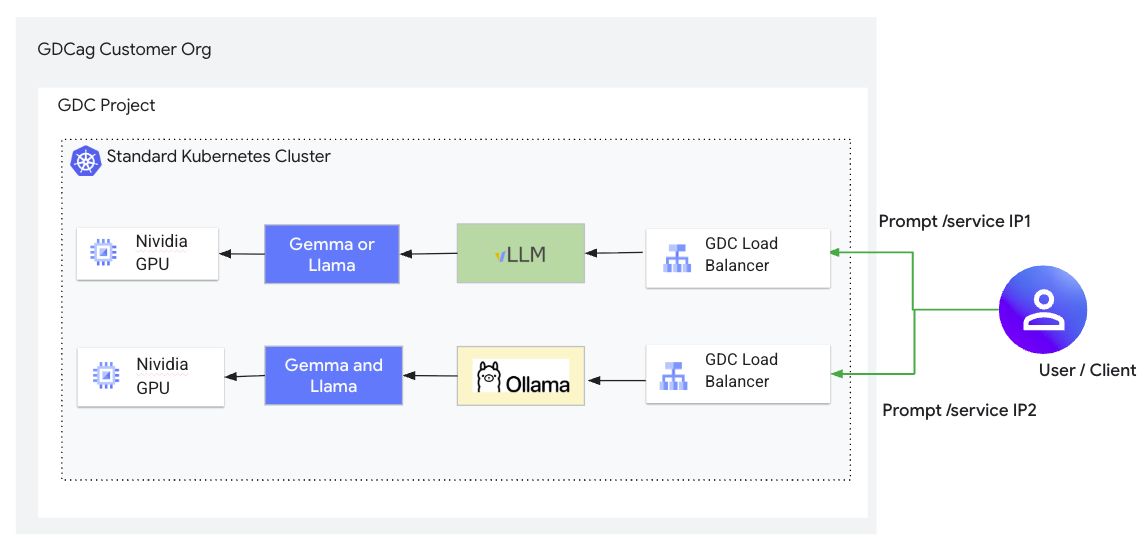
이 솔루션에서는 컨테이너화된 LLM 서빙 백엔드 (vLLM, Ollama)를 사용자 클러스터 내에 배포로 배포합니다. 모델 가중치는 Harbor 레지스트리의 이미지에서 채워진 영구 볼륨에 저장됩니다. LoadBalancer 유형의 Kubernetes 서비스는 백엔드의 API를 노출합니다. 프로젝트 네트워크 정책은 이러한 서비스에 대한 액세스를 보호합니다.
시작하기 전에
다음 기본 요건을 충족해야 합니다.
- GDC 오프라인 버전 1.15.1 이상
- 충분한 리소스 (CPU, 메모리, GPU)로 생성된 사용자 클러스터
- NVIDIA A100 GPU가 1개 이상 필요합니다.
- Harbor 인스턴스를 사용할 수 있고 액세스할 수 있습니다.
- 사용자 클러스터에 액세스하도록 구성된
kubectl및gdcloudCLI - Harbor에 푸시하도록 Docker 클라이언트를 설치하고 구성했습니다.
- 필요한 IAM 권한이 부여됨 (예: 네임스페이스 관리자, 클러스터 개발자**).
- 제한된 모델을 사용하는 경우 Hugging Face 계정 및 인증이 구성되어 있어야 합니다.
섹션 1: 일반 설정
1.1 이미지 가져오기 보안 비밀 만들기
GDC 오프라인 환경에서 컨테이너 워크로드의 이미지 가져오기 보안 비밀을 구성하려면 비공개 Harbor 프로젝트에 액세스할 수 있는 사용자 인증 정보가 포함된 Kubernetes docker-registry 보안 비밀을 만들어야 합니다. 그러면 이 보안 비밀이 배포 사양에서 참조됩니다.
비공개 Harbor 프로젝트의 이미지에 프로그래매틱 방식으로 액세스하려면 Harbor 로봇 계정을 사용해야 합니다.
다음 단계에 따라 이미지 가져오기 보안 비밀을 구성하세요.
Harbor 로봇 계정 만들기:
- Harbor 인스턴스 UI로 이동합니다.
- Harbor 프로젝트로 이동합니다.
- 로봇 계정 탭을 선택합니다.
- New Robot Account(새 로봇 계정)를 클릭합니다.
- 이름을 지정하고 (예:
oss-llm-puller) 만료 시간까지 필요한 권한(최소한 pull 액세스)을 부여합니다. - 제공된 로봇 계정 이름 (예:
robot$oss-llm-puller)과 보안 비밀 토큰을 안전하게 저장합니다.
Docker를 Harbor에 인증:
Docker가 설치되어 있고 Harbor 레지스트리에 네트워크로 액세스할 수 있는 머신에서 로봇 계정 사용자 인증 정보를 사용하여 로그인합니다.
export INSTANCE_URL="HARBOR_INSTANCE_URL"
# for example, harbor1-project1.org1.zone1.google.gdc.com

export ROBOT_NAME="ROBOT_ACCOUNT_NAME"
# for example, robot\$oss-llm-puller (note how we escape the $ character)

export ROBOT_SECRET="ROBOT_ACCOUNT_SECRET"

docker login ${INSTANCE_URL} --username ${ROBOT_NAME} --password ${ROBOT_SECRET}
Kubernetes 이미지 가져오기 보안 비밀을 만듭니다.
kubectl을 사용하여 이전 단계에서 업데이트한 Docker 구성 파일을 사용하여 프로젝트 네임스페이스에 docker-registry 유형의 보안 비밀을 만듭니다.
# Log in into GDC environment using the next commands
gdcloud auth login --login-config-cert WEB_TLS_CERT_PATH
gdcloud clusters get-credentials KUBERNETES_CLUSTER
kubectl config set-context --current --namespace=NAMESPACE

export SECRET_NAME="OSS_LLM_PULL_SECRET"
export NAMESPACE="PROJECT_NAMESPACE"
# Assuming default Docker config path. Adjust if necessary.
export DOCKER_CONFIG_PATH="$HOME/.docker/config.json"

kubectl create secret docker-registry ${SECRET_NAME} \
      --from-file=.dockerconfigjson=${DOCKER_CONFIG_PATH} \
      -n ${NAMESPACE}
섹션 2: vLLM으로 배포
2.1 vLLM Docker 이미지 가져오기
인터넷 액세스 권한이 있는 머신에서 vLLM Docker 이미지를 가져온 다음 Harbor 프로젝트로 전송합니다.
# Pull and Tag vLLM (v0.13.0 recommended for stability)
docker pull vllm/vllm-openai:v0.13.0
docker tag vllm/vllm-openai:v0.13.0 HARBOR_URL/PROJECT/vllm-openai:v0.13.0
docker push HARBOR_URL/PROJECT/vllm-openai:v0.13.0
HARBOR_URL 및 PROJECT을 Harbor 인스턴스 URL 및 프로젝트 이름으로 바꿉니다.
2.2 PVC에서 모델 가중치 준비
YAML 파일을 만듭니다 (예: model-pvc.yaml).
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: model-pvc
spec:
  accessModes:
  - ReadWriteOnce
  resources:
    requests:
      storage: 500Gi
  storageClassName: standard-rwo
  volumeMode: Filesystem
PVC를 적용합니다. kubectl apply -f model-pvc.yaml
Hugging Face에서 가중치를 다운로드합니다.
hf auth login
hf download google/gemma-3-4b-it
헬퍼 포드 (예: helper-pod.yaml)를 사용하여 가중치를 PVC로 전송합니다.
Harbor에 busybox 이미지가 있는지 확인합니다.
# Push busybox if not present
docker pull busybox:latest
docker tag busybox HARBOR_URL/PROJECT/busybox:latest
docker push HARBOR_URL/PROJECT/busybox:latest

# Contents of helper-pod.yaml
apiVersion: v1
kind: Pod
metadata:
  name: model-uploader
spec:
  containers:
  - name: uploader
    image: HARBOR_URL/PROJECT/busybox:latest
    command: ["sleep", "3600"]
    volumeMounts:
    - name: model-data
      mountPath: /data
  imagePullSecrets:
  - name: oss-llm-pull-secret
  volumes:
  - name: model-data
    persistentVolumeClaim:
      claimName: model-pvc
포드를 적용하고 파일을 복사합니다.
kubectl apply -f helper-pod.yaml
# Wait for pod to be Running
kubectl cp ~/.cache/huggingface/hub/ NAMESPACE/model-uploader:/data/
kubectl delete pod model-uploader
2.3 vLLM 백엔드 배포
배포 파일 vllm-gemma-3-4b-it-deployment.yaml을 만듭니다.
apiVersion: apps/v1
kind: Deployment
metadata:
  name: gemma-3-4b-it
  labels:
    app: gemma-3-4b-it
spec:
  replicas: 1
  selector:
    matchLabels:
      app: gemma-3-4b-it
  template:
    metadata:
      labels:
        app: gemma-3-4b-it
    spec:
      volumes:
      - name: cache-volume
        persistentVolumeClaim:
          claimName: model-pvc
      - name: shm
        emptyDir:
          medium: Memory
          sizeLimit: "16Gi"
      containers:
      - name: gemma-3-4b-it
        image: HARBOR_URL/PROJECT/vllm-openai:v0.13.0
        command: ["python3"]
        args: [
          "-m",
          "vllm.entrypoints.openai.api_server",
          "--model",
          "google/gemma-3-4b-it",
          "--max-model-len",
          "32768",
          "--enforce-eager"
        ]
        env:
        - name: HF_HUB_OFFLINE
          value: "1"
        - name: HF_HOME
          value: "/model"
        - name: NCCL_P2P_DISABLE
          value: "1"
        - name: NCCL_IB_DISABLE
          value: "1"
        - name: BORINGSSL_FIPS
          value: "0"
        - name: OPENSSL_FIPS
          value: "0"
        - name: OPENSSL_CONF
          value: "/dev/null"
        - name: FIPS_SIG
          value: "off"
        ports:
        - containerPort: 8000
        securityContext:
          privileged: true
          runAsUser: 0
        resources:
          limits:
            nvidia.com/gpu-pod-NVIDIA_A100_80GB_PCIE: 1
            cpu: "8"
            memory: "64Gi"
          requests:
            nvidia.com/gpu-pod-NVIDIA_A100_80GB_PCIE: 1
            cpu: "8"
            memory: "32Gi"
        volumeMounts:
        - name: cache-volume
          mountPath: /model
        - name: shm
          mountPath: /dev/shm
      imagePullSecrets:
      - name: oss-llm-pull-secret
vllm-gemma-3-4b-it-service.yaml 서비스 파일을 만듭니다.
apiVersion: v1
kind: Service
metadata:
  name: gemma-3-4b-it
  namespace: NAMESPACE
spec:
  ports:
  - name: http-gemma-3-4b-it
    port: 80
    protocol: TCP
    targetPort: 8000
  selector:
    app: gemma-3-4b-it
  sessionAffinity: None
  type: LoadBalancer
구성을 적용합니다.
kubectl apply -f vllm-gemma-3-4b-it-deployment.yaml
kubectl apply -f vllm-gemma-3-4b-it-service.yaml
2.4 네트워크 정책 구성
vLLM 서비스 포트 (8000)로의 인그레스 트래픽을 허용하도록 ProjectNetworkPolicy 리소스를 적용합니다. vllm-netpol.yaml 만들기:
apiVersion: networking.gdc.goog/v1
kind: ProjectNetworkPolicy
metadata:
  name: allow-vllm-ingress
  namespace: NAMESPACE
spec:
  subject:
    subjectType: UserWorkload
  policyType: Ingress
  ingress:
  - from:
    - ipBlock:
        cidr: 0.0.0.0/0 # Restrict this in production
    ports:
    - protocol: TCP
      port: 8000
정책을 적용합니다. kubectl apply -f vllm-netpol.yaml
섹션 3: Ollama를 사용한 배포
3.1 Dockerfile 준비
모델이 미리 로드된 Ollama 이미지를 빌드하는 Dockerfile를 만듭니다.
FROM ubuntu

RUN apt-get update && apt-get install -y --no-install-recommends curl ca-certificates zstd
RUN curl -fsSL https://ollama.com/install.sh -o install.sh
RUN chmod +x install.sh
RUN ./install.sh && \
    rm -rf /var/lib/apt/lists/*

# Pre-pull gemma3 model
RUN ollama serve & \
    sleep 5 && \
    curl --retry 10 --retry-connrefused -s http://localhost:11434 || true && \
    ollama pull gemma3:latest && \
    pkill ollama || true

EXPOSE 11434
CMD ["ollama", "serve"]
3.2 이미지 빌드 및 푸시
이미지를 빌드하고 푸시합니다.
docker build -t ollama-gemma3 .
docker tag ollama-gemma3 HARBOR_URL/PROJECT/ollama-gemma3:latest
docker push HARBOR_URL/PROJECT/ollama-gemma3:latest
3.3 Ollama 백엔드 배포
ollama-gemma3.yaml 만들기:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: ollama-gemma3
  namespace: NAMESPACE
  labels:
    app: ollama-gemma3
spec:
  replicas: 1
  selector:
    matchLabels:
      app: ollama-gemma3
  template:
    metadata:
      labels:
        app: ollama-gemma3
    spec:
      containers:
      - name: ollama-gemma3
        image: HARBOR_URL/PROJECT/ollama-gemma3:latest
        env:
        - name: OLLAMA_HOST
          value: "0.0.0.0"
        imagePullPolicy: Always
        ports:
        - containerPort: 11434
        securityContext:
          privileged: true
          runAsUser: 0
        resources:
          limits:
            nvidia.com/gpu-pod-NVIDIA_A100_80GB_PCIE: 1
          requests:
            nvidia.com/gpu-pod-NVIDIA_A100_80GB_PCIE: 1
      imagePullSecrets:
      - name: oss-llm-pull-secret
---
apiVersion: v1
kind: Service
metadata:
  name: ollama-gemma3
  namespace: NAMESPACE
spec:
  type: LoadBalancer
  selector:
    app: ollama-gemma3
  ports:
  - name: ollama-gemma3-port
    port: 11434
    protocol: TCP
    targetPort: 11434
매니페스트를 적용합니다. kubectl apply -f ollama-gemma3.yaml
3.4 네트워크 정책 구성
ollama-netpol.yaml 만들기:
apiVersion: networking.gdc.goog/v1
kind: ProjectNetworkPolicy
metadata:
  name: allow-ollama-ingress
  namespace: NAMESPACE
spec:
  subject:
    subjectType: UserWorkload
  policyType: Ingress
  ingress:
  - from:
    - ipBlock:
        cidr: 0.0.0.0/0 # Restrict this for production.
    ports:
    - protocol: TCP
      port: 11434
정책을 적용합니다. kubectl apply -f ollama-netpol.yaml
섹션 4: 검증
포드 상태, 서비스 IP 주소를 확인하고 curl를 사용하여 vLLM과 Ollama 모두의 LoadBalancer IP 주소로 테스트 추론 요청을 전송하여 배포를 확인합니다.
모든 컨테이너와 서비스가 Running인지 확인합니다.
# Login into GDC air-gapped using the next commands
gdcloud auth login --login-config-cert WEB_TLS_CERT_PATH
gdcloud clusters get-credentials KUBERNETES_CLUSTER
kubectl config set-context --current --namespace=NAMESPACE

# Pods
kubectl get pods

# Services
kubectl get services
vLLM 테스트:
export VLLM_IP=$(kubectl get service gemma-3-4b-it -n NAMESPACE -o jsonpath='{.status.loadBalancer.ingress[*].ip}')
curl http://${VLLM_IP}/v1/chat/completion \
  -H "Content-Type: application/json" \
  -d '{
    "model": "google/gemma-3-4b-it",
    "messages": [
      {"role": "user", "content": "What is Google Distributed Cloud air-gapped?"}
    ],
    "max_tokens": 100
  }'
Ollama 테스트:
export OLLAMA_IP=$(kubectl get service ollama-gemma3 -n NAMESPACE -o jsonpath='{.status.loadBalancer.ingress[*].ip}')
# Check if Ollama is running
curl http://${OLLAMA_IP}:11434
# Send a completion request
curl -X POST http://${OLLAMA_IP}:11434/v1/completions \
-H "Content-Type: application/json" \
-d '{
  "model": "gemma3:latest",
  "prompt": "Google Distributed Cloud air-gapped is a",
  "max_tokens": 128,
  "temperature": 0.90,
  "stream": false
}'
섹션 5: 운영 및 문제 해결
5.1 vLLM 작업
로그 확인: kubectl logs -f -n NAMESPACE
내부 상태 쿼리 (디버그 포드에서):
wget -qO- http://gemma-3-4b-it/v1/models
wget -qO- http://gemma-3-4b-it/health
5.2 Ollama 작업
CLI 액세스: kubectl exec -it -n NAMESPACE -- sh
포드 내부: ollama list, ollama ps
5.3 확장
Ollama 백엔드로 솔루션 확장
세로
- 전체 GPU를 사용할 때까지 병목 현상이 된 LLM에 더 큰 GPU 슬라이스를 할당합니다.
- 더 나은 응답 정확도를 위해 더 큰 LLM(예: 7B 대신 405B 파라미터 LLM)을 사용하려면 원활하게 실행하기 위해 GPU가 두 개 이상 필요할 수 있습니다.
- 두 개 이상의 GPU에 적합한 모델은 GPU 간 통신과 관련된 지연 시간이 발생합니다.
가로
- 특정 LLM에서 목표 처리량을 달성하는 데 필요한 만큼 Ollama 포드를 배포합니다.
- 이를 위해 해당 Ollama 배포 YAML 파일에서 replica 수를 늘립니다.
- LoadBalancer 유형인 Kubernetes 서비스는 엔드포인트 (즉, 포드) 간에 코드 지원 요청을 분산하고 노출된 외부 IP를 통해 각 응답을 반환합니다.
- Continue 플러그인은 기능당 하나의 IP 주소만 가리킵니다.
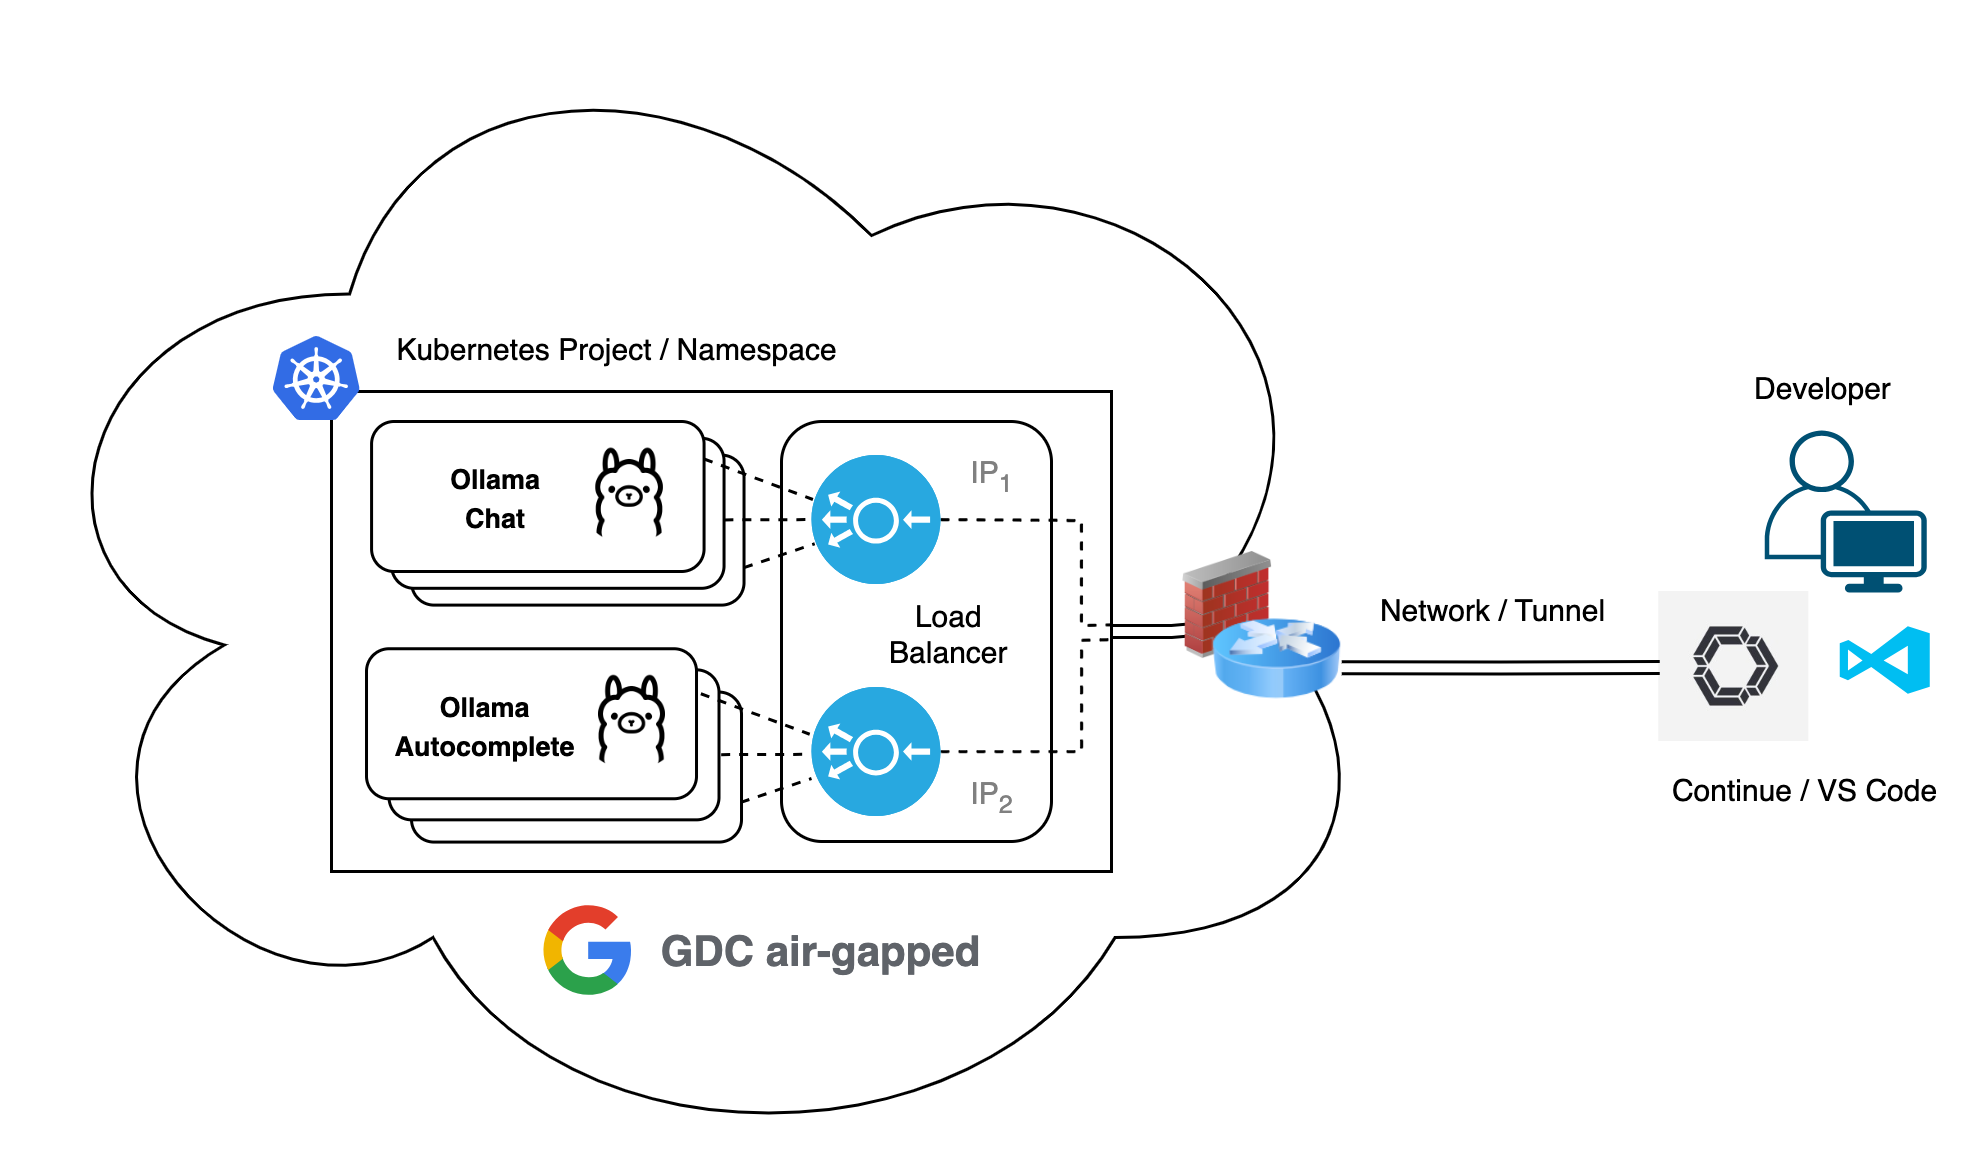
GDC 에어갭 환경 내에서 vLLM 백엔드를 확장하려면 Ollama에 사용된 것과 유사한 전략을 따라 하드웨어 리소스 할당과 포드 복제를 모두 고려하면 됩니다.
vLLM 백엔드로 솔루션 확장
세로
- GPU 할당 업그레이드: 추론 처리량 (토큰/초)이 병목 현상이 되면 NVIDIA A100 GPU를 완전히 사용할 때까지 더 큰 GPU 슬라이스를 할당합니다.
- 멀티 GPU 구성: 단일 80GB A100의 메모리에 맞지 않는 대규모 모델 (예: 700억~4,050억 개의 파라미터)의 경우 텐서 동시 로드를 사용하여 여러 GPU로 확장해야 합니다.
- 지연 시간 고려사항: GPU가 두 개 이상인 모델은 GPU 간 통신 (예: NCCL 동기화)과 관련된 약간의 오버헤드가 발생할 수 있습니다.
가로
- 복제본을 통한 처리량 증가: 동일한 모델에 대한 동시 사용자 요청 수가 많은 경우 vLLM 배포 YAML에서 복제본 수를 늘립니다.
- 전용 모델 인스턴스: vLLM은 단일 모델 서비스 엔진으로 설계되어 초기화 시 KV 캐시 메모리를 고정하므로 호스팅하려는 각기 다른 LLM에 대해 별도의 포드 집합을 배포해야 합니다.
- 부하 분산: GDC Kubernetes 서비스 (유형 LoadBalancer)는 해당 서비스와 연결된 모든 정상 vLLM 포드 엔드포인트 간에 수신되는 추론 요청을 자동으로 분산합니다.
5.4 문제 해결
일반적인 오류 및 완화
| 오류 | 완화 |
|---|---|
| FIPS 자체 테스트 실패 | BoringSSL과 같은 라이브러리에 무결성 서명이 없는 경우 발생합니다. BORINGSSL_FIPS=0을 설정하고 공식 vLLM 이미지를 사용하여 수정 |
| 정체된 체중 로드 | 작은 PVC에서 IOPS 제한이 있는지 확인합니다. 성능 모델 초기화에는 500GiB 볼륨이 필요합니다. |
| 연결 거부됨 | PNP가 targetPort (8000/8080)를 명시적으로 허용하는지 확인합니다. GDC 방화벽은 부하 분산기 VIP의 백엔드 포트에 대한 액세스 권한을 자동으로 부여하지 않습니다. |