


Dichiarazione del problema
Le organizzazioni che eseguono modelli linguistici di grandi dimensioni (LLM) in ambienti con air gap
accumulano rapidamente endpoint dei modelli: ogni modello open weight pubblicato su
Google Distributed Cloud con air gap (consulta il set di guide complementari Modelli open weight
su GDC con air gap) espone il proprio Kubernetes Service,
il proprio indirizzo, le proprie credenziali e il proprio ciclo di vita operativo.
Gli sviluppatori di applicazioni e agenti finiscono in silos architetturali, codificando un
endpoint per modello e riscrivendo le integrazioni a ogni iterazione del modello. Questa
frammentazione crea problemi tecnici e rallenta il deployment di
workload agentici in più fasi e mission-critical.
Anche i livelli di rete standard sono "ciechi all'AI": un bilanciatore del carico convenzionale tratta il traffico di inferenza come HTTP generico e non può leggere il campo model di una richiesta, dare la priorità ai carichi di lavoro sensibili alla latenza, tenere conto dei token anziché delle richieste o indirizzare una richiesta alla replica del server di modelli che contiene già la cache KV pertinente. Nei cluster GPU air-gapped ad alto costo, ciò comporta un sottoutilizzo dell'hardware
e un basso ritorno sull'investimento. Gemini on
GDC
fornisce modelli di frontiera gestiti, ma i clienti che li combinano con modelli open weight
self-hosted hanno bisogno di un livello di inferenza che offra l'agilità del cloud
senza compromettere la sovranità dei dati: nessuna richiesta, prompt o peso del modello può
uscire dal confine di GDC.
Soluzione proposta
Questo documento descrive l'architettura di riferimento per un gateway AI autogestito
su GDC con air gap: un livello di inferenza sicuro e centralizzato
che fornisce alle applicazioni un endpoint compatibile con OpenAI per tutti i modelli e indirizza
ogni richiesta al backend corretto. L'implementazione di riferimento si basa sull'API Kubernetes Gateway: Envoy Gateway è l'implementazione dell'API Gateway (piano di controllo e piano dati del proxy Envoy) ed Envoy Agent Router (in precedenza Envoy AI Gateway) la estende con l'elaborazione delle richieste specifiche per l'AI: estrazione del modello dal corpo della richiesta, traduzione di richieste e risposte, autenticazione upstream, conteggio dei token e, facoltativamente, limitazione di frequenza basata sui token. L'estensione di inferenza dell'API Gateway aggiunge la selezione degli endpoint in base al server dei modelli (InferencePool e Endpoint Picker) in modo che la capacità della GPU venga utilizzata in modo efficiente. Tutti gli artefatti vengono
inseriti nel registro Harbor dell'organizzazione GDC
e l'intero stack viene eseguito in un cluster standard senza connettività
esterna.
Cosa è incluso:questa architettura copre il deployment di Envoy Gateway e Envoy Agent Router in un cluster standard, le risorse Gateway API (GatewayClass, Gateway) e le risorse Envoy Agent Router (AIGatewayRoute, AIServiceBackend, BackendSecurityPolicy, GatewayConfig) che espongono un endpoint unificato compatibile con OpenAI, il routing basato sul corpo nel campo model, l'estensione di inferenza dell'API Gateway (InferencePool, InferenceObjective, selettore di endpoint) per il bilanciamento del carico consapevole del modello, la limitazione della frequenza facoltativa basata su token con Redis, la terminazione TLS al gateway, i criteri di rete (NetworkPolicy/ProjectNetworkPolicy) e la gestione degli artefatti air-gapped in Harbor. I backend di erogazione del modello dietro il gateway (Ollama, vLLM) vengono implementati con la guida complementare Imposta modelli open weight su GDC con air gap.
Cosa non è incluso:questa architettura non copre un prodotto gateway AI gestito, il deployment e l'ottimizzazione dei modelli stessi (set di guide complementari), l'ottimizzazione dei modelli, le modalità GenAI non LLM, il traffico da agente a strumento (MCPRoute) o le distribuzioni di gateway supportate commercialmente. Gemini su
GDC è una conoscenza del prodotto gestita; il suo provisioning è
fuori ambito e questa versione del set di guide convalida il gateway con
modelli open weight self-hosted.
Pubblico:il pubblico principale di questo documento include gli amministratori della piattaforma responsabili dell'implementazione e del funzionamento del gateway in un cluster standard e gli architetti tecnici che progettano piattaforme AI all'interno dell'ambiente con air gap. Gli sviluppatori di applicazioni che utilizzano l'endpoint unificato sono un pubblico secondario che trae vantaggio dalla comprensione del routing delle richieste.
Architettura
La soluzione viene eseguita interamente in un cluster standard dell'organizzazione GDC con air gap. Nel livello Servizi, lo
standard dell'API Kubernetes Gateway standardizza il modello di configurazione; il piano di controllo
del gateway AI (il controller Envoy Gateway e il controller Envoy Agent Router)
legge le risorse dell'API Gateway e di Envoy Agent Router e
configura il piano dati: un proxy Envoy Deployment che è il punto di ingresso
della richiesta (esposto tramite un Service di tipo LoadBalancer) e il processore esterno
Envoy Agent Router che viene eseguito come sidecar nel proxy Pod ed esegue
la logica specifica per l'AI. Nel livello Applicazione, i carichi di lavoro dei clienti
(applicazioni e agenti) inviano una richiesta AI al proxy (1), il proxy passa
la richiesta al processore esterno, che estrae il nome del modello, traduce
la richiesta e registra l'utilizzo dei token (2), il proxy inoltra il traffico bilanciato
alle Pod di inferenza del modello selezionato (3) e il modello viene eseguito sui nodi GPU
del livello Infrastruttura (4). I backend di erogazione dei modelli sono collegati
al gateway come AIServiceBackend (qualsiasi Service compatibile con OpenAI) o
come InferencePool il cui selettore di endpoint seleziona la replica migliore per
richiesta. Le immagini container e i grafici Helm vengono estratti da Harbor.
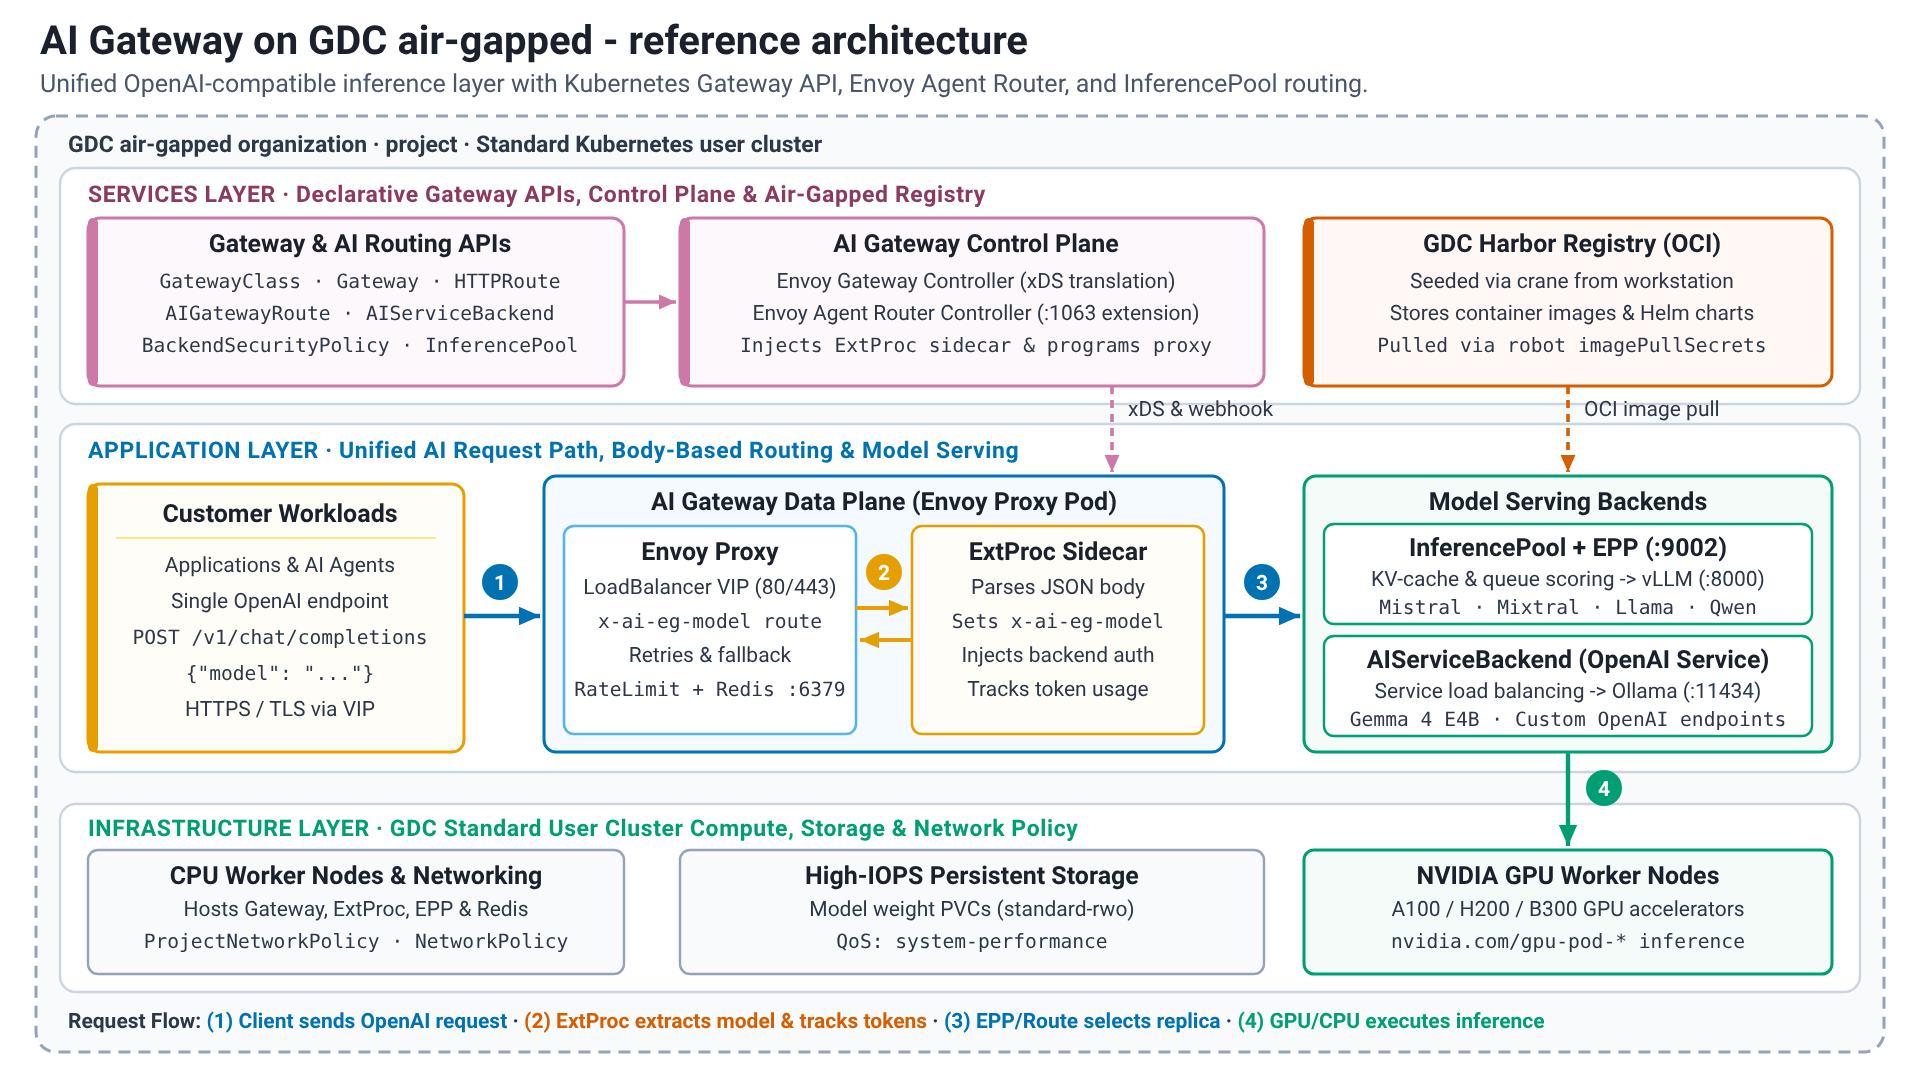
Componenti della soluzione
La soluzione utilizza i seguenti componenti:
| Componente della soluzione | Responsabilità | Flusso di dati | Interfacce |
|---|---|---|---|
| API Kubernetes Gateway | Modello di risorse standard orientato ai ruoli per l'ingresso e il routing: GatewayClass (di proprietà della piattaforma), Gateway (listener, TLS) e risorse di route (di proprietà dei team delle applicazioni). Successore dell'API Ingress senza annotazioni specifiche del fornitore. |
Solo configurazione dichiarativa; le risorse vengono monitorate dai controller e non trasportano traffico di richieste. | API Kubernetes (gateway.networking.k8s.io/v1); i CRD vengono installati dal grafico CRD di Envoy Gateway. |
| Controller (control plane) di Envoy Gateway | Implementa l'API Gateway: esegue il provisioning di un proxy Envoy Deployment e LoadBalancer Service per Gateway, traduce route e policy (BackendTrafficPolicy, SecurityPolicy, EnvoyExtensionPolicy, Backend, EnvoyProxy) nella configurazione xDS, esegue il servizio di limitazione della velocità globale quando configurato e chiama il server di estensione del router dell'agente Envoy tramite il suo gestore delle estensioni in modo che i backend InferencePool vengano aggiunti alla traduzione. |
Monitora l'API Kubernetes e invia la configurazione xDS ai proxy; nessun traffico di richieste. | API Kubernetes (watch), xDS gRPC verso i proxy, gRPC verso il server di estensione (porta 1063). |
| Controller del router dell'agente Envoy (control plane) | Esegue la riconciliazione delle risorse aigateway.envoyproxy.io/v1beta1, AIGatewayRoute (regole di instradamento sul nome del modello estratto), AIServiceBackend (un backend con il relativo schema dell'API), BackendSecurityPolicy (credenziali upstream) e GatewayConfig (impostazioni del processore esterno per Gateway) nelle risorse Envoy Gateway, inserisce il file collaterale del processore esterno nei proxy Envoy Pod ed eroga il server di estensione utilizzato da Envoy Gateway. |
Solo configurazione. | API Kubernetes, server di estensione gRPC (porta 1063), webhook di ammissione mutante per l'iniezione sidecar. |
| Proxy Envoy (data plane) | Punto di ingresso della richiesta: termina TLS, corrisponde a listener e route, bilancia il carico tra gli endpoint di backend, applica limiti di frequenza e timeout, riprova e torna ai backend alternativi ed emette log e metriche di accesso. | Riceve le richieste del client sul VIP LoadBalancer (80/443), consulta il processore esterno per ogni richiesta AI, inoltra la richiesta all'endpoint di backend selezionato (un Service o l'Pod scelto dal selettore di endpoint) e trasmette la risposta in streaming al client. |
HTTP/HTTPS verso i client (API compatibile con OpenAI), gRPC ext_proc verso il sidecar e il selettore di endpoint, HTTP verso i backend, gRPC verso il servizio di limite di frequenza. |
| Processore esterno (ExtProc) del router dell'agente Envoy | Analizza il corpo della richiesta compatibile con OpenAI, estrae il campo model nell'intestazione di routing x-ai-eg-model, applica gli override del nome del modello, traduce i payload di richiesta e risposta tra lo schema dell'API client e lo schema dell'API di backend, inserisce le credenziali upstream definite da BackendSecurityPolicy ed estrae l'utilizzo dei token (input, output, totale) dalla risposta nei metadati dinamici utilizzati per la limitazione di frequenza basata su token e le metriche. |
Container sidecar nel proxy Envoy Pod; elabora i corpi delle richieste e delle risposte, incluse le risposte in streaming. |
gRPC ext_proc di Envoy; endpoint delle metriche di Prometheus. |
| Estensione di inferenza dell'API Gateway (InferencePool + Endpoint Picker) | InferencePool (inference.networking.k8s.io/v1) raggruppa i Pod di un deployment del server di modelli (selettore etichetta, porta di destinazione, ad esempio 8000) e fa riferimento al relativo Endpoint Picker (EPP). InferenceObjective (v1alpha2) assegna una priorità per modello o obiettivo. L'EPP recupera le metriche del server di modelli (profondità della coda delle richieste, utilizzo della cache KV, adattatori LoRA caricati) e seleziona l'endpoint per ogni richiesta. |
Il proxy chiama l'EPP (ext_proc, porta 9002) con le intestazioni della richiesta; l'EPP risponde con l'endpoint da utilizzare; il proxy inoltra la richiesta a questo Pod. |
API Kubernetes (CRD), gRPC ext_proc (9002), scraping Prometheus dei server di modelli. |
| Redis (facoltativo) | Archivio di backup del servizio di limitazione della frequenza di Envoy: contatori condivisi per i limiti basati su richieste e token in tutte le repliche del proxy. Necessario solo quando è configurata la limitazione di frequenza globale. | Il servizio di limitazione della frequenza legge e incrementa i contatori sulla porta 6379 per ogni richiesta limitata. | Protocollo Redis (6379). Redis 8.10 di cui è stato eseguito il deployment nel cluster o un'istanza Redis esistente. |
| Backend di erogazione dei modelli (Ollama / vLLM) | Eroga i modelli open weight dietro il gateway; di cui è stato eseguito il deployment con la guida complementare Imposta modelli open weight su GDC con air gap. Allegato come AIServiceBackend (qualsiasi Service compatibile con OpenAI, ad esempio Ollama) o come InferencePool (server di modelli come vLLM che espongono le metriche su cui si basa il punteggio dello strumento di selezione degli endpoint). |
Ricevi le richieste instradate dal proxy, esegui l'inferenza sui nodi GPU (o sulla CPU per la valutazione funzionale con modelli di piccole dimensioni) e restituisci la risposta compatibile con OpenAI. | API REST compatibile con OpenAI: vLLM sulla porta 8000, Ollama sulla porta 11434; metriche Prometheus (vLLM) per il selettore di endpoint. |
| Porto | Archivia le immagini container (proxy Envoy, Envoy Gateway, controller e processore esterno di Envoy Agent Router, servizio di limitazione della frequenza, selettore di endpoint, Redis) e i grafici Helm (artefatti OCI) della soluzione. | Gli artefatti vengono copiati dai registri pubblici in Harbor con seed_registry.sh (crane) da una workstation con accesso a internet; il cluster esegue il pull delle immagini con un account robot tramite i secret di pull delle immagini e i grafici vengono visualizzati da Harbor con helm template. |
API OCI Distribution; UI Harbor e account robot. |
| Cluster Standard e nodi GPU | Ospita tutti i componenti del gateway (i nodi CPU sono sufficienti) e gli Pod di inferenza (nodi GPU con le risorse dell'acceleratore rilevate dai nodi). Fornisce VIP LoadBalancer, spazio di archiviazione permanente per i pesi del modello e l'applicazione dei criteri di rete. |
Piattaforma di base; le richieste vengono inserite tramite il VIP LoadBalancer di Gateway e rimangono all'interno della rete del cluster. |
API Kubernetes, API di networking GDC (networking.gdc.goog/v1 ProjectNetworkPolicy), console GDC e gdcloud per l'amministratore della piattaforma. |
Caratteristiche e funzionalità
Questa architettura di riferimento fornisce le seguenti funzionalità di base:
- Endpoint unificato compatibile con OpenAI: le applicazioni chiamano un indirizzo
(
/v1/chat/completions,/v1/models, …) per ogni modello pubblicato dietro il gateway.- Componenti:
Gateway,AIGatewayRoute, proxy Envoy, processore esterno. - Responsabilità:esporre un IP virtuale stabile, terminare TLS, accettare il formato di richiesta compatibile con OpenAI e tradurlo nello schema di backend, se necessario.
- Interfacce:HTTPS REST (JSON, inclusi gli eventi inviati dal server per lo streaming).
- Componenti:
- Routing basato sul corpo (con riconoscimento del modello):il gateway legge il campo
modeldel corpo della richiesta e la indirizza al backend corrispondente senza alcuna logica dell'endpoint lato client.- Componenti:processore esterno, corrispondenza delle regole
AIGatewayRoutesux-ai-eg-model,AIServiceBackend,InferencePool. - Responsabilità:estrazione del nome del modello, corrispondenza delle regole di routing,
rinomina dei modelli (
modelNameOverride), suddivisione del traffico in base al peso e fallback ai backend alternativi in base alla priorità. - Interfacce:API Kubernetes (
aigateway.envoyproxy.io/v1beta1).
- Componenti:processore esterno, corrispondenza delle regole
- Bilanciamento del carico basato sul server del modello:le richieste a un
InferencePoolvengono inviate alla replica con la coda più breve e la cache KV più utile anziché in modalità round robin.- Componenti:estensione di inferenza dell'API Gateway (
InferencePool,InferenceObjective, Endpoint Picker). - Responsabilità:scraping delle metriche del server di modelli, endpoint di assegnazione del punteggio (profondità della coda, utilizzo della cache KV, affinità della cache dei prefissi, adattatori LoRA), rispetto delle priorità per obiettivo sotto carico.
- Interfacce: API Kubernetes (
inference.networking.k8s.io/v1,inference.networking.x-k8s.io/v1alpha2), gRPC ext_proc (9002).
- Componenti:estensione di inferenza dell'API Gateway (
- Policy di autenticazione e sicurezza upstream:le credenziali per i backend
che le richiedono vengono inserite dal gateway e mai distribuite alle
applicazioni.
- Componenti:
BackendSecurityPolicy, Envoy GatewaySecurityPolicy, listener TLS. - Responsabilità: inserimento di chiavi API nei backend, terminazione
di TLS client in
Gateway, applicazione di criteri di autenticazione e autorizzazione client, se necessario. - Interfacce:
SecretKubernetes a cui fanno riferimento i criteri.
- Componenti:
- Limitazione di frequenza basata sui token (facoltativo): l'utilizzo viene misurato in token, non solo in richieste.
- Componenti: processore esterno (
llmRequestCosts), Envoy GatewayBackendTrafficPolicy(limite di frequenza globale), servizio di limite di frequenza, Redis. - Responsabilità: estrazione di token di input, output e totali da ogni risposta, allegandoli come costi della richiesta, applicazione di budget per consumatore o per modello in tutte le repliche del proxy.
- Interfacce:API Kubernetes, Redis (6379).
- Componenti: processore esterno (
- Gestione del traffico:le funzionalità standard dell'API Gateway si applicano al traffico AI.
- Componenti:
Gateway,HTTPRoute,AIGatewayRoute,BackendTrafficPolicy. - Responsabilità: corrispondenza basata su host, percorso e intestazione, timeout adatti a generazioni lunghe, tentativi, suddivisione ponderata del traffico e failover basato sulla priorità tra i backend.
- Interfacce:API Kubernetes.
- Componenti:
- Osservabilità:le metriche relative a richieste, latenza e token sono disponibili per
ogni modello.
- Componenti:log di accesso e statistiche del proxy Envoy, metriche del processore esterno (utilizzo dei token, durata della richiesta, tempo al primo token), metriche di Endpoint Picker.
- Responsabilità:esporre metriche in formato Prometheus e log di accesso strutturati che lo stack di osservabilità GDC o un'istanza Prometheus gestita dal cliente possono eseguire lo scraping.
- Interfacce:endpoint delle metriche di Prometheus, log di output standard.
- Gestione degli artefatti air-gap:ogni immagine e grafico viene preparato in
Harbor prima dell'installazione.
- Componenti:Harbor,
seed_registry.sh, account robot, segreti di pull delle immagini, risorsaEnvoyProxy(immagine proxy e segreto di pull). - Responsabilità: seeding di immagini e grafici Helm OCI da una workstation connessa, blocco delle versioni, rendering offline dei grafici con
helm template. - Interfacce:API OCI Distribution, API Kubernetes.
- Componenti:Harbor,
Principi architettonici
- Priorità agli standard: il gateway è configurato tramite l'API Kubernetes Gateway e la relativa estensione di inferenza e utilizza l'API compatibile con OpenAI per le applicazioni, in modo che applicazioni, route e backend rimangano portatili tra le implementazioni del gateway.
- Priorità alla sicurezza: tutti i componenti e i dati risiedono all'interno del
confine con air gap di GDC. TLS termina in
Gateway, le credenziali di backend vengono inserite dal gateway e l'accesso alla rete è limitato con gli oggettiNetworkPolicyeProjectNetworkPolicy. - Sovranità dei dati: prompt, risposte, ponderazioni del modello e dati di utilizzo non escono mai dall'organizzazione GDC del cliente; per il funzionamento non è richiesta connettività esterna.
- Separazione delle competenze: l'API Gateway orientata ai ruoli consente all'amministratore della piattaforma di gestire
GatewayClass,Gateway, TLS e le norme di rete, mentre i team delle applicazioni gestiscono le risorseAIGatewayRoute,AIServiceBackendeInferencePoolnei propri spazi dei nomi. - Piano di controllo e piano dati disaccoppiati: i controller traducono solo la configurazione; il percorso della richiesta è costituito dal proxy Envoy, dal relativo sidecar del processore esterno e dal selettore di endpoint, che continuano a gestire il traffico se un controller viene riavviato.
- Aperta e flessibile: l'architettura utilizza software open source (Envoy Gateway, Envoy Agent Router, Gateway API Inference Extension, Ollama, vLLM) e le stesse risorse API Gateway possono essere gestite da implementazioni alternative.
- Scalabilità e prestazioni: il piano dati viene scalato orizzontalmente aggiungendo repliche proxy e verticalmente regolando CPU e memoria; il bilanciamento del carico consapevole del server dei modelli mantiene le GPU sature senza sovraccaricare le singole repliche.
- Esperienza utente finale semplificata: un endpoint, un formato API e una credenziale per ogni modello riducono il percorso dal deployment del modello al consumo.
- Resilienza: i controlli di integrità e la replica di Kubernetes, i tentativi di Envoy e il failover basato sulla priorità tra i backend mantengono l'endpoint disponibile quando le singole repliche del modello non funzionano.
Considerazioni
- Scalabilità e prestazioni:
- I componenti del gateway sono workload solo CPU; il proxy Envoy
Deploymentdi unGatewayviene scalato orizzontalmente aumentando il numero di repliche (risorsaEnvoyProxy) e verticalmente aumentando le richieste di CPU e memoria. L'ispezione del corpo da parte del processore esterno costa CPU proporzionale alle dimensioni della richiesta e della risposta; le risposte in streaming vengono elaborate in modo incrementale. - Il bilanciamento del carico basato sul server del modello si applica solo ai backend collegati come
InferencePool; i backend collegati comeAIServiceBackendsono bilanciati dal proxy tra gli endpoint del relativoService. - Il gateway non aggiunge capacità GPU: la velocità effettiva e la latenza sono limitate dai server dei modelli. Dimensiona i deployment del modello con il set di guide complementari (vLLM per un throughput elevato, Ollama per facilità d'uso e valutazione solo CPU).
- Le generazioni lunghe richiedono timeout di richiesta e inattività più lunghi rispetto alle API HTTP tipiche. Configurali su route e criteri anziché sui client.
- I componenti del gateway sono workload solo CPU; il proxy Envoy
- Gestione delle risorse:
- Tutti i componenti del gateway vengono eseguiti sui nodi CPU e non richiedono acceleratori. La tabella seguente fornisce un dimensionamento indicativo per un deployment funzionale. L'implementazione di riferimento imposta le richieste e i limiti esatti; i valori di produzione dipendono dal tasso di richieste e dalle dimensioni del payload.
- La tabella delle porte che segue elenca tutte le porte che le policy di rete devono ammettere.
- La pianificazione della GPU appartiene ai deployment dei modelli: i nomi delle risorse dell'acceleratore vengono rilevati dai nodi come descritto nel set di guide complementari.
Dimensionamento indicativo dei componenti del gateway (solo CPU)
| Componente | Repliche | CPU (richiesta) | Memoria (richiesta) | Note |
|---|---|---|---|---|
| Controller Envoy Gateway | 1 | 100 m - 500 m | 256 MiB - 1 GiB | Control plane; not in the request path |
| Controller del router dell'agente Envoy | 1 | 100 m - 500 m | 256 Mi-512 Mi | Control plane e server delle estensioni |
Proxy Envoy Pod (proxy + sidecar del processore esterno) |
1-2 per Gateway |
500m–2 | 512Mi–2Gi | Scalare in base al tasso di richieste e alle dimensioni del payload |
| Selettore endpoint | 1 per InferencePool |
100 m - 500 m | 256 Mi-512 Mi | Esegue lo scraping delle metriche del server di modelli |
| Servizio di limitazione della frequenza (facoltativo) | 1 | 100 m - 500 m | 256 Mi-512 Mi | Solo con la limitazione di frequenza globale |
| Redis (facoltativo) | 1 | 100 m - 500 m | 256 MiB - 1 GiB | Solo con la limitazione di frequenza globale |
Porte di rete
| Porta | Componente | Finalità |
|---|---|---|
| 80 / 443 | Proxy Envoy (Gateway listener) |
Punto di ingresso HTTP / HTTPS sul VIP LoadBalancer |
| 1063 | Controller del router dell'agente Envoy (server di estensione) | Chiamate gRPC dal gestore delle estensioni di Envoy Gateway |
| 9002 | Selettore endpoint | Chiamate gRPC ext_proc dal proxy Envoy |
| 6379 | Redis | Contatori dei limiti di frequenza |
| 8000 | vLLM | API compatibile con OpenAI e metriche del server di modelli |
| 11434 | Ollama | API compatibile con Ollama e OpenAI del server di modelli |
- Disponibilità e affidabilità:
- Il proxy e il processore esterno vengono eseguiti nello stesso
Pod; più repliche dietro la mascheraLoadBalancerServicemascherano i singoli erroriPode i controller possono essere riavviati senza interrompere il traffico. - Le regole
AIGatewayRoutepossono elencare diversi backend con priorità in modo che il gateway esegua il failover su un altro set di repliche o server di modelli quando un backend non è integro. - Il selettore di endpoint è un
Deploymentper pool; se non è disponibile, le richieste a quelInferencePoolnon vanno a buon fine finché non torna disponibile. Esegui con richieste di risorse e probe di idoneità e monitoralo come un componente del data plane. - Redis contiene solo i contatori del limite di frequenza; un'interruzione di Redis influisce sul limite di frequenza, non sul routing.
- Il proxy e il processore esterno vengono eseguiti nello stesso
- Complessità operativa:
- Allineamento delle versioni tra Envoy Gateway, Envoy Agent Router e l'estensione di inferenza dell'API Gateway: esegui l'upgrade di tutti e tre con la combinazione testata (Envoy Gateway 1.8.4, Envoy Agent Router 1.1.0, estensione di inferenza dell'API Gateway 1.5.0).
- Ciclo di vita air-gapped: ogni immagine e grafico viene reinserito in Harbor per
ogni upgrade; la risorsa
EnvoyProxye i valori del grafico bloccano il registro e il segreto di pull. - Due livelli di configurazione:
GatewayClass/Gateway/EnvoyProxydi proprietà della piattaforma eAIGatewayRoute/AIServiceBackend/InferencePooldi proprietà del team; l'onboarding di un nuovo modello significa aggiungere una regola di instradamento e un backend, non un nuovo gateway. - Monitoraggio: tasso di richieste, latenza (incluso il tempo necessario per il primo token), utilizzo dei token per modello e per consumatore, punteggio del selettore di endpoint e utilizzo della GPU dei server dei modelli.
InferenceObjectiveè ancora un'API alpha (v1alpha2); prevedi modifiche allo schema tra le release dell'estensione Inference.
- Sicurezza e conformità:
- L'intera soluzione opera all'interno del perimetro di sicurezza isolato da internet del GDC.
- Le policy di rete sono obbligatorie: uno spazio dei nomi
NetworkPolicyammette il traffico dal proxy alle porte del server di modelli (8000, 11434) e al selettore di endpoint (9002), mentre unProjectNetworkPolicyammette il traffico client al VIPLoadBalancerquando i consumer si trovano al di fuori del progetto. - TLS termina in
Gatewaycon un certificato archiviato in unSecretKubernetes; i client vedono solo l'endpoint del gateway. - Le credenziali upstream (ad esempio una chiave API richiesta da un server di modelli)
vengono archiviate nei
Secreta cui fa riferimento unBackendSecurityPolicye inserite dal gateway, in modo che le applicazioni non contengano mai credenziali di backend. - La limitazione di frequenza basata su token limita il consumo di costose risorse GPU per consumatore o per modello.
- Gli account robot Harbor e i secret di pull delle immagini Kubernetes garantiscono l'accesso sicuro alle immagini container; il controllo degli accessi basato sui ruoli (RBAC) dell'API Gateway orientata ai ruoli separa le responsabilità della piattaforma e dell'applicazione.
Decisioni di progettazione
Per questa architettura di riferimento sono state prese le seguenti decisioni di progettazione chiave:
Decisione 1: implementazione del gateway AI: Envoy Agent Router open source su Envoy Gateway rispetto a distribuzioni alternative
| Contesto | Decisione chiave | Rationale |
|---|---|---|
| Il gateway AI è la scelta architettonica principale con alternative valide, dalle opzioni open source autogestite alle offerte supportate commercialmente: (a) Envoy Agent Router su Envoy Gateway (open source), (b) kgateway e agentgateway (implementazioni open source dell'API Gateway che gestiscono anche il traffico del provider LLM, gli strumenti MCP e la comunicazione da agente ad agente in un unico piano dati, facoltativamente con il supporto del fornitore di solo.io), (c) Solo Enterprise per agentgateway come opzione premium supportata commercialmente. | L'implementazione di riferimento utilizza il router dell'agente Envoy open source su Envoy Gateway. Le alternative rimangono scelte valide per le stesse risorse dell'API Gateway; per gli ambienti di produzione che richiedono assistenza dedicata del fornitore è consigliata una distribuzione supportata commercialmente. | Vantaggi dell'open source: leggero e conforme agli standard, routing L7 ad alte prestazioni, nessuna commissione di licenza, ideale per valutare la soluzione prima di impegnarsi in un'offerta a pagamento. Envoy Agent Router è l'opzione convalidata in questo insieme di guide. Svantaggi dell'open source: l'assistenza è fornita al meglio dal team di soluzioni e dalla community, il che potrebbe non soddisfare gli ambienti di produzione principali. Vantaggi premium: contratti di assistenza aziendale per il ciclo di vita del gateway e, spesso, funzionalità agentiche avanzate. Svantaggi della versione Premium: contratto di licenza o assistenza a pagamento e un ulteriore rapporto con il fornitore. |
Decisione 2: API Gateway Kubernetes con l'estensione Inference rispetto a Ingress o a un'API Gateway proprietaria
| Contesto | Decisione chiave | Rationale |
|---|---|---|
| Gli endpoint di inferenza possono essere esposti con l'API Ingress legacy, un formato di configurazione specifico del gateway o l'API Gateway di Kubernetes. Il bilanciamento del carico basato sul modello richiede inoltre un modo per descrivere i pool di server di modelli e le relative priorità. | La soluzione si basa sull'API Gateway di Kubernetes (GatewayClass, Gateway, route) implementata da Envoy Gateway e sull'estensione di inferenza dell'API Gateway (InferencePool, InferenceObjective, Endpoint Picker) per il routing basato sul modello. |
L'API Gateway è lo standard Kubernetes che succede a Ingress, è orientata ai ruoli (team della piattaforma e dell'applicazione) ed è portabile tra le implementazioni. L'estensione Inference è lo standard della community per il routing consapevole del server di modelli (profondità della coda, cache KV, priorità) ed è supportata immediatamente da Envoy Agent Router; le distribuzioni del gateway alternative implementano le stesse API, il che mantiene reversibile la decisione 1. |
Decisione 3: routing basato sul corpo nel campo model delle richieste compatibili con OpenAI come endpoint unificato
| Contesto | Decisione chiave | Rationale |
|---|---|---|
Le applicazioni possono indirizzare i modelli tramite un endpoint per modello (basato su host o percorso), tramite un'intestazione personalizzata impostata dal client o tramite il campo model che ogni richiesta compatibile con OpenAI già include. |
Il gateway espone un endpoint compatibile con OpenAI e le route nel campo model: il processore esterno lo estrae nell'intestazione x-ai-eg-model e le regole AIGatewayRoute corrispondono a questa intestazione. |
I client e gli SDK compatibili con OpenAI esistenti funzionano senza modifiche e cambiano modello modificando una stringa; gli endpoint, le credenziali e il posizionamento del modello possono cambiare senza toccare le applicazioni; le stesse regole possono mappare un nome di modello a più backend per la suddivisione del traffico, il fallback o gli override del nome del modello. |
Decisione 4: seeding di artefatti con air gap in Harbor rispetto ai pull on demand
| Contesto | Decisione chiave | Rationale |
|---|---|---|
| L'installazione upstream estrae le immagini container dai registri pubblici e i grafici Helm come artefatti OCI on demand, il che è impossibile in un ambiente isolato. | Tutte le immagini container (proxy Envoy, Envoy Gateway, controller e processore esterno Envoy Agent Router, servizio di limite di frequenza, Endpoint Picker, Redis) e i grafici Helm di Envoy Gateway ed Envoy Agent Router vengono inseriti in un progetto Harbor con seed_registry.sh (crane), i grafici vengono visualizzati offline con helm template da Harbor e la risorsa EnvoyProxy e i valori del grafico bloccano il registro Harbor e il secret pull. |
Un passaggio di seeding ripetibile e controllabile per versione; il cluster non ha mai bisogno di connettività esterna; il blocco delle versioni rende gli upgrade espliciti e reversibili. |
Decisione 5: limitazione facoltativa della frequenza basata su token con Redis rispetto ai limiti basati solo sulle richieste
| Contesto | Decisione chiave | Rationale |
|---|---|---|
| La capacità della GPU viene consumata per token, non per richiesta; un limite al conteggio delle richieste non può proteggere un modello condiviso da alcuni prompt molto grandi o da generazioni lunghe. Limitazione di frequenza globale in Envoy Gateway richiede un archivio di contatori condiviso. | Limitazione di frequenza basata su token è una funzionalità facoltativa dell'architettura: il processore esterno registra i token di input, output e totali per richiesta (llmRequestCosts), un BackendTrafficPolicy applica il budget e un'istanza Redis (Redis 8.10, di cui è stato eseguito il deployment nel cluster o in un'istanza esistente) archivia i contatori. I deployment senza limitazione di frequenza non richiedono Redis. |
L'utilizzo viene misurato nell'unità che riflette il costo, i budget vengono applicati in modo coerente in tutte le repliche proxy e la dipendenza viene pagata solo dai clienti che necessitano di quote. |
Decisione 6: topologia: controllo del gateway e piano dati in uno spazio dei nomi dedicato di un cluster standard, modelli negli spazi dei nomi delle applicazioni
| Contesto | Decisione chiave | Rationale |
|---|---|---|
| Il gateway può essere eseguito in un cluster dedicato, in ogni spazio dei nomi dell'applicazione o una volta per cluster standard accanto ai modelli che gestisce. I modelli open-weight su GDC con air gap vengono implementati in cluster standard (set di guide complementari). | Il control plane di Envoy Gateway e Envoy Agent Router e il data plane del proxy Envoy vengono eseguiti in uno spazio dei nomi dedicato del cluster standard che ospita i modelli; AIGatewayRoute, AIServiceBackend, InferencePool e i deployment dei modelli si trovano negli spazi dei nomi delle applicazioni e vengono referenziati in tutti gli spazi dei nomi. |
Le richieste rimangono all'interno della rete del cluster tra il proxy e i modelli Pod (latenza più bassa, nessun bilanciamento del carico aggiuntivo), l'amministratore della piattaforma è proprietario dello spazio dei nomi del gateway, mentre i team delle applicazioni sono proprietari delle proprie route e dei propri modelli e il selettore di endpoint può eseguire lo scraping dei server dei modelli direttamente. Un gateway client per progetto che inoltra a un gateway server centrale rimane un'estensione di questa topologia per il consumo multiprogetto. |
Presupposti e limitazioni
- L'ambiente GDC con air gap 1.16.2-hf1 o versioni successive è disponibile con un cluster standard che esegue Kubernetes v1.32.13-gke.400 o versioni successive.
- Sono presenti risorse hardware sufficienti (in particolare GPU) per i backend di servizio del modello; i componenti gateway vengono eseguiti sui nodi CPU. I modelli reali richiedono GPU; i modelli di piccole dimensioni su Ollama possono essere eseguiti su CPU solo per la valutazione funzionale.
- L'istanza Harbor è configurata e accessibile e una workstation con accesso a internet e connettività all'ambiente GDC (API Harbor e Kubernetes) è disponibile per il seeding di immagini e grafici.
- Gli utenti dispongono delle autorizzazioni necessarie: ruoli di progetto Visualizzatore istanza Harbor e Amministratore cluster standard più un
StandardClusterRoleBindingal ruolocluster-adminsul cluster standard per l'installazione con ambito cluster (CRD,GatewayClass, spazi dei nomi), consulta l'implementazione di riferimento. - I backend di erogazione del modello espongono un'API compatibile con OpenAI; i backend collegati come
InferencePoolespongono anche le metriche compatibili con vLLM su cui si basa il selettore di endpoint. - Limitazione: il supporto per i componenti open source (Envoy Gateway, Envoy Agent Router, Gateway API Inference Extension) è fornito al meglio delle possibilità dal team di soluzioni; l'assistenza dedicata del fornitore richiede una distribuzione supportata commercialmente (Decisione 1).
- Limitazione:
InferenceObjectiveè un'API alpha (inference.networking.x-k8s.io/v1alpha2) e potrebbe cambiare tra le release dell'estensione di inferenza. - Limitazione:per i consumer esterni al progetto sono richiesti un VIP
LoadBalancerperGatewaye unProjectNetworkPolicy; all'interno del progetto, i client in-cluster okubectl port-forwardpossono raggiungere direttamente il gatewayService. - Limitazione: Gemini su GDC, il perfezionamento del modello, i modelli GenAI non LLM e l'hosting di modelli multi-nodo non rientrano nell'ambito di questa versione della soluzione.
Flusso utente
Di seguito è riportato un flusso utente completo per il gateway AI su GDC con air gap: prima il percorso della richiesta su cui si basa uno sviluppatore di applicazioni, poi il percorso di configurazione seguito dall'amministratore della piattaforma.
1. Percorso della richiesta dello sviluppatore
Un'applicazione o un agente ha bisogno solo dell'endpoint del gateway, di una credenziale client se il gateway ne impone una e del nome del modello.
- Invia la richiesta:l'applicazione chiama
POST /v1/chat/completionssull'endpoint del gateway con un corpo JSON compatibile con OpenAI che nomina il modello (ad esempio"model": "gemma"), esattamente come chiamerebbe qualsiasi servizio compatibile con OpenAI. - Inserisci il gateway: la richiesta raggiunge il VIP
LoadBalancerdiGateway; il proxy Envoy termina TLS e corrisponde al listener e alla route. - Elabora il corpo:il proxy passa la richiesta al processore esterno Envoy Agent Router, che analizza il corpo, estrae il nome del modello nell'intestazione
x-ai-eg-modele traduce il payload nello schema di backend se è diverso. - Seleziona il backend:la regola
AIGatewayRouteche corrisponde al nome del modello seleziona unAIServiceBackend(ad esempioServiceOllama) o unInferencePool(ad esempio un set di repliche vLLM); per unInferencePool, lo strumento di selezione degli endpoint sceglie la replica con la coda più breve e la migliore corrispondenza della cache KV. - Inoltro e risposta:il proxy inserisce le credenziali upstream quando viene applicato un
BackendSecurityPolicy, inoltra la richiesta alPodscelto, trasmette in streaming la risposta e consente al processore esterno di registrare l'utilizzo dei token, che alimenta le metriche e, se configurato, il limite di frequenza basato sui token. - Cambia modello:per utilizzare un altro modello, lo sviluppatore modifica la stringa
model. Non sono necessari nuovi endpoint, credenziali o librerie client.
2. Percorso di configurazione dell'amministratore della piattaforma
- Inserisci gli artefatti in Harbor: crea gli account robot Harbor, quindi copia
le immagini container e i grafici Helm di Envoy Gateway ed Envoy Agent Router in Harbor con
seed_registry.shda una workstation con accesso a internet. - Installa Envoy Gateway: esegui il rendering dei grafici CRD e controller da Harbor
con
helm templatee applicali nello spazio dei nomi del gateway; crea la risorsaEnvoyProxyche blocca l'immagine proxy e il pull secret e verifica il controller con unGatewayClass,GatewayeHTTPRoutedi base. - Installa Envoy Agent Router:installa le CRD di Envoy Agent Router e le CRD di estensione di inferenza dell'API Gateway, esegui il deployment del controller Envoy Agent Router e riconfigura Envoy Gateway per chiamare il server di estensione (porta 1063) e accettare i backend
InferencePool; facoltativamente, esegui il deployment di Redis e attiva il servizio di limitazione di frequenza globale. - Esporre il gateway:crea
GatewayClasseGatewaycon listener HTTP e HTTPS (certificato TLSSecret), attendi il VIPLoadBalancere applicaProjectNetworkPolicyper i consumatori al di fuori del progetto. - Allega modelli:esegui il deployment dei backend di erogazione dei modelli con il set di guide complementari, quindi crea risorse
AIServiceBackendperServiceeInferencePoolcompatibili con OpenAI, oltre a risorse di selezione degli endpoint per set di repliche compatibili con vLLM, insieme agli oggettiNetworkPolicydello spazio dei nomi. - Pubblica la route:crea
AIGatewayRoutecon una regola per nome del modello (routing basato sul corpo) e, se necessario, oggettiBackendSecurityPolicyeBackendTrafficPolicyper le credenziali upstream e i budget dei token. - Convalida e funzionamento:chiama
/v1/modelse/v1/chat/completionstramite il VIP (o un fallbackkubectl port-forward), controlla il proxy, il processore esterno e le metriche di Endpoint Picker e comunica i nomi dell'endpoint e del modello ai team delle applicazioni. Scala le repliche del proxy e i deployment dei modelli in modo indipendente; esegui l'upgrade di Envoy Gateway, Envoy Agent Router e dell'estensione di inferenza insieme.
I passaggi dettagliati sono forniti nell'implementazione di riferimento di Envoy Agent Router e nella guida utente al routing basato sul corpo con Envoy Agent Router.
Materiali aggiuntivi
- Implementazione di riferimento del router dell'agente Envoy
- Routing basato sul corpo con la guida per l'utente di Envoy Agent Router
- Architettura di riferimento degli LLM open-weight
- Documentazione di Envoy Agent Router
- Envoy Gateway
- API Kubernetes Gateway
- Estensione Gateway API Inference
- Documentazione di Google Distributed Cloud con air gap