


Questo documento fornisce istruzioni passo passo per configurare il routing basato sul corpo (BBR) per il traffico dei modelli linguistici di grandi dimensioni (LLM) con Envoy Agent Router (precedentemente Envoy AI Gateway) negli ambienti Google Distributed Cloud (GDC) con air gap. Con il routing basato sul corpo, il gateway ispeziona il payload JSON di una richiesta compatibile con OpenAI, estrae il campo model nell'intestazione x-ai-eg-model e instrada la richiesta al backend che gestisce il modello: un InferencePool, il cui selettore di endpoint (EPP) seleziona la replica migliore in base a metriche in tempo reale come la profondità della coda e l'utilizzo della cache KV, o un AIServiceBackend standard.
La guida esegue il deployment di due server di modelli vLLM simulati (meta-llama/Llama-3.1-8B-Instruct e Qwen/Qwen3-32B, forniti dal simulatore di inferenza llm-d in modo che non sia richiesto alcun acceleratore), un InferencePool con un selettore di endpoint per modello, un backend fittizio compatibile con OpenAI e un singolo AIGatewayRoute che esegue il routing in base al nome del modello. Una sezione facoltativa aggiunge alla stessa route un modello open weight reale fornito con Ollama dalle guide complementari Modelli open weight su GDC con air gap.
Architettura
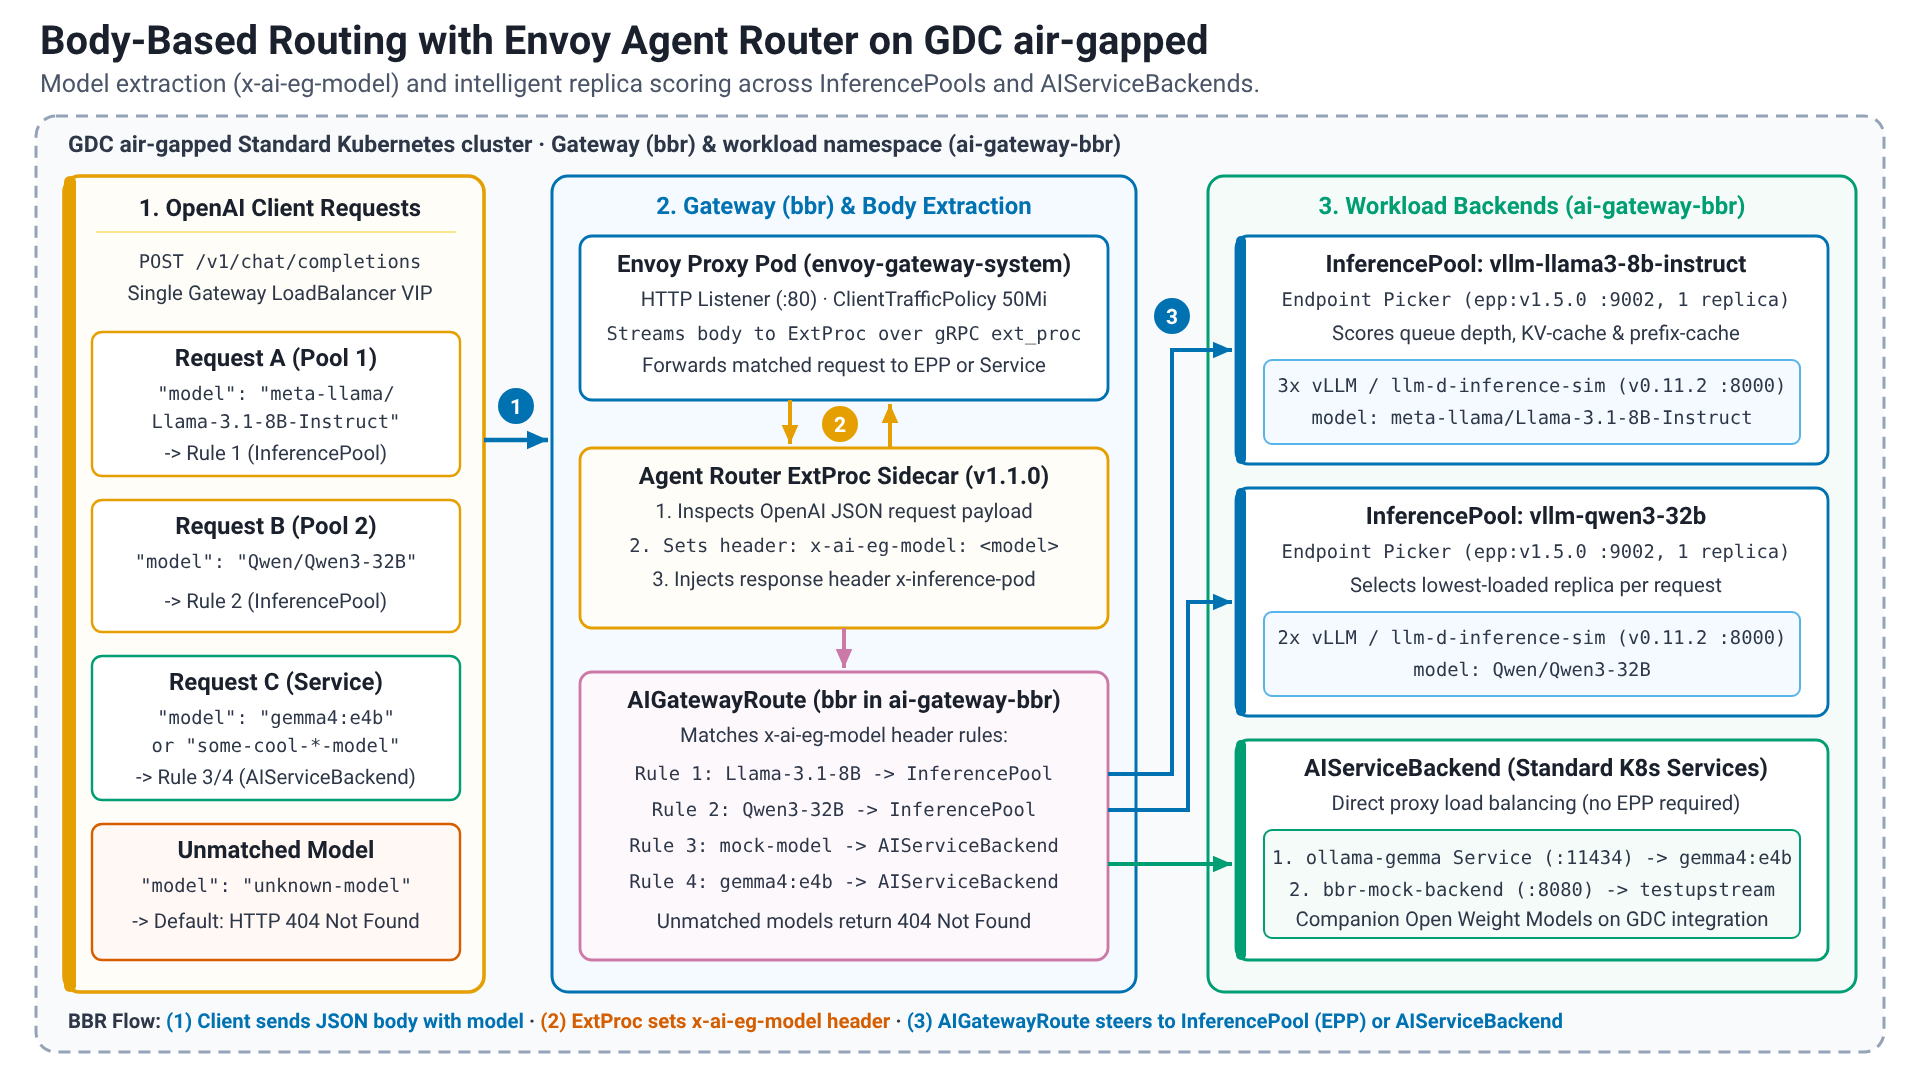
Un Gateway del GatewayClass creato dall'implementazione di riferimento espone un listener HTTP. Envoy Agent Router inserisce il proprio processore esterno nel proxy Envoy Pod di Gateway; il processore analizza ogni corpo della richiesta e imposta l'intestazione di routing. AIGatewayRoute corrisponde a questa intestazione
e inoltra a un InferencePool (un insieme di Pod del server di modelli selezionati
per etichetta, preceduti da un selettore di endpoint Deployment che il proxy consulta per
richiesta) o a un AIServiceBackend che punta a un Service Kubernetes. Tutte le risorse di questa guida si trovano in uno spazio dei nomi del workload; i proxy Pod stessi vengono eseguiti nello spazio dei nomi di Envoy Gateway.
Prima di iniziare
Assicurati che l'implementazione di riferimento di Envoy Agent Router sia stata distribuita utilizzando la workstation e di avere accesso alla directory gdcag-solutions/ai-gateway/envoy.
Identity and Access Management
Assicurati che gli account, i ruoli e le autorizzazioni IAM necessari siano configurati correttamente.
Ruoli GDC User sul progetto:
- Standard Cluster Admin (
standard-cluster-admin)
Ruolo GDC User nel cluster standard:
StandardClusterRoleBindingalcluster-adminStandardClusterRole(creato da un amministratore di progetto IAM, consulta la sezione Identity and Access Management dell'implementazione di riferimento)
Workstation
Esegui tutti i comandi di questa guida da una workstation con gli strumenti e la connettività necessari per l'ambiente e internet, se non diversamente indicato in un passaggio.
Crea la struttura di directory della guida dell'utente:
mkdir -p ${HOME}/gdcag-solutions/ai-gateway/envoy/bbr/env.dCrea il file di configurazione dell'ambiente della guida dell'utente:
cat << 'EOF' > ${HOME}/gdcag-solutions/ai-gateway/envoy/bbr/env.d/bbr.sh && echo "Successfully created." || echo "Failed to create!"
# Workload
export GDCS_WORKLOAD_NAMESPACE="ai-gateway-bbr"
export GDCS_BBR_GATEWAY_NAME="bbr"

# Simulated model servers (llm-d inference simulator, no accelerator required)
export GDCS_INFERENCE_SIM_IMAGE_TAG="v0.11.2"
export GDCS_BBR_MODEL_1_NAME="meta-llama/Llama-3.1-8B-Instruct"
export GDCS_BBR_MODEL_1_POOL="vllm-llama3-8b-instruct"
export GDCS_BBR_MODEL_1_REPLICAS="3"
export GDCS_BBR_MODEL_2_NAME="Qwen/Qwen3-32B"
export GDCS_BBR_MODEL_2_POOL="vllm-qwen3-32b"
export GDCS_BBR_MODEL_2_REPLICAS="2"

# Endpoint Picker (Gateway API Inference Extension)
export GDCS_EPP_IMAGE_TAG="${GDCS_GATEWAY_API_INFERENCE_EXTENSION_VERSION}"
export GDCS_EPP_CHART_VERSION="${GDCS_GATEWAY_API_INFERENCE_EXTENSION_VERSION}"

# Mock OpenAI-compatible backend (traditional AIServiceBackend)
export GDCS_BBR_MOCK_MODEL_NAME="some-cool-self-hosted-model"
EOF
Crea il file del caricatore dell'ambiente della guida dell'utente:
cat << 'EOF' > ${HOME}/gdcag-solutions/ai-gateway/envoy/bbr/env.sh && echo "Successfully created." || echo "Failed to create!"
source "${HOME}/gdcag-solutions/ai-gateway/envoy/env.sh"

export GDCS_USER_GUIDE_HOME="${HOME}/gdcag-solutions/ai-gateway/envoy/bbr"
echo "GDCS_USER_GUIDE_HOME=${GDCS_USER_GUIDE_HOME}"

# Sourced in dependency order
source "${GDCS_USER_GUIDE_HOME}/env.d/bbr.sh"

if [[ -f "${GDCS_USER_GUIDE_HOME}/env.d/ollama.sh" ]]; then
  source "${GDCS_USER_GUIDE_HOME}/env.d/ollama.sh"
fi
EOF
Modifica e rivedi il file di ambiente con l'editor che preferisci:
${EDITOR:-vi} ${HOME}/gdcag-solutions/ai-gateway/envoy/bbr/env.d/bbr.shEsegui il sourcing del file di ambiente:
source ${HOME}/gdcag-solutions/ai-gateway/envoy/bbr/env.sh
Verifica che le variabili di ambiente siano state impostate:
echo "GDCS_USER_GUIDE_HOME=${GDCS_USER_GUIDE_HOME}"
echo "GDCS_HARBOR_PROJECT_URI=${GDCS_HARBOR_PROJECT_URI}"
Cluster
Recupera le credenziali del cluster:
gdcloud clusters get-credentials "${GDC_STANDARD_CLUSTER_NAME}" \
--project="${GDC_PROJECT}" \
--standard \
--zone="${GDC_ZONE}"
Verifica la connettività al cluster:
kubectl get nodes -L node.cluster.private.gdc.goog/machine-classVerifica che lo stato
GatewayClassdell'implementazione di riferimento sia Accepted:kubectl get gatewayclass "${GDCS_GATEWAY_CLASS_NAME}"
Implementazione
L'implementazione esegue il seeding degli artefatti aggiuntivi, esegue il deployment dei server di modelli simulati con i relativi pool di inferenza e selettori di endpoint, aggiunge un backend fittizio e infine crea Gateway e AIGatewayRoute.
Migrazione degli artefatti
Definisci l'elenco delle immagini container richieste per questa guida:
declare -a GDCS_REGISTRY_IMAGES=(
  "ghcr.io/llm-d/llm-d-inference-sim:${GDCS_INFERENCE_SIM_IMAGE_TAG}"
  "registry.k8s.io/gateway-api-inference-extension/epp:${GDCS_EPP_IMAGE_TAG}"
)
export SERIALIZED_IMAGES=$(declare -p GDCS_REGISTRY_IMAGES)
Esegui il seeding delle immagini container richieste in Artifact Registry:
${GDCS_IMPLEMENTATION_HOME}/seed_registry.shDefinisci l'elenco dei grafici Helm richiesti per questa guida:
declare -a GDCS_REGISTRY_CHARTS=(
  "registry.k8s.io/gateway-api-inference-extension/charts/inferencepool:${GDCS_EPP_CHART_VERSION}"
)
export SERIALIZED_CHARTS=$(declare -p GDCS_REGISTRY_CHARTS)
Esegui il seeding dei grafici Helm richiesti in Artifact Registry:
${GDCS_IMPLEMENTATION_HOME}/seed_charts.shVerifica che le immagini e il grafico siano disponibili in Harbor:
crane ls "${GDCS_HARBOR_PROJECT_URI}/llm-d/llm-d-inference-sim"
crane ls "${GDCS_HARBOR_PROJECT_URI}/gateway-api-inference-extension/epp"
helm show chart "${GDCS_HARBOR_CHART_OCI_URI}/gateway-api-inference-extension/charts/inferencepool" --version "${GDCS_EPP_CHART_VERSION}" | grep -E '^(name|version):'
Spazio dei nomi
Crea lo spazio dei nomi:
kubectl create namespace "${GDCS_WORKLOAD_NAMESPACE}" \
--dry-run=client \
--output=yaml | kubectl apply -f -
Aggiungi
imagePullSecret:kubectl create secret docker-registry "${GDCS_HARBOR_K8S_PULL_SECRET}" \ --dry-run=client \ --from-file=.dockerconfigjson=${GDCS_HARBOR_K8S_DOCKER_CONFIG}/config.json \ --namespace="${GDCS_WORKLOAD_NAMESPACE}" \ --output=yaml | kubectl apply -f -
Server di modelli simulati
Ogni server di modelli simulato è un Deployment del simulatore di inferenza llm-d,
che espone l'API e le metriche compatibili con OpenAI vLLM sulla porta 8000 e
risponde con frasi casuali. L'etichetta app dei Pod è il selettore del InferencePool corrispondente.
Crea il manifest per il primo server di modelli simulato:
cat <<EOF > "${GDCS_USER_GUIDE_HOME}/${GDCS_BBR_MODEL_1_POOL}-sim.yaml" && echo "Successfully created." || echo "Failed to create!"
apiVersion: apps/v1
kind: Deployment
metadata:
  name: ${GDCS_BBR_MODEL_1_POOL}
  labels:
    app: ${GDCS_BBR_MODEL_1_POOL}
    inference.networking.k8s.io/engine-type: vllm
spec:
  replicas: ${GDCS_BBR_MODEL_1_REPLICAS}
  selector:
    matchLabels:
      app: ${GDCS_BBR_MODEL_1_POOL}
  template:
    metadata:
      labels:
        app: ${GDCS_BBR_MODEL_1_POOL}
        inference.networking.k8s.io/engine-type: vllm
    spec:
      containers:
        - name: vllm-sim
          image: ${GDCS_HARBOR_PROJECT_URI}/llm-d/llm-d-inference-sim:${GDCS_INFERENCE_SIM_IMAGE_TAG}
          imagePullPolicy: IfNotPresent
          args:
            - --model
            - ${GDCS_BBR_MODEL_1_NAME}
            - --port
            - "8000"
            - --max-loras
            - "2"
            - --lora-modules
            - '{"name": "food-review-1"}'
          env:
            - name: POD_NAME
              valueFrom:
                fieldRef:
                  fieldPath: metadata.name
            - name: NAMESPACE
              valueFrom:
                fieldRef:
                  fieldPath: metadata.namespace
          ports:
            - containerPort: 8000
              name: http
              protocol: TCP
          readinessProbe:
            httpGet:
              path: /health
              port: 8000
            periodSeconds: 5
          resources:
            limits:
              memory: 256Mi
            requests:
              cpu: 50m
              memory: 64Mi
      imagePullSecrets:
        - name: ${GDCS_HARBOR_K8S_PULL_SECRET}
EOF
Applica il manifest per il primo server di modelli simulato:
kubectl apply \
--filename="${GDCS_USER_GUIDE_HOME}/${GDCS_BBR_MODEL_1_POOL}-sim.yaml" \
--namespace="${GDCS_WORKLOAD_NAMESPACE}"
Crea il manifest per il secondo server di modelli simulato:
cat <<EOF > "${GDCS_USER_GUIDE_HOME}/${GDCS_BBR_MODEL_2_POOL}-sim.yaml" && echo "Successfully created." || echo "Failed to create!"
apiVersion: apps/v1
kind: Deployment
metadata:
  name: ${GDCS_BBR_MODEL_2_POOL}
  labels:
    app: ${GDCS_BBR_MODEL_2_POOL}
    inference.networking.k8s.io/engine-type: vllm
spec:
  replicas: ${GDCS_BBR_MODEL_2_REPLICAS}
  selector:
    matchLabels:
      app: ${GDCS_BBR_MODEL_2_POOL}
  template:
    metadata:
      labels:
        app: ${GDCS_BBR_MODEL_2_POOL}
        inference.networking.k8s.io/engine-type: vllm
    spec:
      containers:
        - name: vllm-sim
          image: ${GDCS_HARBOR_PROJECT_URI}/llm-d/llm-d-inference-sim:${GDCS_INFERENCE_SIM_IMAGE_TAG}
          imagePullPolicy: IfNotPresent
          args:
            - --model
            - ${GDCS_BBR_MODEL_2_NAME}
            - --port
            - "8000"
            - --max-loras
            - "2"
            - --lora-modules
            - '{"name": "food-review-1"}'
          env:
            - name: POD_NAME
              valueFrom:
                fieldRef:
                  fieldPath: metadata.name
            - name: NAMESPACE
              valueFrom:
                fieldRef:
                  fieldPath: metadata.namespace
          ports:
            - containerPort: 8000
              name: http
              protocol: TCP
          readinessProbe:
            httpGet:
              path: /health
              port: 8000
            periodSeconds: 5
          resources:
            limits:
              memory: 256Mi
            requests:
              cpu: 50m
              memory: 64Mi
      imagePullSecrets:
        - name: ${GDCS_HARBOR_K8S_PULL_SECRET}
EOF
Applica il manifest per il secondo server di modelli simulato:
kubectl apply \
--filename="${GDCS_USER_GUIDE_HOME}/${GDCS_BBR_MODEL_2_POOL}-sim.yaml" \
--namespace="${GDCS_WORKLOAD_NAMESPACE}"
Attendi che i server di modelli simulati siano disponibili:
watch --color --interval 5 --no-title \
"kubectl get deployments --selector='inference.networking.k8s.io/engine-type' \
--namespace=${GDCS_WORKLOAD_NAMESPACE} | GREP_COLORS='mt=01;92' egrep --color=always -e '^' -e '${GDCS_BBR_MODEL_1_REPLICAS}/${GDCS_BBR_MODEL_1_REPLICAS}' -e '${GDCS_BBR_MODEL_2_REPLICAS}/${GDCS_BBR_MODEL_2_REPLICAS}'"
Pool di inferenza e selettori di endpoint
Il grafico Helm inferencepool dell'estensione di inferenza dell'API Gateway crea, per modello, InferencePool, il selettore di endpoint Deployment e Service (porta gRPC 9002), la configurazione del plug-in (queue-scorer, kv-cache-utilization-scorer, prefix-cache-scorer) e l'RBAC con ambito dello spazio dei nomi di cui il selettore ha bisogno per monitorare Pod e InferencePool.
Crea il file di valori Helm condiviso per i selettori di endpoint. Il grafico non ha un valore secret di pull dell'immagine, quindi il secret viene aggiunto a
Deploymentdopo l'installazione:cat <<EOF > "${GDCS_USER_GUIDE_HOME}/epp-values.yaml" && echo "Successfully created." || echo "Failed to create!" inferenceExtension: image: pullPolicy: IfNotPresent registry: ${GDCS_HARBOR_PROJECT_URI} repository: gateway-api-inference-extension/epp tag: ${GDCS_EPP_IMAGE_TAG} replicas: 1 resources: limits: memory: 4Gi requests: cpu: 500m memory: 1Gi inferencePool: modelServerType: vllm targetPorts: - number: 8000 provider: name: none EOFInstalla
InferencePoole il selettore di endpoint per il primo modello:helm upgrade --install "${GDCS_BBR_MODEL_1_POOL}" "${GDCS_HARBOR_CHART_OCI_URI}/gateway-api-inference-extension/charts/inferencepool" \ --namespace="${GDCS_WORKLOAD_NAMESPACE}" \ --set "inferencePool.modelServers.matchLabels.app=${GDCS_BBR_MODEL_1_POOL}" \ --values="${GDCS_USER_GUIDE_HOME}/epp-values.yaml" \ --version="${GDCS_EPP_CHART_VERSION}"Installa
InferencePoole il selettore di endpoint per il secondo modello:helm upgrade --install "${GDCS_BBR_MODEL_2_POOL}" "${GDCS_HARBOR_CHART_OCI_URI}/gateway-api-inference-extension/charts/inferencepool" \ --namespace="${GDCS_WORKLOAD_NAMESPACE}" \ --set "inferencePool.modelServers.matchLabels.app=${GDCS_BBR_MODEL_2_POOL}" \ --values="${GDCS_USER_GUIDE_HOME}/epp-values.yaml" \ --version="${GDCS_EPP_CHART_VERSION}"Aggiungi
imagePullSecretai selettori di endpointDeployment. La patch avvia un nuovo rollout con il secret:for pool in "${GDCS_BBR_MODEL_1_POOL}" "${GDCS_BBR_MODEL_2_POOL}"; do kubectl patch deployment "${pool}-epp" \ --namespace="${GDCS_WORKLOAD_NAMESPACE}" \ --patch="{\"spec\":{\"template\":{\"spec\":{\"imagePullSecrets\":[{\"name\":\"${GDCS_HARBOR_K8S_PULL_SECRET}\"}]}}}}" doneAttendi che i selettori di endpoint siano disponibili:
watch --color --interval 5 --no-title \
"kubectl get deployments --selector='inference.networking.k8s.io/igw-mode=inferencepool' \
--namespace=${GDCS_WORKLOAD_NAMESPACE} | GREP_COLORS='mt=01;92' egrep --color=always -e '^' -e '1/1     1            1'"
Verifica che i
InferencePoolesistano:kubectl get inferencepools \ --namespace="${GDCS_WORKLOAD_NAMESPACE}"L'output è simile al seguente:
NAME                      AGE
vllm-llama3-8b-instruct   1m
vllm-qwen3-32b            1m
Crea il manifest per i
InferenceObjective. Un obiettivo associa una priorità a unInferencePool; il selettore di endpoint preferisce le priorità più elevate quando il pool è saturo:cat <<EOF > "${GDCS_USER_GUIDE_HOME}/inferenceobjectives.yaml" && echo "Successfully created." || echo "Failed to create!" apiVersion: inference.networking.x-k8s.io/v1alpha2 kind: InferenceObjective metadata: name: ${GDCS_BBR_MODEL_1_POOL} spec: poolRef: name: ${GDCS_BBR_MODEL_1_POOL} priority: 10 --- apiVersion: inference.networking.x-k8s.io/v1alpha2 kind: InferenceObjective metadata: name: ${GDCS_BBR_MODEL_2_POOL} spec: poolRef: name: ${GDCS_BBR_MODEL_2_POOL} priority: 5 EOFApplica il manifest per i
InferenceObjective:kubectl apply \ --filename="${GDCS_USER_GUIDE_HOME}/inferenceobjectives.yaml" \ --namespace="${GDCS_WORKLOAD_NAMESPACE}"
Backend fittizio
Crea il manifest per il backend fittizio compatibile con OpenAI e il relativo
AIServiceBackend. Rappresenta qualsiasi server di modelli indirizzato come unServiceKubernetes semplice anziché come unInferencePool:cat <<EOF > "${GDCS_USER_GUIDE_HOME}/mock-backend.yaml" && echo "Successfully created." || echo "Failed to create!" apiVersion: aigateway.envoyproxy.io/v1beta1 kind: AIServiceBackend metadata: name: mock-backend spec: schema: name: OpenAI backendRef: name: mock-backend kind: Backend group: gateway.envoyproxy.io --- apiVersion: gateway.envoyproxy.io/v1alpha1 kind: Backend metadata: name: mock-backend spec: endpoints: - fqdn: hostname: mock-backend.${GDCS_WORKLOAD_NAMESPACE}.svc.cluster.local port: 80 --- apiVersion: apps/v1 kind: Deployment metadata: name: mock-backend spec: replicas: 1 selector: matchLabels: app: mock-backend template: metadata: labels: app: mock-backend spec: containers: - name: testupstream image: ${GDCS_HARBOR_PROJECT_URI}/envoyproxy/ai-gateway-testupstream:${GDCS_ENVOY_AGENT_ROUTER_VERSION} imagePullPolicy: IfNotPresent ports: - containerPort: 8080 env: - name: TESTUPSTREAM_ID value: test readinessProbe: httpGet: path: /health port: 8080 initialDelaySeconds: 1 periodSeconds: 1 imagePullSecrets: - name: ${GDCS_HARBOR_K8S_PULL_SECRET} --- apiVersion: v1 kind: Service metadata: name: mock-backend spec: selector: app: mock-backend ports: - protocol: TCP port: 80 targetPort: 8080 type: ClusterIP EOFApplica il manifest per il backend fittizio:
kubectl apply \
--filename="${GDCS_USER_GUIDE_HOME}/mock-backend.yaml" \
--namespace="${GDCS_WORKLOAD_NAMESPACE}"
Gateway e route
Crea il manifest per
Gatewaye il relativoClientTrafficPolicy. Il limite del buffer viene aumentato rispetto al valore predefinito di 32 KiB perché il processore esterno memorizza nel buffer il corpo della richiesta:cat <<EOF > "${GDCS_USER_GUIDE_HOME}/gateway.yaml" && echo "Successfully created." || echo "Failed to create!" apiVersion: gateway.networking.k8s.io/v1 kind: Gateway metadata: name: ${GDCS_BBR_GATEWAY_NAME} spec: gatewayClassName: ${GDCS_GATEWAY_CLASS_NAME} listeners: - name: http protocol: HTTP port: 80 --- apiVersion: gateway.envoyproxy.io/v1alpha1 kind: ClientTrafficPolicy metadata: name: ${GDCS_BBR_GATEWAY_NAME}-buffer-limit spec: targetRefs: - group: gateway.networking.k8s.io kind: Gateway name: ${GDCS_BBR_GATEWAY_NAME} connection: bufferLimit: 50Mi EOFApplica il manifest per
Gateway:kubectl apply \ --filename="${GDCS_USER_GUIDE_HOME}/gateway.yaml" \ --namespace="${GDCS_WORKLOAD_NAMESPACE}"Crea il manifest per
AIGatewayRoute. Ogni regola corrisponde all'intestazionex-ai-eg-modelche il processore esterno ricava dal campomodeldel corpo della richiesta:cat <<EOF > "${GDCS_USER_GUIDE_HOME}/aigatewayroute.yaml" && echo "Successfully created." || echo "Failed to create!" apiVersion: aigateway.envoyproxy.io/v1beta1 kind: AIGatewayRoute metadata: name: ${GDCS_BBR_GATEWAY_NAME} spec: parentRefs: - name: ${GDCS_BBR_GATEWAY_NAME} kind: Gateway group: gateway.networking.k8s.io rules: - matches: - headers: - type: Exact name: x-ai-eg-model value: ${GDCS_BBR_MODEL_1_NAME} backendRefs: - group: inference.networking.k8s.io kind: InferencePool name: ${GDCS_BBR_MODEL_1_POOL} - matches: - headers: - type: Exact name: x-ai-eg-model value: ${GDCS_BBR_MODEL_2_NAME} backendRefs: - group: inference.networking.k8s.io kind: InferencePool name: ${GDCS_BBR_MODEL_2_POOL} - matches: - headers: - type: Exact name: x-ai-eg-model value: ${GDCS_BBR_MOCK_MODEL_NAME} backendRefs: - name: mock-backend EOFApplica il manifest per
AIGatewayRoute:kubectl apply \ --filename="${GDCS_USER_GUIDE_HOME}/aigatewayroute.yaml" \ --namespace="${GDCS_WORKLOAD_NAMESPACE}"Attendi che
Gatewayvenga programmato:watch --color --interval 5 --no-title \ "kubectl get gateway/${GDCS_BBR_GATEWAY_NAME} \ --namespace=${GDCS_WORKLOAD_NAMESPACE} | GREP_COLORS='mt=01;92' egrep --color=always -e '^' -e 'True'"Verifica che il codice
AIGatewayRoutesia stato accettato:kubectl get aigatewayroute/${GDCS_BBR_GATEWAY_NAME} \ --namespace="${GDCS_WORKLOAD_NAMESPACE}" \ --output=jsonpath='{range .status.conditions[*]}{.type}={.status} {.message}{"\n"}{end}'L'output è simile al seguente:
Accepted=True AI Gateway Route is accepted
Convalida
Avvia il port forwarding all'Envoy
ServicediGateway:export ENVOY_SERVICE=$(kubectl get service --namespace="${GDCS_ENVOY_GATEWAY_NAMESPACE}" --selector="gateway.envoyproxy.io/owning-gateway-namespace=${GDCS_WORKLOAD_NAMESPACE},gateway.envoyproxy.io/owning-gateway-name=${GDCS_BBR_GATEWAY_NAME}" --output=jsonpath='{.items[0].metadata.name}') echo "ENVOY_SERVICE=${ENVOY_SERVICE}" kubectl port-forward "service/${ENVOY_SERVICE}" \ --namespace="${GDCS_ENVOY_GATEWAY_NAMESPACE}" 8888:80 & PF_PID=$! sleep 2Invia una richiesta per il primo modello. Le intestazioni della risposta mostrano la
Podselezionata dal selettore di endpoint:curl http://127.0.0.1:8888/v1/chat/completions \ --data '{"model": "'${GDCS_BBR_MODEL_1_NAME}'", "messages": [{"role": "user", "content": "Say this is a test."}]}' \ --dump-header - \ --header "Content-Type: application/json" \ --no-progress-meter \ --show-error | grep -E -i '^(HTTP|x-inference-pod|x-inference-port)|"model"|"content"'L'output è simile al seguente:
HTTP/1.1 200 OK
x-inference-port: 8000
x-inference-pod: vllm-llama3-8b-instruct-...
  "model": "meta-llama/Llama-3.1-8B-Instruct",
        "content": "..."
Invia una richiesta per il secondo modello:
curl http://127.0.0.1:8888/v1/chat/completions \
--data '{"model": "'${GDCS_BBR_MODEL_2_NAME}'", "messages": [{"role": "user", "content": "Say this is a test."}]}' \
--dump-header - \
--header "Content-Type: application/json" \
--no-progress-meter \
--show-error | grep -E -i '^(HTTP|x-inference-pod|x-inference-port)|"model"|"content"'
L'output è simile al seguente:
HTTP/1.1 200 OK
x-inference-port: 8000
x-inference-pod: vllm-qwen3-32b-...
  "model": "Qwen/Qwen3-32B",
        "content": "..."
Invia una richiesta per l'erogazione del modello fornita dal backend fittizio:
curl http://127.0.0.1:8888/v1/chat/completions \
--data '{"model": "'${GDCS_BBR_MOCK_MODEL_NAME}'", "messages": [{"role": "user", "content": "Say this is a test."}]}' \
--dump-header - \
--header "Content-Type: application/json" \
--no-progress-meter \
--show-error | grep -E -i '^(HTTP|testupstream-id|x-model)|"content"'
L'output è simile al seguente:
HTTP/1.1 200 OK
testupstream-id: test
x-model: some-cool-self-hosted-model
        "content": "..."
Invia una richiesta per un modello non gestito da nessuna regola. Il gateway la rifiuta anziché inoltrarla:
curl http://127.0.0.1:8888/v1/chat/completions \
--data '{"model": "unknown-model", "messages": [{"role": "user", "content": "Say this is a test."}]}' \
--header "Content-Type: application/json" \
--no-progress-meter \
--show-error \
--write-out '\nHTTP %{http_code}\n'
L'output è simile al seguente:
...
HTTP 404
Invia diverse richieste per il primo modello e verifica che il selettore di endpoint le distribuisca tra le repliche del pool:
for i in $(seq 1 6); do
  curl http://127.0.0.1:8888/v1/chat/completions \
  --data '{"model": "'${GDCS_BBR_MODEL_1_NAME}'", "messages": [{"role": "user", "content": "Request '${i}'"}]}' \
  --dump-header - \
  --header "Content-Type: application/json" \
  --no-progress-meter \
  --output /dev/null \
  --show-error | grep -i '^x-inference-pod'
done | sort | uniq -c
Interrompi il port forwarding:
kill -9 ${PF_PID}
Indirizza a un modello open-weight
Questa sezione facoltativa aggiunge un modello reale alla route: il modello Gemma 4 E4B fornito con Ollama dalla guida complementare Gemma 4 E4B con Ollama su GDC con air gap: guida dell'utente. Ollama espone un'API compatibile con OpenAI, quindi è collegato come AIServiceBackend il cui Backend punta al Service nel cluster di Ollama Deployment. Qualsiasi altro server di modelli compatibile con OpenAI, ad esempio il vLLM Deployment delle guide complementari, può essere collegato nello stesso modo.
Crea il file di configurazione del backend Ollama. Il nome e lo spazio dei nomi
Servicesono quelli della guida dell'utente di Ollama:cat << 'EOF' > ${HOME}/gdcag-solutions/ai-gateway/envoy/bbr/env.d/ollama.sh && echo "Successfully created." || echo "Failed to create!" # Open weight model backend (Ollama user guide) export GDCS_BBR_OLLAMA_MODEL_NAME="BBR_OLLAMA_MODEL_NAME" export GDCS_BBR_OLLAMA_SERVICE_NAME="BBR_OLLAMA_SERVICE_NAME" export GDCS_BBR_OLLAMA_SERVICE_NAMESPACE="BBR_OLLAMA_SERVICE_NAMESPACE" export GDCS_BBR_OLLAMA_SERVICE_PORT="80" EOFSostituisci quanto segue:
BBR_OLLAMA_MODEL_NAME: il nome del modello Ollama (GDCS_OLLAMA_MODEL della guida dell'utente di Ollama).BBR_OLLAMA_SERVICE_NAME: il nome del servizio Ollama (GDCS_OLLAMA_MODEL_KUBERNETES della guida dell'utente di Ollama).BBR_OLLAMA_SERVICE_NAMESPACE: lo spazio dei nomi Ollama (GDCS_WORKLOAD_NAMESPACE della guida dell'utente di Ollama).
Esegui il sourcing del file di ambiente:
source ${HOME}/gdcag-solutions/ai-gateway/envoy/bbr/env.shVerifica che l'
ServiceOllama sia raggiungibile per nome dall'interno del cluster:kubectl get service "${GDCS_BBR_OLLAMA_SERVICE_NAME}" \ --namespace="${GDCS_BBR_OLLAMA_SERVICE_NAMESPACE}"Crea il manifest per Ollama
AIServiceBackend:cat <<EOF > "${GDCS_USER_GUIDE_HOME}/ollama-backend.yaml" && echo "Successfully created." || echo "Failed to create!" apiVersion: aigateway.envoyproxy.io/v1beta1 kind: AIServiceBackend metadata: name: ollama-backend spec: schema: name: OpenAI backendRef: name: ollama-backend kind: Backend group: gateway.envoyproxy.io --- apiVersion: gateway.envoyproxy.io/v1alpha1 kind: Backend metadata: name: ollama-backend spec: endpoints: - fqdn: hostname: ${GDCS_BBR_OLLAMA_SERVICE_NAME}.${GDCS_BBR_OLLAMA_SERVICE_NAMESPACE}.svc.cluster.local port: ${GDCS_BBR_OLLAMA_SERVICE_PORT} EOFApplica il manifest per Ollama
AIServiceBackend:kubectl apply \ --filename="${GDCS_USER_GUIDE_HOME}/ollama-backend.yaml" \ --namespace="${GDCS_WORKLOAD_NAMESPACE}"Aggiungi una regola per il modello Ollama alla
AIGatewayRoutee applicala:cat <<EOF >> "${GDCS_USER_GUIDE_HOME}/aigatewayroute.yaml" && echo "Successfully added." || echo "Failed to add!" - matches: - headers: - type: Exact name: x-ai-eg-model value: ${GDCS_BBR_OLLAMA_MODEL_NAME} backendRefs: - name: ollama-backend EOF kubectl apply \ --filename="${GDCS_USER_GUIDE_HOME}/aigatewayroute.yaml" \ --namespace="${GDCS_WORKLOAD_NAMESPACE}"Invia una richiesta per il modello Ollama tramite il gateway. La modifica della route del passaggio precedente richiede alcuni secondi per raggiungere il proxy, quindi la richiesta riprova in caso di errori temporanei. Nei cluster solo CPU, il modello risponde lentamente, quindi concede cinque minuti:
export ENVOY_SERVICE=$(kubectl get service --namespace="${GDCS_ENVOY_GATEWAY_NAMESPACE}" --selector="gateway.envoyproxy.io/owning-gateway-namespace=${GDCS_WORKLOAD_NAMESPACE},gateway.envoyproxy.io/owning-gateway-name=${GDCS_BBR_GATEWAY_NAME}" --output=jsonpath='{.items[0].metadata.name}')

kubectl port-forward "service/${ENVOY_SERVICE}" \
--namespace="${GDCS_ENVOY_GATEWAY_NAMESPACE}" 8888:80 &
PF_PID=$!

sleep 2

curl http://127.0.0.1:8888/v1/chat/completions \
--data '{"model": "'${GDCS_BBR_OLLAMA_MODEL_NAME}'", "messages": [{"role": "user", "content": "Explain Google Distributed Cloud air-gapped in one sentence."}], "max_tokens": 256}' \
--fail-with-body \
--header "Content-Type: application/json" \
--max-time 300 \
--no-progress-meter \
--output "${GDCS_USER_GUIDE_HOME}/ollama-response.json" \
--retry 5 \
--retry-all-errors \
--retry-delay 5 \
--show-error \
--write-out 'HTTP %{http_code} in %{time_total}s\n'

jq '{model, system_fingerprint, finish_reason: .choices[0].finish_reason, content: .choices[0].message.content, reasoning: ((.choices[0].message.reasoning // "") | .[0:160])}' "${GDCS_USER_GUIDE_HOME}/ollama-response.json"

kill -9 ${PF_PID}
L'output è simile al seguente:
HTTP 200 in 41.2s
{
  "model": "gemma4:e4b",
  "system_fingerprint": "fp_ollama",
  "finish_reason": "length",
  "content": "",
  "reasoning": "Here's a thinking process to construct the one-sentence explanation: ..."
}
Operazioni
Attività del secondo giorno per la route e i relativi backend.
Esponi il gateway all'esterno del cluster
- Per impostazione predefinita, l'Envoy
Servicedi unGatewayè di tipoLoadBalancere riceve un indirizzo IP esterno dal bilanciatore del carico GDC (kubectl get service "${ENVOY_SERVICE}" --namespace="${GDCS_ENVOY_GATEWAY_NAMESPACE}"). Il traffico proveniente dall'esterno del progetto richiede inoltre unProjectNetworkPolicy(networking.gdc.goog/v1) creato nello spazio dei nomi del progetto da un amministratore di Project NetworkPolicy. Consulta Configura le policy di rete del progetto.
Scala un modello
- Scala il server di modelli
Deployment(kubectl scale deployment/${GDCS_BBR_MODEL_1_POOL} --replicas=<n> --namespace="${GDCS_WORKLOAD_NAMESPACE}");InferencePoolseleziona automaticamente i nuoviPode il selettore di endpoint inizia a valutarli una volta che sono pronti.
Modifica le priorità di pianificazione
- Modifica il
prioritydi unInferenceObjectivee applica di nuovoinferenceobjectives.yaml; il selettore di endpoint elimina prima le priorità più basse quando il pool è saturo.
Osserva il selettore dell'endpoint
- Il selettore espone le metriche di Prometheus sulla porta 9090 del suo
Service(kubectl port-forward service/${GDCS_BBR_MODEL_1_POOL}-epp 9090:9090 --namespace="${GDCS_WORKLOAD_NAMESPACE}"poicurl http://127.0.0.1:9090/metrics) e le sue decisioni di pianificazione vengono registrate con livello di dettaglio--v=4(inferenceExtension.flags.v: 4inepp-values.yaml).
Esegui l'upgrade del selettore di endpoint
- Esegui il seeding della nuova immagine
eppe del nuovo graficoinferencepool, aggiornaGDCS_GATEWAY_API_INFERENCE_EXTENSION_VERSIONnel file dell'ambiente di implementazione di riferimento, esegui gli stessi comandihelm upgrade --installe applica nuovamente la patchimagePullSecret.
Risoluzione dei problemi
| Sintomo | Causa probabile | Azione |
|---|---|---|
Selettore endpoint Pod in ImagePullBackOff |
La patch imagePullSecret non è stata applicata o non è stato eseguito il seeding dell'immagine epp |
Esegui di nuovo il passaggio di applicazione patch; crane ls "${GDCS_HARBOR_PROJECT_URI}/gateway-api-inference-extension/epp". |
AIGatewayRoute mostra Accepted=False con un messaggio relativo a InferencePool |
InferencePool non esiste nello spazio dei nomi o Envoy Gateway non può leggere inferencepools |
kubectl get inferencepools --namespace="${GDCS_WORKLOAD_NAMESPACE}"; controlla ClusterRoleBinding envoy-gateway-inferencepool-reader dall'implementazione di riferimento. |
Le richieste di un modello di pool restituiscono 503 |
Nessun Pod pronto corrisponde al selettore del pool o il selettore non è pronto |
kubectl get pods --selector=app=${GDCS_BBR_MODEL_1_POOL} --namespace="${GDCS_WORKLOAD_NAMESPACE}"; kubectl logs deployment/${GDCS_BBR_MODEL_1_POOL}-epp --namespace="${GDCS_WORKLOAD_NAMESPACE}". |
Le richieste restituiscono 404 per un modello con una regola |
Il valore model nel corpo è diverso dalla regola (x-ai-eg-model è una corrispondenza esatta, sensibile alle maiuscole) |
Confronta il corpo della richiesta con il value della regola; kubectl get aigatewayroute ${GDCS_BBR_GATEWAY_NAME} --namespace="${GDCS_WORKLOAD_NAMESPACE}" --output=yaml. |
La richiesta con un prompt di grandi dimensioni viene rifiutata con 413 |
Limite del buffer troppo piccolo per il corpo della richiesta | Aumenta connection.bufferLimit in ClientTrafficPolicy. |
| Timeout della richiesta Ollama | Il modello è in fase di caricamento o generazione sulla CPU; il NetworkPolicy dello spazio dei nomi Ollama non ammette il proxy |
Riprova con un --max-time più lungo; verifica che NetworkPolicy Ollama ammetta l'ingresso sulla porta 11434 dallo spazio dei nomi Envoy Gateway. |
Esegui la pulizia
Rimuovi la route, il gateway e i backend:
kubectl delete \
--filename="${GDCS_USER_GUIDE_HOME}/aigatewayroute.yaml" \
--filename="${GDCS_USER_GUIDE_HOME}/gateway.yaml" \
--filename="${GDCS_USER_GUIDE_HOME}/mock-backend.yaml" \
--filename="${GDCS_USER_GUIDE_HOME}/inferenceobjectives.yaml" \
--ignore-not-found \
--namespace="${GDCS_WORKLOAD_NAMESPACE}"

kubectl delete \
--filename="${GDCS_USER_GUIDE_HOME}/ollama-backend.yaml" \
--ignore-not-found \
--namespace="${GDCS_WORKLOAD_NAMESPACE}" 2>/dev/null || true
Disinstalla gli Endpoint Picker e rimuovi i server di modelli simulati:
helm uninstall "${GDCS_BBR_MODEL_1_POOL}" --namespace="${GDCS_WORKLOAD_NAMESPACE}"
helm uninstall "${GDCS_BBR_MODEL_2_POOL}" --namespace="${GDCS_WORKLOAD_NAMESPACE}"

kubectl delete \
--filename="${GDCS_USER_GUIDE_HOME}/${GDCS_BBR_MODEL_1_POOL}-sim.yaml" \
--filename="${GDCS_USER_GUIDE_HOME}/${GDCS_BBR_MODEL_2_POOL}-sim.yaml" \
--ignore-not-found \
--namespace="${GDCS_WORKLOAD_NAMESPACE}"
Elimina lo spazio dei nomi:
kubectl delete namespace "${GDCS_WORKLOAD_NAMESPACE}"
Materiali aggiuntivi
- Supporto di InferencePool | Router dell'agente Envoy
- Guida ad AIGatewayRoute + InferencePool | Router dell'agente Envoy
- Estensione di inferenza API Gateway
- Simulatore di inferenza llm-d
- Configura le policy di rete del progetto | Google Distributed Cloud con air gap
- Architettura di riferimento di AI Gateway
- Implementazione di riferimento di Envoy Agent Router