


Le organizzazioni che operano in ambienti air-gapped devono affrontare una sfida significativa: richiedono il potere trasformativo dei modelli linguistici di grandi dimensioni (LLM), ma è loro severamente vietato connettersi ad API esterne basate sul cloud a causa di rigorosi protocolli di sicurezza. Per colmare questa lacuna, questi clienti hanno bisogno di un ecosistema solido e autonomo in grado di ospitare e gestire modelli open-weight direttamente nella loro infrastruttura Google Distributed Cloud (GDC) con air gap. Questo deployment localizzato è essenziale per mantenere la sovranità assoluta dei dati, garantendo che le informazioni sensibili non escano mai dai locali fisici. Integrando ambienti di esecuzione sicuri con motori di inferenza locali, gli utenti possono sfruttare funzionalità di AI avanzate mantenendo il controllo amministrativo completo su dati, pesi del modello e security posture interna.
Sebbene Gemini su GDC fornisca funzionalità di frontiera gestite e potenti, i clienti spesso implementano modelli open-weight come Gemma 4 o Llama 4 per una maggiore granularità e controllo. Il deployment di modelli open-weight in ambienti GDC air-gapped offre vantaggi significativi in termini di costi rispetto ai servizi proprietari gestiti. Possedendo i pesi del modello, le organizzazioni eliminano le tariffe API per token ricorrenti, che possono diventare proibitive per i carichi di lavoro automatizzati e ad alto volume. Inoltre, i modelli open source consentono la quantizzazione (ad esempio, a 4 bit o 8 bit), consentendo un ragionamento ad alte prestazioni su hardware più piccolo ed economico a livello perimetrale. Questa ottimizzazione verticale, combinata con la possibilità di condividere l'infrastruttura tra più applicazioni interne senza costi di licenza aggiuntivi, si traduce in un costo totale di proprietà (TCO) notevolmente inferiore per operazioni di inferenza sostenute e su larga scala.
Soluzione proposta
Questo documento descrive l'architettura di riferimento per il deployment e la gestione di modelli linguistici di grandi dimensioni (LLM) open weight in ambienti air-gap di Google Distributed Cloud (GDC). Molti clienti, in particolare quelli in settori altamente regolamentati, non possono utilizzare le API LLM basate su cloud a causa di severi requisiti di sovranità e sicurezza dei dati. Questa architettura soddisfa la necessità di eseguire LLM potenti localmente all'interno della propria istanza GDC sicura.
Cosa è incluso:questa architettura copre il deployment di LLM open source (come Gemma, Llama, DeepSeek) utilizzando i backend di servizio vLLM o Ollama. Include l'utilizzo di Kubernetes per l'orchestrazione, Harbor per l'archiviazione degli artefatti, volumi permanenti per i pesi del modello e criteri di rete del progetto per la sicurezza di rete.
Cosa non è incluso: questa architettura non copre i servizi AI Gateway gestiti, i modelli proprietari come Gemini di Google, i processi di perfezionamento dei modelli o i modelli di AI generativa per altre modalità come la generazione di immagini. Queste funzionalità verranno trattate in guide separate.
Pubblico:il pubblico principale di questo documento include gli amministratori della piattaforma responsabili della distribuzione e della gestione dei servizi su GDC e gli architetti tecnici che progettano soluzioni di AI all'interno dell'ambiente air-gap. Gli utenti finali e gli sviluppatori che interagiranno con i modelli implementati sono i segmenti di pubblico secondari che traggono vantaggio dalla comprensione della struttura sottostante.
Architettura di riferimento
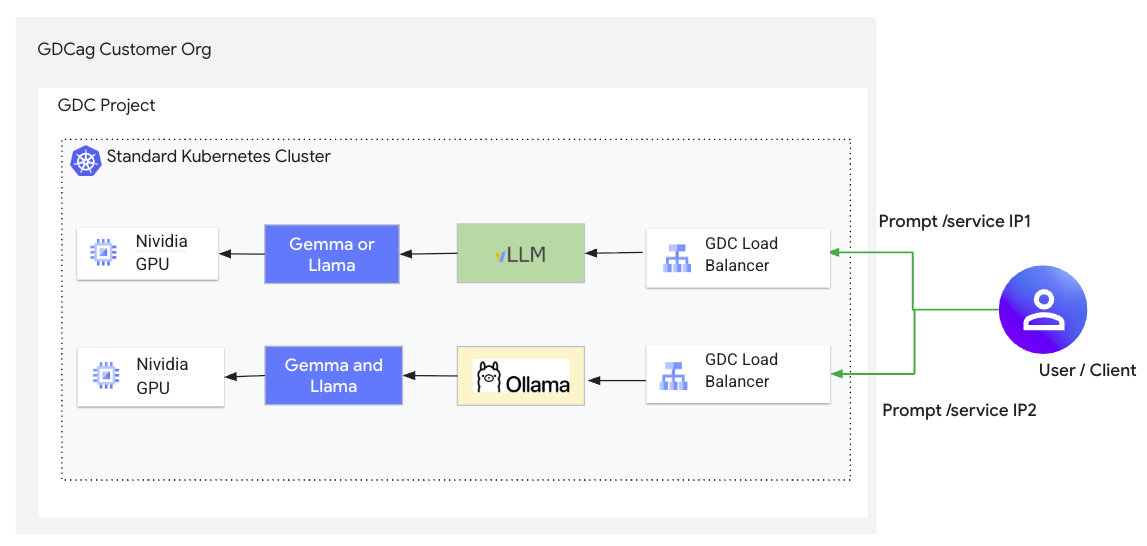
Componenti della soluzione
La soluzione utilizza i seguenti componenti:
| Componente della soluzione | Responsabilità | Flusso di dati | Interfacce |
|---|---|---|---|
| Zona cliente GDC con air gap | Ospita i cluster Kubernetes, il networking e l'infrastruttura di archiviazione | Piattaforma di base | Interfacce di gestione dell'infrastruttura per l'IO. API Kubernetes per amministratori e utenti della piattaforma |
| Bilanciatore del carico | Espone i pod di servizio LLM (vLLM, Ollama) al traffico proveniente dall'esterno del cluster Kubernetes, fornendo un indirizzo IP stabile. | Le richieste dei client esterni vengono inviate all'IP esterno del bilanciatore del carico. LoadBalancer distribuisce le richieste tra i pod di backend integri (vLLM o Ollama) in base al selettore del servizio. | API Kubernetes Service. Esegue automaticamente il provisioning di un bilanciatore del carico di rete nell'ambiente GDC. |
| vLLM | Servizio di inferenza LLM ad alto throughput. Ottimizzato per la bassa latenza utilizzando tecniche come PagedAttention. In genere, serve un modello per istanza. | Riceve richieste di inferenza HTTP dai client. Carica i pesi del modello dal PVC montato. Esegue calcoli sulle GPU collegate. Restituisce risposte HTTP con il testo generato. | API RESTful compatibile con OpenAI per l'inferenza. Accetta richieste JSON. |
| Ollama | Servizio di inferenza LLM, progettato per la facilità d'uso e la gestione di più modelli all'interno di una singola istanza (anche se solo uno è attivo alla volta) | Riceve richieste di inferenza HTTP. Carica i modelli (spesso inclusi nell'immagine container o recuperati al primo utilizzo se non sono isolati). Esegue i calcoli sulle GPU. Restituisce risposte HTTP. I modelli vengono scaricati dopo un periodo di inattività. | L'API RESTful di Ollama accetta richieste JSON. Dispone anche di una CLI. |
| GPU Nvidia / MIG | Fornisce l'accelerazione hardware per l'inferenza LLM. | I backend LLM (vLLM, Ollama) scaricano i calcoli intensivi del modello (moltiplicazioni di matrici e così via) sulle GPU per accelerare l'inferenza. MIG consente di partizionare una singola GPU da utilizzare con più istanze di modelli più piccole. | Esposto come tipo di risorsa in Kubernetes (ad es. nvidia.com/gpu). I pod richiedono queste risorse |
| Porto | Archivia e gestisce in modo sicuro le immagini container per vLLM, Ollama e qualsiasi pod helper (come busybox) | Le immagini container vengono inviate da un ambiente di build (ad es. una workstation con accesso a internet) ad Harbor. I nodi Kubernetes estraggono queste immagini da Harbor per eseguire i container. | API Docker Registry. I nodi Kubernetes interagiscono con Harbor per estrarre le immagini durante la creazione dei pod. Gli utenti interagiscono con la CLI Docker o la UI di Harbor per eseguire il push delle immagini. |
| Richieste di volumi permanenti | Fornisce spazio di archiviazione permanente per i pesi del modello LLM, separato dai cicli di vita dei pod. | I file del modello vengono copiati nel Persistent Volume (ad esempio, utilizzando un pod helper e kubectl cp). Il server vLLM legge i pesi del modello da questo volume montato all'avvio. Ollama in genere raggruppa i modelli all'interno dell'immagine, quindi i PVC sono meno comuni per l'archiviazione dei modelli Ollama in questa configurazione. |
API di archiviazione Kubernetes. Definiti in YAML e montati nei pod come volumi. |
| Policy di rete del progetto | Applica l'isolamento di rete e controlla il flusso di traffico a livello di progetto/spazio dei nomi. Garantisce che solo il traffico autorizzato possa raggiungere i servizi LLM. | Il traffico di rete da e verso i pod all'interno dello spazio dei nomi viene ispezionato. Le regole dei criteri stabiliscono se le connessioni alle porte del servizio LLM (ad es. 8000 per vLLM, 11434 per Ollama) sono consentite, in genere in base agli intervalli IP di origine o ad altre etichette. | API Kubernetes networking.gdc.goog/v1. Definito in YAML. |
Caratteristiche e funzionalità
Questa architettura di riferimento fornisce le seguenti funzionalità di base:
- Erogazione di LLM con pesi aperti:consente l'hosting e l'inferenza di vari modelli con pesi aperti (ad esempio Gemma, Llama, DeepSeek).
- Componenti:backend di servizio LLM (vLLM, Ollama), deployment/pod Kubernetes.
- Responsabilità: caricamento dei pesi del modello, gestione del processo di inferenza, esecuzione dei modelli su acceleratori hardware ed esposizione degli endpoint.
- Interfacce:API REST (compatibili con OpenAI per vLLM, API integrate per Ollama) per le richieste di inferenza, in genere utilizzando JSON.
- Bring Your Own Model (BYOM): gli utenti possono importare e implementare i LLM open weight scelti nell'ambiente air-gap.
- Componenti:Harbor, richieste di volumi permanenti, Kubernetes.
- Responsabilità:archiviazione sicura di immagini container e pesi del modello. Meccanismo per trasferire i modelli nell'ambiente e renderli accessibili ai motori di pubblicazione.
- Interfacce:API Docker Registry (per Harbor), API Kubernetes (per PVC e montaggi di volumi).
- Inferenza con accelerazione hardware:sfrutta le GPU NVIDIA all'interno del cluster GDC per eseguire inferenze LLM in modo efficiente.
- Componenti:GPU NVIDIA, Kubernetes, plug-in per dispositivi.
- Responsabilità:pianificazione dei pod sui nodi con risorse GPU. Esposizione dell'hardware GPU ai container di backend LLM. Supporta la GPU multi-istanza (MIG) per il partizionamento.
- Interfacce: API Kubernetes (per richiedere risorse GPU come
nvidia.com/gpu).
- Accesso controllato dalla rete:garantisce che l'accesso agli endpoint di inferenza LLM sia controllato e isolato all'interno dell'ambiente GDC.
- Componenti:servizi Kubernetes (bilanciatore del carico), ProjectNetworkPolicy.
- Responsabilità:esporre i servizi di inferenza utilizzando un IP stabile. Definizione e applicazione di regole di rete per consentire o negare il traffico ai backend LLM in base a origine, destinazione e porte.
- Interfacce:API Kubernetes (per Services e ProjectNetworkPolicy).
- Scalabilità di Serving:consente di regolare la capacità in base alla domanda.
- Componenti:deployment Kubernetes.
- Responsabilità:abilitare lo scaling orizzontale aumentando il numero di repliche per i pod di backend LLM. Scalabilità verticale mediante la modifica di richieste/limiti di risorse.
- Interfacce:API Kubernetes (per la gestione delle repliche e delle risorse di Deployment).
Principi architettonici
- Priorità alla sicurezza: tutti i componenti e i dati risiedono all'interno del confine con air gap di GDC, garantendo il massimo controllo e la massima sicurezza dei dati. L'accesso alla rete è limitato tramite ProjectNetworkPolicies.
- Sovranità dei dati: i clienti mantengono il pieno controllo dei propri modelli e dati, senza necessità di connettività esterna per il funzionamento.
- Aperta e flessibile: l'architettura sfrutta i backend di servizio open source (vLLM, Ollama) e supporta una serie di LLM con pesi aperti, offrendo ai clienti la possibilità di scegliere ed evitando il vendor lock-in per il motore di inferenza.
- Disaccoppiamento dei componenti: le funzioni chiave come l'archiviazione dei modelli (PVC), la gestione delle immagini (Harbor) e la gestione dell'inferenza (pod vLLM/Ollama) sono componenti distinti, che consentono la gestione e gli aggiornamenti indipendenti.
- Scalabilità e prestazioni: progettato per scalare sia orizzontalmente aumentando il numero di repliche dei pod sia verticalmente regolando le risorse CPU/GPU per soddisfare le esigenze di prestazioni. vLLM viene scelto per scenari con throughput elevato e bassa latenza.
- Ottimizzazione delle risorse: supporta la GPU multi-istanza (MIG) NVIDIA per consentire ai modelli più piccoli di condividere in modo efficiente le risorse GPU, massimizzando l'utilizzo dell'hardware.
- Interfacce standard: basate sugli standard Kubernetes per l'orchestrazione, il deployment e l'esposizione dei servizi. Gli endpoint di inferenza forniscono API REST, con vLLM che offre la compatibilità con OpenAI.
- Resilienza: sfrutta i controlli di integrità e la replica di Kubernetes per garantire la disponibilità del servizio.
Considerazioni
- Scalabilità e prestazioni:
- La scalabilità orizzontale si ottiene aumentando il numero di repliche nel deployment Kubernetes sia per vLLM che per Ollama.
- Lo scalabilità verticale prevede l'allocazione di più CPU/memoria e sezioni GPU più grandi, fino a GPU complete.
- vLLM gestisce un modello per istanza, richiedendo nuovi deployment per modelli aggiuntivi. Ollama può gestire più modelli, ma ne esegue uno solo alla volta.
- Le dimensioni del PVC influiscono in modo significativo sui tempi di caricamento del modello; si consiglia di utilizzare 500 GiB o più per IOPS elevate.
- Gestione delle risorse:
- È essenziale pianificare attentamente le risorse GPU. NVIDIA MIG può essere utilizzato per partizionare le GPU per modelli più piccoli, migliorando l'utilizzo.
- Devono essere allocate CPU e memoria sufficienti per gestire sia l'inferenza sia l'overhead di gestione del modello.
- Per ospitare le dimensioni dei modelli e garantire le prestazioni, è necessario eseguire il provisioning di spazio di archiviazione sufficiente per i PVC.
- Disponibilità e affidabilità:
- I deployment Kubernetes forniscono funzionalità di auto-riparazione e aggiornamento in sequenza.
- I servizi LoadBalancer distribuiscono il traffico tra i pod integri, mascherando i singoli errori dei pod.
- L'archiviazione dei pesi del modello sulle PVC garantisce la persistenza durante i riavvii dei pod.
- Complessità operativa:
- Gestione delle immagini container per diversi backend e versioni in Harbor.
- Procedure per il trasferimento sicuro dei pesi del modello nell'ambiente air-gap.
- Creazione e gestione dei manifest Kubernetes (deployment, servizi, PVC, policy di rete) per ogni modello e backend.
- Monitoraggio dell'utilizzo della GPU, della latenza di inferenza e dei tassi di errore.
- Sicurezza e conformità:
- L'intera soluzione opera all'interno del perimetro di sicurezza isolato da internet del GDC.
- ProjectNetworkPolicies sono obbligatorie per applicare un rigoroso isolamento di rete e controllare l'accesso agli endpoint LLM.
- Gli account robot Harbor e i segreti di pull delle immagini Kubernetes garantiscono l'accesso sicuro alle immagini container.
- I dati in transito possono essere protetti dalle policy di rete di Kubernetes e da qualsiasi crittografia a livello di piattaforma. I dati at-rest sui PVC si basano sulla crittografia dell'archiviazione GDC.
Decisioni di progettazione
Per questa architettura di riferimento sono state prese le seguenti decisioni di progettazione chiave:
Decisione 1: offrire sia vLLM che Ollama anziché un solo modello di inferenza
| Contesto | Decisione chiave | Rationale |
|---|---|---|
| Offri solo una delle due scelte per i livelli di inferenza: VLLM e Ollama oppure offrile entrambe. | Abbiamo deciso di offrire entrambi perché utenti e casi d'uso diversi hanno requisiti variabili per prestazioni, compatibilità delle API e facilità di gestione dei modelli. | vLLM offre serving a bassa latenza e con throughput elevato e compatibilità con l'API OpenAI, adatta alle applicazioni di produzione. Ollama offre una configurazione più semplice, una gestione più facile di più modelli e un'interfaccia intuitiva, ideale per lo sviluppo e la sperimentazione. Il supporto di entrambi offre flessibilità. |
Decisione 2: Utilizzo dell'archiviazione permanente rispetto all'archiviazione di oggetti per l'archiviazione del modello vLLM
| Contesto | Decisione chiave | Rationale |
|---|---|---|
| vLLM richiede che i pesi del modello siano presenti nel file system in fase di runtime. In un ambiente air-gap, i modelli non possono essere scaricati on demand. | L'utilizzo di Persistent Volume Claims garantisce la disponibilità del modello e migliora il tempo di avvio dopo il caricamento iniziale, ma richiede un passaggio iniziale per popolare il PVC, in genere con un pod helper | Le Persistent Volume Claims forniscono un livello di archiviazione permanente e resiliente per i file di modelli di grandi dimensioni, disaccoppiato dal ciclo di vita del pod vLLM. Ciò consente di caricare rapidamente i modelli all'avvio del pod. |
Decisione 3: raggruppamento dei modelli all'interno delle immagini Docker di Ollama rispetto alle immagini autonome
| Contesto | Decisione chiave | Rationale |
|---|---|---|
| Ollama può scaricare modelli, ma ciò richiede l'accesso a internet, che non è disponibile negli ambienti air-gap | È stata presa la decisione di raggruppare le immagini in modo da semplificare l'operazione di runtime nell'ambiente air-gap, in quanto non sono necessarie chiamate esterne. Tuttavia, per aggiornare o aggiungere modelli, l'immagine Docker deve essere ricompilata e inviata nuovamente a Harbor. | La creazione dell'immagine Docker con i modelli pre-scaricati garantisce che Ollama inizi con i modelli necessari disponibili offline. |
Decisione 4: esposizione di vLLM e Ollama con servizi LoadBalancer rispetto a nessun bilanciatore del carico
| Contesto | Decisione chiave | Rationale |
|---|---|---|
| Le API LLM devono essere accessibili alle applicazioni all'interno dell'ambiente GDC. | È stata presa la decisione di esporre i servizi utilizzando un bilanciatore del carico, in quanto questo è l'approccio Kubernetes standard per l'esposizione dei servizi. Tuttavia, questo approccio si basa sul provisioning di LoadBalancer della piattaforma GDC. | I servizi Kubernetes di tipo LoadBalancer forniscono un metodo standard e affidabile per esporre i backend LLM, fornendo un indirizzo IP stabile e distribuendo il carico. |
Decisione 5: applicazione di ProjectNetworkPolicy obbligatoria
| Contesto | Decisione chiave | Rationale |
|---|---|---|
| La sicurezza e l'isolamento sono fondamentali nei deployment GDC con air gap. | È stato deciso di applicare ProjectNetworkPolicy in quanto migliora significativamente la postura di sicurezza dei servizi LLM di cui è stato eseguito il deployment, anche se richiede una definizione accurata delle policy di rete | ProjectNetworkPolicies fornisce un modo nativo di Kubernetes per applicare l'isolamento di rete a livello di spazio dei nomi, garantendo che solo il traffico autorizzato possa raggiungere i servizi LLM. |
Presupposti e limitazioni
- È disponibile l'ambiente GDC con air gap 1.15.1+
- Nel cluster standard sono presenti risorse hardware sufficienti (in particolare GPU).
- L'istanza Harbor è configurata e accessibile.
- Gli utenti dispongono delle autorizzazioni necessarie (amministratore dello spazio dei nomi, sviluppatore del cluster).
- I modelli sono compatibili con i backend di pubblicazione scelti (vLLM/Ollama).
Flusso utente (passaggi end-to-end)
Di seguito è riportato un flusso utente completo per il deployment di modelli linguistici di grandi dimensioni (LLM) open weight negli ambienti con air gap di Google Distributed Cloud (GDC). Il flusso è suddiviso in configurazione comune, due percorsi di deployment (vLLM e Ollama) e convalida finale.
1. Configurazione comune: gestione delle immagini
Prima di eseguire il deployment di qualsiasi LLM, devi configurare il modo in cui l'ambiente GDC eseguirà il pull delle immagini container dal tuo registro Harbor privato.
- Crea un account robot Harbor: genera un account robot nell'interfaccia utente di Harbor e concedigli le autorizzazioni "pull".
- Autentica Docker:utilizza le credenziali dell'account robot per accedere a Harbor da una macchina con accesso alla rete.
- Crea il secret Kubernetes: crea un secret docker-registry nello spazio dei nomi del progetto GDC utilizzando
kubectlper archiviare queste credenziali Harbor da utilizzare per il cluster.
2. Percorso di deployment A: vLLM (throughput elevato)
Questo percorso è consigliato per la distribuzione di modelli orientati al rendimento come Gemma-3.
- Acquire Image: scarica l'immagine Docker vLLM da internet, taggala per il tuo registro Harbor locale ed eseguine il push su Harbor.
- Prepara l'archiviazione del modello:
- Crea una richiesta di volume permanente (PVC) da 500 GiB per archiviare i pesi del modello.
- Scarica i pesi da Hugging Face su una macchina connessa a internet.
- Utilizza un "pod helper" temporaneo e
kubectl cpper trasferire questi pesi nel PVC all'interno dell'ambiente GDC.
- Esegui il deployment del backend:applica un manifest di deployment Kubernetes che fa riferimento all'immagine vLLM e monta la PVC dei pesi del modello.
- Esporre il servizio:crea un servizio
LoadBalancerper fornire un IP esterno per l'API vLLM. - Rete sicura:applica un
ProjectNetworkPolicyper consentire il traffico in entrata sulla porta del servizio (in genere 8000).
3. Percorso di deployment B: Ollama (facilità d'uso)
Questo percorso si concentra su una configurazione semplificata in cui i pesi del modello sono raggruppati o precaricati nell'immagine.
- Crea immagine personalizzata:crea un Dockerfile che installa Ollama e utilizza un comando
RUNper "pre-pull" di modelli specifici (ad es.gemma3) nei livelli dell'immagine. - Push to Harbor:crea l'immagine localmente ed eseguine il push nel tuo registro Harbor privato.
- Deployment ed esposizione:crea un deployment di Ollama e un servizio
LoadBalancer. - Rete sicura:applica un
ProjectNetworkPolicyper la porta Ollama (11434).
4. Convalida e test
Una volta eseguito il deployment, i passaggi finali prevedono la verifica del funzionamento dei servizi.
- Controlla lo stato:verifica che i pod siano "Running" e che ai servizi siano stati assegnati indirizzi IP esterni.
- Test Inference:
- vLLM: invia una richiesta
curlall'indirizzo IPLoadBalancerdi vLLM utilizzando l'endpoint/v1/chat/completionscompatibile con OpenAI. - Ollama: invia una richiesta
curlall'indirizzo IPLoadBalancerdi Ollama all'endpoint/v1/completions.
- vLLM: invia una richiesta
5. Operazioni e scalabilità
- Scalabilità verticale:aumenta le sezioni di GPU o passa a configurazioni multi-GPU per modelli più grandi.
- Scalabilità orizzontale:aumenta il numero di repliche nel deployment per gestire un maggior numero di richieste simultanee degli utenti.
- Risoluzione dei problemi:monitora i log utilizzando
kubectl logse verifica la presenza di problemi comuni come errori di autotest FIPS o limitazioni dei criteri di rete.