


Pernyataan Masalah
Organisasi yang menjalankan Model Bahasa Besar (LLM) di lingkungan yang terisolasi dari internet dengan cepat mengumpulkan endpoint model: setiap model open weight yang ditayangkan di lingkungan yang terisolasi dari internet Google Distributed Cloud (GDC) (lihat set panduan pendamping Menetapkan Model Open Weight di lingkungan yang terisolasi dari internet GDC) mengekspos Kubernetes Service-nya sendiri, alamatnya sendiri, kredensialnya sendiri, dan siklus proses operasionalnya sendiri.
Developer aplikasi dan agen berakhir di silo arsitektur, mengodekan satu
endpoint per model dan menulis ulang integrasi dengan setiap iterasi model. Fragmentasi ini menciptakan utang teknis dan memperlambat deployment workload agentik multi-langkah yang sangat penting.
Lapisan jaringan standar juga "tidak mendukung AI": load balancer konvensional memperlakukan traffic inferensi seperti HTTP generik dan tidak dapat membaca kolom model permintaan, memprioritaskan workload yang sensitif terhadap latensi, memperhitungkan token, bukan permintaan, atau mengarahkan permintaan ke replika server model yang sudah menyimpan cache KV yang relevan. Di cluster GPU air-gapped dengan biaya tinggi, hal ini menyebabkan kurangnya pemanfaatan hardware dan laba atas investasi yang buruk. Meskipun Gemini di GDC menyediakan model canggih terkelola, pelanggan yang menggabungkannya dengan model bobot terbuka yang dihosting sendiri memerlukan lapisan inferensi yang menawarkan ketangkasan seperti cloud tanpa mengorbankan kedaulatan data: tidak ada permintaan, perintah, atau bobot model yang dapat keluar dari batas GDC.
Solusi yang diusulkan
Dokumen ini menguraikan arsitektur referensi untuk gateway AI yang dikelola sendiri
di GDC dengan air gap: lapisan inferensi yang aman dan terpusat
yang memberi aplikasi satu endpoint yang kompatibel dengan OpenAI untuk semua model dan merutekan
setiap permintaan ke backend yang tepat. Implementasi referensi dibangun di atas
Kubernetes Gateway API: Envoy Gateway adalah implementasi Gateway API (bidang
kontrol dan bidang data proxy Envoy) dan Envoy Agent Router (sebelumnya Envoy AI
Gateway) memperluasnya dengan pemrosesan permintaan khusus AI: ekstraksi model dari
isi permintaan, terjemahan permintaan dan respons, autentikasi upstream,
penghitungan token dan, secara opsional, pembatasan frekuensi berbasis token. Ekstensi Inferensi Gateway API menambahkan pemilihan endpoint yang mendukung server model (InferencePooldan Pemilih Endpoint) sehingga kapasitas GPU digunakan secara efisien. Semua artefak di-stage di registry Harbor organisasi GDC dan seluruh stack berjalan di cluster standar tanpa konektivitas eksternal.
Yang disertakan: Arsitektur ini mencakup deployment Envoy Gateway dan Envoy Agent Router dalam cluster standar, resource Gateway API (GatewayClass, Gateway) dan resource Envoy Agent Router (AIGatewayRoute, AIServiceBackend, BackendSecurityPolicy, GatewayConfig) yang mengekspos endpoint yang kompatibel dengan OpenAI terpadu, perutean berbasis isi pada kolom model, Ekstensi Inferensi Gateway API (InferencePool, InferenceObjective, Pemilih Endpoint) untuk load balancing yang mendukung model, pembatasan kapasitas berbasis token opsional dengan Redis, TLS termination di gateway, kebijakan jaringan (NetworkPolicy / ProjectNetworkPolicy) dan pengelolaan artefak air-gapped di Harbor. Backend penyajian model di balik gateway (Ollama, vLLM) di-deploy dengan panduan pendamping yang menetapkan Model Berat Terbuka di GDC yang terisolasi.
Yang tidak disertakan: Arsitektur ini tidak mencakup produk gateway AI terkelola, deployment dan penyesuaian model itu sendiri (kumpulan panduan pendamping), penyesuaian model, modalitas GenAI non-LLM, traffic agen-ke-alat (MCPRoute), atau distribusi gateway yang didukung secara komersial. Gemini di GDC adalah kemampuan produk terkelola; penyediaannya di luar cakupan dan panduan versi ini menetapkan validasi gateway dengan model open source yang dihosting sendiri.
Audiens: Audiens utama untuk dokumen ini mencakup Administrator Platform yang bertanggung jawab untuk men-deploy dan mengoperasikan gateway di cluster standar dan arsitek teknis yang mendesain platform AI dalam lingkungan yang terisolasi. Developer aplikasi yang menggunakan endpoint terpadu adalah audiens sekunder yang akan mendapatkan manfaat dari pemahaman tentang cara permintaan mereka dirutekan.
Arsitektur
Solusi ini berjalan sepenuhnya di cluster standar organisasi GDC dengan air gap. Di lapisan Services,
Kubernetes Gateway API menstandardisasi model konfigurasi; bidang kontrol gateway AI (pengontrol Envoy Gateway dan pengontrol Envoy Agent Router) membaca resource Gateway API dan Envoy Agent Router serta
mengonfigurasi bidang data: proxy Envoy Deployment yang merupakan titik masuk permintaan (diekspos melalui Service berjenis LoadBalancer) dan pemroses eksternal Envoy Agent
Router yang berjalan sebagai sidecar di proxy Pod dan menjalankan
logika khusus AI. Di lapisan Aplikasi, workload pelanggan (aplikasi dan agen) mengirim permintaan AI ke proxy (1), proxy menyerahkan permintaan ke pemroses eksternal, yang mengekstrak nama model, menerjemahkan permintaan, dan mencatat penggunaan token (2), proxy meneruskan traffic yang seimbang ke Pods inferensi model yang dipilih (3), dan model berjalan di node GPU lapisan Infrastruktur (4). Backend penyaluran model dilampirkan ke
gateway sebagai AIServiceBackend (Service yang kompatibel dengan OpenAI) atau
sebagai InferencePool yang Endpoint Picker-nya memilih replika terbaik per
permintaan. Image container dan diagram Helm diambil dari Harbor.
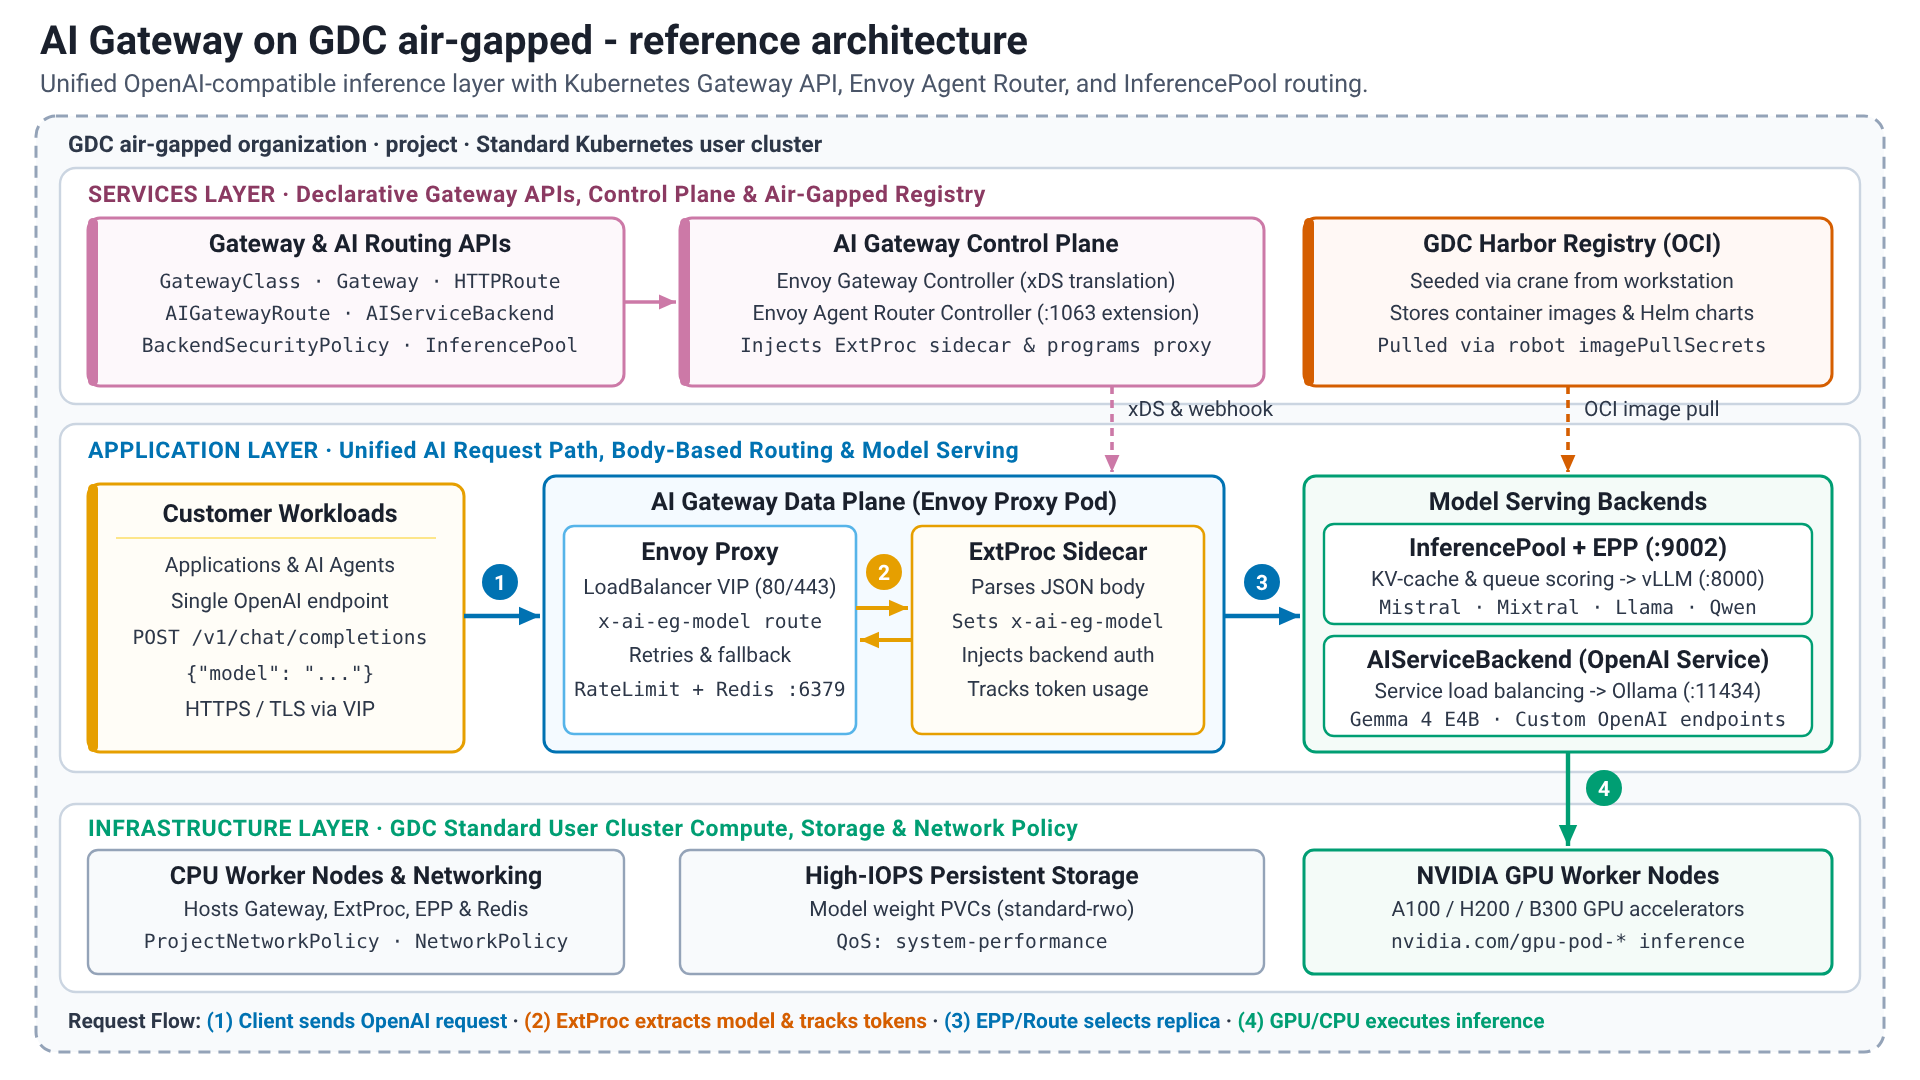
Komponen solusi
Solusi ini menggunakan komponen berikut:
| Komponen Solusi | Tanggung Jawab | Aliran Data | Antarmuka |
|---|---|---|---|
| Kubernetes Gateway API | Model resource standar yang berorientasi pada peran untuk ingress dan perutean: GatewayClass (dimiliki oleh platform), Gateway (pendengar, TLS), dan resource rute (dimiliki oleh tim aplikasi). Pengganti Ingress API tanpa anotasi khusus vendor. |
Hanya konfigurasi deklaratif; resource dipantau oleh pengontrol dan tidak membawa traffic permintaan. | Kubernetes API (gateway.networking.k8s.io/v1); CRD diinstal dari diagram CRD Envoy Gateway. |
| Pengontrol Envoy Gateway (bidang kontrol) | Menerapkan Gateway API: menyediakan satu proxy Envoy Deployment dan LoadBalancer Service per Gateway, menerjemahkan rute dan kebijakan (BackendTrafficPolicy, SecurityPolicy, EnvoyExtensionPolicy, Backend, EnvoyProxy) ke dalam konfigurasi xDS, menjalankan layanan batas laju global saat dikonfigurasi, dan memanggil server ekstensi Envoy Agent Router melalui pengelola ekstensinya sehingga backend InferencePool ditambahkan ke terjemahan. |
Memantau Kubernetes API dan mengirimkan konfigurasi xDS ke proxy; tidak ada traffic permintaan. | Kubernetes API (watch), xDS gRPC ke proxy, gRPC ke server ekstensi (port 1063). |
| Pengontrol Envoy Agent Router (bidang kontrol) | Menyesuaikan resource aigateway.envoyproxy.io/v1beta1, AIGatewayRoute (aturan pemilihan rute pada nama model yang diekstrak), AIServiceBackend (backend dengan skema API-nya), BackendSecurityPolicy (kredensial upstream), dan GatewayConfig (setelan pemroses eksternal per Gateway), ke dalam resource Envoy Gateway, menyuntikkan sidecar pemroses eksternal ke dalam Pod proxy Envoy, dan menyajikan server ekstensi yang digunakan oleh Envoy Gateway. |
Konfigurasi saja. | Kubernetes API, server ekstensi gRPC (port 1063), webhook penerimaan yang mengubah untuk injeksi sidecar. |
| Proxy Envoy (bidang data) | Titik entri permintaan: menghentikan TLS, mencocokkan pendengar dan rute, menyeimbangkan beban di seluruh endpoint backend, menerapkan batas kecepatan dan waktu tunggu, mencoba lagi dan melakukan penggantian ke backend alternatif, serta memancarkan log dan metrik akses. | Menerima permintaan klien di LoadBalancer VIP (80/443), berkonsultasi dengan pemroses eksternal untuk setiap permintaan AI, meneruskan permintaan ke endpoint backend yang dipilih (Service atau Pod yang dipilih oleh Pemilih Endpoint) dan mengalirkan respons kembali ke klien. |
HTTP/HTTPS ke klien (API yang kompatibel dengan OpenAI), gRPC ext_proc ke sidecar dan Endpoint Picker, HTTP ke backend, gRPC ke layanan batas kapasitas. |
| Prosesor eksternal (ExtProc) Router Agen Envoy | Mem-parsing isi permintaan yang kompatibel dengan OpenAI, mengekstrak kolom model ke header perutean x-ai-eg-model, menerapkan penggantian nama model, menerjemahkan payload permintaan dan respons antara skema API klien dan skema API backend, menyuntikkan kredensial upstream yang ditentukan oleh BackendSecurityPolicy, dan mengekstrak penggunaan token (input, output, total) dari respons ke dalam metadata dinamis yang digunakan untuk pembatasan frekuensi dan metrik berbasis token. |
Penampung sidecar di proxy Envoy Pod; memproses isi permintaan dan respons, termasuk respons yang di-streaming. |
gRPC ext_proc Envoy; Endpoint metrik Prometheus. |
| Ekstensi Inferensi Gateway API (InferencePool + Endpoint Picker) | InferencePool (inference.networking.k8s.io/v1) mengelompokkan Pod dari satu deployment server model (pemilih label, port target, misalnya 8000) dan mereferensikan Pemilih Endpoint (EPP). InferenceObjective (v1alpha2) menetapkan prioritas per model atau tujuan. EPP meng-scrape metrik server model (kedalaman antrean permintaan, pemanfaatan KV-cache, adaptor LoRA yang dimuat) dan memilih endpoint untuk setiap permintaan. |
Proxy memanggil EPP (ext_proc, port 9002) dengan header permintaan; EPP menjawab dengan endpoint yang akan digunakan; proxy meneruskan permintaan ke Pod tersebut. |
Kubernetes API (CRD), gRPC ext_proc (9002), pengambilan Prometheus dari server model. |
| Redis (opsional) | Penyimpanan pendukung layanan pembatasan kapasitas Envoy: penghitung bersama untuk pembatasan berbasis permintaan dan berbasis token di semua replika proxy. Hanya diperlukan jika pembatasan frekuensi global dikonfigurasi. | Layanan pembatasan kapasitas membaca dan menaikkan penghitung di port 6379 untuk setiap permintaan yang dibatasi. | Protokol Redis (6379). Redis 8.10 di-deploy di cluster, atau instance Redis yang ada. |
| Backend penyajian model (Ollama / vLLM) | Menyajikan model bobot terbuka di balik gateway; di-deploy dengan panduan pendamping yang menetapkan Model Bobot Terbuka di GDC dengan air gap. Dilampirkan sebagai AIServiceBackend (Service yang kompatibel dengan OpenAI, misalnya Ollama) atau sebagai InferencePool (server model seperti vLLM yang mengekspos metrik yang diberi skor oleh Pemilih Endpoint). |
Menerima permintaan yang dirutekan dari proxy, menjalankan inferensi pada node GPU (atau pada CPU untuk evaluasi fungsional dengan model kecil), dan menampilkan respons yang kompatibel dengan OpenAI. | REST API yang kompatibel dengan OpenAI: vLLM di port 8000, Ollama di port 11434; metrik Prometheus (vLLM) untuk Pemilih Endpoint. |
| Harbor | Menyimpan image container (proxy Envoy, Envoy Gateway, pengontrol Router Agen Envoy dan pemroses eksternal, layanan pembatasan kecepatan, Pemilih Endpoint, Redis) dan diagram Helm (artefak OCI) solusi. | Artefak disalin dari registry publik ke Harbor dengan seed_registry.sh (crane) dari workstation dengan akses internet; cluster menarik image dengan akun robot melalui secret penarikan image dan diagram dirender dari Harbor dengan helm template. |
OCI Distribution API; Akun robot dan UI Harbor. |
| Cluster standar dan node GPU | Menampung semua komponen gateway (node CPU sudah cukup) dan inferensi Pods (node GPU dengan resource akselerator yang ditemukan dari node). Menyediakan VIP LoadBalancer, penyimpanan persisten untuk bobot model, dan penerapan kebijakan jaringan. |
Platform dasar; permintaan masuk melalui LoadBalancer VIP Gateway dan tetap berada di dalam jaringan cluster. |
Kubernetes API, GDC networking API (networking.gdc.goog/v1 ProjectNetworkPolicy), konsol GDC, dan gdcloud untuk Administrator Platform. |
Fitur dan kemampuan
Arsitektur referensi ini menyediakan kemampuan inti berikut:
- Endpoint terpadu yang kompatibel dengan OpenAI: Aplikasi memanggil satu alamat
(
/v1/chat/completions,/v1/models, …) untuk setiap model yang ditayangkan di balik gateway.- Komponen:
Gateway,AIGatewayRoute, proxy Envoy, pemroses eksternal. - Tanggung Jawab: Mengekspos IP virtual yang stabil, menghentikan TLS, menerima format permintaan yang kompatibel dengan OpenAI dan menerjemahkannya ke skema backend jika diperlukan.
- Antarmuka: HTTPS REST (JSON, termasuk peristiwa yang dikirim server untuk streaming).
- Komponen:
- Perutean berbasis isi (dengan mengetahui model): Gateway membaca kolom
modeldari isi permintaan dan merutekan permintaan ke backend yang cocok tanpa logika endpoint sisi klien.- Komponen: Pemroses eksternal, aturan
AIGatewayRouteyang cocok padax-ai-eg-model,AIServiceBackend,InferencePool. - Tanggung jawab: Mengekstrak nama model, mencocokkan aturan rute, mengganti nama model (
modelNameOverride), memisahkan traffic berdasarkan bobot, dan melakukan penggantian ke backend alternatif berdasarkan prioritas. - Antarmuka: Kubernetes API (
aigateway.envoyproxy.io/v1beta1).
- Komponen: Pemroses eksternal, aturan
- Load balancing yang mendukung server model: Permintaan ke
InferencePooldikirim ke replika dengan antrean terpendek dan cache KV yang paling berguna, bukan round robin.- Komponen: Ekstensi Inferensi Gateway API (
InferencePool,InferenceObjective, Pemilih Endpoint). - Tanggung jawab: Meng-scraping metrik server model, memberi skor pada endpoint (kedalaman antrean, pemanfaatan cache nilai kunci, afinitas cache awalan, adaptor LoRA), mematuhi prioritas per tujuan saat ada beban.
- Antarmuka: Kubernetes API (
inference.networking.k8s.io/v1,inference.networking.x-k8s.io/v1alpha2), ext_proc gRPC (9002).
- Komponen: Ekstensi Inferensi Gateway API (
- Kebijakan keamanan dan autentikasi upstream: Kredensial untuk backend
yang memerlukannya disuntikkan oleh gateway dan tidak pernah didistribusikan ke
aplikasi.
- Komponen:
BackendSecurityPolicy, Envoy GatewaySecurityPolicy, TLS listener. - Tanggung jawab: Menyuntikkan kunci API ke backend, menghentikan TLS klien di
Gateway, menerapkan kebijakan autentikasi dan otorisasi klien jika diperlukan. - Antarmuka:
SecretKubernetes yang dirujuk oleh kebijakan.
- Komponen:
- Pembatasan kapasitas berbasis token (opsional): Penggunaan diukur dalam token, bukan
hanya dalam permintaan.
- Komponen: Pemroses eksternal (
llmRequestCosts), Envoy GatewayBackendTrafficPolicy(pembatasan kecepatan global), layanan pembatasan kecepatan, Redis. - Tanggung jawab: Mengekstrak token input, output, dan total dari setiap respons, melampirkannya sebagai biaya permintaan, menerapkan anggaran per konsumen atau per model di semua replika proxy.
- Antarmuka: Kubernetes API, Redis (6379).
- Komponen: Pemroses eksternal (
- Pengelolaan traffic: Kemampuan Gateway API standar berlaku untuk traffic AI.
- Komponen:
Gateway,HTTPRoute,AIGatewayRoute,BackendTrafficPolicy. - Tanggung jawab: Pencocokan berbasis host, jalur, dan header, waktu tunggu yang sesuai untuk pembuatan panjang, percobaan ulang, pemisahan traffic berbobot, dan penggantian berbasis prioritas di antara backend.
- Antarmuka: Kubernetes API.
- Komponen:
- Kemampuan observasi: Metrik permintaan, latensi, dan token tersedia untuk setiap model.
- Komponen: Log dan statistik akses proxy Envoy, metrik pemroses eksternal (penggunaan token, durasi permintaan, waktu hingga token pertama), metrik Endpoint Picker.
- Tanggung jawab: Mengekspos metrik format Prometheus dan log akses terstruktur yang dapat di-scrap oleh stack observabilitas GDC atau Prometheus yang dikelola pelanggan.
- Antarmuka: Endpoint metrik Prometheus, log output standar.
- Pengelolaan artefak yang terisolasi dari internet: Setiap image dan diagram dipersiapkan di Harbor sebelum diinstal.
- Komponen: Harbor,
seed_registry.sh, akun robot, secret penarikan image, resourceEnvoyProxy(image proxy dan secret penarikan). - Tanggung jawab: Menyemai image dan diagram Helm OCI dari workstation yang terhubung, menyematkan versi, merender diagram secara offline dengan
helm template. - Antarmuka: OCI Distribution API, Kubernetes API.
- Komponen: Harbor,
Prinsip arsitektur
- Mengutamakan Standar: Gateway dikonfigurasi melalui Kubernetes Gateway API dan Ekstensi Inferensinya serta menggunakan API yang kompatibel dengan OpenAI untuk aplikasi, sehingga aplikasi, rute, dan backend tetap portabel di seluruh implementasi gateway.
- Utamakan Keamanan: Semua komponen dan data berada dalam batas GDC yang terisolasi. TLS dihentikan di
Gateway, kredensial backend disuntikkan oleh gateway, dan akses jaringan dibatasi dengan objekNetworkPolicydanProjectNetworkPolicy. - Kedaulatan Data: Perintah, respons, bobot model, dan data penggunaan tidak pernah keluar dari organisasi GDC pelanggan; tidak diperlukan konektivitas eksternal untuk pengoperasian.
- Pemisahan Masalah (Separation of Concerns): Gateway API berorientasi peran memungkinkan Administrator Platform memiliki
GatewayClass,Gateway, TLS, dan kebijakan jaringan, sementara tim aplikasi memiliki resourceAIGatewayRoute,AIServiceBackend, danInferencePooldi namespace mereka sendiri. - Bidang Data dan Bidang Kontrol yang Tidak Terikat: Pengontrol hanya menerjemahkan konfigurasi; jalur permintaan terdiri dari proxy Envoy, sidecar prosesor eksternalnya, dan Pemilih Endpoint, yang terus melayani traffic jika pengontrol dimulai ulang.
- Terbuka & Fleksibel: Arsitektur ini menggunakan software open source di seluruhnya (Envoy Gateway, Envoy Agent Router, Gateway API Inference Extension, Ollama, vLLM) dan resource Gateway API yang sama dapat ditayangkan oleh implementasi alternatif.
- Skalabilitas & Performa: Data plane dapat diskalakan secara horizontal dengan menambahkan replika proxy dan secara vertikal dengan menyesuaikan CPU dan memori. Load balancing yang mendukung server model menjaga GPU tetap jenuh tanpa membebani replika individual.
- Pengalaman Pengguna yang Disederhanakan: Satu endpoint, satu format API, dan satu kredensial untuk setiap model memperpendek jalur dari deployment model hingga konsumsi.
- Ketahanan: Health check dan replikasi Kubernetes, percobaan ulang Envoy, dan penggantian berbasis prioritas antara backend menjaga ketersediaan endpoint saat replika model individual gagal.
Pertimbangan
- Skalabilitas dan Performa:
- Komponen gateway adalah workload khusus CPU; proxy Envoy
DeploymentdariGatewaydiskalakan secara horizontal dengan meningkatkan jumlah replikanya (resourceEnvoyProxy) dan secara vertikal dengan menaikkan permintaan CPU dan memori. Pemeriksaan isi oleh pemroses eksternal memerlukan biaya CPU yang sebanding dengan ukuran permintaan dan respons; respons yang di-streaming diproses secara inkremental. - Load balancing yang mendukung server model hanya berlaku untuk backend yang dilampirkan sebagai
InferencePool; backend yang dilampirkan sebagaiAIServiceBackenddi-load balance oleh proxy di seluruh endpointService-nya. - Gateway tidak menambahkan kapasitas GPU: throughput dan latensi dibatasi oleh server model. Tentukan ukuran deployment model dengan set panduan pendamping (vLLM untuk throughput tinggi, Ollama untuk kemudahan penggunaan dan evaluasi khusus CPU).
- Pembuatan yang panjang memerlukan waktu tunggu permintaan dan waktu tunggu tidak ada aktivitas yang lebih lama daripada API HTTP biasa; konfigurasikan waktu tunggu tersebut di rute dan kebijakan, bukan di klien.
- Komponen gateway adalah workload khusus CPU; proxy Envoy
- Pengelolaan Resource:
- Semua komponen gateway berjalan di node CPU dan tidak memerlukan akselerator; tabel berikut memberikan ukuran indikatif untuk deployment fungsional. Implementasi referensi menetapkan permintaan dan batas yang tepat; nilai produksi bergantung pada rasio permintaan dan ukuran payload.
- Tabel port berikut mencantumkan setiap port yang harus diizinkan oleh kebijakan jaringan.
- Perencanaan GPU termasuk dalam deployment model: nama resource akselerator ditemukan dari node seperti yang dijelaskan dalam set panduan pendamping.
Penentuan ukuran indikatif komponen gateway (khusus CPU)
| Komponen | Replika | CPU (permintaan) | Memori (permintaan) | Catatan |
|---|---|---|---|---|
| Pengontrol Envoy Gateway | 1 | 100m–500m | 256 MiB–1 GiB | Bidang kontrol; tidak ada di jalur permintaan |
| Pengontrol Envoy Agent Router | 1 | 100m–500m | 256Mi–512Mi | Bidang kontrol dan server ekstensi |
Proxy Envoy Pod (proxy + sidecar pemroses eksternal) |
1–2 per Gateway |
500m–2 | 512 MiB–2 GiB | Lakukan penskalaan dengan kecepatan permintaan dan ukuran payload |
| Pemilih Endpoint | 1 per InferencePool |
100m–500m | 256 MiB–512 MiB | Mengambil metrik server model |
| Layanan batas laju (opsional) | 1 | 100m–500m | 256Mi–512Mi | Hanya dengan pembatasan kapasitas global |
| Redis (opsional) | 1 | 100m–500m | 256Mi–1Gi | Hanya dengan pembatasan kapasitas global |
Port jaringan
| Port | Komponen | Tujuan |
|---|---|---|
| 80 / 443 | Proxy Envoy (pemroses Gateway) |
Titik entri HTTP / HTTPS di VIP LoadBalancer |
| 1063 | Pengontrol Envoy Agent Router (server ekstensi) | Panggilan gRPC dari pengelola ekstensi Envoy Gateway |
| 9002 | Pemilih Endpoint | Panggilan gRPC ext_proc dari proxy Envoy |
| 6379 | Redis | Penghitung batas kapasitas |
| 8000 | vLLM | API yang kompatibel dengan OpenAI dan metrik server model |
| 11434 | Ollama | Ollama dan API yang kompatibel dengan OpenAI dari server model |
- Ketersediaan dan Keandalan:
- Proxy dan pemroses eksternal berjalan di
Podyang sama; beberapa replika di belakangLoadBalancerServicemenutupi kegagalanPodindividual, dan pengontrol dapat dimulai ulang tanpa mengganggu traffic. - Aturan
AIGatewayRoutedapat mencantumkan beberapa backend dengan prioritas sehingga gateway melakukan penggantian ke server model atau set replika lain saat backend tidak responsif. - Pemilih Endpoint adalah
Deploymentper kumpulan; jika tidak tersedia, permintaan keInferencePooltersebut akan gagal hingga tersedia kembali. Jalankan dengan permintaan resource dan pemeriksaan kesiapan serta pantau seperti komponen bidang data. - Redis hanya menyimpan penghitung batas frekuensi; gangguan Redis memengaruhi pembatasan frekuensi, bukan perutean.
- Proxy dan pemroses eksternal berjalan di
- Kompleksitas Operasional:
- Penyelarasan versi antara Envoy Gateway, Envoy Agent Router, dan Ekstensi Inferensi Gateway API: upgrade ketiganya bersama-sama dengan kombinasi yang telah diuji (Envoy Gateway 1.8.4, Envoy Agent Router 1.1.0, Ekstensi Inferensi Gateway API 1.5.0).
- Siklus proses yang terisolasi dari internet: setiap gambar dan diagram di-reseed ke Harbor untuk
setiap upgrade; resource
EnvoyProxydan nilai diagram menyematkan registry dan pull secret. - Dua lapisan konfigurasi:
GatewayClass/Gateway/EnvoyProxymilik platform danAIGatewayRoute/AIServiceBackend/InferencePoolmilik tim; mengaktifkan model baru berarti menambahkan aturan rute dan backend, bukan gateway baru. - Pemantauan: rasio permintaan, latensi (termasuk waktu hingga token pertama), penggunaan token per model dan per konsumen, pemberian skor Endpoint Picker, dan pemakaian GPU server model.
InferenceObjectivemasih berupa API alfa (v1alpha2); perkirakan perubahan skema di antara rilis Ekstensi Inferensi.
- Keamanan dan Kepatuhan:
- Seluruh solusi beroperasi dalam perimeter keamanan yang terisolasi dari internet GDC.
- Kebijakan jaringan bersifat wajib: namespace
NetworkPolicymengizinkan traffic dari proxy ke port server model (8000, 11434) dan ke Endpoint Picker (9002), danProjectNetworkPolicymengizinkan traffic klien ke VIPLoadBalancersaat konsumen berada di luar project. - TLS dihentikan di
Gatewaydengan sertifikat yang disimpan diSecretKubernetes; klien hanya akan melihat endpoint gateway. - Kredensial upstream (misalnya, kunci API yang diperlukan oleh server model)
disimpan di
Secretyang dirujuk olehBackendSecurityPolicydan disisipkan oleh gateway, sehingga aplikasi tidak pernah menyimpan kredensial backend. - Pembatasan kapasitas berbasis token membatasi konsumsi kapasitas GPU yang mahal per konsumen atau per model.
- Akun robot Harbor dan secret penarikan image Kubernetes memastikan akses yang aman ke image container; RBAC Gateway API yang berorientasi pada peran memisahkan tanggung jawab platform dan aplikasi.
Keputusan desain
Keputusan desain utama berikut telah dibuat untuk arsitektur referensi ini:
Keputusan 1: Penerapan gateway AI: Router Agen Envoy open source di Gateway Envoy versus distribusi alternatif
| Konteks | Keputusan Penting | Alasan |
|---|---|---|
| Gateway AI adalah pilihan arsitektur utama dengan alternatif yang layak, mulai dari opsi open source yang dikelola sendiri hingga penawaran yang didukung secara komersial: (a) Envoy Agent Router di Envoy Gateway (open source), (b) kgateway dan agentgateway (implementasi Gateway API open source yang juga menangani traffic penyedia LLM, alat MCP, dan komunikasi agen-ke-agen dalam satu bidang data, dengan dukungan vendor opsional dari solo.io), (c) Solo Enterprise untuk agentgateway sebagai opsi premium yang didukung secara komersial. | Implementasi referensi menggunakan Envoy Agent Router open source di Envoy Gateway. Alternatif tetap menjadi pilihan yang valid di balik resource Gateway API yang sama; distribusi yang didukung secara komersial direkomendasikan untuk lingkungan produksi yang memerlukan dukungan vendor khusus. | Keunggulan open source: ringan dan sesuai standar, perutean L7 berperforma tinggi, tanpa biaya lisensi, ideal untuk mengevaluasi solusi sebelum berkomitmen pada penawaran berbayar; Envoy Agent Router adalah opsi yang divalidasi dalam set panduan ini. Kekurangan open source: dukungan diberikan dengan upaya terbaik oleh tim Solusi dan didorong oleh komunitas, yang mungkin tidak memuaskan lingkungan produksi inti. Keunggulan premium: perjanjian dukungan perusahaan untuk siklus proses gateway dan, sering kali, kemampuan agentic lanjutan. Kerugian premium: perjanjian dukungan atau lisensi berbayar dan hubungan vendor tambahan. |
Keputusan 2: Kubernetes Gateway API dengan Inference Extension versus Ingress atau API gateway eksklusif
| Konteks | Keputusan Penting | Alasan |
|---|---|---|
| Endpoint inferensi dapat diekspos dengan Ingress API lama, format konfigurasi khusus gateway, atau Kubernetes Gateway API. Load balancing yang mendukung model juga memerlukan cara untuk mendeskripsikan kumpulan server model dan prioritasnya. | Solusi ini menstandardisasi Kubernetes Gateway API (GatewayClass, Gateway, rute) yang diimplementasikan oleh Envoy Gateway, dan Gateway API Inference Extension (InferencePool, InferenceObjective, Endpoint Picker) untuk perutean yang mendukung model. |
Gateway API adalah standar Kubernetes yang menggantikan Ingress, berorientasi peran (tim platform versus aplikasi), dan portabel di seluruh implementasi. Ekstensi Inferensi adalah standar komunitas untuk perutean yang mendukung server model (kedalaman antrean, cache KV, prioritas) dan didukung oleh Envoy Agent Router secara langsung; distribusi gateway alternatif menerapkan API yang sama, sehingga Keputusan 1 dapat dibatalkan. |
Keputusan 3: Perutean berbasis isi pada kolom model permintaan yang kompatibel dengan OpenAI sebagai endpoint terpadu
| Konteks | Keputusan Penting | Alasan |
|---|---|---|
Aplikasi dapat menangani model melalui satu endpoint per model (berbasis host atau jalur), melalui set header kustom yang ditetapkan oleh klien, atau melalui kolom model yang sudah dibawa oleh setiap permintaan yang kompatibel dengan OpenAI. |
Gateway mengekspos satu endpoint yang kompatibel dengan OpenAI dan rute di kolom model: pemroses eksternal mengekstraknya ke header x-ai-eg-model dan aturan AIGatewayRoute cocok dengan header tersebut. |
Klien dan SDK yang kompatibel dengan OpenAI yang ada berfungsi tanpa perubahan dan mengganti model dengan mengubah satu string; endpoint, kredensial, dan penempatan model dapat berubah tanpa memengaruhi aplikasi; aturan yang sama dapat memetakan nama model ke beberapa backend untuk pemisahan traffic, penggantian, atau penggantian nama model. |
Keputusan 4: Penyemaian artefak dengan air gap ke Harbor versus penarikan on-demand
| Konteks | Keputusan Penting | Alasan |
|---|---|---|
| Penginstalan upstream menarik image container dari registry publik dan diagram Helm sebagai artefak OCI sesuai permintaan, yang tidak mungkin dilakukan di lingkungan yang terisolasi. | Semua image container (proxy Envoy, Envoy Gateway, pengontrol Envoy Agent Router dan pemroses eksternal, layanan batas kecepatan, Endpoint Picker, Redis) serta diagram Helm Envoy Gateway dan Envoy Agent Router di-seed ke dalam project Harbor dengan seed_registry.sh (crane), diagram dirender secara offline dengan helm template dari Harbor, dan resource EnvoyProxy serta nilai diagram menyematkan registry Harbor dan secret pull. |
Satu langkah pemberian nilai yang dapat diulang dan diaudit per versi; cluster tidak memerlukan konektivitas eksternal; penyematan versi membuat upgrade menjadi eksplisit dan dapat dibatalkan. |
Keputusan 5: Pembatasan frekuensi berbasis token opsional dengan Redis versus batas berbasis permintaan saja
| Konteks | Keputusan Penting | Alasan |
|---|---|---|
| Kapasitas GPU digunakan per token, bukan per permintaan; batas jumlah permintaan tidak dapat melindungi model bersama dari beberapa perintah yang sangat besar atau pembuatan yang panjang. Pembatasan kecepatan global di Envoy Gateway memerlukan penyimpanan penghitung bersama. | Pembatasan frekuensi berbasis token adalah fitur opsional dari arsitektur: pemroses eksternal mencatat input, output, dan total token per permintaan (llmRequestCosts), BackendTrafficPolicy menerapkan anggaran, dan instance Redis (Redis 8.10, di-deploy di cluster atau instance yang ada) menyimpan penghitung. Deployment tanpa pembatasan kapasitas tidak memerlukan Redis. |
Penggunaan diukur dalam unit yang mencerminkan biaya, anggaran diterapkan secara konsisten di semua replika proxy, dan dependensi hanya dibayar oleh pelanggan yang memerlukan kuota. |
Keputusan 6: Topologi: bidang kontrol dan bidang data gateway dalam namespace khusus dari cluster standar, model dalam namespace aplikasi
| Konteks | Keputusan Penting | Alasan |
|---|---|---|
| Gateway dapat berjalan di cluster khusus, di setiap namespace aplikasi, atau sekali per cluster standar di samping model yang dihadapinya. Model berat terbuka di GDC dengan air gap di-deploy di cluster standar (set panduan pendamping). | Bidang kontrol Envoy Gateway dan Envoy Agent Router serta bidang data proxy Envoy berjalan di namespace khusus cluster standar yang menghosting model; AIGatewayRoute, AIServiceBackend, InferencePool dan deployment model berada di namespace aplikasi dan dirujuk di seluruh namespace. |
Permintaan tetap berada di dalam jaringan cluster antara proxy dan model Pods (latensi terendah, tanpa load balancer tambahan), Administrator Platform memiliki namespace gateway, sementara tim aplikasi memiliki rute dan modelnya, dan Pemilih Endpoint dapat meng-scrape server model secara langsung. Gateway klien per project yang meneruskan ke gateway server pusat tetap menjadi ekstensi topologi ini untuk penggunaan multi-project. |
Asumsi dan batasan
- Lingkungan GDC dengan air gap 1.16.2-hf1 atau yang lebih baru tersedia dengan cluster standar yang menjalankan Kubernetes v1.32.13-gke.400 atau yang lebih baru.
- Tersedia resource hardware yang memadai (terutama GPU) untuk backend penayangan model; komponen gateway itu sendiri berjalan di node CPU. Model nyata memerlukan GPU; model kecil di Ollama dapat berjalan di CPU hanya untuk evaluasi fungsional.
- Instance Harbor disiapkan dan dapat diakses, serta workstation dengan akses internet dan konektivitas ke lingkungan GDC (Harbor dan Kubernetes API) tersedia untuk menyemai image dan diagram.
- Pengguna memiliki izin yang diperlukan: peran project Harbor Instance Viewer dan Standard Cluster Admin serta peran
StandardClusterRoleBindingkecluster-admindi cluster standar untuk penginstalan cakupan cluster (CRD,GatewayClass, namespace), lihat penerapan referensi. - Backend penayangan model mengekspos API yang kompatibel dengan OpenAI; backend yang dilampirkan sebagai
InferencePooljuga mengekspos metrik yang kompatibel dengan vLLM yang diandalkan oleh Pemilih Endpoint. - Batasan: dukungan untuk komponen open source (Envoy Gateway, Envoy Agent Router, Gateway API Inference Extension) diberikan secara optimal oleh tim Solusi; dukungan vendor khusus memerlukan distribusi yang didukung secara komersial (Keputusan 1).
- Batasan:
InferenceObjectiveadalah API alfa (inference.networking.x-k8s.io/v1alpha2) dan dapat berubah di antara rilis Ekstensi Inferensi. - Batasan: VIP
LoadBalanceruntukGatewaydanProjectNetworkPolicydiperlukan untuk konsumen di luar project; di dalam project, klien dalam cluster ataukubectl port-forwarddapat menjangkau gatewayServicesecara langsung. - Batasan: Gemini di GDC, penyesuaian model, model GenAI non-LLM, dan inferensi model multi-node tidak termasuk dalam cakupan solusi versi ini.
Alur pengguna
Berikut adalah alur pengguna yang komprehensif untuk gateway AI di GDC dengan air gap: pertama, jalur permintaan yang diandalkan developer aplikasi, lalu jalur penyiapan yang diikuti Administrator Platform.
1. Jalur permintaan developer
Aplikasi atau agen hanya memerlukan endpoint gateway, kredensial klien jika gateway memberlakukannya, dan nama model.
- Mengirim permintaan: Aplikasi memanggil
POST /v1/chat/completionsdi endpoint gateway dengan isi JSON yang kompatibel dengan OpenAI yang menyebutkan model (misalnya"model": "gemma"), persis seperti saat memanggil layanan yang kompatibel dengan OpenAI. - Masuk ke gateway: Permintaan mencapai VIP
LoadBalancerdariGateway; proxy Envoy menghentikan TLS dan mencocokkan pendengar dan rute. - Memproses isi: Proxy menyerahkan permintaan ke pemroses eksternal Envoy Agent Router, yang mengurai isi, mengekstrak nama model ke header
x-ai-eg-model, dan menerjemahkan payload ke skema backend jika berbeda. - Pilih backend: Aturan
AIGatewayRouteyang cocok dengan nama model memilihAIServiceBackend(misalnya, OllamaService) atauInferencePool(misalnya, set replika vLLM); untukInferencePool, Pemilih Endpoint memilih replika dengan antrean terpendek dan kecocokan KV-cache terbaik. - Teruskan dan respons: Proxy menyisipkan kredensial upstream saat
BackendSecurityPolicyberlaku, meneruskan permintaan kePodyang dipilih, mengalirkan respons kembali, dan memungkinkan pemroses eksternal mencatat penggunaan token, yang memasukkan metrik dan, jika dikonfigurasi, batas frekuensi berbasis token. - Mengganti model: Untuk menggunakan model lain, developer mengubah string
model; tidak diperlukan endpoint, kredensial, atau library klien baru.
2. Jalur penyiapan Administrator Platform
- Menyemai artefak ke Harbor: Buat akun robot Harbor, lalu salin
image container dan diagram Helm Envoy Gateway dan Envoy Agent Router ke
Harbor dengan
seed_registry.shdari workstation dengan akses internet. - Instal Envoy Gateway: Render diagram CRD dan pengontrol dari Harbor dengan
helm templatedan terapkan di namespace gateway; buat resourceEnvoyProxyyang menyematkan image proxy dan pull secret, serta verifikasi pengontrol denganGatewayClass,Gateway, danHTTPRoutedasar. - Instal Envoy Agent Router: Instal CRD Envoy Agent Router dan CRD Ekstensi Inferensi Gateway API, deploy pengontrol Envoy Agent Router, dan konfigurasi ulang Envoy Gateway untuk memanggil server ekstensinya (port 1063) dan menerima backend
InferencePool; secara opsional deploy Redis dan aktifkan layanan pembatasan kapasitas global. - Mengekspos gateway: Buat
GatewayClassdanGatewaydengan listener HTTP dan HTTPS (sertifikat TLSSecret), tunggu VIPLoadBalancer, dan terapkanProjectNetworkPolicyuntuk konsumen di luar project. - Lampirkan model: Deploy backend penayangan model dengan set panduan pendamping, lalu buat resource
AIServiceBackenduntukServiceyang kompatibel dengan OpenAI danInferencePoolserta resource Endpoint Picker untuk set replika yang kompatibel dengan vLLM, bersama dengan objekNetworkPolicynamespace. - Publikasikan rute: Buat
AIGatewayRoutedengan satu aturan per nama model (perutean berbasis isi) dan, jika diperlukan, objekBackendSecurityPolicydanBackendTrafficPolicyuntuk kredensial upstream dan anggaran token. - Validasi dan operasikan: Panggil
/v1/modelsdan/v1/chat/completionsmelalui VIP (atau penggantiankubectl port-forward), periksa proxy, pemroses eksternal dan metrik Endpoint Picker, serta berikan nama model dan endpoint kepada tim aplikasi. Menskalakan replika proxy dan deployment model secara independen; mengupgrade Envoy Gateway, Envoy Agent Router, dan Inference Extension secara bersamaan.
Langkah-langkah mendetail disediakan dalam implementasi referensi Envoy Agent Router dan panduan pengguna perutean berbasis isi dengan Envoy Agent Router.
Materi tambahan
- Implementasi referensi Router Agen Envoy
- Panduan pengguna perutean berbasis isi dengan Envoy Agent Router
- Arsitektur referensi LLM dengan bobot terbuka
- Dokumentasi Envoy Agent Router
- Envoy Gateway
- Kubernetes Gateway API
- Ekstensi Inferensi Gateway API
- Dokumentasi Google Distributed Cloud dengan air gap