


Organisasi yang beroperasi di lingkungan dengan air gap menghadapi tantangan yang signifikan: mereka memerlukan kemampuan transformatif Model Bahasa Besar (LLM), tetapi dilarang keras terhubung ke API berbasis cloud eksternal karena protokol keamanan yang ketat. Untuk menjembatani kesenjangan ini, pelanggan tersebut memerlukan ekosistem mandiri yang andal dan mampu menghosting serta mengelola model berat terbuka secara langsung di infrastruktur air-gapped Google Distributed Cloud (GDC) mereka. Deployment yang dilokalkan ini sangat penting untuk mempertahankan kedaulatan data mutlak, sehingga memastikan informasi sensitif tidak pernah keluar dari lokasi fisik. Dengan mengintegrasikan lingkungan eksekusi yang aman dengan mesin inferensi lokal, pengguna dapat memanfaatkan kemampuan AI tingkat lanjut sekaligus mempertahankan kontrol administratif penuh atas data, bobot model, dan postur keamanan internal mereka.
Meskipun Gemini di GDC menyediakan kemampuan mutakhir yang dikelola dan canggih, pelanggan sering kali men-deploy model dengan bobot terbuka seperti Gemma 4 atau Llama 4 untuk mendapatkan perincian dan kontrol yang lebih baik. Men-deploy model dengan bobot terbuka di lingkungan GDC yang terisolasi dari internet menawarkan keuntungan biaya yang signifikan dibandingkan layanan berpemilik terkelola. Dengan memiliki bobot model, organisasi dapat menghilangkan biaya API per token yang berulang, yang dapat menjadi sangat mahal untuk workload otomatis bervolume tinggi. Selain itu, model open source memungkinkan kuantisasi (misalnya, 4-bit atau 8-bit), sehingga penalaran berperforma tinggi dapat dijalankan di edge dengan jejak hardware yang lebih kecil dan lebih murah. Pengoptimalan vertikal ini, dikombinasikan dengan kemampuan untuk membagikan infrastruktur di beberapa aplikasi internal tanpa biaya lisensi tambahan, menghasilkan Total Biaya Kepemilikan (TCO) yang jauh lebih rendah untuk operasi inferensi berkelanjutan dalam skala besar.
Solusi yang diusulkan
Dokumen ini menguraikan arsitektur referensi untuk men-deploy dan mengelola Model Bahasa Besar (LLM) dengan bobot terbuka di lingkungan tertutup Google Distributed Cloud (GDC). Banyak pelanggan, terutama yang berada di sektor yang sangat teregulasi, tidak dapat menggunakan API LLM berbasis cloud karena persyaratan keamanan dan kedaulatan data yang ketat. Arsitektur ini memenuhi kebutuhan untuk menjalankan LLM yang canggih secara lokal dalam instance GDC yang aman.
Yang disertakan: Arsitektur ini mencakup deployment LLM open source (seperti Gemma, Llama, DeepSeek) menggunakan backend penayangan vLLM atau Ollama. Hal ini mencakup penggunaan Kubernetes untuk orkestrasi, Harbor untuk penyimpanan artefak, volume persisten untuk bobot model, dan kebijakan jaringan project untuk keamanan jaringan.
Yang tidak disertakan: Arsitektur ini tidak mencakup layanan AI Gateway terkelola, model eksklusif seperti Gemini dari Google, proses penyesuaian model, atau model GenAI untuk modalitas lain seperti pembuatan gambar. Fitur ini akan dibahas dalam panduan terpisah.
Audiens: Audiens utama untuk dokumen ini mencakup Administrator Platform yang bertanggung jawab untuk men-deploy dan mengelola layanan di GDC, serta arsitek teknis yang mendesain solusi AI dalam lingkungan air gap. Pengguna akhir dan developer yang akan berinteraksi dengan model yang di-deploy adalah audiens sekunder yang mendapatkan manfaat dari pemahaman struktur dasarnya.
Arsitektur referensi
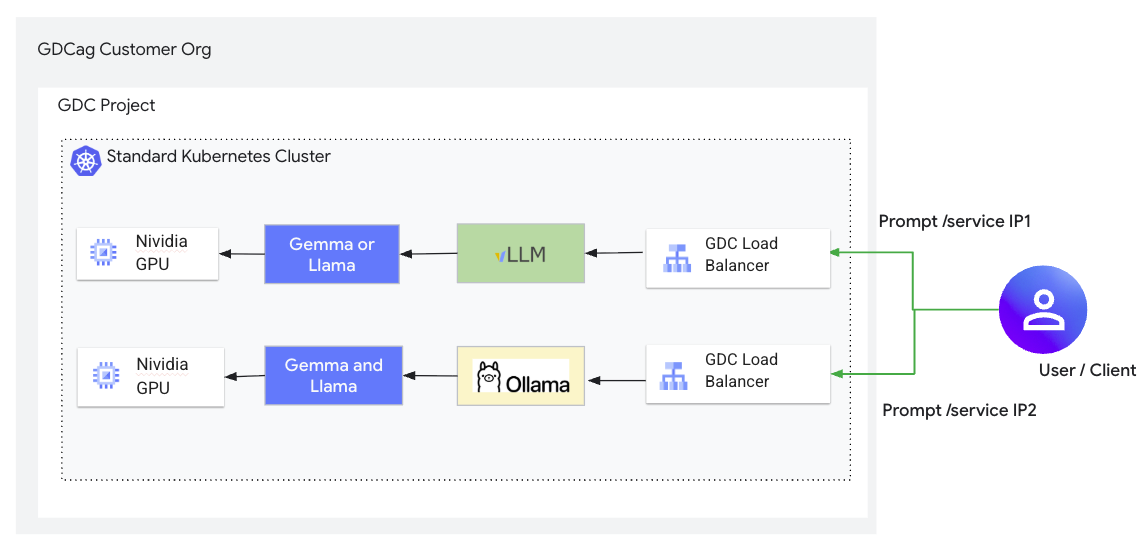
Komponen solusi
Solusi ini memanfaatkan komponen berikut:
| Komponen Solusi | Tanggung Jawab | Aliran Data | Antarmuka |
|---|---|---|---|
| Zona pelanggan GDC dengan air gap | Menghosting infrastruktur cluster, jaringan, dan penyimpanan Kubernetes | Platform Dasar | Antarmuka pengelolaan infrastruktur untuk IO. Kubernetes API untuk Admin Platform dan pengguna |
| Load Balancer | Mengekspos pod penayangan LLM (vLLM, Ollama) ke traffic dari luar cluster Kubernetes, dengan menyediakan alamat IP yang stabil. | Permintaan klien eksternal dikirim ke IP Eksternal LoadBalancer. LoadBalancer mendistribusikan permintaan di seluruh pod backend yang responsif (vLLM atau Ollama) berdasarkan pemilih Layanan | Kubernetes Service API. Menyediakan load balancer jaringan secara otomatis dalam lingkungan GDC. |
| vLLM | Penayangan inferensi LLM dengan throughput tinggi. Dioptimalkan untuk latensi rendah menggunakan teknik seperti PagedAttention. Biasanya melayani satu model per instance. | Menerima permintaan inferensi HTTP dari klien. Memuat bobot model dari PVC yang di-mount. Melakukan komputasi pada GPU yang terpasang. Menampilkan respons HTTP dengan teks yang dihasilkan. | API RESTful yang kompatibel dengan OpenAI untuk inferensi. Menerima permintaan JSON. |
| Ollama | Layanan inferensi LLM, yang dirancang agar mudah digunakan dan mengelola beberapa model dalam satu instance (meskipun hanya satu yang aktif dalam satu waktu) | Menerima permintaan inferensi HTTP. Memuat model (sering kali dibundel dalam image container atau ditarik saat pertama kali digunakan jika tidak diisolasi). Melakukan komputasi di GPU. Menampilkan respons HTTP. Model akan dibatalkan pemuatannya setelah tidak aktif selama beberapa waktu. | Ollama RESTful API Menerima permintaan JSON. Juga memiliki CLI. |
| GPU Nvidia / MIG | Menyediakan akselerasi hardware untuk inferensi LLM. | Backend LLM (vLLM, Ollama) mengalihkan komputasi model yang intensif (perkalian matriks, dll.) ke GPU untuk mempercepat inferensi. MIG memungkinkan partisi GPU tunggal digunakan oleh beberapa instance model yang lebih kecil. | Diekspos sebagai jenis resource di Kubernetes (misalnya, nvidia.com/gpu). Pod meminta resource ini |
| Harbor | Menyimpan dan mengelola image container untuk vLLM, Ollama, dan pod pembantu (seperti busybox) dengan aman | Image container dikirim dari lingkungan build (misalnya, workstation dengan akses internet) ke Harbor. Node Kubernetes menarik image ini dari Harbor untuk menjalankan container. | Docker Registry API. Node Kubernetes berinteraksi dengan Harbor untuk menarik image selama pembuatan pod. Pengguna berinteraksi dengan Docker CLI atau UI Harbor untuk mengirimkan image. |
| Persistent Volume Claims | Menyediakan penyimpanan persisten untuk bobot model LLM, yang tidak terkait dengan siklus proses pod. | File model disalin ke Persistent Volume (misalnya, menggunakan pod helper dan kubectl cp). Server vLLM membaca bobot model dari volume yang di-mount ini saat startup. Ollama biasanya menggabungkan model dalam image, sehingga PVC kurang umum untuk penyimpanan model Ollama dalam penyiapan ini. |
Kubernetes Storage API. Ditentukan dalam YAML dan dipasang ke pod sebagai volume. |
| Kebijakan Jaringan Project | Menerapkan isolasi jaringan dan mengontrol aliran traffic di level project/namespace. Memastikan hanya traffic yang sah yang dapat mencapai layanan LLM. | Traffic jaringan ke dan dari pod dalam namespace diperiksa. Aturan kebijakan menentukan apakah koneksi ke port layanan LLM (misalnya, 8000 untuk vLLM, 11434 untuk Ollama) diizinkan, biasanya berdasarkan rentang IP sumber atau label lainnya. | Kubernetes networking.gdc.goog/v1 API. Ditentukan dalam YAML. |
Fitur dan kemampuan
Arsitektur referensi ini menyediakan kemampuan inti berikut:
- Penayangan LLM Open Weight: Memungkinkan hosting dan inferensi berbagai model open weight (misalnya, Gemma, Llama, DeepSeek).
- Komponen: Backend Layanan LLM (vLLM, Ollama), Deployment/Pod Kubernetes.
- Tanggung jawab: Memuat bobot model, mengelola proses inferensi, mengeksekusi model pada akselerator hardware, dan mengekspos endpoint.
- Antarmuka: REST API (kompatibel dengan OpenAI untuk vLLM, API bawaan untuk Ollama) untuk permintaan inferensi, biasanya menggunakan JSON.
- Bawa Model Anda Sendiri (BYOM): Pengguna dapat mengimpor dan men-deploy LLM dengan bobot terbuka pilihan mereka ke lingkungan yang terisolasi.
- Komponen: Harbor, Persistent Volume Claims, Kubernetes.
- Tanggung jawab: Penyimpanan yang aman untuk image container dan bobot model. Mekanisme untuk mentransfer model ke dalam lingkungan dan membuatnya dapat diakses oleh mesin penayangan.
- Antarmuka: Docker Registry API (untuk Harbor), Kubernetes API (untuk PVC dan pemasangan volume).
- Inferensi dengan Akselerasi Hardware: Memanfaatkan GPU NVIDIA dalam cluster GDC untuk menjalankan inferensi LLM secara efisien.
- Komponen: GPU NVIDIA, Kubernetes, Plugin Perangkat.
- Tanggung jawab: Menjadwalkan pod pada node dengan resource GPU. Mengekspos hardware GPU ke container backend LLM. Mendukung Multi-Instance GPU (MIG) untuk partisi.
- Antarmuka: Kubernetes API (untuk meminta resource GPU seperti
nvidia.com/gpu).
- Akses yang Dikontrol Jaringan: Memastikan bahwa akses ke endpoint inferensi LLM dikontrol dan diisolasi dalam lingkungan GDC.
- Komponen: Layanan Kubernetes (LoadBalancer), ProjectNetworkPolicy.
- Tanggung jawab: Mengekspos layanan inferensi menggunakan IP yang stabil. Menentukan dan menerapkan aturan jaringan untuk mengizinkan atau menolak traffic ke backend LLM berdasarkan sumber, tujuan, dan port.
- Antarmuka: Kubernetes API (untuk Layanan dan ProjectNetworkPolicy).
- Penyajian Skalabel: Memungkinkan penyesuaian kapasitas berdasarkan permintaan.
- Komponen: Deployment Kubernetes.
- Tanggung jawab: Mengaktifkan penskalaan horizontal dengan meningkatkan jumlah replika untuk pod backend LLM. Penskalaan vertikal dengan menyesuaikan permintaan/batas resource.
- Antarmuka: Kubernetes API (untuk mengelola replika dan resource Deployment).
Prinsip arsitektur
- Utamakan Keamanan: Semua komponen dan data berada dalam batas GDC dengan air gap, sehingga memastikan keamanan dan kontrol data maksimum. Akses jaringan dibatasi menggunakan ProjectNetworkPolicies.
- Kedaulatan Data: Pelanggan tetap memiliki kontrol penuh atas model dan data mereka, tanpa memerlukan konektivitas eksternal untuk pengoperasian.
- Terbuka & Fleksibel: Arsitektur ini memanfaatkan backend penayangan open source (vLLM, Ollama) dan mendukung berbagai LLM dengan bobot terbuka, sehingga memberikan pilihan kepada pelanggan dan menghindari keterikatan pada vendor untuk mesin inferensi.
- Pemisahan Komponen: Fungsi utama seperti penyimpanan model (PVC), pengelolaan gambar (Harbor), dan penayangan inferensi (pod vLLM/Ollama) adalah komponen yang berbeda, sehingga memungkinkan pengelolaan dan update yang independen.
- Skalabilitas & Performa: Dirancang untuk menskalakan secara horizontal dengan meningkatkan jumlah replika pod dan secara vertikal dengan menyesuaikan sumber daya CPU/GPU untuk memenuhi permintaan performa. vLLM dipilih untuk skenario throughput tinggi dan latensi rendah.
- Pengoptimalan Resource: Mendukung Multi-Instance GPU (MIG) NVIDIA untuk memungkinkan model yang lebih kecil berbagi resource GPU secara efisien, sehingga memaksimalkan pemanfaatan hardware.
- Antarmuka Standar: Dibuat berdasarkan standar Kubernetes untuk orkestrasi, deployment, dan eksposur layanan. Endpoint inferensi menyediakan REST API, dengan vLLM menawarkan kompatibilitas OpenAI.
- Ketahanan: Memanfaatkan pemeriksaan kondisi dan replikasi Kubernetes untuk memastikan ketersediaan layanan.
Pertimbangan
- Skalabilitas dan Performa:
- Penskalaan horizontal dilakukan dengan meningkatkan jumlah replika di Deployment Kubernetes untuk vLLM dan Ollama.
- Penskalaan vertikal melibatkan alokasi CPU/memori yang lebih besar dan slice GPU yang lebih besar, hingga GPU penuh.
- vLLM menyajikan satu model per instance, sehingga memerlukan Deployment baru untuk model tambahan. Ollama dapat mengelola beberapa model, tetapi hanya menjalankan satu model dalam satu waktu.
- Ukuran PVC sangat memengaruhi waktu pemuatan model; 500 GiB+ direkomendasikan untuk IOPS tinggi.
- Pengelolaan Resource:
- Perencanaan resource GPU yang cermat sangat penting. MIG NVIDIA dapat digunakan untuk mempartisi GPU untuk model yang lebih kecil, sehingga meningkatkan pemanfaatan.
- CPU dan memori yang memadai harus dialokasikan untuk menangani inferensi dan overhead pengelolaan model.
- Penyimpanan yang cukup harus disediakan untuk PVC agar dapat mengakomodasi ukuran model dan memastikan performa.
- Ketersediaan dan Keandalan:
- Deployment Kubernetes menyediakan kemampuan pemulihan mandiri dan update berkelanjutan.
- Layanan LoadBalancer mendistribusikan traffic di seluruh pod yang responsif, sehingga menyembunyikan kegagalan pod individual.
- Menyimpan bobot model di PVC memastikan persistensi di seluruh proses mulai ulang pod.
- Kompleksitas Operasional:
- Mengelola image container untuk berbagai backend dan versi di Harbor.
- Prosedur untuk mentransfer bobot model secara aman ke lingkungan yang terisolasi dari internet.
- Membuat dan mengelola manifes Kubernetes (Deployment, Layanan, PVC, Kebijakan Jaringan) untuk setiap model dan backend.
- Memantau penggunaan GPU, latensi inferensi, dan tingkat error.
- Keamanan dan Kepatuhan:
- Seluruh solusi beroperasi dalam perimeter keamanan yang terisolasi dari internet GDC.
- ProjectNetworkPolicy wajib diterapkan untuk memberlakukan isolasi jaringan yang ketat dan mengontrol akses ke endpoint LLM.
- Akun robot Harbor dan secret penarikan image Kubernetes memastikan akses yang aman ke image container.
- Data dalam pengiriman dapat dilindungi oleh kebijakan jaringan Kubernetes dan enkripsi tingkat platform. Data dalam penyimpanan di PVC mengandalkan enkripsi penyimpanan GDC.
Keputusan desain
Keputusan desain utama berikut telah dibuat untuk arsitektur referensi ini:
Keputusan 1: Menawarkan vLLM dan Ollama versus hanya menawarkan satu model inferensi
| Konteks | Keputusan Penting | Alasan |
|---|---|---|
| Hanya tawarkan salah satu dari dua pilihan untuk lapisan inferensi: VLLM dan Ollama atau tawarkan keduanya. | Kami memutuskan untuk menawarkan keduanya karena pengguna dan kasus penggunaan yang berbeda memiliki berbagai persyaratan untuk performa, kompatibilitas API, dan kemudahan pengelolaan model. | vLLM menyediakan penayangan dengan throughput tinggi dan latensi rendah serta kompatibilitas API OpenAI, yang cocok untuk aplikasi produksi. Ollama menawarkan penyiapan yang lebih sederhana, pengelolaan beberapa model yang lebih mudah, dan antarmuka yang mudah digunakan, sehingga lebih baik untuk pengembangan dan eksperimen. Mendukung keduanya memberikan fleksibilitas. |
Keputusan 2: Memanfaatkan penyimpanan persisten versus penyimpanan objek untuk penyimpanan model vLLM
| Konteks | Keputusan Penting | Alasan |
|---|---|---|
| vLLM memerlukan bobot model agar ada di sistem file saat runtime. Dalam lingkungan yang terisolasi dari internet, model tidak dapat didownload sesuai permintaan. | Menggunakan Persistent Volume Claims memastikan ketersediaan model dan meningkatkan waktu mulai setelah pemuatan awal, tetapi memerlukan langkah awal untuk mengisi PVC, yang biasanya melibatkan pod helper | Persistent Volume Claims menyediakan lapisan penyimpanan yang tangguh dan persisten untuk file model besar, yang terpisah dari siklus proses pod vLLM. Hal ini memungkinkan model dimuat dengan cepat saat pod dimulai. |
Keputusan 3: Menggabungkan model dalam image Docker Ollama versus image mandiri
| Konteks | Keputusan Penting | Alasan |
|---|---|---|
| Ollama dapat mendownload model, tetapi hal ini memerlukan akses internet, yang tidak tersedia di lingkungan yang terisolasi | Keputusan dibuat untuk menggabungkan gambar agar menyederhanakan operasi runtime di lingkungan yang terisolasi karena tidak ada panggilan eksternal yang diperlukan. Namun, untuk mengupdate atau menambahkan model, image Docker harus dibangun ulang dan didorong ulang ke Harbor. | Membangun image Docker dengan model yang telah didownload sebelumnya memastikan Ollama dimulai dengan model yang diperlukan tersedia secara offline. |
Keputusan 4: Mengekspos vLLM dan Ollama dengan layanan LoadBalancer versus tanpa load balancer
| Konteks | Keputusan Penting | Alasan |
|---|---|---|
| LLM API harus dapat diakses oleh aplikasi dalam lingkungan GDC. | Keputusan dibuat untuk mengekspos layanan menggunakan load balancer karena ini adalah pendekatan Kubernetes Standar untuk eksposur layanan, tetapi pendekatan ini bergantung pada penyediaan LoadBalancer platform GDC. | Layanan Kubernetes jenis LoadBalancer menyediakan metode standar dan andal untuk mengekspos backend LLM, menyediakan alamat IP yang stabil, dan mendistribusikan beban. |
Keputusan 5: Menerapkan ProjectNetworkPolicy wajib
| Konteks | Keputusan Penting | Alasan |
|---|---|---|
| Keamanan dan isolasi sangat penting dalam deployment GDC dengan air gap. | ProjectNetworkPolicy diputuskan untuk diterapkan karena Meningkatkan postur keamanan layanan LLM yang di-deploy secara signifikan meskipun Memerlukan definisi kebijakan jaringan yang cermat | ProjectNetworkPolicies menyediakan cara native Kubernetes untuk menerapkan isolasi jaringan di tingkat namespace, sehingga hanya traffic yang diizinkan yang dapat mencapai layanan LLM. |
Asumsi dan batasan
- Lingkungan GDC dengan air gap 1.15.1+ tersedia
- Sumber daya hardware yang memadai (terutama GPU) ada di cluster standar.
- Instance Harbor disiapkan dan dapat diakses.
- Pengguna memiliki izin yang diperlukan (Admin Namespace, Developer Cluster).
- Model kompatibel dengan backend penayangan yang dipilih (vLLM/Ollama).
Alur pengguna (langkah-langkah dari awal hingga akhir)
Berikut adalah alur pengguna yang komprehensif untuk men-deploy Model Bahasa Besar (LLM) dengan bobot terbuka di lingkungan air-gapped Google Distributed Cloud (GDC). Alur dibagi menjadi penyiapan umum, dua jalur deployment (vLLM dan Ollama), dan validasi akhir.
1. Penyiapan umum: Pengelolaan gambar
Sebelum men-deploy LLM apa pun, Anda harus mengonfigurasi cara lingkungan GDC mengambil image container dari registry Harbor pribadi Anda.
- Buat Akun Robot Harbor: Buat akun robot di UI Harbor dan berikan izin "pull" untuk akun tersebut.
- Mengautentikasi Docker: Gunakan kredensial akun robot untuk login ke Harbor dari mesin dengan akses jaringan.
- Buat Secret Kubernetes: Buat secret docker-registry di namespace project GDC Anda menggunakan
kubectluntuk menyimpan kredensial Harbor ini agar dapat digunakan oleh cluster.
2. Jalur deployment A: vLLM (throughput tinggi)
Jalur ini direkomendasikan untuk menyajikan model yang berorientasi pada performa seperti Gemma-3.
- Dapatkan Image: Tarik image Docker vLLM dari internet, beri tag untuk registry Harbor lokal Anda, dan kirim ke Harbor.
- Siapkan Penyimpanan Model:
- Buat Klaim Volume Persisten (PVC) 500 GiB untuk menyimpan bobot model.
- Download bobot dari Hugging Face di komputer yang terhubung ke internet.
- Gunakan "pod pembantu" sementara dan
kubectl cpuntuk mentransfer bobot ini ke dalam PVC dalam lingkungan GDC.
- Deploy Backend: Terapkan manifes Deployment Kubernetes yang mereferensikan image vLLM dan memasang PVC bobot model.
- Mengekspos Layanan: Buat layanan
LoadBalanceruntuk menyediakan IP eksternal untuk vLLM API. - Jaringan Aman: Terapkan
ProjectNetworkPolicyuntuk mengizinkan traffic masuk di port layanan (biasanya 8000).
3. Jalur deployment B: Ollama (kemudahan penggunaan)
Jalur ini berfokus pada penyiapan yang disederhanakan di mana bobot model dibundel atau dimuat sebelumnya ke dalam gambar.
- Bangun Image Kustom: Buat Dockerfile yang menginstal Ollama dan menggunakan perintah
RUNuntuk "melakukan pra-penarikan" model tertentu (misalnya,gemma3) ke dalam lapisan image. - Kirim ke Harbor: Bangun image secara lokal dan kirimkan ke registry Harbor pribadi Anda.
- Deploy & Ekspos: Buat Deployment Ollama dan layanan
LoadBalancer. - Jaringan Aman: Terapkan
ProjectNetworkPolicyuntuk port Ollama (11434).
4. Validasi dan pengujian
Setelah di-deploy, langkah terakhir adalah memverifikasi bahwa layanan berfungsi.
- Periksa Status: Pastikan pod "Berjalan" dan layanan telah diberi alamat IP eksternal.
- Inferensi Pengujian:
- vLLM: Kirim permintaan
curlke alamat IPLoadBalancervLLM menggunakan endpoint/v1/chat/completionsyang kompatibel dengan OpenAI. - Ollama: Kirim permintaan
curlke alamat IPLoadBalancerOllama untuk endpoint/v1/completions.
- vLLM: Kirim permintaan
5. Operasi dan penskalaan
- Penskalaan Vertikal: Tingkatkan slice GPU atau beralih ke konfigurasi multi-GPU untuk model yang lebih besar.
- Penskalaan Horizontal: Tingkatkan jumlah replika dalam deployment untuk menangani lebih banyak permintaan pengguna serentak.
- Pemecahan masalah: Pantau log menggunakan
kubectl logsdan periksa masalah umum seperti kegagalan pengujian mandiri FIPS atau batasan kebijakan jaringan.