


Description du problème
Les organisations qui exécutent des grands modèles de langage (LLM) dans des environnements isolés accumulent rapidement des points de terminaison de modèle : chaque modèle à poids ouvert diffusé sur Google Distributed Cloud (GDC) isolé (consultez l'ensemble de guides associé "Définir des modèles à poids ouvert sur GDC isolé") expose son propre Service Kubernetes, sa propre adresse, ses propres identifiants et son propre cycle de vie opérationnel.
Les développeurs d'applications et d'agents se retrouvent dans des silos architecturaux, codant en dur un point de terminaison par modèle et réécrivant les intégrations à chaque itération du modèle. Cette fragmentation crée une dette technique et ralentit le déploiement des charges de travail agentiques critiques en plusieurs étapes.
Les couches réseau standards sont également "aveugles à l'IA" : un équilibreur de charge conventionnel traite le trafic d'inférence comme du trafic HTTP générique et ne peut pas lire le champ model d'une requête, hiérarchiser les charges de travail sensibles à la latence, tenir compte des jetons au lieu des requêtes ni orienter une requête vers la réplique du serveur de modèle qui détient déjà le cache KV pertinent. Dans les clusters de GPU isolés et coûteux, cela entraîne une sous-utilisation du matériel et un mauvais retour sur investissement. Alors que Gemini sur GDC fournit des modèles frontier gérés, les clients qui les combinent avec des modèles open weight auto-hébergés ont besoin d'une couche d'inférence qui offre une agilité semblable à celle du cloud sans compromettre la souveraineté des données : aucune requête, aucun prompt ni aucun poids de modèle ne peuvent quitter la limite GDC.
Solution proposée
Ce document décrit l'architecture de référence pour une passerelle d'IA autogérée sur GDC sous air gap : une couche d'inférence sécurisée et centralisée qui fournit aux applications un point de terminaison compatible avec OpenAI pour tous les modèles et achemine chaque requête vers le backend approprié. L'implémentation de référence s'appuie sur l'API Kubernetes Gateway : Envoy Gateway est l'implémentation de l'API Gateway (plan de contrôle et plan de données du proxy Envoy), et Envoy Agent Router (anciennement Envoy AI Gateway) l'étend avec le traitement des requêtes spécifiques à l'IA : extraction du modèle du corps de la requête, traduction des requêtes et des réponses, authentification en amont, comptabilisation des jetons et, éventuellement, limitation du débit basée sur les jetons. L'extension d'inférence de l'API Gateway ajoute une sélection de points de terminaison compatibles avec les serveurs de modèles (InferencePool et sélecteur de points de terminaison) afin que la capacité du GPU soit utilisée efficacement. Tous les artefacts sont mis en scène dans le registre Harbor de l'organisation GDC, et l'ensemble de la pile s'exécute dans un cluster standard sans connectivité externe.
Contenu : cette architecture couvre le déploiement d'Envoy Gateway et d'Envoy Agent Router dans un cluster standard, les ressources de l'API Gateway (GatewayClass, Gateway) et les ressources d'Envoy Agent Router (AIGatewayRoute, AIServiceBackend, BackendSecurityPolicy, GatewayConfig) qui exposent un point de terminaison unifié compatible avec OpenAI, le routage basé sur le corps du champ model, l'extension d'inférence de l'API Gateway (InferencePool, InferenceObjective, sélecteur de point de terminaison) pour l'équilibrage de charge tenant compte du modèle, la limitation du débit basée sur les jetons avec Redis (facultatif), la terminaison TLS au niveau de la passerelle, les règles réseau (NetworkPolicy/ProjectNetworkPolicy) et la gestion des artefacts sous air gap dans Harbor. Les backends de diffusion de modèles derrière la passerelle (Ollama, vLLM) sont déployés avec le guide associé "Open Weight Models on GDC" (Modèles Open Weight sur GDC) en mode air-gapped.
Ce qui n'est pas inclus : cette architecture ne couvre pas un produit de passerelle d'IA gérée, le déploiement et l'ajustement des modèles eux-mêmes (ensemble de guides associés), le réglage fin des modèles, les modalités d'IA générative non LLM, le trafic agent-outil (MCPRoute) ni les distributions de passerelle compatibles commercialement. Gemini sur GDC est une fonctionnalité de produit gérée. Son provisionnement est hors champ d'application. Cette version de l'ensemble de guides valide la passerelle avec des modèles open source auto-hébergés.
Audience : ce document s'adresse principalement aux administrateurs de plate-forme chargés de déployer et d'exploiter la passerelle dans un cluster standard, ainsi qu'aux architectes techniques qui conçoivent des plates-formes d'IA dans l'environnement isolé. Les développeurs d'applications qui utilisent le point de terminaison unifié constituent une audience secondaire. Il est important qu'ils comprennent comment leurs requêtes sont acheminées.
Architecture
La solution s'exécute entièrement dans un cluster standard de l'organisation GDC sous air gap. Dans la couche Services, la norme Kubernetes Gateway API standardise le modèle de configuration. Le plan de contrôle de la passerelle d'IA (le contrôleur Envoy Gateway et le contrôleur Envoy Agent Router) lit les ressources Gateway API et Envoy Agent Router, et configure le plan de données : un proxy Envoy Deployment qui est le point d'entrée des requêtes (exposé via un Service de type LoadBalancer) et le processeur externe Envoy Agent Router qui s'exécute en tant que side-car dans le proxy Pod et exécute la logique spécifique à l'IA. Dans la couche Application, les charges de travail client (applications et agents) envoient une requête d'IA au proxy (1). Le proxy transmet la requête au processeur externe, qui extrait le nom du modèle, traduit la requête et enregistre l'utilisation des jetons (2). Le proxy transfère le trafic équilibré aux Pod d'inférence du modèle sélectionné (3), et le modèle s'exécute sur les nœuds GPU de la couche Infrastructure (4). Les backends de mise en service du modèle sont associés à la passerelle en tant que AIServiceBackend (tout Service compatible avec OpenAI) ou en tant que InferencePool dont le sélecteur de points de terminaison sélectionne la meilleure instance répliquée par requête. Les images de conteneurs et les charts Helm sont extraits de Harbor.
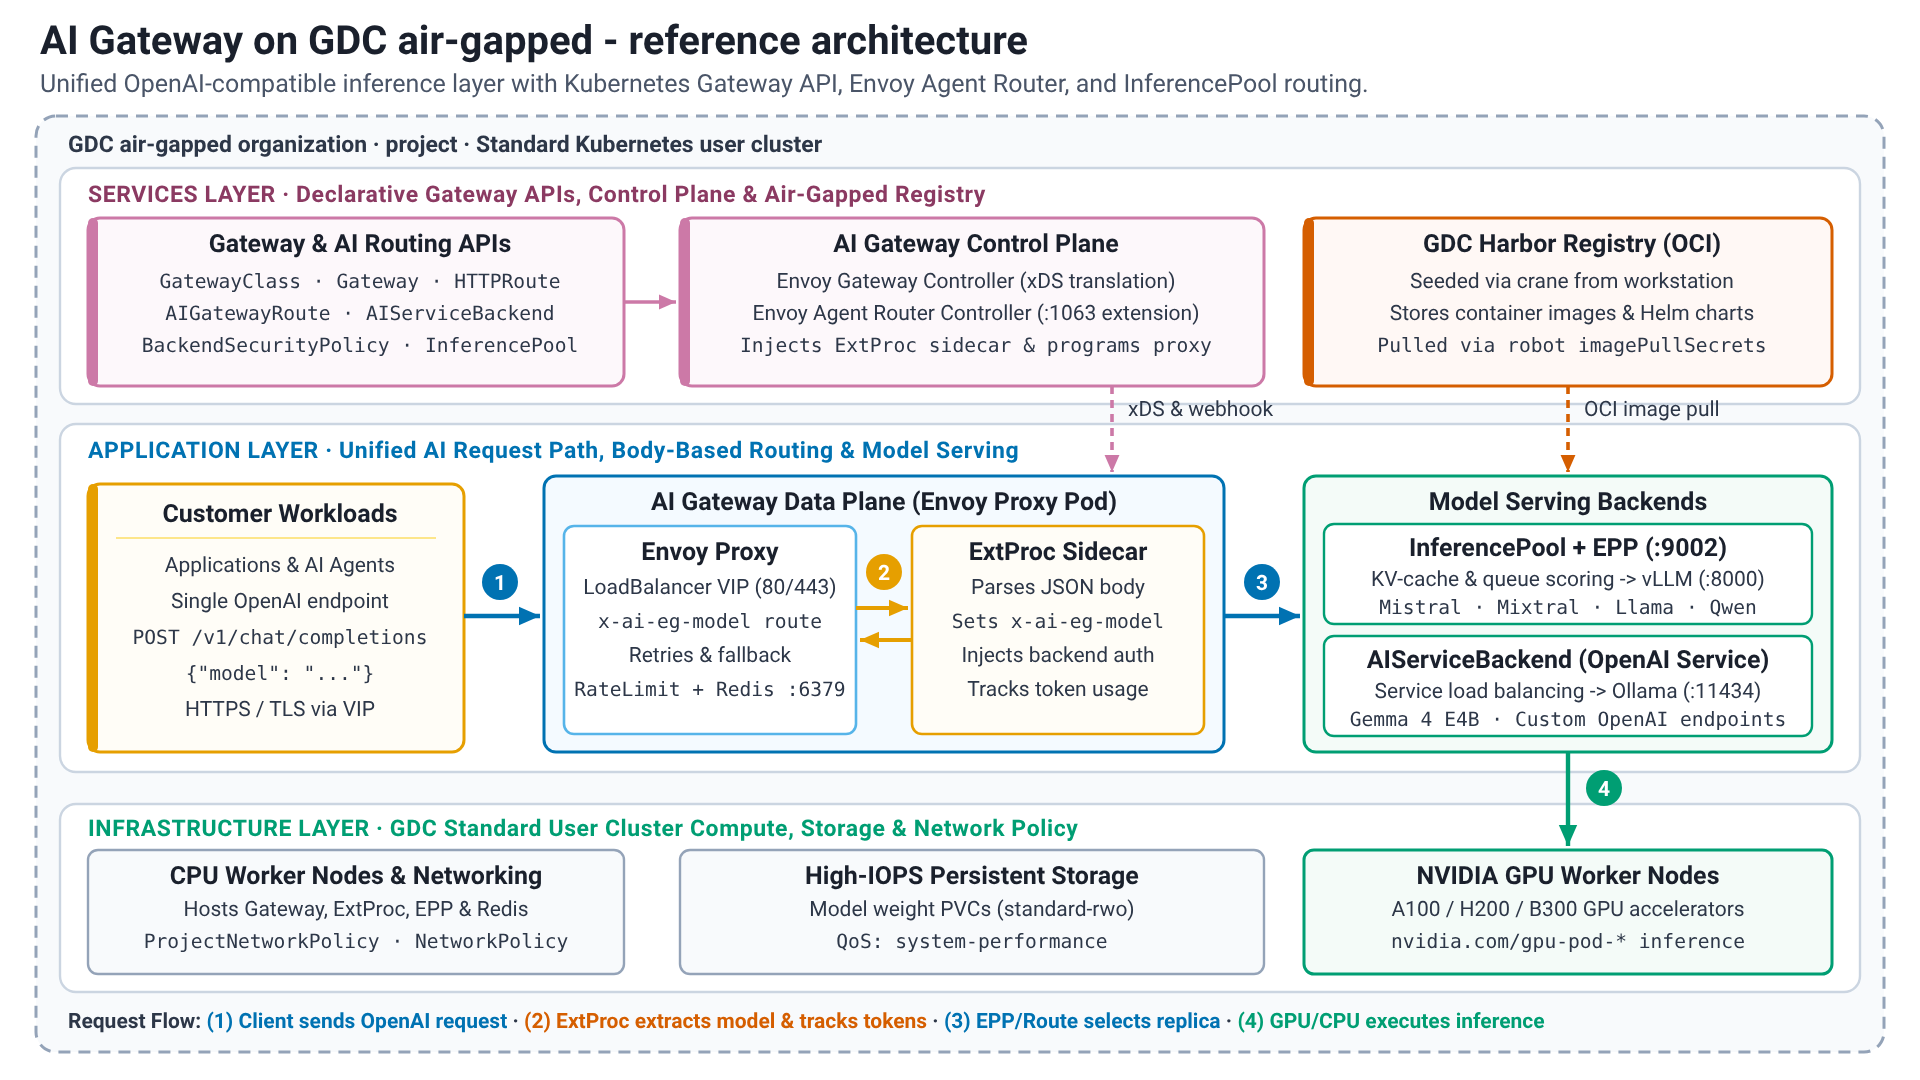
Composants de la solution
La solution utilise les composants suivants :
| Composant de la solution | Responsabilités | Flux de données | Interfaces |
|---|---|---|---|
| API Kubernetes Gateway | Modèle de ressources standard axé sur les rôles pour l'entrée et le routage : GatewayClass (propriété de la plate-forme), Gateway (écouteurs, TLS) et ressources de route (propriété des équipes d'application). Successeur de l'API Ingress sans annotations spécifiques au fournisseur. |
Configuration déclarative uniquement : les ressources sont surveillées par les contrôleurs et ne génèrent aucun trafic de requête. | API Kubernetes (gateway.networking.k8s.io/v1) : les CRD sont installées à partir du graphique Envoy Gateway CRD. |
| Contrôleur Envoy Gateway (plan de contrôle) | Implémente l'API Gateway : provisionne un proxy Envoy Deployment et LoadBalancer Service par Gateway, traduit les routes et les règles (BackendTrafficPolicy, SecurityPolicy, EnvoyExtensionPolicy, Backend, EnvoyProxy) en configuration xDS, exécute le service de limitation du débit global lorsqu'il est configuré et appelle le serveur d'extension Envoy Agent Router via son gestionnaire d'extensions afin que les backends InferencePool soient ajoutés à la traduction. |
Surveille l'API Kubernetes et envoie la configuration xDS aux proxys. Aucun trafic de requête. | API Kubernetes (watch), xDS gRPC vers les proxys, gRPC vers le serveur d'extension (port 1063). |
| Contrôleur (plan de contrôle) du routeur Envoy Agent | Réconcilie les ressources aigateway.envoyproxy.io/v1beta1, AIGatewayRoute (règles de routage sur le nom du modèle extrait), AIServiceBackend (backend avec son schéma de l'API), BackendSecurityPolicy (identifiants en amont) et GatewayConfig (paramètres du processeur externe par Gateway) dans les ressources Envoy Gateway, injecte le side-car du processeur externe dans les Pod du proxy Envoy et diffuse le serveur d'extension utilisé par Envoy Gateway. |
Configuration uniquement. | API Kubernetes, serveur d'extension gRPC (port 1063), webhook d'admission de mutation pour l'injection de side-car. |
| Proxy Envoy (plan de données) | Point d'entrée des requêtes : met fin à TLS, fait correspondre les écouteurs et les routes, équilibre la charge entre les points de terminaison de backend, applique les limites de débit et les délais d'attente, effectue des nouvelles tentatives et revient à d'autres backends, et émet des journaux d'accès et des métriques. | Reçoit les requêtes client sur l'adresse IP virtuelle LoadBalancer (80/443), consulte le processeur externe pour chaque requête d'IA, transfère la requête au point de terminaison de backend sélectionné (un Service ou le Pod choisi par le sélecteur de points de terminaison) et renvoie la réponse au client. |
HTTP/HTTPS vers les clients (API compatible avec OpenAI), ext_proc gRPC vers le side-car et le sélecteur de points de terminaison, HTTP vers les backends, gRPC vers le service de limitation du débit. |
| Processeur externe (ExtProc) du routeur Envoy Agent | Analyse le corps de la requête compatible avec OpenAI, extrait le champ model dans l'en-tête de routage x-ai-eg-model, applique les remplacements de nom de modèle, traduit les charges utiles de requête et de réponse entre le schéma de l'API client et le schéma de l'API backend, injecte les identifiants en amont définis par BackendSecurityPolicy et extrait l'utilisation des jetons (entrée, sortie, total) de la réponse dans les métadonnées dynamiques utilisées pour la limitation du débit et les métriques basées sur les jetons. |
Conteneur side-car dans le proxy Envoy Pod : traite les corps de requête et de réponse, y compris les réponses diffusées. |
Point de terminaison gRPC ext_proc Envoy ; point de terminaison des métriques Prometheus. |
| Extension d'inférence de l'API Gateway (InferencePool + sélecteur de points de terminaison) | InferencePool (inference.networking.k8s.io/v1) regroupe les Pod d'un déploiement de serveur de modèle (sélecteur de libellés, port cible, par exemple 8000) et référence son sélecteur de points de terminaison (EPP). InferenceObjective (v1alpha2) attribue une priorité par modèle ou objectif. L'EPP récupère les métriques du serveur de modèle (profondeur de la file d'attente des requêtes, utilisation du cache KV, adaptateurs LoRA chargés) et sélectionne le point de terminaison pour chaque requête. |
Le proxy appelle l'EPP (ext_proc, port 9002) avec les en-têtes de requête. L'EPP répond avec le point de terminaison à utiliser. Le proxy transmet la requête à ce Pod. |
API Kubernetes (CRD), gRPC ext_proc (9002), scraping Prometheus des serveurs de modèles. |
| Redis (facultatif) | Stockage de sauvegarde du service de limitation du débit Envoy : compteurs partagés pour les limites basées sur les requêtes et les jetons sur toutes les répliques de proxy. N'est nécessaire que lorsque la limitation du débit global est configurée. | Le service de limitation du débit lit et incrémente les compteurs sur le port 6379 pour chaque requête limitée. | Protocole Redis (6379). Redis 8.10 déployé dans le cluster ou une instance Redis existante. |
| Backends de mise en service du modèle (Ollama / vLLM) | Diffuser les modèles à pondération ouverte derrière la passerelle, déployés avec le guide associé "Définir des modèles à pondération ouverte sur GDC air-gapped". Attaché en tant que AIServiceBackend (tout Service compatible avec OpenAI, par exemple Ollama) ou en tant que InferencePool (serveurs de modèles tels que vLLM qui exposent les métriques sur lesquelles le sélecteur de points de terminaison s'appuie). |
Recevez les requêtes routées depuis le proxy, exécutez l'inférence sur les nœuds GPU (ou sur le CPU pour l'évaluation fonctionnelle avec de petits modèles) et renvoyez la réponse compatible avec OpenAI. | API REST compatible avec OpenAI : vLLM sur le port 8000, Ollama sur le port 11434 ; métriques Prometheus (vLLM) pour le sélecteur de points de terminaison. |
| Harbor | Stocke les images de conteneur (proxy Envoy, Envoy Gateway, contrôleur Envoy Agent Router et processeur externe, service de limitation du débit, sélecteur de points de terminaison, Redis) et les charts Helm (artefacts OCI) de la solution. | Les artefacts sont copiés des registres publics vers Harbor avec seed_registry.sh (crane) à partir d'une station de travail avec accès à Internet. Le cluster extrait les images avec un compte robot via des secrets d'extraction d'image, et les graphiques sont rendus à partir de Harbor avec helm template. |
API OCI Distribution ; interface utilisateur Harbor et comptes robot |
| Cluster Standard et nœuds GPU | Héberge tous les composants de la passerelle (les nœuds de processeur sont suffisants) et les Pod d'inférence (nœuds GPU avec les ressources d'accélérateur découvertes à partir des nœuds). Fournit des adresses IP virtuelles LoadBalancer, un stockage persistant pour les pondérations de modèle et l'application des règles réseau. |
Plate-forme de base : les requêtes entrent par l'adresse IP virtuelle LoadBalancer de Gateway et restent dans le réseau du cluster. |
API Kubernetes, API réseau GDC (networking.gdc.goog/v1 ProjectNetworkPolicy), console GDC et gdcloud pour l'administrateur de plate-forme. |
Fonctionnalités et capacités
Cette architecture de référence offre les fonctionnalités de base suivantes :
- Point de terminaison unifié compatible avec OpenAI : les applications appellent une adresse (
/v1/chat/completions,/v1/models, etc.) pour chaque modèle diffusé derrière la passerelle.- Composants :
Gateway,AIGatewayRoute, proxy Envoy, processeur externe. - Responsabilités : exposer une adresse IP virtuelle stable, mettre fin à TLS, accepter le format de requête compatible avec OpenAI et le traduire dans le schéma de backend si nécessaire.
- Interfaces : HTTPS REST (JSON, y compris les événements envoyés par le serveur pour le streaming).
- Composants :
- Routage basé sur le corps (tenant compte du modèle) : la passerelle lit le champ
modeldu corps de la requête et achemine la requête vers le backend correspondant sans aucune logique de point de terminaison côté client.- Composants : processeur externe, correspondance des règles
AIGatewayRoutesurx-ai-eg-model,AIServiceBackend,InferencePool. - Responsabilités : extraire le nom du modèle, faire correspondre les règles de routage, renommer les modèles (
modelNameOverride), répartir le trafic par pondération et revenir à d'autres backends par priorité. - Interfaces : API Kubernetes (
aigateway.envoyproxy.io/v1beta1).
- Composants : processeur externe, correspondance des règles
- Équilibrage de charge tenant compte du serveur de modèle : les requêtes adressées à un
InferencePoolsont envoyées à la réplique ayant la file d'attente la plus courte et le cache KV le plus utile au lieu d&#round robin (à tour de rôle);être distribuées de manière séquentielle.- Composants : extension Gateway API Inference (
InferencePool,InferenceObjective, sélecteur de points de terminaison). - Responsabilités : récupération des métriques du serveur de modèle, scoring des points de terminaison (profondeur de la file d'attente, utilisation du cache KV, affinité du cache de préfixes, adaptateurs LoRA), respect des priorités par objectif sous charge.
- Interfaces : API Kubernetes (
inference.networking.k8s.io/v1,inference.networking.x-k8s.io/v1alpha2), ext_proc gRPC (9002).
- Composants : extension Gateway API Inference (
- Authentification en amont et règles de sécurité : les identifiants des backends qui en ont besoin sont injectés par la passerelle et ne sont jamais distribués aux applications.
- Composants :
BackendSecurityPolicy, Envoy GatewaySecurityPolicy, écouteurs TLS. - Responsabilités : injecter des clés API dans les backends, mettre fin au protocole TLS du client au niveau de
Gateway, appliquer les règles d'authentification et d'autorisation du client si nécessaire. - Interfaces :
SecretKubernetes référencés par les règles.
- Composants :
- Limitation du débit basée sur les jetons (facultatif) : l'utilisation est mesurée en jetons, et pas seulement en requêtes.
- Composants : processeur externe (
llmRequestCosts), Envoy GatewayBackendTrafficPolicy(limite de débit globale), service de limite de débit, Redis. - Responsabilités : extraire les jetons d'entrée, de sortie et totaux de chaque réponse, les joindre en tant que coûts de requête, appliquer des budgets par consommateur ou par modèle sur toutes les répliques de proxy.
- Interfaces : API Kubernetes, Redis (6379).
- Composants : processeur externe (
- Gestion du trafic : les fonctionnalités standards de l'API Gateway s'appliquent au trafic d'IA.
- Composants :
Gateway,HTTPRoute,AIGatewayRoute,BackendTrafficPolicy. - Responsabilités : correspondance basée sur l'hôte, le chemin d'accès et l'en-tête, délais d'attente adaptés aux générations longues, nouvelles tentatives, répartition du trafic pondérée et bascule basée sur la priorité entre les backends.
- Interfaces : API Kubernetes.
- Composants :
- Observabilité : les métriques sur les requêtes, la latence et les jetons sont disponibles pour chaque modèle.
- Composants : journaux d'accès et statistiques du proxy Envoy, métriques du processeur externe (utilisation de jetons, durée des requêtes, temps écoulé avant le premier jeton), métriques du sélecteur de points de terminaison.
- Responsabilités : exposer les métriques au format Prometheus et les journaux d'accès structurés que la pile d'observabilité GDC ou un Prometheus géré par le client peuvent extraire.
- Interfaces : points de terminaison des métriques Prometheus, journaux de sortie standard.
- Gestion des artefacts en mode air-gap : chaque image et graphique est mis en scène dans Harbor avant l'installation.
- Composants : Harbor,
seed_registry.sh, comptes de robot, secrets d'extraction d'image, ressourceEnvoyProxy(image proxy et secret d'extraction). - Responsabilités : amorcer des images et des charts Helm OCI à partir d'une station de travail connectée, épingler des versions, afficher des charts hors connexion avec
helm template. - Interfaces : API OCI Distribution, API Kubernetes.
- Composants : Harbor,
Principes architecturaux
- Priorité aux normes : la passerelle est configurée via l'API Kubernetes Gateway et son extension d'inférence. Elle communique avec les applications à l'aide de l'API compatible avec OpenAI. Les applications, les routes et les backends restent donc portables sur les différentes implémentations de passerelle.
- La sécurité avant tout : tous les composants et toutes les données résident dans la limite du GDC sous air gap. Le protocole TLS se termine au niveau de
Gateway, les identifiants de backend sont injectés par la passerelle et l'accès au réseau est limité avec les objetsNetworkPolicyetProjectNetworkPolicy. - Souveraineté des données : les requêtes, les réponses, les pondérations des modèles et les données d'utilisation ne quittent jamais l'organisation GDC du client. Aucune connectivité externe n'est requise pour le fonctionnement.
- Séparation des préoccupations : l'API Gateway orientée rôle permet à l'administrateur de la plate-forme de posséder les règles
GatewayClass,Gateway, TLS et réseau, tandis que les équipes d'application possèdent leurs ressourcesAIGatewayRoute,AIServiceBackendetInferencePooldans leurs propres espaces de noms. - Plan de contrôle et plan de données découplés : les contrôleurs ne font que traduire la configuration. Le chemin de requête se compose du proxy Envoy, de son side-car de processeur externe et du sélecteur de points de terminaison, qui continuent de diffuser le trafic si un contrôleur redémarre.
- Ouvert et flexible : l'architecture utilise des logiciels Open Source (Envoy Gateway, Envoy Agent Router, extension d'inférence de l'API Gateway, Ollama, vLLM). Les mêmes ressources de l'API Gateway peuvent être fournies par d'autres implémentations.
- Évolutivité et performances : le plan de données évolue horizontalement en ajoutant des répliques de proxy et verticalement en ajustant le processeur et la mémoire. L'équilibrage de charge compatible avec le serveur de modèles permet de saturer les GPU sans surcharger les répliques individuelles.
- Expérience utilisateur final simplifiée : un point de terminaison, un format d'API et un identifiant pour chaque modèle raccourcissent le chemin entre le déploiement et la consommation du modèle.
- Résilience : les vérifications de l'état et la réplication Kubernetes, les nouvelles tentatives Envoy et le basculement basé sur la priorité entre les backends permettent de maintenir le point de terminaison disponible en cas d'échec de réplicas de modèles individuels.
Remarques
- Évolutivité et performances :
- Les composants de passerelle sont des charges de travail de processeur uniquement. Le proxy Envoy
Deploymentd'unGatewayévolue horizontalement en augmentant son nombre de répliques (ressourceEnvoyProxy) et verticalement en augmentant les demandes de processeur et de mémoire. L'inspection du corps par le processeur externe coûte du CPU proportionnellement à la taille de la requête et de la réponse. Les réponses diffusées en continu sont traitées de manière incrémentielle. - L'équilibrage de charge compatible avec les serveurs de modèles ne s'applique qu'aux backends associés en tant que
InferencePool. Les backends associés en tant queAIServiceBackendsont équilibrés par le proxy sur les points de terminaison de leurService. - La passerelle n'ajoute pas de capacité de GPU : le débit et la latence sont limités par les serveurs de modèles. Dimensionnez les déploiements de modèles avec l'ensemble de guides associés (vLLM pour le haut débit, Ollama pour la facilité d'utilisation et l'évaluation avec processeur uniquement).
- Les générations longues nécessitent des délais d'inactivité et de requête plus longs que les API HTTP classiques. Configurez-les sur les routes et les règles plutôt que sur les clients.
- Les composants de passerelle sont des charges de travail de processeur uniquement. Le proxy Envoy
- Gestion des ressources :
- Tous les composants de la passerelle s'exécutent sur des nœuds de processeur et n'ont pas besoin d'accélérateur. Le tableau suivant fournit une indication de la taille pour un déploiement fonctionnel. L'implémentation de référence définit les demandes et les limites exactes. Les valeurs de production dépendent du taux de requêtes et de la taille des charges utiles.
- Le tableau des ports ci-dessous liste tous les ports que les règles de réseau doivent autoriser.
- La planification des GPU appartient aux déploiements de modèles : les noms des ressources d'accélérateur sont découverts à partir des nœuds, comme décrit dans l'ensemble de guides associés.
Dimensionnement indicatif des composants de la passerelle (CPU uniquement)
| Composant | Instances répliquées | CPU (demande) | Mémoire (demande) | Remarques |
|---|---|---|---|---|
| Contrôleur Envoy Gateway | 1 | 100 m à 500 m | 256 Mi à 1 Gi | Plan de contrôle ; pas dans le chemin de la requête |
| Contrôleur de routeur d'agent Envoy | 1 | 100 m à 500 m | 256 Mi à 512 Mi | Plan de contrôle et serveur d'extension |
Proxy Envoy Pod (proxy + side-car de processeur externe) |
1 à 2 par Gateway |
500 m–2 | 512 Mio–2 Gio | Évoluer en fonction du taux de demandes et de la taille de la charge utile |
| Sélecteur de point de terminaison | 1 par InferencePool |
100 m à 500 m | 256 Mi à 512 Mi | Scrape les métriques du serveur de modèles |
| Service de limitation du débit (facultatif) | 1 | 100 m à 500 m | 256 Mi à 512 Mi | Uniquement avec la limitation du débit globale |
| Redis (facultatif) | 1 | 100 m à 500 m | 256 Mi à 1 Gi | Uniquement avec la limitation du débit globale |
ses ports réseau ;
| Port | Composant | Objectif |
|---|---|---|
| 80 / 443 | Proxy Envoy (écouteurs Gateway) |
Point d'entrée HTTP / HTTPS sur le VIP LoadBalancer |
| 1063 | Contrôleur de routeur Envoy Agent (serveur d'extension) | Appels gRPC depuis le gestionnaire d'extensions Envoy Gateway |
| 9002 | Sélecteur de point de terminaison | Appels gRPC ext_proc depuis le proxy Envoy |
| 6379 | Redis | Compteurs de limites de débit |
| 8000 | vLLM | API et métriques compatibles avec OpenAI du serveur de modèle |
| 11434 | Ollama | Ollama et API compatible avec OpenAI du serveur de modèle |
- Disponibilité et fiabilité :
- Le proxy et le processeur externe s'exécutent dans le même
Pod. Plusieurs répliques derrière le masqueLoadBalancerServicemasquent les défaillances individuelles dePod, et les contrôleurs peuvent redémarrer sans interrompre le trafic. - Les règles
AIGatewayRoutepeuvent lister plusieurs backends avec des priorités afin que la passerelle revienne à un autre ensemble de répliques ou serveur de modèle lorsqu'un backend n'est pas sain. - Le sélecteur de points de terminaison est un
Deploymentpar pool. S'il n'est pas disponible, les requêtes adressées à ceInferencePooléchouent jusqu'à ce qu'il soit de nouveau disponible. Exécutez-le avec des requêtes de ressources et des vérifications de disponibilité, et surveillez-le comme un composant du plan de données. - Redis ne contient que des compteurs de limites de débit. Une panne de Redis affecte la limitation du débit, mais pas le routage.
- Le proxy et le processeur externe s'exécutent dans le même
- Complexité opérationnelle :
- Alignement des versions entre Envoy Gateway, Envoy Agent Router et l'extension d'inférence de l'API Gateway : mettez à niveau les trois ensemble avec la combinaison testée (Envoy Gateway 1.8.4, Envoy Agent Router 1.1.0, extension d'inférence de l'API Gateway 1.5.0).
- Cycle de vie en mode Air-gapped : chaque image et graphique est réamorcé dans Harbor pour chaque mise à niveau. La ressource
EnvoyProxyet les valeurs du graphique épinglent le registre et le secret d'extraction. - Deux couches de configuration :
GatewayClass/Gateway/EnvoyProxyappartenant à la plate-forme etAIGatewayRoute/AIServiceBackend/InferencePoolappartenant à l'équipe. L'intégration d'un nouveau modèle implique l'ajout d'une règle de routage et d'un backend, et non d'une nouvelle passerelle. - Surveillance : taux de requêtes, latence (y compris le délai d'émission du premier jeton), utilisation des jetons par modèle et par consommateur, score du sélecteur de points de terminaison et utilisation du GPU des serveurs de modèles.
InferenceObjectiveest toujours une API alpha (v1alpha2). Attendez-vous à des modifications de schéma entre les versions de l'extension Inference.
- Sécurité et conformité :
- L'ensemble de la solution fonctionne dans le périmètre de sécurité hermétique du GDC.
- Les règles de réseau sont obligatoires : un espace de noms
NetworkPolicyautorise le trafic du proxy vers les ports du serveur de modèle (8000, 11434) et vers le sélecteur de points de terminaison (9002), et unProjectNetworkPolicyautorise le trafic client vers l'adresse IP virtuelleLoadBalancerlorsque les consommateurs résident en dehors du projet. - TLS se termine au niveau de
Gatewayavec un certificat stocké dans unSecretKubernetes. Les clients ne voient que le point de terminaison de la passerelle. - Les identifiants en amont (par exemple, une clé API requise par un serveur de modèle) sont stockés dans des
Secretréférencés par unBackendSecurityPolicyet injectés par la passerelle. Les applications ne détiennent donc jamais d'identifiants de backend. - La limitation du débit basée sur les jetons limite la consommation de capacité GPU coûteuse par consommateur ou par modèle.
- Les comptes robots Harbor et les secrets d'extraction d'images Kubernetes garantissent un accès sécurisé aux images de conteneurs. Le RBAC de l'API Gateway orienté rôle sépare les responsabilités de la plate-forme et de l'application.
Décisions de conception
Les principales décisions de conception suivantes ont été prises pour cette architecture de référence :
Décision 1 : Implémentation de la passerelle d'IA : Envoy Agent Router Open Source sur Envoy Gateway ou distributions alternatives
| Contexte | Décision clé | Explication |
|---|---|---|
| La passerelle d'IA est le principal choix architectural avec des alternatives viables, allant des options Open Source autogérées aux offres commerciales : (a) Routeur Envoy Agent sur Envoy Gateway (Open Source), (b) kgateway et agentgateway (implémentations Open Source de l'API Gateway qui gèrent également le trafic des fournisseurs de LLM, les outils MCP et la communication d'agent à agent dans un seul plan de données, éventuellement avec l'assistance du fournisseur solo.io), (c) Solo Enterprise pour agentgateway en tant qu'option premium commerciale. | L'implémentation de référence utilise le routeur Envoy Agent Open Source sur Envoy Gateway. Les alternatives restent des choix valables derrière les mêmes ressources de l'API Gateway. Une distribution commerciale est recommandée pour les environnements de production qui nécessitent une assistance dédiée du fournisseur. | Avantages de l'open source : léger et conforme aux normes, routage L7 hautes performances, pas de frais de licence, idéal pour évaluer la solution avant de s'engager dans une offre payante. Envoy Agent Router est l'option validée dans cet ensemble de guides. Inconvénients de l'Open Source : l'assistance est assurée dans la mesure du possible par l'équipe Solutions et la communauté. Elle peut ne pas répondre aux besoins des environnements de production principaux. Avantages Premium : contrats d'assistance pour les entreprises concernant le cycle de vie de la passerelle et, souvent, des capacités agentives avancées. Inconvénients de la version Premium : contrat de licence ou d'assistance payant et relation supplémentaire avec un fournisseur. |
Décision 2 : API Kubernetes Gateway avec l'extension Inference par rapport à Ingress ou à une API Gateway propriétaire
| Contexte | Décision clé | Explication |
|---|---|---|
| Les points de terminaison d'inférence peuvent être exposés avec l'ancienne API Ingress, un format de configuration spécifique à la passerelle ou l'API Kubernetes Gateway. L'équilibrage de charge tenant compte du modèle a également besoin d'un moyen de décrire les pools de serveurs de modèles et leurs priorités. | La solution est basée sur l'API Kubernetes Gateway (GatewayClass, Gateway, routes) implémentée par Envoy Gateway, et sur l'extension d'inférence de l'API Gateway (InferencePool, InferenceObjective, sélecteur de points de terminaison) pour le routage tenant compte des modèles. |
L'API Gateway est la norme Kubernetes qui succède à Ingress. Elle est orientée rôles (équipes de plate-forme par rapport aux équipes d'application) et portable entre les implémentations. L'extension Inference est la norme de la communauté pour le routage compatible avec les serveurs de modèles (profondeur de file d'attente, cache KV, priorités). Elle est compatible avec Envoy Agent Router dès le départ. Les autres distributions de passerelle implémentent les mêmes API, ce qui permet de revenir sur la décision 1. |
Décision 3 : Routage basé sur le corps sur le champ model des requêtes compatibles avec OpenAI en tant que point de terminaison unifié
| Contexte | Décision clé | Explication |
|---|---|---|
Les applications peuvent adresser les modèles via un point de terminaison par modèle (basé sur l'hôte ou le chemin d'accès), via un en-tête personnalisé défini par le client ou via le champ model que chaque requête compatible avec OpenAI comporte déjà. |
La passerelle expose un point de terminaison compatible avec OpenAI et des routes sur le champ model : le processeur externe l'extrait dans l'en-tête x-ai-eg-model et les règles AIGatewayRoute correspondent à cet en-tête. |
Les clients et SDK compatibles avec OpenAI existants fonctionnent sans modification et permettent de changer de modèle en modifiant une chaîne. Les points de terminaison, les identifiants et l'emplacement du modèle peuvent être modifiés sans toucher aux applications. Les mêmes règles peuvent mapper un nom de modèle à plusieurs backends pour la répartition du trafic, le basculement ou les remplacements de noms de modèles. |
Décision 4 : Amorçage d'artefacts sous air gap dans Harbor par rapport aux pulls à la demande
| Contexte | Décision clé | Explication |
|---|---|---|
| L'installation en amont extrait les images de conteneurs des registres publics et les charts Helm en tant qu'artefacts OCI à la demande, ce qui est impossible dans un environnement isolé. | Toutes les images de conteneur (proxy Envoy, Envoy Gateway, contrôleur de routeur Envoy Agent et processeur externe, service de limitation du débit, sélecteur de points de terminaison, Redis) ainsi que les graphiques Helm d'Envoy Gateway et d'Envoy Agent Router sont insérés dans un projet Harbor avec seed_registry.sh (crane). Les graphiques sont affichés hors connexion avec helm template à partir de Harbor, et la ressource EnvoyProxy et les valeurs du graphique épinglent le registre Harbor et le secret d'extraction. |
Une étape d'amorçage répétable et auditable par version ; le cluster n'a jamais besoin de connectivité externe ; l'épinglage de version rend les mises à niveau explicites et réversibles. |
Décision 5 : Limitation du débit basée sur les jetons avec Redis (facultatif) par rapport aux limites basées sur les requêtes uniquement
| Contexte | Décision clé | Explication |
|---|---|---|
| La capacité de GPU est consommée par jeton, et non par requête. Une limite du nombre de requêtes ne peut pas protéger un modèle partagé contre quelques requêtes très volumineuses ou de longues générations. La limitation du débit global dans Envoy Gateway nécessite un magasin de compteurs partagé. | La limitation du débit basée sur les jetons est une fonctionnalité facultative de l'architecture : le processeur externe enregistre les jetons d'entrée, de sortie et totaux par requête (llmRequestCosts), un BackendTrafficPolicy applique le budget et une instance Redis (Redis 8.10, déployée dans le cluster ou une instance existante) stocke les compteurs. Les déploiements sans limitation du débit n'ont pas besoin de Redis. |
L'utilisation est mesurée dans l'unité qui reflète les coûts, les budgets sont appliqués de manière cohérente à toutes les répliques de proxy et la dépendance n'est payée que par les clients qui ont besoin de quotas. |
Décision 6 : Topologie : plan de contrôle et plan de données de la passerelle dans un espace de noms dédié d'un cluster standard, modèles dans les espaces de noms d'application
| Contexte | Décision clé | Explication |
|---|---|---|
| La passerelle peut s'exécuter dans un cluster dédié, dans chaque espace de noms d'application ou une fois par cluster standard à côté des modèles qu'elle dessert. Les modèles à pondération ouverte sur GDC air-gapped sont déployés dans des clusters standards (ensemble de guides associés). | Le plan de contrôle Envoy Gateway et Envoy Agent Router, ainsi que le plan de données du proxy Envoy, s'exécutent dans un espace de noms dédié du cluster standard qui héberge les modèles : AIGatewayRoute, AIServiceBackend, InferencePool. Les déploiements de modèles se trouvent dans les espaces de noms des applications et sont référencés dans les espaces de noms. |
Les requêtes restent dans le réseau du cluster entre le proxy et les Pod de modèle (latence la plus faible, sans équilibreurs de charge supplémentaires). L'administrateur de la plate-forme possède l'espace de noms de la passerelle, tandis que les équipes d'application possèdent leurs routes et leurs modèles. Le sélecteur de points de terminaison peut extraire les serveurs de modèles directement. Une passerelle client par projet qui transfère les données vers une passerelle de serveur centralisée reste une extension de cette topologie pour la consommation multiprojets. |
Hypothèses et limites
- L'environnement GDC sous air gap 1.16.2-hf1 ou version ultérieure est disponible avec un cluster standard exécutant Kubernetes v1.32.13-gke.400 ou version ultérieure.
- Des ressources matérielles suffisantes (en particulier des GPU) sont disponibles pour les backends de diffusion de modèles. Les composants de passerelle eux-mêmes s'exécutent sur des nœuds de processeur. Les modèles réels nécessitent des GPU. Les petits modèles sur Ollama peuvent s'exécuter sur le CPU pour une évaluation fonctionnelle uniquement.
- Une instance Harbor est configurée et accessible, et une station de travail avec accès à Internet et connectivité à l'environnement GDC (API Harbor et Kubernetes) est disponible pour amorcer les images et les graphiques.
- Les utilisateurs disposent des autorisations nécessaires : rôles de projet "Lecteur d'instance Harbor" et "Administrateur de cluster standard", ainsi qu'un
StandardClusterRoleBindingpour le rôlecluster-adminsur le cluster standard pour l'installation à portée de cluster (CRD,GatewayClass, espaces de noms). Consultez l'implémentation de référence. - Les backends de mise en service du modèle exposent une API compatible avec OpenAI. Les backends associés en tant que
InferencePoolexposent également les métriques compatibles avec vLLM sur lesquelles repose le sélecteur de points de terminaison. - Limitation : l'équipe Solutions fournit une assistance au mieux pour les composants Open Source (Envoy Gateway, Envoy Agent Router, extension d'inférence de l'API Gateway). Une assistance dédiée du fournisseur nécessite une distribution commerciale (décision 1).
- Limitation :
InferenceObjectiveest une API alpha (inference.networking.x-k8s.io/v1alpha2) et peut changer entre les versions de l'extension Inference. - Limitation : Une adresse IP virtuelle
LoadBalancerpourGatewayet unProjectNetworkPolicysont requis pour les consommateurs en dehors du projet. Dans le projet, les clients du cluster oukubectl port-forwardpeuvent accéder directement à la passerelleService. - Limitation : Gemini sur GDC, l'affinage de modèles, les modèles d'IA générative non LLM et la diffusion de modèles multinœuds ne sont pas inclus dans cette version de la solution.
Parcours utilisateur
Vous trouverez ci-dessous un parcours utilisateur complet pour la passerelle d'IA sur GDC sous air gap : d'abord le chemin de requête sur lequel s'appuie un développeur d'applications, puis le chemin de configuration suivi par l'administrateur de plate-forme.
1. Chemin de requête du développeur
Une application ou un agent n'ont besoin que du point de terminaison de la passerelle, d'un identifiant client si la passerelle en impose un et du nom du modèle.
- Envoyez la requête : l'application appelle
POST /v1/chat/completionssur le point de terminaison de la passerelle avec un corps JSON compatible avec OpenAI qui nomme le modèle (par exemple,"model": "gemma"), exactement comme elle appellerait n'importe quel service compatible avec OpenAI. - Entrée de la passerelle : la requête atteint l'adresse IP virtuelle
LoadBalancerdeGateway. Le proxy Envoy interrompt TLS et fait correspondre l'écouteur et la route. - Traiter le corps : le proxy transmet la requête au processeur externe Envoy Agent Router, qui analyse le corps, extrait le nom du modèle dans l'en-tête
x-ai-eg-modelet traduit la charge utile dans le schéma de backend si elle est différente. - Sélectionnez le backend : la règle
AIGatewayRoutequi correspond au nom du modèle sélectionne unAIServiceBackend(par exemple, l'ServiceOllama) ou unInferencePool(par exemple, un ensemble de répliques vLLM). Pour unInferencePool, le sélecteur de points de terminaison choisit la réplique avec la file d'attente la plus courte et la meilleure correspondance du cache KV. - Transférer et répondre : le proxy injecte les identifiants en amont lorsqu'un
BackendSecurityPolicys'applique, transfère la requête auPodchoisi, renvoie la réponse en flux continu et permet au processeur externe d'enregistrer l'utilisation des jetons, ce qui alimente les métriques et, le cas échéant, la limite de débit basée sur les jetons. - Changer de modèle : pour utiliser un autre modèle, le développeur modifie la chaîne
model. Aucun nouveau point de terminaison, identifiant ni bibliothèque cliente n'est nécessaire.
2. Chemin de configuration de l'administrateur de plate-forme
- Importer des artefacts dans Harbor : créez les comptes robot Harbor, puis copiez les images de conteneur et les graphiques Helm Envoy Gateway et Envoy Agent Router dans Harbor avec
seed_registry.shà partir d'une station de travail ayant accès à Internet. - Installez Envoy Gateway : affichez les graphiques CRD et de contrôleur à partir de Harbor avec
helm templateet appliquez-les dans l'espace de noms de la passerelle. Créez la ressourceEnvoyProxyqui épingle l'image du proxy et le secret d'extraction, puis validez le contrôleur avec unGatewayClass,GatewayetHTTPRoutede base. - Installer Envoy Agent Router : installez les CRD Envoy Agent Router et les CRD Gateway API Inference Extension, déployez le contrôleur Envoy Agent Router et reconfigurez Envoy Gateway pour appeler son serveur d'extension (port 1063) et accepter les backends
InferencePool. Vous pouvez également déployer Redis et activer le service de limitation de débit global. - Exposer la passerelle : créez
GatewayClassetGatewayavec des écouteurs HTTP et HTTPS (certificat TLSSecret), attendez le VIPLoadBalanceret appliquezProjectNetworkPolicypour les consommateurs en dehors du projet. - Associer des modèles : déployez les backends de diffusion de modèles avec l'ensemble de guides associés, puis créez des ressources
AIServiceBackendpour lesServicecompatibles avec OpenAI et des ressources Endpoint Picker pour les ensembles de répliques compatibles avec vLLM, ainsi que les objets de l'espace de nomsNetworkPolicy.InferencePool - Publiez la route : créez l'
AIGatewayRouteavec une règle par nom de modèle (routage basé sur le corps) et, si nécessaire, les objetsBackendSecurityPolicyetBackendTrafficPolicypour les identifiants en amont et les budgets de jetons. - Valider et exploiter : appelez
/v1/modelset/v1/chat/completionsvia l'adresse IPV (ou une solution de secourskubectl port-forward), vérifiez les métriques du proxy, du processeur externe et du sélecteur de points de terminaison, puis transmettez les noms de points de terminaison et de modèles aux équipes chargées des applications. Faites évoluer les répliques de proxy et les déploiements de modèles de manière indépendante. Mettez à niveau Envoy Gateway, Envoy Agent Router et l'extension d'inférence ensemble.
Pour connaître la procédure détaillée, consultez l'implémentation de référence de l'agent Envoy Router et le guide de l'utilisateur sur le routage basé sur le corps avec Envoy Agent Router.
Autres ressources
- Implémentation de référence du routeur Envoy Agent
- Guide de l'utilisateur du routeur Envoy Agent pour le routage basé sur le corps
- Architecture de référence des LLM open-weight
- Documentation Envoy Agent Router
- Envoy Gateway
- API Kubernetes Gateway
- Extension Gateway API Inference
- Documentation Google Distributed Cloud sous air gap