


Les organisations opérant dans des environnements isolés sont confrontées à un défi de taille : elles ont besoin du pouvoir transformateur des grands modèles de langage (LLM), mais sont strictement interdites de se connecter à des API externes basées sur le cloud en raison de protocoles de sécurité rigoureux. Pour combler cette lacune, ces clients ont besoin d'un écosystème robuste et autonome capable d'héberger et de gérer des modèles open-weight directement sur leur infrastructure Google Distributed Cloud (GDC) sous air gap. Ce déploiement localisé est essentiel pour maintenir une souveraineté absolue des données, en veillant à ce que les informations sensibles ne quittent jamais les locaux physiques. En intégrant des environnements d'exécution sécurisés à des moteurs d'inférence locaux, les utilisateurs peuvent exploiter des fonctionnalités d'IA avancées tout en conservant un contrôle administratif complet sur leurs données, les pondérations de leurs modèles et leur stratégie de sécurité interne.
Bien que Gemini sur GDC fournisse des fonctionnalités avancées et gérées, les clients déploient souvent des modèles open source tels que Gemma 4 ou Llama 4 pour une granularité et un contrôle plus importants. Le déploiement de modèles open-weight dans des environnements GDC isolés offre des avantages financiers considérables par rapport aux services propriétaires gérés. En possédant les pondérations du modèle, les organisations éliminent les frais d'API récurrents par jeton, qui peuvent devenir prohibitifs pour les charges de travail automatisées à volume élevé. De plus, les modèles Open Source permettent la quantification (par exemple, 4 bits ou 8 bits), ce qui permet d'exécuter un raisonnement hautes performances sur des empreintes matérielles plus petites et moins coûteuses à la périphérie. Cette optimisation verticale, combinée à la possibilité de partager l'infrastructure entre plusieurs applications internes sans frais de licence supplémentaires, permet de réduire considérablement le coût total de possession (TCO) pour les opérations d'inférence soutenues à grande échelle.
Solution proposée
Ce document décrit l'architecture de référence pour le déploiement et la gestion de grands modèles de langage (LLM) ouverts dans des environnements Google Distributed Cloud (GDC) air-gapped. De nombreux clients, en particulier ceux des secteurs fortement réglementés, ne peuvent pas utiliser les API LLM basées sur le cloud en raison d'exigences strictes en matière de souveraineté et de sécurité des données. Cette architecture répond au besoin d'exécuter des LLM puissants en local dans leur propre instance GDC sécurisée.
Contenu : cette architecture couvre le déploiement de LLM Open Source (tels que Gemma, Llama et DeepSeek) à l'aide des backends de diffusion vLLM ou Ollama. Il inclut l'utilisation de Kubernetes pour l'orchestration, de Harbor pour le stockage des artefacts, de volumes persistants pour les pondérations des modèles et de règles de réseau de projet pour la sécurité du réseau.
Ce qui n'est pas inclus : cette architecture ne couvre pas les services AI Gateway gérés, les modèles propriétaires tels que Gemini de Google, les processus d'affinage de modèles ni les modèles d'IA générative pour d'autres modalités telles que la génération d'images. Ces fonctionnalités seront abordées dans des guides distincts.
Audience : ce document s'adresse principalement aux administrateurs de plate-forme responsables du déploiement et de la gestion des services sur GDC, ainsi qu'aux architectes techniques qui conçoivent des solutions d'IA dans l'environnement isolé. Les utilisateurs finaux et les développeurs qui interagiront avec les modèles déployés sont des audiences secondaires qui bénéficient de la compréhension de la structure sous-jacente.
Architecture de référence
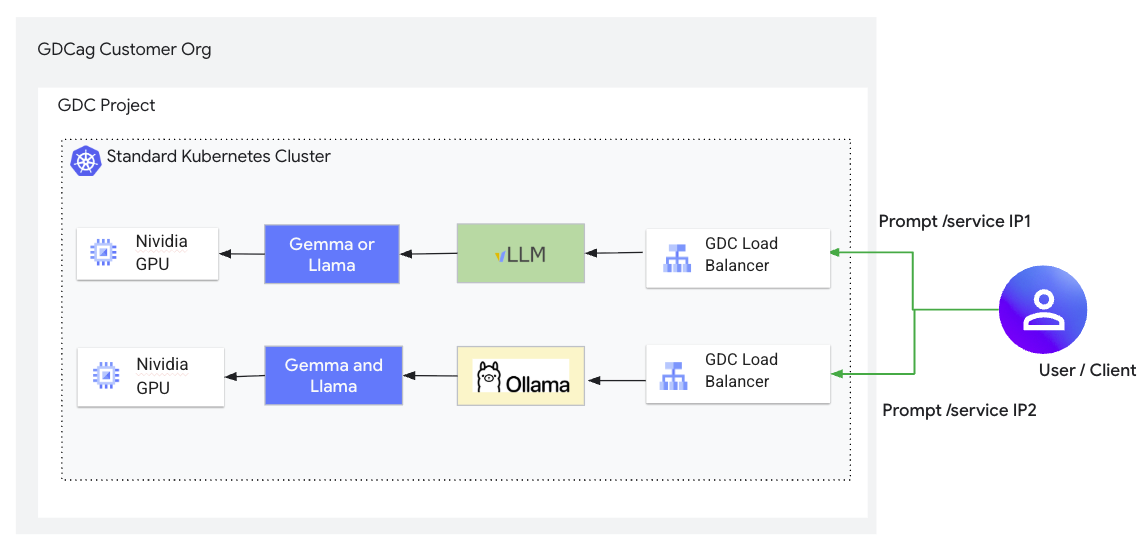
Composants de la solution
La solution utilise les composants suivants :
| Composant de la solution | Responsabilités | Flux de données | Interfaces |
|---|---|---|---|
| Zone client GDC sous air gap | Héberge les clusters Kubernetes, la mise en réseau et l'infrastructure de stockage | Plate-forme de base | Interfaces de gestion de l'infrastructure pour l'IO. API Kubernetes pour les administrateurs et les utilisateurs de la plate-forme |
| Équilibreur de charge | Expose les pods de diffusion LLM (vLLM, Ollama) au trafic provenant de l'extérieur du cluster Kubernetes, en fournissant une adresse IP stable. | Les requêtes de clients externes sont envoyées à l'adresse IP externe de LoadBalancer. LoadBalancer répartit les requêtes entre les pods de backend opérationnels (vLLM ou Ollama) en fonction du sélecteur du service. | API Kubernetes Service. Provisionne automatiquement un équilibreur de charge réseau dans l'environnement GDC. |
| vLLM | Mise en service d'inférence LLM à haut débit. Optimisé pour une faible latence à l'aide de techniques telles que PagedAttention. Sert généralement un modèle par instance. | Reçoit les requêtes d'inférence HTTP des clients. Charge les pondérations du modèle à partir du PVC installé. Effectue des calculs sur les GPU associés. Renvoie des réponses HTTP avec du texte généré. | API RESTful compatible avec OpenAI pour l'inférence. Accepte les requêtes JSON. |
| Ollama | Diffusion de l'inférence LLM, conçue pour faciliter l'utilisation et la gestion de plusieurs modèles dans une même instance (bien qu'un seul soit actif à la fois) | Reçoit les requêtes d'inférence HTTP. Charge les modèles (souvent regroupés dans l'image de conteneur ou extraits lors de la première utilisation s'ils ne sont pas isolés). Effectue des calculs sur les GPU. Renvoie des réponses HTTP. Les modèles sont déchargés après une période d'inactivité. | L'API RESTful Ollama accepte les requêtes JSON. Il dispose également d'une CLI. |
| GPU / MIG Nvidia | Fournir une accélération matérielle pour l'inférence LLM. | Les backends LLM (vLLM, Ollama) déchargent les calculs intensifs du modèle (multiplications matricielles, etc.) sur les GPU pour accélérer l'inférence. MIG permet de partitionner un seul GPU pour qu'il soit utilisé par plusieurs instances de modèles plus petits. | Exposé en tant que type de ressource dans Kubernetes (par exemple, nvidia.com/gpu). Les pods demandent ces ressources. |
| Harbor | Stocke et gère de manière sécurisée les images de conteneurs pour vLLM, Ollama et tous les pods d'assistance (comme busybox) | Les images de conteneur sont transférées d'un environnement de compilation (par exemple, une station de travail avec accès à Internet) vers Harbor. Les nœuds Kubernetes extraient ces images de Harbor pour exécuter les conteneurs. | API Docker Registry. Les nœuds Kubernetes interagissent avec Harbor pour extraire les images lors de la création de pods. Les utilisateurs interagissent avec la CLI Docker ou l'interface utilisateur Harbor pour envoyer des images. |
| Demandes de volume persistant | Fournit un stockage persistant pour les pondérations de modèle LLM, indépendant des cycles de vie des pods. | Les fichiers de modèle sont copiés dans le volume persistant (par exemple, à l'aide d'un pod d'assistance et de kubectl cp). Le serveur vLLM lit les pondérations du modèle à partir de ce volume installé au démarrage. Ollama regroupe généralement les modèles dans l'image. Les PVC sont donc moins courants pour le stockage des modèles Ollama dans cette configuration. |
API de stockage Kubernetes. Définis en YAML et montés dans des pods en tant que volumes. |
| Règle de réseau du projet | Applique l'isolation du réseau et contrôle le flux de trafic au niveau du projet/de l'espace de noms. Garantit que seul le trafic autorisé peut atteindre les services LLM. | Le trafic réseau vers et depuis les pods de l'espace de noms est inspecté. Les règles de stratégie déterminent si les connexions aux ports du service LLM (par exemple, 8000 pour vLLM, 11434 pour Ollama) sont autorisées, généralement en fonction des plages d'adresses IP sources ou d'autres libellés. | API Kubernetes networking.gdc.goog/v1. Définie en YAML. |
Fonctionnalités et capacités
Cette architecture de référence offre les fonctionnalités de base suivantes :
- Diffusion de LLM à pondération ouverte : permet d'héberger et d'inférer différents modèles à pondération ouverte (par exemple, Gemma, Llama, DeepSeek).
- Composants : backends de diffusion LLM (vLLM, Ollama), déploiements/pods Kubernetes.
- Responsabilités : chargement des pondérations du modèle, gestion du processus d'inférence, exécution des modèles sur des accélérateurs matériels et exposition des points de terminaison.
- Interfaces : API REST (compatibles avec OpenAI pour vLLM, API intégrée pour Ollama) pour les requêtes d'inférence, généralement au format JSON.
- Bring Your Own Model (BYOM) : les utilisateurs peuvent importer et déployer les LLM open source de leur choix dans l'environnement isolé.
- Composants : Harbor, demandes de volumes persistants, Kubernetes.
- Responsabilités : stockage sécurisé des images de conteneurs et des pondérations de modèles. Mécanisme permettant de transférer des modèles dans l'environnement et de les rendre accessibles aux moteurs de diffusion.
- Interfaces : API Docker Registry (pour Harbor), API Kubernetes (pour les PVC et les montages de volumes).
- Inférence accélérée par le matériel : utilise les GPU NVIDIA dans le cluster GDC pour exécuter efficacement les inférences LLM.
- Composants : GPU NVIDIA, Kubernetes, plug-ins d'appareils.
- Responsabilités : planifier les pods sur les nœuds avec des ressources GPU. Exposer le matériel GPU aux conteneurs de backend LLM. Compatible avec le GPU multi-instance (MIG) pour le partitionnement.
- Interfaces : API Kubernetes (pour demander des ressources GPU telles que
nvidia.com/gpu).
- Accès réseau contrôlé : garantit que l'accès aux points de terminaison d'inférence LLM est contrôlé et isolé dans l'environnement GDC.
- Composants : services Kubernetes (LoadBalancer), ProjectNetworkPolicy.
- Responsabilités : exposer les services d'inférence à l'aide d'une adresse IP stable. Définir et appliquer des règles réseau pour autoriser ou refuser le trafic vers les backends LLM en fonction de la source, de la destination et des ports.
- Interfaces : API Kubernetes (pour les services et ProjectNetworkPolicy).
- Mise en service évolutive : permet d'ajuster la capacité en fonction de la demande.
- Composants : déploiements Kubernetes.
- Responsabilités : activer le scaling horizontal en augmentant le nombre de répliques pour les pods de backend LLM. Scaling vertical en ajustant les demandes/limites de ressources.
- Interfaces : API Kubernetes (pour gérer les ressources et les répliques de déploiement).
Principes architecturaux
- La sécurité avant tout : tous les composants et toutes les données résident dans la limite du GDC sous air gap, ce qui garantit une sécurité et un contrôle des données optimaux. L'accès au réseau est limité à l'aide de ProjectNetworkPolicies.
- Souveraineté des données : les clients conservent le contrôle total de leurs modèles et de leurs données, sans avoir besoin de connectivité externe pour les utiliser.
- Ouverte et flexible : l'architecture s'appuie sur des backends de diffusion Open Source (vLLM, Ollama) et prend en charge différents LLM à poids ouverts, ce qui permet aux clients de choisir et d'éviter la dépendance vis-à-vis d'un fournisseur pour le moteur d'inférence.
- Découplage des composants : les fonctions clés telles que le stockage de modèles (PVC), la gestion des images (Harbor) et le service d'inférence (pods vLLM/Ollama) sont des composants distincts, ce qui permet une gestion et des mises à jour indépendantes.
- Évolutivité et performances : conçu pour évoluer à la fois horizontalement en augmentant le nombre de répliques de pods et verticalement en ajustant les ressources de processeur/GPU pour répondre aux exigences de performances. vLLM est choisi pour les scénarios à haut débit et à faible latence.
- Optimisation des ressources : compatible avec les GPU multi-instances (MIG) NVIDIA pour permettre aux modèles plus petits de partager efficacement les ressources GPU, ce qui maximise l'utilisation du matériel.
- Interfaces standards : basées sur les normes Kubernetes pour l'orchestration, le déploiement et l'exposition des services. Les points de terminaison d'inférence fournissent des API REST, avec vLLM offrant une compatibilité avec OpenAI.
- Résilience : utilise les vérifications de l'état et la réplication Kubernetes pour garantir la disponibilité du service.
Remarques
- Évolutivité et performances :
- Le scaling horizontal est obtenu en augmentant le nombre de répliques dans le déploiement Kubernetes pour vLLM et Ollama.
- La mise à l'échelle verticale consiste à allouer plus de processeur/de mémoire et des tranches de GPU plus importantes, jusqu'à des GPU complets.
- vLLM met en service un modèle par instance, ce qui nécessite de nouveaux déploiements pour les modèles supplémentaires. Ollama peut gérer plusieurs modèles, mais n'en exécute qu'un seul à la fois.
- La taille du PVC a un impact significatif sur les temps de chargement des modèles. Une taille de 500 Gio ou plus est recommandée pour les IOPS élevés.
- Gestion des ressources :
- Il est essentiel de planifier soigneusement les ressources GPU. NVIDIA MIG peut être utilisé pour partitionner les GPU pour les modèles plus petits, ce qui améliore l'utilisation.
- Des ressources processeur et mémoire suffisantes doivent être allouées pour gérer à la fois l'inférence et la surcharge de gestion des modèles.
- Un espace de stockage suffisant doit être provisionné pour les PVC afin d'accueillir les tailles de modèle et d'assurer les performances.
- Disponibilité et fiabilité :
- Les déploiements Kubernetes offrent des fonctionnalités d'autoréparation et de mise à jour progressive.
- Les services LoadBalancer répartissent le trafic entre les pods opérationnels, masquant ainsi les défaillances de pods individuels.
- Le stockage des pondérations de modèle sur des PVC garantit la persistance lors des redémarrages de pods.
- Complexité opérationnelle :
- Gestion des images de conteneurs pour différents backends et versions dans Harbor.
- Procédures pour transférer en toute sécurité les pondérations de modèle dans l'environnement isolé.
- Créer et gérer des fichiers manifestes Kubernetes (déploiements, services, PVC, règles de réseau) pour chaque modèle et backend.
- Surveillance de l'utilisation du GPU, de la latence d'inférence et des taux d'erreur.
- Sécurité et conformité :
- L'ensemble de la solution fonctionne dans le périmètre de sécurité hermétique du GDC.
- Les ProjectNetworkPolicies sont obligatoires pour appliquer une isolation réseau stricte et contrôler l'accès aux points de terminaison LLM.
- Les comptes robots Harbor et les secrets d'extraction d'images Kubernetes garantissent un accès sécurisé aux images de conteneurs.
- Les données en transit peuvent être protégées par des règles réseau Kubernetes et par tout chiffrement au niveau de la plate-forme. Les données au repos sur les PVC reposent sur le chiffrement du stockage GDC.
Décisions de conception
Les principales décisions de conception suivantes ont été prises pour cette architecture de référence :
Décision 1 : Proposer à la fois vLLM et Ollama ou un seul modèle d'inférence
| Contexte | Décision clé | Explication |
|---|---|---|
| Proposez uniquement l'un des deux choix pour les couches d'inférence : VLLM et Ollama, ou proposez les deux. | Nous avons décidé de proposer les deux, car les différents utilisateurs et cas d'utilisation ont des exigences différentes en termes de performances, de compatibilité des API et de facilité de gestion des modèles. | vLLM offre un service à haut débit et à faible latence, et est compatible avec l'API OpenAI. Il est adapté aux applications de production. Ollama offre une configuration plus simple, une gestion plus facile de plusieurs modèles et une interface conviviale, ce qui est mieux adapté au développement et à l'expérimentation. La prise en charge des deux offre de la flexibilité. |
Décision 2 : Utiliser le stockage persistant ou le stockage d'objets pour le stockage du modèle vLLM
| Contexte | Décision clé | Explication |
|---|---|---|
| vLLM exige que les pondérations du modèle soient présentes dans le système de fichiers au moment de l'exécution. Dans un environnement isolé, les modèles ne peuvent pas être téléchargés à la demande. | L'utilisation de PersistentVolumeClaims garantit la disponibilité du modèle et améliore le temps de démarrage après le chargement initial. Toutefois, elle nécessite une étape initiale pour remplir le PVC, qui implique généralement un pod d'assistance. | Les revendications de volume persistant fournissent une couche de stockage résiliente et persistante pour les fichiers de grands modèles, indépendamment du cycle de vie du pod vLLM. Cela permet de charger rapidement les modèles au démarrage du pod. |
Décision 3 : Regrouper les modèles dans les images Docker Ollama ou dans des images autonomes
| Contexte | Décision clé | Explication |
|---|---|---|
| Ollama peut télécharger des modèles, mais cela nécessite un accès à Internet, qui n'est pas disponible dans les environnements isolés. | Il a été décidé de regrouper les images afin de simplifier l'opération d'exécution dans l'environnement isolé, car aucun appel externe n'est nécessaire. Toutefois, pour mettre à jour ou ajouter des modèles, l'image Docker doit être reconstruite et repoussée vers Harbor. | La création de l'image Docker avec les modèles pré-téléchargés garantit qu'Ollama démarre avec les modèles nécessaires disponibles hors connexion. |
Décision 4 : Exposer vLLM et Ollama avec des services LoadBalancer ou sans équilibreur de charge
| Contexte | Décision clé | Explication |
|---|---|---|
| Les API LLM doivent être accessibles aux applications dans l'environnement GDC. | La décision a été prise d'exposer les services à l'aide d'un équilibreur de charge, car il s'agit de l'approche Kubernetes standard pour l'exposition des services. Toutefois, cette approche repose sur le provisionnement LoadBalancer de la plate-forme GDC. | Les services Kubernetes de type LoadBalancer fournissent une méthode standard et fiable pour exposer les backends LLM, en fournissant une adresse IP stable et en distribuant la charge. |
Décision 5 : Appliquer ProjectNetworkPolicy obligatoire
| Contexte | Décision clé | Explication |
|---|---|---|
| La sécurité et l'isolation sont essentielles dans les déploiements GDC sous air gap. | Il a été décidé d'appliquer ProjectNetworkPolicy, car il améliore considérablement la sécurité des services LLM déployés, même s'il nécessite une définition minutieuse des règles réseau. | Les ProjectNetworkPolicies offrent un moyen natif à Kubernetes d'appliquer l'isolation du réseau au niveau de l'espace de noms, en veillant à ce que seul le trafic autorisé puisse atteindre les services LLM. |
Hypothèses et limites
- L'environnement GDC sous air gap 1.15.1+ est disponible
- Le cluster standard dispose de ressources matérielles suffisantes (en particulier des GPU).
- L'instance Harbor est configurée et accessible.
- Les utilisateurs disposent des autorisations nécessaires (administrateur d'espace de noms, développeur de cluster).
- Les modèles sont compatibles avec les backends de diffusion choisis (vLLM/Ollama).
Parcours utilisateur (étapes de bout en bout)
Vous trouverez ci-dessous un parcours utilisateur complet pour déployer des grands modèles de langage (LLM) à poids ouvert dans des environnements Google Distributed Cloud (GDC) isolés. Le flux est divisé en configuration courante, deux chemins de déploiement (vLLM et Ollama) et validation finale.
1. Configuration courante : gestion des images
Avant de déployer un LLM, vous devez configurer la façon dont l'environnement GDC extrait les images de conteneur de votre registre Harbor privé.
- Créez un compte robot Harbor : générez un compte robot dans l'interface utilisateur Harbor et accordez-lui des autorisations de récupération.
- Authentifiez Docker : utilisez les identifiants du compte robot pour vous connecter à Harbor depuis une machine ayant accès au réseau.
- Créer un secret Kubernetes : créez un secret docker-registry dans l'espace de noms de votre projet GDC à l'aide de
kubectlpour stocker ces identifiants Harbor que le cluster utilisera.
2. Parcours de déploiement A : vLLM (débit élevé)
Ce chemin est recommandé pour diffuser des modèles axés sur les performances, comme Gemma-3.
- Acquérir l'image : extrayez l'image Docker vLLM depuis Internet, ajoutez-lui un tag pour votre registre Harbor local et transférez-la vers Harbor.
- Préparer le stockage du modèle :
- Créez une revendication de volume persistant (PVC) de 500 Gio pour stocker les pondérations du modèle.
- Téléchargez les pondérations depuis Hugging Face sur une machine connectée à Internet.
- Utilisez un "pod d'assistance" temporaire et
kubectl cppour transférer ces poids dans le PVC de l'environnement GDC.
- Déployer le backend : appliquez un fichier manifeste de déploiement Kubernetes qui référence l'image vLLM et monte le PVC de poids du modèle.
- Exposer le service : créez un service
LoadBalancerpour fournir une adresse IP externe à l'API vLLM. - Réseau sécurisé : appliquez un
ProjectNetworkPolicypour autoriser le trafic entrant sur le port de service (généralement 8000).
3. Parcours de déploiement B : Ollama (facilité d'utilisation)
Ce chemin d'accès se concentre sur une configuration simplifiée où les pondérations du modèle sont regroupées ou préchargées dans l'image.
- Créer une image personnalisée : créez un fichier Dockerfile qui installe Ollama et utilise une commande
RUNpour "pré-extraire" des modèles spécifiques (par exemple,gemma3) dans les calques d'image. - Transférer vers Harbor : créez l'image en local et transférez-la vers votre registre Harbor privé.
- Déployer et exposer : créez un déploiement Ollama et un service
LoadBalancer. - Réseau sécurisé : appliquez un
ProjectNetworkPolicypour le port Ollama (11434).
4. Validation et test
Une fois les services déployés, les dernières étapes consistent à vérifier qu'ils fonctionnent.
- Vérifier l'état : vérifiez que les pods sont "en cours d'exécution" et que des adresses IP externes ont été attribuées aux services.
- Test d'inférence :
- vLLM : envoyez une requête
curlà l'adresse IPLoadBalancerde vLLM à l'aide du point de terminaison/v1/chat/completionscompatible avec OpenAI. - Ollama : envoyez une requête
curlà l'adresse IPLoadBalancerd'Ollama vers le point de terminaison/v1/completions.
- vLLM : envoyez une requête
5. Opérations et scaling
- Scaling vertical : augmentez les tranches de GPU ou passez à des configurations multi-GPU pour les modèles plus volumineux.
- Scaling horizontal : augmentez le nombre de répliques dans le déploiement pour gérer un plus grand nombre de requêtes utilisateur simultanées.
- Dépannage : surveillez les journaux à l'aide de
kubectl logset recherchez les problèmes courants tels que les échecs d'autotest FIPS ou les restrictions liées aux règles de réseau.