


遷移資料管道
將上游資料管道遷移至 BigQuery,即可直接在 Google Cloud 中擷取及轉換資料,以便淘汰舊版資料倉儲並降低營運負擔。規劃遷移作業時,您可以選擇最適合資料倉儲架構的管道模式、遷移方法和自動化調度管理技術。
什麼是資料管道?
從運算層面來說,資料管道是一種透過一系列相連處理步驟處理資料的應用程式。一般來說,資料管道可應用於資訊系統之間的資料移轉、擷取、轉換和載入 (ETL)、資料充實和即時資料分析。資料管道通常會以「批次」程序的形式運作,在執行時執行及處理資料,或以「串流」程序的形式運作,在資料可供管道使用時持續執行及處理資料。
在資料倉儲系統領域中,資料管道經常用於讀取交易系統產生的資料、套用轉換,接著再將資料寫入資料倉儲系統。每項轉換作業都是以獨立的函式說明,任何函式的輸入內容均為先前一或多個函式的輸出結果。這些相互連結的函式會以圖表呈現,通常稱為有向無環圖 (DAG),也就是圖表會遵循方向 (從來源到目的地),且為無環圖,任何函式的輸入內容都不能依賴 DAG 中其他下游函式的輸出內容。換句話說,不允許迴圈。圖表的每個節點都是一個函式,每條邊則代表資料從一個函式流向另一個函式。初始函式是「來源」,也就是與來源資料系統的連線。最後一項功能是「接收器」,也就是與目的地資料系統的連線。
在資料管道領域中,「來源」通常是指 RDBMS 等交易系統,「接收器」則會連結至資料倉儲系統。這類圖表稱為「資料流程 DAG」。您也可以使用 DAG,在資料管道和其他系統之間自動調度資料移動。這種用法稱為「自動化調度管理」或「控制流程 DAG」。
遷移資料管道的時機
將用途遷移至 BigQuery 時,您可以選擇卸載或完整遷移。
一方面來說,卸載某個應用實例時,您不需要一開始就先遷移上游資料管道。首先,您要將應用實例的結構定義和資料從現有的資料倉儲系統遷移至 BigQuery。接著,請建立從舊有資料倉儲系統連結至新資料倉儲系統的漸進式副本,讓資料保持同步。最後,請遷移並驗證下游程序,例如指令碼、查詢、資訊主頁和業務應用程式。
此時,上游資料管道尚未發生變更,仍會將資料寫入現有的資料倉儲系統。您可以再次將已卸載的應用實例新增至遷移待處理工作,以便在後續的疊代作業中進行完整遷移。
另一方面,當您完整遷移用途時,用途所需的上游資料管道會遷移至 Google Cloud。完整遷移需要先卸載用途。完整遷移之後,您可以淘汰內部部署資料倉儲系統提供的相應舊版資料表,因為資料會直接擷取至 BigQuery。
在疊代作業執行期間,您可以選擇下列其中一個選項:
- 僅卸載您的應用實例。
- 完整遷移先前已卸載的應用實例。
- 先在相同的疊代作業中卸載應用實例,再從頭開始完整遷移應用實例。
在所有應用實例皆已完整遷移之後,您可以選擇關閉舊有倉儲系統。這麼做可以減少負擔與費用,因此相當重要。
遷移資料管道的方式
本文其餘部分將說明如何遷移資料管道,包括要採用的方法和程序,以及要使用的技術。選項包括重新調整現有資料管道的用途 (重新導向至 BigQuery 載入),以及重寫資料管道,以便利用 Google Cloud代管服務。
資料管道的程序與模式
您可以使用資料管道來執行多項程序和模式。這些管道最常用於資料倉儲。您可能會使用「批次資料」管道或「串流」資料管道。批次資料管道會對一段時間內收集的資料執行 (例如每天一次)。串流資料管道會處理作業系統產生的即時事件,例如在CDC中,線上交易處理 (OLTP) 資料庫產生的資料列變更。
擷取、轉換及載入 (ETL)
在資料倉儲中,資料管道通常會執行擷取、轉換和載入 (ETL) 程序。ETL 技術可以在資料倉儲系統以外之處執行,這代表資料倉儲資源主要用於並行查詢,而非資料的準備與轉換作業。不過,您必須學習 SQL 以外的其他工具和語言才能呈現轉換,這是在資料倉儲系統以外之處執行轉換的缺點之一。
下圖呈現了典型的 ETL 程序。
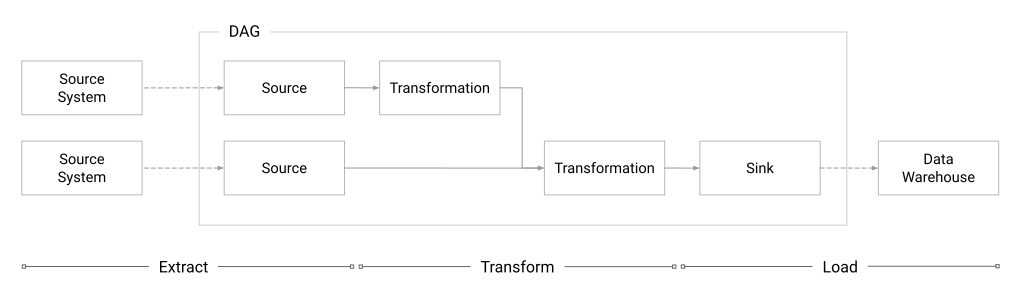
圖 1. 典型的 ETL 程序。
典型的 ETL 資料管道會從一或多個來源系統提取資料 (建議越少越好,以免因系統無法使用等問題而導致作業失敗)。接著,管道會執行一系列的轉換作業,包括清除資料、對其套用業務規則、檢查資料完整性,以及建立匯總工作或取消匯總工作。詳情請參閱實際 ETL 循環。
如果您同時使用多個資料管道也屬正常情況。第一個資料管道只負責將資料從來源系統複製到資料倉儲系統。後續管道會套用商業邏輯並轉換資料,以便用於不同的資料市集。資料市集是專門用於特定業務單位或業務目標的資料倉儲子集。
如果有多個資料管道,您需要自動化調度管理這些管道。下圖即為這個自動化調度管理程序的範例。
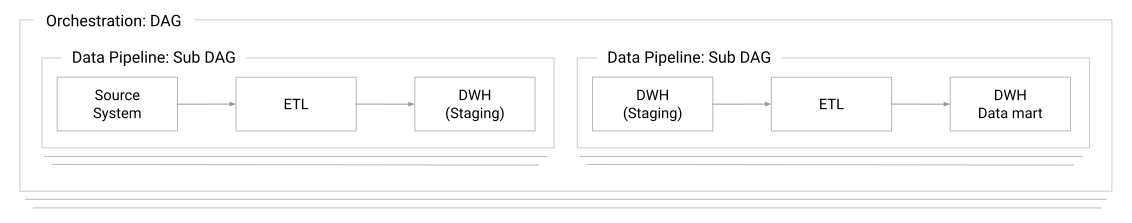
圖 2. 多個資料管道的自動化調度管理程序
在這個圖表中,每個資料管道的作用就如同自動化調度管理 DAG 的子 DAG。每個自動化調度管理 DAG 中都包含數個可配合較大目標的資料管道,例如為業務單位準備資料,方便業務分析師執行其資訊主頁或報表。
擷取、載入及轉換 (ELT)
ELT 是 ETL 的替代做法。ELT 會將資料管道分為兩個部分。首先,ELT 技術會從來源系統擷取資料,並載入資料倉儲。其次,資料倉儲系統頂端的 SQL 指令碼會執行轉換作業。這個方法的優點在於您可以使用 SQL 來表示轉換作業,缺點則是這麼做可能會耗用並行查詢所需的資料倉儲資源。因此,ELT 批次工作通常會在夜間 (或離峰時段) 執行,這時資料倉儲系統資源的需求量較小。
下圖呈現了典型的 ELT 程序。
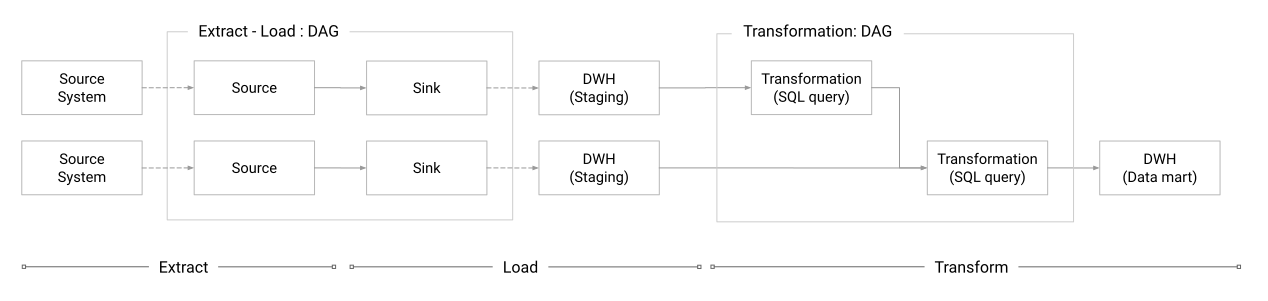
圖 3. 典型的 ELT 程序。
在您採用 ELT 方法之後,系統通常會分隔擷取資料並載入至 DAG,再將轉換作業載入至各自的 DAG。資料會載入至資料倉儲系統一次並經過多次轉換,以便建立在報表等下游作業中使用的不同資料表。這些 DAG 接著會成為大型自動化調度管理 DAG 中的子 DAG (如 ETL 章節所示)。
您將資料管道從壅塞的內部部署資料倉儲系統遷移至雲端時,請務必記得 BigQuery 等雲端資料倉儲系統採用的是大量平行資料處理技術。以 BigQuery 來說,您其實可以購買更多資源,藉此支援日漸增加的 ELT 與並行查詢需求。詳情請參閱「盡可能提高查詢效能簡介」。
擷取及載入 (EL)
您可以單獨使用擷取和載入 (EL) 程序,也可以在之後進行轉換,在這種情況下,程序會變成 ELT。EL 之所以單獨提及,是因為有多項自動化服務可執行這項工作,因此您不需建立自己的擷取資料管道。詳情請參閱「什麼是 BigQuery 資料移轉服務?」。
變更資料擷取 (CDC)
變更資料擷取 (CDC) 是用於追蹤資料變更的幾種軟體設計模式之一。通常用於資料倉儲系統,這是因為資料倉儲系統是用來整理資料,並追蹤不同來源系統隨著時間經過而產生的資料變更。
下圖顯示 CDC 與 ELT 如何搭配運作的範例:
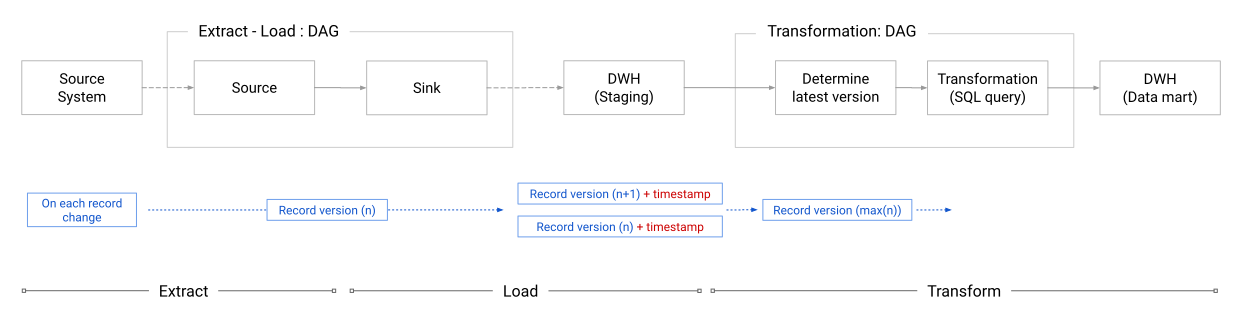
圖 4. CDC 與 ELT 搭配運作的方式。
CDC 相當適合與 ELT 搭配使用,因為您在下游進行任何變更之前,會希望先儲存原始記錄。
如要執行 EL 部分,您可以使用 Datastream 等 CDC 軟體或 Debezium 等開放原始碼工具處理資料庫記錄,並使用 Dataflow 將記錄寫入 BigQuery。接著,您可以使用 SQL 查詢來判斷最新版本,再套用進一步的轉換。範例如下:
WITH ranked AS (
  SELECT
    *,
    ROW_NUMBER() OVER (
      PARTITION BY RECORD KEY
      ORDER BY EVENT TIMESTAMP DESC
    ) AS rank
  FROM TABLE NAME
)
SELECT *
FROM ranked
WHERE rank = 1
重新建立資料管道或重新編寫管道程式碼時,請考慮使用套用為 ELT 程序的 CDC 模式。這個方法可確保您擁有完整的資料變更上游記錄,並提供明確的責任區隔,例如:
- 來源系統團隊會確保其記錄檔的可用性和資料事件的發布狀態。
- 資料平台團隊會確保資料倉儲系統中的原始記錄擷取定序作業含有時間戳記。
- 資料工程與分析師團隊會排定一系列的轉換作業來填入資料市集。
具備營運資料管道的意見回饋循環
作業資料管道是資料處理管道,可從資料倉儲擷取資料、視需要轉換資料,並將結果寫入作業系統。
營運系統是指處理機構日常交易的系統,例如 OLTP 資料庫、客戶關係管理 (CRM) 系統、產品目錄管理 (PCM) 系統等。由於這些系統通常會做為資料來源,因此作業資料管道會實作意見回饋循環模式。
作業資料管道模式如下圖所示。
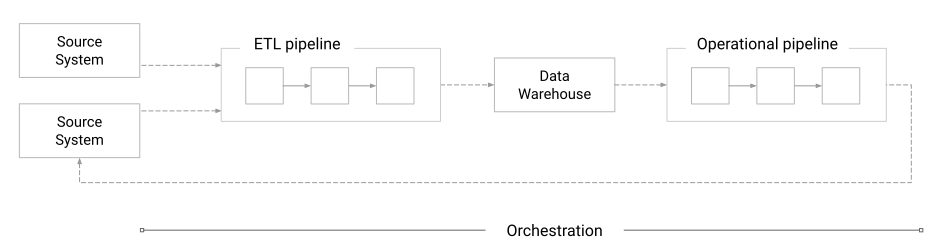
圖 5:營運資料管道的模式。
以下範例探討將產品價格寫入 PCM 系統的營運資料管道。PCM 系統是銷售相關產品資訊的權威系統,例如顏色、銷售通路、價格和季節性。以下是資料的端對端流動程序:
- 價格相關資料可從多個來源取得。這類資料可能包含 PCM 提供的各地區目前價格、第三方服務提供的競爭對手產品價格、內部系統提供的需求預測與供應商可靠性等資訊。
- ETL 管道會從來源提取資料、轉換資料,然後將結果寫入資料倉儲系統。這種情況下的轉換作業是相當複雜的運算工作,牽涉到目標為針對 PCM 中各項產品產生最佳基本價格的所有來源。
- 最後,作業管道會從資料倉儲擷取底價,執行輕量轉換來調整季節性事件的價格,並將最終價格寫回 PCM。
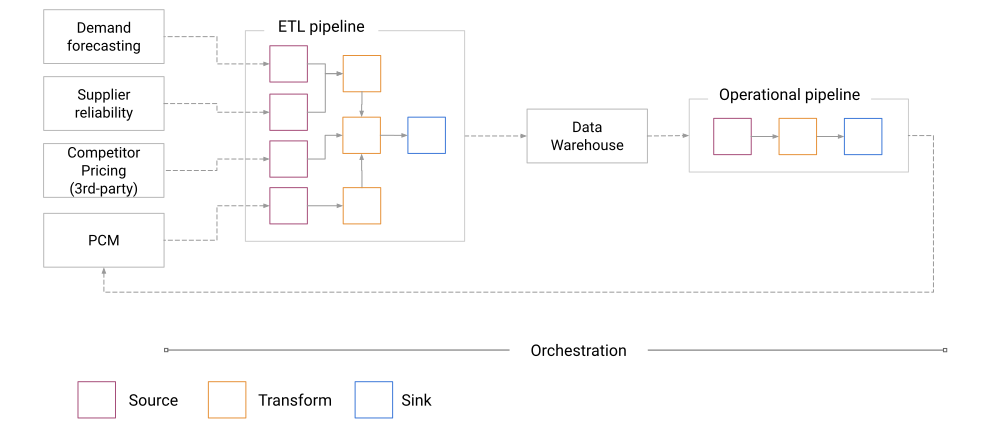
圖 6. 將產品價格寫入 PCM 系統的營運資料管道。
作業資料管道是一種下游程序,而實作 ETL、ELT 或 CDC 的資料管道則是上游程序。不過,用來導入這兩種管道的工具可能發生重疊。舉例來說,您可以使用 Dataflow 定義及執行所有資料處理 DAG、使用 GoogleSQL 定義在 BigQuery 中執行的轉換作業,以及使用 Managed Service for Apache Airflow 自動調度管理端對端資料流程。
選擇遷移方法
本節說明您可以採用的各種資料管道遷移方法。
將資料管道重新導向,以便將資料寫入 BigQuery
在下列情況下,您可以考慮使用的技術是否提供內建的 BigQuery 接收器 (寫入連接器):
- 舊版資料倉儲是由執行 ETL 程序的資料管道提供。
- 轉換邏輯會在資料儲存至資料倉儲前執行。
獨立軟體供應商 (ISV) 提供具備 BigQuery 連接器的資料處理技術,包括:
- Informatica:BigQuery 連接器指南
- Talend:在 BigQuery 中寫入資料
如果資料管道技術不支援將資料擷取至 BigQuery,請考慮使用此方法的變化版本,將資料暫時寫入檔案,然後由 BigQuery 擷取。
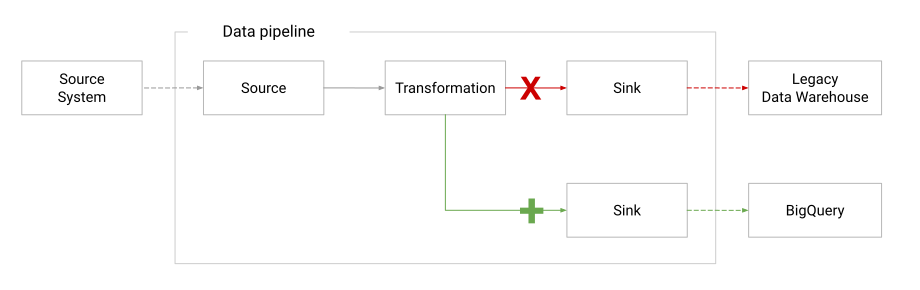
圖 7. 重新設定或重新編寫資料管道將資料寫入 BigQuery 的最後一項功能。
概括來說,這項工作涉及重寫或重新設定資料管道的最後一個函式,以便將資料寫入 BigQuery。不過,您可能需要進行額外變更或新工作,例如:
功能
- 資料對應:由於目標資料庫資料表結構定義可能發生改變,您可能需要重新設定這些對應關係。
- 指標驗證:您必須驗證舊有和新的報表,因為結構定義和查詢都有可能發生改變。
非功能性
- 您可能需要設定防火牆,允許從地端部署環境傳出資料至 BigQuery。
- 您可能需要變更網路,建立額外頻寬,以容納傳出的資料移轉。
將檔案當做中繼工具,以便將資料管道重新導向
如果現有的內部部署資料管道技術不支援 Google API,或是您無法使用 Google API,可以將檔案當做中繼工具,藉此將資料傳送至 BigQuery。
這個方法與重新導向類似,不過您可以使用能將資料寫入內部部署檔案系統的接收器,而非可將資料寫入 BigQuery 的原生接收器。如果資料位於檔案系統中,您就能將其複製到 Cloud Storage。詳情請參閱 Cloud Storage 擷取選項總覽,以及選擇擷取選項時涉及的條件。
最後一個步驟是按照「批次載入資料」中的指南,將資料從 Cloud Storage 載入 BigQuery。
下圖呈現了本節所述的方法。
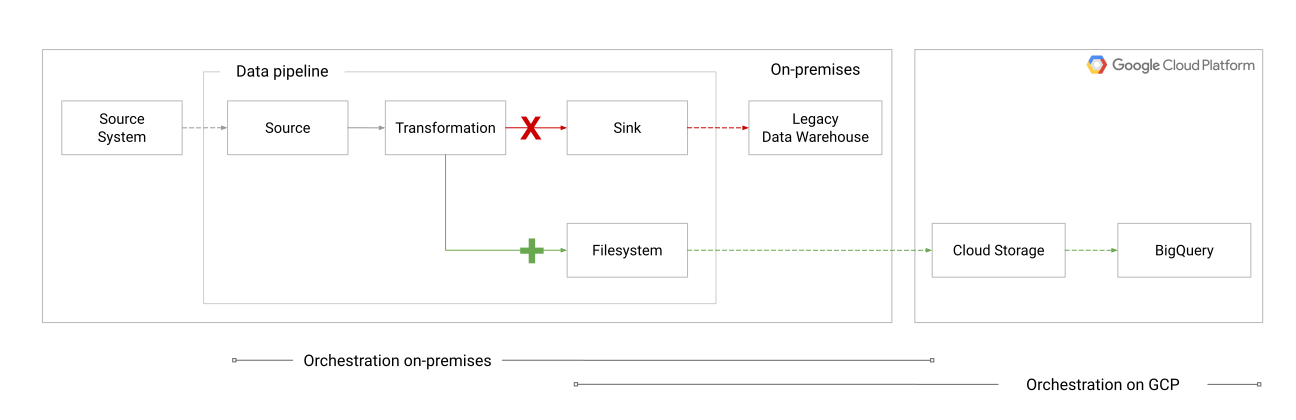
圖 8:將檔案當做中繼工具,以便將資料管道重新導向。
以 ETL 管道的自動化調度管理作業來說,您必須分別執行以下兩個步驟:
- 重複使用現有的內部部署管道自動化調度管理作業,將經過轉換的資料寫入檔案系統。擴充這個自動化調度管理作業,將檔案從內部部署檔案系統複製到 Cloud Storage,或是建立會定期執行的額外指令碼來進行複製步驟。
- 資料存放在 Cloud Storage 後,請使用 Cloud Storage 移轉作業,排定從 Cloud Storage 到 BigQuery 的週期性載入作業。Cloud Storage 移轉作業的替代方案包括 Cloud Storage 觸發條件和 Managed Airflow。
在圖 8 中,請注意Google Cloud 上的自動化調度管理功能也可以使用提取模型,透過 SFTP 等通訊協定擷取檔案。
將現有 ELT 管道遷移至 BigQuery
ELT 管道的第一個部分為將資料載入資料倉儲系統,第二個部分則是使用 SQL 轉換資料,以便在下游使用。您在遷移 ELT 管道時,這些部分都有專屬的遷移方法。
至於將資料載入資料倉儲的部分 (EL 部分),您可以按照「重新導向資料管道」一節中的指南操作,但請忽略轉換相關建議,因為轉換不屬於 EL 管道。
如果 BigQuery 資料移轉服務 (DTS) 直接或透過第三方整合服務支援您的資料來源,您可以使用 DTS 取代 EL 管道。
將現有 OSS 資料管道遷移至 Managed Service for Apache Spark
將資料管道遷移至 Google Cloud時,您可能需要遷移一些使用開放原始碼軟體架構編寫的舊版工作,例如 Apache Hadoop、Apache Spark 或 Apache Flink。
Managed Service for Apache Spark 可讓您以簡單、符合成本效益的方式,部署快速、易用、全代管的 Hadoop 和 Spark 叢集。Managed Service for Apache Spark 與 BigQuery 連接器整合,這個 Java 程式庫可讓 Hadoop 和 Spark 使用 Apache Hadoop InputFormat 和 OutputFormat 類別的抽象版本,直接將資料寫入 BigQuery。
Managed Service for Apache Spark 可讓您輕鬆建立及刪除叢集,因此您可以使用多個臨時叢集,而不必使用單一大型叢集。這種方法有幾個優點:
- 您可以為個別工作使用不同叢集設定,以消除跨工作管理工具的管理負擔。
- 您可以依據個別工作或工作群組的需求調整叢集規模。
- 您只有在工作使用資源時才需支付費用。
- 您不需要時時刻刻維護叢集,因為您每次使用叢集時,系統都會重新設定叢集。
- 不需要為開發、測試和實際工作環境維護不同的基礎架構。您可以視需求使用相同的定義來建立多個不同的叢集版本。
遷移工作時,建議您採取漸進式做法。逐步遷移可讓您:
- 將現有 Hadoop 基礎架構中的個別工作與成熟環境中固有的複雜作業區隔開來。
- 單獨查看各項工作來評估相關需求,並決定遷移作業的最佳路徑。
- 在發生非預期問題時予以處理,而不會延誤相關工作。
- 為每個複雜程序建立概念驗證,而不影響正式環境。
- 審慎地將工作遷移至建議的臨時模型。
將現有的 Hadoop 和 Spark 工作遷移至 Managed Service for Apache Spark 時,您可以確認工作的依附元件是否涵蓋在支援的 Managed Service for Apache Spark 版本中。如需安裝自訂軟體,建議您建立自己的 Managed Service for Apache Spark 映像檔、使用部分可用的初始化動作 (例如 Apache Flink)、自行編寫初始化動作,或指定自訂 Python 套件需求。
如要開始使用,請參閱 Managed Service for Apache Spark 快速入門指南和 BigQuery 連接器程式碼範例。
重新託管第三方資料管道,以便在 Google Cloud上執行
建立內部部署資料管道的常見情況是使用第三方軟體來管理管道的執行作業,以及運算資源分配方式。
取決於所用軟體的功能、授權、支援和維護條款,您可以選用多個替代方案將這些管道移轉至雲端。
以下各節將說明其中幾個替代方案。
概括來說,您可以在 Google Cloud中執行第三方軟體,以下是可行的替代方案,依複雜度由低到高排列:
- 您的軟體供應商已與 Google Cloud 合作,在 Google Cloud Marketplace 提供軟體。
- 第三方軟體廠商的產品可以在 Kubernetes 中運作。
- 第三方軟體會在一或多個虛擬機器 (VM) 中運作。
如果第三方軟體提供 Cloud Marketplace 解決方案,則涉及的工作如下:
- 從 Cloud Marketplace 控制台部署第三方軟體。
- 按照「使用疊代方法遷移」一節所述的疊代方法,選取並遷移用途。
這個替代方案最為簡便,因為您可以繼續使用廠商先前提供給您的平台將資料管道部署至雲端。您也可以使用供應商的專屬工具,在原始環境和 Google Cloud上的新環境之間遷移。
如果供應商未提供 Cloud Marketplace 解決方案,但其產品可在 Kubernetes 上執行,您可以使用 Google Kubernetes Engine (GKE) 託管管道。這項程序中包含的工作如下:
- 按照供應商的建議建立 GKE 叢集,確保第三方產品能充分運用 Kubernetes 提供的任務平行處理功能。
- 按照廠商建議在 GKE 叢集中安裝第三方軟體:
- 按照「將資料倉儲系統遷移至 BigQuery:總覽」一文所述的反覆方法,選取並遷移用途。
以複雜程度來說,這個替代方案提供了一種折衷方式,利用廠商產品原生的 Kubernetes 支援來擴充及平行處理管道的執行作業。不過,您必須建立及管理 GKE 叢集。
如果供應商不支援 Kubernetes,您必須在 VM 集區中安裝其軟體,才能啟用水平擴展和平行處理工作。如果供應商軟體原生支援將工作分配給多個 VM,請使用這些提供的功能,並視需要將 VM 執行個體分組到代管執行個體群組 (MIG) 中,以便向內和向外擴充。
是否能夠平行處理工作至關重要。如果供應商未提供將工作分配至不同 VM 的功能,建議您使用工作農場模式,將工作分配至 MIG 中的 VM。下圖說明瞭這個方法。
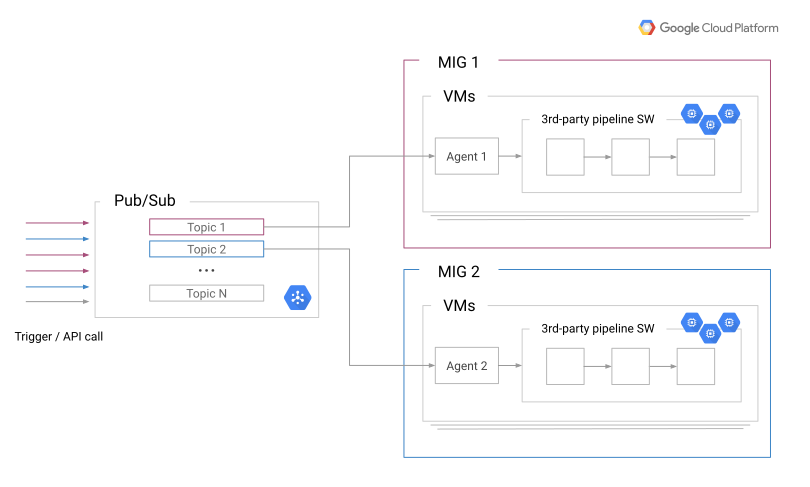
圖 9:含有三個 VM 的代管執行個體群組 (MIG)。
在這個圖表中,MIG 中的每個 VM 都會執行第三方管道軟體。您可以透過多種方式觸發管道執行作業:
- 當新資料抵達 Cloud Storage bucket 時,使用 Cloud Scheduler、Managed Airflow 或 Cloud Storage 觸發條件自動執行。
- 透過程式呼叫 Cloud 端點或 Cloud 函式,或使用 Pub/Sub API。
- 手動:使用 Google Cloud CLI 將新訊息放入 Pub/Sub 主題。
基本上,這些方法都會將訊息傳送至預先定義的 Pub/Sub 主題。您建立一個簡單的代理程式,並安裝在每個 VM 中。代理會監聽一或多個 Pub/Sub 主題。每當訊息傳送至主題時,代理程式就會從主題中提取訊息、在第三方軟體中啟動管道,然後監聽完成進度。管道佈建完成之後,代理程式會從監聽的主題中擷取後續訊息。
在所有情況下,建議您與供應商合作,遵守適當的授權條款,讓管道在 Google Cloud上運作。
重寫資料管道,改用 Google Cloud代管服務
在某些情況下,您可能會選擇重寫部分現有資料管道,以使用在 Google Cloud上全代管的新架構和服務。如果現有管道最初是以現已淘汰的技術實作,或者您預期在雲端中移植並繼續維護未經修改的管道會太不切實際或成本過高,則這個選項非常適合。
以下各節將介紹全代管 Google Cloud 服務,可讓您大規模執行進階資料轉換:Cloud Data Fusion 和 Dataflow。
Cloud Data Fusion
Cloud Data Fusion 是以開放原始碼 CDAP 專案建構而成,是一項全代管資料整合服務,可透過圖形介面建構及管理資料管道。
您可以在 Cloud Data Fusion UI 中開發資料管道,方法是將來源連結至轉換、接收器和其他節點,形成 DAG。部署資料管道時,Cloud Data Fusion 規劃工具會將這個 DAG 轉換為一系列平行運算,並在 Managed Service for Apache Spark 上以 Apache Spark 工作的形式執行。
使用 Cloud Data Fusion 時,您可以使用 Java Database Connectivity (JDBC) 驅動程式連結來源系統的資料庫,藉此讀取及轉換資料,並將資料載入所選目標位置 (例如 BigQuery),而不必編寫任何程式碼。如要這麼做,您必須將 JDBC 驅動程式上傳至 Cloud Data Fusion 執行個體並進行設定,以便用於資料管道。詳情請參閱搭配使用 JDBC 驅動程式與 Cloud Data Fusion 的相關指南。
Cloud Data Fusion 會將來源、轉換、匯總、接收器、錯誤收集器、快訊發布者、動作和執行後動作的外掛程式,公開為可自訂的元件。預先建構的外掛程式可讓您存取各種資料來源。如果沒有外掛程式,您可以使用 Cloud Data Fusion 外掛程式 API 自行建構。詳情請參閱「外掛程式總覽」。
有了 Cloud Data Fusion 管道,您就能建立批次和串流資料管道。資料管道不僅可以讓您存取記錄檔和指標,也能提向系統管理員提供多個方法來實作資料處理工作流程,而且不需要使用自訂工具。
如要開始使用,請參閱「Cloud Data Fusion 概念總覽」。如需實際範例,請參閱快速入門指南和建立指定廣告活動管道的教學課程。
Dataflow
Dataflow 是全代管服務,可大規模執行 Apache Beam 工作。Apache Beam 是開放原始碼架構,提供多項時間區間設定與工作階段分析基元,以及來源與接收連接器生態系統,包括 BigQuery 連接器。Apache Beam 可讓您在串流 (即時) 與批次 (舊有) 模式下轉換並擴充資料,而且可靠性和明確性完全相同。
Dataflow 採用無伺服器方法,會自動處理效能、資源調度、可用性、安全性和法規遵循等作業,因此可免除作業負擔。讓您專心設計程式,而不需要管理伺服器叢集。
您可以透過指令列介面、Java SDK 或 Python SDK,以不同方式提交 Dataflow 工作。此外,我們也正在開發可攜性架構,讓所有 SDK 和執行工具之間能完全互通。
如要將資料查詢和管道從其他架構遷移至 Apache Beam 和 Dataflow,請參閱 Apache Beam 程式設計模型,並瀏覽官方 Dataflow 說明文件。
如需實際範例,請參閱 Dataflow 快速入門導覽課程和教學課程。
自動化調度管理與排程
從較高的層級來看,「自動化調度管理」是多個系統的自動化協調作業,「排程」則是指自動化調度管理工作的自動觸發條件。
- 放大:資料管道本身即為 DAG 所述的資料轉換自動化調度管理工具,也就是「資料處理 DAG」。
- 縮小:如果資料管道會使用其他資料管道的輸出內容,您就必須對多個管道進行自動化調度管理。每個管道都會構成較大 DAG 中的子 DAG,也就是「自動化調度管理 DAG」。
這是資料倉儲技術的常見設定。ETL 專區的圖 1 顯示設定範例。以下各節著重於多個資料管道的自動化調度管理作業。
依附元件
依附元件共分為兩種:「集中傳遞」依附元件是將多個資料管道合併為自動化調度管理 DAG 的一個頂點,「擴散傳遞」依附元件則是一個資料管道會觸發其他多個資料管道。不過,上述兩種方式通常會合併採用,如下圖所示。
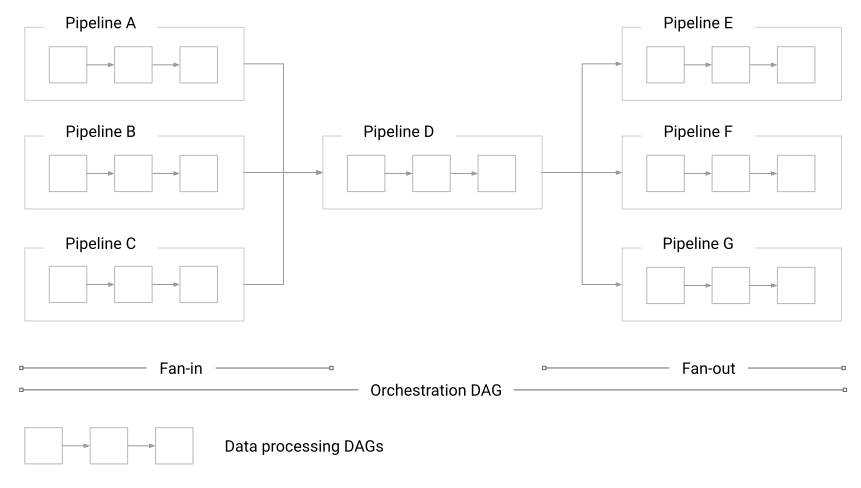
圖 10:同時使用集中傳遞與擴散傳遞依附元件。
在未採用最佳設定的環境中,某些依附元件是可用資源數量受到限制而產生的結果。舉例來說,某個資料管道在運作時產生了副產品,也就是一些常用資料。其他資料管道只是為了避免重新計算而使用這些常用資料,但與建立資料的資料管道無關。如果第一個管道發生任何功能性或非功能性問題,使用其輸出內容的資料管道也會無法運作。最好的情況是強迫這些管道等待,最差的情況則是讓這些管道完全無法運作,如下圖所示。
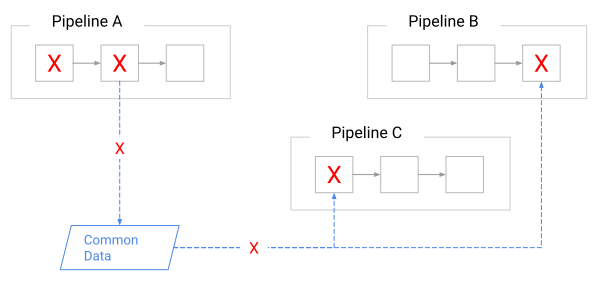
圖 11:下游資料管道失敗,導致使用其輸出內容的管道無法運作。
Google Cloud提供豐富的運算資源和專門工具,可讓您最佳化管道的執行和自動化調度管理。以下各節將會說明這些資源與工具。
涉及的遷移工作
最佳做法是簡化您的自動化調度管理需求。隨著資料管道之間的依附元件數量不斷增加,自動化調度管理作業也會日益複雜。遷移至 Google Cloud 時,您可以檢查自動化調度管理 DAG、找出依附元件,並決定如何最佳化這些依附元件。
建議您一步一步調整依附元件的設定,做法如下:
- 在第一個疊代中,將自動化調度管理作業原封不動地移至 Google Cloud。
- 在後續的疊代作業中分析依附元件,並在適用情況下啟用平行處理功能。
- 最後,將常見工作擷取至所屬的 DAG,以便重新整理自動化調度管理作業。
下一節將以實務範例說明這個方法。
實務範例
假設機構有兩個相關管道:
- 第一個管道會計算整個機構的利潤與損失 (P&L),這個管道很複雜,涉及許多轉換作業。管道的一部分包含計算每月銷售額,這些銷售額會用於後續的轉換步驟,並最終寫入資料表。
- 第二個管道會計算不同產品的逐年與逐月銷售成長幅度,方便行銷部門調整投注於廣告活動的資源。這個管道必須使用 P&L 資料管道先前計算出的每月銷售額資料。
機構希望將 P&L 資料管道的優先順序設為高於行銷管道。不過可惜的是,P&L 這個複雜的資料管道會使用大量資源,因此您無法並行執行其他管道。此外,如果損益管道失敗,行銷管道和其他依附管道就沒有執行所需的資料,必須等待損益管道重試。下圖說明這種情況。

圖 12:複雜的資料管道可能會讓優先順序較低的管道無法運作。
機構正在遷移至 BigQuery,並找出了兩個應用實例 (P&L 和行銷銷售額成長幅度管道),並將這兩個管道新增至遷移待處理工作。規劃下一個疊代時,組織會優先處理損益用途,並將其納入疊代待辦事項,因為該用途受到目前地端部署資源的嚴重限制,且經常造成延遲。另外,機構也新增了部分相依應用實例,行銷應用實例即是其中之一。
遷移團隊執行第一次疊代作業。他們選擇使用重新導向方法,將損益和行銷用途都移至 Google Cloud 。不會變更管道步驟或自動化調度管理。重要差異在於,現在損益管道可以處理幾乎無限的運算能力,因此執行速度比地端部署快得多。接著,管道將每月銷售額資料寫入行銷成長幅度管道使用的 BigQuery 資料表。下圖呈現了這些變更。
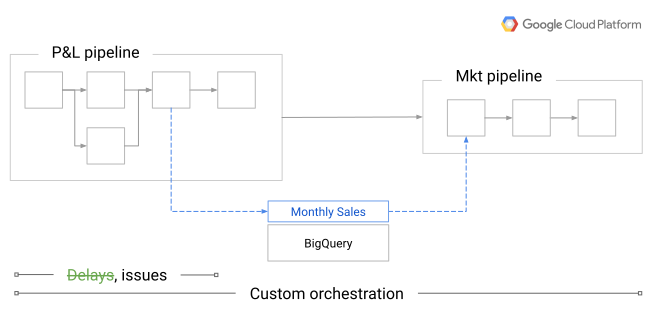
圖 13:使用重新導向方法加快複雜資料管道的運作速度
雖然 Google Cloud 已協助解決非功能性 P&L 問題,但功能性問題仍未解決。在每月銷售額計算程序的前置作業中,某些毫無關聯的工作經常會引發錯誤而導致計算作業無法進行,必須使用這類資料的管道就無法啟動。
在第二次疊代作業中,團隊希望將兩個應用實例新增至疊代待處理工作來提升成效。團隊找出了在 P&L 管道中計算每月銷售額的管道步驟,這些步驟構成了子 DAG,如下圖所示。遷移團隊將子 DAG 複製到行銷管道,讓該管道能獨立於 P&L 執行。 Google Cloud 中有足夠的運算能力,可同時執行兩個管道。
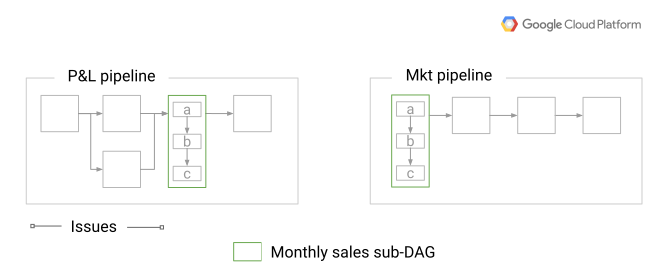
圖 14:機構使用子 DAG 來並行執行的管道。
這麼做的缺點在於複製子 DAG 邏輯會產生程式碼管理方面的負擔,因為團隊必須讓子 DAG 邏輯的兩個副本保持同步。
在第三次疊代作業中,團隊重新查看應用實例,並將每月銷售額子 DAG 擷取至獨立管道。新的每月銷售管道完成後,就會觸發或展開至損益、行銷成長和其他依附管道。這項設定會建立新的整體自動化調度管理 DAG,當中的每個管道都是其子 DAG。
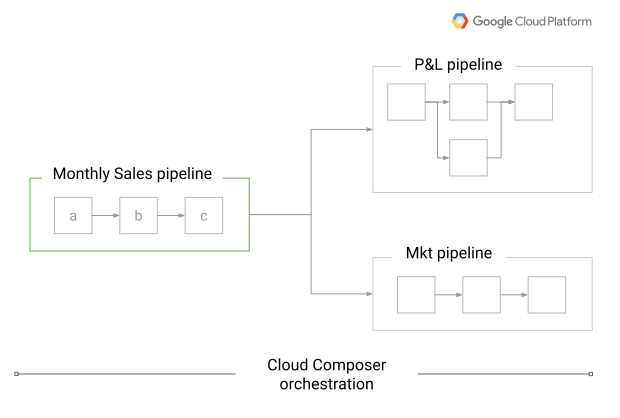
圖 15:整體自動化調度管理 DAG,每個管道都隸屬於各自的子 DAG。
在後續疊代中,遷移團隊可以解決任何剩餘的功能問題,並將管道遷移至使用下列 Google Cloud代管服務等:
- Dataflow:可讓您使用 Beam 模型,將每個資料管道定義為獨立的 DAG。
- Managed Airflow:可將更廣泛的自動化調度管理作業定義為一或多個 Airflow DAG。
雖然 Airflow 原生支援子 DAG,但這項功能可能會限制效能,因此不建議使用。請改用獨立 DAG 搭配 TriggerDagRunOperator 運算子。
後續步驟
進一步瞭解資料倉儲遷移作業的下列步驟:
您也可以瞭解如何從特定資料倉儲技術遷移至 BigQuery: