


從 Oracle 遷移至 BigQuery
本文件提供從 Oracle 遷移至 BigQuery 的概略指南。說明基本的架構差異,並建議如何從在 Oracle RDBMS (包括 Exadata) 上執行的資料倉儲和資料市集遷移至 BigQuery。本文提供的詳細資料也適用於 Exadata、ExaCC 和 Oracle Autonomous Data Warehouse,因為這些服務使用相容的 Oracle 軟體。
本文適用於企業架構師、資料庫管理員、應用程式開發人員和 IT 資安專業人員,協助他們從 Oracle 遷移至 BigQuery,並解決遷移過程中的技術難題。
您也可以使用批次 SQL 翻譯大量遷移 SQL 指令碼,或使用互動式 SQL 翻譯翻譯臨時查詢。這兩項工具都支援 Oracle SQL、PL/SQL 和 Exadata (預先發布版)。
遷移前
為確保資料倉儲遷移作業順利完成,請在專案時間軸初期開始規劃遷移策略。如要瞭解如何有系統地規劃遷移工作,請參閱「遷移內容和方式:遷移架構」。
BigQuery 運算資源規劃
在幕後,BigQuery 的數據分析處理量是以運算單元為單位。BigQuery 運算單元是 Google 專屬的運算能力單位,用於執行 SQL 查詢。
BigQuery 會在查詢執行時持續計算查詢所需的運算單元數量,但會根據公平排程器將運算單元分配給查詢。
規劃 BigQuery 運算單元容量時,您可以選擇下列計價模式:
隨選定價:在隨選定價模式中,BigQuery 會按照實際處理的位元組數 (資料大小) 收取費用,因此您只需為執行的查詢付費。如要進一步瞭解 BigQuery 如何判斷資料大小,請參閱「資料大小計算」。由於運算單元決定了基礎運算能力,您可以根據所需的運算單元數量 (而非處理的位元組數) 支付 BigQuery 使用費用。根據預設, Google Cloud 專案最多只能有 2,000 個運算單元。
以運算資源為基礎的定價模式:採用以運算資源為基礎的定價模式時,您需要購買 BigQuery 運算單元預留項目 (至少 100 個),而非依據查詢處理的位元組數付費。對於企業資料倉儲工作負載,我們建議採用依運算資源計價的模式,因為這類工作負載通常會有多個並行報表和擷取、載入、轉換 (ELT) 查詢,且用量可預測。
為協助您估算運算單元,建議您使用 Cloud Monitoring 設定 BigQuery 監控功能,並使用 BigQuery 分析稽核記錄。許多客戶會使用數據分析 (例如,請參閱數據分析資訊主頁的開放原始碼範例)、Looker 或 Tableau 做為前端,以視覺化方式呈現 BigQuery 稽核記錄資料,特別是各項查詢和專案的運算單元用量。您也可以運用 BigQuery 系統資料表資料,監控各項工作和預留項目的運算單元使用率。如需範例,請參閱 數據分析 資訊主頁的開放原始碼範例。
定期監控及分析運算單元使用率,有助於預估貴組織在 Google Cloud成長時所需的運算單元總數。
舉例來說,假設您一開始預留 4,000 個 BigQuery 運算單元,同時執行 100 項中等複雜度的查詢。如果發現查詢執行計畫的等待時間過長,且資訊主頁顯示運算單元使用率偏高,可能代表需要更多 BigQuery 運算單元來支援工作負載。如要透過一年或三年承諾使用合約自行購買運算單元,可以使用 Google Cloud 控制台或 bq 指令列工具開始使用 BigQuery 預留項目。
如果對目前的方案和上述選項有任何疑問,請與業務代表聯絡。
Google Cloud的安全性
以下各節將說明常見的 Oracle 安全控管機制,以及如何確保資料倉儲在 Google Cloud環境中受到保護。
身分與存取權管理 (IAM)
Oracle 提供使用者、權限、角色和設定檔,用於管理資源存取權。
BigQuery 使用 IAM 管理資源存取權,並提供資源和動作的集中式存取權管理。BigQuery 提供的資源類型包括組織、專案、資料集、資料表和檢視表。在 IAM 政策階層中,資料集是專案的子資源。資料表會繼承所屬資料集的權限。
如要授予資源存取權,請將一或多個角色指派給使用者、群組或服務帳戶。組織和專案角色會影響執行工作或管理專案的能力,而資料集角色則會影響存取或修改專案內資料的能力。
IAM 提供下列類型的角色:
- 預先定義的角色旨在支援常見用途和存取控管模式。預先定義的角色由 Google Cloud管理,可提供特定服務的精細存取權。
基本角色包括擁有者、編輯者和檢視者角色。
自訂角色:根據使用者指定的權限清單,提供精細的存取權限。
如果同時為使用者指派預先定義角色和基本角色,則授予的權限會是各個角色權限的聯集。
資料列層級安全性
Oracle Label Security (OLS) 可限制逐列存取資料。資料列層級安全性的典型用途,是限制銷售人員只能存取自己管理的帳戶。實作資料列層級安全性,即可精細控管存取權。
如要在 BigQuery 中實現資料列層級安全性,您可以使用授權檢視表和資料列層級存取權政策。如要進一步瞭解如何設計及實施這些政策,請參閱「BigQuery 資料列層級安全防護機制簡介」。
全磁碟加密
Oracle 提供透明資料加密 (TDE) 和網路加密,用於加密靜態和傳輸中的資料。TDE 需要 Advanced Security 選項,該選項需另外授權。
無論來源或其他條件為何,BigQuery 預設會加密所有靜態和傳輸中的資料,且無法關閉這項功能。BigQuery 也支援客戶自行管理的加密金鑰 (CMEK),方便使用者在 Cloud Key Management Service 中控管及管理金鑰加密金鑰。如要進一步瞭解 Google Cloud的加密功能,請參閱「預設靜態資料加密」和「傳輸中資料加密」。
資料遮蓋和遮蓋
Oracle 在 Real Application Testing 中使用資料遮蓋和資料遮蓋,可讓您遮蓋 (遮蓋) 應用程式發出的查詢傳回的資料。
BigQuery 支援資料欄層級的動態資料遮蓋功能。您能針對不同使用者群組,選擇性地遮蓋特定資料欄的資料,但這些使用者還是能正常使用該資料欄。
您可以使用 Sensitive Data Protection,在 BigQuery 中識別及遮蓋具敏感性的個人識別資訊 (PII)。
BigQuery 與 Oracle 比較
本節說明 BigQuery 和 Oracle 之間的主要差異。這些重點可協助您找出遷移障礙,並規劃必要的變更。
系統架構
Oracle 和 BigQuery 的主要差異之一,在於 BigQuery 是無伺服器雲端 EDW,具有獨立的儲存和運算層,可根據查詢需求擴充。BigQuery 採用無伺服器架構,因此您不必受限於硬體決策,而是可以透過預留項目,為查詢和使用者要求更多資源。BigQuery 也不需要設定基礎軟體和基礎架構,例如作業系統 (OS)、網路系統和儲存系統,包括資源調度及高可用性。BigQuery 會處理擴充、管理和管理作業。下圖說明 BigQuery 儲存空間階層。

瞭解基礎儲存空間和查詢處理架構,例如儲存空間 (Colossus) 與查詢執行 (Dremel) 之間的分隔,以及Google Cloud 如何分配資源 (Borg),有助於瞭解行為差異,並最佳化查詢效能和成本效益。詳情請參閱 BigQuery、Oracle 和 Exadata 的參考系統架構。
資料和儲存空間架構
資料和儲存空間結構是所有資料分析系統的重要部分,因為這會影響查詢效能、成本、擴充性和效率。
BigQuery 會將資料儲存和運算作業分開,並將資料儲存在 Colossus 中,資料會經過壓縮,並以名為 Capacitor 的欄式格式儲存。
BigQuery 使用 Capacitor,直接對壓縮資料執行作業,不需解壓縮。如上圖所示,BigQuery 提供資料集做為最高層級的抽象層,用於管理資料表的存取權。結構定義和標籤可用於進一步整理資料表。BigQuery 提供分區功能,可提升查詢效能、降低成本,並管理資訊生命週期。儲存空間資源會在使用當下分配,並在您移除資料或捨棄資料表時取消分配。
Oracle 會使用 Oracle 區塊格式,以資料列格式儲存資料,並以區段形式整理。結構定義 (由使用者擁有) 用於整理資料表和其他資料庫物件。自 Oracle 12c 起,多租戶架構可用於在一個資料庫執行個體中建立可插式資料庫,進一步隔離資料。分區可用於提升查詢效能和資訊生命週期作業。Oracle 為獨立和 Real Application Clusters (RAC) 資料庫提供多種儲存選項,例如 ASM、OS 檔案系統和叢集檔案系統。
Exadata 在儲存體單元伺服器中提供最佳化的儲存體基礎架構,並允許 Oracle 伺服器利用 ASM 以透明的方式存取這項資料。Exadata 提供混合分欄壓縮 (HCC) 選項,讓使用者壓縮資料表和分區。
Oracle 需要預先佈建儲存空間容量、仔細調整大小,以及在區段、資料檔案和資料表空間上設定自動遞增。
查詢執行和效能
BigQuery 會在查詢層級管理效能和資源調度,盡可能提高成本效益。BigQuery 採用多種最佳化技術,例如:
- 在記憶體中執行查詢
- 以 Dremel 執行引擎為基礎的多層級樹狀架構
- Capacitor 內建自動儲存空間最佳化功能
- Jupiter 的每秒總對分頻寬為 1 PB
- 自動調度資源管理,提供快速的 PB 規模查詢
BigQuery 會在載入資料時收集資料欄統計資料,並提供診斷查詢計畫和時間資訊。查詢資源會根據查詢類型及複雜度分配。每筆查詢都會使用一些運算單元,這些運算單元是由一定數量的 CPU 與 RAM 組成。
Oracle 提供資料統計資料收集工作。資料庫最佳化工具會使用統計資料,提供最佳執行計畫。索引可能需要用於快速資料列查詢和彙整作業。Oracle 也提供記憶體內資料欄儲存庫,用於記憶體內數據分析。Exadata 提供多項效能改善功能,例如儲存格智慧掃描、儲存體索引、快閃快取,以及儲存體伺服器與資料庫伺服器之間的 InfiniBand 連線。Real Application Clusters (RAC) 可用於實現伺服器高可用性,並使用相同的基礎儲存空間,擴充資料庫 CPU 密集型應用程式。
如要使用 Oracle 最佳化查詢效能,必須仔細考量這些選項和資料庫參數。Oracle 提供多項工具,例如 Active Session History (ASH)、Automatic Database Diagnostic Monitor (ADDM)、Automatic Workload Repository (AWR) 報表、SQL 監控和 Tuning Advisor,以及 Undo 和 Memory Tuning Advisor,可用於調整效能。
靈活的數據分析
在 BigQuery 中,您可以啟用不同的專案、使用者和群組,查詢不同專案中的資料集。查詢執行作業區隔可讓自主團隊在專案中工作,而不會影響其他使用者和專案,方法是將運算單元配額和查詢計費與其他專案和託管資料集的專案區隔開來。
高可用性、備份和災難復原
Oracle 提供 Data Guard 做為災難復原和資料庫複製解決方案。您可以設定 Real Application Clusters (RAC),確保伺服器可用性。您可以設定復原管理員 (RMAN) 備份,用於備份資料庫和封存記錄,以及執行還原和復原作業。Flashback 資料庫功能可用於資料庫閃回,將資料庫倒轉至特定時間點。復原資料表空間會保留資料表快照。您可以根據先前執行的 DML/DDL 作業和復原保留設定,使用閃回查詢和「as of」查詢子句查詢舊快照。在 Oracle 中,資料庫的完整性應在資料表空間內管理,而資料表空間取決於系統中繼資料、復原和對應的資料表空間,因為同步一致對 Oracle 備份很重要,且復原程序應包含完整的原始資料。如果不需要在 Oracle 中使用時間點復原功能,您可以在資料表結構定義層級排定匯出作業。
BigQuery 是全代管服務,與傳統資料庫系統的不同之處在於,BigQuery 具備完整的備份功能。您不必考慮伺服器、儲存空間故障、系統錯誤和實體資料損毀等問題。BigQuery 會根據資料集位置,在不同資料中心複製資料,盡可能提高可靠性和可用性。BigQuery 多區域功能會跨不同區域複製資料,並防範區域內單一可用區無法使用的情況。BigQuery 單一區域功能會在同一區域內的不同可用區複製資料。
BigQuery 可讓您查詢最多七天前的資料表歷來快照,並使用時間回溯功能在兩天內還原已刪除的資料表。您可以使用快照語法 (dataset.table@timestamp) 複製已刪除的資料表 (以便還原)。您也可以從 BigQuery 資料表匯出資料,以滿足其他備份需求,例如從意外的使用者操作中復原。現有資料倉儲 (DWH) 系統採用的備份策略和排程,可用於備份。
批次作業和快照技術可讓您為 BigQuery 採用不同的備份策略,因此不必頻繁匯出未變更的資料表和分區。載入或 ETL 作業完成後,只要匯出分區或資料表的一個備份即可。如要降低備份成本,您可以將匯出檔案儲存在 Cloud Storage Nearline Storage 或 Coldline Storage 中,並定義生命週期政策,在經過一段時間後刪除檔案,具體取決於資料保留需求。
快取
BigQuery 提供每位使用者快取,如果資料未變更,查詢結果會快取約 24 小時。如果結果是從快取擷取,查詢就不會產生費用。
Oracle 提供多種資料和查詢結果快取,例如緩衝區快取、結果快取、Exadata Flash 快取和記憶體內資料欄儲存庫。
連線
BigQuery 會處理連線管理,您不需要進行任何伺服器端設定。BigQuery 提供 JDBC 和 ODBC 驅動程式。您可以使用 Google Cloud 控制台或 bq command-line tool 進行互動式查詢。您可以使用 REST API 和用戶端程式庫,透過程式與 BigQuery 互動。您可以將 Google 試算表直接連結至 BigQuery,並使用 ODBC 和 JDBC 驅動程式連結至 Excel。如需電腦版用戶端,可以使用 DBeaver 等免費工具。
Oracle 提供監聽器、服務、服務處理常式、多項設定和調整參數,以及共用和專屬伺服器,用於處理資料庫連線。Oracle 提供 JDBC、JDBC Thin、ODBC 驅動程式、Oracle Client 和 TNS 連線。RAC 設定需要掃描監聽器、掃描 IP 位址和掃描名稱。
價格和授權
Oracle 會根據資料庫版本和資料庫選項 (例如 RAC、多租戶、Active Data Guard、分區、記憶體內、Real Application Testing、GoldenGate、Spatial and Graph) 的核心數量,收取授權和支援費用。
BigQuery 提供彈性的定價方案,依據儲存空間、查詢和串流資料即時插入用量計費。BigQuery 提供依用量計費模式,適合需要預測特定區域費用和運算單元容量的客戶。用於串流資料即時插入和載入作業的運算單元,不會計入專案運算單元容量。如要決定要為資料倉儲購買多少運算單元,請參閱「BigQuery 容量規劃」。
BigQuery 也會自動將儲存超過 90 天未修改資料的儲存費用減半。
加上標籤中
BigQuery 資料集、資料表和檢視表可使用鍵/值組合加上標籤。標籤可用來區分儲存空間費用和內部交易退單。
監控與稽核記錄
Oracle 提供不同層級和種類的資料庫稽核選項、稽核資料庫和資料庫防火牆功能,這些功能需另外授權。Oracle 提供 Enterprise Manager 監控資料庫。
BigQuery 的資料存取記錄和稽核記錄均使用 Cloud 稽核記錄,且預設為啟用。資料存取記錄會保留 30 天,其他系統事件和管理員活動記錄則會保留 400 天。如需更長的保留期限,可以按照「 Google Cloud中的安全性記錄檔分析」一文所述,將記錄匯出至 BigQuery、Cloud Storage 或 Pub/Sub。如需與現有事件監控工具整合,可以使用 Pub/Sub 匯出,並在現有工具上進行自訂開發,以便從 Pub/Sub 讀取記錄。
稽核記錄包含所有 API 呼叫、查詢陳述式和工作狀態。您可以使用 Cloud Monitoring 監控運算單元分配情形、查詢和儲存的掃描位元組數,以及其他 BigQuery 指標。BigQuery 查詢計畫和時間軸可用於分析查詢階段和效能。
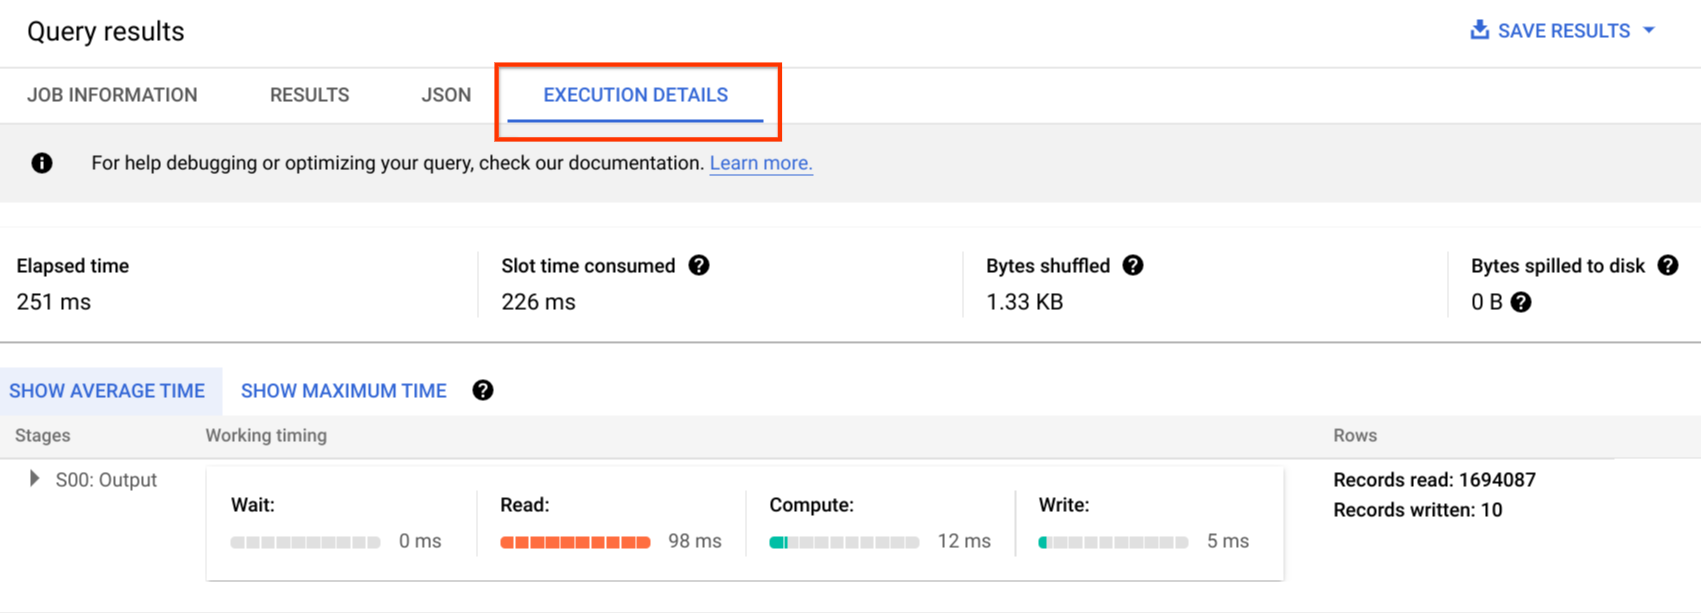
您可以使用錯誤訊息表格,排解查詢工作和 API 錯誤。如要區分每項查詢或工作的運算單元分配,可以使用這項公用程式,這對採用用量計價模式,且有多個專案分散在多個團隊的客戶來說非常實用。
維護、升級和版本
BigQuery 是全代管服務,您不需要進行任何維護或升級。BigQuery 不提供不同版本。升級作業會持續進行,不需要停機,也不會影響系統效能。詳情請參閱版本資訊。
Oracle 和 Exadata 需要您執行資料庫和基礎架構層級的修補、升級和維護作業。Oracle 有許多版本,且預計每年都會發布新的主要版本。雖然新版本回溯相容,但查詢效能、情境和功能可能會有所變動。
有些應用程式可能需要特定版本,例如 10g、11g 或 12c。進行重大資料庫升級時,必須仔細規劃和測試。從不同版本遷移時,查詢子句和資料庫物件可能會有不同的技術轉換需求。
工作負載
Oracle Exadata 支援混合工作負載,包括 OLTP 工作負載。BigQuery 專為數據分析設計,不適合處理 OLTP 工作負載。使用相同 Oracle 的 OLTP 工作負載應遷移至Google Cloud的 Cloud SQL、Spanner 或 Firestore。Oracle 提供額外選項,例如 Advanced Analytics 和 Spatial and Graph。這些工作負載可能需要重新編寫,才能遷移至 BigQuery。詳情請參閱「遷移 Oracle 選項」。
參數和設定
Oracle 提供許多參數,並要求在作業系統、資料庫、RAC、ASM 和監聽器層級設定及調整這些參數,以因應不同的工作負載和應用程式。BigQuery 是全代管服務,您不需要設定任何初始化參數。
限制與配額
Oracle 會根據基礎架構、硬體容量、參數、軟體版本和授權,設定硬性和軟性限制。BigQuery 對特定動作和物件設有配額和限制。
BigQuery 佈建
BigQuery 是平台即服務 (PaaS),也是雲端大規模平行處理資料倉儲。Google 會管理後端,因此容量會自動擴充及縮減,不需使用者介入。因此,與許多 RDBMS 系統不同,BigQuery 不必在使用前佈建資源。BigQuery 會依據您的用量模式動態分配儲存空間和查詢資源。儲存空間資源會在使用當下分配,並在您移除資料或捨棄資料表時取消分配。查詢資源會根據查詢類型及複雜度分配。每項查詢都會使用運算單元。系統會使用最終公平排程器,因此在短時間內,某些查詢可能會取得較高的運算單元配額,但排程器最終會修正這個問題。
以傳統 VM 來說,BigQuery 相當於同時提供以下兩者:
- 以秒計費
- 以秒為單位調整資源
為完成這項工作,BigQuery 會執行下列操作:
- 部署大量資源,避免需要快速擴充。
- 使用多租戶資源,一次可立即分配大量資源,持續數秒。
- 透過規模經濟,有效率地為使用者分配資源。
- 只會針對您執行的工作收費,而非部署的資源,因此您只需為使用的資源付費。
如要進一步瞭解定價,請參閱「瞭解 BigQuery 快速擴充和簡單定價」。
結構定義遷移
如要將資料從 Oracle 遷移至 BigQuery,您必須瞭解 Oracle 資料類型和 BigQuery 對應關係。
Oracle 資料類型和 BigQuery 對應
Oracle 資料類型與 BigQuery 資料類型不同。如要進一步瞭解 BigQuery 資料類型,請參閱官方說明文件。
如要詳細比較 Oracle 和 BigQuery 資料類型,請參閱「Oracle SQL 翻譯指南」。
索引
在許多數據分析工作負載中,會使用資料欄資料表,而非資料列儲存庫。這會大幅增加資料欄作業,並消除批次分析的索引使用。BigQuery 也會以資料欄格式儲存資料,因此不需要索引。如果數據分析工作負載需要單一、小型的資料列存取權,Bigtable 可能是更好的替代方案。如果工作負載需要處理具有強大關聯一致性的交易,Spanner 或 Cloud SQL 是更好的替代方案。
總之,BigQuery 不需要索引,也不提供索引來進行批次分析。您可以使用分區或分群。如要進一步瞭解如何在 BigQuery 中調整及改善查詢效能,請參閱「最佳化查詢效能簡介」。
瀏覽次數
與 Oracle 類似,BigQuery 允許建立自訂檢視表。不過,BigQuery 中的檢視表不支援 DML 陳述式。
materialized view
在一次寫入、多次讀取的報表和工作負載中,materialized view 通常用於縮短報表轉譯時間。
Oracle 提供 materialized view,只要建立及維護資料表來保存查詢結果資料集,即可提高檢視效能。在 Oracle 中,有兩種方式可以重新整理 materialized view:on-commit 和 隨選。
BigQuery 也提供具體化檢視表功能。BigQuery 會運用 materialized view 的預先運算結果,並盡可能只讀取基礎資料表的差異變更,以計算最新結果。
數據分析或其他現代商業智慧工具中的快取功能,也能提升效能,並省去重新執行相同查詢的需求,進而節省成本。
資料表分區
資料表分區廣泛用於 Oracle 資料倉儲。與 Oracle 不同,BigQuery 不支援階層式分區。
BigQuery 實作三種資料表分區,可讓查詢根據分區資料欄指定述詞篩選器,減少掃描的資料量。
- 依擷取時間分區的資料表:根據資料的擷取時間分區。
- 依資料欄分區的資料表:資料表會依據
TIMESTAMP或DATE資料欄分區。 - 依整數範圍分區的資料表:根據整數資料欄分區的資料表。
如要進一步瞭解 BigQuery 中分區資料表的限制和配額,請參閱「分區資料表簡介」。
如果 BigQuery 限制會影響遷移資料庫的功能,請考慮使用資料分割,而非分區。
此外,BigQuery 不支援 EXCHANGE PARTITION、SPLIT PARTITION,或將非分區資料表轉換為分區資料表。
分群
分群功能可有效率地整理及擷取儲存在多個資料欄中,且經常一起存取的資料。不過,Oracle 和 BigQuery 適合叢集化的情況不同。在 BigQuery 中,如果資料表通常會依特定資料欄篩選及匯總,請使用分群。從 Oracle 遷移清單分區或索引組織資料表時,可以考慮使用分群。
臨時資料表
Oracle ETL 管道經常使用臨時資料表。臨時資料表會在使用者工作階段期間保留資料。工作階段結束時,系統會自動刪除這項資料。
BigQuery 會使用臨時資料表,快取未寫入永久資料表的查詢結果。查詢完成後,暫存資料表最多會保留 24 小時。資料表會建立在特殊資料集中,並隨機命名。您也可以建立臨時資料表供自己使用。詳情請參閱「臨時資料表」。
外部資料表
與 Oracle 類似,BigQuery 可讓您查詢外部資料來源。BigQuery 支援直接從外部資料來源查詢資料,包括:
- Amazon Simple Storage Service (Amazon S3)
- Azure Blob 儲存體
- Bigtable
- Spanner
- Cloud SQL
- Cloud Storage
- Google 雲端硬碟
建立資料模型
星狀或雪花狀資料模型可有效率地儲存分析資料,通常用於 Oracle Exadata 的資料倉儲。
反正規化資料表可免除昂貴的彙整作業,在大多數情況下,可為 BigQuery 中的數據分析提供更佳效能。BigQuery 也支援星狀和雪花狀資料模型。如要進一步瞭解 BigQuery 的資料倉儲設計,請參閱「設計結構定義」。
資料列格式與資料欄格式,以及伺服器限制與無伺服器
Oracle 採用資料列格式,將資料表資料列儲存在資料區塊中,因此系統會根據特定資料欄的篩選和匯總,在區塊中擷取不必要的資料欄,用於分析查詢。
Oracle 採用共用所有項目的架構,並指派固定的硬體資源依附元件 (例如記憶體和儲存空間) 給伺服器。這兩項主要因素促成許多資料建模技術的發展,以提升儲存效率和分析查詢效能。星形和雪花形結構定義,以及資料庫建模,都是常見的方法。
BigQuery 採用資料欄格式儲存資料,沒有固定的儲存空間和記憶體限制。這種架構可讓您根據讀取和業務需求,進一步反正規化及設計結構定義,降低複雜度並提高彈性、擴充性和效能。
去標準化
關聯式資料庫正規化的主要目標之一,是減少資料冗餘。雖然這個模型最適合使用資料列格式的關聯式資料庫,但資料去正規化更適合用於資料欄資料庫。如要進一步瞭解反正規化資料的優點,以及 BigQuery 的其他查詢最佳化策略,請參閱「反正規化」。
扁平化現有結構定義的技術
BigQuery 技術結合了資料欄資料存取和處理、記憶體內儲存空間和分散式處理,可提供優質的查詢效能。
設計 BigQuery DWH 結構定義時,以扁平資料表結構建立事實資料表 (將所有維度資料表合併為事實資料表中的單一記錄),儲存空間利用率會比使用多個 DWH 維度資料表更好。除了減少儲存空間用量外,在 BigQuery 中使用扁平資料表,也能減少 JOIN 用量。下圖說明扁平化結構定義的範例。
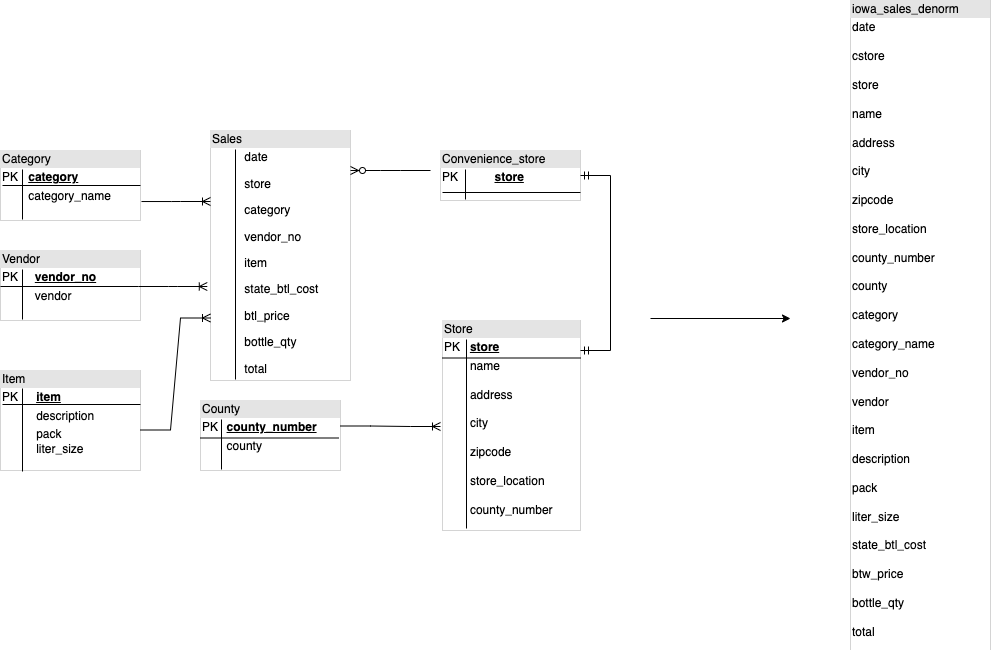
扁平化星形結構定義範例
圖 1 顯示虛構的銷售管理資料庫,其中包含四個資料表:
- 訂單/銷售表格 (事實資料表)
- 員工資料表
- 門市表格
- 客戶表格
銷售資料表的主鍵是 OrderNum,其中也包含其他三個資料表的外鍵。
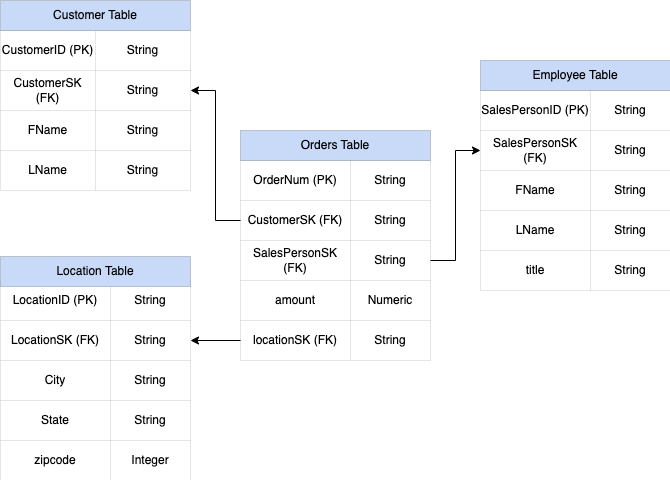
圖 1:星形結構定義中的銷售資料範例
範例資料
訂單/事實資料表內容
| OrderNum | CustomerID | SalesPersonID | amount | Location |
|---|---|---|---|---|
| O-1 | 1234 | 12 | 234.22 | 18 |
| O-2 | 4567 | 1 | 192.10 | 27 |
| O-3 | 12 | 14.66 | 18 | |
| O-4 | 4567 | 4 | 182.00 | 26 |
員工表格內容
| SalesPersonID | FName | LName | title |
|---|---|---|---|
| 1 | Alex | Smith | 銷售專員 |
| 4 | 麗莎 | 陳 | 銷售專員 |
| 12 | John | 陳 | 銷售專員 |
客戶資料表內容
| CustomerID | FName | LName |
|---|---|---|
| 1234 | Amanda | Lee |
| 4567 | Matt | Ryan |
位置表格內容
| Location | city | state | zipcode |
|---|---|---|---|
| 18 | Bronx | NY | 10452 |
| 26 | 山景城 | CA | 90210 |
| 27 | 芝加哥 | IL | 60613 |
使用 LEFT OUTER JOIN 簡化資料的查詢
#standardSQL
INSERT INTO flattened
SELECT
  orders.ordernum,
  orders.customerID,
  customer.fname,
  customer.lname,
  orders.salespersonID,
  employee.fname,
  employee.lname,
  employee.title,
  orders.amount,
  orders.location,
  location.city,
  location.state,
  location.zipcode
FROM orders
LEFT OUTER JOIN customer
  ON customer.customerID = orders.customerID
LEFT OUTER JOIN employee
  ON employee.salespersonID = orders.salespersonID
LEFT OUTER JOIN location
  ON location.locationID = orders.locationID
展開資料的輸出內容
| OrderNum | CustomerID | FName | LName | SalesPersonID | FName | LName | amount | Location | city | state | zipcode |
|---|---|---|---|---|---|---|---|---|---|---|---|
| O-1 | 1234 | Amanda | Lee | 12 | John | Doe | 234.22 | 18 | Bronx | NY | 10452 |
| O-2 | 4567 | Matt | Ryan | 1 | Alex | Smith | 192.10 | 27 | 芝加哥 | IL | 60613 |
| O-3 | 12 | John | Doe | 14.66 | 18 | Bronx | NY | 10452 | |||
| O-4 | 4567 | Matt | Ryan | 4 | Lisa | Doe | 182.00 | 26 | Mountain
查看 |
CA | 90210 |
巢狀和重複欄位
為了從關聯式結構定義 (例如包含維度和事實資料表的星狀和雪花狀結構定義) 設計及建立 DWH 結構定義,BigQuery 提供巢狀和重複欄位功能。因此,您可以採用類似關聯正規化 (或部分正規化) DWH 結構定義的方式保留關係,而不會影響效能。詳情請參閱成效最佳做法。
如要進一步瞭解巢狀和重複欄位的實作方式,請查看 CUSTOMERS 資料表和 ORDER/SALES 資料表的簡單關聯結構定義。這兩個資料表分別代表一個實體,並使用主鍵和外鍵等鍵定義關係,做為使用 JOIN 查詢時資料表之間的連結。BigQuery 巢狀和重複欄位可讓您在單一資料表中,保留實體之間的相同關係。如要實作這項功能,請提供所有客戶資料,並為每位客戶建立巢狀訂單資料。詳情請參閱「指定巢狀和重複資料欄」。
如要將平面結構轉換為巢狀或重複的結構定義,請按照下列方式建立巢狀欄位:
CustomerID、FName、LName巢狀結構至名為Customer的新欄位。SalesPersonID、FName、LName巢狀結構至名為Salesperson的新欄位。LocationID、city、state、zip code巢狀結構至名為Location的新欄位。
OrderNum 和 amount 欄位代表不重複的元素,因此不會巢狀。
您希望結構定義具有足夠的彈性,讓每筆訂單都能有多位客戶:主要客戶和次要客戶。客戶欄位會標示為重複。產生的結構定義如圖 2 所示,說明瞭巢狀和重複欄位。
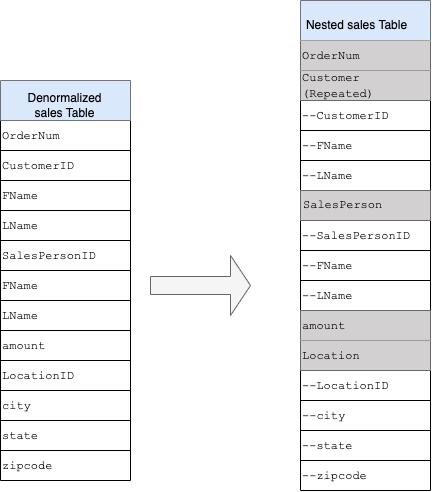
圖 2:巢狀結構的邏輯表示法
在某些情況下,使用巢狀和重複欄位進行反正規化並不會提升效能。如要進一步瞭解限制和規範,請參閱「在資料表結構定義中指定巢狀與重複的資料欄」。
代理鍵
在資料表中,通常會使用不重複索引鍵來識別資料列。Oracle 通常會使用序列來建立這些鍵。在 BigQuery 中,您可以使用 row_number 和 partition by 函式建立代理鍵。詳情請參閱「BigQuery and surrogate keys: a practical approach」(BigQuery 和代理鍵:實用方法)。
追蹤變更和記錄
規劃 BigQuery DWH 遷移作業時,請考量緩慢變化維度 (SCD) 的概念。一般來說,SCD 一詞是指在維度資料表中進行變更 (DML 作業) 的程序。
基於多種原因,傳統資料倉儲會使用不同類型來處理資料變更,並在緩慢變化的維度中保留歷來資料。這些類型用法是因應先前討論的硬體限制和效率需求。由於儲存空間的費用遠低於運算費用,且可無限擴充,因此如果資料備援和重複資料能加快 BigQuery 的查詢速度,建議您採用。您可以使用資料快照技術,將整個資料載入新的每日分區。
角色和使用者專屬檢視畫面
當使用者屬於不同團隊,且只能查看所需記錄和結果時,請使用角色專屬和使用者專屬檢視畫面。
BigQuery 支援column-和資料列層級的安全防護機制。資料欄層級安全防護機制會使用政策標記或資料類型分類,提供機密資料欄的精細存取權。資料列層級安全性:可篩選資料,並根據符合條件的使用者,授予資料表中特定資料列的存取權。
資料遷移
本節提供從 Oracle 遷移資料至 BigQuery 的相關資訊,包括初始載入、變更資料擷取 (CDC),以及 ETL/ELT 工具和方法。
遷移活動
建議您找出適合遷移的用途,分階段執行遷移作業。有多種工具和服務可將資料從 Oracle 遷移至 Google Cloud。雖然這份清單並未詳盡列出所有項目,但確實能讓您瞭解遷移作業的規模和範圍。
從 Oracle 匯出資料:詳情請參閱「初始載入」和「從 Oracle 到 BigQuery 的 CDC 和串流擷取」。ETL 工具可用於初始載入。
資料暫存 (在 Cloud Storage 中):Cloud Storage 是從 Oracle 匯出資料的建議到達位置 (暫存區)。Cloud Storage 專為快速、彈性擷取結構化或非結構化資料而設計。
ETL 程序:詳情請參閱「ETL/ELT 遷移」。
直接將資料載入 BigQuery:您可以直接從 Cloud Storage、透過 Dataflow 或即時串流,將資料載入 BigQuery。需要轉換資料時,請使用 Dataflow。
初始載入
視資料大小和網路頻寬而定,將初始資料從現有 Oracle 資料倉儲遷移至 BigQuery 的方式,可能與增量 ETL/ELT 管道不同。如果資料大小為幾 TB,則可使用相同的 ETL/ELT 管道。
如果資料量不超過幾 TB,則傾印資料並使用 gcloud storage 進行移轉,會比使用類似 JdbcIO 的程式輔助資料庫擷取方法更有效率,因為程式輔助方法可能需要更精細的效能調整。如果資料大小超過數 TB,且資料儲存在雲端或線上儲存空間 (例如 Amazon Simple Storage Service (Amazon S3)),請考慮使用 BigQuery 資料移轉服務。如要進行大規模移轉 (尤其是網路頻寬有限的移轉作業),Transfer Appliance 是實用的選項。
初始載入限制
規劃資料遷移作業時,請考量下列事項:
- Oracle DWH 資料大小:結構定義的來源大小對所選資料移轉方法有重大影響,尤其是資料大小較大 (TB 以上) 時。如果資料大小相對較小,資料移轉程序就能以較少的步驟完成。處理大規模資料會使整體程序更加複雜。
停機時間:決定是否要在遷移至 BigQuery 時停機,是相當重要的考量。如要縮短停機時間,您可以大量載入穩定的歷來資料,並使用 CDC 解決方案,掌握移轉期間發生的變更。
定價:在某些情況下,您可能需要第三方整合服務工具 (例如 ETL 或複製工具),這類工具需要額外授權。
初始資料移轉 (批次)
使用批次方法移轉資料,代表資料會以單一程序持續匯出 (例如將 Oracle DWH 結構定義資料匯出為 CSV、Avro 或 Parquet 檔案,或匯入 Cloud Storage 以在 BigQuery 建立資料集。「ETL/ELT 遷移」中說明的所有 ETL 工具和概念,都可用於初始載入。
如果不想使用 ETL/ELT 工具進行初始載入,可以編寫自訂指令碼,將資料匯出至檔案 (CSV、Avro 或 Parquet),然後使用 gcloud storage、BigQuery 資料移轉服務或 Transfer Appliance,將資料上傳至 Cloud Storage。如要進一步瞭解如何調整大型資料移轉作業的效能和移轉選項,請參閱「移轉大型資料集」。然後將資料從 Cloud Storage 載入 BigQuery。
Cloud Storage 是處理初始資料到達網頁的理想選擇。Cloud Storage 是高可用性且耐用的物件儲存服務,檔案數量沒有限制,而且只需依用量付費。這項服務經過最佳化,可與 BigQuery 和 Dataflow 等其他 Google Cloud 服務搭配使用。
從 Oracle 到 BigQuery 的 CDC 和串流擷取
擷取 Oracle 變更資料的方法有很多種。每個選項都有優缺點,主要在於對來源系統的效能影響、開發和設定需求,以及定價和授權。
記錄式 CDC
Oracle 建議使用 Oracle GoldenGate 擷取重做記錄檔,您可以使用 GoldenGate for Big Data 將記錄檔串流至 BigQuery。GoldenGate 則需要依 CPU 數量授權。如要瞭解價格,請參閱 Oracle Technology 全球價目表。如果可以使用 Oracle GoldenGate for Big Data (已取得授權),則可選擇使用 GoldenGate 建立資料管道,以便移轉資料 (初始載入),然後同步所有資料修改。
Oracle XStream
Oracle 會將每次修訂版本儲存在重做記錄檔中,這些重做檔案可用於 CDC。Oracle XStream Out 是以 LogMiner 為基礎建構,由 Debezium (0.8 版起) 等第三方工具提供,或使用 Striim 等工具進行商業用途。即使未安裝及使用 GoldenGate,使用 XStream API 也必須購買 Oracle GoldenGate 授權。XStream 可讓您在 Oracle 和其他軟體之間有效率地傳播 Streams 訊息。
Oracle LogMiner
LogMiner 不需要特殊授權。您可以使用 Debezium 社群連接器中的 LogMiner 選項。您也可以使用 Attunity、Striim 或 StreamSets 等工具,以商業方式使用。LogMiner 可能會對非常活躍的來源資料庫造成效能影響,如果變更量 (重做大小) 每小時超過 10 GB,請務必謹慎使用,具體取決於伺服器的 CPU、記憶體和 I/O 容量和使用率。
以 SQL 為基礎的 CDC
這就是遞增 ETL 方法,SQL 查詢會根據單調遞增鍵和保留上次修改或插入日期的時間戳記欄,持續輪詢來源資料表是否有任何變更。如果沒有單調遞增鍵,使用精確度較低 (秒) 的時間戳記資料欄 (修改日期),可能會導致記錄重複或資料遺漏,具體情況取決於資料量和比較運算子,例如 > 或 >=。
如要解決這類問題,您可以在時間戳記資料欄中使用更高的精確度,例如六個小數位數 (微秒,這是 BigQuery 支援的最大精確度),也可以在 ETL/ELT 管道中新增簡化工作,具體取決於業務鍵和資料特性。
索引應位於鍵或時間戳記資料欄,以提升擷取效能,並減少對來源資料庫的影響。刪除作業是這種方法的難題,因為應在來源應用程式中以虛刪除方式處理,例如加上刪除標記並更新 last_modified_date。另一種解決方案是使用觸發條件,將這些作業記錄在其他資料表中。
觸發條件
您可以在來源資料表上建立資料庫觸發條件,將變更記錄到影子日誌資料表。日誌資料表可以保留整列資料,追蹤每個資料欄的變更,也可以只保留主鍵和作業類型 (插入、更新或刪除)。接著,您可以使用「SQL 變更資料擷取」一節所述的 SQL 方法擷取變更資料。使用觸發條件可能會影響交易效能,如果儲存完整資料列,單列 DML 作業延遲時間會加倍。如果只儲存主鍵,可以減少這項負擔,但這樣一來,在以 SQL 為基礎的擷取作業中,就必須對原始資料表執行 JOIN 作業,這樣會遺漏中繼變更。
ETL/ELT 遷移
在 Google Cloud上處理 ETL/ELT 的方式有很多種。特定 ETL 工作負載轉換的技術指南不在本文件的範圍內。您可以考慮採用 lift-and-shift 做法,或根據成本和時間等限制,重新架構資料整合平台。如要進一步瞭解如何將資料管道遷移至 Google Cloud ,以及許多其他遷移概念,請參閱「遷移資料管道」。
隨即轉移方法
如果現有平台支援 BigQuery,且您想繼續使用現有的資料整合工具:
- 您可以保留 ETL/ELT 平台,並在 ETL/ELT 工作中,使用 BigQuery 變更必要的儲存階段。
- 如果您也想將 ETL/ELT 平台遷移至 Google Cloud ,可以詢問供應商其工具是否已在 Google Cloud取得授權,如果是,您可以將其安裝在 Compute Engine 上,或查看 Google Cloud Marketplace。
如要瞭解資料整合解決方案供應商,請參閱「BigQuery 合作夥伴」。
重新架構 ETL/ELT 平台
如要重新架構資料管道,強烈建議您考慮使用 Google Cloud 服務。
Cloud Data Fusion
Cloud Data Fusion 是 Google Cloud 上的代管 CDAP,提供視覺化介面,並有多種外掛程式,可用於拖曳和管道開發等工作。Cloud Data Fusion 可用於擷取多種來源系統的資料,並提供批次和串流複製功能。Cloud Data Fusion 或 Oracle 外掛程式可用於擷取 Oracle 資料。BigQuery 外掛程式可用於將資料載入 BigQuery,並處理結構定義更新。
來源和接收器外掛程式都未定義輸出結構定義,且來源外掛程式也使用 select * from 複製新資料欄。
您可以使用 Cloud Data Fusion 的 Wrangle 功能清理及準備資料。
Dataflow
Dataflow 是無伺服器資料處理平台,可自動調度資源,以及處理批次和串流資料。如果 Python 和 Java 開發人員想編寫資料管道程式碼,並在串流和批次工作負載使用相同程式碼,Dataflow 是不錯的選擇。使用 JDBC to BigQuery 範本,從 Oracle 或其他關聯式資料庫擷取資料,並載入 BigQuery。
Managed Service for Apache Airflow
Managed Airflow 是以 Apache Airflow 為基礎建構的全代管工作流程自動化調度管理服務。 Google Cloud 您可以編寫、排定及監控橫跨雲端環境和地端部署資料中心的管道。Managed Airflow 提供運算子和貢獻,可執行多雲端技術,適用於擷取和載入、ELT 轉換和 REST API 呼叫等用途。
Managed Airflow 會使用有向無環圖 (DAG) 排定及自動化調度管理工作流程。如要瞭解一般 Airflow 概念,請參閱「Airflow Apache 概念」。如要進一步瞭解 DAG,請參閱「編寫 DAG (工作流程)」。如需使用 Apache Airflow 的 ETL 最佳做法範例,請參閱使用 Airflow 的 ETL 最佳做法說明文件網站¶。您可以將該範例中的 Hive 運算子替換為 BigQuery 運算子,同樣的概念也適用。
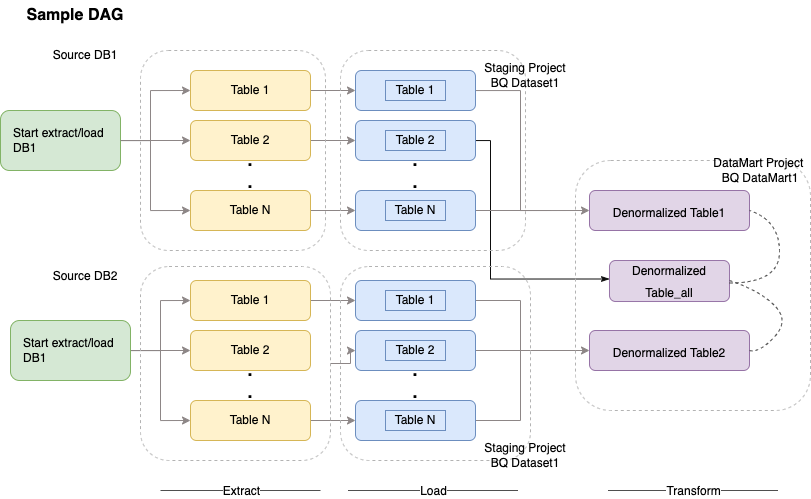
以下程式碼範例是上圖範例 DAG 的高階部分:
    default_args = {
      'owner': 'airflow',
      'depends_on_past': False,
     'start_date': airflow.utils.dates.days_ago(2),
     'email': ['airflow@example.com'],
     'email_on_failure': False,
     'email_on_retry': False,
     'retries': 2,
     'retry_delay': timedelta(minutes=10),
    }
    schedule_interval = "00 01 * * *"
    dag = DAG('load_db1_db2',catchup=False, default_args=default_args,
    schedule_interval=schedule_interval)
    tables = {
      'DB1_TABLE1': {'database':'DB1', 'table_name':'TABLE1'},
      'DB1_TABLE2': {'database':'DB1', 'table_name':'TABLE2'},
      'DB1_TABLEN': {'database':'DB1', 'table_name':'TABLEN'},
      'DB2_TABLE1': {'database':'DB2', 'table_name':'TABLE1'},
      'DB2_TABLE2': {'database':'DB2', 'table_name':'TABLE2'},
      'DB2_TABLEN': {'database':'DB2', 'table_name':'TABLEN'},
    }
    start_db1_daily_incremental_load = DummyOperator(
       task_id='start_db1_daily_incremental_load', dag=dag)
    start_db2_daily_incremental_load = DummyOperator(
       task_id='start_db2_daily_incremental_load', dag=dag)

    load_denormalized_table1 = BigQueryOperator(
       task_id='load_denormalized_table1',
       use_legacy_sql=False,
       write_disposition='WRITE_TRUNCATE',
       allow_large_results=True,
       trigger_rule='all_done',
       bql='''
       #standardSQL
       select
           t1.*,tN.* except (ID)
           from `ingest-project.ingest_db1.TABLE1` as t1
           left join `ingest-project.ingest_db1.TABLEN` as tN on t1.ID = tN.ID
        ''',    destination_dataset_table='datamart-project.dm1.dt1', dag=dag)

        load_denormalized_table2 = BigQueryOperator(
           task_id='load_denormalized_table2',
           use_legacy_sql=False,
           write_disposition='WRITE_TRUNCATE',
           allow_large_results=True,
           trigger_rule='all_done',
        bql='''
        #standardSQL
        select
           t1.*,t2.* except (ID),tN.* except (ID)
           from `ingest-project.ingest_db1.TABLE1` as t1
           left join `ingest-project.ingest_db2.TABLE2` as t2 on t1.ID = t2.ID
           left join `ingest-project.ingest_db2.TABLEN` as tN on t2.ID = tN.ID
        ''',    destination_dataset_table='datamart-project.dm1.dt2', dag=dag)

        load_denormalized_table_all = BigQueryOperator(
           task_id='load_denormalized_table_all',
           use_legacy_sql=False,
           write_disposition='WRITE_TRUNCATE',
           allow_large_results=True,
          trigger_rule='all_done',
        bql='''
        #standardSQL
        select
           t1.*,t2.* except (ID),t3.* except (ID)
           from `datamart-project.dm1.dt1` as t1
           left join `ingest-project.ingest_db1.TABLE2` as t2 on t1.ID = t2.ID
           left join `datamart-project.dm1.dt2` as t3 on t2.ID = t3.ID
        ''',    destination_dataset_table='datamart-project.dm1.dt_all', dag=dag)

        def start_pipeline(database,table,...):
        #start initial or incremental load job here
        #you can write your custom operator to integrate ingestion tool
        #or you can use operators available in composer instead

        for table,table_attr in tables.items():
        tbl=table_attr['table_name']
        db=table_attr['database'])
        load_start = PythonOperator(
        task_id='start_load_{db}_{tbl}'.format(tbl=tbl,db=db),
        python_callable=start_pipeline,
        op_kwargs={'database': db,
        'table':tbl},
        dag=dag
        )

        load_monitor = HttpSensor(
          task_id='load_monitor_{db}_{tbl}'.format(tbl=tbl,db=db),
          http_conn_id='ingestion-tool',
          endpoint='restapi-endpoint/',
          request_params={},
          response_check=lambda response: """{"status":"STOPPED"}""" in
          response.text,
          poke_interval=1,
          dag=dag,
        )

        load_start.set_downstream(load_monitor)

        if table_attr['database']=='db1':
          load_start.set_upstream(start_db1_daily_incremental_load)
        else:
          load_start.set_upstream(start_db2_daily_incremental_load)

        if table_attr['database']=='db1':
          load_monitor.set_downstream(load_denormalized_table1)
        else:
          load_monitor.set_downstream(load_denormalized_table2)
          load_denormalized_table1.set_downstream(load_denormalized_table_all)
          load_denormalized_table2.set_downstream(load_denormalized_table_all)
上述程式碼僅供示範,無法直接使用。
Dataprep by Trifacta
Dataprep 是一項資料服務,可讓您透過圖表探索、清理及準備結構化與非結構化資料,以便用於數據分析、報表和機器學習作業。您會將來源資料匯出為 JSON 或 CSV 檔案,使用 Dataprep 轉換資料,並使用 Dataflow 載入資料。如需範例,請參閱「使用 Dataflow 和 Dataprep 將 Oracle 資料 (ETL) 傳送至 BigQuery」。
Managed Service for Apache Spark
Managed Service for Apache Spark 是 Google 代管的 Hadoop 服務。您可以使用 Sqoop,將 Oracle 和許多關聯式資料庫中的資料匯出至 Cloud Storage,做為 Avro 檔案,然後使用 bq tool 將 Avro 檔案載入 BigQuery。在 Hadoop 上安裝 CDAP 等 ETL 工具,並使用 JDBC 擷取資料,以及使用 Apache Spark 或 MapReduce 轉換資料,是非常常見的做法。
合作夥伴適用的資料遷移工具
擷取、轉換和載入 (ETL) 領域有多家供應商。Informatica、Talend、Matillion、Infoworks、Stitch、Fivetran 和 Striim 等 ETL 市場領導者已與 BigQuery 和 Oracle 深度整合,可協助擷取、轉換、載入資料,以及管理處理工作流程。
ETL 工具已存在多年。某些組織可能會發現,運用現有的可靠 ETL 指令碼投資相當方便。BigQuery 合作夥伴網站列出了部分重要合作夥伴解決方案。何時該選擇合作夥伴工具,而非Google Cloud 內建公用程式,取決於您目前的基礎架構,以及 IT 團隊是否熟悉使用 Java 或 Python 程式碼開發資料管道。
商業智慧 (BI) 工具遷移
BigQuery 支援彈性的商業智慧 (BI) 解決方案套件,可用於製作報表和分析。如要進一步瞭解商業智慧工具遷移和 BigQuery 整合,請參閱「BigQuery 數據分析總覽」。
查詢 (SQL) 翻譯
BigQuery 的 GoogleSQL 支援 SQL 2011 標準,並提供擴充功能,可支援查詢巢狀和重複資料。所有符合 ANSI 標準的 SQL 函式和運算子,只要稍加修改即可使用。如要詳細比較 Oracle 和 BigQuery SQL 語法與函式,請參閱「Oracle 到 BigQuery SQL 翻譯參考資料」。
使用批次 SQL 翻譯大量遷移 SQL 程式碼,或使用互動式 SQL 翻譯翻譯臨時查詢。
遷移 Oracle 選項
本節提供架構建議和參考資料,說明如何轉換使用 Oracle Data Mining、R 和 Spatial and Graph 功能的應用程式。
Oracle Advanced Analytics 選項
Oracle 提供進階分析選項,可用於資料探勘、基本機器學習 (ML) 演算法和 R 語言。進階分析選項需要授權。您可以根據從開發到大規模正式環境的需求,從完整的 Google AI/機器學習產品清單中選擇。
Oracle R Enterprise
Oracle R Enterprise (ORE) 是 Oracle Advanced Analytics 選項的元件,可將開放原始碼 R 統計程式設計語言與 Oracle Database 整合。在標準 ORE 部署中,R 會安裝在 Oracle 伺服器上。
如要處理極大規模的資料或倉儲方法,將 R 與 BigQuery 整合是理想的選擇。您可以使用開放原始碼 bigrquery R 程式庫,將 R 與 BigQuery 整合。
Google 與 RStudio 合作,為使用者提供該領域的先進工具。RStudio 可用於存取 BigQuery 中數 TB 的資料、在 TensorFlow 中擬合模型,以及透過 AI 平台大規模執行機器學習模型。在 Google Cloud中,R 可大規模安裝在 Compute Engine。
Oracle Data Mining
Oracle Data Mining (ODM) 是 Oracle Advanced Analytics 選項的元件,可讓開發人員在 Oracle 上使用 Oracle PL/SQL Developer 建構機器學習模型。
開發人員可透過 BigQuery ML 執行多種模型,例如線性迴歸、二元邏輯迴歸、多元邏輯迴歸、k-means 分群和 TensorFlow 模型匯入。詳情請參閱「BigQuery ML 簡介」。
轉換 ODM 工作可能需要重寫程式碼。您可以選擇全方位的 Google AI 產品,例如 BigQuery ML、AI API (Speech-to-Text、Text-to-Speech、Dialogflow、Cloud Translation、Cloud Natural Language API、Cloud Vision 等),或 Gemini Enterprise Agent Platform。
Vertex AI Workbench 可做為資料科學家的開發環境,Vertex AI 訓練 則可用於大規模執行訓練和評分工作負載。
Spatial and Graph 選項
Oracle 提供 Spatial and Graph 選項,用於查詢幾何圖形和圖表,且需要授權。您可以在 BigQuery 中使用幾何圖形函式,不需額外付費或取得授權,也可以在 Google Cloud中使用其他圖形資料庫。
空間
BigQuery 提供地理空間分析函式和資料類型。詳情請參閱「使用 地理空間分析資料」。Oracle 空間資料類型和函式可轉換為 BigQuery 標準 SQL 中的地理函式。地理位置函式不會在標準 BigQuery 定價之外增加費用。
圖表
JanusGraph 是開放原始碼圖形資料庫解決方案,可使用 Bigtable 做為儲存體後端。詳情請參閱「在 GKE 上執行 JanusGraph 並搭配 Bigtable」。
Neo4j 是另一種圖形資料庫解決方案,以 Google Cloud 服務形式在 Google Kubernetes Engine (GKE) 上執行。
Oracle Application Express
Oracle Application Express (APEX) 應用程式是 Oracle 專屬,需要重新編寫。報表和資料視覺化功能可使用數據分析或 BI Engine 開發,而建立和編輯資料列等應用程式層級功能,則可使用 Cloud SQL 在 AppSheet 上開發,不需編寫程式碼。
後續步驟
- 瞭解如何最佳化工作負載,全面提升效能並降低成本。
- 瞭解如何最佳化 BigQuery 儲存空間。
- 如要瞭解 BigQuery 更新,請參閱版本資訊。
- 請參閱 Oracle SQL 翻譯指南。