


批次載入資料
BigQuery 批次載入功能可讓您透過單一載入工作,將 Cloud Storage 或本機檔案中的資料擷取至新的或現有的資料表。您可以載入 Avro、逗號分隔值 (CSV)、以換行符號分隔的 JSON、ORC 或 Parquet 檔案,以及儲存在 Cloud Storage 中的 Datastore 和 Firestore 匯出資料。如要自動將 Cloud Storage 中的資料定期載入 BigQuery,可以使用 BigQuery 資料移轉服務。
歡迎試用
如果您未曾使用過 Google Cloud,歡迎建立帳戶,親自體驗實際使用 BigQuery 的成效。新客戶還能獲得價值 $300 美元的免費抵免額,用於執行、測試及部署工作負載。
免費試用 BigQuery事前準備
授予 Identity and Access Management (IAM) 角色,讓使用者具備必要權限,可執行本文件中的各項工作,並建立資料集來儲存資料。
所需權限
如要將資料載入 BigQuery,您必須具備 IAM 權限,才能執行載入工作,並將資料載入 BigQuery 資料表和分區。如果您是從 Cloud Storage 載入資料,也需要 IAM 權限,才能存取含有資料的 bucket。
將資料載入 BigQuery 的權限
如要將資料載入新的 BigQuery 資料表或分區,或附加或覆寫現有資料表或分區,您必須具備下列 IAM 權限:
bigquery.tables.createbigquery.tables.updateDatabigquery.tables.updatebigquery.jobs.create
下列各項預先定義的 IAM 角色,都包含將資料載入 BigQuery 資料表或分區所需的權限:
roles/bigquery.dataEditorroles/bigquery.dataOwnerroles/bigquery.admin(包含bigquery.jobs.create權限)bigquery.user(包含bigquery.jobs.create權限)bigquery.jobUser(包含bigquery.jobs.create權限)
此外,如果您具備 bigquery.datasets.create 權限,則可在建立的資料集中,使用載入工作建立及更新資料表。
如要進一步瞭解 BigQuery 的 IAM 角色和權限,請參閱「預先定義的角色和權限」。
從 Cloud Storage 載入資料的權限
如要取得從 Cloud Storage bucket 載入資料所需的權限,請要求管理員授予您 bucket 的儲存空間管理員 (roles/storage.admin) IAM 角色。如要進一步瞭解如何授予角色,請參閱「管理專案、資料夾和組織的存取權」。
這個預先定義的角色具備從 Cloud Storage bucket 載入資料所需的權限。如要查看確切的必要權限,請展開「Required permissions」(必要權限) 部分:
所需權限
您必須具備下列權限,才能從 Cloud Storage bucket 載入資料:
-
storage.buckets.get -
storage.objects.get -
storage.objects.list (required if you are using a URI wildcard)
建立資料集
建立 BigQuery 資料集來儲存資料。
載入 Cloud Storage 中的資料
BigQuery 支援從以下任何一種 Cloud Storage 儲存空間級別載入資料:
- 標準
- Nearline
- Coldline
- 封存
如要瞭解如何將資料載入 BigQuery,請參閱資料格式對應的頁面:
如要瞭解如何設定從 Cloud Storage 到 BigQuery 的週期性載入作業,請參閱「Cloud Storage 移轉作業」。
位置注意事項
資料集建立後即無法變更位置,但您可以複製或手動移動資料集。如需詳細資訊,請參閱:
擷取 Cloud Storage URI
如要從 Cloud Storage 資料來源載入資料,您必須提供 Cloud Storage URI。
Cloud Storage 資源路徑包含 bucket 名稱和物件 (檔案名稱)。舉例來說,如果 Cloud Storage bucket 名為 mybucket,資料檔案名為 myfile.csv,則資源路徑為 gs://mybucket/myfile.csv。
BigQuery 不支援在初始雙斜線後方包含多個連續斜線的 Cloud Storage 資源路徑。Cloud Storage 物件名稱可以包含多個連續斜線 (「/」) 字元。不過,BigQuery 會將多個連續斜線轉換為單一斜線。舉例來說,下列資源路徑雖然在 Cloud Storage 中有效,但在 BigQuery 中無法運作:gs://bucket/my//object//name。
如何擷取 Cloud Storage 資源路徑:
開啟 Cloud Storage 主控台。
瀏覽至含有來源資料的物件 (檔案) 位置。
按一下物件名稱。
「物件詳細資料」頁面隨即開啟。
複製「gsutil URI」欄位中提供的值,開頭為
gs://。
Google Datastore 匯出檔案只能指定一個 URI,而且必須以 .backup_info 或 .export_metadata 結尾。
Cloud Storage URI 的萬用字元支援
如果資料分散在多個檔案中,可以使用星號 (*) 萬用字元選取多個檔案。使用星號萬用字元時,必須遵守下列規則:
- 星號可以出現在物件名稱內或物件名稱結尾。
- 不支援使用多個星號。例如,路徑
gs://mybucket/fed-*/temp/*.csv無效。 - 不支援在 bucket 名稱中使用星號。
範例:
以下範例說明如何選取所有資料夾中開頭為
gs://mybucket/fed-samples/fed-sample的檔案:gs://mybucket/fed-samples/fed-sample*以下範例說明如何只選取名為
fed-samples的資料夾和fed-samples的任何子資料夾中副檔名為.csv的檔案:gs://mybucket/fed-samples/*.csv以下範例說明如何在名為
fed-samples的資料夾中,選取命名模式為fed-sample*.csv的檔案。這個範例不會選取fed-samples子資料夾中的檔案。gs://mybucket/fed-samples/fed-sample*.csv
使用 bq 指令列工具時,您可能需要在某些平台上逸出星號。
從 Cloud Storage 載入 Datastore 或 Firestore 匯出資料時,無法使用星號萬用字元。
限制
從 Cloud Storage bucket 將資料載入 BigQuery 時,須遵守下列限制:
- BigQuery 不保證外部資料來源的資料一致性。如果基礎資料在查詢執行期間遭到變更,可能會導致非預期的行為。
- BigQuery 不支援 Cloud Storage 物件版本管理。如果您在 Cloud Storage URI 中加入世代編號,載入工作就會失敗。
根據 Cloud Storage 來源資料的格式,可能還有其他的限制。如需詳細資訊,請參閱:
從本機檔案載入資料
您可以使用下列任一方式,從可讀取的資料來源 (例如本機電腦) 載入資料:
- Google Cloud 控制台
- bq 指令列工具的
bq load指令 - API
- 用戶端程式庫
使用 Google Cloud 控制台或 bq 指令列工具載入資料時,系統會自動建立載入工作。
從本機資料來源載入資料:
控制台
在 Google Cloud 控制台開啟「BigQuery」頁面。
點選左側窗格中的 「Explorer」。
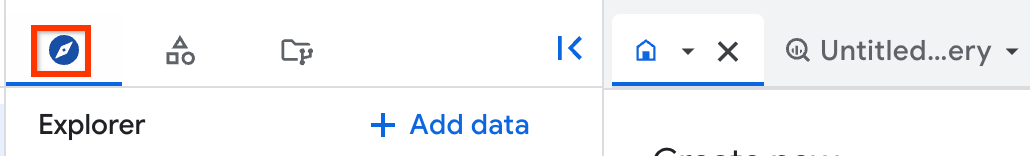
如果沒有看到左側窗格,請按一下 「Expand left pane」(展開左側窗格),開啟窗格。
在「Explorer」窗格中展開專案,點選「Datasets」(資料集),然後選取資料集。
在詳細資料窗格中,按一下「 建立資料表」。
在「Create table」(建立資料表) 頁面的「Source」(來源) 區段中:
- 針對「Create table from」(使用下列資料建立資料表),選取 [Upload] (上傳)。
- 在「選取檔案」部分,點選「瀏覽」。
- 瀏覽至檔案,然後按一下 [Open] (開啟)。請注意,本機檔案不支援萬用字元和以半形逗號分隔的清單。
- 在「File format」(檔案格式) 部分,選取 [CSV]、[JSON (newline delimited)] (JSON (以換行符號分隔))、[Avro]、[Parquet] 或 [ORC]。
在「Create table」(建立資料表) 頁面的「Destination」(目的地) 區段中:
- 在「Project」(專案) 部分,選擇適當的專案。
- 在「Dataset」(資料集) 部分,選擇適當的資料集。
- 在「Table」(資料表) 欄位中,輸入您在 BigQuery 中建立的資料表名稱。
- 確認「Table type」(資料表類型) 設為「Native table」(原生資料表)。
在「Schema」(結構定義) 部分輸入結構定義。
如為 CSV 及 JSON 檔案,您可以勾選 [Auto-detect] (自動偵測) 選項,以啟用結構定義自動偵測功能。您可以在其他支援檔案類型的來源資料中找到結構定義資訊。
您也可以使用下列任一個方式手動輸入結構定義資訊:
按一下 [Edit as text] (以文字形式編輯),然後以 JSON 陣列的形式輸入資料表結構定義:
使用 [Add Field] (新增欄位) 手動輸入結構定義。
在「Advanced options」(進階選項) 區段中選取適合的項目。如要瞭解可用選項,請參閱 CSV 選項和 JSON 選項。
選用:在「Advanced options」(進階選項) 中選擇寫入配置:
- 空白時寫入:只有在資料表空白時才寫入資料。
- 附加至資料表:將資料附加至資料表結尾。這是預設設定。
- 覆寫資料表:在寫入新資料前,清除資料表中的所有現有資料。
點選「建立資料表」。
bq
請使用 bq load 指令來指定 source_format,然後將路徑加入本機檔案中。
(選用) 提供 --location 旗標,並將值設為您的位置。
如果您要在非預設專案中載入資料,請採用下列格式將專案 ID 新增至資料集:PROJECT_ID:DATASET。
bq --location=LOCATION load \
--source_format=FORMAT \
PROJECT_ID:DATASET.TABLE \
PATH_TO_SOURCE \
SCHEMA
更改下列內容:
LOCATION:您的位置。--location是選用旗標。舉例來說,如果您在東京地區使用 BigQuery,就可將該旗標的值設為asia-northeast1。您可以使用 .bigqueryrc 檔案設定位置的預設值。FORMAT:CSV、AVRO、PARQUET、ORC或NEWLINE_DELIMITED_JSON。project_id:您的專案 ID。dataset:現有資料集。table:要載入資料的資料表名稱。path_to_source:本機檔案的路徑。schema:有效的結構定義。結構定義可以是本機 JSON 檔案,也可以在指令中內嵌輸入。您也可以使用--autodetect旗標,而不提供結構定義定義。
此外,您也可以為選項新增旗標,控管 BigQuery 剖析資料的方式。舉例來說,您可以使用 --skip_leading_rows 旗標,忽略 CSV 檔案中的標題列。詳情請參閱「CSV 選項」和「JSON 選項」。
範例:
下列指令會將本機以換行符號分隔的 JSON 檔案 (mydata.json) 載入預設專案中 mydataset 內名為 mytable 的資料表。結構定義定義於名為 myschema.json 的本機結構定義檔案中。
    bq load \
    --source_format=NEWLINE_DELIMITED_JSON \
    mydataset.mytable \
    ./mydata.json \
    ./myschema.json
下列指令會將本機 CSV 檔案 (mydata.csv) 載入 myotherproject 中 mydataset 內名為 mytable 的資料表。結構定義是以內嵌方式定義,格式為 FIELD:DATA_TYPE, FIELD:DATA_TYPE。
    bq load \
    --source_format=CSV \
    myotherproject:mydataset.mytable \
    ./mydata.csv \
    qtr:STRING,sales:FLOAT,year:STRING
下列指令會將本機 CSV 檔案 (mydata.csv) 載入預設專案中 mydataset 內名為 mytable 的資料表。結構定義是使用結構定義自動偵測功能定義。
    bq load \
    --autodetect \
    --source_format=CSV \
    mydataset.mytable \
    ./mydata.csv
C#
在試用這個範例之前,請先按照「使用用戶端程式庫的 BigQuery 快速入門導覽課程」中的 C# 設定操作說明進行操作。詳情請參閱 BigQuery C# API 參考文件。
如要向 BigQuery 進行驗證,請設定應用程式預設憑證。詳情請參閱「設定用戶端程式庫的驗證機制」。
下列程式碼示範如何將本機 CSV 檔案載入新的 BigQuery 資料表。如要載入其他格式的本機檔案,請使用 JobCreationOptions 基礎類別中適當格式的更新選項類別,而非UploadCsvOptions。
Go
在試用這個範例之前,請先按照「使用用戶端程式庫的 BigQuery 快速入門導覽課程」中的 Go 設定操作說明進行操作。詳情請參閱 BigQuery Go API 參考文件。
如要向 BigQuery 進行驗證,請設定應用程式預設憑證。詳情請參閱「設定用戶端程式庫的驗證機制」。
下列程式碼示範如何將本機 CSV 檔案載入新的 BigQuery 資料表。如要載入其他格式的本機檔案,請將NewReaderSource 的 DataFormat 屬性設為適當格式。
Java
在試用這個範例之前,請先按照「使用用戶端程式庫的 BigQuery 快速入門導覽課程」中的 Java 設定操作說明進行操作。詳情請參閱 BigQuery Java API 參考文件。
如要向 BigQuery 進行驗證,請設定應用程式預設憑證。詳情請參閱「設定用戶端程式庫的驗證機制」。
下列程式碼示範如何將本機 CSV 檔案載入新的 BigQuery 資料表。如要載入其他格式的本機檔案,請將 FormatOptions 設為適當格式。
Node.js
在試用這個範例之前,請先按照「使用用戶端程式庫的 BigQuery 快速入門導覽課程」中的 Node.js 設定操作說明進行操作。詳情請參閱 BigQuery Node.js API 參考文件。
如要向 BigQuery 進行驗證,請設定應用程式預設憑證。詳情請參閱「設定用戶端程式庫的驗證機制」。
下列程式碼示範如何將本機 CSV 檔案載入新的 BigQuery 資料表。如要載入其他格式的本機檔案,請將 load 函式的metadata 參數設為適當格式。
PHP
在試用這個範例之前,請先按照「使用用戶端程式庫的 BigQuery 快速入門導覽課程」中的 PHP 設定操作說明進行操作。詳情請參閱 BigQuery PHP API 參考文件。
如要向 BigQuery 進行驗證,請設定應用程式預設憑證。詳情請參閱「設定用戶端程式庫的驗證機制」。
下列程式碼示範如何將本機 CSV 檔案載入新的 BigQuery 資料表。如要載入其他格式的本機檔案,請將 sourceFormat 設為適當格式。
Python
在試用這個範例之前,請先按照「使用用戶端程式庫的 BigQuery 快速入門導覽課程」中的 Python 設定操作說明進行操作。詳情請參閱 BigQuery Python API 參考文件。
如要向 BigQuery 進行驗證,請設定應用程式預設憑證。詳情請參閱「設定用戶端程式庫的驗證機制」。
下列程式碼示範如何將本機 CSV 檔案載入新的 BigQuery 資料表。如要載入其他格式的本機檔案,請將 LoadJobConfig.source_format 屬性設為適當格式。
Ruby
在試用這個範例之前,請先按照「使用用戶端程式庫的 BigQuery 快速入門導覽課程」中的 Ruby 設定操作說明進行操作。詳情請參閱 BigQuery Ruby API 參考文件。
如要向 BigQuery 進行驗證,請設定應用程式預設憑證。詳情請參閱「設定用戶端程式庫的驗證機制」。
下列程式碼示範如何將本機 CSV 檔案載入新的 BigQuery 資料表。如要載入其他格式的本機檔案,請將 Table#load_job 方法的format 參數設為適當格式。
限制
從本機資料來源載入資料時,會受到以下限制:
- 從本機資料來源載入檔案時,不支援萬用字元和逗號分隔清單。檔案必須個別載入。
- 使用 Google Cloud 控制台時,從本機資料來源載入的檔案不得超過 100 MB。如果檔案較大,請從 Cloud Storage 載入。
載入工作容量
與查詢的隨選模式類似,載入工作預設會使用共用的運算單元集區。如果載入工作使用共用集區,工作詳細資料會顯示預留項目 default-pipeline。BigQuery 不保證這個共用集區的可用容量或載入工作處理量。
如要提高處理量,或以可預測的方式控管載入工作的容量,您可以建立運算單元預留項目,並指派專屬 PIPELINE 運算單元來執行載入工作。詳情請參閱「預留項目指派作業」。
載入壓縮與未壓縮資料
如果是 Avro、Parquet 和 ORC 格式,BigQuery 支援載入檔案資料已使用支援轉碼器壓縮的檔案。不過,BigQuery 不支援載入這些格式中本身已壓縮的檔案,例如使用 gzip 公用程式壓縮的檔案。
Avro 二進位格式是載入壓縮資料的建議格式。Avro 資料的載入速度較快,因為即使資料區塊經過壓縮,仍可平行讀取資料。如需支援的壓縮轉碼器清單,請參閱「Avro 壓縮」。
Parquet 二進位格式也是不錯的選擇,因為 Parquet 會對每個資料欄進行編碼,這種高效率的處理方式通常可產生較佳的壓縮比率與較小的檔案。Parquet 檔案也會運用壓縮技術來並行載入資料。如需支援的壓縮轉碼器清單,請參閱「Parquet 壓縮」。
ORC 二進位制格式提供類似於 Parquet 格式的優點。ORC 檔案中的資料能夠快速載入,是因為系統可以平行讀取資料條。每個資料條中的資料列都會按順序載入。如要縮短載入時間,請將資料條帶大小設為約 256 MB 以下。如需支援的壓縮轉碼器清單,請參閱「ORC 壓縮」。
對於其他資料格式 (CSV 以及 JSON) 而言,BigQuery 可以快速載入未壓縮的檔案,甚至比壓縮檔還快,這是因為可以平行讀取未壓縮的檔案。由於未壓縮檔案比較大,使用這種檔案可能會超出頻寬限制,在載入到 BigQuery 之前暫存在 Cloud Storage 的資料成本也比較高。請注意,無論是已壓縮還是未壓縮的檔案,都無法保證行的排序。建議您先評估自己的使用情況,再決定要採行哪一種做法。
一般來說,如果頻寬有限,請先使用 gzip 壓縮 CSV 和 JSON 檔案,再上傳至 Cloud Storage。將資料載入 BigQuery 時,CSV 和 JSON 檔案僅支援 gzip 檔案壓縮類型。如果載入速度對應用程式很重要,且您有大量頻寬可載入資料,請不要壓縮檔案。
附加或覆寫資料表
如要在資料表中載入額外資料,您可以指定來源檔案或附加查詢結果。如果資料的結構定義與目標資料表或分區的結構定義不符,您可以在附加或覆寫時更新目標資料表或分區的結構定義。
如果您在附加資料時更新結構定義,BigQuery 可讓您:
- 新增欄位
- 將
REQUIRED欄位放寬為NULLABLE
如果您是要覆寫資料表,系統一定會覆寫結構定義。覆寫表格時,結構定義更新不受限制。
在 Google Cloud 控制台,使用「Write preference」(寫入偏好設定) 選項,指定從來源檔案或查詢結果載入資料時要採取的動作。bq 指令列工具和 API 包含下列選項:
| 主控台選項 | bq 工具旗標 | BigQuery API 屬性 | 說明 |
|---|---|---|---|
| Write if empty | 無 | WRITE_EMPTY | 資料表空白時才會寫入資料。 |
| 附加到資料表 | --noreplace 或 --replace=false。如果您沒有指定 --replace,預設值就是附加 |
WRITE_APPEND | (預設值) 將資料附加至資料表尾端。 |
| 覆寫資料表 | --replace 或 --replace=true |
WRITE_TRUNCATE | 清除資料表中所有現有的資料後再寫入新資料。 |
配額政策
如要瞭解批次載入資料的配額政策,請參閱「配額與限制」頁面的「載入工作」一節。
查看目前的配額用量
您可以執行 INFORMATION_SCHEMA 查詢,查看指定時間範圍內執行的工作中繼資料,瞭解目前查詢、載入、擷取或複製工作的使用量。您可以比較目前用量與配額限制,判斷特定類型工作的配額用量。以下查詢範例使用 INFORMATION_SCHEMA.JOBS 檢視表,依專案列出查詢、載入、擷取和複製工作的數量:
SELECT
  sum(case  when job_type="QUERY" then 1 else 0 end) as QRY_CNT,
  sum(case  when job_type="LOAD" then 1 else 0 end) as LOAD_CNT,
  sum(case  when job_type="EXTRACT" then 1 else 0 end) as EXT_CNT,
  sum(case  when job_type="COPY" then 1 else 0 end) as CPY_CNT
FROM `region-REGION_NAME`.INFORMATION_SCHEMA.JOBS_BY_PROJECT
WHERE date(creation_time)= CURRENT_DATE()
定價
使用共用運算單元集區將資料批次載入 BigQuery,不需支付任何費用。詳情請參閱「BigQuery 資料擷取定價」。
如果嘗試從 Cloud Storage bucket 載入資料,但 bucket 與目的地 BigQuery 資料集位於不同位置,則須支付資料移轉費用。
用途範例
假設有一個夜間批次處理管道,必須在固定期限內完成。資料必須在這個期限前準備就緒,才能由另一個批次處理程序進一步處理,產生要傳送給監管機構的報表。這種用途常見於金融等受監管的產業。
透過載入工作批次載入資料是這個用途的正確做法,因為只要能趕上期限,就不必擔心延遲問題。確認 Cloud Storage bucket 符合地點規定,可將資料載入 BigQuery 資料集。
BigQuery 載入工作的結果是不可分割的,也就是說,系統會插入所有記錄,或是不插入任何記錄。最佳做法是,在單一載入工作中插入所有資料時,使用 JobConfigurationLoad 資源的 WRITE_TRUNCATE 處置方式建立新資料表。重試失敗的載入工作時,這項功能非常重要,因為用戶端可能無法區分失敗的工作,以及因將成功狀態傳回用戶端等原因而導致的失敗。
假設要擷取的資料已成功複製到 Cloud Storage,只要使用指數輪詢重試,即可解決擷取失敗的問題。
建議您不要讓夜間批次工作達到預設配額 (每個資料表每天 1,500 次載入),即使重試也一樣。以遞增方式載入資料時,預設配額足以每 5 分鐘執行一次載入工作,且平均每項工作至少有 1 次重試的未消耗配額。