


במסמך הזה מוצגת ארכיטקטורה לדוגמה שאפשר להשתמש בה כדי לתכנן את התשתית להרצת אפליקציית AI גנרטיבי עם יצירה משולבת-אחזור (RAG) באמצעות Google Kubernetes Engine (GKE), Cloud SQL וכלים בקוד פתוח כמו Ray, Hugging Face ו-LangChain. כדי לעזור לכם להתנסות בארכיטקטורה לדוגמה, ב-GitHub יש אפליקציה לדוגמה והגדרות של Terraform.
המסמך הזה מיועד למפתחים שרוצים לפתח ולפרוס במהירות אפליקציות מבוססות-AI גנרטיבי עם יכולות RAG, באמצעות כלים ומודלים בקוד פתוח. הוא מיועד למשתמשים עם ניסיון ב-GKE וב-Cloud SQL, ועם הבנה בסיסית של AI, למידת מכונה (ML) ומודלים גדולים של שפה (LLM). במסמך הזה לא מוסבר איך לעצב ולפתח אפליקציה של AI גנרטיבי.
ארכיטקטורה
בתרשים הבא מוצגת סקירה כללית של ארכיטקטורה לאפליקציית AI גנרטיבי עם יכולות RAG ב- Google Cloud:
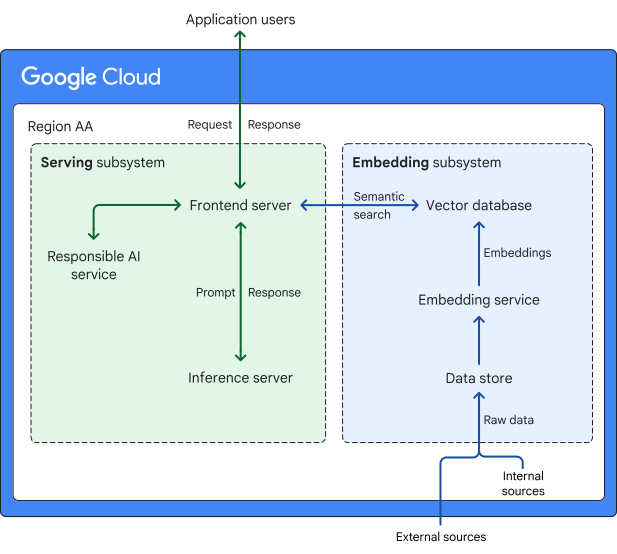
הארכיטקטורה מכילה תת-מערכת להצגה ותת-מערכת להטמעה.
- תת-המערכת להצגת מודעות מטפלת בתהליך הבקשה-תגובה בין האפליקציה למשתמשים שלה. תת-המערכת כוללת שרת קצה קדמי, שרת הסקה ושירות AI אחראי (RAI). תת-המערכת להצגת מודעות מקיימת אינטראקציה עם תת-המערכת להטמעה דרך מסד נתונים וקטורי.
- תת-המערכת להטמעה מאפשרת את יכולת ה-RAG בארכיטקטורה. תת-המערכת הזו מבצעת את הפעולות הבאות:
- הטמעת נתונים ממקורות נתונים ב- Google Cloud, באתר המקומי ובפלטפורמות ענן אחרות.
- ממיר את הנתונים שנטמעו לוקטורים מוטמעים.
- שומר את ההטמעות במסד נתונים וקטורי.
התרשים הבא מציג תצוגה מפורטת של הארכיטקטורה:
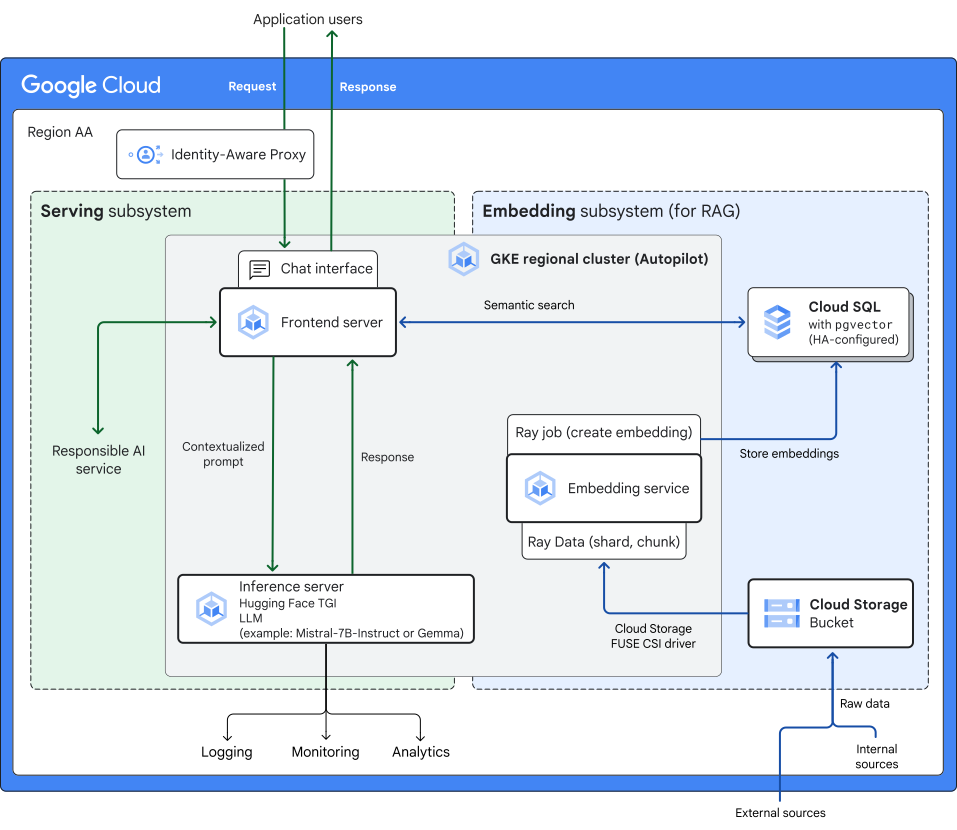
כמו שמוצג בתרשים הקודם, שרת החזית, שרת ההסקה ושירות ההטמעה פרוסים באשכול GKE אזורי במצב Autopilot. הנתונים של RAG נקלטים דרך קטגוריה של Cloud Storage. הארכיטקטורה משתמשת במכונה של Cloud SQL ל-PostgreSQL עם התוסף pgvector כדי לאחסן וקטורים של הטמעות ולבצע חיפושים סמנטיים.
בקטעים הבאים מתוארים הרכיבים וזרימת הנתונים בכל תת-מערכת של הארכיטקטורה.
תת-מערכת להטמעה
זהו תהליך העברת הנתונים בתת-המערכת של ההטמעה:
- נתונים ממקורות חיצוניים ופנימיים מועלים לקטגוריה של Cloud Storage על ידי משתמשים אנושיים או באופן פרוגרמטי. הנתונים שהועלו יכולים להיות בקבצים, במסדי נתונים או בנתונים בסטרימינג.
- (לא מוצג בדיאגרמת הארכיטקטורה). פעילות העלאת הנתונים מפעילה אירוע שמתפרסם בשירות העברת הודעות כמו Pub/Sub. שירות ההודעות שולח התראה לשירות ההטמעה.
- כששירות ההטמעה מקבל התראה על אירוע של העלאת נתונים, הוא מבצע את הפעולות הבאות:
- אחזור נתונים מהקטגוריה של Cloud Storage באמצעות מנהל התקן ה-CSI של Cloud Storage FUSE.
- קורא את הנתונים שהועלו ומעבד אותם מראש באמצעות Ray Data. העיבוד המקדים יכול לכלול חלוקה של הנתונים לחלקים והמרה שלהם לפורמט שמתאים ליצירת הטמעות.
- מריץ משימת Ray כדי ליצור וקטורים של הטמעות מהנתונים שעברו עיבוד מראש, באמצעות מודל בקוד פתוח שנפרס באותו אשכול.
- כתיבת וקטורי ההטמעה במסד הנתונים הווקטורי של Cloud SQL ל-PostgreSQL.
כמו שמתואר בקטע הבא, כשמערכת המשנה להצגת מודעות מעבדת בקשות של משתמשים, היא משתמשת בווקטורים של ההטמעה כדי לאחזר נתונים רלוונטיים שספציפיים לדומיין.
תת-מערכת להצגת מודעות
זהו תהליך הבקשה והתגובה בתת-המערכת להצגת מודעות:
- משתמש שולח בקשה בשפה טבעית לשרת קצה קדמי דרך ממשק צ'אט מבוסס-אינטרנט. שרת הקצה הקדמי פועל ב-GKE.
- שרת החזית מריץ תהליך LangChain שמבצע את הפעולות הבאות:
- ממיר את הבקשה בשפה טבעית לווקטורים של הטמעה באמצעות אותו מודל ואותם פרמטרים שבהם משתמש שירות ההטמעה.
- אחזור נתוני קרקוע רלוונטיים באמצעות חיפוש סמנטי של ההטמעות במסד הנתונים הווקטורי.
- יוצר הנחיה מבוססת-הקשר על ידי שילוב של הבקשה המקורית עם נתוני ה-grounding שאוחזרו.
- שליחת ההנחיה עם ההקשר לשרת ההסקה שפועל ב-GKE.
- שרת ההסקה משתמש במסגרת להצגת מודעות Hugging Face TGI כדי להציג מודל פתוח כמו Mistral-7B-Instruct או Gemma.
ה-LLM יוצר תשובה להנחיה, ושרת ההסקה שולח את התשובה לשרת החזיתי.
אתם יכולים לאחסן ולראות יומנים של פעילות הבקשה-תגובה ב-Cloud Logging, ולהגדיר מעקב מבוסס-יומנים באמצעות Cloud Monitoring. אפשר גם לטעון את התשובות שנוצרו ל-BigQuery כדי לנתח אותן אופליין.
שרת החזית מפעיל שירות RAI כדי להחיל על התשובה את מסנני הבטיחות הנדרשים. אתם יכולים להשתמש בכלים כמו Sensitive Data Protection ו-Cloud Natural Language API כדי לגלות, לסנן, לסווג ולהסיר פרטי זיהוי מתוכן רגיש בתשובות.
שרת החזית שולח את התגובה המסוננת למשתמש.
המוצרים שהשתמשו בהם
בטבלה הבאה מפורטים מוצרי Google Cloud ומוצרי הקוד הפתוח שמשמשים בארכיטקטורה שלמעלה:
Google Cloud מוצרים
- Google Kubernetes Engine (GKE): שירות Kubernetes שמאפשר לפרוס ולהפעיל אפליקציות בקונטיינרים בקנה מידה נרחב באמצעות התשתית של Google.
- Cloud Storage: מאגר אובייקטים ללא הגבלה ובעלות נמוכה, לסוגי נתונים שונים. אפשר לגשת לנתונים מתוך Google Cloudומחוץ לו, והם משוכפלים במיקומים שונים כדי ליצור יתירות.
- Cloud SQL: שירות מנוהל של מסד נתונים רלציוני, שבעזרתו אפשר להקצות, להפעיל ולנהל את מסדי הנתונים של MySQL, PostgreSQL ו-SQL Server ב- Google Cloud.
מוצרים בקוד פתוח
- Hugging Face Text Generation Inference (TGI): ערכת כלים לפריסה ולהצגה של מודלים גדולים של שפה (LLM).
- Ray: מסגרת מחשוב מאוחדת בקוד פתוח שעוזרת להרחיב את עומסי העבודה של AI ו-Python.
- LangChain: מסגרת לפיתוח ולפריסה של אפליקציות שמבוססות על מודלים גדולים של שפה (LLM).
תרחישים לדוגמה
RAG היא שיטה יעילה לשיפור איכות הפלט שנוצר ממודל שפה גדול (LLM). בקטע הזה מפורטות דוגמאות לתרחישים שבהם אפשר להשתמש באפליקציות של AI גנרטיבי עם יכולות RAG.
המלצות מותאמות אישית על מוצרים
אתר קניות אונליין יכול להשתמש בצ'אט בוט שמבוסס על LLM כדי לעזור ללקוחות למצוא מוצרים או לקבל עזרה שקשורה לקניות. אפשר להוסיף לשאלות של המשתמש נתונים היסטוריים על דפוסי הקנייה והאינטראקציה שלו עם האתר. הנתונים יכולים לכלול ביקורות ומשובים של משתמשים שמאוחסנים במאגר נתונים לא מובנים, או מדדים שקשורים לחיפוש שמאוחסנים במחסן נתונים לצורכי ניתוח התנהגות המשתמשים. לאחר מכן, מודל ה-LLM יכול לעבד את השאלה המורחבת כדי ליצור תשובות מותאמות אישית שיכולות להיות מושכות ומשכנעות יותר למשתמש.
מערכות סיוע קליניות
רופאים בבתי חולים צריכים לבדוק ולסכם את המידע הרפואי של המטופלים כדי לקבל החלטות מושכלות לגבי הטיפול. אפליקציית AI גנרטיבי שמשתמשת במודל בסיס רפואי כמו MedGemma יכולה לעזור לרופאים לסכם הערות קליניות ולבדוק את ההקשר הרפואי. התשובות שהאפליקציה יוצרת יכולות להיות מעוגנות בנתונים בסיכומי מצב בריאותי היסטוריים של מטופלים, על ידי הוספת הקשר לפרומפטים באמצעות נתונים ממסד הנתונים של התיקים הרפואיים האלקטרוניים (EHR) של בית החולים או ממאגר ידע חיצוני כמו PubMed.
מחקר משפטי יעיל
מחקר משפטי מבוסס-AI גנרטיבי מאפשר לעורכי דין לשלוח במהירות שאילתות על כמויות גדולות של חוקים ופסקי דין, כדי לזהות תקדימים משפטיים רלוונטיים או לסכם מושגים משפטיים מורכבים. כדי לשפר את תוצאות המחקר, אפשר להוסיף להנחיות של עורך הדין נתונים שאוחזרו ממאגר המידע הקנייני של משרד עורכי הדין, שכולל חוזים, תכתובות משפטיות קודמות ורשומות פנימיות של תיקים. הגישה הזו עוזרת ליצור תשובות שרלוונטיות לתחום המשפטי שבו עורך הדין מתמחה.
חלופות לעיצוב
בקטע הזה מוצגות גישות עיצוב חלופיות שאפשר להשתמש בהן באפליקציית ה-AI הגנרטיבי עם יכולות RAG ב- Google Cloud.
חיפוש וקטורי מנוהל
אם אתם צריכים ארכיטקטורה שמשתמשת במוצר חיפוש וקטורי מנוהל, אתם יכולים להשתמש ב-Gemini Enterprise Agent Platform ובחיפוש וקטורי, שמספק תשתית להצגת מודעות שמותאמת לחיפוש וקטורי בקנה מידה גדול מאוד. מידע נוסף זמין במאמר תשתית RAG ל-AI גנרטיבי באמצעות Gemini Enterprise Agent Platform וחיפוש וקטורי.
ארכיטקטורות RAG אחרות
מידע על אפשרויות ארכיטקטורה נוספות לעומסי עבודה של RAG זמין במאמר AI גנרטיבי עם RAG.
שיקולים שקשורים לעיצוב
בקטע הזה מוסבר איך לפתח ולהפעיל ארכיטקטורת AI גנרטיבי עם יכולות RAG שמתארחת ב-GKE, ועומדת בדרישות הספציפיות שלכם בנושאי אבטחה ותאימות, אמינות, עלות וביצועים. ההנחיות בקטע הזה הן חלקיות. בהתאם לדרישות הספציפיות של האפליקציה ולמוצרים ולתכונות של Google Cloud שבהם אתם משתמשים, יכול להיות שתצטרכו להביא בחשבון גורמי תכנון ופשרות נוספים.
להנחיות עיצוב שקשורות לכלים בקוד פתוח בארכיטקטורה לדוגמה, קראו את המסמכים של הכלים האלה.
אבטחה, פרטיות ותאימות
בקטע הזה מתוארים הגורמים שצריך להביא בחשבון כשמתכננים ויוצרים אפליקציית AI גנרטיבי עם יכולות RAG ב- Google Cloud , שעומדת בדרישות האבטחה, הפרטיות והתאימות שלכם.
| מוצר | שיקולים שקשורים לעיצוב |
|---|---|
| GKE |
במצב אוטומטי של הפעלה, GKE מגדיר מראש את האשכול ומנהל את הצמתים בהתאם לשיטות המומלצות לאבטחה, כך שתוכלו להתמקד באבטחה הספציפית לעומס העבודה. מידע נוסף זמין במאמר אמצעי האבטחה של GKE Autopilot. כדי לשפר את בקרת הגישה לאפליקציות שפועלות ב-GKE, אתם יכולים להשתמש בשרת proxy לאימות זהויות (IAP). IAP משתלב עם משאב ה-Ingress של GKE ומוודא שרק משתמשים מאומתים עם התפקיד הנכון בניהול הזהויות והרשאות הגישה (IAM) יכולים לגשת לאפליקציות. מידע נוסף זמין במאמר הפעלת IAP ל-GKE. כברירת מחדל, הנתונים שלכם ב-GKE מוצפנים במצב מנוחה ובמעבר באמצעות Google-owned and Google-managed encryption keys. כדי להוסיף שכבת אבטחה לנתונים רגישים, אתם יכולים להצפין נתונים בשכבת האפליקציה באמצעות מפתח שבבעלותכם ובניהולכם ב-Cloud KMS. מידע נוסף זמין במאמר הצפנת סודות בשכבת האפליקציה. אם אתם משתמשים באשכול GKE רגיל, אתם יכולים להשתמש ביכולות הנוספות הבאות להצפנת נתונים:
|
| Cloud SQL |
לא צריך להיות אפשר לגשת למכונה של Cloud SQL בארכיטקטורה מהאינטרנט הציבורי. אם צריך גישה חיצונית למכונה של Cloud SQL, אפשר להצפין את החיבורים החיצוניים באמצעות SSL/TLS או המחבר Cloud SQL Auth Proxy. המחבר של שרת ה-proxy לאימות מספק הרשאת חיבור באמצעות IAM. המחבר משתמש בחיבור TLS 1.3 עם הצפנת AES של 256 ביט כדי לאמת את זהויות הלקוח והשרת ולהצפין את תנועת הנתונים. בחיבורים שנוצרו באמצעות Java, Python, Go או Node.js, השתמשו במחבר השפה המתאים במקום במחבר Auth Proxy. כברירת מחדל, ב-Cloud SQL נעשה שימוש במפתחות להצפנת נתונים (DEK) ובמפתחות להצפנת מפתחות הצפנה (KEK) שבבעלות Google ובניהולה, כדי להצפין נתונים במצב מנוחה. אם אתם צריכים להשתמש במפתחות KEK שאתם שולטים בהם ומנהלים אותם, אתם יכולים להשתמש במפתחות הצפנה בניהול הלקוח (CMEK). כדי למנוע גישה לא מורשית ל-Cloud SQL Admin API, אתם יכולים ליצור גבולות גזרה לשירות באמצעות VPC Service Controls. במאמר סקירה כללית על מיקום אחסון הנתונים מוסבר איך להגדיר את Cloud SQL כדי לעמוד בדרישות של מיקום אחסון הנתונים. |
| Cloud Storage |
כברירת מחדל, הנתונים שמאוחסנים ב-Cloud Storage מוצפנים באמצעות Google-owned and Google-managed encryption keys. במקרה הצורך, אתם יכולים להשתמש במפתחות CMEK או במפתחות משלכם שאתם מנהלים באמצעות שיטת ניהול חיצונית, כמו מפתחות הצפנה באספקת הלקוח (CSEK). למידע נוסף, קראו את המאמר אפשרויות להצפנת נתונים. ב-Cloud Storage יש שתי שיטות לשליטה בגישה של משתמשים לקטגוריות ולאובייקטים: IAM ורשימות של בקרת גישה (ACL). ברוב המקרים, מומלץ להשתמש ב-IAM, שמאפשר להעניק הרשאות ברמת הקטגוריה והפרויקט. למידע נוסף, קראו את המאמר סקירה כללית על בקרת הגישה. יכול להיות שהנתונים שאתם טוענים לתת-המערכת של ההטמעה דרך Cloud Storage כוללים מידע רגיש. כדי להגן על הנתונים האלה, אתם יכולים להשתמש ב-Sensitive Data Protection כדי לגלות, לסווג ולהסיר פרטי זיהוי מהנתונים. מידע נוסף זמין במאמר שימוש ב-Sensitive Data Protection עם Cloud Storage. כדי לצמצם את הסיכון לזליגת נתונים מ-Cloud Storage, אתם יכולים ליצור גבולות גזרה לשירות באמצעות VPC Service Controls. Cloud Storage עוזר לכם לעמוד בדרישות של מיקום אחסון הנתונים. הנתונים מאוחסנים או משוכפלים באזורים שאתם מציינים. |
| כל המוצרים בארכיטקטורה הזו |
יומני הביקורת של פעילות אדמין מופעלים כברירת מחדל בכל Google Cloud השירותים שמשמשים בארכיטקטורה לדוגמה הזו. אפשר לגשת ליומנים דרך Cloud Logging. אפשר להשתמש ביומנים האלה כדי לעקוב אחרי קריאות ל-API או פעולות אחרות שמשנות את ההגדרות או את המטא-נתונים של משאבי Google Cloud . יומני הביקורת של גישה לנתונים מופעלים כברירת מחדל גם לכל שירותי Google Cloud בארכיטקטורה הזו. אתם יכולים להשתמש ביומנים האלה כדי לעקוב אחרי:
אחרי שפורסים את האפליקציה ב- Google Cloud, אפשר לקבל המלצות לשיפור האבטחה באמצעות Active Assist. בודקים את ההמלצות ומיישמים אותן בהתאם לסביבה שלכם. איך מוצאים המלצות ב-Active Assist |
במאמר נקודת מבט על AI ו-ML: אבטחה ב-Well-Architected Framework מפורטים עקרונות אבטחה והמלצות ספציפיים לעומסי עבודה של AI ו-ML.
אמינות
בקטע הזה מתוארים גורמי התכנון שצריך להביא בחשבון כדי לבנות ולהפעיל תשתית אמינה לאפליקציית AI גנרטיבי עם יכולות RAG ב-Google Cloud.
| מוצר | שיקולים שקשורים לעיצוב |
|---|---|
| GKE |
במצב אוטומטי שמשמש בארכיטקטורה הזו, GKE מספק את יכולות האמינות המובנות הבאות:
כדי לוודא שיש מספיק קיבולת GPU כשצריך להתאים אוטומטית לעומס את אשכול GKE, אתם יכולים ליצור מקומות שמורים ולהשתמש בהם. הזמנת מקום מבטיחה קיבולת באזור ספציפי למשאב מסוים. הזמנה יכולה להיות ספציפית לפרויקט, או משותפת לכמה פרויקטים. אתם מחויבים על משאבים שמורים גם אם הם לא הוקצו או לא היו בשימוש. מידע נוסף מופיע במאמר צריכת משאבים שמורים של תחום מוגדר. כדי לקצר את זמן ההפעלה של שרת ההסקה, אפשר להשתמש בשיטות כמו טעינת נתונים שעברו אופטימיזציה, סטרימינג של קובצי אימג' וצמתים שמופעלים במהירות. מידע נוסף זמין במאמר אופטימיזציה של זמן האחזור בהפעלה במצב התחלתי (cold start) של עומסי עבודה להסקת מסקנות. |
| Cloud SQL |
כדי לוודא שמסד הנתונים הווקטורי עמיד בפני כשלים במסד הנתונים והפסקות חשמל באזור, צריך להשתמש במכונה של Cloud SQL שהוגדרה לזמינות גבוהה. במקרה של תקלה במסד הנתונים הראשי או הפסקת חשמל באזור, Cloud SQL עובר באופן אוטומטי למסד הנתונים החלופי באזור אחר. אין צורך לשנות את כתובת ה-IP של נקודת הקצה של מסד הנתונים. כדי לוודא שהמכונות של Cloud SQL מכוסות על ידי הסכם SLA, צריך לפעול לפי ההנחיות התפעוליות המומלצות. לדוגמה, ודאו שהמעבד והזיכרון מותאמים לעומס העבודה, והפעילו הגדלות אוטומטיות של נפח האחסון. מידע נוסף זמין במאמר הנחיות תפעוליות. |
| Cloud Storage | אפשר ליצור קטגוריות של Cloud Storage באחד מסוגי המיקומים הבאים: אזורי, שני אזורים או מספר אזורים. נתונים שמאוחסנים בקטגוריות אזוריות משוכפלים באופן סינכרוני בכמה אזורים בתוך אזור. כדי להגביר את הזמינות, אפשר להשתמש בקטגוריות בשני אזורים או במספר אזורים, שבהן הנתונים משוכפלים באופן אסינכרוני בין אזורים. |
| כל המוצרים בארכיטקטורה | אחרי שפורסים את האפליקציה ב- Google Cloud, אפשר לקבל המלצות לשיפור האמינות באמצעות Active Assist. בודקים את ההמלצות ומיישמים אותן בהתאם לסביבה שלכם. איך מוצאים המלצות ב-Active Assist |
במאמר נקודת מבט על AI ו-ML: אמינות ב-Well-Architected Framework מפורטים עקרונות והמלצות לאמינות שספציפיים לעומסי עבודה של AI ו-ML.
הוזלת עלויות
בקטע הזה מוסבר איך לבצע אופטימיזציה של עלויות ההגדרה וההפעלה של אפליקציית AI גנרטיבי עם יכולות RAG ב- Google Cloud.
| מוצר | שיקולים שקשורים לעיצוב |
|---|---|
| GKE |
במצב אוטומטי, GKE משפר את יעילות התשתית של האשכול בהתאם לדרישות של עומס העבודה. אתם לא צריכים לעקוב כל הזמן אחרי ניצול המשאבים או לנהל את הקיבולת כדי לשלוט בעלויות. אם אתם יכולים לחזות את השימוש ב-CPU, בזיכרון ובנפח אחסון נדרש של אשכול GKE Autopilot, תוכלו לחסוך כסף באמצעות הנחות תמורת התחייבות לשימוש. מידע נוסף זמין במאמר הנחות תמורת התחייבות לשימוש ב-GKE. כדי להפחית את עלות ההפעלה של האפליקציה, אתם יכולים להשתמש בVM במודל Spot לצומתי GKE. המחיר של VM במודל Spot נמוך יותר ממכונות וירטואליות רגילות, אבל יכול להיות שהן יופסקו לפני הזמן. למידע נוסף על אופטימיזציה של עלויות, אפשר לעיין במקורות המידע הבאים: |
| Cloud SQL |
הגדרה של זמינות גבוהה (HA) עוזרת לצמצם את זמן ההשבתה של מסד הנתונים ב-Cloud SQL כשהאזור או המכונה לא זמינים. עם זאת, העלות של מכונה עם הגדרת זמינות גבוהה גבוהה יותר מזו של מכונה עצמאית. אם אתם לא צריכים זמינות גבוהה למסד הנתונים הווקטורי, אתם יכולים להוזיל את העלויות באמצעות מכונה עצמאית, שלא עמידה בפני הפסקות חשמל באזור. אתם יכולים לזהות אם הקצאתם יותר מדי משאבים למכונה של Cloud SQL, ולשפר את החיוב באמצעות תובנות והמלצות לגבי עלויות ב-Cloud SQL שמבוססות על Active Assist. מידע נוסף מופיע במאמר הקטנת מכונות Cloud SQL שהוקצו להן יותר מדי משאבים. אם אתם יכולים לחזות את דרישות המעבד (CPU) והזיכרון של מכונת Cloud SQL, תוכלו לחסוך כסף על ידי קבלת הנחות תמורת התחייבות לשימוש. מידע נוסף זמין במאמר הנחות תמורת התחייבות לשימוש ב-Cloud SQL. |
| Cloud Storage | בוחרים סוג אחסון מתאים לקטגוריה של Cloud Storage שמשמשת לטעינת נתונים לתת-המערכת של ההטמעה. כשבוחרים את סוג האחסון, צריך להביא בחשבון את הדרישות של עומסי העבודה בנוגע לשמירת הנתונים ולתדירות הגישה. לדוגמה, כדי לשלוט בעלויות האחסון, אפשר לבחור בסוג Standard ולהשתמש בניהול מחזור החיים של אובייקטים. כך אפשר לשדרג לאחור באופן אוטומטי אובייקטים לסוג אחסון בעלות נמוכה יותר, או למחוק אובייקטים על סמך תנאים שאתם מגדירים. |
| כל המוצרים בארכיטקטורה | אחרי שפורסים את האפליקציה ב- Google Cloud, אפשר לקבל המלצות לשיפור נוסף של העלויות באמצעות Active Assist. בודקים את ההמלצות ומיישמים אותן בהתאם לסביבה שלכם. איך מוצאים המלצות ב-Active Assist |
כדי להעריך את העלות של המשאבים ב- Google Cloud , אתם יכולים להשתמש במחשבון העלויות שלGoogle Cloud .
במאמר נקודת מבט של AI ו-ML: אופטימיזציה של עלויות ב-Well-Architected Framework, תוכלו לקרוא על עקרונות והמלצות לאופטימיזציה של עלויות שספציפיות לעומסי עבודה של AI ו-ML.
אופטימיזציה של הביצועים
בקטע הזה מתוארים הגורמים שצריך להביא בחשבון כשמתכננים ויוצרים אפליקציית AI גנרטיבי עם יכולות RAG ב- Google Cloud , שעומדת בדרישות הביצועים שלכם.
| מוצר | שיקולים שקשורים לעיצוב |
|---|---|
| GKE |
בוחרים את סוגי המחשוב המתאימים ל-Pods, בהתאם לדרישות הביצועים של עומסי העבודה. ל-Pods שמריצים את שרת ההסקה ואת שירות ההטמעה, מומלץ להשתמש בסוג מכונה עם GPU כמו nvidia-l4.
|
| Cloud SQL |
כדי לשפר את הביצועים של מכונת Cloud SQL, ודאו שהמעבד (CPU) והזיכרון שהוקצו למכונה מתאימים לעומס העבודה. מידע נוסף מופיע במאמר אופטימיזציה של מכונות Cloud SQL עם הקצאות-חסר. כדי לשפר את זמן התגובה של חיפוש וקטורי של השכן הקרוב ביותר (ANN), משתמשים באינדקס Inverted File with Flat Compression (IVFFlat) או באינדקס Hierarchical Navigable Small World (HNSW). כדי לעזור לכם לנתח ולשפר את ביצועי השאילתות של מסדי הנתונים, Cloud SQL מספק את הכלי Query Insights. אתם יכולים להשתמש בכלי הזה כדי לעקוב אחרי הביצועים ולמצוא את המקור של שאילתה בעייתית. למידע נוסף, קראו את המאמר שימוש בתובנות לגבי שאילתות כדי לשפר את הביצועים של שאילתות. כדי לקבל סקירה כללית על הסטטוס והביצועים של מסדי הנתונים ולראות מדדים מפורטים כמו שיא החיבורים וניצול הדיסק, אתם יכולים להשתמש בלוח הבקרה של System Insights. מידע נוסף מופיע במאמר שימוש בתובנות מערכת לשיפור ביצועי המערכת. |
| Cloud Storage | כדי להעלות קבצים גדולים, אתם יכולים להשתמש בשיטה שנקראת העלאות מורכבות מקבילות. באסטרטגיה הזאת, הקובץ הגדול מפוצל לחלקים. החלקים מועלים ל-Cloud Storage במקביל, ואז הנתונים מורכבים מחדש בענן. כשרוחב הפס של הרשת ומהירות הדיסק לא מהווים גורם מגביל, העלאות מורכבות מקבילות יכולות להיות מהירות יותר מהעלאות רגילות. עם זאת, לאסטרטגיה הזו יש כמה מגבלות והשלכות על העלויות. מידע נוסף זמין במאמר העלאות מורכבות במקביל. |
| כל המוצרים בארכיטקטורה | אחרי שפורסים את האפליקציה ב- Google Cloud, אפשר לקבל המלצות לשיפור הביצועים באמצעות Active Assist. בודקים את ההמלצות ומיישמים אותן בהתאם לסביבה שלכם. איך מוצאים המלצות ב-Active Assist |
במאמר נקודת מבט על AI ו-ML: אופטימיזציה של ביצועים ב-Well-Architected Framework, תוכלו לקרוא על עקרונות והמלצות לאופטימיזציה של ביצועים שספציפיים לעומסי עבודה של AI ו-ML.
פריסה
כדי לפרוס טופולוגיה שמבוססת על ארכיטקטורת העזר הזו, אתם יכולים להוריד ולהשתמש בקוד לדוגמה בקוד פתוח שזמין במאגר ב-GitHub. הקוד לדוגמה לא מיועד לשימוש בסביבות ייצור. אתם יכולים להשתמש בקוד כדי להתנסות בהגדרת תשתית AI לאפליקציית AI גנרטיבי עם RAG.
הקוד לדוגמה מבצע את הפעולות הבאות:
- מקצה מכונה של Cloud SQL ל-PostgreSQL שתשמש כמסד הנתונים הווקטורי.
- פריסת Ray, JupyterHub ו-Hugging Face TGI באשכול GKE שציינתם.
- פריסת אפליקציה לדוגמה של צ'אט בוט מבוסס-אינטרנט באשכול GKE, כדי שתוכלו לאמת את יכולת ה-RAG.
הוראות לשימוש בקוד לדוגמה מופיעות בקובץ README של הקוד. אם נתקלתם בשגיאות כשאתם משתמשים בקוד לדוגמה, ואין בעיות פתוחות ב-GitHub שקשורות לשגיאות האלה, אתם יכולים ליצור בעיות ב-GitHub.
הקוד לדוגמה פורס משאבים Google Cloud שניתן לחייב עליהם. בסיום השימוש בקוד, הסירו את כל המשאבים שאתם לא צריכים יותר.
המאמרים הבאים
- כדאי לעיין במדריכים הבאים של GKE בנושא שיטות מומלצות:
- הצגת מודלים פתוחים של Gemma באמצעות מעבדים גרפיים ב-GKE עם Hugging Face TGI.
- פיתוח תשתית RAG ל-AI גנרטיבי באמצעות Agent Platform וחיפוש וקטורי.
- בניית תשתית RAG ל-AI גנרטיבי באמצעות Agent Platform ו-AlloyDB ל-PostgreSQL.
- איך בונים תשתית RAG ל-AI גנרטיבי באמצעות Gemini Enterprise ו-Agent Platform
- איך יוצרים תשתית GraphRAG ל-AI גנרטיבי באמצעות Agent Platform ו-Spanner Graph
- לסקירה כללית של עקרונות והמלצות לארכיטקטורה שספציפיים לעומסי עבודה של AI ו-ML ב- Google Cloud, קראו את המאמר נקודת המבט של AI ו-ML ב-Well-Architected Framework.
- לדוגמאות נוספות של ארכיטקטורות, תרשימים ושיטות מומלצות, עיינו במאמר Cloud Architecture Center.
שותפים ביצירת התוכן
מחבר: Kumar Dhanagopal | מפתח פתרונות חוצי-מוצרים
תורמים אחרים:
- אנה ברנברג | עמיתת הנדסה
- עלי זאידי | ארכיטקט פתרונות
- באלה נרסימהאן | מנהל קבוצת מוצרים
- ביל ברנסן | מהנדס אבטחה
- ברנדון רויאל | מנהל מוצר יוצא
- Cynthia Thomas | מנהלת מוצר
- ג'פרי אנדרסון | מנהל מוצר
- Gleb Otochkin | Cloud Advocate, Databases
- ג'ק וות'רספון | אחראי קשרי מפתחים (Developers Advocate)
- ג'ולי אמונדסון | מהנדסת תוכנה בכירה
- Kent Hua | Solutions Manager
- Kavitha Rajendran | מומחית AI/ML, אדריכלית פתרונות
- מארק שלאגנהאוף | כותב טכני, רשתות
- מייגן אוקיף | אחראית קשרי מפתחים (Developers Advocate)
- מופי רחמן | Google Cloud Advocate