


במאמר הזה מוצגת ארכיטקטורה לדוגמה שתעזור לכם לתכנן תשתית לאפליקציות של AI גנרטיבי ב-GraphRAG ב- Google Cloud. קהל היעד כולל אדריכלים, מפתחים ואדמינים שיוצרים ומנהלים מערכות חכמות לאחזור מידע. ההנחה במסמך היא שיש לכם הבנה בסיסית ב-AI, בניהול נתוני גרפים ובמושגים של Knowledge Graph. במסמך הזה אין הנחיות ספציפיות לתכנון ולפיתוח של אפליקציות GraphRAG.
GraphRAG היא גישה מבוססת-גרף ל-Retrieval-Augmented Generation (יצירה משולבת-אחזור, RAG). RAG עוזר לעגן תשובות שנוצרו על ידי AI על ידי הוספת נתונים רלוונטיים להקשר להנחיות, שנשלפים באמצעות חיפוש וקטורי. GraphRAG משלב חיפוש וקטורי עם שאילתה של גרף ידע כדי לאחזר נתונים לפי הקשר, שמשקפים טוב יותר את הקשרים בין נתונים ממקורות שונים. הנחיות שמשופרות באמצעות GraphRAG יכולות ליצור תשובות מפורטות ורלוונטיות יותר מ-AI.
ארכיטקטורה
בתרשים הבא מוצגת ארכיטקטורה של אפליקציית AI גנרטיבי עם יכולות GraphRAG ב- Google Cloud:
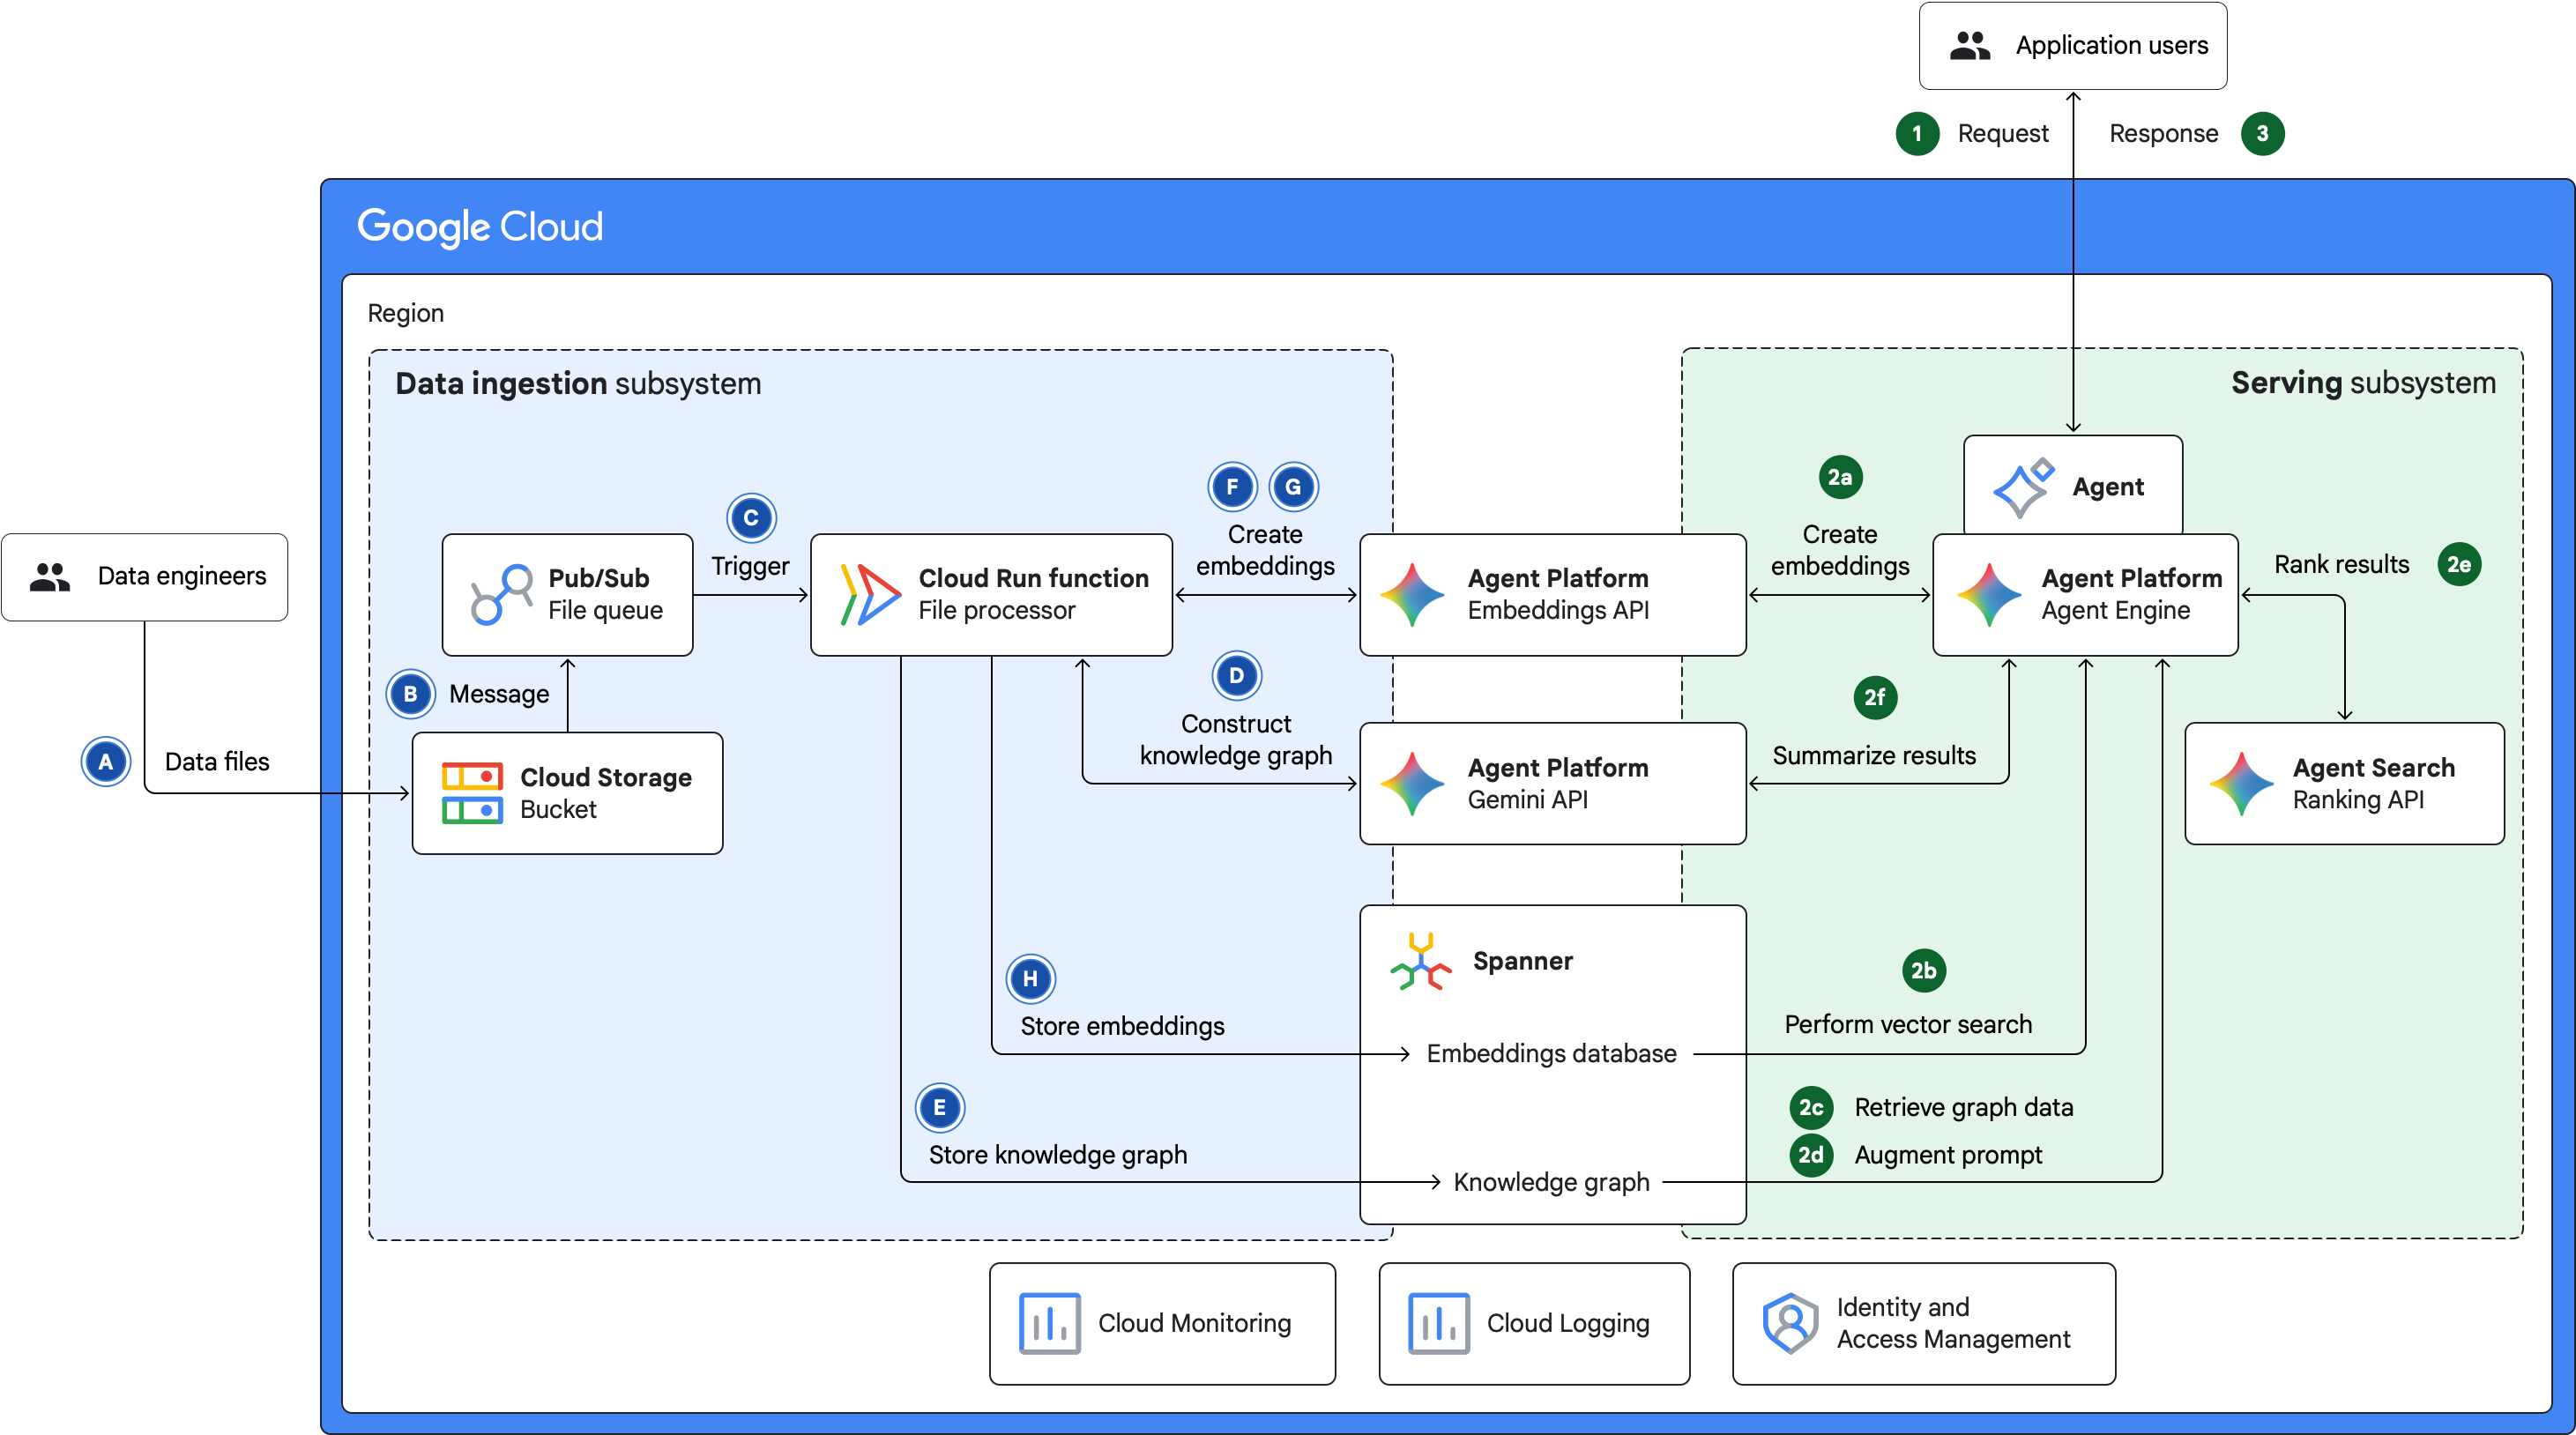
הארכיטקטורה בתרשים הקודם מורכבת משתי תת-מערכות: הטמעת נתונים והצגת נתונים. בקטעים הבאים מתוארים המטרה של תת-המערכות וזרימת הנתונים בתוך תת-המערכות וביניהן.
תת-מערכת להטמעת נתונים
תת-המערכת להטמעת נתונים מטמיעה נתונים ממקורות חיצוניים ואז מכינה את הנתונים ל-GraphRAG. תהליך הטמעת הנתונים והכנתם כולל את השלבים הבאים:
- הנתונים נקלטים בקטגוריה של Cloud Storage. הנתונים האלה יכולים להיות מועלים על ידי מנתח נתונים, מוטמעים ממסד נתונים או מוזרמים מכל מקור.
- כשנתונים נקלטים, נשלחת הודעה לנושא Pub/Sub.
- Pub/Sub מפעיל פונקציית Cloud Run כדי לעבד את הנתונים שהועלו.
- פונקציית Cloud Run יוצרת תרשים ידע מקובצי הקלט באמצעות Gemini API וכלים כמו
LLMGraphTransformerשל LangChain. - הפונקציה שומרת את Knowledge Graph במסד נתונים של Spanner Graph.
- הפונקציה מחלקת את התוכן הטקסטואלי של קובצי הנתונים ליחידות קטנות באמצעות כלים כמו
RecursiveCharacterTextSplitterשל LangChain או Layout Parser של Document AI. - הפונקציה יוצרת הטמעות וקטורים של קטעי הטקסט באמצעות ממשקי ה-API להטמעות של Gemini Enterprise Agent Platform.
- הפונקציה שומרת את הטמעות הווקטורים ואת צומתי התרשים המשויכים ב-Spanner Graph.
הטמעות הווקטורים משמשות כבסיס לאחזור סמנטי. הצמתים של תרשים הידע מאפשרים מעבר וניתוח של דפוסים וקשרים מורכבים בין נתונים.
תת-מערכת להצגת מודעות
תת-המערכת להצגת מודעות מנהלת את מחזור החיים של השאילתות והתשובות בין אפליקציית ה-AI הגנרטיבי לבין המשתמשים שלה. תהליך ההצגה כולל את השלבים הבאים:
- המשתמש שולח שאילתה בשפה טבעית לסוכן AI שנפרס ב-Agent Runtime ב-Gemini Enterprise Agent Platform.
- הסוכן מעבד את השאילתה באופן הבא:
- ממירה את השאילתה להטמעות וקטורים באמצעות ממשקי ה-API של Agent Platform Embeddings.
- שליפת צומתי תרשים שקשורים לשאילתה על ידי ביצוע חיפוש דמיון וקטורי במסד הנתונים של ההטמעות.
- שליפת נתונים שקשורים לשאילתה על ידי מעבר ב-Knowledge Graph.
- משפר את ההנחיה על ידי שילוב של השאילתה המקורית עם נתוני התרשים שאוחזרו.
- משתמש ב-Agent Search ranking API כדי לדרג את התוצאות, שמורכבות מצמתים וקצוות שאוחזרו ממסד הנתונים של התרשים. הדירוג מבוסס על הרלוונטיות הסמנטית לשאילתה.
- מסכם את התוצאות באמצעות קריאה ל-Gemini API.
- לאחר מכן, הנציג שולח את התוצאה המסוכמת למשתמש.
אתם יכולים לאחסן יומני פעילות של שאילתות ותשובות ב-Cloud Logging, לצפות בהם ולהגדיר מעקב מבוסס-יומנים באמצעות Cloud Monitoring.
המוצרים שהשתמשו בהם
בארכיטקטורה לדוגמה הזו נעשה שימוש במוצרים ובכלים הבאים של Google:
- Spanner Graph: מסד נתונים של גרפים שמספק את תכונות המדרגיות, הזמינות והעקביות של Spanner.
- Gemini Enterprise Agent Platform: פלטפורמה מקיפה שמאפשרת ליצור, לנהל, לבצע אופטימיזציה ולהתאים לעומס (scale) סוכני AI ברמה שמתאימה לארגונים.
- פונקציות Cloud Run: פלטפורמת מחשוב בלי שרת (serverless computing) שמאפשרת להריץ פונקציות למטרה יחידה ישירות ב- Google Cloud.
- Cloud Storage: מאגר אובייקטים ללא הגבלה ובעלות נמוכה, לסוגי נתונים שונים. אפשר לגשת לנתונים מתוך Google Cloudומחוץ לו, והם משוכפלים במיקומים שונים כדי ליצור יתירות.
- Pub/Sub: שירות העברת הודעות אסינכרוני וניתן להתאמה, שמפריד בין השירותים שמפיקים הודעות לבין השירותים שמעבדים את ההודעות האלה.
- Cloud Logging: מערכת לניהול יומנים בזמן אמת עם אחסון, חיפוש, ניתוח והתראות.
- Cloud Monitoring: שירות שמאפשר לראות את הביצועים, הזמינות והתקינות של האפליקציות והתשתית.
תרחישים לדוגמה
GraphRAG מאפשר אחזור נתונים חכם לתרחישים לדוגמה בתעשיות שונות. בקטע הזה מתוארים כמה תרחישים לדוגמה בתחומים של בריאות, פיננסים, שירותים משפטיים וייצור.
שירותי בריאות ותרופות: תמיכה בקבלת החלטות רפואיות
במערכות לתמיכה בקבלת החלטות קליניות, GraphRAG משלב כמויות עצומות של נתונים מספרות רפואית, מתיקים רפואיים אלקטרוניים של מטופלים, ממסדי נתונים של אינטראקציות בין תרופות ומתוצאות של ניסויים קליניים, ויוצר מהם גרף ידע מאוחד. כשהרופאים והחוקרים שולחים שאילתה לגבי התסמינים והתרופות הנוכחיות של המטופל, GraphRAG עובר על Knowledge Graph כדי לזהות מצבים רלוונטיים ואינטראקציות פוטנציאליות בין תרופות. הוא גם יכול ליצור המלצות לטיפול בהתאמה אישית על סמך נתונים אחרים, כמו הפרופיל הגנטי של המטופל. הסוג הזה של אחזור מידע מספק תשובות עשירות יותר מבחינת ההקשר ומבוססות על ראיות, בהשוואה להתאמה למילות מפתח.
שירותים פיננסיים: איחוד נתונים פיננסיים
חברות של שירותים פיננסיים משתמשות ב-Knowledge Graph כדי לתת למנתחי הנתונים שלהן תצוגה מאוחדת ומובנית של נתונים ממקורות שונים, כמו דוחות של מנתחי נתונים, שיחות ועידה בנושא תוצאות כספיות והערכות סיכונים. Knowledge Graph מזהים ישויות נתונים חשובות כמו חברות ומנהלים, וממפים את הקשרים החשובים בין הישויות. הגישה הזו מספקת רשת עשירה של נתונים מקושרים, שמאפשרת ניתוח פיננסי מעמיק ויעיל יותר. אנליסטים יכולים לגלות תובנות שהיו מוסתרות בעבר, כמו תלות מורכבת בשרשרת האספקה, חברי דירקטוריון שחופפים בין מתחרים וחשיפה לסיכונים גיאופוליטיים מורכבים.
שירותים משפטיים: מחקר תיקים וניתוח תקדימים
בתחום המשפטי, אפשר להשתמש ב-GraphRAG כדי ליצור המלצות משפטיות מותאמות אישית על סמך תקדימים, חוקים, פסיקות, עדכונים רגולטוריים ומסמכים פנימיים. כשהם מתכוננים לתיקים, עורכי דין יכולים לשאול שאלות מורכבות על טיעונים משפטיים ספציפיים, פסיקות קודמות בתיקים דומים או ההשלכות של חקיקה חדשה. GraphRAG משתמש בקישוריות של הידע המשפטי הזמין כדי לזהות תקדימים רלוונטיים ולהסביר את האפשרות ליישם אותם. הוא גם יכול להציע טיעונים נגדיים על ידי מעקב אחר הקשרים בין מושגים משפטיים, חוקים ופרשנויות משפטיות. הגישה הזו מאפשרת לאנשי מקצוע בתחום המשפטי לקבל תובנות מעמיקות ומדויקות יותר מאשר בשיטות קונבנציונליות לאחזור ידע.
ייצור ושרשרת אספקה: גישה לידע ארגוני
פעולות הייצור ושרשרת האספקה דורשות רמה גבוהה של דיוק. הידע שנדרש כדי לשמור על רמת הדיוק הנדרשת נמצא בדרך כלל באלפי מסמכים צפופים וסטטיים של נוהלי עבודה תקינים (SOP). כשיש תקלה בקו ייצור או במכונה במפעל, או כשיש בעיה לוגיסטית, מהנדסים וטכנאים מבזבזים הרבה זמן בחיפוש במסמכי PDF לא מקושרים כדי לאבחן את הבעיה ולפתור אותה. אפשר לשלב בין Knowledge Graph לבין AI בממשק שיחה כדי להפוך ידע ארגוני חבוי לשותף אינטראקטיבי לאבחון.
חלופות עיצוב
הארכיטקטורה שמתוארת במסמך הזה היא מודולרית. בהתאם לדרישות שלכם, אתם יכולים להתאים רכיבים מסוימים של הארכיטקטורה כדי להשתמש במוצרים, בכלים ובטכנולוגיות חלופיים.
יצירת ה-Knowledge Graph
אתם יכולים להשתמש בכלי LLMGraphTransformer של LangChain כדי ליצור Knowledge Graph מאפס. כדי לשפר את האיכות של Knowledge Graph שנוצר, אתם יכולים לציין את סכימת התרשים באמצעות פרמטרים של LLMGraphTransformer כמו allowed_nodes, allowed_relationships, node_properties ו-relationship_properties. עם זאת, יכול להיות ש-LLMGraphTransformer יחלץ ישויות מדומיינים כלליים, ולכן יכול להיות שהוא לא יתאים לדומיינים נישתיים כמו בריאות או תרופות. בנוסף, אם לארגון שלכם כבר יש תהליך חזק ליצירת Knowledge Graph, תת-המערכת להטמעת נתונים שמוצגת בארכיטקטורה לדוגמה היא אופציונלית.
אחסון של Knowledge Graph והטמעות וקטורים
בארכיטקטורה שמתוארת במאמר הזה, Spanner משמש כמאגר הנתונים של גרף הידע וגם של הטמעות הווקטורים. אם תרשימי הידע של הארגון כבר קיימים במקום אחר (למשל בפלטפורמה כמו Neo4j), כדאי לשקול להשתמש במסד נתונים וקטורי להטמעות. עם זאת, הגישה הזו דורשת מאמץ ניהולי נוסף ויכול להיות שהיא תעלה יותר. Spanner מספק מאגר נתונים מאוחד ועקבי ברמה הגלובלית, גם למבני גרפים וגם להטמעות וקטורים. מאגר נתונים כזה מאפשר ניהול נתונים מאוחד, שעוזר לשפר את העלות, הביצועים, ניהול האבטחה והיעילות התפעולית.
Agent runtime
בארכיטקטורה לדוגמה הזו, הנציג נפרס ב-Agent Runtime, שמספק סביבת זמן ריצה מנוהלת לנציגי AI. אפשרויות אחרות שאפשר לשקול הן Cloud Run ו-Google Kubernetes Engine (GKE). האפשרויות האלה לא נכללות במסמך הזה.
עיגון באמצעות RAG
כמו שמוסבר בקטע תרחישים לדוגמה, GraphRAG מאפשר לאחזר נתונים בצורה חכמה לצורך ביסוס בתרחישים רבים. עם זאת, אם לנתוני המקור שבהם אתם משתמשים כדי להרחיב את ההנחיות אין קשרים מורכבים, יכול להיות ש-RAG היא בחירה מתאימה לאפליקציית ה-AI הגנרטיבי שלכם.
בארכיטקטורות לדוגמה הבאות מוסבר איך לבנות את התשתית הנדרשת ל-RAG ב- Google Cloud באמצעות מסדי נתונים מנוהלים עם תמיכה בווקטורים או מוצרים ייעודיים לחיפוש וקטורי:
- תשתית RAG ל-AI גנרטיבי באמצעות Agent Platform וחיפוש וקטורי
- תשתית RAG ל-AI גנרטיבי באמצעות Agent Platform ו-AlloyDB ל-PostgreSQL
- תשתית RAG ל-AI גנרטיבי באמצעות GKE ו-Cloud SQL
- תשתית RAG ל-AI גנרטיבי באמצעות Gemini Enterprise ו-Agent Platform
שיקולים בתכנון
בקטע הזה מתוארים גורמי תכנון, שיטות מומלצות והמלצות שכדאי להביא בחשבון כשמשתמשים בארכיטקטורה לדוגמה כדי לפתח טופולוגיה שעומדת בדרישות הספציפיות שלכם בנוגע לאבטחה, לאמינות, לעלות ולביצועים.
ההנחיות בקטע הזה הן חלקיות בלבד. בהתאם לדרישות של עומס העבודה ולמוצרים ולתכונות של Google Cloud ושל צד שלישי שבהם אתם משתמשים, יכול להיות שתצטרכו להביא בחשבון גורמי תכנון ופשרות נוספים.
אבטחה, פרטיות ותאימות
בקטע הזה מתוארים שיקולים והמלצות לתכנון טופולוגיה ב- Google Cloud שעומדת בדרישות האבטחה והתאימות של עומס העבודה.
שיקולי אבטחה ב-Agent Platform
כדי לוודא שההגדרות והשימוש ב-Agent Platform עומדים בדרישות האבטחה שלכם, כדאי לפעול לפי ההמלצות הבאות:
אמצעי בקרה לאבטחה: פלטפורמת Agent תומכת ב Google Cloud אמצעי בקרה לאבטחה שבהם אתם יכולים להשתמש כדי לעמוד בדרישות שלכם לגבי מיקום אחסון הנתונים, הצפנת נתונים, אבטחת רשת ו-Access Transparency. מידע נוסף זמין במשאבי העזרה הבאים:
בטיחות: מודלים של AI גנרטיבי עלולים ליצור תשובות מזיקות, במיוחד אם מבקשים מהם תשובות כאלה באופן מפורש. כדי לשפר את הבטיחות ולצמצם את הסיכון לשימוש לרעה, אתם יכולים להגדיר מסנני תוכן שימנעו תשובות פוגעניות. מידע נוסף זמין במאמר מסנני בטיחות ותוכן.
הצפנת נתונים ב-Spanner Graph
כברירת מחדל, הנתונים שמאוחסנים ב-Spanner Graph מוצפנים באמצעות Google-owned and Google-managed encryption keys. אם אתם צריכים להשתמש במפתחות הצפנה שאתם שולטים בהם ומנהלים אותם, אתם יכולים להשתמש במפתחות הצפנה בניהול הלקוח (CMEK). מידע נוסף זמין במאמר מידע על CMEK.
שיקולי אבטחה בפונקציות Cloud Run
כדי לוודא שההטמעה של פונקציות Cloud Run עומדת בדרישות האבטחה, כדאי לפעול לפי ההמלצות הבאות:
- הצפנת נתונים: כברירת מחדל, Cloud Run מצפין נתונים באמצעות Google-owned and Google-managed encryption keys. כדי להגן על הקונטיינרים באמצעות מפתחות בשליטתכם, אתם יכולים להשתמש במפתחות CMEK. מידע נוסף מופיע במאמר שימוש במפתחות הצפנה בניהול הלקוח.
- אבטחה של קובצי אימג' של קונטיינרים: כדי לוודא שרק קובצי אימג' מורשים של קונטיינרים נפרסים ב-Cloud Run, אתם יכולים להשתמש ב-Binary Authorization.
- מיקום אחסון הנתונים: ב-Cloud Run אפשר לעמוד בדרישות לגבי מיקום אחסון הנתונים. פונקציות Cloud Run פועלות באזור שנבחר.
שיקולי אבטחה ב-Cloud Storage
כדי לוודא שההגדרות של Cloud Storage עומדות בדרישות האבטחה, כדאי לפעול לפי ההמלצות הבאות:
- הצפנת נתונים: כברירת מחדל, הנתונים שמאוחסנים ב-Cloud Storage מוצפנים באמצעותGoogle-owned and Google-managed encryption keys. אם צריך, אתם יכולים להשתמש במפתחות CMEK או במפתחות משלכם שאתם מנהלים באמצעות שיטת ניהול חיצונית, כמו מפתחות הצפנה באספקת הלקוח (CSEK). מידע נוסף מופיע במאמר אפשרויות להצפנת נתונים.
- בקרת גישה: ב-Cloud Storage יש שתי שיטות שבאמצעותן אפשר לתת למשתמשים גישה לקטגוריות ולאובייקטים: ניהול זהויות והרשאות גישה (IAM) ורשימות של בקרת גישה (ACL). ברוב המקרים, מומלץ להשתמש ב-IAM, שמאפשר להעניק הרשאות ברמת הקטגוריה והפרויקט. סקירה כללית על בקרת גישה
- הגנה על נתונים: הנתונים שאתם טוענים לתת-המערכת של הטמעת הנתונים דרך Cloud Storage עשויים לכלול מידע אישי רגיש. אתם יכולים להשתמש ב-Sensitive Data Protection כדי לגלות, לסווג ולהסיר פרטים מזהים ממידע רגיש. מידע נוסף זמין במאמר שימוש ב-Sensitive Data Protection עם Cloud Storage.
- מיקום אחסון הנתונים: בעזרת Cloud Storage תוכלו לעמוד בדרישות לגבי מיקום אחסון הנתונים. הנתונים מאוחסנים או משוכפלים באזור שאתם מציינים.
שיקולי אבטחה ב-Pub/Sub
כדי לוודא שההגדרות של Pub/Sub עומדות בדרישות האבטחה, כדאי לפעול לפי ההמלצות הבאות:
- הצפנת נתונים: כברירת מחדל, Pub/Sub מצפין את כל ההודעות, גם במנוחה וגם במעבר, באמצעותGoogle-owned and Google-managed encryption keys. ב-Pub/Sub אפשר להשתמש במפתחות CMEK להצפנת הודעות בשכבת האפליקציה. למידע נוסף, קראו את המאמר הגדרת הצפנת הודעות.
- מיקום אחסון הנתונים: אם יש לכם דרישות לגבי מיקום אחסון הנתונים, כדי לוודא שנתוני ההודעות מאוחסנים במיקומים ספציפיים, אתם יכולים להגדיר כללי מדיניות לאחסון הודעות.
שיקולי אבטחה ב-Cloud Logging
כדי לוודא שההגדרות של Cloud Logging עומדות בדרישות האבטחה, כדאי להביא בחשבון את הגורמים וההמלצות הבאים:
- ביקורת על פעילות אדמין: יומני הביקורת של פעילות אדמין מופעלים כברירת מחדל בכל שירותי Google Cloud שמשמשים בארכיטקטורה לדוגמה הזו. ביומנים האלה מתועדות קריאות ל-API או פעולות אחרות שמשנות את ההגדרות או את המטא-נתונים של משאבי Google Cloud .
- ביקורת על גישה לנתונים: בשירותי Google Cloud שמשמשים בארכיטקטורה הזו, אתם יכולים להפעיל יומני ביקורת של גישה לנתונים. היומנים האלה מאפשרים לכם לעקוב אחרי קריאות ל-API שקוראות את ההגדרות או את המטא-נתונים של משאבים, או אחרי בקשות של משתמשים ליצור, לשנות או לקרוא נתוני משאבים שסופקו על ידי משתמשים.
- מיקום אחסון הנתונים: כדי לעמוד בדרישות של מיקום אחסון הנתונים, אתם יכולים להגדיר את Cloud Logging כך שיאחסן את נתוני היומנים באזור שאתם מציינים. מידע נוסף זמין במאמר התאמה אזורית של היומנים.
במאמר נקודת מבט על AI ו-ML: אבטחה ב- Google Cloud Well-Architected Framework מפורטים עקרונות והמלצות לאבטחה שרלוונטיים ספציפית לעומסי עבודה של AI ו-ML.
אמינות
בקטע הזה מתוארים שיקולים והמלצות לתכנון, לבנייה ולהפעלה של תשתית אמינה לפריסה ב- Google Cloud.
זמינות נקודות הקצה והקיבולת של Agent Platform
אם מספר הבקשות חורג מהקיבולת שהוקצתה, מוחזר קוד השגיאה 429. לעומסי עבודה קריטיים לעסק שדורשים באופן עקבי קצב נתונים גבוה, אתם יכולים להזמין קצב נתונים באמצעות הקצאת משאבים לפי התפוקה שנקבעה. אם אפשר לשתף נתונים בין כמה אזורים או מדינות, אתם יכולים להשתמש בנקודת קצה גלובלית.
זמינות הנתונים ותוכנית התאוששות מאסון (DR) ב-Spanner Graph
Spanner מיועד לזמינות גבוהה של נתונים וליכולת התאמה גלובלית. כדי להבטיח זמינות גם בזמן הפסקה זמנית בפעילות באזור, Spanner מציע הגדרות לכמה אזורים, שיוצרות רפליקות של נתונים בכמה אזורים. בנוסף ליכולות החוסן המובנות האלה, Spanner מספק את התכונות הבאות כדי לתמוך באסטרטגיות מקיפות של תוכנית התאוששות מאסון (DR):
- הגנה מפני מחיקה של מסד נתונים
- יכולות גיבוי ושחזור חזקות, כולל עותקים מתוזמנים ועותקים בין אזורים שונים
- שחזור מערכת מנקודה מסוימת בזמן (PITR) להגנה מפני פגיעה לוגית בנתונים, שגיאות של מפעילים או כתיבה מקרית, למשך עד שבעה ימים
מידע נוסף זמין במאמר סקירה כללית על תוכנית התאוששות מאסון (DR).
עמידות של פונקציות Cloud Run להפסקות בתשתית
Cloud Run הוא שירות אזורי. הנתונים מאוחסנים באופן סינכרוני בכמה אזורים בתוך אזור. התנועה מאוזנת באופן אוטומטי בין האזורים. אם יש הפסקה זמנית בשירות באזור מסוים, Cloud Run ממשיך לפעול והנתונים לא אובדים. אם יש הפסקה זמנית בשירות באזור מסוים, השירות מפסיק לפעול עד ש-Google פותרת את הבעיה.
זמינות הנתונים ב-Cloud Storage
אפשר ליצור קטגוריות של Cloud Storage באחד משלושה סוגי מיקומים: אזורי, שני אזורים או מספר אזורים. נתונים שמאוחסנים בקטגוריות אזוריות משוכפלים באופן סינכרוני בכמה אזורים בתוך אזור. כדי להגביר את הזמינות, אתם יכולים להשתמש בקטגוריות של שני אזורים או של מספר אזורים, שבהן הנתונים משוכפלים באופן אסינכרוני בין אזורים.
שיקולי אמינות של Pub/Sub
כדי לוודא שהגדרות Pub/Sub עומדות בדרישות האמינות, כדאי לפעול לפי ההמלצות הבאות:
- בקרת קצב: כדי למנוע שגיאות בתקופות של עלייה זמנית בתנועת ההודעות, אתם יכולים להגביל את קצב בקשות הפרסום על ידי הגדרת בקרת זרימה בהגדרות של בעל התוכן הדיגיטלי.
- טיפול בשגיאות: כדי לטפל בניסיונות פרסום שנכשלו, משנים את המשתנים של בקשות הניסיון החוזר לפי הצורך. למידע נוסף, קראו את המאמר ניסיון חוזר של בקשות.
המלצות לאמינות של כל המוצרים בארכיטקטורה
אחרי שפורסים את עומס העבודה ב- Google Cloud, כדאי ליישם את ההמלצות הרלוונטיות של Active Assist כדי לשפר את האמינות של משאבי הענן.
במסמך נקודת מבט על AI ו-ML: אמינות ב-Well-Architected Framework מפורטים עקרונות והמלצות לאמינות שספציפיים לעומסי עבודה של AI ו-ML.
הוזלת עלויות
בקטע הזה מוסבר איך לבצע אופטימיזציה של עלויות ההגדרה וההפעלה של טופולוגיית Google Cloud שאתם בונים באמצעות ארכיטקטורת העזר הזו.
שיקולי עלות ב-Agent Platform
כדי לוודא שההגדרות והשימוש ב-Agent Platform עומדים בדרישות העלות, כדאי לפעול לפי ההמלצות הבאות:
- ניתוח וניהול עלויות: כדי לנתח ולנהל את העלויות של Agent Platform, מומלץ ליצור בסיס של שאילתות לשנייה (QPS) וטוקנים לשנייה (TPS) ולעקוב אחרי המדדים האלה אחרי הפריסה. הוא גם עוזר לתכנן את הקיבולת. לדוגמה, בעזרת ערך הבסיס אפשר לקבוע מתי צריך להשתמש בהקצאת משאבים לפי התפוקה שנקבעה.
- בחירת מודל: בחירת המודל המתאים לאפליקציית ה-AI הגנרטיבי היא החלטה קריטית שמשפיעה ישירות על העלויות ועל הביצועים. כדי לזהות את המודל שמספק איזון אופטימלי בין ביצועים לעלות בתרחיש לדוגמה הספציפי שלכם, כדאי לבדוק מודלים באופן איטרטיבי. מומלץ להתחיל עם המודל הכי חסכוני ולהתקדם בהדרגה לאפשרויות חזקות יותר.
- הנדסת פרומפטים: אורך הפרומפטים (קלט) והתשובות שנוצרות (פלט) משפיעים ישירות על הביצועים והעלות. כתבו הנחיות קצרות וישירות, וספקו מספיק הקשר. תכננו את ההנחיות כך שתקבלו תשובות תמציתיות מהמודל. לדוגמה, אפשר להוסיף ביטויים כמו "סכם ב-2 משפטים" או "ציין 3 נקודות עיקריות". מידע נוסף זמין במאמר שיטות מומלצות לעיצוב הנחיות.
- שמירת הקשר במטמון: כדי להוזיל את העלות של בקשות שכוללות תוכן חוזר עם מספר גבוה של אסימוני קלט, אתם יכולים להשתמש בשמירת הקשר במטמון.
- בקשות Batch: למשימות עיבוד בקנה מידה גדול שאפשר לבצע באופן אסינכרוני, כמו יצירת תוכן וניתוח אופליין, כדאי להשתמש בהסקה באצווה. החיוב על בקשות Batch נמוך יותר מהחיוב על בקשות רגילות.
שיקולי עלות של Spanner Graph
כדי לוודא שההגדרות של Spanner Graph עומדות בדרישות העלות, כדאי לפעול לפי ההמלצות הבאות:
- התאמה אוטומטית של קיבולת המחשוב לעומס: כדי לשלוט בעלויות, אפשר להשתמש בכלי המנוהל להתאמה לעומס כדי לשנות באופן דינמי את קיבולת המחשוב של מסדי הנתונים ב-Spanner Graph, בהתאם לניצול ה-CPU ולצורכי האחסון. בדרך כלל נדרשת קיבולת מינימלית, גם לעומסי עבודה קטנים.
- אופטימיזציה של תעריפים: אם אתם יכולים לחזות את השימוש שלכם במשאבי המחשוב, או אם השימוש יציב או בסיסי, אנחנו ממליצים לרכוש הנחות תמורת התחייבות לשימוש (CUD). הנחות תמורת התחייבות לשימוש (CUD) הן הנחות משמעותיות שניתנות בתמורה להתחייבות להוצאה שעתית מסוימת על קיבולת המחשוב.
- רפליקציה של גיבויים: כשמעתיקים גיבויים לאזורים שונים לצורך תוכנית התאוששות מאסון (DR) או תאימות, צריך להביא בחשבון את העלויות של תעבורת הנתונים היוצאת (egress) ברשת. כדי לצמצם את העלויות, כדאי להעתיק רק את הגיבויים החיוניים.
שיקולי עלות של פונקציות Cloud Run
כדי לוודא שההטמעה של פונקציות Cloud Run עומדת בדרישות העלות, כדאי לפעול לפי ההמלצות הבאות:
הקצאת משאבים: כשיוצרים פונקציות Cloud Run, אפשר לציין את כמות הזיכרון והמעבד (CPU) שיוקצו. כדי לשלוט בעלויות, כדאי להתחיל עם הקצאות ברירת המחדל (המינימליות) של המעבד (CPU) והזיכרון. כדי לשפר את הביצועים, אפשר להגדיל את ההקצאה על ידי הגדרת מגבלת המעבד (CPU) ומגבלת הזיכרון. מידע נוסף זמין במשאבי העזרה הבאים:
אופטימיזציה של התעריפים: אם אתם יכולים לחזות את דרישות המעבד (CPU) והזיכרון, תוכלו לחסוך כסף באמצעות הנחות תמורת התחייבות לשימוש (CUD).
סוג האחסון וניהול מחזור החיים ב-Cloud Storage
לקטגוריה של Cloud Storage בתת-המערכת של הטמעת הנתונים, בוחרים סוג אחסון שמתאים לדרישות של עומס העבודה בנוגע לשמירת נתונים ולתדירות הגישה. לדוגמה, כדי לשלוט בעלויות האחסון, אתם יכולים לבחור בסוג Standard ולהשתמש בניהול מחזור החיים של אובייקטים. הגישה הזו מאפשרת להוריד באופן אוטומטי את סוג האחסון (storage class) של אובייקטים לסוג אחסון בעלות נמוכה יותר, או למחוק באופן אוטומטי אובייקטים על סמך תנאים מסוימים.
שיקולי עלות ב-Cloud Logging
כדי לשלוט בעלות האחסון של היומנים, כדאי לפעול לפי ההמלצות הבאות:
- להקטין את נפח היומנים על ידי החרגה או סינון של רשומות יומן מיותרות. מידע נוסף זמין במאמר מסנני החרגה.
- אופטימיזציה של תקופת השמירה של היומנים. מידע נוסף מופיע במאמר הגדרת שמירה בהתאמה אישית.
המלצות לאופטימיזציה של עלויות לכל המוצרים בארכיטקטורה
כדי לוודא שהארכיטקטורה עומדת בדרישות העלות, כדאי לפעול לפי ההמלצות הכלליות הבאות:
- אופטימיזציה אחרי הפריסה: אחרי שפורסים את עומס העבודה ב-Google Cloud, אפשר להמשיך לייעל את עלות המשאבים שנפרסו באמצעות ההמלצות הרלוונטיות של Active Assist.
- הערכת עלויות: כדי להעריך את העלות של המשאבים ב- Google Cloud, אתם יכולים להשתמש במחשבון העלויות שלGoogle Cloud .
במאמר נקודת מבט על AI ו-ML: אופטימיזציה של עלויות ב-Well-Architected Framework, תוכלו לקרוא על עקרונות והמלצות לאופטימיזציה של עלויות שספציפיות לעומסי עבודה של AI ו-ML.
אופטימיזציה של הביצועים
בקטע הזה מתוארים שיקולים והמלצות לתכנון טופולוגיה ב- Google Cloud שעומדת בדרישות הביצועים של עומסי העבודה שלכם.
שיקולי ביצועים ב-Agent Platform
כדי לוודא שההגדרות והשימוש ב-Agent Platform עומדים בדרישות הביצועים, כדאי לפעול לפי ההמלצות הבאות:
- בחירת מודל: בחירת המודל המתאים לאפליקציית ה-AI הגנרטיבי היא החלטה קריטית שמשפיעה ישירות על העלויות ועל הביצועים. כדי לזהות את המודל שמספק איזון אופטימלי בין ביצועים לעלות בתרחיש לדוגמה הספציפי שלכם, כדאי לבדוק מודלים באופן איטרטיבי. מומלץ להתחיל עם המודל הכי חסכוני ולהתקדם בהדרגה לאפשרויות חזקות יותר.
- הנדסת פרומפטים: אורך הפרומפטים (קלט) והתשובות שנוצרות (פלט) משפיעים ישירות על הביצועים והעלות. כתבו הנחיות קצרות וישירות, וספקו מספיק הקשר. תכננו את ההנחיות כך שתקבלו תשובות תמציתיות מהמודל. לדוגמה, אפשר להוסיף ביטויים כמו "סכם בשני משפטים" או "ציין 3 נקודות עיקריות". מידע נוסף זמין במאמר שיטות מומלצות לעיצוב הנחיות.
- אופטימיזציה של הנחיות: הכלי לאופטימיזציה של הנחיות ב-Agent Platform מאפשר לשפר במהירות את הביצועים של ההנחיות בקנה מידה נרחב, בלי צורך לשכתב אותן ידנית. הכלי הזה עוזר להתאים ביעילות את ההנחיות למודלים שונים.
עיצוב סכימה וכוונון שאילתות ב-Spanner Graph
המלצות לאופטימיזציה של הביצועים של Spanner Graph מפורטות במאמרים הבאים:
הקצאת משאבים לפונקציות Cloud Run
כברירת מחדל, לכל מכונה של פונקציית Cloud Run מוקצים מעבד אחד וזיכרון בנפח 256MiB. בהתאם לדרישות הביצועים, אתם יכולים להגדיר מגבלות למעבד (CPU) ולזיכרון. מידע נוסף זמין במשאבי העזרה הבאים:
למידע נוסף על אופטימיזציה של הביצועים, קראו את הטיפים הכלליים לפיתוח ב-Cloud Run.
העלאות מורכבות מקבילות ב-Cloud Storage
כדי להעלות קבצים גדולים, אתם יכולים להשתמש בהעלאות מורכבות מקבילות. באסטרטגיה הזאת, הקובץ הגדול מפוצל לחלקים. החלקים מועלים ל-Cloud Storage במקביל, ואז הנתונים מורכבים מחדש בענן. אם רוחב הפס של הרשת ומהירות הכתיבה לדיסק לא מהווים גורם מגביל, העלאות מורכבות מקבילות יכולות להיות מהירות יותר מהעלאות רגילות. עם זאת, לאסטרטגיה הזו יש כמה מגבלות והשלכות על העלויות. מידע נוסף זמין במאמר העלאות מורכבות במקביל.
המלצות לאופטימיזציה של הביצועים בכל המוצרים בארכיטקטורה
אחרי שפורסים את עומס העבודה ב- Google Cloud, אפשר להמשיך לשפר את הביצועים של משאבי הענן באמצעות יישום ההמלצות הרלוונטיות של Active Assist.
במאמר נקודת מבט של AI ו-ML: אופטימיזציה של ביצועים ב-Well-Architected Framework, תוכלו לקרוא על עקרונות והמלצות לאופטימיזציה של ביצועים שרלוונטיים ספציפית לעומסי עבודה של AI ו-ML.
פריסה
כדי לבדוק איך GraphRAG פועל ב- Google Cloud, הורידו והריצו את קובץ ה-Jupyter notebook הבא מ-GitHub: GraphRAG on Google Cloud With Spanner Graph and Agent Runtime on Gemini Enterprise Agent Platform.
המאמרים הבאים
- פיתוח אפליקציות GraphRAG באמצעות Spanner Graph ו-LangChain
- בחירת רכיבי הארכיטקטורה של ה-AI האקטיבי
- תשתית RAG ל-AI גנרטיבי באמצעות Agent Platform וחיפוש וקטורי
- תשתית RAG ל-AI גנרטיבי באמצעות Agent Platform ו-AlloyDB ל-PostgreSQL
- תשתית RAG ל-AI גנרטיבי באמצעות GKE ו-Cloud SQL
- תשתית RAG ל-AI גנרטיבי באמצעות Gemini Enterprise ו-Agent Platform
- כדי לקבל מידע על עקרונות והמלצות לארכיטקטורה של עומסי עבודה של AI ב- Google Cloud, קראו את המאמר Well-Architected Framework: AI and ML perspective.
- לדוגמאות נוספות של ארכיטקטורות, תרשימים ושיטות מומלצות, עיינו במאמר Cloud Architecture Center.
שותפים ביצירת התוכן
מחברים:
- טריסטן לי | ארכיטקט ראשי, AI/ML
- קומאר דהנגופאל | מפתח פתרונות חוצי-מוצרים
תורמים אחרים:
- אסיף שייח' | מהנדס AI ללקוחות
- אשיש צ'אוהאן | מהנדס AI ללקוחות
- גרג ברוסמן | מנהל מוצר
- לוקאס ברודרר | מנהל מוצר, AI ב-Cloud
- ננדיטה אמבר | מהנדסת שירות לקוחות בתחום ה-AI
- פיוש מאת'ור | מנהל מוצר, Spanner
- סמית'ה ונקאט | מהנדסת AI ללקוחות