


במסמך הזה מוצגת ארכיטקטורה לדוגמה שאפשר להשתמש בה כדי לתכנן את התשתית להרצת אפליקציה של בינה מלאכותית גנרטיבית (AI) עם Retrieval-Augmented Generation (יצירה משולבת-אחזור, RAG). קהל היעד של המסמך הזה כולל מפתחים ואדמינים של אפליקציות מבוססות-AI גנרטיבי ו-Cloud Architects. ההנחה במסמך היא שיש לכם הבנה בסיסית במושגים שקשורים ל-AI, ללמידת מכונה (ML) ולמודלים גדולים של שפה (LLM). במסמך הזה לא מוסבר איך לעצב ולפתח אפליקציית AI גנרטיבי.
ארכיטקטורה
בתרשים הבא מוצגת סקירה כללית של ארכיטקטורה לאפליקציית AI גנרטיבי עם יכולות RAG ב- Google Cloud:
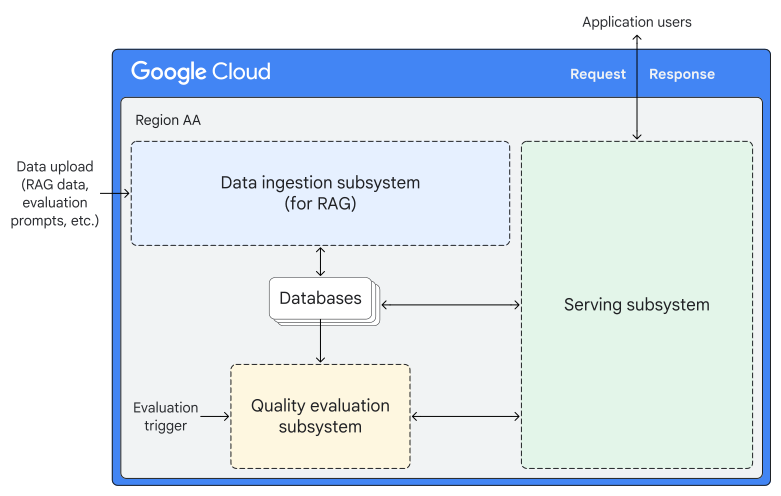
הארכיטקטורה מכילה את הרכיבים הבאים שמקושרים זה לזה:
| רכיב | מטרה | אינטראקציות |
|---|---|---|
| מערכת משנה להטמעת נתונים | הכנה ועיבוד של הנתונים החיצוניים שמשמשים להפעלת יכולת ה-RAG. | תת-המערכת של הטמעת הנתונים מקיימת אינטראקציה עם תת-המערכות האחרות בארכיטקטורה דרך שכבת מסד הנתונים. |
| תת-מערכת להצגת מודעות | לטפל בתהליך הבקשה-תגובה בין אפליקציית ה-AI הגנרטיבי לבין המשתמשים שלה. | תת-המערכת להצגת מודעות יוצרת אינטראקציה עם תת-המערכת להטמעת נתונים דרך שכבת מסד הנתונים. |
| מערכת משנה להערכת איכות | להעריך את איכות התשובות שמערכת המשנה להצגת מודעות יוצרת. | תת-המערכת להערכת איכות מקיימת אינטראקציה ישירה עם תת-המערכת להצגת מודעות, ועם תת-המערכת להטמעת נתונים דרך שכבת מסד הנתונים. |
| מסדי נתונים | לאחסן את הנתונים הבאים:
|
כל תת-המערכות בארכיטקטורה מקיימות אינטראקציה עם מסדי הנתונים. |
התרשים הבא מציג תצוגה מפורטת של הארכיטקטורה:
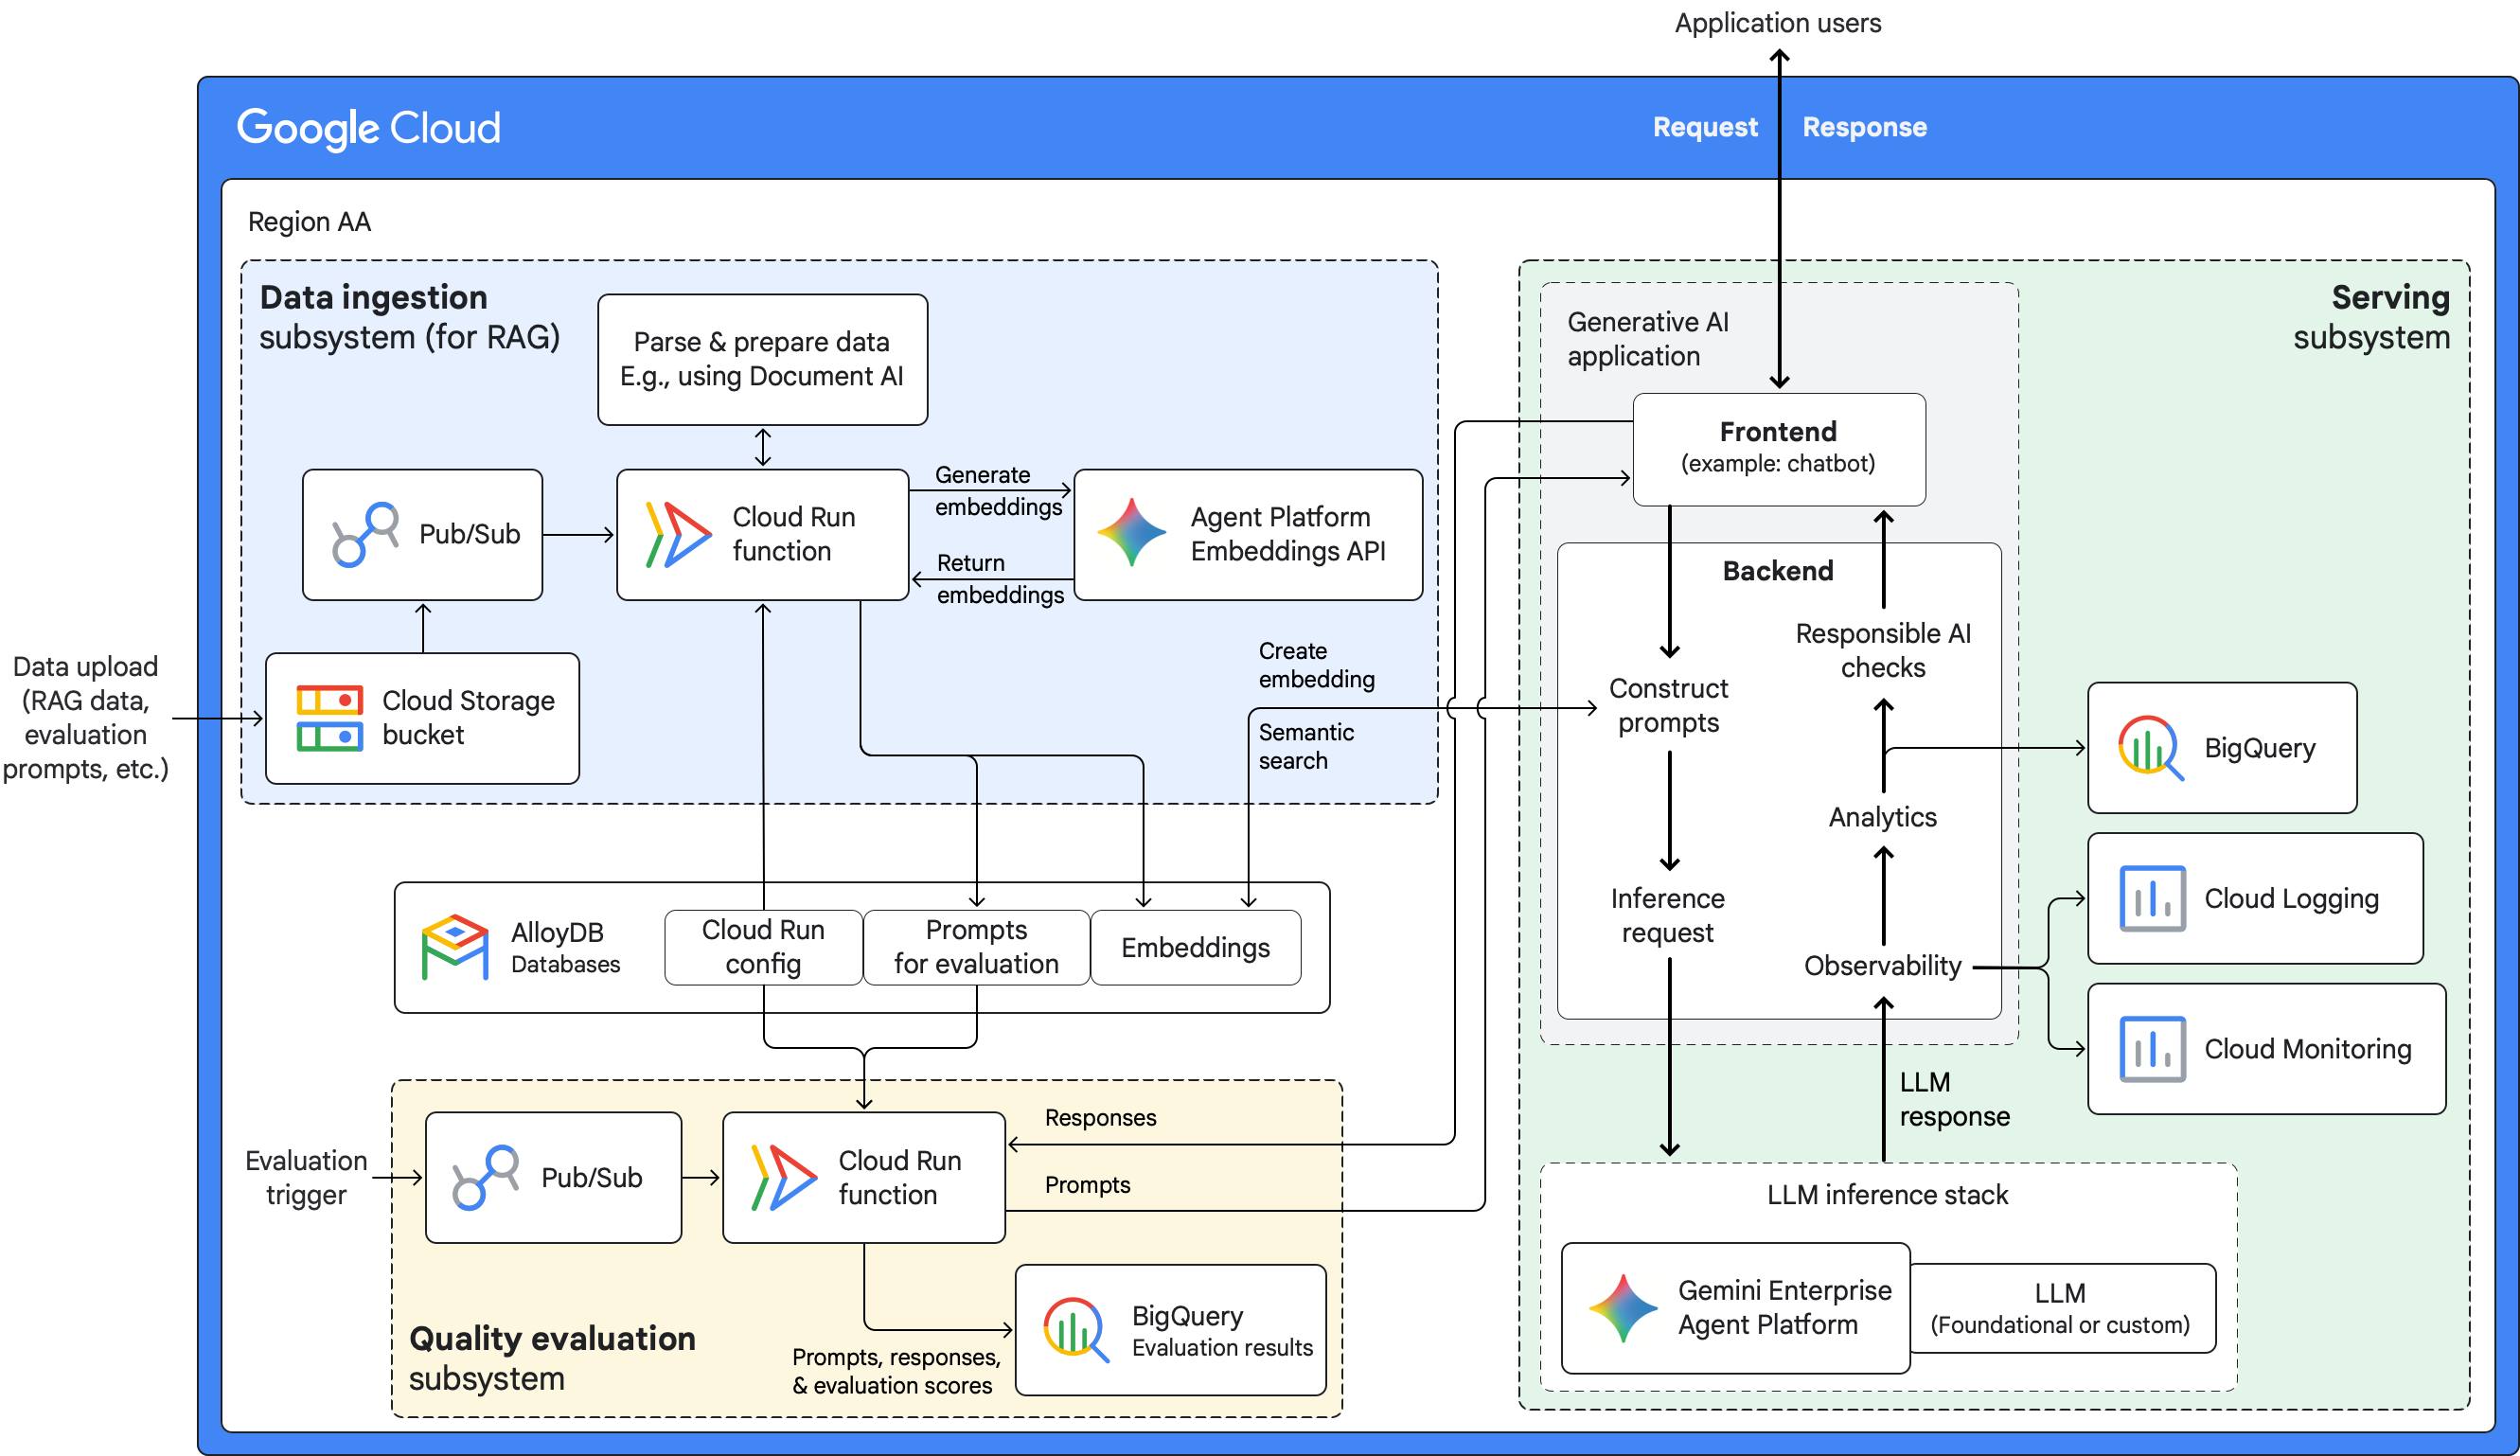
בקטעים הבאים מפורטים הרכיבים וזרימת הנתונים בכל תת-מערכת של הארכיטקטורה.
מערכת משנה להטמעת נתונים
תת-המערכת של הטמעת הנתונים מטמיעה נתונים ממקורות חיצוניים כמו קבצים, מסדי נתונים ושירותי סטרימינג. הנתונים שהועלו כוללים הנחיות להערכת איכות. תת-המערכת של הטמעת הנתונים מספקת את יכולת ה-RAG בארכיטקטורה. הדיאגרמה הבאה מציגה פרטים על תת-המערכת של הטמעת הנתונים בארכיטקטורה:
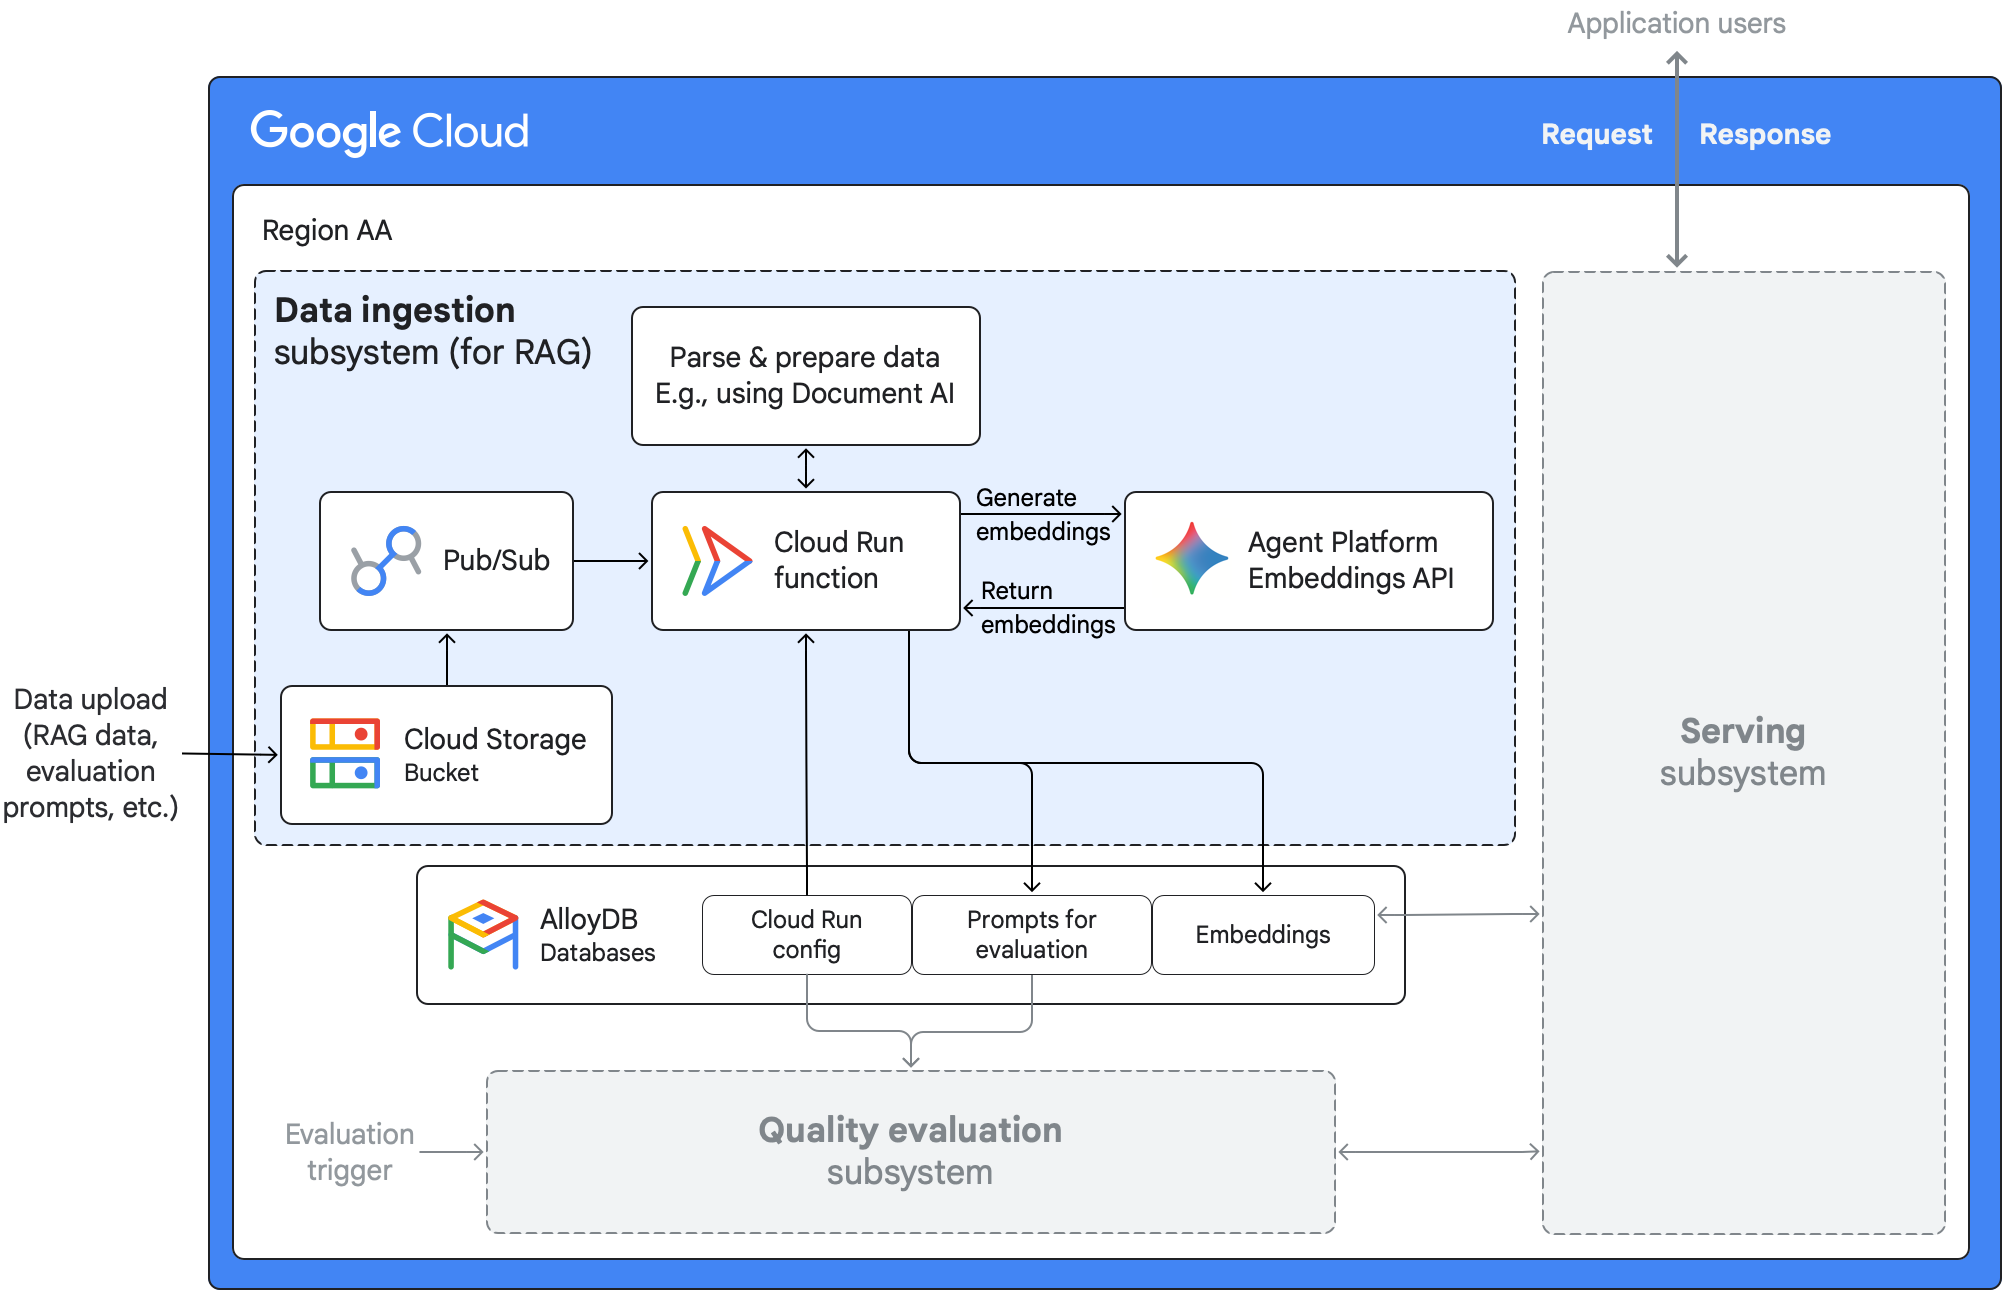
אלה השלבים בתהליך הטמעת הנתונים:
- הנתונים מועלים לקטגוריה של Cloud Storage. מקורות הנתונים יכולים להיות אפליקציות, מסדי נתונים או שירותי סטרימינג.
- כשמעלים נתונים ל-Cloud Storage, מתפרסמת הודעה בנושא Pub/Sub.
- Pub/Sub מפעיל פונקציית Cloud Run כדי לעבד את הנתונים שהועלו.
- הפונקציה מופעלת באמצעות נתוני תצורה שמאוחסנים במסד נתונים של AlloyDB ל-PostgreSQL.
- הפונקציה מנתחת את הנתונים הגולמיים, מעצבת אותם לפי הצורך ומחלקת אותם למקטעים.
הפונקציה משתמשת במודל הטמעה מתאים ב-Gemini Enterprise Agent Platform כדי ליצור הטמעות וקטוריות של הנתונים שהוטמעו.
הפונקציה שומרת את ההטמעות במסד נתונים של AlloyDB ל-PostgreSQL, שבו מופעל התוסף
pgvector. כמו שמתואר בקטע הבא, כשמערכת המשנה להצגת מודעות מעבדת בקשות של משתמשים, היא משתמשת בהטמעות במסד הנתונים הווקטורי כדי לאחזר נתונים רלוונטיים שספציפיים לדומיין.
תת-מערכת להצגת מודעות
תת-המערכת להצגת מודעות מטפלת בתהליך הבקשה-תגובה בין אפליקציית ה-AI הגנרטיבי לבין המשתמשים שלה. התרשים הבא מציג את הפרטים של תת-מערכת ההצגה בארכיטקטורה:
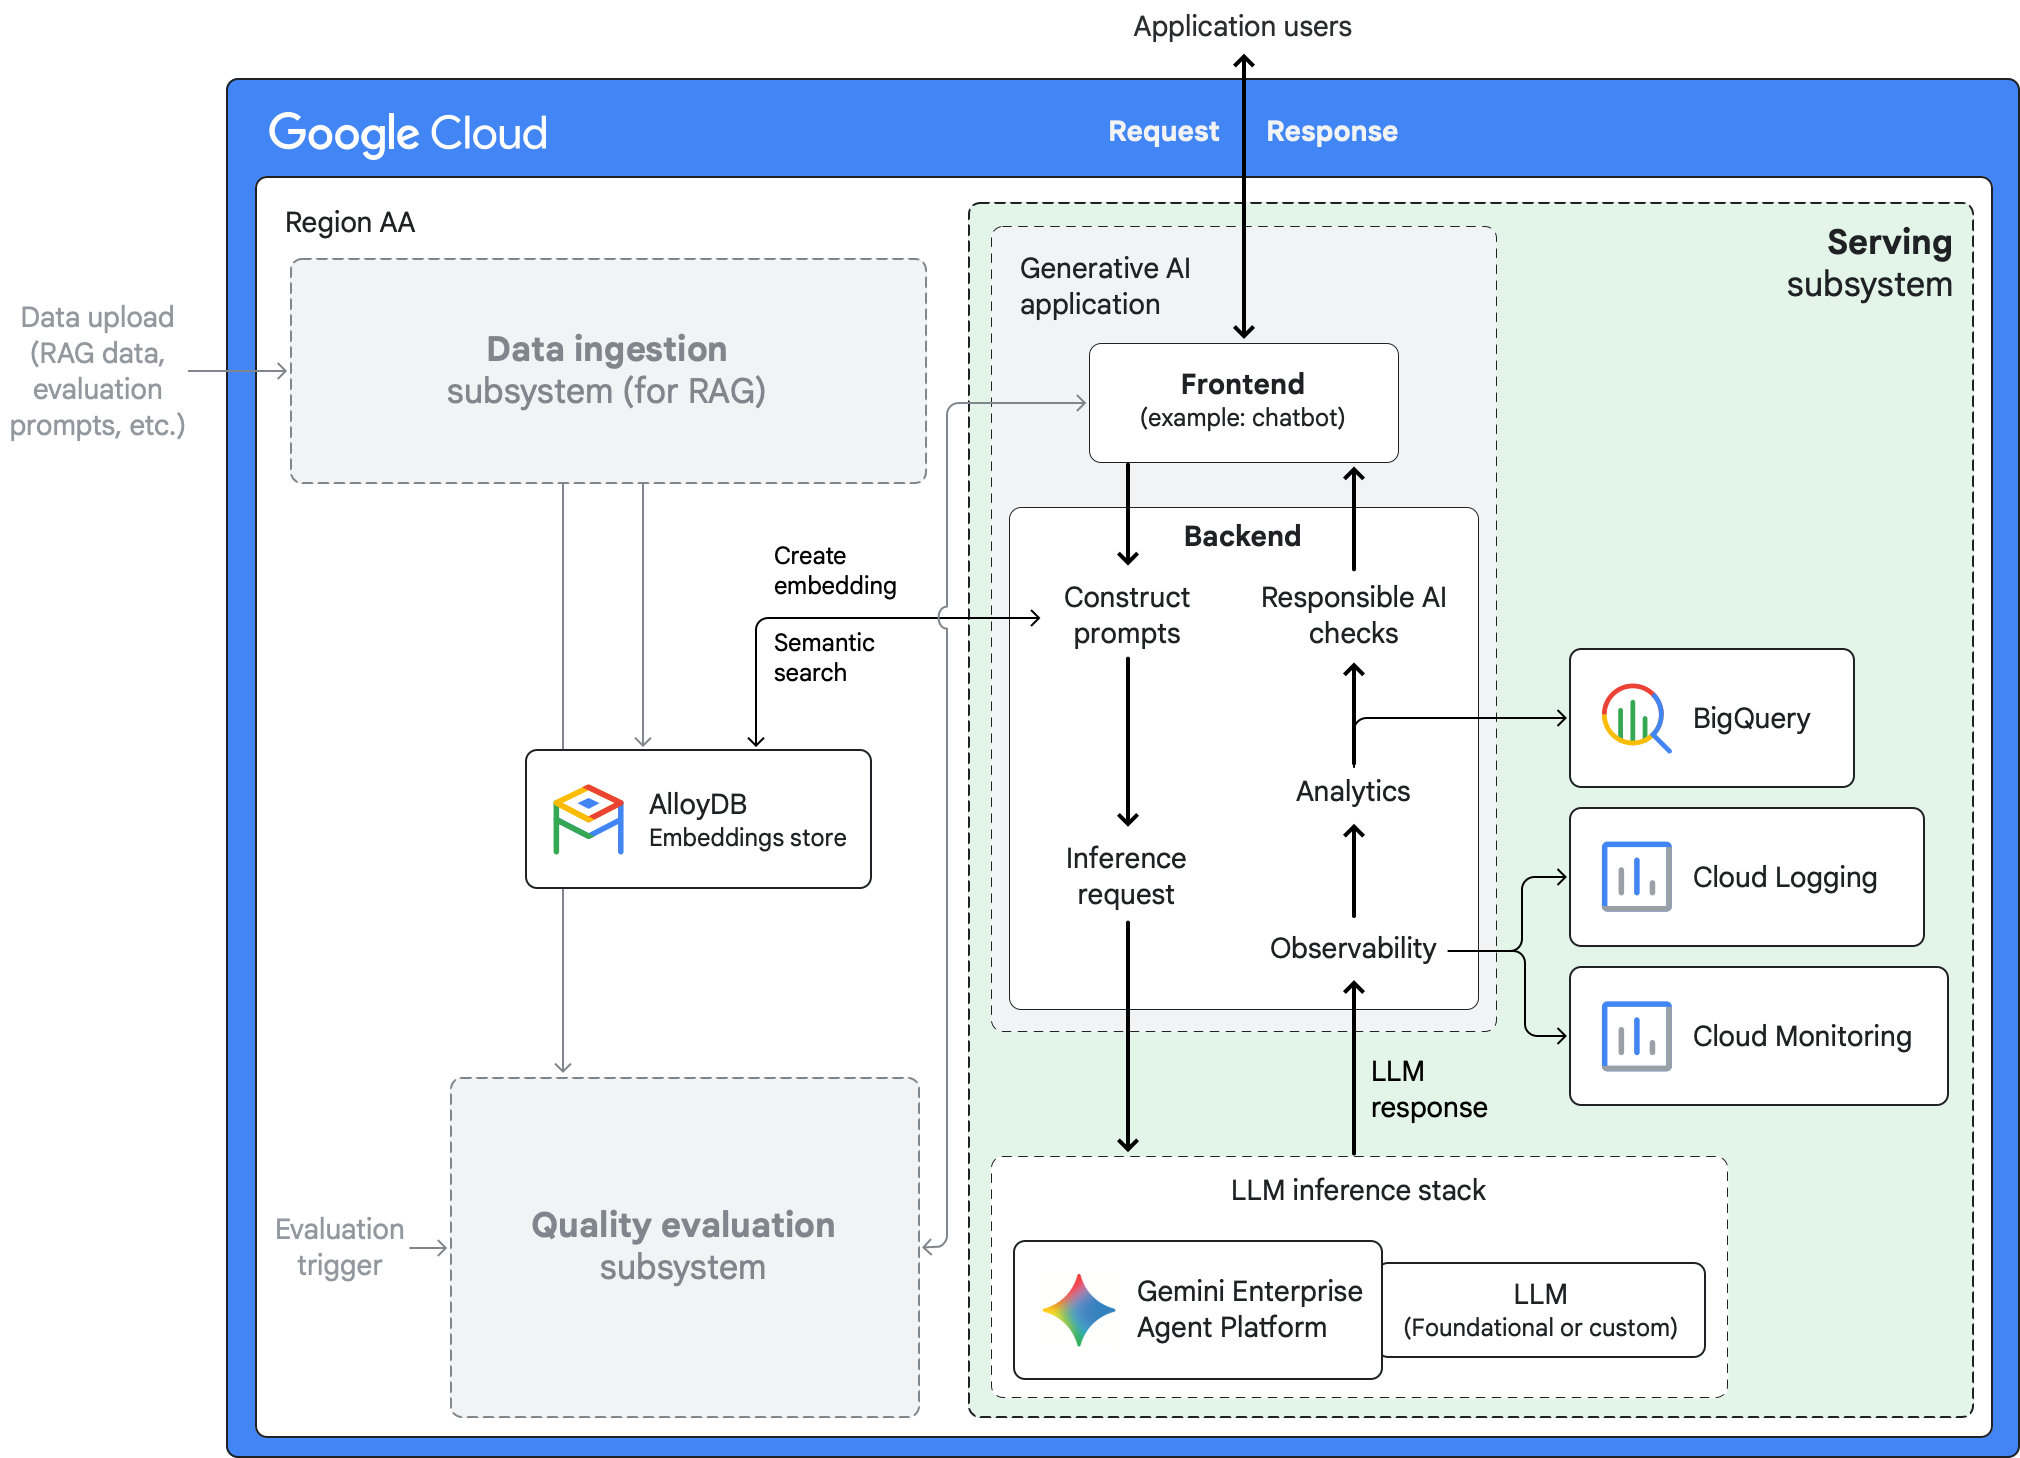
אלה השלבים בתהליך הבקשה והתגובה בתת-המערכת להצגת מודעות:
- המשתמשים שולחים בקשות לאפליקציית ה-AI הגנרטיבי דרך ממשק קצה (לדוגמה, צ'אט בוט או אפליקציה לנייד).
אפליקציית ה-AI הגנרטיבי ממירה את הבקשה בשפה טבעית להטמעות.
האפליקציה משלימה את שלב השליפה של גישת ה-RAG:
- האפליקציה מבצעת חיפוש סמנטי של ההטמעה במאגר הווקטורים של AlloyDB ל-PostgreSQL, שמנוהל על ידי תת-המערכת להטמעת נתונים. חיפוש סמנטי עוזר למצוא הטמעות על סמך הכוונה של ההנחיה, ולא על סמך התוכן הטקסטואלי שלה.
- האפליקציה משלבת את הבקשה המקורית עם הנתונים הגולמיים שאוחזרו על סמך ההטמעה התואמת, כדי ליצור הנחיה לפי הקשר.
האפליקציה שולחת את ההנחיה עם ההקשר למחסנית הסקת מסקנות של LLM שפועלת ב-Agent Platform.
מחסנית ההסקה של ה-LLM משתמשת ב-LLM של AI גנרטיבי, שיכול להיות מודל LLM בסיסי או מודל LLM בהתאמה אישית, ויוצרת תשובה שמוגבלת להקשר שסופק.
- האפליקציה יכולה לאחסן יומנים של פעילות הבקשה-תגובה ב-Cloud Logging. אתם יכולים לצפות ביומנים ולהשתמש בהם למעקב באמצעות Cloud Monitoring. Google לא ניגשת לנתוני היומן ולא משתמשת בהם.
- האפליקציה טוענת את התשובות ל-BigQuery לצורך ניתוח אופליין.
האפליקציה מסננת את התשובות באמצעות מסנני AI אחראי.
האפליקציה שולחת את התשובות המסוננות למשתמשים דרך ממשק המשתמש.
מערכת משנה להערכת איכות
בתרשים הבא מוצגים פרטים על תת-המערכת להערכת איכות בארכיטקטורה:
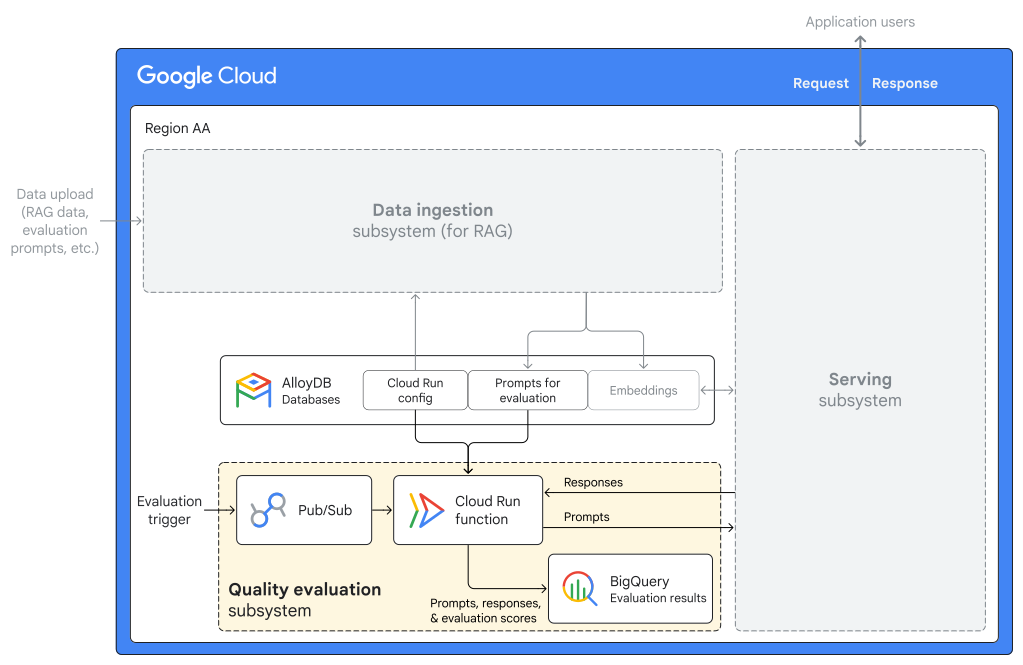
כשמערכת המשנה להערכת איכות מקבלת בקשה, היא מבצעת את הפעולות הבאות:
- Pub/Sub מפעיל פונקציית Cloud Run.
- הפונקציה מופעלת באמצעות נתוני תצורה שמאוחסנים במסד נתונים של AlloyDB ל-PostgreSQL.
- הפונקציה שולפת הנחיות להערכה ממסד נתונים של AlloyDB ל-PostgreSQL. ההנחיות הועלו בעבר למסד הנתונים על ידי תת-המערכת להטמעת נתונים.
הפונקציה משתמשת בהנחיות להערכה כדי לבדוק את איכות התשובות שנוצרות על ידי תת-המערכת להצגת מודעות.
הפלט של ההערכה הזו כולל ציוני הערכה למדדים כמו דיוק עובדתי ורלוונטיות.
הפונקציה טוענת את ציוני ההערכה, את ההנחיות ואת התשובות שהוערכו ל-BigQuery לצורך ניתוח עתידי.
המוצרים שהשתמשו בהם
הטבלה הבאה מסכמת את כל מוצרי Google Cloud שמשמשים בארכיטקטורה הקודמת:
- Gemini Enterprise Agent Platform: פלטפורמה מקיפה שמאפשרת לפתח, להרחיב, לנהל ולשפר סוכני AI ברמה שמתאימה לארגונים.
- פונקציות Cloud Run: פלטפורמת מחשוב בלי שרת (serverless computing) שמאפשרת להריץ פונקציות למטרה יחידה ישירות ב- Google Cloud.
- BigQuery: מחסן נתונים (data warehouse) ארגוני שעוזר לנהל ולנתח את הנתונים באמצעות תכונות מובנות כמו למידת מכונה, ניתוח נתונים גיאו-מרחביים ובינה עסקית (BI).
- Cloud Storage: מאגר אובייקטים ללא הגבלה ובעלות נמוכה, לסוגי נתונים שונים. אפשר לגשת לנתונים מתוך Google Cloudומחוץ לו, והם משוכפלים במיקומים שונים כדי ליצור יתירות.
- AlloyDB ל-PostgreSQL: שירות מנוהל של מסד נתונים שתואם ל-PostgreSQL, שמיועד לעומסי העבודה הכי כבדים, כולל עיבוד היברידי של טרנזקציות וניתוח נתונים.
- Pub/Sub: שירות אסינכרוני וניתן להתאמה להעברת הודעות, שמפריד בין השירותים שיוצרים את ההודעות לבין השירותים שמעבדים אותן.
- Cloud Logging: מערכת לניהול יומנים בזמן אמת עם אחסון, חיפוש, ניתוח והתראות.
- Cloud Monitoring: שירות שמאפשר לראות את נתוני הביצועים, הזמינות והתקינות של האפליקציות והתשתית.
תרחישים לדוגמה
RAG היא שיטה יעילה לשיפור איכות הפלט שנוצר ממודל שפה גדול (LLM). בקטע הזה מפורטות דוגמאות לתרחישים שבהם אפשר להשתמש באפליקציות של AI גנרטיבי עם יכולות RAG.
המלצות מותאמות אישית על מוצרים
אתר קניות אונליין יכול להשתמש בצ'אט בוט שמבוסס על LLM כדי לעזור ללקוחות למצוא מוצרים או לקבל עזרה שקשורה לקניות. אפשר להוסיף לשאלות של המשתמש נתונים היסטוריים על דפוסי הקנייה והאינטראקציה שלו עם האתר. הנתונים יכולים לכלול ביקורות ומשובים של משתמשים שמאוחסנים במאגר נתונים לא מובנים, או מדדים שקשורים לחיפוש שמאוחסנים במחסן נתונים לצורכי ניתוח התנהגות המשתמשים. לאחר מכן, מודל ה-LLM יכול לעבד את השאלה המורחבת כדי ליצור תשובות מותאמות אישית שיכולות להיות מושכות ומשכנעות יותר למשתמש.
מערכות סיוע קליניות
רופאים בבתי חולים צריכים לבדוק ולסכם את המידע הרפואי של המטופלים כדי לקבל החלטות מושכלות לגבי הטיפול. אפליקציית AI גנרטיבי שמשתמשת במודל בסיס רפואי כמו MedGemma יכולה לעזור לרופאים לסכם הערות קליניות ולבדוק את ההקשר הרפואי. התשובות שהאפליקציה יוצרת יכולות להיות מעוגנות בנתונים בסיכומי מצב בריאותי היסטוריים של מטופלים, על ידי הוספת הקשר לפרומפטים באמצעות נתונים ממסד הנתונים של התיקים הרפואיים האלקטרוניים (EHR) של בית החולים או ממאגר ידע חיצוני כמו PubMed.
מחקר משפטי יעיל
מחקר משפטי מבוסס-AI גנרטיבי מאפשר לעורכי דין לשלוח במהירות שאילתות על כמויות גדולות של חוקים ופסקי דין, כדי לזהות תקדימים משפטיים רלוונטיים או לסכם מושגים משפטיים מורכבים. כדי לשפר את תוצאות המחקר, אפשר להוסיף להנחיות של עורך הדין נתונים שאוחזרו ממאגר המידע הקנייני של משרד עורכי הדין, שכולל חוזים, תכתובות משפטיות קודמות ורשומות פנימיות של תיקים. הגישה הזו עוזרת ליצור תשובות שרלוונטיות לתחום המשפטי שבו עורך הדין מתמחה.
חלופות לעיצוב
בקטע הזה מוצגות גישות עיצוב חלופיות שאפשר להשתמש בהן באפליקציית ה-AI הגנרטיבי עם יכולות RAG ב- Google Cloud.
חיפוש וקטורי מנוהל
אם אתם צריכים ארכיטקטורה שמשתמשת במוצר חיפוש וקטורי מנוהל, אתם יכולים להשתמש ב-Agent Platform ובחיפוש וקטורי, שמספקים תשתית אופטימלית להצגת מודעות לחיפוש וקטורי בקנה מידה גדול מאוד. מידע נוסף זמין במאמר תשתית RAG ל-AI גנרטיבי באמצעות Agent Platform ו-חיפוש וקטורי.
כלים ומודלים של קוד פתוח
אם אתם רוצים לפתח ולפרוס במהירות אפליקציות של AI גנרטיבי עם יכולות RAG באמצעות כלים ומודלים בקוד פתוח כמו Ray, Hugging Face ו-LangChain, קראו את המאמר תשתית RAG ל-AI גנרטיבי באמצעות GKE ו-Cloud SQL.
ארכיטקטורות RAG אחרות
מידע על אפשרויות ארכיטקטורה נוספות לעומסי עבודה של RAG זמין במאמר AI גנרטיבי עם RAG.
שיקולים שקשורים לעיצוב
בקטע הזה מוסבר איך לפתח ארכיטקטורת AI גנרטיבי עם יכולות RAG ב- Google Cloud , שעומדת בדרישות הספציפיות שלכם בנושאי אבטחה ותאימות, אמינות, עלות וביצועים. ההנחיות בקטע הזה הן חלקיות. בהתאם לדרישות הספציפיות של אפליקציית ה-AI הגנרטיבי ו Google Cloud המוצרים והתכונות שבהם אתם משתמשים, יכול להיות שתצטרכו להביא בחשבון גורמי תכנון ופשרות נוספים.
אבטחה ותאימות
בקטע הזה מוסבר מה צריך להביא בחשבון כשמתכננים ויוצרים אפליקציית AI גנרטיבי עם יכולות RAG ב- Google Cloud , שעומדת בדרישות האבטחה והתאימות שלכם.
| מוצר | שיקולים שקשורים לעיצוב |
|---|---|
| Agent Platform | פלטפורמת Agent Platform תומכת ב Google Cloud אמצעי בקרה לאבטחה שמאפשרים לעמוד בדרישות לגבי מיקום אחסון הנתונים, הצפנת נתונים, אבטחת רשת ו-Access Transparency. מידע נוסף זמין במאמרים אמצעי בקרה לאבטחה של שירותי למידת מכונה ואמצעי בקרה לאבטחה של AI גנרטיבי. |
| פונקציות Cloud Run | כדי להגן על הנתונים באמצעות מפתח שבשליטתכם, אתם יכולים להשתמש במפתחות הצפנה בניהול הלקוח (CMEK). מידע נוסף מופיע במאמר שימוש במפתחות הצפנה בניהול הלקוח. |
| AlloyDB ל-PostgreSQL |
כברירת מחדל, הנתונים שמאוחסנים ב-AlloyDB ל-PostgreSQL מוצפנים באמצעות Google-owned and Google-managed encryption keys. אם אתם צריכים להשתמש במפתחות הצפנה שאתם שולטים בהם ומנהלים אותם, אתם יכולים להשתמש ב-CMEK. למידע נוסף, קראו את המאמר מידע על CMEK. כדי לצמצם את הסיכון לזליגת נתונים ממסדי נתונים של AlloyDB ל-PostgreSQL, אתם יכולים ליצור גבולות גזרה לשירות באמצעות VPC Service Controls. כברירת מחדל, מכונה של AlloyDB ל-PostgreSQL מקבלת רק חיבורים שמשתמשים ב-SSL. כדי לאבטח עוד יותר את החיבורים למסדי הנתונים של AlloyDB ל-PostgreSQL, אתם יכולים להשתמש במחבר AlloyDB ל-PostgreSQL Auth Proxy. המחבר של שרת ה-Proxy לאימות מספק הרשאת חיבור שמבוססת על ניהול זהויות והרשאות גישה (IAM), ומשתמש בחיבור TLS 1.3 עם הצפנת AES של 256 ביט כדי לאמת את זהויות הלקוח והשרת ולהצפין את תעבורת הנתונים. מידע נוסף זמין במאמר מידע על שרת ה-proxy לאימות של AlloyDB ל-PostgreSQL. בחיבורים שנוצרו באמצעות Java, Python או Go, השתמשו במחבר השפה המתאים במקום במחבר Auth Proxy. AlloyDB ל-PostgreSQL עוזר לכם לעמוד בדרישות לגבי מיקום אחסון הנתונים. הנתונים מאוחסנים או משוכפלים באזורים שאתם מציינים. |
| BigQuery |
ב-BigQuery יש הרבה תכונות שמאפשרות לכם לשלוט בגישה לנתונים, להגן על נתונים רגישים ולוודא שהנתונים מדויקים ועקביים. למידע נוסף, קראו את המאמר מבוא למשילות מידע (data governance) ב-BigQuery. בעזרת BigQuery אתם יכולים לעמוד בדרישות לגבי מיקום אחסון הנתונים. הנתונים מאוחסנים באזור שאתם מציינים. |
| Cloud Storage |
כברירת מחדל, הנתונים שמאוחסנים ב-Cloud Storage מוצפנים באמצעות Google-owned and Google-managed encryption keys. במקרה הצורך, אתם יכולים להשתמש במפתחות CMEK או במפתחות משלכם שאתם מנהלים באמצעות שיטת ניהול חיצונית, כמו מפתחות הצפנה באספקת הלקוח (CSEK). למידע נוסף, קראו את המאמר אפשרויות להצפנת נתונים. ב-Cloud Storage יש שתי שיטות שבאמצעותן אפשר לתת למשתמשים גישה לקטגוריות ולאובייקטים: IAM ורשימות של בקרת גישה (ACL). ברוב המקרים, מומלץ להשתמש ב-IAM, שמאפשר לתת הרשאות ברמת הקטגוריה והפרויקט. למידע נוסף, קראו את המאמר סקירה כללית על בקרת הגישה. יכול להיות שהנתונים שאתם טוענים לתת-המערכת של הטמעת הנתונים דרך Cloud Storage כוללים מידע רגיש. כדי להגן על הנתונים האלה, אתם יכולים להשתמש ב-Sensitive Data Protection כדי לגלות, לסווג ולהסיר פרטי זיהוי מהנתונים. מידע נוסף זמין במאמר שימוש ב-Sensitive Data Protection עם Cloud Storage. בעזרת Cloud Storage אתם יכולים לעמוד בדרישות לגבי מיקום אחסון הנתונים. הנתונים מאוחסנים או משוכפלים באזורים שאתם מציינים. |
| Pub/Sub |
כברירת מחדל, כל ההודעות ב-Pub/Sub מוצפנות במצב מנוחה ובזמן העברה באמצעות Google-owned and Google-managed encryption keys. ב-Pub/Sub אפשר להשתמש במפתחות CMEK להצפנת הודעות בשכבת האפליקציה. מידע נוסף זמין במאמר הגדרת הצפנת הודעות. אם יש לכם דרישות לגבי מיקום אחסון הנתונים, כדי לוודא שנתוני ההודעות מאוחסנים במיקומים ספציפיים, אתם יכולים להגדיר כללי מדיניות לאחסון הודעות. |
| Cloud Logging |
יומני הביקורת של פעילות אדמין מופעלים כברירת מחדל בכל Google Cloud השירותים שמשמשים בארכיטקטורה לדוגמה הזו. ביומנים האלה מתועדות קריאות ל-API או פעולות אחרות שמשנות את ההגדרות או את המטא-נתונים של משאבי Google Cloud . יומני הביקורת של גישה לנתונים מופעלים כברירת מחדל ב-BigQuery. בשירותים האחרים שמשתמשים בהם בארכיטקטורה הזו, אתם יכולים להפעיל יומני ביקורת של גישה לנתונים. היומנים מאפשרים לעקוב אחרי קריאות ל-API שקוראות את ההגדרות או את המטא-נתונים של המשאבים, או אחרי בקשות של משתמשים ליצור, לשנות או לקרוא נתוני משאבים שסופקו על ידי משתמשים. כדי לעמוד בדרישות של מיקום אחסון הנתונים, אתם יכולים להגדיר את Cloud Logging כך שיאחסן את נתוני היומנים באזור שאתם מציינים. למידע נוסף, קראו את המאמר הגדרת אזור ליומנים. |
במאמר נקודת מבט על AI ו-ML: אבטחה ב-Well-Architected Framework מפורטים עקרונות אבטחה והמלצות ספציפיים לעומסי עבודה של AI ו-ML.
אמינות
בקטע הזה מתוארים גורמי התכנון שצריך להביא בחשבון כדי לבנות ולהפעיל תשתית אמינה לאפליקציית AI גנרטיבי עם יכולות RAG ב-Google Cloud.
| מוצר | שיקולים שקשורים לעיצוב |
|---|---|
| AlloyDB ל-PostgreSQL |
כברירת מחדל, אשכולות AlloyDB ל-PostgreSQL מספקים זמינות גבוהה (HA) עם יתירות כשל אוטומטית. למכונה הראשית יש צמתים מיותרים שנמצאים בשני אזורים שונים בתוך אזור. היתירות הזו מבטיחה שהאשכולות יהיו עמידים בפני הפסקות זמניות בשירות באזורים. כדי להתכונן להתאוששות מהפסקות זמניות בשירות באזור, אפשר להשתמש ברפליקציה בין אזורים. |
| BigQuery |
הנתונים שאתם טוענים ל-BigQuery נשמרים באופן סינכרוני בשני אזורים בתוך המיקום שציינתם. היתירות הזו עוזרת להבטיח שהנתונים לא יאבדו במקרה של הפסקה זמנית בפעילות של אזור. למידע נוסף על תכונות האמינות ב-BigQuery, קראו את המאמר הסבר על אמינות. |
| Cloud Storage | אפשר ליצור קטגוריות של Cloud Storage באחד משלושה סוגי מיקומים: אזורי, שני אזורים או מספר אזורים. נתונים שמאוחסנים בקטגוריות אזוריות משוכפלים באופן סינכרוני בכמה אזורים בתוך אזור. כדי להגביר את הזמינות, אפשר להשתמש בקטגוריות של שני אזורים או של מספר אזורים, שבהן הנתונים משוכפלים באופן אסינכרוני בין אזורים. |
| Pub/Sub |
כדי לנהל עליות חדות זמניות בתנועת ההודעות, אפשר להגדיר בקרת זרימה בהגדרות של בעל האפליקציה. כדי לטפל בפרסומים שנכשלו, משנים את המשתנים של בקשות הניסיון החוזר לפי הצורך. למידע נוסף, קראו את המאמר ניסיון חוזר של בקשות. |
במאמר נקודת מבט על AI ו-ML: אמינות ב-Well-Architected Framework מפורטים עקרונות והמלצות לאמינות שספציפיים לעומסי עבודה של AI ו-ML.
הוזלת עלויות
בקטע הזה מוסבר איך לבצע אופטימיזציה של עלויות ההגדרה וההפעלה של אפליקציית AI גנרטיבי עם יכולות RAG ב- Google Cloud.
| מוצר | שיקולים שקשורים לעיצוב |
|---|---|
| AlloyDB ל-PostgreSQL |
כברירת מחדל, המכונה הראשית של אשכול AlloyDB ל-PostgreSQL היא בזמינות גבוהה (HA). למכונה יש צומת פעיל וצומת במצב המתנה. אם הצומת הפעיל נכשל, AlloyDB ל-PostgreSQL עובר אוטומטית לצומת ההמתנה. אם אתם לא צריכים זמינות גבוהה למסדי הנתונים, אתם יכולים להוזיל את העלויות על ידי הפיכת המכונה הראשית של האשכול למכונה בסיסית. מכונה בסיסית לא עמידה בפני הפסקות חשמל באזור, וזמן ההשבתה שלה ארוך יותר במהלך פעולות תחזוקה. מידע נוסף מופיע במאמר הפחתת עלויות באמצעות מכונות בסיסיות. אם אתם יכולים לחזות את דרישות המעבד (CPU) והזיכרון של מכונת AlloyDB ל-PostgreSQL, תוכלו לחסוך כסף באמצעות הנחות תמורת התחייבות לשימוש. מידע נוסף מופיע במאמר הנחות תמורת התחייבות לשימוש ב-AlloyDB ל-PostgreSQL. |
| BigQuery | ב-BigQuery אפשר להעריך את עלות השאילתות לפני שמריצים אותן. כדי להוזיל את עלויות השאילתות, צריך לבצע אופטימיזציה של האחסון ושל חישוב השאילתות. למידע נוסף, קראו את המאמר הערכה ובקרה של עלויות. |
| Cloud Storage | לקטגוריה של Cloud Storage שמשמשת לטעינת נתונים לתת-המערכת של הטמעת הנתונים, בוחרים סוג אחסון מתאים על סמך הדרישות של שמירת הנתונים ותדירות הגישה של עומסי העבודה. לדוגמה, אתם יכולים לבחור בסוג האחסון Standard ולהשתמש בניהול מחזור החיים של אובייקטים כדי לשלוט בעלויות האחסון. לשם כך, אתם יכולים להגדיר תנאים שבהם אובייקטים ישונמכו אוטומטית לסוג אחסון בעלות נמוכה יותר, או יימחקו. |
| Cloud Logging |
כדי לשלוט בעלות האחסון של היומנים, אתם יכולים:
|
במאמר נקודת מבט של AI ו-ML: אופטימיזציה של עלויות ב-Well-Architected Framework, תוכלו לקרוא על עקרונות והמלצות לאופטימיזציה של עלויות שספציפיות לעומסי עבודה של AI ו-ML.
ביצועים
בקטע הזה מתוארים הגורמים שצריך להביא בחשבון כשמתכננים ויוצרים אפליקציית AI גנרטיבי עם יכולות RAG ב- Google Cloud , שעומדת בדרישות הביצועים שלכם.
| מוצר | שיקולים שקשורים לעיצוב |
|---|---|
| AlloyDB ל-PostgreSQL |
כדי לעזור לכם לנתח ולשפר את ביצועי השאילתות של מסדי הנתונים, AlloyDB ל-PostgreSQL מספק את הכלי Query Insights. אתם יכולים להשתמש בכלי הזה כדי לעקוב אחרי הביצועים ולמצוא את המקור של שאילתה בעייתית. מידע נוסף זמין במאמר סקירה כללית על תובנות לגבי שאילתות. כדי לקבל סקירה כללית על הסטטוס והביצועים של מסדי הנתונים, ולראות מדדים מפורטים כמו שיא החיבורים ועיכוב הרפליקציה המקסימלי, אתם יכולים להשתמש בלוח הבקרה של System Insights. מידע נוסף מופיע במאמר מעקב אחרי מכונה באמצעות מרכז הבקרה של AlloyDB ל-PostgreSQL System Insights. כדי להפחית את העומס על המכונה הראשית של AlloyDB ל-PostgreSQL ולהרחיב אופקית את הקיבולת לטיפול בבקשות קריאה, אתם יכולים להוסיף לאשכול מכונות של מאגר קריאה. מידע נוסף זמין במאמר צמתים ומכונות של AlloyDB ל-PostgreSQL. |
| BigQuery |
ב-BigQuery יש תרשים הפעלה של שאילתות שמאפשר לנתח את הביצועים של השאילתות ולקבל תובנות לגבי הביצועים לבעיות כמו תחרות על יחידות קיבולת (Slot) ומכסה לא מספיקה של מיון נתונים (shuffle). מידע נוסף זמין במאמר קבלת תובנות לגבי ביצועי שאילתות. אחרי שתטפלו בבעיות שזיהיתם באמצעות התובנות לגבי ביצועי השאילתות, תוכלו לבצע אופטימיזציה נוספת של השאילתות באמצעות שיטות כמו הפחתת נפח נתוני הקלט והפלט. למידע נוסף, קראו את המאמר שיפור חישוב השאילתות. |
| Cloud Storage | כדי להעלות קבצים גדולים, אתם יכולים להשתמש בשיטה שנקראת העלאות מורכבות מקבילות. באסטרטגיה הזאת, הקובץ הגדול מפוצל לחלקים. החלקים מועלים ל-Cloud Storage במקביל, ואז הנתונים מורכבים מחדש בענן. העלאות מורכבות מקבילות יכולות להיות מהירות יותר מהעלאות רגילות, בתנאי שרוחב הפס של הרשת ומהירות הכתיבה לדיסק לא מהווים גורם מגביל. עם זאת, לאסטרטגיה הזו יש כמה מגבלות והשלכות על העלויות. מידע נוסף זמין במאמר העלאות מורכבות במקביל. |
במאמר נקודת מבט על AI ו-ML: אופטימיזציה של ביצועים ב-Well-Architected Framework, תוכלו לקרוא על עקרונות והמלצות לאופטימיזציה של ביצועים שספציפיים לעומסי עבודה של AI ו-ML.
פריסה
כדי להתחיל להתנסות בבניית תשתית ב- Google Cloudלאפליקציות של AI גנרטיבי עם יכולות RAG, אתם יכולים להשתמש בקוד לדוגמה שזמין ב-GitHub. הקוד הזה פורס אפליקציית צ'אט שמבוססת על Python ב-Cloud Run, ומשתמש במסד נתונים מנוהל לחלוטין של Cloud SQL לחיפוש וקטורי.
המאמרים הבאים
- בחירת מודלים ותשתית לאפליקציית ה-AI הגנרטיבי
- פיתוח אפליקציית צ'אט מבוססת-LLM ו-RAG באמצעות AlloyDB ל-PostgreSQL ו-LangChain
- תשתית RAG ל-AI גנרטיבי באמצעות Agent Platform וחיפוש וקטורי
- תשתית RAG ל-AI גנרטיבי באמצעות GKE ו-Cloud SQL
- תשתית RAG ל-AI גנרטיבי באמצעות Gemini Enterprise ו-Agent Platform
- תשתית GraphRAG ל-AI גנרטיבי באמצעות Agent Platform ו-Spanner Graph
- לסקירה כללית של עקרונות והמלצות לארכיטקטורה שספציפיים לעומסי עבודה של AI ו-ML ב- Google Cloud, קראו את המאמר נקודת המבט של AI ו-ML ב-Well-Architected Framework.
- לדוגמאות נוספות של ארכיטקטורות, תרשימים ושיטות מומלצות, עיינו במאמר Cloud Architecture Center.
שותפים ביצירת התוכן
מחבר: Kumar Dhanagopal | מפתח פתרונות חוצי-מוצרים
תורמים אחרים:
- אנדרו ברוק | מנהל הנדסה
- אנה ברנברג | עמיתת הנדסה
- אסף נמר | ארכיטקט ראשי לאבטחת ענן
- Balachandar Krishnamoorthy | מהנדס תוכנה ראשי
- דניאל ליס | ארכיטקט אבטחה בענן
- דרק דאוני | מהנדס קשרי מפתחים
- ערן לואיס | מנהל מוצר בכיר
- ג'פרי אנדרסון | מנהל מוצר
- Gleb Otochkin | Cloud Advocate, Databases
- האמסה בוואראגהאן | מנהלת מוצר בתחום ה-AI
- אירינה סיגלר | מנהלת מוצר
- ג'ק וות'רספון | אחראי קשרי מפתחים (Developers Advocate)
- ג'ייסון דבנפורט | אחראי קשרי מפתחים (Developer Advocate)
- ג'ורדן טוטן | מהנדס לקוחות
- ג'וליה ויזינגר | מנהלת מוצר
- קארה גרינפילד | מהנדסת לקוחות
- קורטיס ואן גנט | מהנדס תוכנה בכיר
- Per Jacobsson | מהנדס תוכנה
- פראנב נאמביאר | מנהל
- ריצ'רד הנדריקס | צוות מרכז הארכיטקטורה
- Safiuddin Khaja | Cloud Engineer
- סנדי גאי | מנהל קבוצת מוצרים
- ולדימיר ווסקוביץ' | מנהל ניהול מוצר
- סטראן ג'יאניני | מנהל קבוצת מוצרים
- Wietse Venema | מהנדס קשרי מפתחים